主要成果:パッケージサイズの巨大化と主流技術の予測
AIチップのトレンドはトランジスタレベルからパッケージングレベルへと移行しており、パッケージサイズがレティクル限界(露光装置で一度に描画できる最大面積)を大幅に超えて拡大しています。TrendForceの分析によると、技術的な成熟度と歩留まりの優位性から、TSMCのCoWoS-Lが2028年までAIチップ向け高度パッケージングの主流であり続ける見通しです。一方で、IntelのEMIB-Tなどの代替ソリューションがAIチップ顧客への導入を積極的に進めています。
技術詳細:CoWoS-LとEMIB-Tのアプローチ
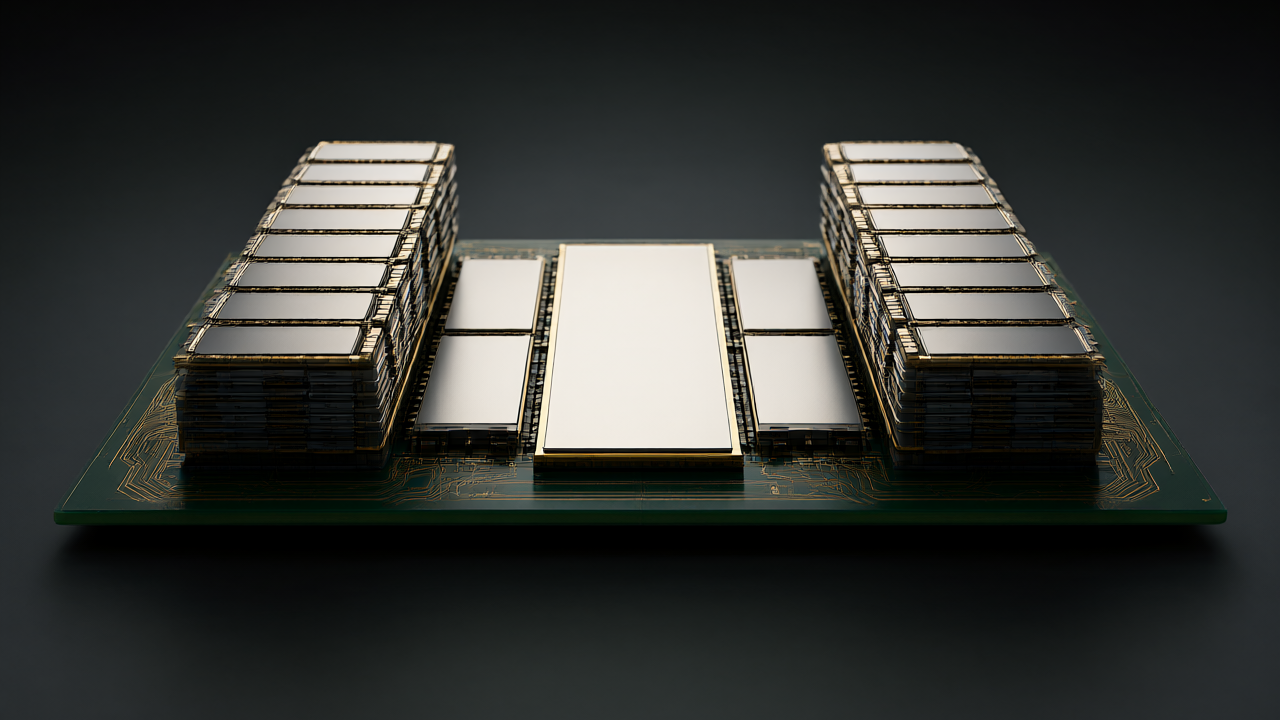
TSMCのCoWoS-Lは、再配線層(RDL)に「ローカルシリコンインターコネクト(LSI)」と呼ばれる小さなシリコンダイを埋め込む構造を採用しています。LSIが高密度なダイ間接続(SoC間、SoC-チップレット間、SoC-HBM間)を担い、RDLが広範囲の信号・電力伝送を担うことで、コストと複雑さを抑えつつパッケージサイズの拡大を可能にしています。また、SoC直下に埋め込みディープトレンチキャパシタ(eDTC)を配置し、電力管理を向上させる構成も可能です。
対するIntelのEMIB-Tは、パッケージ基板に小さなシリコンブリッジを埋め込む手法です。最新のEMIB-Tではシリコンブリッジにシリコン貫通電極(TSV)を追加し、基板からチップへ電力を垂直に供給することで、電力経路の短縮と電力密度の向上を実現しています。ECTC 2026で提示された仕様では、第1層インターコネクトのバンプピッチを25マイクロメートルまで縮小し、パッケージサイズを120mm x 120mmまで拡大。レティクル面積の9倍以上の演算・メモリチップの統合をサポートし、12Gb/sのHBM4eや64Gb/sのUCIeなどの高速インターコネクトに対応しています。
背景:GPUおよびASICにおける統合密度の向上
パッケージの拡大はGPUだけでなくAI ASICにも波及しています。NvidiaのBlackwellはレティクル限界の約3.3倍の面積に達しており、次世代のRubinでは4倍になると予想されます。Rubin GPUは3,360億個のトランジスタを搭載し、HBM4の採用により最大288GBのメモリ容量と22TB/sのメモリ帯域幅を提供します。また、AMDの次世代MI455Xは8つの演算チップで構成され、72基のGPUを搭載するHeliosラックスケールシステムをターゲットとしています。クラウド事業者では、GoogleのTPU v7やAWSのTrainium v3などが2026年以降の展開を見せています。
今後の展望:量産スケジュールと採用動向
TSMCは2024年に3.5倍レティクルのCoWoS-Lを量産開始し、2025年の公開資料では5.5倍レティクルソリューションの認定を完了させ、2026年の量産開始を計画しています。Nvidia、AMD、Meta(MTIA 400)がすでにCoWoS-Lを採用しており、MicrosoftやAWSも2027年に採用すると予想されます。一方、IntelのEMIB-Tは、CoWoS-Lのコストやキャパシティを懸念するメーカーにとっての代替案となっており、Googleが2027年に採用し、AWSが技術テストを行う見込みです。
元記事: https://finance.biggo.com/news/4eb5b699-fd87-4922-8d26-0463a5d2360e
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます