HIGH BANDWIDTH MEMORY · TECHNOLOGY EXPLAINER
HBMとは何か
High Bandwidth Memory(広帯域メモリ)は、なぜAI時代に「積む・近づける・広げる」必要があったのか。初心者から素材技術者まで、構造・材料・限界を一つの流れで理解します。
- HBMとは何か(3行でつかむ)
- なぜHBMが必要になったのか
- DDR・GDDRとの違い
- 帯域幅が広くなる仕組み
- 構造:TSV・マイクロバンプ・ベースダイ・インターポーザ
- 素材技術者の視点:薄化・封止・反り・放熱
- 世代比較(HBMからHBM4まで)
- AIアクセラレータで重要な理由
- 課題:発熱・歩留まり・コスト
- これから(HBM5・SPHBM4・ハイブリッドボンディング)
- 用語集/参考資料/出典対応表
数値の性格を混同させないため、以下のバッジで区別しています。
事実=JEDEC規格またはメーカー・ベンダーの公表資料に記載のある値(出典リンクあり)
本稿の計算=公表値から本記事が算出した概算値
未確定/将来=開発中・検討段階であり、確定した仕様や量産実績ではない事項
1. HBMとは何か(3行でつかむ)
HBM(High Bandwidth Memory/広帯域メモリ)を一言でいうと、 「DRAMを縦に積み、プロセッサのすぐ隣に置き、極端に本数の多い配線でつないだメモリ」です。 JEDEC(半導体の国際標準化団体)が2013年に最初の規格を発行しました。
- 積む:DRAMのチップを4〜16枚、上下に重ねて1つの立体(スタック/キューブ)にする
- 近づける:基板上ではなく、プロセッサと同じパッケージの中、数mmの距離に置く
- 広げる:データ配線を1,024本(HBM4では2,048本)に増やす事実 (JEDEC, 2025)
この3つの組み合わせにより、HBM4では1スタックあたり最大2 TB/sという帯域幅がJEDEC規格で定義されています 事実。 一般的なPC用のDDR5メモリモジュール1枚(DDR5-6400)の帯域幅が約51.2 GB/s本稿の計算であることを考えると、 その差はおよそ40倍です。
2. なぜHBMが必要になったのか
演算は速くなったのに、データが届かない
コンピュータの性能は「計算する力」と「データを運ぶ力」の両方で決まります。 この数十年、計算する力(プロセッサ)は急速に伸びましたが、 メモリからデータを運ぶ力はそれほど伸びませんでした。 結果として、演算器が仕事を終えて次のデータを待っている時間が増えます。 これが「メモリの壁」と呼ばれる問題です。
生成AI、とくに大規模言語モデル(LLM)の推論では、この問題が極端な形で現れます。 文章を1文字(1トークン)生成するたびに、モデルの重みデータをメモリから読み出す必要があります。 モデルが数百GBの規模になると、「どれだけ速く計算できるか」ではなく「どれだけ速くメモリから読み出せるか」で処理速度が決まってしまいます。
周波数を上げる道が行き詰まった
データを運ぶ力を上げる方法は、原理的には2つしかありません。 (A) 1本の配線を速く動かすか、(B) 配線の本数を増やすかです。
従来のDDRやGDDRは主に(A)の道を進んできました。しかし基板(プリント基板)の上を数cm走る配線を 高い周波数で駆動すると、信号の波形が崩れ、消費電力が跳ね上がります。 配線1本を速くするほど、送信回路も受信回路も強力にしなければならず、電力とノイズの両面で限界に近づきました。
HBMの答え:配線を「短く」して「本数」で勝負する
HBMは(B)の道を選びました。ただし、基板の上に1,000本以上の高速配線を引くことは物理的に困難です。 そこでHBMは発想を変えます。
- DRAMを縦に積んで、平面の専有面積を減らす
- プロセッサと同じパッケージの中に置き、配線距離を数cmから数mmへ縮める
- 基板ではなくシリコンの配線層(インターポーザ)で結び、µm単位の細さで数千本を引く
配線が短くなると、信号の反射や減衰が小さくなり、低い電圧・低い周波数のまま大量のデータを流せます。 実際HBM3規格では、ホスト側インタフェースに0.4Vという低振幅(low-swing)の信号を採用し、動作電圧を1.1Vに下げています 事実(JEDEC, 2022)。
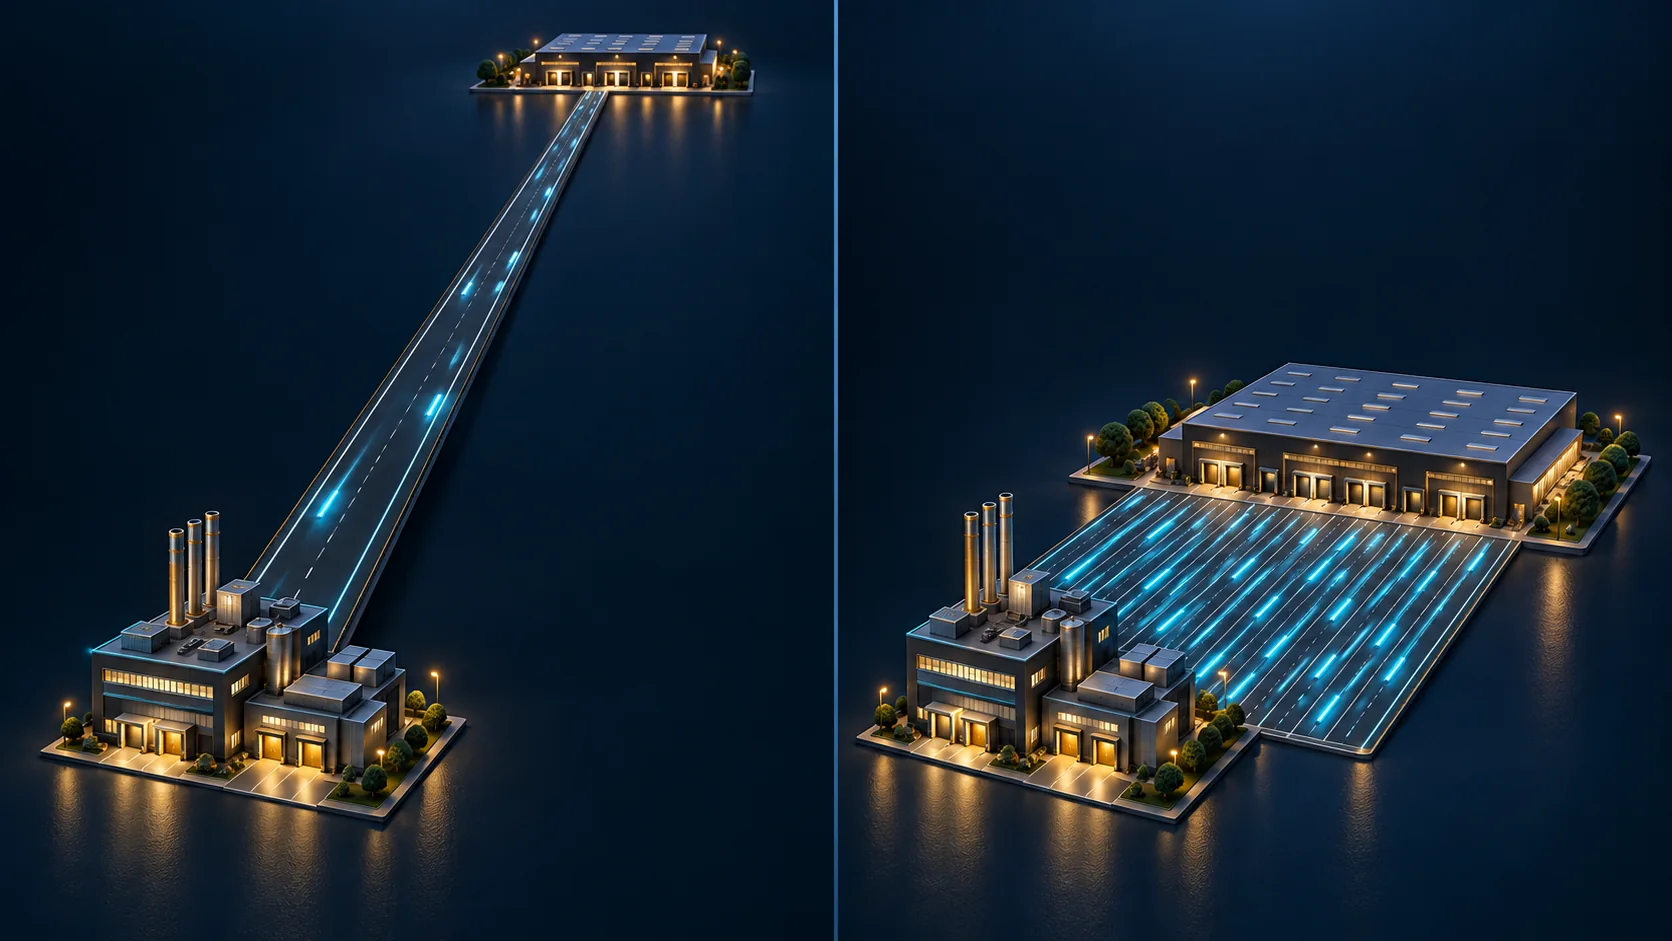
GDDRは「2車線の道路を、制限速度ぎりぎりのスピードで走らせる」方式。 HBMは「速度は控えめでも、2,048車線を用意する」方式です。 ただし2,048車線の道路を長距離で作るのは不可能なので、工場(プロセッサ)の真横に倉庫(DRAM)を建てて、数mmだけつなぐ——それがHBMの発想です。
3. DDR・GDDRとの違い
| 比較軸 | DDR5(PC・サーバ本体メモリ) | GDDR7(グラフィックス) | HBM4 |
|---|---|---|---|
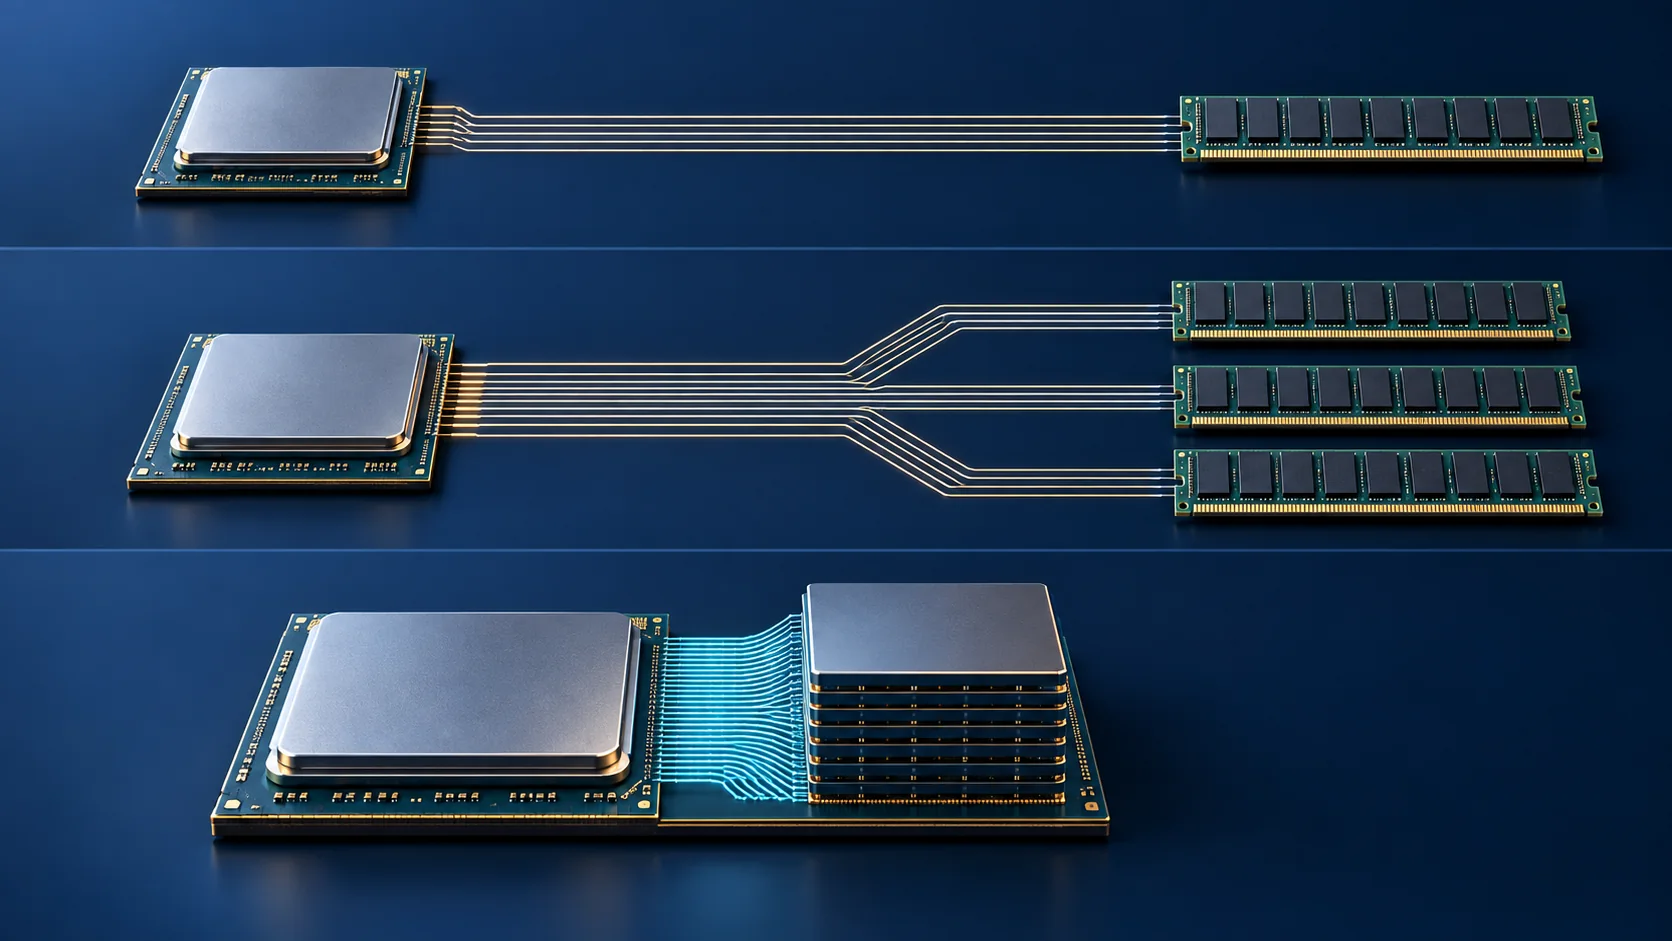
| 実装形態 | DIMMモジュール(着脱可能) | 基板上にパッケージ単品を並べる | プロセッサと同一パッケージ内、積層 |
| プロセッサまでの距離 | 数cm〜十数cm | 数cm | 数mm |
| データ配線の本数 | 64bit/モジュール | 数十bit/デバイス | 2,048bit/スタック 事実 |
| 帯域幅 | 約51.2 GB/s(DDR5-6400 1枚)本稿の計算 | 最大192 GB/s/デバイス 事実 | 最大2 TB/s/スタック 事実 |
| 容量の増やし方 | モジュールを挿し足す(TB級まで可) | デバイス数を増やす | スタック数・段数で決まる(増設不可) |
| 交換・修理 | 可能 | 基板実装のため実質不可 | 不可(パッケージ一体) |
| コスト | 低い | 中程度 | 高い(先端パッケージが必須) |
| 主な用途 | PC・サーバの主記憶 | ゲーミングGPU・民生機器 | AIアクセラレータ・HPC |
※表は横にスクロールできます。GDDR7の192 GB/sはJEDEC JESD239が定める1デバイスあたりの上限値です。GPUボードでは複数デバイスを並べて合計帯域を稼ぎます。
重要なのは、HBMがDDRの「上位互換」ではないという点です。 HBMは容量を後から増やせず、単価も高い。DDRは帯域では劣るが、安く、大容量まで拡張でき、交換もできる。 現在のAIサーバは、HBMとDDRを役割分担させて両方を搭載しています。
4. 帯域幅が広くなる仕組み
メモリの帯域幅は、次のシンプルな式で決まります。
| メモリ | 配線本数 | 1本あたり速度 | 帯域幅 | 区分 |
|---|---|---|---|---|
| HBM4(JEDEC規格の上限) | 2,048 bit | 8 Gb/s | 2,048 GB/s = 2 TB/s | 事実 |
| HBM3(JEDEC規格の上限) | 1,024 bit | 6.4 Gb/s | 819 GB/s | 事実 |
| DDR5-6400 DIMM 1枚 | 64 bit | 6.4 GT/s | 51.2 GB/s | 本稿の計算 |
注目すべきは、HBMの1本あたりの速度はDDR5と大差がないことです(HBM4で8 Gb/s、DDR5-6400で6.4 GT/s)。 HBMが速いのは、1本1本が速いからではなく、本数が32倍あるからです。 「速くする」のではなく「広くする」——これがHigh Bandwidth Memoryという名前の意味です。
5. 構造:TSV・マイクロバンプ・ベースダイ・インターポーザ
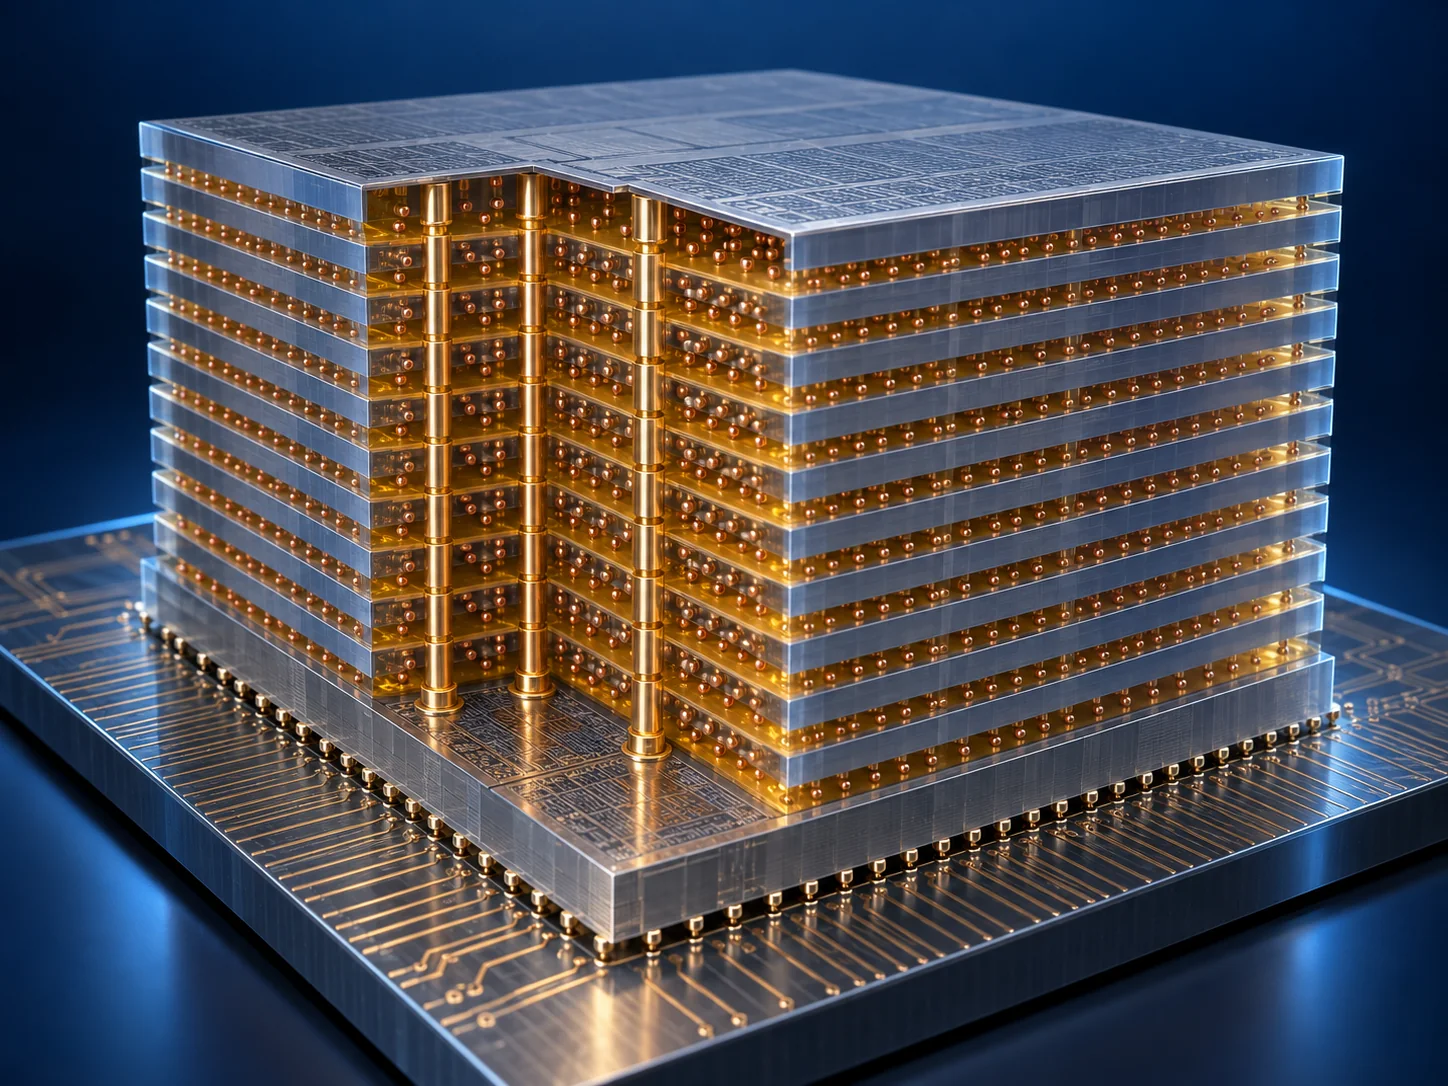
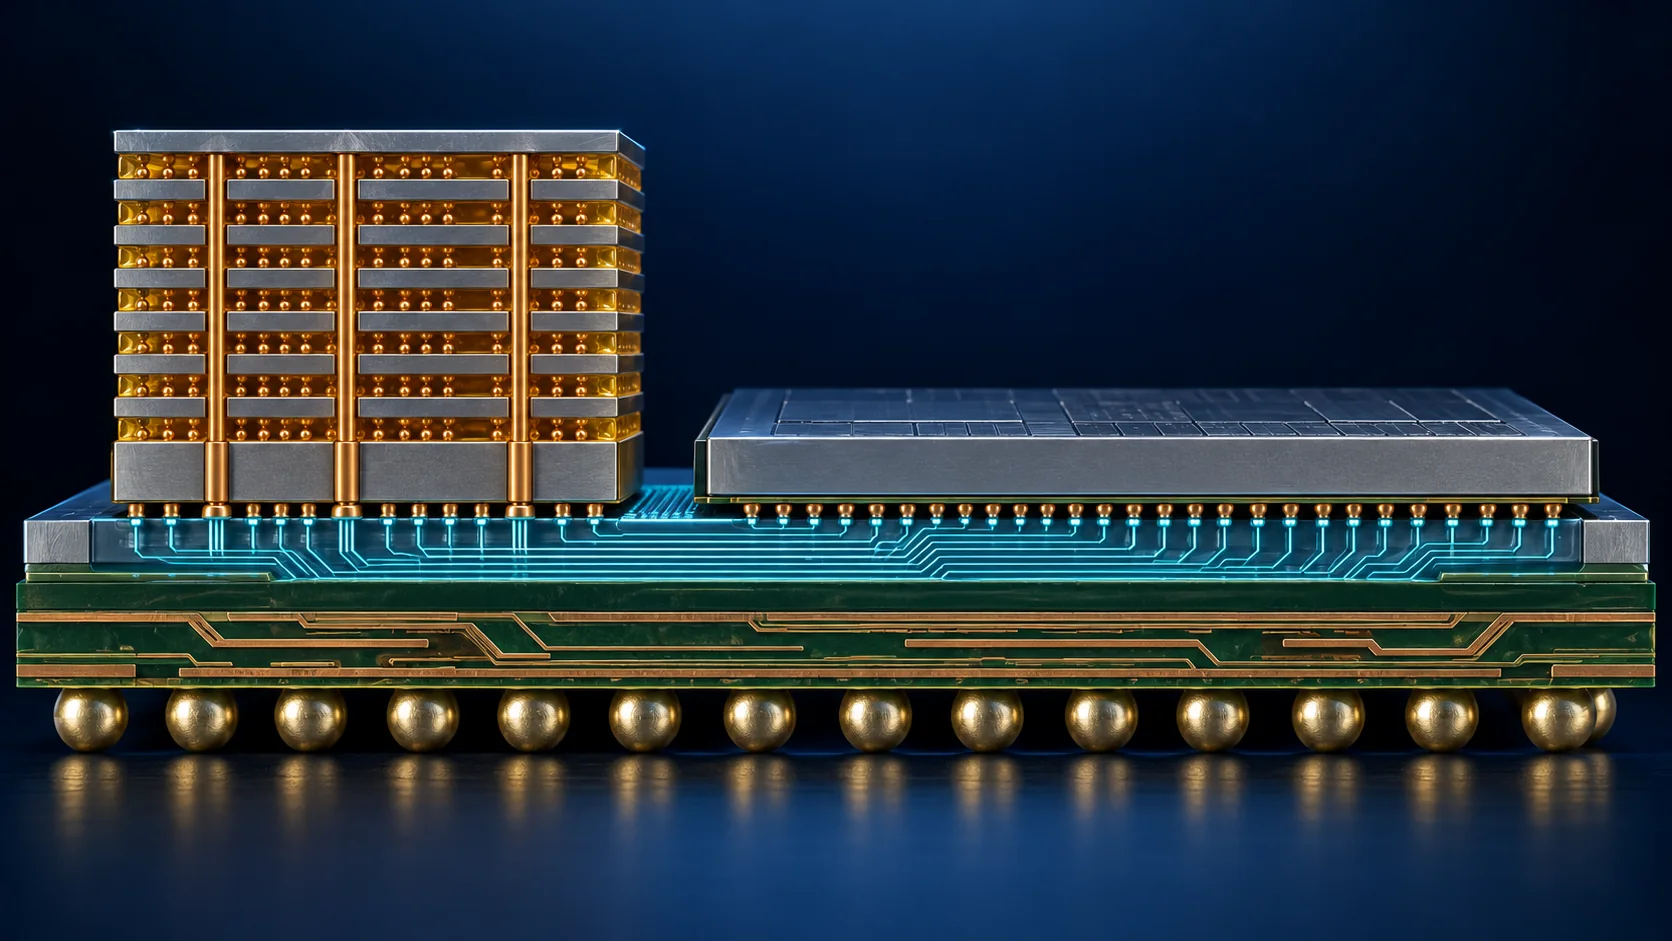
HBMは「1個の部品」ではなく、複数の要素を立体的に組み上げた構造体です。下から順に見ていきます。
それぞれの役割
- DRAMコアダイ:実際にデータを記憶する層。JEDEC規格では4段・8段・12段・16段の構成が定義されています事実。
- ベースダイ:スタックの最下層にある制御用のチップ。外部とのインタフェースやテスト機能を担います。
- TSV(Through-Silicon Via/シリコン貫通電極):シリコンのダイを上下に貫通する銅の電極。これがなければ積んだチップ同士を短距離でつなげません。HBMを成立させている最重要要素です。
- マイクロバンプ:ダイとダイ、ダイとインターポーザをつなぐ微小な接合部。銅ピラーとはんだで構成されます。
- 封止材:ダイ間の隙間を埋める樹脂。機械的保護に加え、熱の通り道としても働きます(→第6章)。
- シリコンインターポーザ:HBMスタックとロジックダイを載せる「土台」。シリコン上の微細配線で数千本の接続を実現します。
HBM4ではデータ配線が1,024本から2,048本へ倍増し、独立チャネル数も16から32へ倍増しました事実 (JEDEC, 2025)。 配線が倍になるということは、ベースダイとインターポーザの接続点も倍になるということです。 これがパッケージ技術の難度を一段引き上げました。
6. 素材技術者の視点:薄化・封止・反り・放熱
HBMの性能競争は、実のところDRAM回路の競争であると同時に、材料とプロセスの競争です。 ここが、一般的なHBM解説ではあまり語られない部分です。
(1) ダイ薄化 ― 段数を増やしても高さを増やせない
HBMはパッケージの総厚が決まっているため、段数を増やすにはDRAMチップ自体を薄くするしかありません。 SK hynixは、12段のHBM3では8段品に対してDRAMチップを40%薄くしたと公表しています事実 (SK hynix)。 Samsungも、TC-NCF技術により12段品を8段品と同じパッケージ高さに収めたと述べています事実 (Samsung, 2024)。
薄くすれば当然、反りやすく、割れやすくなります。ここから先はすべて材料と応力の話になります。
(2) 封止方式の二大系統:MR-MUF と TC-NCF
積んだダイの隙間をどう埋めるか。大きく2つのアプローチがあり、メーカーによって選択が分かれています。
| 方式 | MR-MUF(マスリフロー成形アンダーフィル) | TC-NCF(熱圧着+非導電性フィルム) |
|---|---|---|
| 工程の考え方 | ダイを積んだ後、バンプを一括リフローで接合し、液状の封止樹脂を流し込んで硬化 | あらかじめNCFフィルムを貼り、1段ごとに熱と圧力をかけて接合 |
| 主な材料 | EMC(エポキシ樹脂をベースとする熱硬化性の封止材) | NCF(非導電性フィルム) |
| 放熱面 | 熱の拡散に効くサーマルダミーバンプをTC-NCF比で最大4倍配置できるとする事実 | バンプサイズを使い分けることで熱特性を改善するとする事実 |
| 公表されている成果 | Advanced MR-MUF用の新EMCは従来EMC比1.6倍の放熱性。HBM2EはHBM2比で放熱性能36%改善事実 | チップ間ギャップ7µmを達成し、HBM3 8段品比で垂直密度20%超向上事実 |
| 出典 | SK hynix Newsroom | Samsung Newsroom |
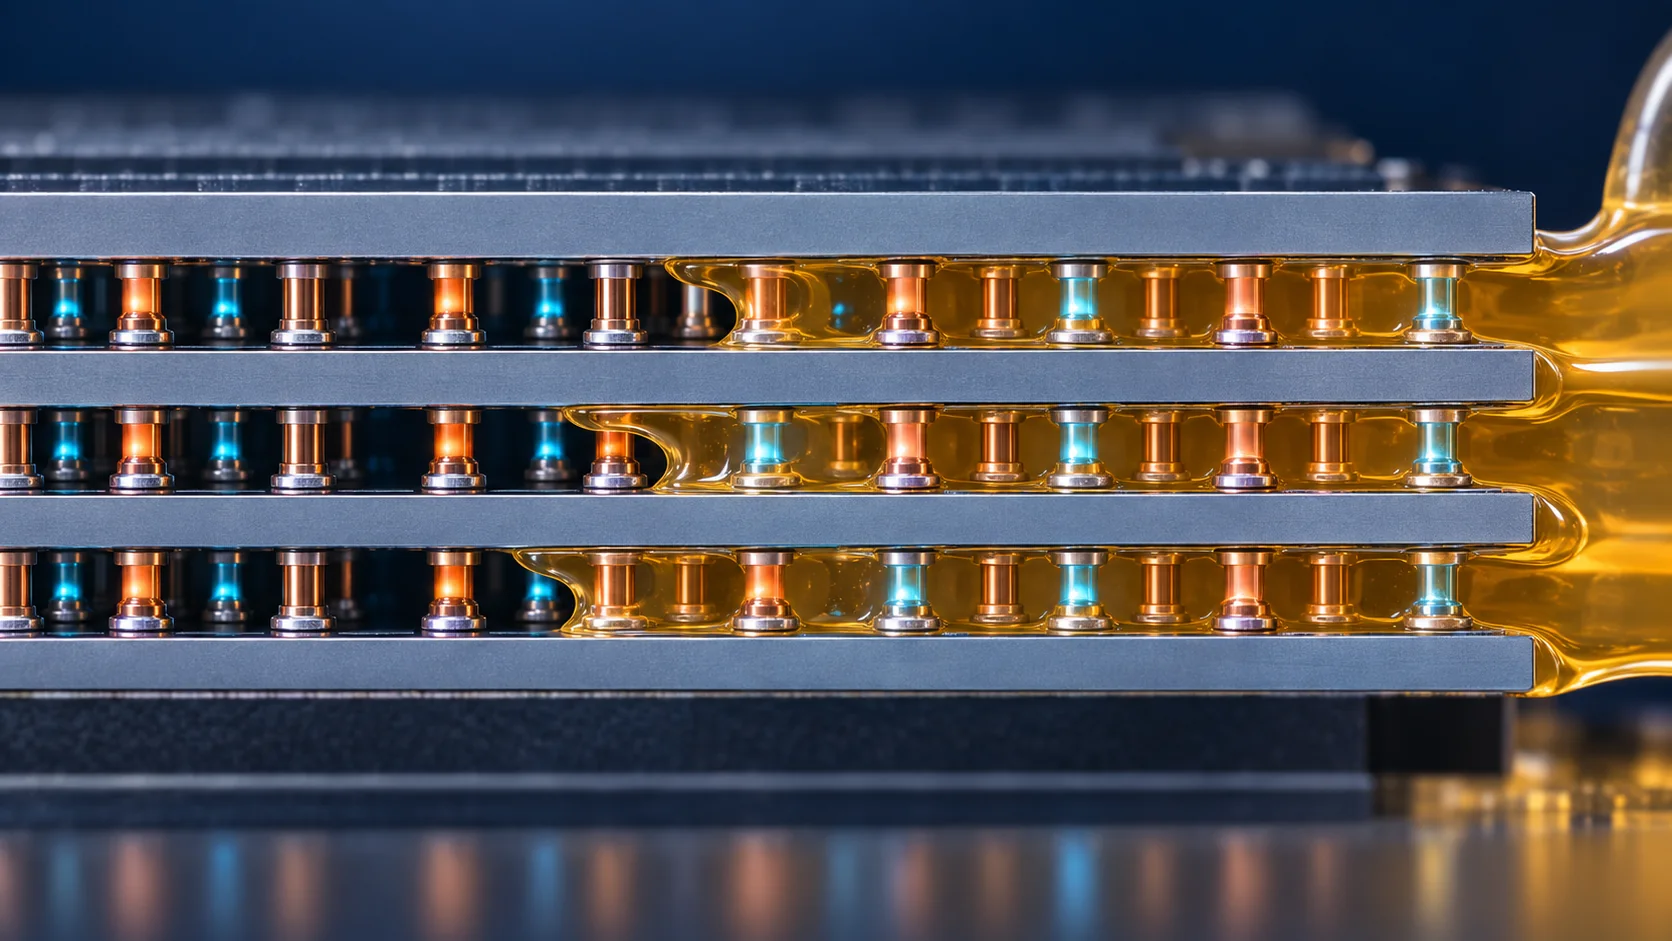
封止材は「保護材」ではなく「熱の配管」です。 スタック内部のDRAMダイは、上下を他のダイに挟まれ、熱の逃げ場がほとんどありません。 熱を外へ運ぶ経路は、(a) TSVと銅バンプという金属の柱、(b) ダイ間を埋める樹脂、の2つしかない。 だからこそSK hynixは電気的には機能しない「サーマルダミーバンプ」を大量に配置し、 EMC自体の熱伝導性を1.6倍に改良したと説明しています。
同時に、この樹脂はシリコン・銅・有機基板という熱膨張係数の異なる材料の間に挟まれます。 硬化収縮と熱サイクルによる応力が反り(warpage)とバンプ不良の主因となるため、 熱伝導率・弾性率・ガラス転移温度・フィラー粒径・流動性のすべてを同時に成立させる必要があります。 段数が増え、ダイが薄くなるほど、この設計余裕は減っていきます。
(3) 反り(warpage)の制御
SK hynixは、積層の各段で瞬間的に高温を与えて上側チップのバンプを下側チップのパッドに融着させ、 このパッドがチップを保持して反りを防ぐ「チップコントロール技術」を用いると説明しています事実 (SK hynix)。 薄化・積層・封止・反り制御は独立した課題ではなく、互いにトレードオフの関係にある一つの連立方程式です。
(4) 土台の材料が変わる可能性 ― シリコンから有機基板へ
従来のHBMは、シリコンインターポーザの上に実装するのが前提でした。 しかし2026年6月、JEDECはSPHBM4(JESD330-4)を発行しています事実。 これはHBM4と同じDRAMダイを使いながら、新しいインタフェース用ベースダイを介して、 通常の有機基板に実装できるようにする規格です。
仕組みは明快です。HBM4が2,048本のデータ信号を使うのに対し、SPHBM4は512本+4:1シリアライズで 同等の総スループットを実現します事実。 信号本数を1/4にすることでバンプピッチを緩和でき、有機基板への接続が可能になる——という設計です (JEDEC)。
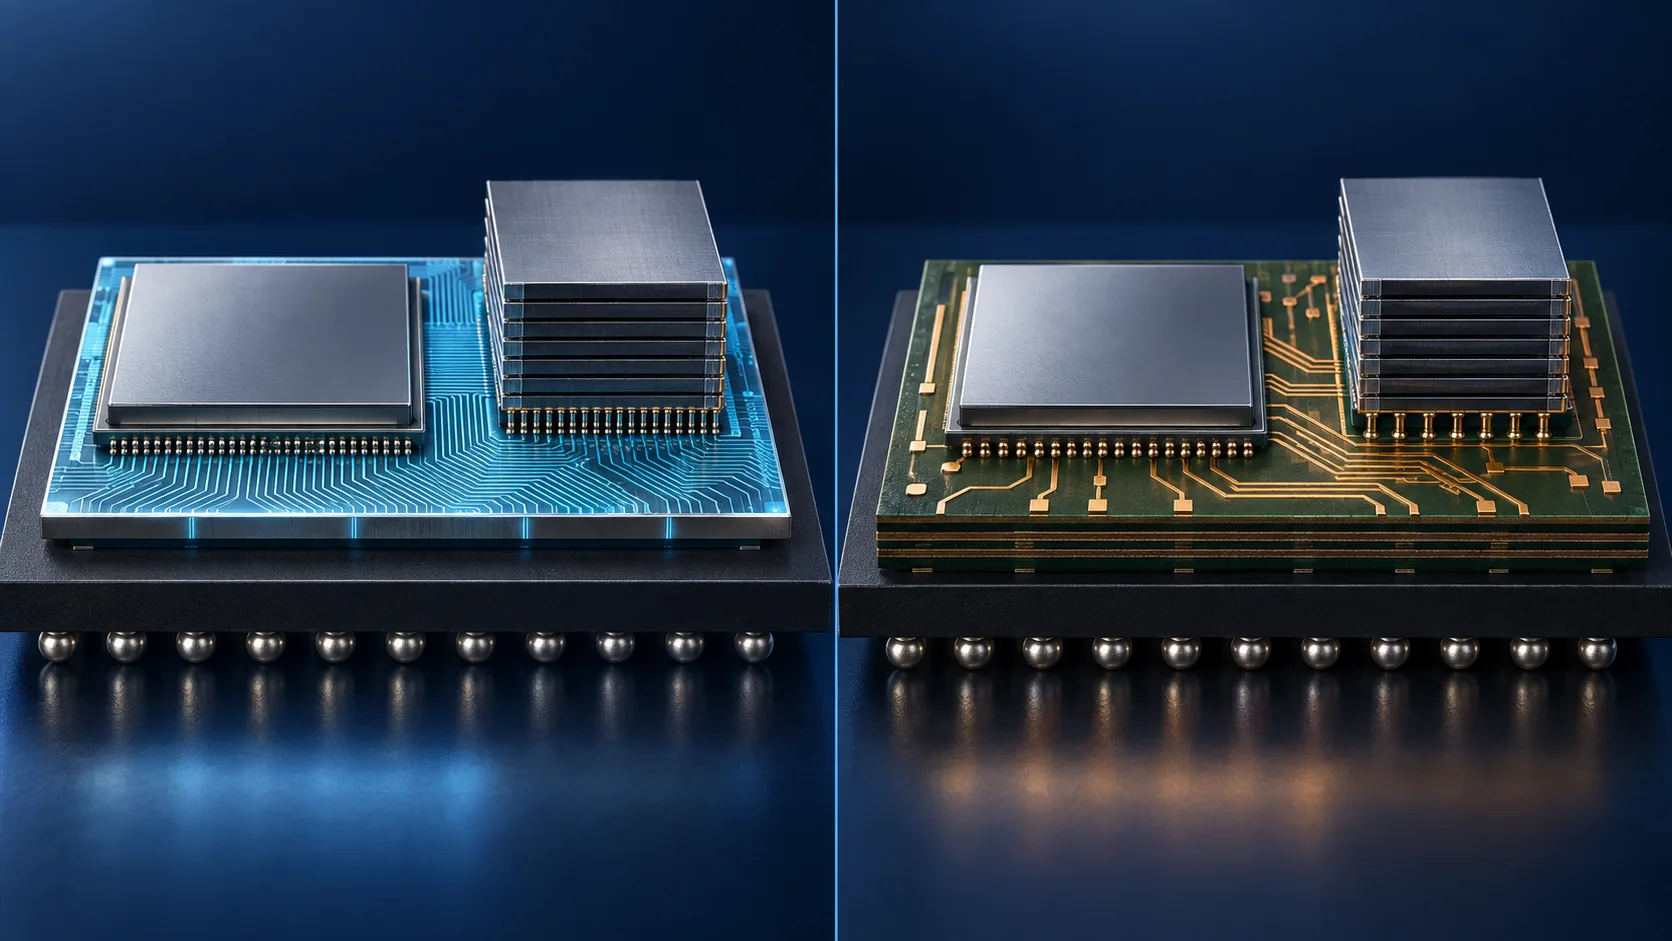
シリコンインターポーザが必須でなくなれば、有機基板材料・ビルドアップ材・微細配線形成プロセスが HBM実装の主戦場に加わることになります。SPHBM4は、材料メーカーにとって規格文書以上の意味を持つ可能性があります。
7. 世代比較(HBMからHBM4まで)
(A) JEDEC規格の推移
| 規格文書 | 発行 | I/O幅 | ピン速度(上限) | 帯域幅/スタック | 段数 | 容量/スタック |
|---|---|---|---|---|---|---|
| JESD235A(HBM2) | 2016年1月 | 1,024 bit | 2 Gb/s | 256 GB/s | 2/4/8段 | 1〜8 GB |
| JESD235B | 2018年12月 | 1,024 bit | 2.4 Gb/s | 307 GB/s | 2/4/8/12段 | 1〜24 GB |
| JESD238(HBM3) | 2022年1月 | 1,024 bit | 6.4 Gb/s | 819 GB/s | 4/8/12段(16段に拡張余地) | 4〜64 GB |
| JESD270-4(HBM4) | 2025年4月 | 2,048 bit | 8 Gb/s | 2 TB/s | 4/8/12/16段 | 最大64 GB |
| JESD330-4(SPHBM4) | 2026年6月 | 512 bit(4:1シリアライズ) | ― | HBM4と同等の総スループット | HBM4と同一コア | HBM4と同一 |
すべて事実(JEDEC公表資料)。JESD270-4は2025年12月にJESD270-4A(Version 1.1)へ改訂されています。
JEDECが発行しているHBMの規格文書は JESD235系(HBM/HBM2)、JESD238系(HBM3)、 JESD270-4系(HBM4)、JESD330-4(SPHBM4)です (JEDEC 主記憶ページの文書一覧)。 「HBM2E」「HBM3E」という独立した規格番号は存在せず、各世代を高速化した製品群に対するメーカー側の呼称です。 そのため、製品仕様が規格文書に記載された上限値を上回ることがあります(下表を参照)。
(B) 製品・実装の例
| 時期 | 製品・搭載例 | 公表されている主な仕様 |
|---|---|---|
| 2015年 | AMD Radeon R9 Fury X(HBM搭載の最初のGPU) | 4,096 bitのメモリインタフェース、512 GB/s。スタック単体では1,024 bit=128 GB/s相当本稿の計算 |
| 2020年7月 | SK hynix HBM2E 量産 | 1,024 I/O、3.6 Gb/s/ピン、460 GB/s超、16Gbチップ8段積層で16 GB |
| 2024年2月 | Samsung HBM3E 12H(36GB) | 12段36 GB、最大1,280 GB/s、TC-NCF適用、チップ間ギャップ7µm |
| 2024年〜 | Micron HBM3E | 8段24 GB/12段36 GB、ピン速度9.2 Gb/s超、1.2 TB/s超、16チャネル/32擬似チャネル、1,024 I/O |
| 2024年〜 | NVIDIA H200(HBM3E搭載) | HBM3E 141 GB/4.8 TB/s |
| 2025年9月 | SK hynix HBM4 開発完了 | 2,048 I/O、10 Gb/s超(JEDEC規格の8 Gb/sを上回ると明記)、電力効率40%超改善、1bnmプロセス、Advanced MR-MUF |
| 2026年 | Micron HBM4 量産 | 2,048ピン、11 Gb/s超、2.8 TB/s超/スタック、12段36 GB。16段48 GBはサンプル出荷 |
| 2026年 | NVIDIA Rubin(HBM4搭載) | HBM4 最大288 GB/最大22 TB/s、12段スタック。「HBM3Eに対しインタフェース幅が倍」と説明 |
すべて事実(各社公表資料。出典は末尾の一覧を参照)。AMDの行の「128 GB/s相当」のみ本稿による計算値です。
HBM4のJEDEC規格上限は8 Gb/sですが、SK hynixは10 Gb/s超、Micronは11 Gb/s超を公表しています。 SK hynix自身が「JEDEC標準の8 Gbpsを超える」と明記している通り、 規格は下限の互換性を保証するものであり、製品性能の上限を縛るものではありません。 技術記事で数値を引用する際は、「規格値」なのか「製品値」なのかを必ず区別する必要があります。
8. AIアクセラレータで重要な理由
推論の速度はメモリ帯域で決まる
LLMが1トークンを生成するには、モデルの重みを読み出す必要があります。 バッチサイズが小さい推論では、演算1回あたりに読み出すデータ量が大きく、 演算器の性能ではなくメモリ帯域が処理速度の上限になります。 帯域が2倍になれば、この領域では処理速度もおおむね2倍に近づきます。
容量も同じくらい重要
モデルがメモリに載りきらなければ、複数のGPUに分割して通信しながら処理することになり、 その通信が新たなボトルネックになります。 HBMは帯域と容量を同時に稼げる数少ない手段です。
世代ごとの実機データ
| 世代 | 搭載例 | メモリ容量 | メモリ帯域 |
|---|---|---|---|
| HBM3E | NVIDIA H200 | 141 GB | 4.8 TB/s |
| HBM4 | NVIDIA Rubin | 最大288 GB | 最大22 TB/s |
いずれもNVIDIAの公表値事実。NVIDIAはRubinについて「Blackwell/Blackwell Ultra比で2.8倍の帯域」と説明しています。
Rubinの22 TB/sを12段スタック構成で割ると、1スタックあたり約2.75 TB/sとなり本稿の計算、 Micronが公表するHBM4の「2.8 TB/s超」とおおむね整合します。 AIアクセラレータの帯域は、HBM1スタックの性能×スタック数でほぼ決まることが確認できます。
9. 課題:発熱・歩留まり・コスト
(1) 発熱
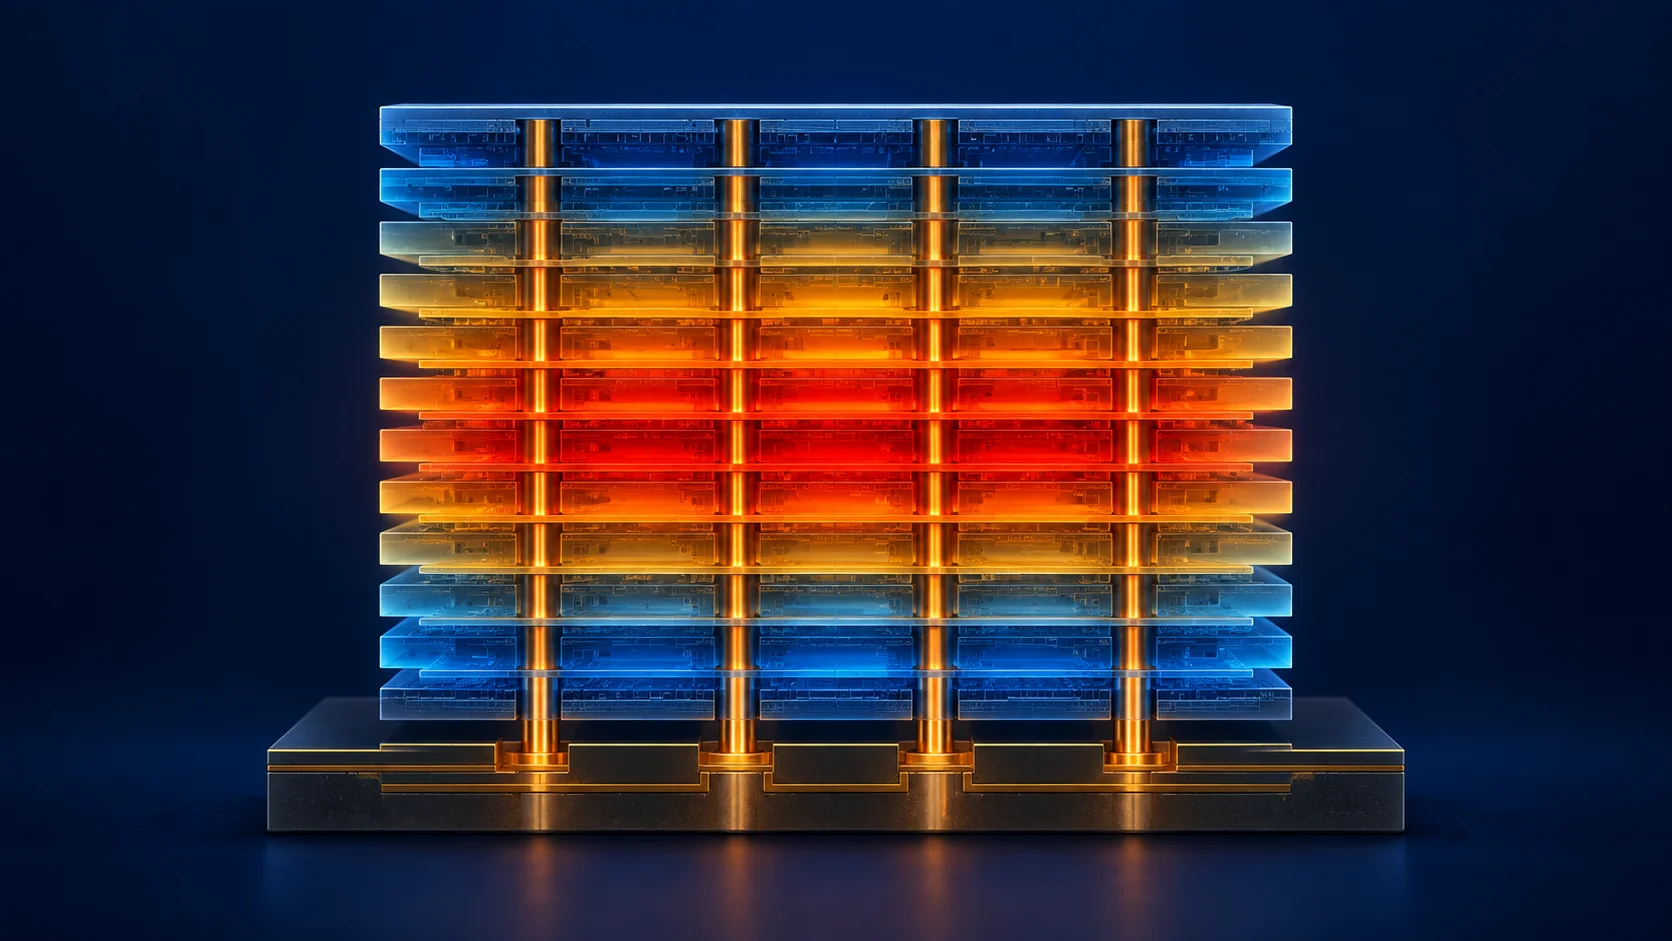
スタックの内部に位置するダイは、上下を他のダイに挟まれており、熱の逃げ道が限られます。 段数が増え、ダイが薄くなり、動作速度が上がるほど、この問題は厳しくなります。 各社が封止材の熱伝導性やサーマルダミーバンプの数を競っているのは、この制約が性能の実質的な上限を決めているからです。
(2) 歩留まり
HBMは構造上、1枚のダイの不良がスタック全体の不良になります。 12段構成なら、12枚すべてが良品で、かつ11層分の接合がすべて成功して初めて製品になります。 段数を増やすほど、最終的な良品率は不利になっていく——これは構造からくる必然です (本段落は構造からの説明であり、特定メーカーの歩留まり数値を示すものではありません)。
(3) 実装コスト
HBMはシリコンインターポーザなどの先端パッケージ技術を前提とします。 TSMCのCoWoSでは、インターポーザ面積が1レチクル(約830 mm²)級から3.3倍レチクル級へ拡大してきました事実 (TSMC)。 大面積のシリコンを使うほど歩留まりとコストの負担は増え、 メモリ単体の価格だけでなく、パッケージ工程全体がコスト要因になります。 先に触れたSPHBM4は、この構造的なコスト問題に対する標準化側からの一つの回答とも読めます。
10. これから
HBM5:JEDECのJC-42.2(HBM小委員会)で開発中であることが公表されています事実 (JEDEC)。仕様の詳細は未公表です。
SPHBM4:2026年6月に発行済み。有機基板への実装という新しい選択肢が標準として用意されました事実。
段数をさらに増やすうえで注目されているのが、はんだバンプを介さずに銅同士を直接接合する ハイブリッドボンディングです未確定/将来。 バンプが不要になれば層間の厚みを大幅に減らせ、熱伝導にも有利になると考えられています。
ただし、本稿の調査時点(2026年9月)において、HBMの量産にハイブリッドボンディングを採用したという メーカーの公式発表は確認できませんでした。 導入時期については業界メディアの報道でも見方が分かれており、確定した情報として扱うべきではありません。 技術解説でこの話題に触れる際は、「検討・開発段階の技術」として明示することをお勧めします。
11. 用語集
- HBM
- High Bandwidth Memory。DRAMを積層し、プロセッサと同一パッケージ内で広帯域に接続するメモリ規格。
- 帯域幅(バンド幅)
- 単位時間あたりに転送できるデータ量。GB/s、TB/sで表す。「配線本数×1本あたり速度÷8」で決まる。
- TSV
- Through-Silicon Via。シリコンダイを貫通する電極。積層したチップを最短距離で電気的に接続する。
- マイクロバンプ
- ダイ同士、またはダイとインターポーザを接続する微小な接合部。銅ピラーとはんだで構成される。
- ベースダイ
- HBMスタック最下層の制御用チップ。チャネル制御やテスト機能を担う。
- インターポーザ
- HBMとロジックダイを載せる中間基板。シリコン製では微細配線で数千本の接続が可能。
- チャネル/擬似チャネル
- 互いに独立して動作するメモリの区画。HBM4では32チャネル×2擬似チャネル。並列度を高める仕組み。
- EMC
- Epoxy Molding Compound。エポキシ樹脂をベースとする熱硬化性の封止材。MR-MUFで使用される。
- NCF
- Non-Conductive Film。非導電性の接着フィルム。TC-NCF方式で層間に用いられる。
- MR-MUF
- Mass Reflow Molded Underfill。バンプを一括リフローで接合し、液状封止材で埋める方式。
- TC-NCF
- Thermal Compression Non-Conductive Film。フィルムを介して1段ずつ熱圧着する方式。
- サーマルダミーバンプ
- 電気信号を通さず、熱の拡散のみを目的として配置されるバンプ。
- 反り(warpage)
- 材料間の熱膨張差や樹脂の硬化収縮によって生じる基板・ダイの変形。接合不良の主因。
- レチクル
- 露光装置が一度に転写できる最大領域。約830 mm²。インターポーザの面積上限を規定する。
- SPHBM4
- Standard Package HBM4。信号本数を512本に減らし、有機基板への実装を可能にするJEDEC規格(JESD330-4)。
12. 参考資料(一次情報)
- JEDEC「JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard」2025年4月16日 — jedec.org
- JEDEC「High Bandwidth Memory (HBM4) DRAM / JESD270-4A」2025年12月 — jedec.org
- JEDEC「JEDEC Publishes HBM3 Update to High Bandwidth Memory (HBM) Standard」2022年1月27日 — jedec.org
- JEDEC「JEDEC Updates Groundbreaking HBM Standard(JESD235A)」2016年1月12日 — jedec.org
- JEDEC「JEDEC Updates Groundbreaking HBM Standard(JESD235B)」2018年12月17日 — jedec.org
- JEDEC「JEDEC Prepares SPHBM4 Standard to Deliver HBM4-Level Throughput with Reduced Pin Count」2025年12月11日 — jedec.org
- JEDEC「Main Memory: DDR SDRAM, HBM」(JESD330-4の2026年6月発行、HBM5開発中の記載) — jedec.org
- JEDEC「JEDEC Publishes GDDR7 Graphics Memory Standard(JESD239)」2024年3月5日 — jedec.org
- AMD「AMD Ushers in a New Era of PC Gaming…(Radeon R9 300シリーズ)」2015年6月16日 — ir.amd.com
- SK hynix「SK hynix Starts Mass-Production of High-Speed DRAM, HBM2E」 — news.skhynix.com
- SK hynix「SK hynix Completes World's First HBM4 Development and Readies Mass Production」2025年9月12日 — news.skhynix.com
- SK hynix「Rulebreakers' Revolutions: MR-MUF Unlocks HBM Heat Control」 — news.skhynix.com
- Samsung「Samsung Develops Industry-First 36GB HBM3E 12H DRAM」2024年2月27日 — news.samsung.com
- Micron「HBM3E」製品ページ — micron.com
- Micron「HBM4」製品ページ — micron.com
- NVIDIA「H200 Tensor Core GPU」 — nvidia.com
- NVIDIA「Inside NVIDIA Rubin GPU Architecture」 — developer.nvidia.com
- TSMC「CoWoS」技術ページ — 3dfabric.tsmc.com
13. 主張と出典の対応表(監査)
本記事の主要な数値について、記載箇所・根拠・区分を一覧にしました。
最終更新:2026年9月20日/出典はすべて一次情報(JEDEC規格の公表資料、メーカー公式発表、製品ページ)に限定しています。 図はすべて説明用のAI生成概念図であり、実際の製品写真・断面構造・寸法比・配線数を正確に表すものではありません。図中の名称・数値・凡例は、生成画像へ焼き込まずHTMLテキストとして分離しています。