初めて学ぶ人のための、シリーズの入口
(一番最初に読んで)マテリアルインフォマティクス概論(LLMとの違いを含む)
MIは何をする分野か。LLMとの役割分担、実験による確認、組み合わせた将来像を、全体像から理解する。
- MIは、材料開発の「次に何を試すか」を、データと計算で考えるための分野です。
- LLMは、主に言葉を扱う学習モデルの一種です。MIと同じ種類の言葉ではなく、MIの中で使う道具にもなります。
- 候補を提案できても、本当に作れたか、狙った条件で働くかは、計算や実験の証拠で確かめます。
1. MIは、どんな困りごとを解くのか
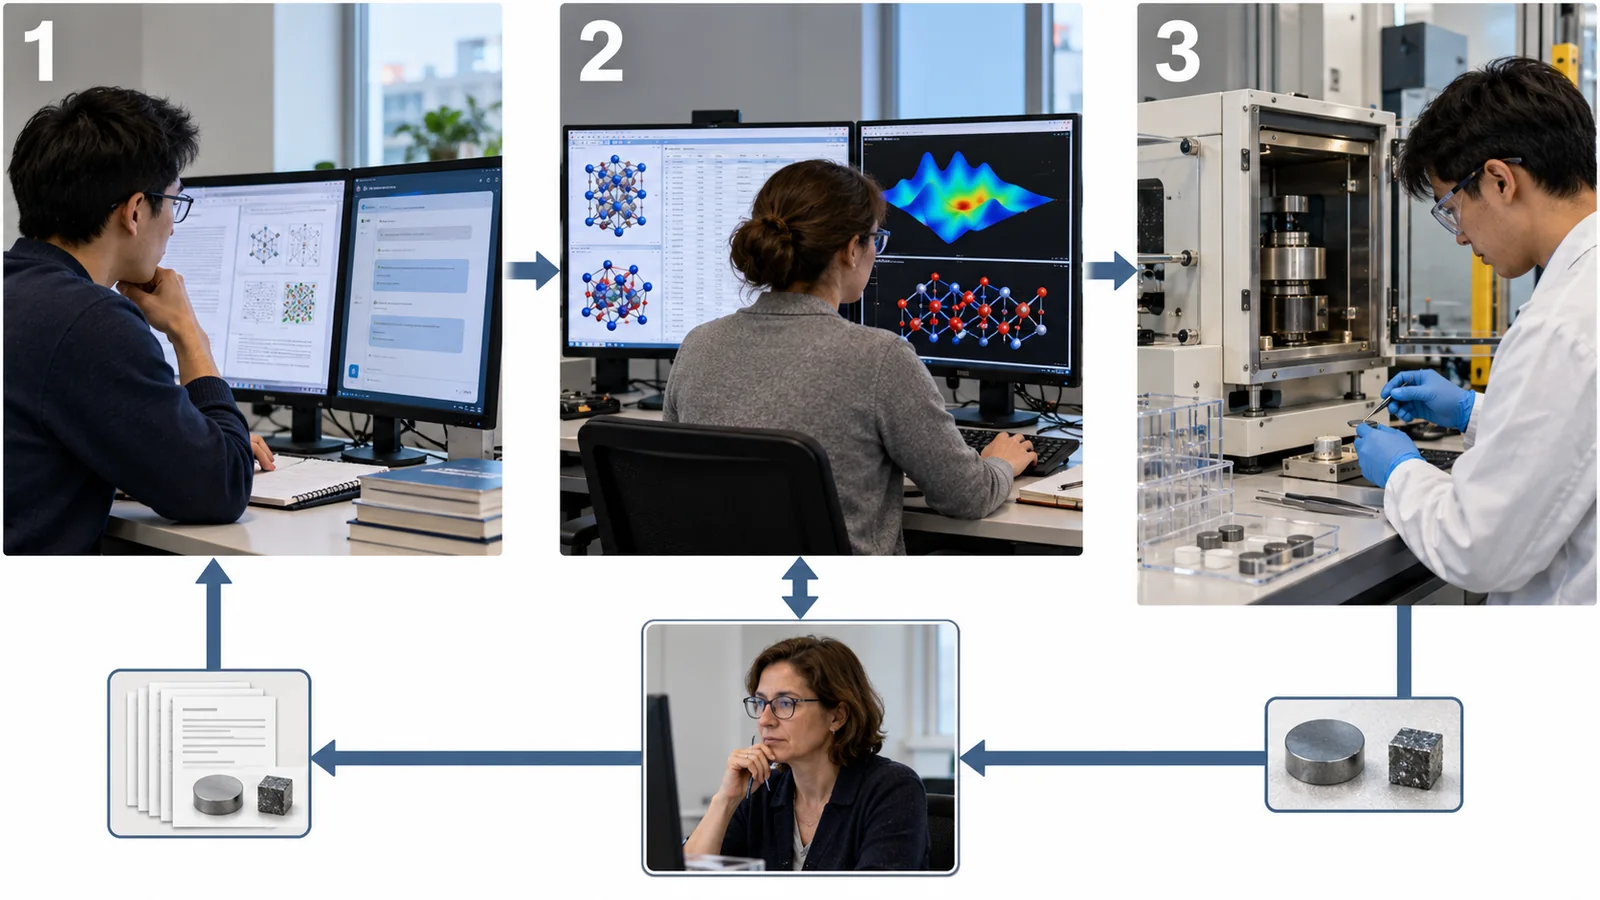
たとえば、電子部品を守る材料に「熱は逃がしたいが、電気は通したくない」という要求があるとします。樹脂や粉末の種類、混ぜる割合、混ぜ方、固める条件を変えると、熱の伝わり方だけでなく、流れやすさ、強さ、加工のしやすさも変わります。全部の組合せを順番に試すのは大変です。
そこで、過去の試験を整理し、似た条件で得た結果や物理計算を手掛かりに、次の候補を絞ります。そして実際に作って測り、外れた理由も記録して、次を選び直します。これが本記事でまず押さえてほしいMIの姿です。人の経験を捨てることでも、必ず新材料が見つかる魔法でもありません。
この材料開発の例は、全体の流れを理解するための本記事の設定です。特定の製品、配合、性能値を示すものではありません。
2. 全体像は「整える・予測する・試す・戻す」
マテリアルインフォマティクス(MI:materials informatics)は、材料科学と、データを扱う方法を結び付ける分野です。機械学習だけでなく、データベース、統計的な実験計画、物理シミュレーション、測定と記録の整備も関わります。材料の組成や結晶構造を入力に物性を予測する研究課題は、Matbenchの原論文にも具体的に示されています。[1]
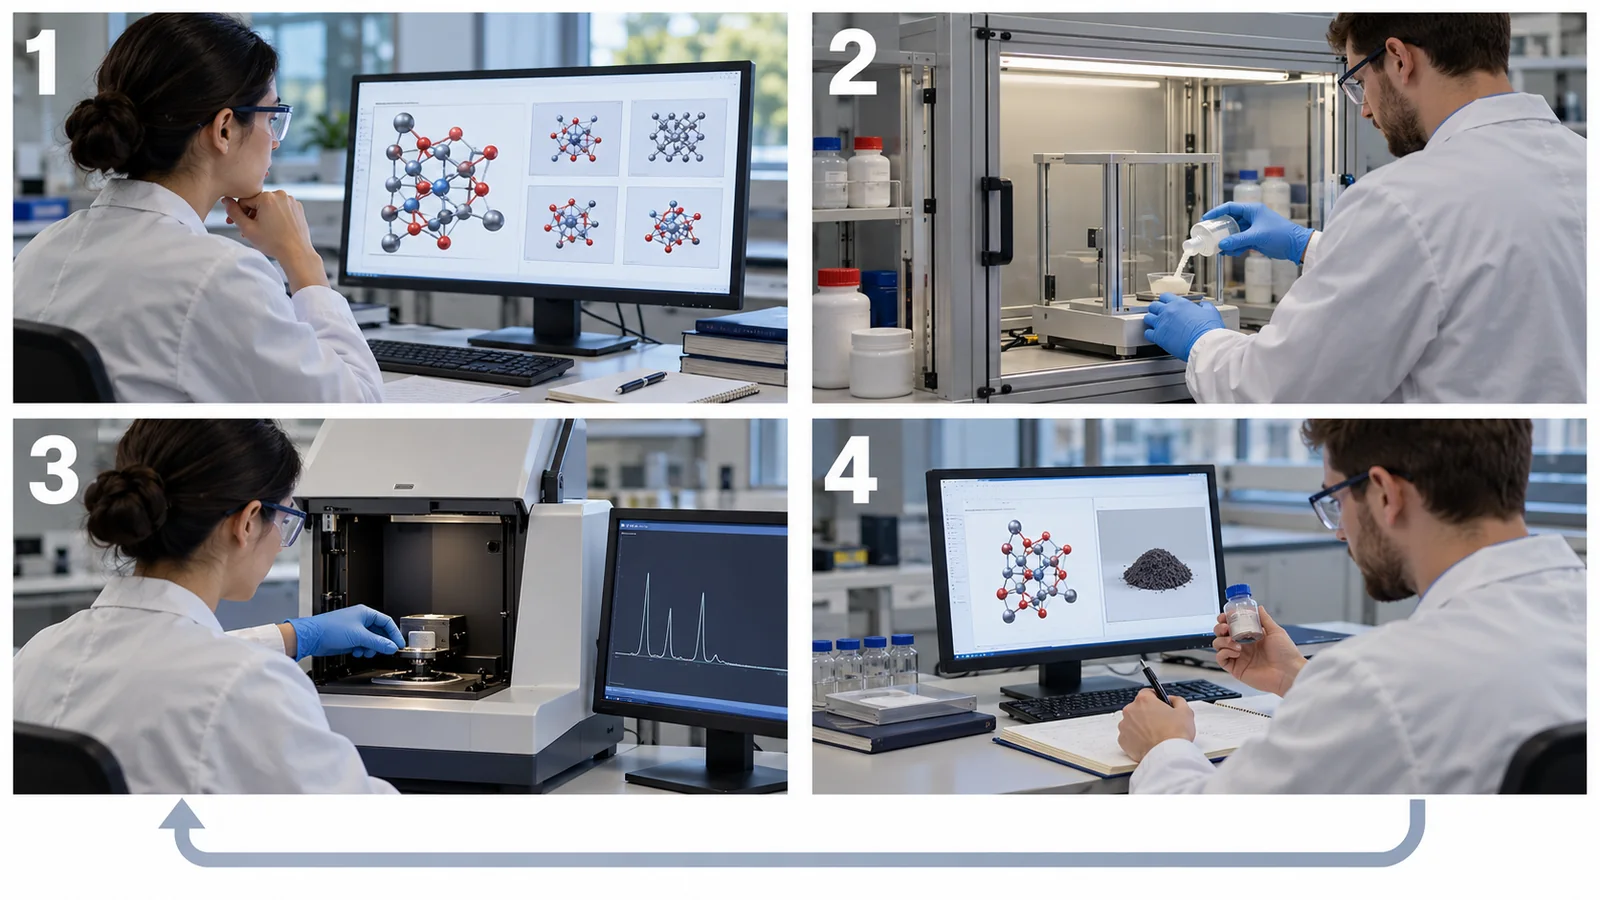
- 目的を決める:何を良くし、何を悪くしてはいけないか。費用や安全などの制約も決める。
- 比較できる記録を集める:材料名だけでなく、試料、つくり方、測り方、単位をそろえる。
- 候補を見積もる:経験則、統計、機械学習、物理計算などから、目的に合う道具を選ぶ。
- 次を選ぶ:良さそうかだけでなく、分からなさ、費用、実行できる条件も考える。
- 作って測る:対照や繰り返しを含め、予測と実際の違いを確かめる。
- 結果を戻す:成功だけでなく、失敗や実施できなかった理由も次へつなぐ。
この六つは学習用の整理で、決まった規格上の工程ではありません。目的によって順番も道具も変わります。まずは「AIの箱」ではなく、この循環を思い浮かべてください。
3. MIとLLMは、何が違うのか
MIは分野・取り組みの名前、LLM(大規模言語モデル:large language model)はモデルの種類です。したがって「MIかLLMか」という二者択一ではありません。「材料開発という仕事」と「その仕事の中で使える道具」を比べている、と考えると整理できます。
| 見る点 | MIという取り組み | 主に言葉を扱うLLM |
|---|---|---|
| 主な問い | この目的には、どの材料・条件を次に試すか。 | 与えた文脈に対して、どんな文章・構造化出力・操作案を返すか。 |
| 扱うもの | 組成、構造、工程、画像、スペクトル、測定値、文献など。 | 主に文章やコード。画像等も扱うモデルや、外部の道具と接続する使い方もある。 |
| 出てくるもの | 予測、候補、実験の優先順、比較可能な記録など。 | 説明、要約、抽出した表、コード、道具への指示案など。学習・設計次第では数値予測も扱う。 |
| 確かめ方 | 対象材料に合う評価、独立したデータ、実際の測定、用途の要求で判断する。 | 原文との一致、回答の正しさ、実行結果などを課題別に評価する。材料についての主張にはMI側の検証も必要。 |
LLMは、大量の文章などから並び方や関係を学んだモデルです。自然な文章が出ることと、その中の物性値や因果関係が正しいことは別です。一方で「LLMは数値予測に絶対使えない」も不正確です。Jablonkaらは、課題用データで追加学習した言語モデルを、化学・材料の予測に使う研究を報告しています。専用の学習と評価をした研究であり、普通の対話で出た回答の信頼性を保証するものではありません。[2]
材料のAIが全部LLMというわけではありません。原子の関係を扱うグラフニューラルネットワーク、原子に働く力を近似する模型、構造候補を作る生成モデルなど、目的の違う道具があります。逆に、MIにはAIを使わない統計や物理計算も含まれます。
4. 同じ開発テーマで、役割を分けてみる
先ほどの「熱は逃がし、電気は通しにくい材料」を例にします。次の分担は、実在システムの再現ではなく、本記事が組み立てた説明用の例です。
- 人:必要な試験条件と、熱以外にも守るべき要求を決める。
- LLMの支援:使ってよい文献から候補の材料名や条件を抜き出し、原文の箇所と結び付ける。書かれていない条件は空欄にする。
- データの整備:試料ID、配合、加工、測定温度、測定法、値と単位を対応させる。
- 専用の予測・計算:目的に合う模型で候補を比較する。知らない領域や予測の不確かさも見る。
- 人と実験:安全に実施できる条件を確認して試料を作り、対照を含めて測る。
- 次の判断:予測と違った理由を調べ、記録を戻す。候補が良くても、製品として使うための評価はさらに必要。
LLMに「最良の配合を教えて」と聞くだけでは、この手順の代わりになりません。反対に、試験データがきれいでも、何を測ったか、どんな用途に必要かが不明なら、役立つ予測を選べません。
5. LLMが助けやすい仕事と、任せたままにしない仕事
LLMは、文献を読む入口、表記の違いを整理する下書き、計算手順のコード案、結果の説明、専門の道具を呼び出す計画などに使えます。ただし、それぞれに確認が要ります。
- 文献からの抽出:材料・条件・値・単位と原文を照合する。見つからない情報を作らせない。
- コードや計算の支援:入力、単位、方法、収束、出力を確認する。動いたコードが正しい計算とは限らない。
- 実験への接続:装置が許す操作、安全、停止条件、人の承認を決める。自由文の指示をそのまま装置へ流さない。
- 結果の説明:「計算で予測」「試料を作製」「実測で確認」「用途で実証」を区別する。説明の上手さで証拠を代用しない。
BoikoらのCoscientist研究は、LLMを検索、コード、実験の道具とつないだ化学研究の例です。特定の課題・装置・条件での報告であり、未知の材料を何でも安全に自律開発できるという証拠ではありません。[3]
6. 評価・標準の読み方――「高精度」だけで安心しない
最初は次の五つを確認すると、発表を読みやすくなります。これは本記事の学習用チェックリストで、万能な合格規格ではありません。
- 何を答えたか:計算値の再現か、測定値の予測か、実際の新しい試料の性能か。
- 何と比べたか:単純な基準、既知の材料、人の手順と、同じ条件や予算で比べたか。
- どう分けたか:同じ試料の繰り返し、似た組成、同じロットが、学習側と評価側に混ざっていないか。
- どこまで通じるか:別の材料群、工程、測定環境でも確かめたか。失敗や分からない範囲を示しているか。
- 証拠を追えるか:元データ、試料、単位、測定法、模型の版、解析の条件が残っているか。
たとえば、論文の表を正しく抜き出せる割合と、材料の強さを予測した誤差は、別の能力を測っています。LLMの回答、物性予測、実験の自動化を、同じ「成功率」でまとめないようにしましょう。
データの整備には、見つけやすさ・アクセス・相互運用・再利用を考えるFAIR原則があります。ただし、FAIRは全データを無制限公開するという意味ではありません。機密、利用許諾、アクセスの条件も整理します。[4] NIMSのDICEのような実際の基盤も、サービスやデータごとの条件を読んで使います。[5]
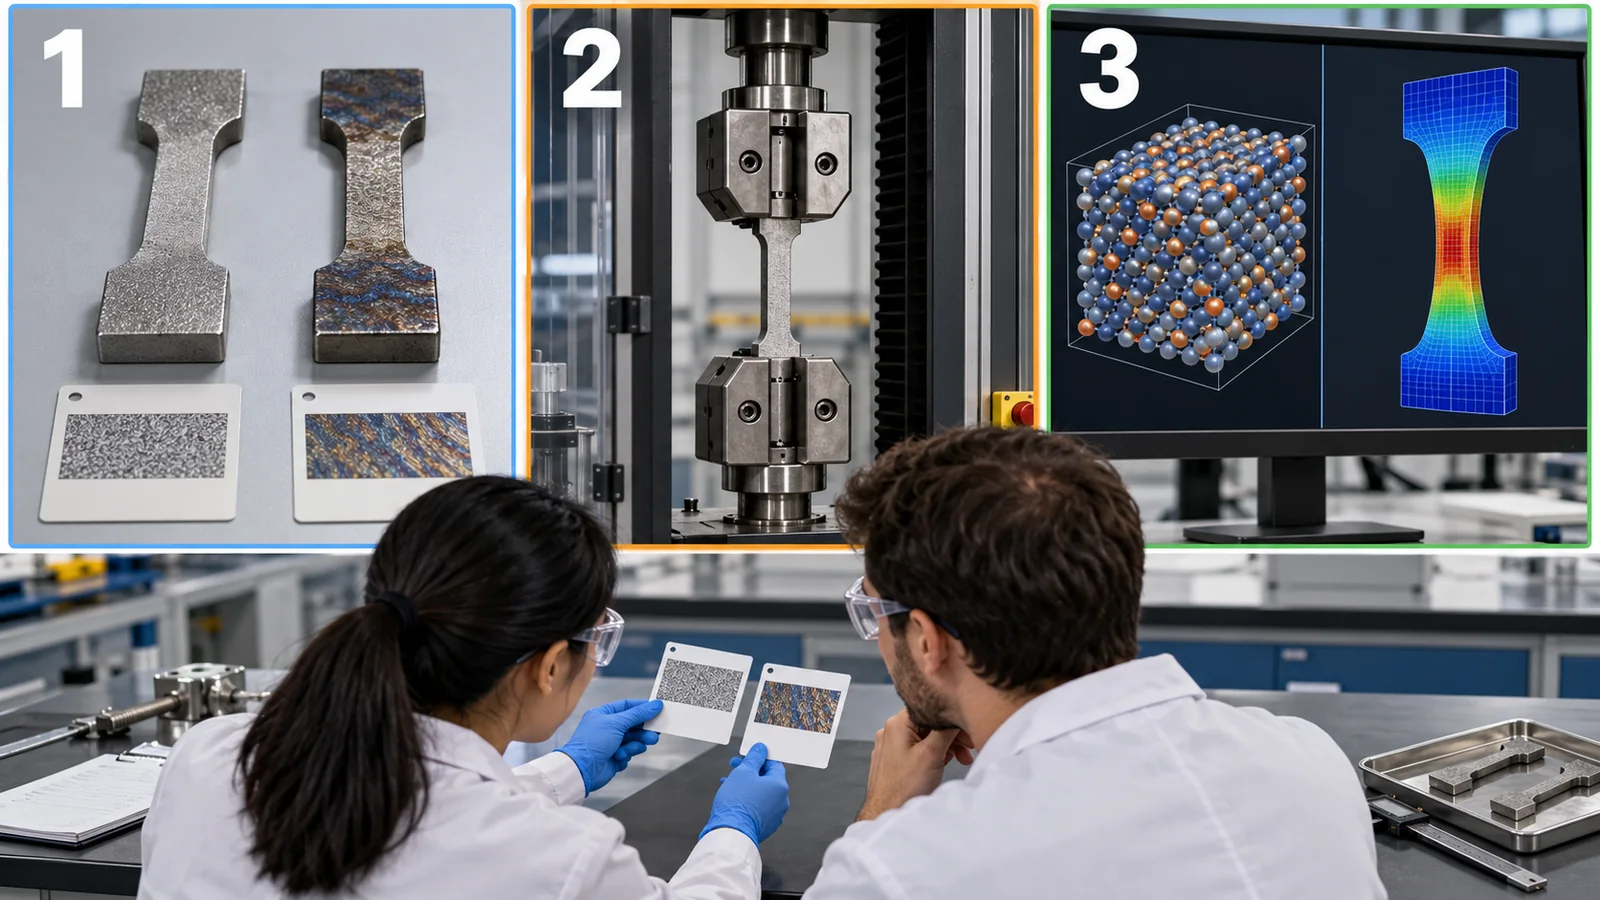
7. LLMとMIを組み合わせた未来像
ここからは本記事の考察です。既にある個別の研究を、すべて達成済みの製品として描くものでも、実現時期を予言するものでもありません。成熟度は材料・装置・組織で違います。
① まず「研究の記録係・通訳」を助ける
研究者は目的を自然な言葉で伝え、LLMが文献や社内の許可された記録を探す。材料名や単位をそろえ、元の箇所を付けて下書きを作る。人が確認した記録を、MIで使える表へつなぐ姿です。価値は文章が速く出ることより、記録を探し直す手間や、条件の取り違えを減らせるかにあります。
② 次に「専門の道具をつなぐ調整役」になる
LLMは対話と計画を受け持ち、物理計算、物性予測、条件の最適化、実験管理は、それぞれ適した道具が受け持つ。許された範囲では実行を進め、不確かなとき、制約を外れたとき、危険があるときは人へ戻す。模型や道具を替えても、何をしたか追える記録が残る姿です。
③ 将来は、組織や工程をまたぐ開発へ
研究室の候補だけでなく、試作、量産、使用中の不具合までつなぎ、「作りやすく、使う環境でも働く材料」を探す方向が考えられます。ただし、装置の互換性、測定の校正、試料の対応、知財・契約、データを共有できる範囲、人の責任が難所です。LLMを大きくするだけでは、この難所は解消しません。
つまり、将来像は「会話AIが研究者を丸ごと置き換える」より、人が目的と責任を持ち、LLMが情報と作業をつなぎ、専用の模型と実験が判断の証拠を作るという役割分担で考えると理解しやすくなります。
8. 初めてなら、どこから始めればよいか
最初から巨大なデータベースや自律実験室をそろえる必要はありません。「一つの用途」「一つの測定法」「次に選びたい条件」を決め、既存の試験記録を比較できる形にするところから考えてみてください。単純な基準と比べ、独立した試料で確かめ、失敗も残す。この小さな循環が分かれば、より高度な道具を使う意味が見えてきます。
9. 次に読む記事――必要なところだけ詳しく
全部を順番に読む必要はありません。まず「データと予測」、次に興味のある材料や道具へ進んでください。既存の技術解説38本を、入口ごとにまとめました。
データと予測の基礎
マテリアルインフォマティクス概論 / 材料データと記述子 / 材料データベースとFAIR原則 / 機械学習とニューラルネットワークの基礎 / 小データ機械学習 / 不確かさと適用範囲
計算で材料を見る
量子化学・材料シミュレーション / 密度汎関数理論の基礎 / 分子動力学 / 機械学習原子間ポテンシャル / グラフニューラルネットワーク / 高スループット計算 / マルチスケールシミュレーションとデジタルツイン / 結晶構造予測と安定性
次の実験を選び、確かめる
ベイズ最適化と能動学習 / 高スループット実験とロボット合成 / クローズドループ最適化 / 自律実験室 / 説明可能なAIと材料知見 / MIの結果の評価と再現性の読み方
LLM・生成AI・エージェント
Transformerと大規模言語モデル / 材料向け大規模言語モデルとテキストマイニング / AIエージェントの仕組み / AIエージェントによる材料研究 / 生成AIによる材料設計
材料や測定から入る
合金・構造材料への応用 / 高エントロピー合金 / 高分子インフォマティクス / ポリマーの基礎 / 電池材料への応用 / 次世代電池の化学と比較 / 触媒への応用 / 白金族金属と触媒 / 金属有機構造体 / 半導体・電子材料への応用 / スペクトル・画像データのAI解析
評価と制度を読む
企業・機関の役割を知る
NIMS / National Institute of Standards and Technology / Google DeepMind / Microsoft / Citrine Informatics / Preferred Networks / Chemspeed Technologies
まとめ:MIは開発の進め方、LLMはその中でも使える道具
MIの中心は、データと計算で次の候補を選び、作って測って学び直すことです。LLMは文献・言葉・コード・道具をつなぐ支援にも、課題ごとに学習・評価した予測器にもなり得ます。しかし、もっともらしい回答や計算上の候補を、実際に使える材料と取り違えないことが大切です。
出典と、本記事の整理・考察
下記は原研究・原則の発表者・基盤運営者の一次情報です。説明用の材料例、工程の分け方、比較表、将来像は本記事の整理と考察で、外部の予測や実証済みの製品仕様ではありません。確認日:2026年10月23日。
- Dunn et al. (2020), Benchmarking materials property prediction methods: the Matbench test set and Automatminer reference algorithm
- Jablonka et al. (2024), Leveraging large language models for predictive chemistry
- Boiko et al. (2023), Autonomous chemical research with large language models
- Wilkinson et al. (2016), The FAIR Guiding Principles for scientific data management and stewardship
- NIMS, DICE materials data platform