TECHNOLOGY EXPLAINER
AIエージェントの仕組み
― 言語モデルにツールとループを与えると何ができ、どこで壊れるか
「AIエージェント」は、言語モデルが検索・計算・コード実行・社内システムの操作などの「ツール」を使い、結果を見ながら何度も行動を選んで作業を進める仕組みです。便利そうに聞こえる一方で、「どこまで任せられるのか」「失敗したら何が起きるのか」は、仕組みを知らないと判断できません。 この記事では、LLM+ツール+ループという基本構造、関数呼び出し、計画とメモリ、ワークフローとエージェントの違い、実際に何が自動化できているか、失敗の型、そして評価と標準の読み方を、一次情報の範囲で整理します。
- AIエージェントとは何か(3行でつかむ)
- ワークフローとエージェントの違い
- 基本構造 ― LLM+ツール+ループ
- 計画とメモリ
- ワークフローの型と、複数のエージェント
- 実際に何が自動化できているか
- 失敗の型(本稿の計算つき)
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定・策定中であり、実績や確定が確認できていない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
この分野は変化が速く、ツールや提供形態は数か月で入れ替わります。本記事の日付・数値は2026年10月15日に公開資料で確認した範囲です。 ベンチマークの数値は、その論文や報告の時点のモデル・設定での値で、現在のモデルの性能ではありません。異なる設定・実施主体の数値を並べて優劣は論じません。開発元が自社の製品について述べた数値は「開発元の記述」として扱います。
1. AIエージェントとは何か(3行でつかむ)
- 基本は「LLM がツールを使い、環境からの結果を見ながらループで進める」仕組み:特別な魔法ではなく、言語モデルの出力(どのツールを、どんな引数で呼ぶか)を、アプリが実行して結果を返す、という往復のくり返しです事実[参考資料1・4・5]
- 「ワークフロー」と「エージェント」は違う:経路をコードが決めるのがワークフロー、LLM が自分の進め方とツールの使い方を決めるのがエージェントです。多くの用途では、単純なワークフローやひとつの LLM 呼び出しで足ります事実[参考資料1]
- 長い作業ほど、失敗の確率は急に上がる:各ステップが99%成功でも、50ステップ連続で成功する確率は約61%です。何が自動化できているかは、課題の長さ・条件・試行回数とあわせて読みます本稿の計算/事実
エージェントの「平均の成功率」ではなく、「同じ課題を繰り返しても毎回成功するか」と「失敗したときに何が起きうるか(権限と取り消しやすさ)」で判断します。 τ-bench の論文は、同じ課題を繰り返したときの信頼性を測る指標(pass^k)を導入し、当時の最先端の関数呼び出しエージェントが、課題の半分未満しか成功せず、小売の領域で8回繰り返して毎回成功する割合は25%未満だったと報告しています事実[参考資料13]。
2. ワークフローとエージェントの違い
「エージェント」という言葉の定義は、文書ごとに違います。Anthropic は、完全に自律的なものから、あらかじめ決めた手順に沿うものまで、すべてをエージェント型システム(agentic systems)と呼び、そのうえで構造上の区別を置きます。ワークフローは、LLM とツールが「あらかじめ決めたコードの経路」で組み合わされるシステム、エージェントは、LLM が「自分の進め方とツールの使い方を動的に決め、どう作業を達成するかの制御を保つ」システムです事実[参考資料1]。
OpenAI の実践ガイドは、エージェントを「ユーザーに代わって独立にタスクを達成するシステム」と定義し、LLM を組み込んでいても、ワークフローの実行を制御するのに使っていないもの(単純なチャットボット、1回きりの LLM 呼び出し、感情分類器)はエージェントではない、としています。特徴として、(1) LLM が実行の管理と判断を行い、ワークフローの完了を認識し、必要なら自分の行動を修正し、失敗したら停止して制御を人に返せること、(2) 外部システムとやり取りする複数のツールを持ち、状況に応じて動的に選び、明確なガードレールの範囲で動くこと、を挙げます事実[参考資料3]。
ISO/IEC 22989:2022(AIの概念と用語)は「AI agent」などの用語を定義しているとされます(ISO ページの要約。本文は有料のため確認していません)[参考資料33]。 表現は違っても、2社の記述に共通するのは、制御の流れを LLM が決めるという点です。
Anthropic は、LLM を使うアプリケーションでは「可能なかぎり単純な解決策を探し、必要なときだけ複雑さを増やす」ことを勧め、それは「エージェント型システムをまったく作らない」ことを意味する場合もある、と述べます。エージェント型システムは、タスクの性能のために遅延とコストを引き換えにすることが多い、とも述べています。多くの用途では、検索と文脈内の例で単一の LLM 呼び出しを最適化すれば十分だとしています事実[参考資料1]。
3. 基本構造 ― LLM+ツール+ループ
(1) 関数呼び出し(ツール利用)の往復
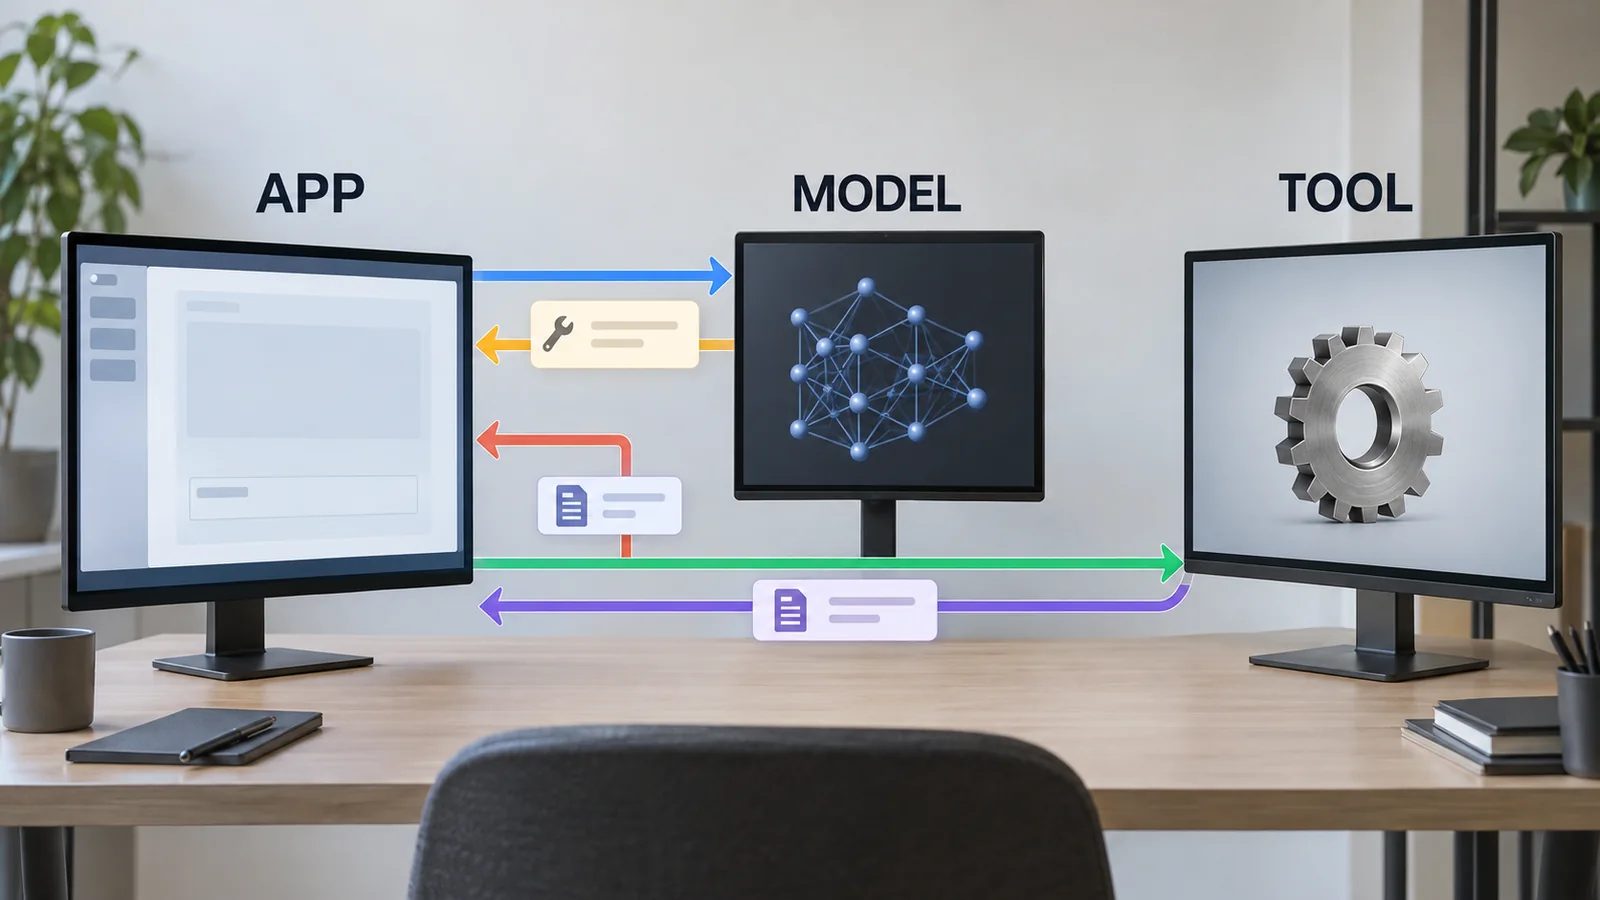
ツール利用(関数呼び出し)の基本は、どの開発元でも似ています。Gemini API のドキュメントは、次の流れを示します。(1) 関数の名前・引数・目的を宣言してモデルに渡す、(2) モデルは、関数を実行する代わりに、呼ぶべき関数の名前と引数を返す、(3) 関数の実行は呼び出し側のアプリの責任で、モデルは関数を実行しない、(4) 結果をモデルに返し、ユーザー向けの回答を作らせる。この過程は複数ターンにわたって繰り返せ、一度に複数の関数を呼ぶ(並列)ことも、順番に呼ぶ(合成的)こともできます事実[参考資料4]。 Claude のドキュメントも同様で、クライアント側のツールは呼び出し側のアプリで実行され、モデルは stop_reason が tool_use の応答を返し、アプリが結果を tool_result として送り返します。一方、検索などのサーバー側のツールは提供者の基盤で実行されます事実[参考資料5]。
元のSVG模式図・数値・出典注記を見る
この構造は、モデルが関数名と引数の「文字列」を出力するだけで、実際の行動はアプリが決めた範囲で起きることを意味します。安全性の中心は、ステップ③で何を許可するかです(第7章)。 OpenAI のガイドは、ツールを3種類に分けます。データ(情報を取得する:データベースの照会、PDFの読み取り、Web検索)、アクション(システムに作用する:レコードの更新、メッセージの送信)、オーケストレーション(エージェント自身が別のエージェントのツールになる)です事実[参考資料3]。 研究では、Toolformer が、言語モデルが電卓・質問応答・検索エンジン・翻訳・カレンダーなどの API を、いつ、どの引数で呼ぶかを、少数の例から自己教師ありで学べると示しました[参考資料7]。
(2) 推論と行動を交互に:ReAct
ReAct(Yao ら)は、LLM に推論の痕跡(考え)と行動を交互に生成させます。考えは行動計画の作成・追跡・更新と例外処理に役立ち、行動は知識ベースや環境から追加情報を得る手段になります。論文は、質問応答(HotpotQA)と事実検証(Fever)で、簡単な Wikipedia API を使うことで、連鎖思考に見られるハルシネーションと誤りの伝播を克服したと述べ、対話的な意思決定ベンチマーク(ALFWorld、WebShop)では、模倣学習と強化学習の手法を絶対成功率でそれぞれ34%、10%上回ったと報告しています(1〜2個の文脈内の例だけで。論文時点のモデル)事実[参考資料6]。
(3) ループと停止条件
Anthropic は、エージェントを「環境からのフィードバックにもとづいてツールを使う LLM がループで動くもの」にすぎない、と説明します。各ステップで、ツールの結果やコード実行のような環境からの「正解に近い情報(ground truth)」を得て進み具合を判断することが重要で、完了で終わるが、最大反復回数のような停止条件を入れて制御を保つのも一般的だとしています[参考資料1]。 OpenAI のガイドは、ループを「run」と呼び、終了条件の例として、最終出力用のツールの呼び出し、特定の構造化出力、エラー、最大ターン数への到達、ツール呼び出しなしの応答を挙げます[参考資料3]事実。
4. 計画とメモリ
(1) 計画
複数のステップにまたがる作業では、「次に何をするか」の決め方が性能を左右します。ReAct は、考えを挟むことで行動計画を更新します。Tree of Thoughts(Yao ら)は、連鎖思考を一般化し、文章の単位(「考え」)の複数の道筋を探索し、自己評価して次の行動を選び、必要なら先読みや後戻りをする枠組みです。論文は、Game of 24 で、GPT-4 の連鎖思考が課題の4%しか解けなかったのに対し、74%に達したと報告しています(論文時点のモデルと課題の条件)事実[参考資料11]。
一方、Valmeekam らは、国際計画コンペティションの領域に基づくベンチマークで、LLM が自律的に実行可能な計画を作る能力は「かなり乏しく」、平均の成功率は約3%だったと報告しました。ヒューリスティックとして使う場合や、人が加わる場合は、わずかに有望でした事実[参考資料12]。 これらは2023年前半のモデルでの結果で、その後に登場した推論モデル(本シリーズ「推論モデル」編)での結果ではありません。計画の能力は、モデルの世代で大きく変わりうる点に注意が必要です(本記事による解説)。
(2) メモリ
エージェントのメモリは、大きく「短期」と「長期」に分けて整理できます(本記事の整理)。
| 種類 | 何を保存するか | 代表例(出典) | 注意 |
|---|---|---|---|
| 短期(文脈) | これまでの会話、ツールの呼び出しと結果。モデルの文脈ウィンドウの中に置く | 関数呼び出しのやり取りで結果をモデルに返す[参考資料4] | ステップが増えるほど文脈は長くなり、毎回読み直す量が増える(第7章の計算) |
| 長期(外部の記憶) | 経験や知識を、モデルの外に自然言語などで保存し、必要なときに取り出す | Generative Agents:経験を自然言語で完全に記録し、時間とともに高次の「振り返り」に合成し、動的に検索して行動を計画する(25人のエージェントのサンドボックス)[参考資料9] | 何を残し、何を取り出すかの設計が品質を左右する |
| 階層的な記憶管理 | 速い記憶と遅い記憶を使い分け、限られた文脈ウィンドウの中に、大きな資源があるように見せる | MemGPT:オペレーティングシステムの階層メモリに着想を得た「仮想的な文脈管理」。文書分析と複数セッションの対話で評価[参考資料10] | 論文の評価は2領域。他の用途への一般化は確認していない |
| 失敗からの学習の記録 | 試行の結果についての言語的な「反省」を、エピソード記憶のバッファに残す | Reflexion:重みを更新せず、言語のフィードバックで強化する。HumanEval で91%の pass@1(当時の GPT-4 は80%と論文は記載)[参考資料8] | 論文時点のモデルでの値。現在のモデルとの比較ではない |
すべて事実(各論文・ドキュメントの記述)。「短期・長期」の整理は本記事によるものです。
5. ワークフローの型と、複数のエージェント
エージェントを作る前に、まずワークフローで足りないかを検討します。Anthropic は、基本の構成要素を「拡張した LLM」(検索・ツール・メモリで強化した LLM)とし、その上に5つのワークフローの型を示しています事実[参考資料1]。
| 型 | 何をするか(Anthropic の記述) | 向く場面(Anthropic の記述) |
|---|---|---|
| プロンプトの連鎖 | 課題を固定の部分課題の列に分け、各 LLM 呼び出しが前の出力を処理する。途中に、プログラムによる検査(ゲート)を置ける | きれいに固定の部分課題に分けられる場合。各呼び出しを易しくして、遅延と引き換えに精度を上げる |
| ルーティング | 入力を分類し、専門のあとの処理へ振り分ける | 明確に分けられるカテゴリーがあり、分類が正確にできる場合 |
| 並列化 | 部分課題を並行して処理する(分割)か、同じ課題を複数回実行して結果を集める(投票) | 速度のために並列にできる場合、または複数の視点や試行で信頼度を上げたい場合 |
| オーケストレーター+ワーカー | 中心の LLM が課題を動的に分解し、ワーカーの LLM に委任して、結果を統合する | 必要な部分課題を予測できない複雑な課題(例:変更が必要なファイル数が課題で決まるコーディング) |
| 評価者+最適化 | 一つの LLM が応答を生成し、別の LLM が評価とフィードバックを与えるループ | 評価基準が明確で、反復の改善に測定できる価値がある場合 |
すべて事実(Anthropic、2024年12月19日付)。これらは「処方箋」ではなく、組み合わせて調整する共通のパターンだと同社は述べています。
複数のエージェントは、いつ有効か
Anthropic の調査機能の事例(2025年6月13日付)は、リード役のエージェントが並列のサブエージェントに分担させる構成を説明します。同社の内部の調査用評価で、リードに Claude Opus 4、サブエージェントに Claude Sonnet 4 を使った複数エージェントの構成が、単独の Claude Opus 4 を90.2%上回ったと述べ、特に、独立した複数の方向を同時に探る「幅優先」の問い合わせで強いとしています。一方で、「エージェントは通常、チャットの約4倍、複数エージェントのシステムは約15倍のトークンを使う」とし、経済的に成り立つには、課題の価値が性能向上の費用を上回る必要があり、全エージェントが同じ文脈を共有する、あるいは相互の依存が多い領域(たとえば多くのコーディング課題)には、今のところ向かない、と述べています。同社の分析では、BrowseComp の性能のばらつきの80%をトークン使用量だけで説明できたとされます事実[参考資料2]。 これは開発元の内部評価と分析で、第三者による再現は確認していません。
Cemri らは、7つの有名な複数エージェントの枠組みの1,600件超の注釈つきの実行記録(MAST-Data)を集め、失敗の分類(MAST)を作りました。専門家の注釈で14の失敗モードを特定し、(i) システム設計の問題、(ii) エージェント間の食い違い、(iii) 課題の検証、の3つに分類しています。複数エージェントの枠組みの性能向上は、一般的なベンチマークでは小さいことが多い、という問題意識から出発しています事実[参考資料21]。
6. 実際に何が自動化できているか
ベンチマークの数値は、モデルの世代と設定で大きく変わります。次の表は、各論文・ページが示した値で、いずれも公表時点のモデルでの結果です。現在のモデルの性能ではなく、並べて優劣をつけるものでもありません。
| ベンチマーク(出典) | 測るもの | 報告された値(公表時点) | 読むときの注意 |
|---|---|---|---|
| GAIA(Mialon ら、2023年)[参考資料14] | 推論・マルチモーダル・Web閲覧・ツール利用を要する、概念的には単純な実世界の質問466問 | 人間の回答者92%、プラグイン付き GPT-4 は15% | 回答の一部は非公開(300問)でリーダーボードに使われる |
| WebArena(Zhou ら、2023年)[参考資料15] | 実際に動く4領域のWebサイト(ECサイト、フォーラム、共同開発、コンテンツ管理)での、機能的な正しさを測る長い課題 | 最良の GPT-4 ベースのエージェントの課題成功率14.41%、人間は78.24% | 論文時点の最良のエージェント。後続の結果は別 |
| AgentBench(Liu ら、2023年)[参考資料16] | 8つの環境での LLM のエージェントとしての推論・意思決定 | 商用の上位モデルは強い一方、70B以下の多くのオープンモデルとは大きな差。失敗の主な原因は、長期の推論、意思決定、指示への追従の弱さと分析 | コードでの訓練の影響は課題によって異なる、と論文は述べる |
| τ-bench(Yao ら、2024年)[参考資料13] | ユーザー(LLMが模擬)とのやり取りの中で、領域のAPIツールと方針に従うか。最終的なデータベース状態を目標状態と比べる | gpt-4o などの関数呼び出しエージェントで、成功は課題の50%未満。小売で pass^8 は25%未満 | pass^k は、k回の繰り返しですべて成功する信頼性の指標 |
| TheAgentCompany(Xu ら、2024年)[参考資料17] | 小さなソフトウェア会社を模した環境で、Web閲覧、コード作成、プログラム実行、同僚との連絡を行う専門的な課題 | 最も競争力のあるエージェントが、課題の30%を自律的に完了 | 単純な課題の相当部分は解け、難しい長い課題はまだ届かない、と論文は整理 |
| Remote Labor Index(Mazeika ら、2025年)[参考資料18] | 実際のフリーランスの案件(240件)をエンドツーエンドで。自動化率=成果物が人の標準と同等以上と判定された割合 | 最高の性能のエージェントでも自動化率2.5% | 評価は訓練を受けた専門家が手作業で行う。論文時点の値で、リーダーボードは更新されうる |
すべて事実(各論文の要旨とページ)。数値は公表時点のものです。
課題の「長さ」で測る方法もあります。METR(Kwa ら)は、50%の成功率で完了できる課題の、人間の所要時間(50%タスク完了時間ホライズン)という指標を提案しました。論文は、当時の最先端のモデル(Claude 3.7 Sonnet)で約50分、最先端モデルのこの値は2019年以降おおむね7か月ごとに倍増してきた(2024年に加速した可能性もある)と報告し、これが現実のソフトウェア課題に一般化するなら、5年以内に、人間が1か月かかる多くのソフトウェア課題を自動化できるようになる、と外挿しています事実[参考資料19]。 ただし METR 自身のページ(最終更新2026年9月8日、「もはや積極的には更新されていない」と記載)は、次の誤読を戒めています。(1) 50%ホライズンはエージェントが自律的に動ける時間ではなく、課題の難しさの尺度である、(2) 課題は自己完結していて明確に定義され、実世界の仕事(過去の文脈や暗黙知を要する)より「きれい」である、(3) 課題は主にソフトウェア、機械学習、サイバーセキュリティで、他の領域の値は大きく異なりうる、(4) 人間による所要時間は、文脈の少ない人(新人、外部の請負人)を基準にしている事実[参考資料20]。
RLI の2.5%と、TheAgentCompany の30%は、課題の種類も、判定の方法も、公表時点のモデルも違います。数字の大小を比べて、「どちらが進んでいるか」は言えません。判断は、(1) 自分の課題に近いか、(2) 何回試した結果か、(3) 誰がどう採点したか、(4) 失敗が許容できるか、で行います(本記事による解説)。
7. 失敗の型(本稿の計算つき)
エージェントの失敗は、いくつかの型に分けて考えると対策が立てやすくなります。以下は、一次資料に現れた失敗と対策の整理です(型の分け方は本記事のもの)。
(1) 誤りの累積と、繰り返したときのばらつき
Anthropic は、エージェントの自律性が「より高いコストと、誤りが積み重なる可能性」を意味すると述べ、サンドボックス環境での十分なテストとガードレールを勧めます[参考資料1]。調査機能の事例も、「エージェントは状態を持ち、誤りが累積する」と述べ、エラーが起きたとき最初からやり直せない(高価で、ユーザーに不満が残る)ので、途中から再開できる仕組みを作ったとしています[参考資料2]事実。
本稿の計算 単純なモデルで、直感を数値にします。
- 連続ステップ:各ステップが独立に成功率 r で成功するなら、n ステップすべて成功する確率は rn。r=0.99、n=50 で約60.5%。r=0.95、n=20 で約35.8%。r=0.9、n=10 で約34.9%。r=0.999、n=100 でも約90.5%
- 繰り返しの信頼性:1回の成功率が p で独立なら、k回すべて成功する確率(pass^k に相当する理想化)は pk。p=0.9 で k=8 なら約43%。p=0.6 なら k=8 で約1.7%。一方、「k回のうち1回でも成功する」確率は 1−(1−p)k で、p=0.6、k=8 なら約99.9%。「1回でも成功する」と「毎回成功する」は、まったく違う性能です
- 文脈の累積:最初の文脈を3,000トークン、1ステップごとに1,000トークンが加わるとし、n ステップ目に読む文脈を 3,000+(n−1)×1,000 とすると、累計は 3,000n+1,000×n(n−1)/2。n=30 で525,000、n=50 で1,375,000トークン。文脈が累積しない(毎回4,000)場合は、n=50 で200,000
前提と限界:独立という仮定は理想化で、実際は、前の誤りが後の誤りを呼ぶことも、途中で自己修正することもあります。τ-bench の pass^k は課題ごとに計算して平均する指標で、上の pk は直感のための式です。文脈の計算は、要約による圧縮・キャッシュ・ツール結果の取捨を考慮しない単純なモデルで、実在のエージェントの測定値ではありません。
(2) 暴走とコスト
ループに停止条件がないと、エージェントは同じ操作をくり返したり、探し続けたりします。Anthropic の調査機能の初期のエージェントは、簡単な問い合わせに50のサブエージェントを起動する、存在しない情報源をウェブで延々と探す、過剰な更新で互いの邪魔をする、といった誤りを起こした、と同社は述べています[参考資料2]。対策の基本は、最大反復回数やトークン予算の上限、失敗回数の閾値を超えたら人に制御を返す仕組みです(OpenAI のガイドは、失敗閾値の超過と高リスクの行動を、人の介入の2つの主なきっかけに挙げる)[参考資料3]事実。
(3) ツールの誤用と、外部データ経由の指示の混入
AgentBench は、失敗の主な原因として、長期の推論、意思決定、指示への追従の弱さを挙げています[参考資料16]。 さらに、エージェントは外部のデータ(メール、ファイル、Webページ)を読んで作業するため、そこに紛れ込んだ指示に従ってしまう危険があります。Greshake らは、LLM を組み込んだアプリケーションが「データと指示の境界を曖昧にする」ことを指摘し、取得されそうなデータに指示を埋め込む間接プロンプトインジェクションを、攻撃の分類とともに示しました。実在のシステムでの実証も含み、有効な対策はまだ不足している、としています[参考資料22]。 NIST の CAISI は、エージェントが乗っ取られる(ハイジャックされる)問題を、「信頼できる内部の指示と、信頼できない外部のデータとが、明確に分離されていない」ことから生じるものと説明し、評価は固定せず適応的であるべきこと、複数回の試行で攻撃の成功を測ると、より現実的な結果になりうること、などを示しています事実[参考資料23]。 本記事は、攻撃の具体的な手順を扱いません。
(4) 権限が大きすぎる(過剰な代理権限)
OWASP の「LLM06:2025 過剰な代理権限(Excessive Agency)」は、LLM の出力が予想外・曖昧・操作されたものであっても、害のある行動が実行されてしまう脆弱性と定義し、原因は通常、過剰な機能、過剰な権限、過剰な自律性のうち一つ以上だとします。例として、読み取りだけが目的の拡張機能に変更・削除の機能まで含まれている、ユーザー個人の文脈で動くはずの拡張機能が、全ユーザーのファイルにアクセスできる高権限の共通の身元を使っている、文書の削除をユーザーの確認なしに実行する、を挙げています(OWASP は業界団体のプロジェクトで、法令や規格ではありません)事実[参考資料24]。 OpenAI のガイドは、ツールごとに、読み取り専用か書き込みか、取り消せるか、必要なアカウント権限、金銭的な影響を考慮して低・中・高のリスクを付け、高リスクの関数の実行前にガードレールの確認や人への引き継ぎを行う、という考え方を示します[参考資料3]事実。
(5) 複数のエージェントの調整の失敗
MAST の3分類(システム設計、エージェント間の食い違い、課題の検証)[参考資料21]と、Anthropic の事例が述べる初期の誤り[参考資料2]は、エージェントを増やすと調整の複雑さが急に増すことを示しています。トークン使用量は約15倍になりえる、という費用の問題も加わります[参考資料2]事実。
実験や製造の標準作業手順書(SOP)は、「決まった経路」です。Anthropic の言う「ワークフロー」(コードが経路を決める)に近く、予測しやすさと一貫性が、エージェントの柔軟性より重要な場面が多いはずです[参考資料1]。たとえば、測定データの取り込み、単位の変換、異常値の検出、報告書の下書きといった個々のステップに LLM を使い、ステップの間には、プログラムによる検査(ゲート)を置く設計が、まず検討に値します(本記事による解説)。 装置の制御そのものは、決定的な制御とインターロックに任せ、LLM は提案や下書きにとどめて、実行は人が承認する、という分担が安全です(解説。装置の安全規格は、本シリーズ「世界モデルと身体性AI」編で扱う ISO 10218 などを参照してください)。
OWASP の3つの原因(過剰な機能・権限・自律性)は、研究室や工場にそのまま当てはまります。(1) エージェントが呼べる機能は、必要な最小限か(装置の起動・停止・条件変更まで公開していないか)。(2) 接続するアカウントの権限は、読み取りだけで足りるか(データベースの更新・削除ができないか)。(3) 取り消せない操作(試料の消費、装置条件の上書き、ロットの記録の変更)に、人の承認はあるか[参考資料24・3]。 コードやデータと違い、物理的な試料や装置への操作は、後から元に戻せないことがあります。最初は読み取り専用のツールだけを渡し、実績を見てから書き込みを少しずつ許す進め方が、OpenAI のガイドの「信頼が高まるまで人の監督を置く」考え方と整合します(解説)。
エージェントの実行では、各ステップの入力・ツール呼び出し・出力・使ったモデルの版・時刻を記録します。実験ノートと同じく、あとで同じ結果を再現し、失敗の原因をたどるための証拠になります。この分野は変化が速く、モデルの版が変わると挙動も変わるため、版の固定と記録が重要です(解説)。 また、評価は、1回の成功ではなく、同じ課題を繰り返して毎回成功するか(pass^k の考え方)と、全体の成功率(歩留まり)で見ます。複数エージェントは約15倍のトークンを使いえる[参考資料2]ので、費用と電力の見積もりも導入の判断材料です。電力は本シリーズ「AIデータセンターの電力と冷却」編で扱います。
8. 限界と、確認できなかったこと
(1) 現在のモデルの性能
第4章・第6章のベンチマークの数値は、論文や報告の公表時点のモデルでの値です。2026年10月15日時点の最新モデルでの結果や、リーダーボードの現在の順位は網羅していません。METR のページは、2026年9月8日が最終更新で、もはや積極的には更新されていないと記載されています。
(2) 開発元の記述
Anthropic の複数エージェントの事例(90.2%、約4倍・約15倍のトークン、BrowseComp の分散の80%)は、開発元の内部評価と分析で、第三者の再現は確認していません。OpenAI の関数呼び出しの発表ページは自動取得が拒否されたため、関数呼び出しの説明は Google と Anthropic のドキュメントにもとづきます。
(3) 規格
エージェントの信頼性や安全性を直接定める国際規格は、確認できませんでした。ISO/IEC 22989 などは、ISO ページの記載の範囲で題名・版・発行時期を確認しており、本文は確認していません(有料のため)。NIST の AI Agent Standards Initiative(2026年2月17日発表)は、成果物がこれから公表される段階で、本稿は内容を断定しません。
(4) 取り上げなかった内容
Model Context Protocol とエージェント連携は「Model Context Protocolとエージェント連携」編、エージェントの評価・安全の詳細は「エージェントの評価と安全」編、コード生成と画面操作は「コーディングエージェントとコンピュータ操作」編で扱います。特定製品の機能比較・価格は扱いません。攻撃の具体的な手順は書きません。
- エージェントは「LLM+ツール+ループ」です。モデルは関数を実行せず、実行は呼び出し側の責任。安全の中心は、何を許可するかです事実
- ワークフロー(コードが経路を決める)と、エージェント(LLM が決める)は別物です。多くの用途では単純な構成で足り、エージェントは遅延とコストを引き換えにします事実
- 自動化の実績は、課題・条件・公表時点で大きく違います。公表時点の数値を並べて優劣はつけられません事実
- 失敗の型:誤りの累積(0.99の50乗は約61%)、繰り返しのばらつき、暴走とコスト、外部データ経由の指示の混入、過剰な権限、複数エージェントの調整失敗本稿の計算/事実
- 標準化はこれからです。エージェントを直接扱う規格は確認できず、NIST が検討を始めた段階です未確定/将来
9. 評価・標準の読み方
エージェントの評価には、(1)課題の達成率、(2)繰り返したときの信頼性、(3)課題の長さ・難しさ、(4)失敗の原因の分類、(5)セキュリティの5つの面があります。モデルの単体評価と違い、ツール・環境・採点方法・試行回数が結果を左右します。 標準・指針は、エージェントそのものではなく、AIのリスク管理や用語の枠組みが中心で、エージェントを直接扱う標準は策定の初期段階です。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 課題の達成率(エンドツーエンド) | GAIA(466問)[[gaia]]、WebArena(4領域のWebサイト)[[webarena]]、AgentBench(8環境)[[agentbench]]、TheAgentCompany(小さな会社を模した環境)[[tac]]、Remote Labor Index(実際のフリーランス案件240件)[[rli]] | 確認できなかった | 数値は公表時点のモデルの値。採点者(人か自動か)、課題の種類、試行回数で変わる。RLI の自動化率は「合理的な顧客が受け入れるか」の判定で、専門家が手作業で採点 事実 |
| 繰り返したときの信頼性 | τ-bench の pass^k:k回の繰り返しですべて成功する割合(Yao ら)[[taubench]] | 確認できなかった | 平均の成功率だけでは見えない不安定さを測る。論文の値は gpt-4o などの当時のモデル 事実 |
| 課題の長さ・難しさ | METR の50%タスク完了時間ホライズン(Kwa ら)[[metr]]。ページ(最終更新2026年9月8日)[[metrpage]] | 確認できなかった | ホライズンは「エージェントが自律的に動ける時間」ではない。課題は自己完結でソフトウェア・ML・サイバー中心、人の所要時間は文脈の少ない人が基準。50%の成功率の課題の長さであり、毎回成功する長さではない 事実 |
| 失敗の原因の分類 | MAST:複数エージェントの失敗の14モードを3分類、1,600件超の実行記録(Cemri ら)[[mast]] | 確認できなかった | 複数エージェントの枠組みが対象。単独エージェントへの一般化は論文以上には確認していない 事実 |
| セキュリティ(ハイジャックなど) | AgentDojo を使った評価(NIST CAISI の技術ブログ、2025年1月17日。4環境)[[nisthijack]]。間接プロンプトインジェクションの分類(Greshake ら)[[greshake]]。OWASP LLM06:2025 過剰な代理権限[[owasp]] | OWASP は業界団体の文書で、法令・規格ではない。NIST の RFI(2026年1月、回答期限3月9日)[[nistrfi,fedreg]]と、回答の要約 NIST 800-5(2026年5月18日)[[nist8005]]は、ガイドラインそのものではない | 評価は適応的に、複数回の試行で行うのがよいと CAISI は述べる。コンポーネントごとの対策だけでなく、権限の設計が中心 事実 |
| AIのマネジメント・リスク・用語 | (ベンチマークではなく枠組み) | ISO/IEC 42001:2023(AIマネジメントシステム)[[iso42001]]。ISO/IEC 23894:2023(リスク管理)[[iso23894]]。ISO/IEC 22989:2022(概念と用語。「AI agent」を含む)[[iso22989]]。NIST AI RMF 1.0(2023年1月)[[nist100]]と AI 600-1(2024年7月。情報セキュリティ、人とAIの関係、バリューチェーンなどのリスクを含む)[[nist600]] | NIST の2文書は自主的に使う枠組み。ISO/IEC 42001 は組織の管理体制の規格で、個々のエージェントの安全を保証しない。本文は有料のため、題名・適用範囲にとどめる 事実 |
| エージェントを直接扱う標準化の動き | (ベンチマークではなく標準化活動) | NIST CAISI の AI Agent Standards Initiative(2026年2月17日発表。業界主導の標準、オープンソースのプロトコル、エージェントのセキュリティと識別の研究の3本柱。研究・ガイドライン・成果物は今後発表と記載)[[nistinit]] | 成果物はこれから。内容を前提にしない 未確定/将来 |
表の整理は本記事のもの(解説)です。ISO/IEC の本文は有料で確認していません。確認日 2026年10月15日。
読み方の注意(素材技術者向けに3点)
- 数値は、設定と実施主体で変わります。同じ課題でも、ツールの与え方、プロンプト、採点者、試行回数が違えば結果は変わります。開発元の内部評価は独立した評価ではありません。公表時点のモデルの値を、現在のモデルの性能として読みません
- 平均より「毎回」と「最悪」を見ます。pass^k のように繰り返しの信頼性を測り、失敗したときに何が起きうるか(権限・取り消せるか)を、成功率とは別に評価します。ベンチマーク一般の飽和・汚染は、本シリーズ「ベンチマークと評価の読み方」編で扱います
- 標準・指針は「要求」「推奨」「策定中」を区別します。NIST の枠組みや OWASP の文書は拘束力がなく、ISO/IEC 42001 は組織の管理体制の要求事項で、エージェントそのものの出力を保証しません。エージェントを直接扱う標準は策定の初期で、法的な拘束力のある規制は「EU AI法」編などで扱います
10. 用語集
- AIエージェント
- LLM が、ツールを使い、環境からの結果を見ながら、ループで作業を進める仕組み。
- ワークフロー
- LLM とツールを、あらかじめ決めたコードの経路で組み合わせるシステム。
- 関数呼び出し(ツール利用)
- モデルが呼ぶ関数の名前と引数を返し、アプリが実行して結果を返す仕組み。
- ReAct
- 推論の痕跡と行動を交互に生成させる方法。
- ground truth(環境からの情報)
- ツールの結果やコード実行の結果など、進み具合を判断する根拠。
- 停止条件
- 最大反復回数やトークン予算など、ループを止める条件。
- オーケストレーター+ワーカー
- 中心の LLM が課題を分解し、ワーカーの LLM に委任する型。
- pass^k
- k回の繰り返しですべて成功する割合。信頼性の指標。
- 50%タスク完了時間ホライズン
- AIが50%の成功率で完了できる課題の、人間の所要時間。
- 間接プロンプトインジェクション
- エージェントが読む外部データに指示が紛れ込み、意図しない行動を誘発すること。
- エージェントのハイジャック
- 間接プロンプトインジェクションの一種。NIST CAISI が使う用語。
- 過剰な代理権限
- OWASP の用語。機能・権限・自律性が必要以上に大きいこと。
- ガードレール
- 入出力の検査や、ツールのリスク評価などで、エージェントの行動を制限する仕組み。
- メモリ(短期・長期)
- 文脈の中の記憶と、モデルの外に保存する記憶(本記事の整理)。
11. 参考資料(一次情報)
- Anthropic "Building effective agents"(2024年12月19日付。ページに「ツール群の多くは2024年12月以降に変わった」との注記あり)。確認日 2026年10月15日 — anthropic.com/engineering/building-effective-agents
- Anthropic "How we built our multi-agent research system"(2025年6月13日付)。確認日 2026年10月15日 — anthropic.com/engineering/multi-agent-research-system
- OpenAI "A practical guide to building agents"(PDF。ファイルのメタデータ上の作成日は2025年4月7日)。確認日 2026年10月15日 — cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
- Google "Function calling with the Gemini API"(ページの最終更新 2026年9月23日と記載)。確認日 2026年10月15日 — ai.google.dev/gemini-api/docs/function-calling
- Anthropic "Tool use with Claude"(Claude Platform Docs)。確認日 2026年10月15日 — platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Yao S. ほか "ReAct: Synergizing Reasoning and Acting in Language Models", arXiv:2210.03629 (2022) — arxiv.org/abs/2210.03629
- Schick T. ほか "Toolformer: Language Models Can Teach Themselves to Use Tools", arXiv:2302.04761 (2023) — arxiv.org/abs/2302.04761
- Shinn N. ほか "Reflexion: Language Agents with Verbal Reinforcement Learning", arXiv:2303.11366 (2023) — arxiv.org/abs/2303.11366
- Park J. S. ほか "Generative Agents: Interactive Simulacra of Human Behavior", arXiv:2304.03442 (2023) — arxiv.org/abs/2304.03442
- Packer C. ほか "MemGPT: Towards LLMs as Operating Systems", arXiv:2310.08560 (2023) — arxiv.org/abs/2310.08560
- Yao S. ほか "Tree of Thoughts: Deliberate Problem Solving with Large Language Models", arXiv:2305.10601 (2023) — arxiv.org/abs/2305.10601
- Valmeekam K. ほか "On the Planning Abilities of Large Language Models (A Critical Investigation with a Proposed Benchmark)", arXiv:2302.06706 (2023) — arxiv.org/abs/2302.06706
- Yao S. ほか "τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains", arXiv:2406.12045 (2024) — arxiv.org/abs/2406.12045
- Mialon G. ほか "GAIA: a benchmark for General AI Assistants", arXiv:2311.12983 (2023) — arxiv.org/abs/2311.12983
- Zhou S. ほか "WebArena: A Realistic Web Environment for Building Autonomous Agents", arXiv:2307.13854 (2023) — arxiv.org/abs/2307.13854
- Liu X. ほか "AgentBench: Evaluating LLMs as Agents", arXiv:2308.03688 (2023) — arxiv.org/abs/2308.03688
- Xu F. F. ほか "TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks", arXiv:2412.14161 (2024) — arxiv.org/abs/2412.14161
- Mazeika M. ほか "Remote Labor Index: Measuring AI Automation of Remote Work", arXiv:2510.26787 (2025) — arxiv.org/abs/2510.26787
- Kwa T. ほか(METR) "Measuring AI Ability to Complete Long Software Tasks", NeurIPS 2025, arXiv:2503.14499 — arxiv.org/abs/2503.14499
- METR "Task-Completion Time Horizons of Frontier AI Models"(ページの最終更新 2026年9月8日、「もはや積極的には更新されていない」と記載)。確認日 2026年10月15日 — metr.org/time-horizons
- Cemri M. ほか "Why Do Multi-Agent LLM Systems Fail?", arXiv:2503.13657 (2025) — arxiv.org/abs/2503.13657
- Greshake K. ほか "Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection", arXiv:2302.12173 (2023) — arxiv.org/abs/2302.12173
- NIST CAISI "Technical Blog: Strengthening AI Agent Hijacking Evaluations"(2025年1月17日付) — nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations
- OWASP Gen AI Security Project "LLM06:2025 Excessive Agency"(業界団体のプロジェクトの文書。法令・規格ではない)。確認日 2026年10月15日 — genai.owasp.org/llmrisk/llm062025-excessive-agency
- NIST CAISI "CAISI Issues Request for Information About Securing AI Agent Systems"(2026年1月12日付)。連邦官報の告示は2026年1月8日付、回答期限 2026年3月9日 — nist.gov/news-events/news/2026/01/caisi-issues-request-information-about-securing-ai-agent-systems
- Federal Register "Request for Information Regarding Security Considerations for Artificial Intelligence Agents"(NIST、2026年1月8日付の告示) — federalregister.gov/documents/full_text/xml/2026/01/08/2026-00206.xml
- NIST CAISI "Announcing the AI Agent Standards Initiative for Interoperable and Secure Innovation"(2026年2月17日付) — nist.gov/news-events/news/2026/02/announcing-ai-agent-standards-initiative-interoperable-and-secure
- NIST "Summary Analysis of Responses to the Request for Information Regarding Security Considerations for AI Agents"(NIST Trustworthy and Responsible AI 800-5、2026年5月18日公開) — nist.gov/publications/summary-analysis-responses-request-information-regarding-security-considerations-ai
- NIST NIST AI 100-1 "Artificial Intelligence Risk Management Framework (AI RMF 1.0)"(2023年1月) — doi.org/10.6028/NIST.AI.100-1
- NIST NIST AI 600-1 "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile"(2024年7月) — doi.org/10.6028/NIST.AI.600-1
- ISO/IEC ISO/IEC 42001:2023 "Information technology — Artificial intelligence — Management system"(第1版、2023年12月) — iso.org/standard/81230.html
- ISO/IEC ISO/IEC 23894:2023 "Information technology — Artificial intelligence — Guidance on risk management"(第1版、2023年2月) — iso.org/standard/77304.html
- ISO/IEC ISO/IEC 22989:2022 "Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(第1版、2022年7月。「AI agent」などの用語を定義すると ISO ページの要約にある) — iso.org/standard/74296.html
12. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| エージェント型システムの区別:ワークフロー(コードの経路で LLM とツールを組み合わせる)とエージェント(LLM が自分の進め方とツールの使い方を決める)。「可能なかぎり単純な解決策」、ループ・環境からの ground truth・停止条件、5つのワークフローの型(連鎖、ルーティング、並列化、オーケストレーター+ワーカー、評価者+最適化)、「ツール群の多くは2024年12月以降に変わった」との注記 | 出典1 https://www.anthropic.com/engineering/building-effective-agents | 事実 |
| OpenAI のガイド:エージェントの定義と特徴、エージェントでないもの、ツール3種(データ・アクション・オーケストレーション)、「run」のループと終了条件、ツールのリスク評価(読み取り専用か書き込みか、取り消せるか、権限、金銭的影響)、人の介入のきっかけ(失敗閾値の超過、高リスクの行動) | 出典3 https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf | 事実 |
| 関数呼び出しの流れ(宣言→関数名と引数を返す→アプリが実行→結果を返す、並列・合成的な呼び出し、実行は呼び出し側の責任)、クライアント側ツールとサーバー側ツール、stop_reason が tool_use | 出典4 https://ai.google.dev/gemini-api/docs/function-calling 出典5 https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview | 事実 |
| Toolformer(電卓・質問応答・検索・翻訳・カレンダー)、ReAct(ALFWorld +34%、WebShop +10%)、Tree of Thoughts(Game of 24 で74%、連鎖思考は4%)、Valmeekam ら(自律的な計画の成功率は平均約3%) | 出典7 https://arxiv.org/abs/2302.04761 出典6 https://arxiv.org/abs/2210.03629 出典11 https://arxiv.org/abs/2305.10601 出典12 https://arxiv.org/abs/2302.06706 | 事実 |
| Generative Agents(自然言語の記録・振り返り・検索)、MemGPT(仮想的な文脈管理)、Reflexion(言語の反省を記憶、HumanEval 91%) | 出典9 https://arxiv.org/abs/2304.03442 出典10 https://arxiv.org/abs/2310.08560 出典8 https://arxiv.org/abs/2303.11366 | 事実 |
| 複数エージェント:内部評価で単独を90.2%上回る、トークンは約4倍・約15倍、BrowseComp の分散の80%をトークン使用量が説明、共有文脈・依存の多い領域には不向き、初期の誤り(50のサブエージェント等)、誤りが累積すること。MAST(1,600件超、7枠組み、14モード、3分類) | 出典2 https://www.anthropic.com/engineering/multi-agent-research-system 出典21 https://arxiv.org/abs/2503.13657 | 事実 |
| GAIA(466問、人間92%・プラグイン付き GPT-4 15%)、WebArena(14.41%と78.24%)、AgentBench(8環境)、τ-bench(50%未満、pass^8 25%未満)、TheAgentCompany(30%)、Remote Labor Index(240件、2.5%、自動化率の定義)。いずれも公表時点のモデル | 出典14 https://arxiv.org/abs/2311.12983 出典15 https://arxiv.org/abs/2307.13854 出典16 https://arxiv.org/abs/2308.03688 出典13 https://arxiv.org/abs/2406.12045 出典17 https://arxiv.org/abs/2412.14161 出典18 https://arxiv.org/abs/2510.26787 | 事実 |
| METR の50%タスク完了時間ホライズン(Claude 3.7 Sonnet で約50分、2019年以降おおむね7か月で倍増、外挿の記述)、METR ページ(最終更新2026年9月8日、自律で動ける時間ではない、課題の性質、人の所要時間の基準) | 出典19 https://arxiv.org/abs/2503.14499 出典20 https://metr.org/time-horizons/ | 事実 |
| 間接プロンプトインジェクション(データと指示の境界)、NIST CAISI の技術ブログ(2025年1月17日、信頼できる内部指示と外部データの分離の欠如、適応的な評価、複数回の試行、AgentDojo の4環境)、OWASP LLM06:2025(過剰な機能・権限・自律性、例) | 出典22 https://arxiv.org/abs/2302.12173 出典23 https://www.nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations 出典24 https://genai.owasp.org/llmrisk/llm062025-excessive-agency/ | 事実 |
| NIST CAISI の RFI(2026年1月12日付、連邦官報 2026年1月8日付、回答期限 2026年3月9日)、AI Agent Standards Initiative(2026年2月17日付、3本柱、成果物は今後)、NIST 800-5(2026年5月18日公開、RFI 回答の要約) | 出典25 https://www.nist.gov/news-events/news/2026/01/caisi-issues-request-information-about-securing-ai-agent-systems 出典26 https://www.federalregister.gov/documents/full_text/xml/2026/01/08/2026-00206.xml 出典27 https://www.nist.gov/news-events/news/2026/02/announcing-ai-agent-standards-initiative-interoperable-and-secure 出典28 https://www.nist.gov/publications/summary-analysis-responses-request-information-regarding-security-considerations-ai | 事実 |
| ISO/IEC 42001:2023、23894:2023、22989:2022(「AI agent」を含むとの ISO ページの要約)、NIST AI 100-1(2023年1月)、NIST AI 600-1(2024年7月)。番号・題名・版は公式ページの記載、ISO の本文は未確認 | 出典31 https://www.iso.org/standard/81230.html 出典32 https://www.iso.org/standard/77304.html 出典33 https://www.iso.org/standard/74296.html 出典29 https://doi.org/10.6028/NIST.AI.100-1 出典30 https://doi.org/10.6028/NIST.AI.600-1 | 事実 |
| 連続ステップの成功率 r^n(0.99の50乗=約60.5%、0.95の20乗=約35.8%、0.9の10乗=約34.9%、0.999の100乗=約90.5%)、繰り返しの成功 p^k(0.9の8乗=約43%、0.6の8乗=約1.7%、1回でも成功は約99.9%)、文脈の累計(n=30 で525,000、n=50 で1,375,000、累積しない場合200,000) | 本稿の計算。独立という理想化と、文脈3,000+1,000/ステップの仮定にもとづく。実在のエージェントの測定値ではない。τ-bench の pass^k は課題ごとに計算して平均する指標で、p^k は直感のための式 | 本稿の計算 |
| エージェントの信頼性・安全を直接定める国際規格、開発元の評価の第三者による再現、最新モデルでの結果、NIST の AI Agent Standards Initiative の成果物、ISO/IEC の規格本文、OpenAI の関数呼び出し発表ページの全文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「手順書のある作業はワークフローから」「読み取り専用から始め、書き込みと取り消せない操作は人の承認に」「実行ログは実験ノート、評価は繰り返して歩留まりで見る」という読み取りと、表の整理(第4・9章)、メモリの短期・長期の整理 | 公表内容にもとづく本記事の整理・解説。各社・各機関が表明した見解ではない | 解説 |
| 図2〜図5が説明のための作図(実測データではない)であること。図1と図6がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(開発元の技術文書、arXiv の論文、METR・NIST・OWASP の公式ページ、ISO/IEC の規格ページ)に限定しています。ISO/IEC の規格本文は有料のため確認できていません。 読み取りや整理を含むため、それらは「解説」として出典付きの事実と区別しています。 最新モデルでの結果、開発元の評価の第三者による再現、エージェントを直接定める規格、NIST の AI Agent Standards Initiative の成果物、規格の本文については、確認できなかったため記載していません。 ベンチマークの数値は公表時点・指定の設定のもので、モデルの優劣を示すものではありません。攻撃の具体的な手順は記載していません。 図2〜図5はベクター作図、図1と図6はImageGen生成の概念画像です(いずれも実際の測定結果や製品の実物を示すものではありません)。