TECHNOLOGY EXPLAINER
機械学習とニューラルネットワークの基礎
― 「データから関数を当てはめる」ことと、評価で壊れやすいところ
機械学習は、入力と出力の関係を、データから当てはめる手法です。ニューラルネットワークはその一つで、層を重ねた関数のパラメータを、損失の勾配で少しずつ動かして学習します。 ところが、訓練データに当てはまることと、新しい試料にも当たることは別です。この記事では、学習の3類型、損失と最適化、誤差逆伝播、過学習、評価の基本を、小さな数値例で確かめながら整理します。後半では、素材技術者が自分のデータ解析や材料研究で使うときの落とし穴(データ漏れ、外挿、小さなデータ)を、一次情報の範囲で扱います。
- 機械学習とは何か(3行でつかむ)
- 学習の3類型 ― 教師あり、教師なし、強化学習
- モデル、損失、最適化 ― ニューラルネットワークが「学ぶ」仕組み
- 誤差逆伝播 ― 小さな数値例で追う
- 汎化と過学習 ― 訓練データに当てはまることと、新しいデータに当たること
- 評価の基本 ― データの分け方と指標
- 素材技術者が使うときの注意 ― データ漏れ、外挿、小さなデータ
- 計算資源との接点 ― パラメータ数とメモリ
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=改訂中・制定途中・提案段階などで、確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。
第4章〜第6章の数値例は、本稿が作った小さな合成データ(乱数の種を固定)の計算です。実在の材料データや製品の性能を示すものではありません。「こう書けば効く」という処方でもなく、仕組みと落とし穴を数値で見せるための例です。 規格(ISO/IEC)は題名・適用範囲の確認にとどめ、本文は確認していません。特定のソフトウェアや企業の優劣は論じません。
1. 機械学習とは何か(3行でつかむ)
- 機械学習は「データから関数を当てはめる」こと:入力(組成、画像、スペクトル)から出力(物性値、欠陥の有無)を返す関数を、人が式で書く代わりに、データに合わせてパラメータを調整して作ります
- ニューラルネットワークは、線形変換と非線形関数を重ねたもの:全パラメータを、損失(予測と正解のずれ)が小さくなる向きに少しずつ動かします。各パラメータの動かす向きは誤差逆伝播で効率よく求めます事実[参考資料1]
- 訓練データでの当たりは、新しい試料での当たりを保証しない:評価で壊れやすいのは、データの分け方(同じ系統の試料が訓練と評価にまたがる「漏れ」)、指標の選び方、訓練データの範囲の外への外挿です
「訓練データに当てはまる」ことは、「新しいデータで当たる」ことの証拠になりません。 Zhang らは、画像認識のニューラルネットワークが、ラベルをランダムに付け替えたデータでも訓練データに容易に当てはまる(訓練誤差を下げられる)ことを示しました事実[参考資料5]。 当てはまるだけなら、何も学ばなくても達成できる、ということです。
2. 学習の3類型 ― 教師あり、教師なし、強化学習
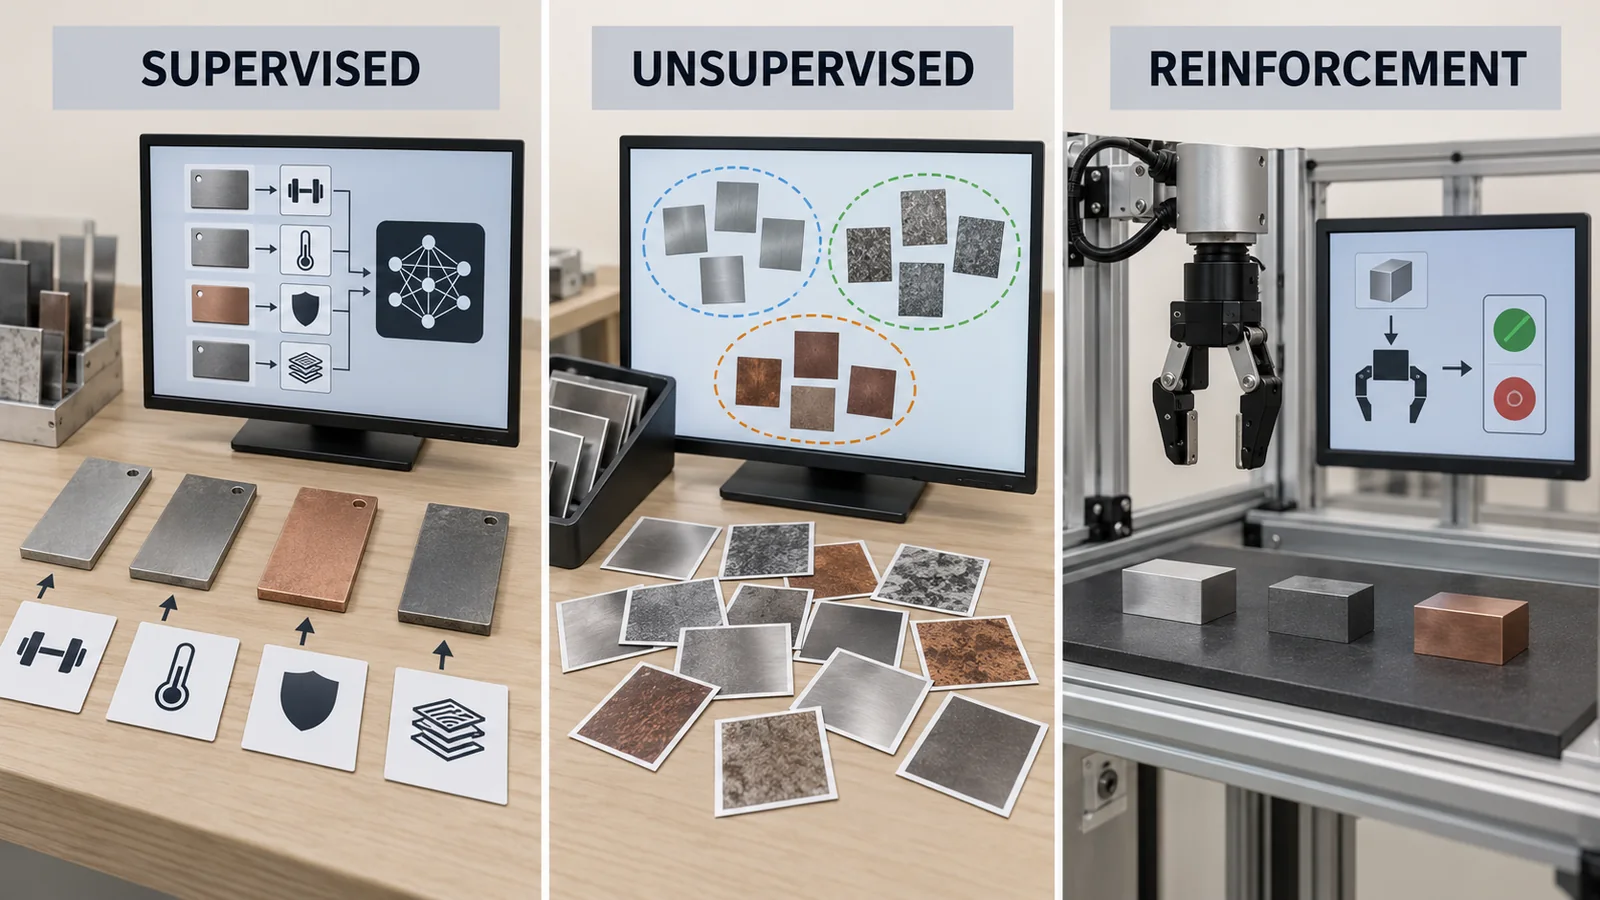
ここでは学習の目標を、「正解との違いを小さくする」「正解ラベルなしでデータの表現を学ぶ」「行動と報酬から方策を学ぶ」の3つに整理します。これは入口としての本記事の分類で、手法が必ず一つの箱に収まるという意味ではありません。誤差逆伝播の原著研究[参考資料1]と、後に挙げる個別の研究・公式実装資料を、具体的な仕組みと評価を確かめるための出典にします。
| 類型 | 与えるデータ | 学習の目標 | 素材分野での使い方の例(解説) | 注意 |
|---|---|---|---|---|
| 教師あり学習 | 入力 x と、正解 y の組 | x から y を返す関数を作る。回帰(連続値)と分類(カテゴリ)がある | 組成や構造から物性値を予測する。顕微鏡像から欠陥を分類する | 正解 y の質とコストが制約。測定のばらつきは、予測の精度の下限になる |
| 教師なし学習 | 入力 x だけ(正解がない) | データの構造(まとまり、少数の軸による表現)を見つける | スペクトルや顕微鏡像のクラスタリング、次元削減による可視化 | 「正解」がないので、良し悪しは目的に応じて別に評価する必要がある |
| 強化学習 | 環境とのやりとり(行動と、その結果の状態・報酬) | 累積の報酬を大きくする方策を探す | 条件を逐次変えて報酬(目的の指標)を上げる、という枠組みで説明される(素材分野での実用例は、本稿では確認していません) | 報酬の設計で結果が決まる。試行回数のコストが大きい |
3つの類型と素材分野での使い方の例は、本記事による導入のための整理です。分類自体を実験結果とは扱いません。
元のSVG模式図・数値・出典注記を見る
大規模言語モデルの学習の中心は、自己教師あり学習(正解ラベルを、データ自身から作る。例:文章の次の単語を当てる)です。これは本シリーズ「Transformerと大規模言語モデル」編で扱います。また、人の好みを報酬にして調整する後段の学習(強化学習の応用)は、本シリーズ「事後学習とファインチューニング」編で扱います。
3. モデル、損失、最適化 ― ニューラルネットワークが「学ぶ」仕組み
(1) モデル:線形変換と非線形関数の重ね合わせ
ニューラルネットワークの1つの層は、入力ベクトル x に重み行列 W を掛け、バイアス b を足し、活性化関数 φ(tanh、ReLU など)を通します(h = φ(Wx + b))。これを何層も重ねたものがネットワークです。活性化関数が非線形なので、層を重ねることで曲がった関数を表せます(本記事による解説)。 Hornik らは、隠れ層を持つ標準的な多層の順伝播型ネットワークが、隠れ素子を十分に増やせば関数を任意の精度で近似できる、という「万能近似」の結果を示しました事実[参考資料3]。 ただし、これは近似できるネットワークが存在することの結果です。データから、そのパラメータが見つかることや、新しいデータで当たることは保証しません(本記事による解説)。定理の細かな条件(活性化関数の種類、近似の意味)は、本稿では原論文の本文を確認していません。
(2) 損失:「ずれ」を1つの数にする
学習の目標を数式にするのが損失関数 L です。回帰では、予測と正解の差の二乗の平均(平均二乗誤差)がよく使われ、分類では、正解のクラスに与えた確率の対数に基づく交差エントロピーが使われます(本記事による解説)。損失は「何を良しとするか」を決める設計の一部で、評価の指標とは別に選べます。
(3) 最適化:勾配に沿ってパラメータを動かす
パラメータ θ を、損失が小さくなる向き(勾配の逆向き)に、学習率 η の大きさだけ動かすのが勾配降下法です(θ ← θ − η∇L)。データ全体ではなく、少数のデータ(ミニバッチ)で勾配を見積もって動かすのが確率的勾配降下法(SGD)です。 Adam は、勾配の一次モーメントと二次モーメントを移動平均で持ち、パラメータごとに歩幅を調整する方法で、原論文は、試したいくつかの問題で良かった既定値として α = 0.001、β1 = 0.9、β2 = 0.999、ε = 10−8 を示しています事実[参考資料2]。 これらの値は、原論文が試した問題での既定値であり、どのデータでも最良とは限りません(本記事による解説)。学習率、バッチの大きさ、層の数や幅などのハイパーパラメータは、訓練データではなく、検証データで選びます(第6章)。
| 学習の1ステップ | やること | 注意 |
|---|---|---|
| ① 順伝播 | ミニバッチを入力し、各層を通して予測 ŷ を出す | 後で逆伝播に使うため、各層の中間値を保存する(メモリを使う) |
| ② 損失の計算 | 予測と正解のずれを、損失 L にする | 損失の定義が、何を良しとするかを決める |
| ③ 逆伝播 | L を各パラメータで偏微分した勾配を、出力側から順に求める | 第4章の数値例を参照 |
| ④ 更新 | 勾配と最適化手法(SGD、Adam など)でパラメータを動かす | 学習率が大きすぎると発散し、小さすぎると進まない |
| ⑤ 繰り返し | データを何周か(エポック)回し、検証データの損失を監視する | 検証データの損失が悪化し始めたら、学習を止める(早期終了)などの対策がある |
学習ループは、損失を計算し、勾配からパラメータを更新する流れを理解するための本記事の説明です。特定の実装の全工程を示すものではありません。
パラメータ数の例(本稿の計算):入力784個、隠れ層128個、出力10個の全結合ネットワーク(手書き数字の分類によく使われる形)のパラメータ数は、784×128+128+128×10+10 = 101,770 個です。1回の順伝播の計算量は、乗算と加算を合わせて約 2×101,770 ≒ 20万回の浮動小数点演算(活性化関数などを除く概算)です。
4. 誤差逆伝播 ― 小さな数値例で追う
誤差逆伝播(バックプロパゲーション)は、Rumelhart、Hinton、Williamsが1986年に報告した学習手順です[参考資料1]。出力と目標の違いを表す損失から、各層の重みをどちらへ変えるべきかを逆向きに計算します。以下の式と小さな数値例は、この手順を理解するための本記事の説明です。
仕組みは、連鎖律(合成関数の微分)です。出力側で求めた「損失が出力にどれだけ敏感か」を、1層ずつ入力側にさかのぼって掛け合わせると、すべてのパラメータの勾配が、順伝播とほぼ同じ程度の計算で求まります(本記事による解説)。次の例は、2入力・隠れ素子2個(tanh)・出力1個のネットワークです。
- 入力 x = (1, 2)、重み W₁ = [[0.1, 0.2], [0.3, 0.4]]、W₂ = (0.5, 0.6)、バイアスは0、目標 t = 1
- 順伝播で ŷ = 0.7114、損失 L = 0.04166。逆伝播で、W₁ の1つの成分の勾配 ∂L/∂W₁[0,0] = −0.11350 が得られます
- この勾配が正しいかは、重みをごくわずか(10−6)動かして損失の変化を測る数値微分で確認できます。本稿の計算では −0.113501 で、逆伝播の値(−0.113501)と一致しました
- 学習率 0.1 で1回更新すると、損失は 0.04166 から 0.02759 に下がります
本稿の計算。Python(NumPy)で、倍精度で計算。入力、重み、目標は説明用の値で、実在のデータではありません。
逆伝播では、各層の勾配を求めるのに、順伝播で出した中間の値(上の例の h など)をもう一度使います。つまり、学習は、推論(予測だけ)より多くのメモリを使います。ネットワークが大きくなると、この中間値とパラメータ、勾配、最適化の状態がメモリを占め、第8章で見るように、メモリの容量と帯域が計算の制約になります。
素材から見ると、この制約が、HBM(広帯域メモリ)の積層やパッケージ、冷却の材料に対する要求の出どころです。本シリーズ「HBM」編と「AIアクセラレータ」編で扱っています(本記事による解説)。
5. 汎化と過学習 ― 訓練データに当てはまることと、新しいデータに当たること
学習の目的は、訓練データを覚えることではなく、まだ見ていないデータで当たること(汎化)です。モデルが複雑すぎて、データのノイズまで当てはめてしまう状態を過学習、単純すぎて傾向も表せない状態を過少適合と呼びます。次の図は、過学習を小さな合成データで再現したものです。
- データ:y = sin(2πx) に、標準偏差0.2の正規ノイズを加えた15点を訓練データにしました。評価には、同じ作り方の新しい2,000点を使いました(乱数の種0)
- モデル:多項式(次数が高いほど自由度が大きい)を、最小二乗法で当てはめました
- 結果:次数1〜2では直線に近く、訓練でもテストでも大きくずれます(過少適合)。次数3〜5で、テストの誤差は約0.24と最小になります。次数が増えると、訓練の誤差は下がり続けるのに、テストの誤差は上がります(次数9で0.41)
- 次数14(15点を通る補間):訓練の誤差はほぼ0ですが、テストの誤差は約8,600まで跳ね上がりました(数値計算の精度の問題も含みます)
本稿の計算。合成データで、特定の材料データの結果ではありません。測定ノイズ(0.2)は、どのモデルでも下回れない誤差の目安になります(本記事による解説)。
(1) 過学習を抑える方法(一般的なもの)
代表的な方法として、データを増やす、モデルを小さくする、正則化(重みが大きくなることに罰則を課す重み減衰など)、早期終了(検証データの損失が悪化し始めたら止める)、ドロップアウト(学習中に素子をランダムに無効にする)があります。ドロップアウトは Srivastava らが、ニューラルネットワークの過学習を防ぐ簡単な方法として提案しました事実[参考資料4]。その他の方法の説明は、本記事による用語の整理です。
(2) 「複雑さを増すと必ず悪くなる」とは限らない
古典的な統計では、モデルが複雑すぎると分散が増えて、テスト誤差が上がる(U字の曲線)と説明されます。しかし現代のニューラルネットワークは、訓練データを完全に補間するほど大きくても、高い精度を出すことが知られています。Belkin らは、この両者を二重降下(double descent)の曲線でまとめました。補間できる点(補間しきい値)を超えて複雑さを増すと、性能が再び良くなる、というものです事実[参考資料6]。Nakkiran らは、モデルの大きさだけでなく、学習のエポック数でも二重降下が起き、訓練データを増やすことが性能を悪化させる領域さえあることを示しました事実[参考資料7]。
上の図の多項式の例(古典的な U 字)と、巨大なニューラルネットワークの二重降下は、モデルの種類・データ・正則化・学習の方法が違う別の現象として観察されたものです(本記事による解説)。実務でわかるのは、「どの複雑さが良いか」は理論から決まらず、検証データで測って決めるということです。
(3) 評価用データの使い回しにも限界がある
同じ評価用データを何年も使い続けると、研究者が無意識に、そのデータに合わせてモデルや設定を選んでしまうおそれがあります。Recht らは、CIFAR-10 と ImageNet について、元の作り方に近い手順で新しい評価用データを作り直して、既存のモデルを測り直しました。精度は、CIFAR-10 で3〜15%、ImageNet で11〜14%下がりました事実[参考資料8]。一方で、元のデータでの精度の向上は、新しいデータでの、より大きな向上につながっていました。著者らは、この低下は、評価データへの適応ではなく、元の評価データより「やや難しい」画像への一般化の力の不足によると結論しています[参考資料8]。
ここでの教訓は、「評価用データでの数字」は、そのデータの作られ方と使われ方に条件づけられることです(本記事による解説)。この点は、本シリーズ「ベンチマークと評価の読み方」編で、言語モデルのベンチマークについて詳しく扱います。
6. 評価の基本 ― データの分け方と指標
(1) 訓練・検証・テストに分ける
データを、訓練用(パラメータの学習)、検証用(ハイパーパラメータとモデルの選択)、テスト用(最後に1回だけ性能を報告)に分けます。データが少ないときは、訓練用と検証用を何通りかに分けて平均する交差検証を使います。scikit-learn のユーザーガイドは、予測の仕方を学んだデータで同じ評価をすると、ラベルを覚えただけのモデルでも満点になり、見たことのないデータでは何の役にも立たない、として、テスト用データを取り分けるのが一般的な手順だと説明しています事実[参考資料19]。
(2) 指標は、目的に合わせて選ぶ
指標は、モデルの出力の種類で変わります。分類では、正解率(accuracy)、適合率(precision)、再現率(recall)、F1値、ROC曲線の面積(AUC)などが、回帰では、平均絶対誤差(MAE)、二乗平均平方根誤差(RMSE)、決定係数(R²)などが使われます(本記事による解説)。ISO/IEC TS 4213:2022 は、分類のモデル・システム・アルゴリズムの性能を測る方法を定める技術仕様です事実[参考資料23](本文は有料で、本稿では未確認)。
例:まれな欠陥を探す分類(本稿の計算)。10,000個の試料のうち、欠陥品が100個(1%)あるとします。すべて「良品」と答えるだけの何もしないモデルでも、正解率は 99% です。一方、欠陥品100個のうち60個を見つけ(再現率60%)、良品9,900個のうち140個を誤って欠陥と判定した(適合率 60 ÷ 200 = 30%)モデルの正解率は 98.2% で、何もしないモデルより低くなります。F1値は 0.40 です。
| モデル | 真陽性 | 偽陰性 | 偽陽性 | 真陰性 | 正解率 | 適合率 | 再現率 |
|---|---|---|---|---|---|---|---|
| 常に「良品」と答える | 0 | 100 | 0 | 9,900 | 99.0% | 定義できない | 0% |
| 欠陥を拾うモデル(例) | 60 | 40 | 140 | 9,760 | 98.2% | 30% | 60% |
本稿の計算。数値は説明用の架空の例です。不均衡なデータでは、正解率だけでは良し悪しを判断できません。どの指標を使うかは、見逃し(偽陰性)と誤検出(偽陽性)のコストで決めます(本記事による解説)。
(3) 単純な基準(ベースライン)と比べる
複雑なモデルの数字だけでは、良いかどうかわかりません。「常に平均を返す」「最も近い訓練データの値を返す」などの単純な基準と比べて、初めて意味が出ます。Meredig らは、材料探索への機械学習の評価で、最近傍の単純なベンチマークを導入しています事実[参考資料11]。
7. 素材技術者が使うときの注意 ― データ漏れ、外挿、小さなデータ
素材のデータは、系統だった試料群(同じ組成の系列、同じ成膜バッチ、同じ装置の繰り返し測定)でできていることが多く、データ分割や評価で落とし穴が起きやすい性質があります(本記事による解説)。
(1) データ漏れ(leakage)
Kapoor と Narayanan は、機械学習を使う科学の研究のうち、データ漏れが見つかった17分野で、少なくとも294本の論文が影響を受けていたと報告しています。漏れの型は8つに整理され、テスト用データがない、前処理を訓練とテストにまたがって行う、特徴選択をまたがって行う、データの重複、不適切な特徴量、時間的な漏れ、訓練とテストの独立性がない、テストの分布の偏り、が含まれます事実[参考資料10]。 素材データでの典型は、同じ試料や同じ系統の試料が訓練と評価にまたがることです。Kapoor らの「訓練とテストの独立性の欠如(L3.2)」にあたります。対策として、訓練とテストの間の依存関係を考慮した分割(ブロック交差検証など)が挙げられています[参考資料10・13]。scikit-learn の GroupKFold は、同じグループが訓練用と評価用の両方に入らないように分ける方法です事実[参考資料20]。
次の合成データの実験で、分け方による評価の違いを見ました(本稿の計算)。30の系統(各系統10試料)を作り、各系統の特徴量は系統ごとの固定のパターンに小さなノイズを加え、物性値は系統ごとの値(系統間で標準偏差2)に小さなノイズ(0.3)を加えたものにしました。この物性値は、系統の中の特徴量の違いとは無関係です。3近傍の単純な予測で5分割の交差検証をすると、
- ランダムに分ける:決定係数 R² = 0.96(同じ系統の試料が訓練にも入るので、近い試料の値を写すだけで高く出る)
- 系統ごとに分ける:R² = −1.28(評価の系統は訓練に一つもなく、新しい系統の値は予測できない)
本稿の計算。極端な合成データです(物性値が系統の違いだけで決まる)。実際のデータで両者がどれだけ開くかは、系統の効果の大きさによります。R² は 0 より小さくなりえます(平均値を返す予測より悪い)。
評価の数字は、「何を新しいデータと呼ぶか」を、データの分け方で決めた結果です。新しい組成、新しい成膜バッチ、新しい装置・新しい日のどれに当たることを知りたいのかで、分割の単位(グループ)を変える必要があります。新しい組成への当たりを知りたいのに、同じ組成の繰り返し測定がテストにも入っていれば、数字は過大になります(本記事による解説)。
前処理(標準化、特徴選択)を全データで先に行うのも、Kapoor らの漏れの型です[参考資料10]。前処理も、訓練データだけで学習して、テストには適用だけします。
(2) 外挿:新しい材料の探索は、たいてい外挿の問題
Meredig らは、「従来の機械学習の指標は、材料探索のモデル性能を過大評価する」と述べ、leave-one-cluster-out 交差検証(LOCO CV)(似た材料のまとまり(クラスタ)ごと取り除いて評価する方法)と、最近傍の単純なベンチマークを導入しました。材料探索での性能は、問題、データのとり方、外挿に強く依存する、としています事実[参考資料11]。 訓練データの範囲の外(新しい化学系、新しい組成領域)を探すのが目的なら、ランダム分割の数字は、目的に合った評価ではありません(本記事による解説)。
(3) 小さなデータ
Zhang と Ling は、材料データは他の分野より小さく、多様なことがあるとして、データ量と予測性能の関係を調べました。データ量の影響は、モデルの自由度(DoF)を介して現れ、精度と DoF の関連が現れるのは過少適合のサインだ、としています事実[参考資料14]。Dunn らの材料特性予測のベンチマーク Matbench は、312〜13.2万件の13課題からなり、結晶グラフに基づく手法が、従来の記述子に基づく手法を上回るのは、約104件以上のデータがあるときのようだ、と報告しています事実[参考資料12]。 データが少ないほど、モデルの違いより、データの質と、物理・化学の知識を特徴量に入れる工夫の寄与が大きくなる(本記事による解説)、と読めます。
(4) 近道学習と、同じ性能の別のモデル
Geirhosらは、形と質感が食い違う画像でCNNと人を比較し、ImageNetで学習したCNNに質感への偏りがあること、訓練画像を変えることで形に基づく表現へ変えられることを報告しています[参考資料15]。これは特定の画像・モデルによる実験結果で、すべてのモデルに共通する法則とは扱いません。素材画像でも、試料以外の背景などを手掛かりにしていないかを確かめる、というのが本記事の注意点です。D’Amourらの配備先での振る舞いの違いについては原著[参考資料16]を参照します。
第5章の図の点線は、測定ノイズの大きさです。どのモデルも、ここを大きく下回るずれは達成できません(訓練データでの誤差がこれを下回るのは、ノイズまで覚えている、つまり過学習の兆候です)。 同じ試料を繰り返し測ったときのばらつき(再現性)を先に知っておけば、「モデルが十分に良いのか」の目安になります(本記事による解説)。
また、通常のニューラルネットワークの出力は、1つの値(点推定)だけで、予測の信頼度を示しません。複数のモデルの平均を取るアンサンブルは、予測の不確かさを見積もる簡単な方法の一つとして報告されています事実[参考資料17]。材料探索で次に測る試料を決めるときは、予測値だけでなく、不確かさの見積もりが判断材料になります(本記事による解説)。
機械学習を材料の探索や、自動化した実験と組み合わせる話は、本シリーズ「マテリアルインフォマティクス」分野で扱います。この記事は、その土台になる基礎と、評価の落とし穴の整理にとどめています。
8. 計算資源との接点 ― パラメータ数とメモリ
小さなネットワークや、材料の特徴量を使う機械学習は、ノートパソコンで数秒〜数分で学習できることが多く、計算資源の制約は小さい、といえます(本記事による解説)。一方、パラメータが数十億を超えるモデルでは、メモリが最初の制約になります。
ZeRO の論文は、混合精度(半精度 fp16 で計算し、単精度 fp32 の複製を保持する)で Adam を使って学習するとき、パラメータ1つあたり、パラメータ(fp16)2バイト、勾配(fp16)2バイト、最適化の状態12バイト(fp32 のパラメータの複製、一次モーメント、二次モーメント)の計16バイトが必要だと説明しています事実[参考資料18]。パラメータ数 Ψ のモデルでは、16Ψ バイトです。ここから、モデルの大きさごとのメモリの下限を計算できます。
| パラメータ数 | パラメータ・勾配・最適化の状態の合計(16バイト/個) | 読み方 |
|---|---|---|
| 1億(108) | 1.6 GB | 1枚のGPUのメモリに十分収まる大きさ |
| 10億(109) | 16 GB | GPU 1枚のメモリを大きく占める |
| 70億(7×10⁹) | 112 GB | 単独の GPU のメモリを超える規模。複数枚に分けて持つ必要がある |
本稿の計算。16Ψ バイトは ZeRO 論文の混合精度・Adam の場合[参考資料18]。活性化(逆伝播のために保存する中間値)やバッチの大きさ、通信用の領域は含みません(実際の必要量はこれより大きくなります)。GPU のメモリ容量は製品・世代で異なるため、ここでは特定の製品の値を使っていません。
この制約は、HBM(広帯域メモリ)の積層、2.5D パッケージ(CoWoS など)、熱を逃がす界面材料への要求につながります。詳しくは、本シリーズ「HBM」編、「CoWoS」編、「熱界面材料TIM」編と、「AIアクセラレータ」編で扱っています。
9. 限界と、確認できなかったこと/まとめ
(1) 規格の本文
ISO/IEC 22989、23053、TS 4213、5259-1、5259-3、23894、42001 の本文は有料のため確認していません。本記事は、ISO のページで確認できた番号・題名・発行年月・段階の記載にとどめ、要求事項や定義を書いていません。
(2) 合成データの数値
第4〜7章の数値は、本稿が作った合成データの計算です。次数別の誤差、R² の差、混同行列の例は、仕組みを見せるためのもので、実際の材料データでの大きさを示すものではありません。
(3) 万能近似の条件
Hornik らの結果は、題名と一般的な理解にとどめました。活性化関数の条件や近似の意味などの細部は、原論文の本文を確認していません。
(4) 扱っていない手法
決定木・ランダムフォレスト・勾配ブースティング、サポートベクターマシン、ガウス過程回帰、畳み込み・再帰・グラフのニューラルネットワークは扱っていません。表形式の材料データでは、これらが使われることも多いと考えられますが、本稿では一次情報を確認していません。Transformer は本シリーズ「Transformerと大規模言語モデル」編で扱います。
(5) 強化学習の素材分野での実用
強化学習を素材・プロセス分野で実用した例は、本稿では確認していません。
- 機械学習は、データからパラメータを当てはめる手法です。ニューラルネットワークは、層を重ねた関数を、損失の勾配(誤差逆伝播で求める)で学習します事実
- 訓練データに当てはまることは、汎化の証拠になりません。ランダムなラベルにも当てはまります。合成データの例では、次数を上げるほど訓練誤差は下がり、テスト誤差は上がりました事実/本稿の計算
- 指標は目的で選びます。まれな欠陥の探索では、何もしないモデルの正解率(99%)が、有用なモデル(98.2%)を上回りえます本稿の計算
- 素材データは、系統だった試料群でできています。同じ系統が訓練と評価にまたがると、数字は過大になります(合成データでは R² 0.96 と −1.28)。新しい材料の探索は外挿で、小さなデータが多いことにも注意が要ります事実/本稿の計算
- 大きなモデルの最初の制約はメモリです。混合精度の Adam では1パラメータあたり16バイトの状態が要ります事実
10. 評価・標準の読み方
機械学習の性能は、評価用データ、データの分け方、指標、比較の基準(ベースライン)を決めて初めて数字になります。分類なら混同行列から求める指標、回帰なら誤差の指標で測り、研究用の共通ベンチマーク(ImageNet、Matbench など)で手法を比べます。 安全性や信頼性は、数字だけでは足りず、データの品質、リスク管理、組織の運用を定める標準・指針(ISO/IEC、NIST)が使われます。ここでは、確認できた範囲を表にします(確認日 2026年10月15日)。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 分類の性能 | 混同行列に基づく指標(正解率、適合率、再現率、F1)。本稿第6章本稿の計算 | ISO/IEC TS 4213:2022 "Information technology — Artificial intelligence — Assessment of machine learning classification performance"(2022年10月発行。ISO のページで「改訂される予定」の段階)[26]事実未確定/将来 | 不均衡なデータで正解率は誤解を招く。指標は見逃しと誤検出のコストで選ぶ |
| 汎化性能 | ホールドアウトと交差検証(scikit-learn ユーザーガイド)[22]。新しい評価データでの再測定(Recht ら、2019)[11]事実 | ISO/IEC 23053:2022 "Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML)"(2022年6月発行)[25]。評価手順の中身は未確認事実 | 評価用データの使い回しや、データの分け方で数字が変わる(第5・7章) |
| 画像分類の研究用ベンチマーク | ImageNet Large Scale Visual Recognition Challenge(1000カテゴリ。Russakovsky ら、2015)[12]。新評価データ(Recht ら)[11]事実 | 確認できなかった | 同じデータでの比較でも、評価データの作られ方・使われ方に条件づけられる |
| 材料特性の予測 | Matbench(13課題、312〜13.2万件。Dunn ら、2020)[15]。leave-one-cluster-out 交差検証と最近傍ベンチマーク(Meredig ら、2018)[14]事実 | 確認できなかった | ランダム分割は外挿の性能を過大に見せる。系統・クラスタ単位の分割で測る |
| 学習データの品質 | 確認できなかった(データセットの品質を測る共通ベンチマークは確認していない) | ISO/IEC 5259-1:2024(データ品質の概要・用語・例)、ISO/IEC 5259-3:2024(データ品質マネジメントの要求事項と指針)。ISO のページは、5259 を全5部のパッケージとして掲載[27・28]事実 | 本文は未確認。要求事項の中身は書いていない |
| 概念と用語 | —(評価ではなく用語の標準) | ISO/IEC 22989:2022 "Artificial intelligence concepts and terminology"(2022年7月発行)[24]事実 | 用語の定義は、資料(教科書、規格)で細部が異なりうる |
| リスク管理・運用 | — | ISO/IEC 23894:2023(AI のリスク管理の指針)[29]、ISO/IEC 42001:2023(AI のマネジメントシステム)[30]。NIST AI RMF 1.0(NIST AI 100-1、2023年1月。自主的な利用を前提)[31]事実 | NIST AI RMF の後継版は、確認日時点で確認できなかった。ISO/IEC 42001 の要求事項は未確認 |
| 再現性・データ漏れの点検 | model info sheets(Kapoor と Narayanan、2023)。漏れの8つの型ごとに、分割・前処理・重複などの説明を求める[13]事実 | 確認できなかった | 論文を読むだけでは見つけられない漏れがある。報告には分割の単位と前処理の手順を書く |
表の整理は本稿の計算(整理)。ISO/IEC の番号・題名・発行年月・段階は ISO の公式ページで確認(確認日 2026年10月15日)。規格本文は有料のため、適用範囲の記載にとどめています。
読み方の注意(素材技術者向け)
- 数字は、設定と実施主体で変わります:R² や正解率は、データの分割の単位、前処理の順序、評価の実施者(開発者か、第三者か)で変わります。同じ指標名でも、設定が違う数字を並べて優劣をつけないでください
- 評価用データは、使い回すと劣化します:同じ評価用データを長く使うと、その評価用データへの適応や、「評価用データの作られ方」に特有の癖を拾った数字になりえます[参考資料8・15]
- 標準・指針は、多くが任意の採用です:ISO/IEC の規格は、一般に、法令や契約で引用されて初めて拘束力を持つ位置づけで、NIST AI RMF は自主的な利用を前提にしています[参考資料28](ISO/IEC の位置づけは本記事による解説)。「規格に準拠」という表現は、どの規格のどの要求事項かを確認してください
- 宣言値と実測値は別です:論文やカタログの精度は、条件つきの実験の値です。自社のデータで、自社の分割で測り直す価値があります
11. 用語集
- 教師あり学習
- 入力と正解の組から、入力を出力にうつす関数を学ぶ。
- 教師なし学習
- 正解のないデータから、まとまりや少数の軸を見つける。
- 強化学習
- 環境とのやりとりで、累積の報酬が大きくなる行動の方針を学ぶ。
- 損失関数
- 予測と正解のずれを1つの数にしたもの。学習はこれを小さくする。
- 勾配降下法/SGD
- 損失が小さくなる向きにパラメータを動かす方法。SGDはミニバッチで勾配を見積もる。
- Adam
- 勾配の一次・二次モーメントでパラメータごとに歩幅を調整する最適化手法。
- 誤差逆伝播
- 連鎖律で、損失の勾配を出力側から順に求める手順。
- 活性化関数
- 層の出力に非線形性を与える関数(tanh、ReLU など)。
- 過学習/過少適合
- 訓練データのノイズまで当てはめる/傾向も表せない状態。
- 汎化
- まだ見ていないデータで当たること。
- 正則化
- 複雑さに罰則を課すなどして、過学習を抑える工夫。
- 交差検証
- データを何通りかに分けて、訓練と評価を繰り返し平均する方法。
- データ漏れ(leakage)
- 評価に使うべき情報が、訓練に入り込むこと。評価が過大になる。
- 適合率/再現率
- 陽性と判定したうちの正しい割合/実際の陽性のうち見つけた割合。
- LOCO CV
- 似たもののまとまり(クラスタ)ごと取り除いて評価する交差検証。外挿の評価に使う。
- ハイパーパラメータ
- 学習率や層の数など、学習の前に人が決める設定。
- 二重降下
- モデルの複雑さを増すと、いったん悪化した性能が再び良くなる現象。
- 近道学習
- 標準のテストでは良いが、現実の条件には移らない判断規則を使うこと。
12. 参考資料(一次情報)
- Rumelhart D. E., Hinton G. E., Williams R. J. "Learning representations by back-propagating errors", Nature 323, 533–536 (1986), DOI 10.1038/323533a0 — nature.com/articles/323533a0
- Kingma D. P., Ba J. "Adam: A Method for Stochastic Optimization", arXiv:1412.6980(ICLR 2015) — arxiv.org/abs/1412.6980
- Hornik K., Stinchcombe M., White H. "Multilayer feedforward networks are universal approximators", Neural Networks 2, 359–366 (1989), DOI 10.1016/0893-6080(89)90020-8 — doi.org/10.1016/0893-6080(89)90020-8
- Srivastava N. ほか "Dropout: A Simple Way to Prevent Neural Networks from Overfitting", J. Mach. Learn. Res. 15, 1929–1958 (2014) — jmlr.org/papers/v15/srivastava14a.html
- Zhang C. ほか "Understanding deep learning requires rethinking generalization", arXiv:1611.03530(ICLR 2017) — arxiv.org/abs/1611.03530
- Belkin M. ほか "Reconciling modern machine-learning practice and the classical bias–variance trade-off", Proc. Natl. Acad. Sci. USA 116, 15849–15854 (2019), DOI 10.1073/pnas.1903070116 — doi.org/10.1073/pnas.1903070116
- Nakkiran P. ほか "Deep Double Descent: Where Bigger Models and More Data Hurt", arXiv:1912.02292 — arxiv.org/abs/1912.02292
- Recht B. ほか "Do ImageNet Classifiers Generalize to ImageNet?", arXiv:1902.10811(ICML 2019) — arxiv.org/abs/1902.10811
- Russakovsky O. ほか "ImageNet Large Scale Visual Recognition Challenge", Int. J. Comput. Vis. 115, 211–252 (2015), DOI 10.1007/s11263-015-0816-y — doi.org/10.1007/s11263-015-0816-y
- Kapoor S., Narayanan A. "Leakage and the reproducibility crisis in machine-learning-based science", Patterns 4, 100804 (2023), DOI 10.1016/j.patter.2023.100804(オープンアクセス) — doi.org/10.1016/j.patter.2023.100804
- Meredig B. ほか "Can machine learning identify the next high-temperature superconductor? Examining extrapolation performance for materials discovery", Mol. Syst. Des. Eng. 3, 819–825 (2018), DOI 10.1039/C8ME00012C — doi.org/10.1039/C8ME00012C
- Dunn A. ほか "Benchmarking materials property prediction methods: the Matbench test set and Automatminer reference algorithm", npj Comput. Mater. 6, 138 (2020), DOI 10.1038/s41524-020-00406-3(オープンアクセス) — doi.org/10.1038/s41524-020-00406-3
- Roberts D. R. ほか "Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure", Ecography 40, 913–929 (2017), DOI 10.1111/ecog.02881 — doi.org/10.1111/ecog.02881
- Zhang Y., Ling C. "A strategy to apply machine learning to small datasets in materials science", npj Comput. Mater. 4, 25 (2018), DOI 10.1038/s41524-018-0081-z(オープンアクセス) — doi.org/10.1038/s41524-018-0081-z
- Geirhos R. et al. "ImageNet-trained CNNs are biased towards texture; increasing shape bias improves accuracy and robustness", ICLR 2019, arXiv:1811.12231 — https://arxiv.org/abs/1811.12231
- D'Amour A. ほか "Underspecification Presents Challenges for Credibility in Modern Machine Learning", arXiv:2011.03395 — arxiv.org/abs/2011.03395
- Lakshminarayanan B., Pritzel A., Blundell C. "Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles", arXiv:1612.01474(NeurIPS 2017) — arxiv.org/abs/1612.01474
- Rajbhandari S. ほか "ZeRO: Memory Optimizations Toward Training Trillion Parameter Models", arXiv:1910.02054(SC20) — arxiv.org/abs/1910.02054
- scikit-learn User Guide "Cross-validation: evaluating estimator performance" — scikit-learn.org/stable/modules/cross_validation.html
- scikit-learn API "GroupKFold" — scikit-learn.org/…/sklearn.model_selection.GroupKFold.html
- ISO/IEC "ISO/IEC 22989:2022 Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(ISO のページ) — iso.org/standard/74296.html
- ISO/IEC "ISO/IEC 23053:2022 Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML)"(ISO のページ) — iso.org/standard/74438.html
- ISO/IEC "ISO/IEC TS 4213:2022 Information technology — Artificial intelligence — Assessment of machine learning classification performance"(ISO のページ) — iso.org/standard/79799.html
- ISO/IEC "ISO/IEC 5259-1:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 1: Overview, terminology, and examples"(ISO のページ) — iso.org/standard/81088.html
- ISO/IEC "ISO/IEC 5259-3:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 3: Data quality management requirements and guidelines"(ISO のページ) — iso.org/standard/81092.html
- ISO/IEC "ISO/IEC 23894:2023 AI — Guidance on risk management"(ISO のページ) — iso.org/standard/77304.html
- ISO/IEC "ISO/IEC 42001:2023 AI management systems"(ISO のページ) — iso.org/standard/81230.html
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1, 2023年1月, DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 逆伝播を、結合の重みを繰り返し調整して出力と望ましい出力の差の尺度を最小にする手順として報告したこと。隠れ素子が課題の特徴を表すようになること(Rumelhart ら、1986) | Nature の論文ページ(要旨) 出典1 https://www.nature.com/articles/323533a0 | 事実 |
| Adam の既定値(α=0.001、β₁=0.9、β₂=0.999、ε=10⁻⁸)が、試した問題での良い既定値として示されていること | Kingma と Ba(Algorithm 1 の注記) 出典2 https://arxiv.org/abs/1412.6980 | 事実 |
| 多層の順伝播型ネットワークが関数の万能近似器であるという結果(題名)。条件の細部は未確認 | Hornik ら(1989)の題名・書誌 出典3 https://doi.org/10.1016/0893-6080(89)90020-8 | 事実 |
| ドロップアウトが、ニューラルネットワークの過学習を防ぐ簡単な方法として提案されたこと | Srivastava ら(2014)の題名 出典4 https://jmlr.org/papers/v15/srivastava14a.html | 事実 |
| ネットワークがランダムなラベルにも容易に当てはまること | Zhang ら(2017) 出典5 https://arxiv.org/abs/1611.03530 | 事実 |
| 二重降下の曲線が、古典的な U 字を包含すること。モデルの大きさ・エポック数での二重降下と、訓練データを増やすと悪化する領域 | Belkin ら(2019)、Nakkiran ら 出典6 https://doi.org/10.1073/pnas.1903070116 出典7 https://arxiv.org/abs/1912.02292 | 事実 |
| 新しい評価データで、CIFAR-10 は3〜15%、ImageNet は11〜14%精度が下がったこと。元の精度の向上は新しいデータでの、より大きな向上に対応すること。原因は評価データへの適応ではなく、やや難しい画像への一般化の力の不足とした著者の結論 | Recht ら(2019)の要旨・序論 出典8 https://arxiv.org/abs/1902.10811 | 事実 |
| ILSVRC が、数百の物体カテゴリと数百万枚の画像のベンチマークで、2010年から毎年実施され、50を超える機関が参加したこと。1000カテゴリ | Russakovsky ら(2015) 出典9 https://doi.org/10.1007/s11263-015-0816-y | 事実 |
| データ漏れが17分野・少なくとも294本の論文に影響したこと、漏れの8つの型、model info sheets | Kapoor と Narayanan(2023) 出典10 https://doi.org/10.1016/j.patter.2023.100804 | 事実 |
| 従来の機械学習の指標が材料探索の性能を過大評価すること、LOCO CV と最近傍ベンチマークの導入、性能が問題・データのとり方・外挿に依存すること | Meredig ら(2018)の要旨 出典11 https://doi.org/10.1039/C8ME00012C | 事実 |
| Matbench が13課題(312〜13.2万件、10の情報源)で、結晶グラフ手法が約10⁴件以上のデータで従来手法を上回るように見えること | Dunn ら(2020)の要旨 出典12 https://doi.org/10.1038/s41524-020-00406-3 | 事実 |
| 構造をもつデータで、ランダムな交差検証が予測誤差を過小評価し、ブロック交差検証が対処になること | Roberts ら(2017)の要旨 出典13 https://doi.org/10.1111/ecog.02881 | 事実 |
| 小さな材料データで、データ量の影響がモデルの自由度を介して現れ、精度と自由度の関連が過少適合のサインであること | Zhang と Ling(2018)の要旨 出典14 https://doi.org/10.1038/s41524-018-0081-z | 事実 |
| 形と質感の食い違う画像による実験でのCNNの質感への偏りと、訓練画像変更の効果。対象を限定した結果。 | Geirhos et al., ICLR 2019 出典15 https://arxiv.org/abs/1811.12231 | 原著研究 |
| 訓練領域での性能が同等とみなされるモデルが、運用領域では大きく違う振る舞いをすること(過少決定) | D'Amour ら 出典16 https://arxiv.org/abs/2011.03395 | 事実 |
| アンサンブルが、予測の不確かさを見積もる簡単で拡張しやすい方法として提案されたこと | Lakshminarayanan ら(要旨) 出典17 https://arxiv.org/abs/1612.01474 | 事実 |
| 混合精度の Adam で、パラメータ2バイト・勾配2バイト・最適化の状態12バイトの計16Ψ バイトが要ること | ZeRO 論文(第3章の説明) 出典18 https://arxiv.org/abs/1910.02054 | 事実 |
| テスト用データを取り分ける一般的な手順の説明、GroupKFold が同じグループを訓練と評価にまたがせない分割であること | scikit-learn のドキュメント 出典19 https://scikit-learn.org/stable/modules/cross_validation.html 出典20 https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GroupKFold.html | 事実 |
| ISO/IEC 22989:2022(2022年7月)、23053:2022(2022年6月)、TS 4213:2022(2022年10月、改訂予定の段階)の番号・題名・発行年月 | ISO のページ 出典21 https://www.iso.org/standard/74296.html 出典22 https://www.iso.org/standard/74438.html 出典23 https://www.iso.org/standard/79799.html | 事実 |
| ISO/IEC 5259-1:2024、5259-3:2024(いずれも2024年7月)、23894:2023(2023年2月)、42001:2023(2023年12月)の番号・題名・発行年月 | ISO のページ 出典24 https://www.iso.org/standard/81088.html 出典25 https://www.iso.org/standard/81092.html 出典26 https://www.iso.org/standard/77304.html 出典27 https://www.iso.org/standard/81230.html | 事実 |
| NIST AI RMF 1.0(NIST AI 100-1、2023年1月)が自主的な利用を前提とし、見直しは遅くとも2028年までに行う予定とされていること | NIST AI 100-1 の本文 出典28 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| 訓練誤差・テスト誤差の表(多項式の次数1〜14)、逆伝播の数値例、正解率99%と98.2%の比較、R² 0.96 と −1.28、パラメータ101,770個、メモリの表(1.6 GB、16 GB、112 GB) | 本稿の計算(Python・NumPy。合成データ、乱数の種を固定。ZeRO の16Ψ バイトに基づく)。実在のデータの結果ではない | 本稿の計算 |
| ISO/IEC 規格の本文(要求事項、定義、評価手順)、Hornik らの定理の条件、強化学習の素材分野での実用、決定木系など他の手法、NIST AI RMF の後継版 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「逆伝播は途中の値を覚えておく」「何を新しいと呼ぶかは分割の単位で決まる」「測定のばらつきが予測の限界を決める」「ISO/IEC 規格は多くが任意の採用」という読み取りと、素材分野での使い方の例 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2・図3・図4・図5が実データの観察ではなく説明のための作図であること。図1と図6がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(査読論文、arXiv の論文、ISO・NIST の公式ページ)に限定しています。ISO/IEC 規格の本文は有料のため確認できていません。 数値例は本稿が作った合成データの計算で、実在の材料データの結果ではありません。 ISO/IEC 規格の本文、万能近似定理の条件の細部、強化学習の素材分野での実用、決定木系などの他の手法については、確認できなかったため記載していません。 図はすべて説明用の概念図または本稿の計算を含む作図で、図1と図6はImageGen生成の概念画像です。