TECHNOLOGY EXPLAINER
生成AIによる材料設計
― 「新材料○万種を発見」は、何を数えた数字なのか
画像を作るAIの技術が、結晶や分子を「作る」ことにも使われ始めました。望む性質を指定して、それらしい材料の候補を直接つくる、という期待です。Microsoft の MatterGen や、Google DeepMind の GNoME が、よく知られています。この記事では、拡散モデルなどが結晶を作る仕組み、生成された結晶の評価の仕方、そして、「新材料○万種」が何を数えた数字かを整理します。計算上の予測と、実験で確かめた件数を区別し、批判や再評価があるもの(A-Lab、MatterGen の合成例)は、論文・訂正・査読つき論文で確認できる範囲で、両方を中立に並べます。
- 3行でわかる/読む前に/シリーズの中での位置
- 「生成」とは:探すのでなく、作る
- 拡散モデルで結晶を作る仕組みと、主な生成モデル
- 生成された結晶を、どう評価するか
- MatterGen の例:生成から合成まで
- GNoME の例:「220万」「38.1万」「736」は、何を数えたか
- 批判と再評価:両方を並べる
- 素材技術者から見て
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・目標・草案・改訂中・策定中・見通しなど、確定していない事項
このほか、素材技術者向けの読み取りは「解説」として区別しています。推測は太字で示します。企業・研究グループの発表は「著者らの主張・報告」と明記します。
1. 3行でわかる/読む前に/シリーズの中での位置
- 生成モデルは、既知の材料のデータから分布を学び、新しい候補を作ります。MatterGen の論文は、拡散モデルで、従来の生成モデルより、新規で安定な構造を作る割合が2倍以上だと述べます。実験で合成して確かめたのは、4つの候補のうち1つで、合成されたのは、組成が乱れた TaCr₂O₆ でした事実[[zeni2025]]
- 「新材料○万種を発見」は、計算上の予測の件数です。GNoME は、DFT で、既存のデータに対して安定と出た結晶を220万、更新した凸包の上の新発見を38.1万と報告します。実験で確かめた件数は別で、ICSD の実験構造と一致したのは736です事実[[merchant2023,gnome_pmc]]
- 批判・再評価があります。A-Lab(GNoME などの候補を自動で合成した研究)は、2026年1月の著者訂正で、「新規」の意味と件数が改められました。MatterGen の合成例についても、査読つきの論文が「新規ではない」と主張しています。本稿は、両方を並べ、勝ち負けは判定しません事実[[szymanski_corr,juelsholt2026]]
前提は、材料の「安定」の指標(エネルギー凸包の上の高さ、E_hull)と、「安定」と「合成できる」の違いです(本シリーズ「結晶構造予測と安定性」編)。機械学習は「過去のデータから傾向を学ぶ近似器」で、データの範囲の外(外挿)は苦手です。この記事は単独でも読めるよう書いています。
共通の考え方:材料探索は広大な地図の中から宝のありかを探す作業で、計算は「安く速く候補を出す」、実験は「本当にそうか確かめる」、AIは「探す場所を絞る」という分担です。順問題は「材料→特性」を予測すること、逆問題は「望む特性→材料」を提案することです。生成モデルは、逆問題への挑戦です。
「結晶構造予測と安定性」編と「機械学習原子間ポテンシャル」編の次に読むのがおすすめです。生成された候補を実験で確かめる流れは「自律実験室」編と「クローズドループ最適化」編、結果の評価は「MIの結果の評価と再現性の読み方」編が続きます。
2. 「生成」とは:探すのでなく、作る
これまでの探索は、すでにある候補の中から、よいものを選ぶ方法(スクリーニング)でした。MatterGen の論文は、スクリーニングは、既知の材料の数に限られ、これまでで最大の、未知の結晶の探索でも、10⁶〜10⁷個の規模で、潜在的に安定な無機化合物の、ごく一部にすぎない、と述べます。たとえば、組成の組合せだけを考えても、四元系の化合物は約10¹⁰ 個あるとされます(Davies ら、2016)事実[[zeni2025,mattergen_arxiv,davies2016]]。
生成モデルは、既知の材料のデータから「らしさ」の分布を学び、そこから、新しい候補を直接作るものです。さらに、望む性質(たとえば、体積弾性率)を指定して、それに合うものを作ることもできます(これを逆設計といいます)。Gómez-Bombarelli ら(2018)は、分子を連続な数のベクトルに変換し、そのベクトルを操作して、新しい分子を作る方法を示しました(変分オートエンコーダ)事実[[gomez2018]]。結晶では、同じ発想が、拡散モデルや、言語モデルで試されています。
不正確です。生成モデルが作るのは、学習データに似た、候補の構造です。それが、安定か、作れるか、狙いの性質をもつかは、DFT などの計算と、合成・測定の実験で確かめる必要があります。MatterGen の論文も、生成した構造の評価に DFT を使い、合成は「概念実証」としての1例にとどめています[[zeni2025]]。AIが絞るのは「探す場所」で、確かめるのは人と実験です(本記事による解説)。
3. 拡散モデルで結晶を作る仕組みと、主な生成モデル
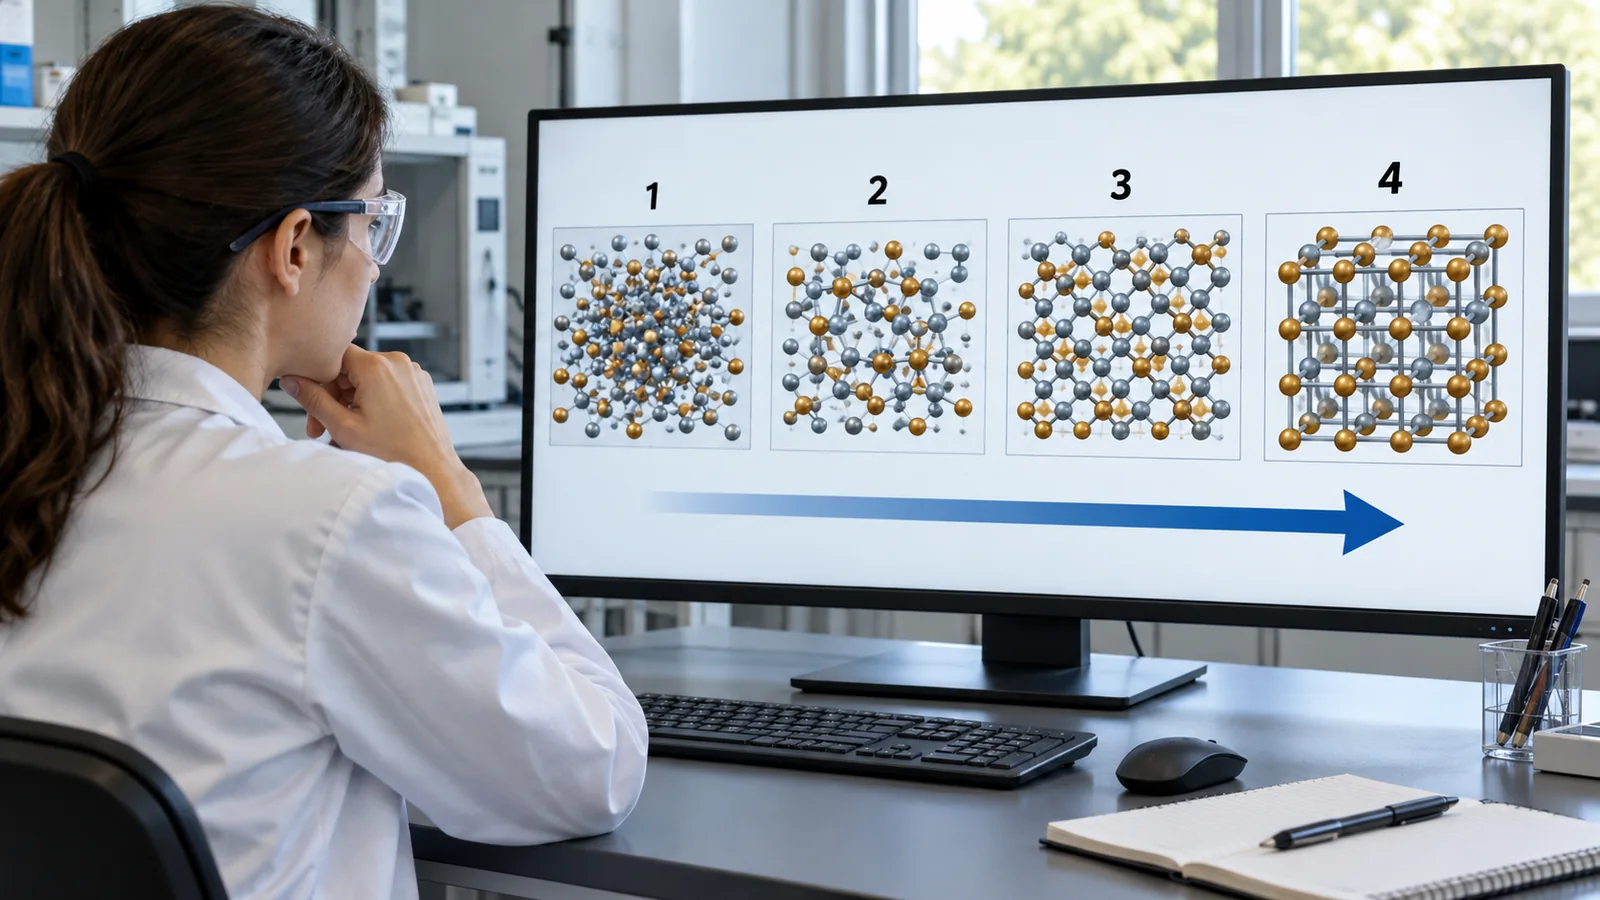
結晶の生成で、いま広く使われるのが拡散モデルです。画像生成で知られる方法(Ho ら、2020)事実[[ho2020]]を、結晶に合わせたものです。考え方は、壊して、その逆をたどることです。
元のSVG・数値・出典を確認する
元SVGの説明:概念図(ベクター作図)。拡散モデルの考え方。結晶(①)の原子の位置にノイズを足していくと、②→③→④と壊れ、最後はほぼ乱数になる。生成は、これを逆にたどる。上の4枚は、本稿の計算で作った、2次元の簡単な例。
- 壊す(順方向):結晶の原子の位置に、ノイズを少しずつ足し、最後には乱数にします。結晶は、周期的に繰り返す構造なので、座標は周期境界で折り返します。元素は「不明」に置き換えます
- 作る(逆方向):学習したネットワークが、「ノイズを少し取り除く向き」を示し、乱数から出発して、少しずつ結晶へ近づけます
- MatterGen の工夫:原子の種類、座標、周期的な格子の3つを、それぞれに合ったノイズで壊し、逆にたどります。ネットワークは、回転・平行移動で結果が正しく変わる(等変)ように作られ、対称性をデータから学ばなくてよいようにしています。アダプター(既存のモデルに差し込む調整用の部品)で、組成・対称性・物性を指定して作れるようにし、分類器なしの誘導で、狙いの方向へ導きます。学習には、Materials Project と Alexandria から作った、20原子以下の安定な構造 607,683 件(Alex-MP-20)を使っています事実[[zeni2025]]
| 方式(例) | 考え方 | 論文の記述(著者らの報告) | 読み方の注意 |
|---|---|---|---|
| 変分オートエンコーダ系(CDVAE、Xie ら) | 結晶を潜在ベクトルに圧縮し、拡散の過程で、原子の位置をエネルギーの低い方へ動かして作る | 入力構造の再構成、妥当で多様な材料の生成、特定の性質を最適化する材料の生成の3つの課題で、過去の方法を上回ると述べる[[xie2022]]事実 | 結晶の周期性・対称性を明示的に扱う。評価は、論文の設定の範囲 |
| 拡散モデル(DiffCSP、Jiao ら) | 格子と原子の座標を、周期的な等変のネットワークで同時に生成。分数座標を使う | 結晶構造予測(組成が与えられる問題)で、既存の方法を大きく上回り、DFT を使う方法より計算コストがずっと低いと述べる[[jiao2023]]事実 | 組成を与えて構造を作る課題。組成も生成する設定にも拡張 |
| 拡散モデル(MatterGen) | 原子の種類・座標・格子を同時に生成。アダプターで条件づけ | 従来の生成モデルより、新規で安定な構造の割合が2倍以上、局所エネルギー最小に10倍以上近いと述べる[[zeni2025]]事実 | 20原子以下の無機結晶が対象(モデルカードの範囲外の用途に、20原子超・有機結晶・非晶質)[[mattergen_hf]] |
| 言語モデル(Gruver ら) | 結晶をテキストとして表し、大規模言語モデルを微調整して生成 | 最大のモデル(LLaMA-2 70B を微調整)は、準安定と予測される材料を、CDVAE の約2倍の割合(49% 対 28%)で生成すると述べる[[gruver2024]]事実 | 評価には、学習した MLIP と DFT のエネルギーを使う。モデルの優劣は、条件が違うため断定しない |
| 分子(Gómez-Bombarelli ら) | 分子を連続なベクトルに変換して、操作し、元に戻す | 薬のような分子と、重原子9個未満の分子で実証[[gomez2018]]事実 | 結晶ではなく分子。本稿は考え方の例として紹介 |
各モデルの数値は、データ、評価の設定、基準が違うため、横に並べて優劣を決められません。CDVAE・DiffCSP・Gruver らは、arXiv の論文(会議論文)の記述で、出版版との差は確認していません。
4. 生成された結晶を、どう評価するか
生成された構造は、「それらしく見える」だけでは足りません。MatterGen の論文は、安定・独自・新規(SUN)という基準で評価しています。
- 安定の基準が、緩い:MatterGen の論文の「安定」は、DFT で緩和したエネルギーが、基準データの凸包の上 0.1 eV/原子 以内です。1,024個を DFT で調べると、MP の凸包に対して78%が 0.1 eV/原子 以内で、0 以下は13%。Alex-MP-ICSD の凸包に対しては、75%が以内で、0 以下は3%でした事実[[zeni2025]]。本シリーズ「結晶構造予測と安定性」編のとおり、観測されている結晶でも、凸包の上の高さの中央値は 15 meV/原子、90パーセンタイルは 67 meV/原子ですから、0.1 eV(100 meV)は、緩めの基準です[[sun2016]](本記事による解説)
- 局所最小への近さ:生成した構造の95%は、DFT で緩和した構造とのずれ(RMSD)が 0.076 Å 未満でした事実[[zeni2025]]
- 独自性と新規性:独自な構造の割合は、1,000個で100%、1,000万個で52%に下がります。新規な構造の割合は61%です。MatterGen は、学習に使っていない、実験で確かめられた ICSD の構造を、2,000件超、再発見したとも報告しています事実[[zeni2025]]
- 従来の生成モデルとの比較:同じ小さなデータで学習した MatterGen-MP は、CDVAE・DiffCSP より、SUN の構造が60%多く、緩和後のずれは50%小さい。データを大きくした MatterGen は、さらに SUN が70%増え、ずれは5分の1になった、と述べます事実[[zeni2025]]
- 探索の効率:論文は、五元系で、MatterGen は約1万の生成で良い成績に達したのに対し、置換は約7万、ランダム構造探索(RSS)は約60万だったと述べます。ただし、三元・四元系では、置換が同等かより効率的だと、同じ論文が述べています事実[[zeni2025]]
- 物性を指定した設計:体積弾性率 400 GPa を狙うとき、DFT での物性計算を180回の予算で、MatterGen は SUN の構造を106個(95の組成)、既存のデータからのスクリーニングは40個(28の組成)見つけたと述べます。この物性は、DFT での計算値です事実[[zeni2025]]
「新規」は、どの基準データと照合したかで決まります。MatterGen の論文では、「新規」は、乱れのある ICSD の 117,652 構造を加えた基準データのどれとも一致しないこと、という定義です[[zeni2025]]。基準データに入っていない既知の材料は、「新規」と判定されます。A-Lab の著者訂正も、「新規」は「予測の基盤に対して新しい」という意図で、科学にとって新しいとは限らない、と述べました[[szymanski_corr]]。「新規」と書かれていたら、何と照合したかを確認してください(本記事による解説)。
評価の枠組みも、整い始めています。LeMat-GenBench(プレプリント、2025年12月)は、結晶の生成モデル12個を、統一した指標で評価し、安定性が上がると、新規性と多様性が平均して下がり、すべての面で優れるモデルはなかったと報告しています事実[[lemat]]。また、MatterGen の公式リポジトリは、付属の評価コードが MatterSim を使うため、論文の DFT での評価と結果が違いうるので、DFT で確認するよう勧めています[[mattergen_gh]]。
5. MatterGen の例:生成から合成まで
MatterGen の論文は、「概念実証」として、生成した材料を実際に合成し、性質を測っています。数を追ってみましょう。
- 生成と絞り込み:体積弾性率の4つの目標(50・100・150・200 GPa)ごとに、8,192個を生成し、新規性・独自性、MatterSim と DFT での安定性、MatterSim でのフォノンの安定性、酸素を含むことで絞り、75個に。そこから、専門家が見て4つを選び、合成を試しました。合成できたのは、4つのうち1つでした事実[[zeni2025]]
- 合成された物質:Rietveld 解析(X線回折のデータから結晶構造を精密化する方法)によると、合成された物質は TaCr₂O₆ で、MatterGen が予測した規則的な構造の、組成が乱れた版でした。目標 200 GPa に対し、規則的な構造の DFT の値は 222 GPa、実験値は、ナノインデンテーションのヤング率から換算して、4回の測定の最大で 169 GPa(158±11 GPa)でした。粉末の試料は密でない可能性があり、最大値を最良の推定としています事実[[zeni2025]]
- 本稿の読み取り:200 に対し 169 は、約15.5%低い値です本稿の計算。論文は「目標の20%以内」と述べます。合成された物質が、予測された規則的な構造そのものではなく、乱れた版だったことは、第7章の議論の中心になります
6. GNoME の例:「220万」「38.1万」「736」は、何を数えたか
Merchant ら(2023)の GNoME は、大規模に学習したグラフニューラルネットワークで、安定な結晶を探索しました。報告された数字を、何を数えているかに分けて読みます。
- 220万:GNoME のモデルが、Materials Project に対して安定(凸包の下)と見つけた結晶構造の数です。計算(DFT)の結果です事実[[merchant2023,gnome_pmc]]
- 38.1万:そのうち、更新した凸包の上にある「新たに発見された」安定な材料の数です。以前の約4.8万の安定な結晶に積み上がり、安定な結晶は合計で約42.1万です。計算の結果です事実[[gnome_pmc]]
- 736:ICSD に集められた実験構造のうち、GNoME が(先に)出した構造と一致したものの数です。GNoME の候補は2021年3月時点のデータにもとづき、その後、研究者が実験で作った結晶が、答え合わせになりました。実験で報告された構造との照合で、これが、実験にかかわる数です事実[[gnome_pmc]]
- 予測の精度:最終モデルは、エネルギーを 11 meV/原子 の精度で予測し、安定な構造の的中率(hit rate)が、構造つきで80%超、組成だけで100回の試行あたり33%と、以前の研究の1%から改善したと、著者らは述べます事実[[gnome_pmc]]
- 論文自身が述べる注意:GNoME の材料は、将来の発見で凸包から外れうること。GNoME は、MP と OQMD の「安定」だった 5,000 以上の材料を、凸包から押し出していること事実[[gnome_pmc]]。「安定」は、その時点のデータに対する相対的な判定です
- データの扱い:GNoME のデータは、CC BY-NC 4.0(非営利)で、コードは Apache-2.0 です。理論モデリング用で、注意して使うよう、公式の注意書きがあります事実[[gnome_gh]]。商用利用の可否は、条文で確認してください(本稿は法的助言ではありません)
違います。38.1万は、DFT の計算で、更新した凸包の上と出た構造の数です。実験にかかわる、独立の確認(ICSD の実験構造との一致)は736で、桁がまったく違います。しかも、736は、38.1万の一部とは限らず、GNoME が出した構造の、より広い集合との照合です(論文の記述の範囲)。数えているものが違う数字を、割り算して「成功率」にしてはいけません(本記事による解説)。
7. 批判と再評価:両方を並べる
この分野は、主張と、その後の検証が、同じ速さで進んでいます。本章は、論文・訂正・査読つき論文で確認できる範囲を、中立に並べます。誰が正しいかの判定は、していません。
A-Lab と GNoME の候補
- 主張:Szymanski ら(2023)は、GNoME と Materials Project の計算データで選んだ目標を、自動の実験室 A-Lab で、17日間連続で合成し、58の目標のうち41の新規化合物を合成したと報告しました事実[[szymanski2023]]
- 批判(Leeman ら、2024):43の生成物を検討し、解析の4つの共通の見落としを指摘して、その研究では、新規の材料は発見されていないと結論づけました。理由は、元素が同じ結晶の位置を分け合う「乱れ」を、予測が無視しがちで、成功とされた物質の3分の2は、予測された規則的な化合物の、既知の乱れた版である可能性が高い、というものです。また、粉末X線回折の自動の Rietveld 解析は、まだ信頼できないとも述べます事実[[leeman2024]]
- 著者訂正(2026年1月19日):Nature に、著者訂正が掲載されました。訂正は、「新規」の主張は誤解されうるもので、その意図は、材料が予測の基盤にとって新しい、ということで、科学にとって新しいとは限らないと述べます。さらに、回折パターンを手作業で再解析し、報告された40の成功のうち36で、予測の基盤が正しい結論に達したこと、4つは、X線回折だけでは判定できないこと(成功の数から除外)、学習データに誤って含まれていた1つの化合物を議論から外したことを述べます。この再解析は、公開後に査読されたとされます。現在の要旨は、57の目標のうち36の化合物と改められています事実[[szymanski_corr,szymanski2023]]
- 展望論文:Cheetham と Seshadri(2024)は、GNoME の論文について、題名で問いを立てる展望論文を書いています(「人工知能は、材料発見を推進しているか?」)。本文は確認できなかったので、内容には踏み込みません[[cheetham2024]]
MatterGen の合成例
- 主張:第5章のとおり、合成された物質は、組成が乱れた TaCr₂O₆(Ta₁/₃Cr₂/₃O₂ に相当)で、MatterGen が予測した規則的な構造の、乱れた版でした。論文はこれを、「概念実証」として示しています事実[[zeni2025]]
- 批判(Juelsholt、2026):査読つきの論文(Materials Horizons)で、結晶学的な解析から、これは新規の化合物ではなく、1971年に報告された Ta₁/₂Cr₁/₂O₂ と同一で、MatterGen の学習データに含まれていたと主張しています。乱れた既知の相を、新しい規則的な化合物と誤認することが、これらの道具の持続する課題で、人による厳密な検証が必要だと述べます事実[[juelsholt2026]]
- 応答:MatterGen の著者らの、この主張への応答は、本稿の確認範囲では見つかりませんでした。ただし、MatterGen の論文自身が、合成された物質が乱れた版であることを明記しています[[zeni2025]]
- 両方が一致している点:①乱れ(元素が席を分け合うこと)の扱いが、予測の課題であること。MatterGen の論文(arXiv 版の付録)も、乱れた材料には、同じ組成を表す規則的な近似が複数あり、新規性や凸包の上の高さが正しく評価されない場合がある、と認めています事実[[mattergen_arxiv]]。②人による結晶学的な検証が要ること。③合成の確認は、回折データの解析に依存すること(A-Lab の訂正は、判定できない4つを除外)
- 意見が分かれている点:その研究が「新材料を発見した」と言えるか(Leeman ら:言えない。A-Lab の訂正:「新規」は予測の基盤にとって、という意図)。MatterGen の合成例が「新規」か(Juelsholt:既知で、学習データに含まれる。MatterGen の論文:概念実証)。「新規」の定義が違うことが、食い違いの一因と考えられます(推測)
結晶の中で、ある席に、2つ以上の元素が、ランダムに入ることを乱れ(無秩序、固溶)といいます。計算で作る構造は、ふつう、席ごとに元素が決まった「規則配列」です。しかし、現実の試料は、乱れていることがあり、その場合、回折の結果から決まる対称性が高くなり、「既知の合金や固溶体」になりえます。計算の「新しい規則配列」が、実験では「既知の乱れた物質」だった、ということが起こりえます(Leeman ら、Juelsholt の指摘)。
8. 素材技術者から見て
生成された候補は、実験で試す候補を増やす道具です。MatterGen の合成では、8,192×4 の生成から、フィルタで75、専門家の目で4、合成成功が1でした[[zeni2025]]。この「専門家の目」を、自社に置き換えると、原料と装置、競合する相、毒性・供給のリスク、コストで、候補を絞る工程です。結晶学の専門家(X線回折を読める人)を、判定に入れることが、とくに大切です(本記事による解説)。
合成して、X線回折で、「予測した構造と一致した」とする前に、乱れた版(席を分け合う、より対称性の高い構造)や、既知の合金・固溶体ではないかを、必ず検討します。回折データは、規則配列のモデルと、乱れのモデルの両方でフィットして比べ、既知の相のデータベース(ICSD など)と照合します。対照(既知の関連相を、同じ条件で作る)と、ロット差の確認も加えます。自動の Rietveld 解析は、まだ信頼できないとの指摘があるため、人が解析結果を確認します[[leeman2024]](本記事による解説)。
報告で「新規で安定」とあれば、①何と照合したか(基準データの範囲、乱れのある構造を含むか)、②安定の基準(凸包の上 0 か、0.1 eV/原子 以内か)、③何で確かめたか(DFT か、機械学習ポテンシャルか、実験か)を、確認します。MatterGen の論文は、0.1 eV/原子 以内を「安定」とし、0 以下は、1,024個のうち、MP の凸包に対して13%、Alex-MP-ICSD の凸包に対して3%でした[[zeni2025]]。基準が変わると、割合が大きく変わります。
モデル・データ・コードは、別のライセンスのことがあります。MatterGen のコードと重みは MIT ライセンス、学習データの MP と Alexandria は CC BY 4.0 と、モデルカードに記載があります[[mattergen_hf,mattergen_gh]]。GNoME のデータは CC BY-NC 4.0(非営利)で、コードは Apache-2.0 です[[gnome_gh]]。商用利用の可否は、条文で確認してください(本稿は法的助言ではありません)。また、自社の配合・実験データを、外部の生成モデルの学習や微調整に使うときは、秘密保持と知的財産の扱いを、事前に決めてください。
9. 限界と、確認できなかったこと/まとめ
- 生成モデル(拡散モデルなど)は、既知の材料のデータから、新しい結晶の候補を作ります。評価には、安定・独自・新規(SUN)が使われ、「安定」の基準(0.1 eV/原子 以内か、0 以下か)と、「新規」の基準データで、数字が大きく変わります事実
- 「新材料○万種」は、計算上の予測の件数です。GNoME の220万、38.1万は DFT の結果で、実験にかかわるのは、ICSD の実験構造との一致736です。数えているものが違う数字を、割り算して成功率にしてはいけません事実本稿の計算
- 批判・再評価があります。A-Lab は2026年1月の訂正で、「新規」の意味と件数(57の目標のうち36)が改められ、MatterGen の合成例も、既知の乱れた相だという主張(Juelsholt)があります。乱れの扱いと、人による結晶学的な検証が、共通の課題です事実
- AIが絞るのは探す場所で、確かめるのは計算と実験です。実験計画では、生成した候補を、優先順位づけに使い、判定には、結晶学の専門家を入れます
確認できなかったこと
- Cheetham と Seshadri(2024)の本文は確認できず、題名の範囲で扱いました
- MatterGen の著者らの、Juelsholt(2026)の主張への応答は、確認できませんでした。TaCr₂O₆ の新規性の最終的な判定は、本稿では行いません
- MatterGen の論文の補足情報(Supplementary Information)は確認していません。乱れた材料についての記述は、arXiv 版の付録によります
- GNoME の「736」が、381,000 のうち何件かの内訳は、確認していません
- CDVAE・DiffCSP・Gruver らは、arXiv の記述で、出版版(会議論文)との差を確認していません。LeMat-GenBench はプレプリントで、査読後の版は確認していません
- A-Lab の訂正後の、個々の化合物の判定の詳細は、確認していません(訂正文と、更新後の要旨の範囲)
- 生成材料の評価・合成可能性を定める国際標準は、確認できませんでした
10. 評価・標準の読み方
生成による設計の「ものさし」は、まず生成の質(妥当か、安定か、独自か、新規か)、次に狙いの性質への到達(DFT の計算値で)、最後に実験での確認(合成できたか、構造と性質は予測どおりか)です。ものさしが測っていないのは、「新規」の基準の違いと、乱れた相の扱いです。確認日は2026年10月23日です。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・IUCr・NIST など) | 読み方の注意 |
|---|---|---|---|
| 生成の質(安定・独自・新規) | SUN(MatterGen、Zeni ら):安定=凸包の上 0.1 eV/原子 以内、新規=基準データのどれとも一致しない[[zeni2025]]事実。CDVAE の評価課題:再構成・妥当性と多様性・性質の最適化[[xie2022]]事実 | 確認できなかった(生成材料の評価の国際標準) | 基準データ・安定の基準・構造の照合の方法で、数字が変わる。論文ごとに定義が違う |
| 生成モデルの統一評価 | LeMat-GenBench(プレプリント):12のモデルを統一した指標で評価。安定性が上がると、新規性・多様性は下がる[[lemat]]事実 | 確認できなかった | プレプリント。順位表は更新される。自社の系での実力とは別 |
| 安定性の判定 | Matbench Discovery(探索用の機械学習の評価。回帰と分類の指標のずれ)[[matbench]]事実。DFT の凸包との比較[[merchant2023]]事実 | 確認できなかった | 「安定」は、その時点のデータの凸包に対する相対的な判定。将来の発見で外れうる(GNoME の論文) |
| 実験での確認(構造の同定) | X線回折の Rietveld 解析(A-Lab、MatterGen の合成例)。A-Lab は再解析で、40の成功のうち36を確認、4は判定できない[[szymanski_corr]]事実 | IUCr の CIF と、その検証サービス checkCIF[[iucr_cif]]事実 | checkCIF は CIF の整合性の検証で、材料の新規性や、乱れの有無の判定ではない |
| データ・モデルのライセンス | MatterGen:MIT。学習データ MP・Alexandria:CC BY 4.0[[mattergen_hf]]。GNoME のデータ:CC BY-NC 4.0、コード:Apache-2.0[[gnome_gh]]事実 | 確認できなかった(材料向け生成モデルのライセンスの標準) | コード・重み・データは別のライセンスのことがある。条文で確認 |
| AI 全般の枠組み | NIST AI Risk Management Framework 1.0(2023年1月26日公開):任意利用の枠組み。改訂の動きがあると、NIST のページに記載(確認日時点)[[nistairmf]]事実未確定/将来 | 生成材料に特化した国際標準は確認できなかった | AI 全般の指針は、「新規」の定義や、乱れの扱いまでは定めない |
表の整理は本稿の計算(整理)。番号・題名・数値は、論文・公式ページで確認(確認日 2026年10月23日)。標準は、いずれも推奨・形式・任意利用の枠組みで、法的な拘束力のある規格ではありません。ASTM の規格は、本稿の範囲では該当を確認していません。
読み方の注意(素材技術者向け)
- ベンチマークの順位と、自社の材料での実力は別:生成モデルの評価は、MP・ICSD などの無機結晶が対象です。ポリマー・界面・複合材は範囲外の可能性があります(モデルカードの対象外の用途も参照)[[mattergen_hf]]
- 予測と実験検証の違い:「新材料○万種」は計算の予測の件数です。実験で確かめた件数を、別に確認します(GNoME:736。MatterGen の合成:4つ中1つ)
- データ漏洩と分割の落とし穴:生成した構造が、学習データに含まれる既知の物質(乱れた版を含む)と一致すると、「新規」に見えても、新規ではありません(Juelsholt の指摘)[[juelsholt2026]]
- 標準・指針は、推奨か要求か:CIF・checkCIF・NIST AI RMF は、形式・検証・任意利用の枠組みで、法的な拘束力のある規格ではありません
- 計画と達成:企業・研究グループの「発見」は主張です。訂正・再評価が出ることがあるので、日付と版を確認します
11. 用語集
- 生成モデル
- データの分布を学び、そこから新しい例を作る機械学習モデル。
- 逆設計(逆問題)
- 望む特性から、それに合う材料を作る・提案すること。
- 拡散モデル
- データにノイズを足して壊し、その逆をたどって作る生成モデル。
- 変分オートエンコーダ(VAE)
- データを潜在ベクトルに圧縮し、そこから元に戻す・新しく作る方法。
- 等変(equivariant)
- 系を回したとき、出力も同じように回る性質。対称性をデータから学ばなくてよくなる。
- アダプター
- 学習済みのモデルに差し込む調整用の部品。条件づけの微調整に使う。
- 分類器なしの誘導(classifier-free guidance)
- 条件を与えたときと与えないときの差を使い、狙いの方向へ生成を導く方法。
- SUN
- stable(安定)・unique(独自)・new(新規)の頭文字。MatterGen の論文の評価基準。
- エネルギー凸包/E_hull
- 各組成で最も安定な相の組合せの線/その上の高さ。安定性の指標。
- 新規(new)
- 基準データのどれとも一致しないこと。「世界初」とは限らない。
- 乱れ(無秩序)
- 結晶の同じ席に、複数の元素がランダムに入ること。
- 規則配列
- 席ごとに元素が決まっている並び。計算で作る構造の多く。
- Rietveld 解析
- X線回折のデータから、結晶構造を精密化する方法。
- RMSD
- 2つの構造のずれの大きさ。生成した構造と、緩和した構造の近さの指標。
- MP/ICSD/Alexandria
- Materials Project/無機結晶構造データベース/計算で作った結晶のデータベース。
- GNoME
- Google DeepMind のグラフネットワークによる、安定な結晶の探索(Merchant ら)。
- A-Lab
- 無機粉末の固相合成を自動で行う実験室(Szymanski ら)。
- 著者訂正
- 論文の著者が、出版後に、誤りや記述を改める訂正。
- 概念実証
- 実現できることを、1例で示すこと。一般的な成功率ではない。
- ライセンス
- コード・重み・データの利用条件。それぞれ別のことがある。
- プレプリント
- 査読を経る前に公開された論文。
12. 参考資料(一次情報)
- Zeni C. ほか "A generative model for inorganic materials design", Nature 639, 624–632 (2025), DOI 10.1038/s41586-025-08628-5 — doi.org/10.1038/s41586-025-08628-5
- Zeni C. ほか MatterGen: a generative model for inorganic materials design (arXiv version; the appendix statement on disordered materials is cited from it), arXiv:2312.03687 (2023) — arxiv.org/abs/2312.03687
- Microsoft "mattergen repository README (license shown by GitHub: MIT; notes on evaluation with MatterSim)" — github.com/microsoft/mattergen
- Hugging Face (microsoft) "MatterGen model card (license: MIT; intended and out-of-scope uses; training data)" — huggingface.co/microsoft/mattergen
- Merchant A. ほか "Scaling deep learning for materials discovery", Nature 624, 80–85 (2023), DOI 10.1038/s41586-023-06735-9 — doi.org/10.1038/s41586-023-06735-9
- Merchant A. ほか Scaling deep learning for materials discovery (open-access full text on PubMed Central; the numbers in this article are taken from it), PMC10700131 (2023) — pmc.ncbi.nlm.nih.gov/articles/PMC10700131
- Google DeepMind "materials_discovery repository README (GNoME: code Apache-2.0; data CC BY-NC 4.0)" — github.com/google-deepmind/materials_discovery
- Szymanski N. J. ほか "An autonomous laboratory for the accelerated synthesis of inorganic materials (current version, updated after the author correction)", Nature 624, 86–91 (2023), DOI 10.1038/s41586-023-06734-w — doi.org/10.1038/s41586-023-06734-w
- Szymanski N. J. ほか "Author Correction: An autonomous laboratory for the accelerated synthesis of inorganic materials", Nature 650, E1 (2026), DOI 10.1038/s41586-025-09992-y — doi.org/10.1038/s41586-025-09992-y
- Leeman J. ほか "Challenges in High-Throughput Inorganic Materials Prediction and Autonomous Synthesis", PRX Energy 3, 011002 (2024), DOI 10.1103/PRXEnergy.3.011002 — doi.org/10.1103/PRXEnergy.3.011002
- Juelsholt M. "Continued challenges in high-throughput materials predictions: MatterGen predicts compounds from the training dataset", Mater. Horiz. 13 (11), 5672–5679 (2026), DOI 10.1039/d6mh00268d — doi.org/10.1039/d6mh00268d
- Cheetham A. K., Seshadri R. "Artificial Intelligence Driving Materials Discovery? Perspective on the Article: Scaling Deep Learning for Materials Discovery", Chem. Mater. 36, 3490–3495 (2024), DOI 10.1021/acs.chemmater.4c00643 — doi.org/10.1021/acs.chemmater.4c00643
- Ho J., Jain A., Abbeel P. "Denoising Diffusion Probabilistic Models", arXiv:2006.11239 (NeurIPS 2020) (2020) — arxiv.org/abs/2006.11239
- Xie T. ほか "Crystal Diffusion Variational Autoencoder for Periodic Material Generation", arXiv:2110.06197 (ICLR 2022) (2021) — arxiv.org/abs/2110.06197
- Jiao R. ほか "Crystal Structure Prediction by Joint Equivariant Diffusion", arXiv:2309.04475 (NeurIPS 2023) (2023) — arxiv.org/abs/2309.04475
- Gruver N. ほか "Fine-Tuned Language Models Generate Stable Inorganic Materials as Text", arXiv:2402.04379 (ICLR 2024) (2024) — arxiv.org/abs/2402.04379
- Gómez-Bombarelli R. ほか "Automatic Chemical Design Using a Data-Driven Continuous Representation of Molecules", ACS Cent. Sci. 4, 268–276 (2018), DOI 10.1021/acscentsci.7b00572 — doi.org/10.1021/acscentsci.7b00572
- Davies D. W. ほか "Computational Screening of All Stoichiometric Inorganic Materials", Chem 1, 617–627 (2016), DOI 10.1016/j.chempr.2016.09.010 — doi.org/10.1016/j.chempr.2016.09.010
- Riebesell J. ほか "A framework to evaluate machine learning crystal stability predictions", Nat. Mach. Intell. 7, 836–847 (2025), DOI 10.1038/s42256-025-01055-1 — doi.org/10.1038/s42256-025-01055-1
- Betala S. ほか "LeMat-GenBench: A Unified Evaluation Framework for Crystal Generative Models", arXiv:2512.04562 (preprint) (2025) — arxiv.org/abs/2512.04562
- Sun W. ほか "The thermodynamic scale of inorganic crystalline metastability", Sci. Adv. 2, e1600225 (2016), DOI 10.1126/sciadv.1600225 — doi.org/10.1126/sciadv.1600225
- IUCr (International Union of Crystallography) Crystallographic Information Framework (includes the checkCIF validation service; page checked 22 October 2026) — www.iucr.org/what-we-do/digital-standards/cif
- NIST (National Institute of Standards and Technology) "AI Risk Management Framework (AI RMF 1.0, released 26 January 2023; page checked 22 October 2026)" — www.nist.gov/itl/ai-risk-management-framework
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| MatterGen(Zeni ら、2025):拡散モデルで、原子の種類・座標・周期的な格子を同時に生成。アダプターで組成・対称性・物性を条件づけ、分類器なしの誘導で導く。Alex-MP-20:607,683 の安定な構造(20原子以下)。従来の生成モデルより、新規で安定な構造の割合が2倍以上、局所エネルギー最小に10倍以上近い | 出典1 https://doi.org/10.1038/s41586-025-08628-5 | 事実 |
| スクリーニングは既知の材料の数に限られる。未知の結晶の最大規模の探索は 10⁶〜10⁷ 個で、潜在的に安定な無機化合物の一部。四元系は組成の組合せだけで約 10¹⁰(MatterGen の論文・arXiv 版が Davies ら(2016)を引用) | 出典1 https://doi.org/10.1038/s41586-025-08628-5 出典2 https://arxiv.org/abs/2312.03687 出典18 https://doi.org/10.1016/j.chempr.2016.09.010 | 事実 |
| 拡散モデルの基本(Ho ら、2020)。CDVAE(Xie ら):再構成・生成・性質の最適化の3課題で過去の方法を上回る。DiffCSP(Jiao ら):結晶構造予測で既存の方法を上回り、DFT を使う方法より計算コストが低い。Gruver ら:LLaMA-2 70B の微調整で、準安定と予測される割合が CDVAE の約2倍(49%対28%)。Gómez-Bombarelli ら(2018):分子を連続ベクトルに変換して生成 | 出典13 https://arxiv.org/abs/2006.11239 出典14 https://arxiv.org/abs/2110.06197 出典15 https://arxiv.org/abs/2309.04475 出典16 https://arxiv.org/abs/2402.04379 出典17 https://doi.org/10.1021/acscentsci.7b00572 | 事実 |
| 図2:2次元の簡単な例(16原子、2元素)に、座標へ正規分布のノイズ(σ=0.03、0.10、周期境界で折り返し)を加えた図。④は一様な乱数と、元素を「不明」にした状態 | 本稿の計算(概念図用の簡単な例) | 本稿の計算 |
| MatterGen の評価(1,024構造の DFT):MP の凸包に対して78%が 0.1 eV/原子 以内(0 以下は13%)、Alex-MP-ICSD の凸包に対して75%(0 以下は3%)。95%が RMSD 0.076 Å 未満。独自な割合は1,000個で100%、1,000万個で52%。新規は61%。学習に使っていない ICSD の構造を2,000件超再発見。SUN の定義(安定=基準 Alex-MP-ICSD の凸包の上 0.1 eV/原子 以内、新規=乱れのある ICSD 117,652 を加えた基準のどれとも一致しない) | 出典1 https://doi.org/10.1038/s41586-025-08628-5 | 事実 |
| MatterGen-MP は CDVAE・DiffCSP より SUN が60%多く、緩和後のずれが50%小さい。データを大きくすると SUN がさらに70%増え、ずれは5倍小さい。五元系:MatterGen 約1万の生成、置換約7万、RSS 約60万(三元・四元系では置換が同等以上に効率的)。体積弾性率 400 GPa:DFT 180回の予算で、MatterGen は SUN を106個(95の組成)、スクリーニングは40個(28の組成) | 出典1 https://doi.org/10.1038/s41586-025-08628-5 | 事実 |
| MatterGen の合成例:4つの目標ごとに 8,192 個を生成。新規性・独自性、MatterSim と DFT の安定性、フォノンの安定性、酸素を含むことで75個に。専門家が4つ選び、1つ合成。Rietveld 解析で、TaCr₂O₆ の組成が乱れた版。目標 200 GPa、規則的な構造の DFT 値 222 GPa、実験値は最大 169 GPa(158±11 GPa、ナノインデンテーション、DFT のポアソン比 0.30)。「概念実証」 | 出典1 https://doi.org/10.1038/s41586-025-08628-5 | 事実 |
| 169 GPa は目標 200 GPa より約15.5%低い(1−169/200) | 本稿の計算 | 本稿の計算 |
| MatterGen の公式リポジトリ:コードは MIT。付属の評価コードは MatterSim を使い、論文の DFT 評価と結果が違いうるため、DFT での確認を推奨。モデルカード:MIT、20原子超・有機結晶・非晶質などは対象外。学習データ MP・Alexandria は CC BY 4.0 | 出典3 https://github.com/microsoft/mattergen 出典4 https://huggingface.co/microsoft/mattergen | 事実 |
| GNoME(Merchant ら、2023):220万の構造が MP に対して安定。更新した凸包で38.1万が新規の安定な材料(合計約42.1万)。以前の安定な結晶は約4.8万。エネルギー 11 meV/原子、的中率80%超(構造つき)・33%(組成のみ、100回あたり)、以前は1%。736は、ICSD の実験構造と一致。凸包から外れうる、MP・OQMD の5,000超を押し出した | 出典5 https://doi.org/10.1038/s41586-023-06735-9 出典6 https://pmc.ncbi.nlm.nih.gov/articles/PMC10700131 | 事実 |
| GNoME の公式リポジトリ:データは CC BY-NC 4.0、コードは Apache-2.0。理論モデリング用で、注意して使うよう記載 | 出典7 https://github.com/google-deepmind/materials_discovery | 事実 |
| LeMat-GenBench(プレプリント):12の生成モデルを統一した指標で評価。安定性が上がると新規性・多様性が平均して下がり、すべての面で優れるモデルはない。Matbench Discovery:回帰の指標と分類の指標のずれ | 出典20 https://arxiv.org/abs/2512.04562 出典19 https://doi.org/10.1038/s42256-025-01055-1 | 事実 |
| 観測されている無機結晶の凸包の上の高さ:中央値 15、90パーセンタイル 67 meV/原子(0.1 eV の基準が緩めであることの根拠) | 出典21 https://doi.org/10.1126/sciadv.1600225 | 事実 |
| A-Lab(Szymanski ら、2023):GNoME と MP の安定性データで選んだ目標を、17日間の自動合成。当初は58の目標のうち41。現在の要旨は57の目標のうち36 | 出典8 https://doi.org/10.1038/s41586-023-06734-w | 事実 |
| Leeman ら(2024):43の生成物を検討、4つの共通の見落とし、新規の材料は発見されていないと結論。乱れの無視、成功の3分の2は既知の乱れた版の可能性、自動 Rietveld 解析は信頼できない | 出典10 https://doi.org/10.1103/PRXEnergy.3.011002 | 事実 |
| 著者訂正(Nature、2026年1月19日):「新規」は予測の基盤にとって新しいという意図。再解析で40の成功のうち36を確認、4は判定できない。成功の数を更新し、学習データに誤って含まれていた1つ(Zn₂Cr₃FeO₈)を議論から除外 | 出典9 https://doi.org/10.1038/s41586-025-09992-y | 事実 |
| Juelsholt(Materials Horizons、2026、査読あり):TaCr₂O₆(乱れた版 Ta₁/₃Cr₂/₃O₂)は、1971年報告の Ta₁/₂Cr₁/₂O₂ と同一で、MatterGen の学習データに含まれると主張。MatterGen の著者らの応答は確認できなかった | 出典11 https://doi.org/10.1039/d6mh00268d | 事実 |
| MatterGen の論文(arXiv 版の付録):乱れた材料には規則的な近似が複数あり、新規性・凸包の上の高さが正しく評価されない場合がある | 出典2 https://arxiv.org/abs/2312.03687 | 事実 |
| Cheetham と Seshadri(2024):GNoME の論文についての展望論文(題名のみ。本文は未確認) | 出典12 https://doi.org/10.1021/acs.chemmater.4c00643 | 事実 |
| IUCr の CIF と checkCIF(CIF の検証サービス)。NIST AI RMF 1.0(2023年1月26日公開、任意利用、改訂の動きがあるとのページの記載) | 出典22 https://www.iucr.org/what-we-do/digital-standards/cif 出典23 https://www.nist.gov/itl/ai-risk-management-framework | 事実未確定/将来 |
| 素材技術者の視点(優先順位づけ、乱れの見分け方、新規と安定の定義、ライセンスとデータの扱い)。「AIが材料を発明する」「新規=世界初」「38万種を実験で作った」が誤解である、という整理は解説 | 解説(本稿の見解) | |
| 生成材料の評価・合成可能性を定める国際標準は確認できなかった。Cheetham と Seshadri の本文、MatterGen の著者らの応答、MatterGen の補足情報、736の内訳も確認できなかった | 本稿の確認結果(確認できなかった) |
最終更新:2026年10月23日/出典は一次情報(論文、プレプリント、論文の訂正、GitHub・Hugging Face・IUCr・NIST の公式ページ)に限定しています。数値例は本稿の計算で、実際の生成モデルの出力ではありません。Cheetham と Seshadri の本文、MatterGen の著者らの Juelsholt への応答、MatterGen の補足情報、GNoME の736の内訳、A-Lab の訂正後の個々の判定、生成材料の評価に関する国際標準については、確認できなかったため、断定していません。批判・再評価のある事例は、論文・訂正・査読つき論文で確認できる範囲を、両方並べており、勝ち負けの判定はしていません。図2〜図8は説明用の概念図または本稿の計算を含む作図で、図1と図9はAI生成イメージ(描く場面の指示のみ記載)です。