主要成果
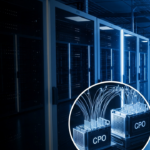
Marvellは、AI推論におけるKVキャッシュ(過去のコンテキストを保持し、再計算を避けるためのメモリ)の制約を解決するため、光インターコネクトを用いた共有メモリ装置「Photonic Fabric Memory Appliance (PFMA)」を開発した。シミュレーションベースの分析によると、この共有メモリ構成を採用することで、同一の計算リソースを用いながら、最初のトークン出力までの時間(time-to-first-token)を同等に維持したまま、同時会話数を約6倍に拡大できるとしている。
技術・詳細
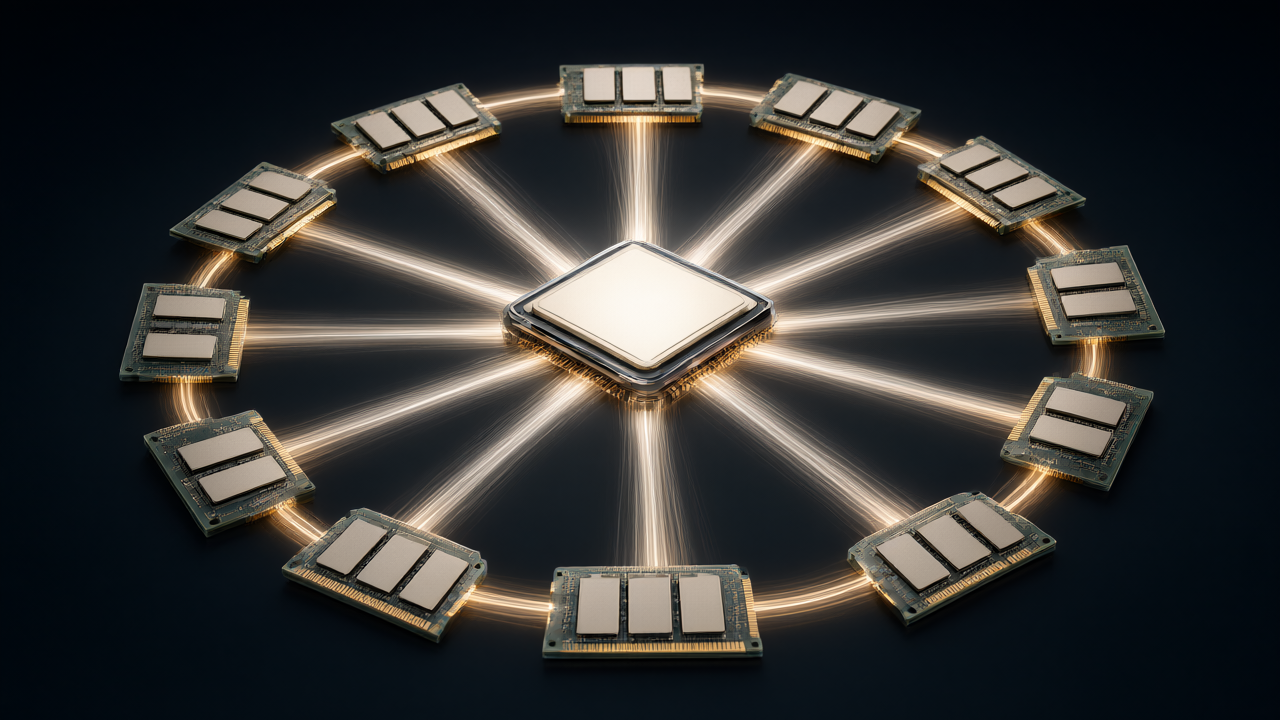
PFMAはラックマウント型の装置で、128個の標準DDR5 DIMMスロットと、大容量DDR5プールのキャッシュとして機能する約1 TBのHBM3eを搭載している。16個のPhotonic Fabricメモリモジュールがパッシブファイバーシャッフルを通じて接続され、接続されたシステムに統合された共有アドレス空間を提供する。物理的な分離と伝搬遅延のバランスを考慮し、ラックをまたいだメモリ共有の実用的な光到達距離は25〜30メートルと定義されている。
システムへの統合パスは以下の2種類が提供される:
- PF-NICカード:PCIe Gen6 x16およびCXL 3.xを用いてサーバーに接続する。
- PF-Chiplet:XPUパッケージに直接統合する。
Marvellは、チップレット接続のPFMAをローカルGPU HBMの下位にあたる「G1.5ティア」、サーバー接続のPFMAをシステムDRAMとストレージの間にある「G2.5ティア」として位置づけている。
背景・業界の文脈
推論モデルやエージェントアプリケーションにおいて会話が長期化するにつれ、メモリは単一コンポーネントではなく、クラスター全体で管理されるリソースである必要性が高まっている。KVキャッシュをSSDベースのオフロードよりも計算リソースに近い場所に保持することで、推論ソフトウェアはワークロードを処理するプロセッサをより柔軟に選択できるようになる。また、共有プールを利用することで、キャッシュを生成した元のGPUにワークロードを固定し続ける必要性が軽減される。
今後の展望
本提案は、KVキャッシュの配置をクラスターアーキテクチャの決定事項へと変化させる。ただし、実際の性能はキャッシュヒット率、DDR帯域幅、アクセスパターン、ファイバー長、同時要求数に依存する。また、提示された初ワード遅延のターゲットはプリシリコン(回路設計段階)の見積もりであり、変更される可能性がある。Marvellは、2026年2月に買収したCelestial AIの技術を統合し、従来のCXL拡張やストレージコントローラーを超えた、ラックをまたぐ光共有メモリ戦略を推進している。
元記事: https://convergedigest.com/pecc-summit-marvell-optical-memory-kv-cache/
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます