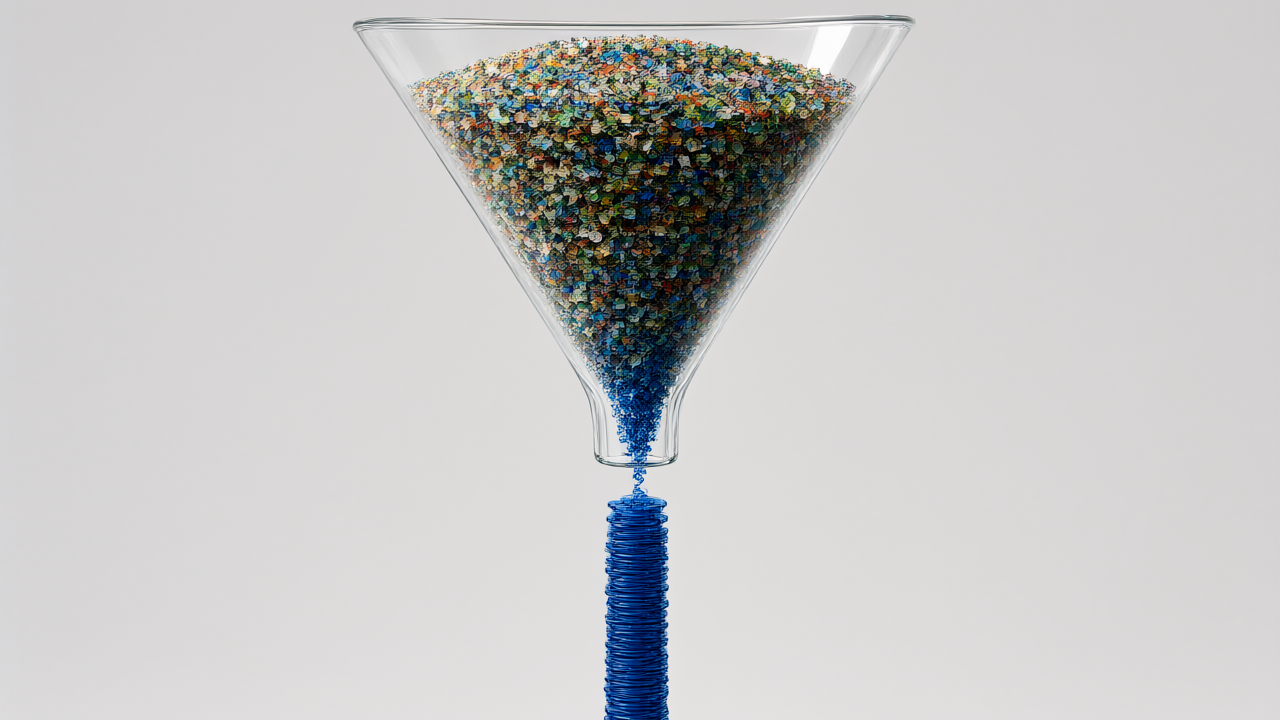
主要成果
Dharma AIは、小規模言語モデル(SLM)の語彙を特定のタスクやドメインに合わせて最適化する手法「VocabX」を開発し、実際のアプリケーションにおいて推論コストを77%削減することに成功しました。この成果は、Qwen3-4Bをベースとしたポルトガル語の作文採点システムで実証されており、ベースモデルや学習データ、トレーニングレシピを変更することなく、トークナイザーの最適化のみでコストを大幅に引き下げた点が特徴です。
技術・詳細
一般的な汎用モデルのトークナイザーは、多言語や多様なドメインをカバーするように設計されていますが、単一ドメインのタスクでは「断片化」と「過剰」という2つの無駄が生じます。断片化とは、ドメイン内で頻出する定型文やJSON形式のエンベロープなどが多くのトークンに分割されることで、出力トークン数が増加する現象です。一方、過剰とは、タスクでは決して使用されない数万件の語彙(例:ポルトガル語の採点タスクにおける中国語のトークン)に対しても、モデルが生成のたびにスコアを計算し続ける負荷を指します。
VocabXでは、単なる出現頻度ではなく「トークンごとのコスト」に基づいて語彙を再構築しました。これにより、Qwen3-4Bで約152,000件あった出力層の行数を約65,000件まで削減しました。特に、推論の「デコード(生成)」フェーズはメモリ帯域が制限要因となるため、LMヘッド(最終層)の行列サイズを小さくすることが、データ転送量の削減に直結し、コスト低減に寄与しました。
背景・業界の文脈
推論コストにおいて、入力(プリフィル)よりも出力(デコード)の方が遥かに高コストであるという特性があります。本事例の採点システムでは、生成される1トークンのコストは、読み込まれる1トークンの7.4倍に達していました。汎用モデルの語彙をそのまま継承することは、小規模モデルにとって大きな負担となります。例えばQwen3-4Bのようなモデルでは、語彙行列がパラメータ全体の約10%を占めており、この部分の最適化がSLMにおける最大のコスト削減レバーとなります。
今後の展望
Dharma AIは、これらの結果をまとめた論文「VocabX」を近日中に公開する予定であり、現在はレビュー段階にあります。汎用モデルを特定のドメインに特化させる際、トークナイザーを固定せず、ドメイン固有の語彙に再構築することが、実用的な推論コストを抑えるための極めて有効なアプローチであることが示されました。
元記事: https://huggingface.co/blog/Dharma-AI/vocabx-vocabulary-specialization
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます