主要成果
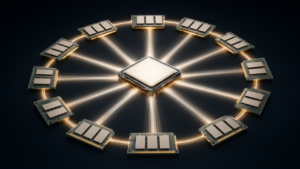
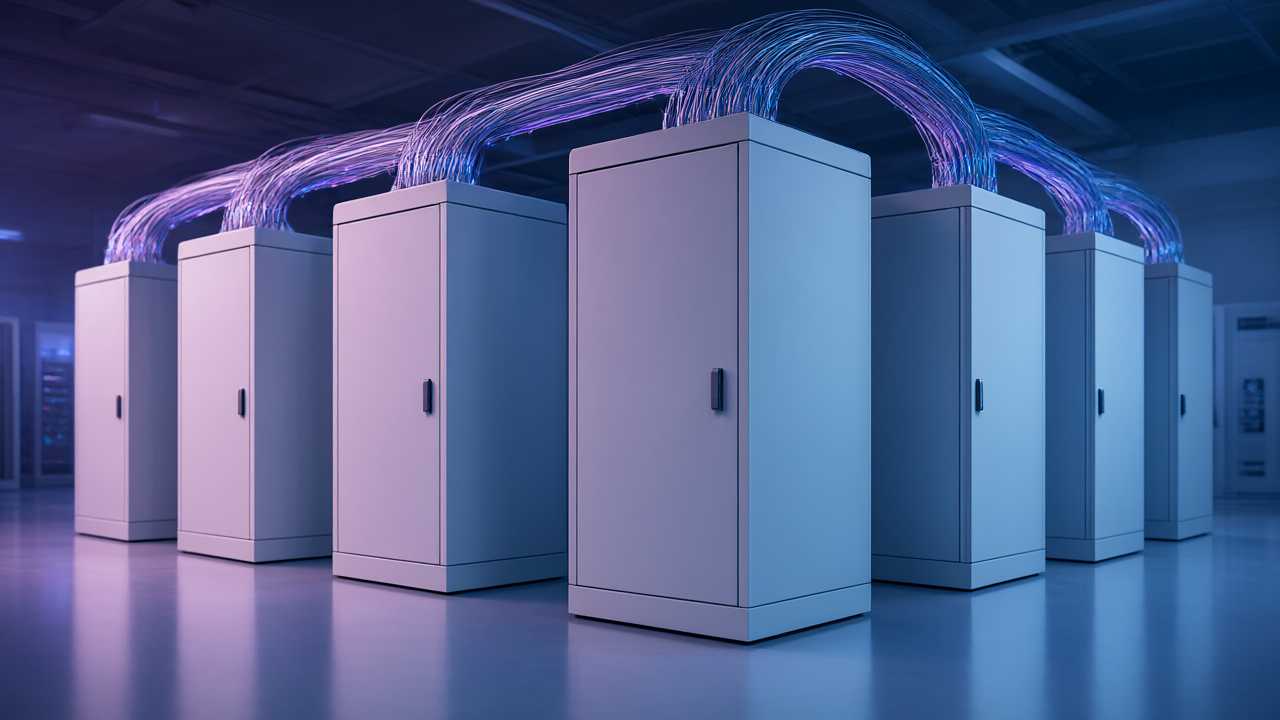
NVIDIAは、OCP Global Summitにおいて、576基のGPUを光接続によって統合する「Vera Rubin Ultra NVL576 CPO」の構成を明らかにした。このシステムは、72基のRubin Ultra GPUを搭載したMGX NVLラックを8台組み合わせる設計となっており、2層の全対全接続トポロジーを用いることで、合計576基のGPUを一つのNVLinkドメインにまとめる。これにより、10兆(10T+)を超えるパラメーターを持つ超大規模AIモデルの処理において、電力当たりの性能を最大化させることを狙っている。
技術・詳細
本構成の核心となるのが「NVLink 7 CPO Switch Tray」の導入である。CPO(Co-Packaged Optics)は、電気信号と光信号を変換する光エンジンをスイッチチップと同じパッケージ内に配置する技術で、電気配線を短縮することで高速通信に伴う電力消費と信号伝送の制約を軽減できる。NVL576では、銅配線と直接光接続を併用し、8ラックにまたがるGPU群を高速に連携させる。
また、本システムは以下の点において他の構成と区別される:
- NVLinkドメインとEthernetの差: NVL576の「576」は密接な連携を行うスケールアップ型のNVLinkドメイン規模を指すが、AIファクトリー全体を繋ぐスケールアウト型のEthernetネットワーク(Spectrum-X Photonics Multiplane Ethernet)では、最大512K基のGPU接続を想定している。
- 試作機との違い: GB200を使用したマルチラック試作機「Polyphe」や、1ラックに144基を収める「Kyber NVL144」とは異なる設計である。
背景・業界の文脈
大規模AIモデルの分散処理では、個々のGPUの演算力だけでなく、GPU間のデータ転送効率が全体の性能を左右する。NVIDIAはMGXアーキテクチャを通じて、液冷システムや電源・冷却インターフェースの共通化(MGX 1.2)を進めており、製造時の組み立てや導入後の保守作業の簡素化を図っている。あわせて、Spectrum-Xにおいて「電力効率5倍」という数値が示されており、インフラ全体の効率化が急務となっている背景がある。
今後の展望
製品の登場は2027年が示唆されているが、量産時の最終仕様は確定していない。光エンジンの実装方式について、CPO以外にチップ近傍の基板上に配置するNPO(Near-Packaged Optics)を検討する余地も残されている。今後の評価ポイントは、モデルや演算精度を揃えた実測性能に加え、光部品が故障した際の交換作業やシステム停止範囲といった「保守性」が、大規模運用の効率にどう影響するかが焦点となる。
元記事: https://xenospectrum.com/nvidia-rubin-ultra-nvl576-cpo/
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます