主要成果
浙江大学の研究チームは、AIコンピューティングシステム向けの次世代光入出力(I/O)に向けた、スケーラブルなシリコンフォトニクス相互接続アーキテクチャを開発しました。このシステムは、光通信で重視されるOバンドにおいて、合計帯域幅3.2テラビット/秒(Tbps)という極めて高いデータ転送速度を達成しています。本研究成果は、学術誌『PhotoniX Synergy』に掲載されました。
技術・詳細
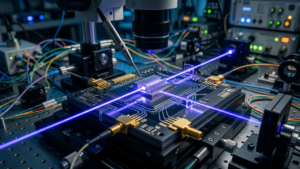
本アーキテクチャは、帯域幅、物理的なフットプリント、挿入損失、およびチャネル間のクロストークという相反する要求をバランスさせるため、送信側と受信側で異なる設計を採用したヘテロジニアスなマルチプレクサ(多重化器)およびデマルチプレクサ(分波器)を導入しています。
- 送信側:広帯域の格子フィルタベースのマルチプレクサを採用。カスケード接続された干渉計ステージにより、広い動作許容範囲と制御されたパスバンドで多くの波長を結合させます。
- 受信側:コンパクトなバーニア・デュアルマイクロリング・デマルチプレクサを採用。ペアになったリング共振器の自由スペクトル範囲のわずかな不一致を利用することで、従来のフィルタバンクよりも少ないチップ面積でチャネルを分離します。
さらに、容量を拡大するために「ハイブリッド波長・ポート多重化」戦略を導入しました。これは、1つの波導路に異なる波長の光を重ねる「波長多重化」と、チップ上の複数の物理的な波導路ポートにこの手法を複製する「ポート多重化」を同時に行う手法です。合計帯域幅は「1ポートあたりの波長数 × ポート数」の積としてスケールするため、単一の波導路に過剰な数の波長を詰め込むことなく、テラビット級の容量を実現しています。また、温度や製造誤差による波長変動を抑えるための波長安定化機能も設計に組み込まれています。
背景・業界の文脈
現代のAIクラスターでは、プロセッサ、メモリバンク、サーバー間で膨大なデータ移動が発生します。しかし、チップやボード間を接続する従来の銅線(電気的相互接続)は、AIモデルの巨大化に伴うトラフィック増大に追いつかず、エネルギー消費と帯域幅の制約が深刻なボトルネックとなっています。シリコンフォトニクスは、データを光にエンコードしてシリコンチップ上の波導路で伝送するため、低損失かつ高密度な帯域幅を提供でき、AIインフラの性能と電力予算を改善する有力な代替手段とされています。
今後の展望
対応著者のJianyi Yang教授は、テラビット規模のシリコンフォトニクス相互接続をよりスケーラブルで堅牢にすることを目標としています。単に数値上の帯域幅を追求するのではなく、特殊なパッケージングや極端な温度制御を必要とせず、ハードウェアの増加に伴って比例的に容量を拡張できる設計を目指しています。これにより、次世代のAIコンピューティングシステムにおいて、実用的かつ管理可能な複雑さでテラビット級の光I/Oを実現する経路が提示されました。
元記事: https://bioengineer.org/silicon-photonics-chip-hits-3-2-terabits-per-second-for-ai-data-traffic/
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます