主要成果
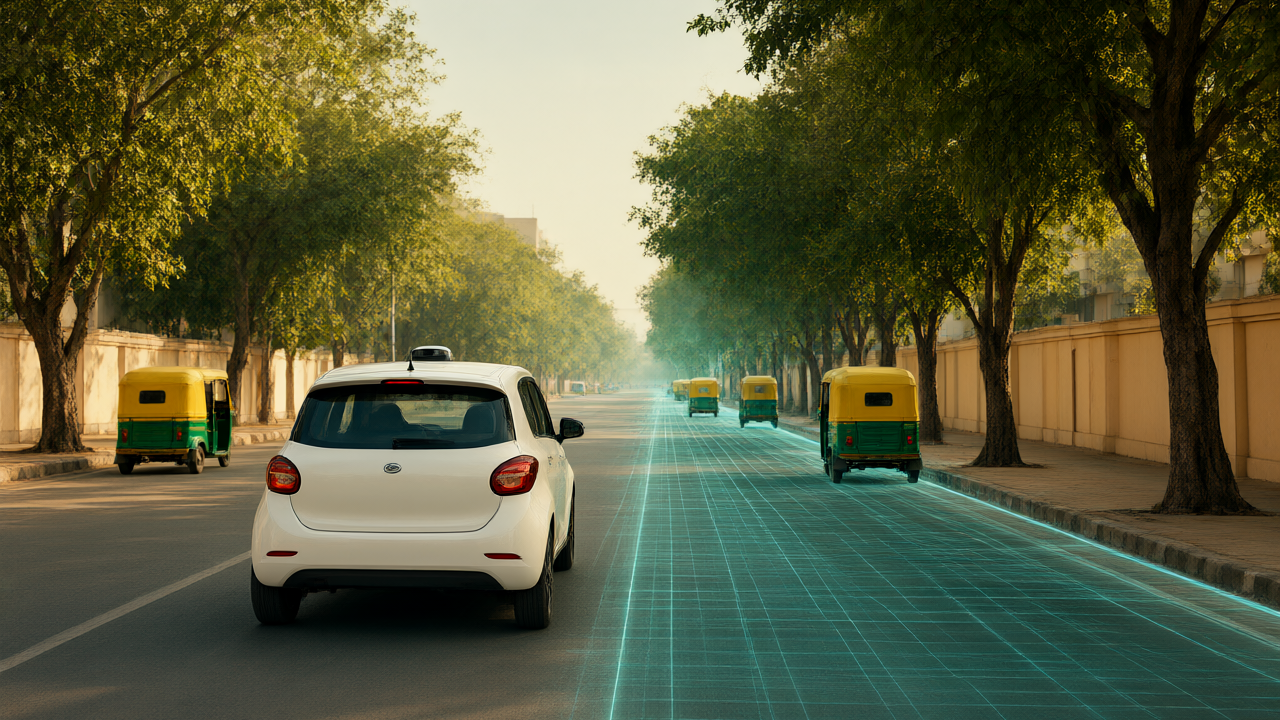
Odyssey-3の最大の特徴は、極めて少ないデータ量で実世界に適用可能な制御ポリシーを構築できる点にある。具体的には、実道路や実センサーを一切使用せず、生成された約20時間のシミュレーション動画のみで学習させた自動運転ポリシーが、先週インドの実際の路上で走行した。このデータ効率の高さは、高精度な合成トレーニング環境が実走行データの代替となり得ることを示唆している。
技術・詳細
Odyssey-3は「自己回帰ディフュージョン・トランスフォーマー(autoregressive diffusion transformer)」アーキテクチャを採用している。これは、言語モデルのように過去のフレームから次を予測する因果的時間予測と、反復的なデノイジングによる空間生成を組み合わせたものである。また、推論速度を向上させるため「敵対的蒸留(adversarial distillation)」を用いて生徒モデルを訓練しており、ベース層では832×480ピクセルで16fps、Pro層では1,280×720ピクセルの出力を実現している。
本モデルは単一タスク用ではなく、事前学習済みの重みが異なる制御インターフェースや形態に汎用化される基盤モデルとして設計されている。これにより、以下の多様なドメインでの適用が実証された。
- ヒューマノイド:Flexion社と共同開発した制御ポリシーにおいて、学習データにない照明変化などの環境変化への適応力が向上した。
- ロボットアーム:数十時間のデモンストレーション学習により、未学習のリカバリー動作(掴み損ねへの対応など)を完遂した。
- ドローン:屋内障害物回避のナビゲーションポリシーをシミュレーションで学習し、物理環境で評価した。
- AIエージェント:インタラクティブな環境を生成し、エージェントの訓練とモデルの精度向上を同時に行うフィードバックループを構築した。
- ゲーム:Grand Theft Auto Vをプレイ可能であり、追加学習なしでRed Dead Redemption 2やSleeping Dogsへの行動転移を示した。
性能評価
物理実験の継続性を測定する「Physics-IQ Verified」ベンチマークのvideo-to-videoトラックにおいて、8つの候補から最良を選択するプロトコルで66.1という最高スコアを記録した。また、image-to-videoトラックでは54.7(同様にbest-of-eight)を記録している。さらに、制御追従や視覚品質などを測定するWorldMarkにおいても、4つの分割項目のうち3つでリードしているとしている。
今後の展望
Odyssey-3のリリースは、合成トレーニング環境と実ロボット展開の間にある「sim-to-realギャップ」を埋める重要なマイルストーンとなる。2026年10月8日に公開された本モデルは、現在experience.odyssey.systemsにてAPIキー不要のリサーチプレビューが提供されており、物理AI開発におけるデータ収集のコスト構造を根本的に変える可能性がある。
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます