主要成果
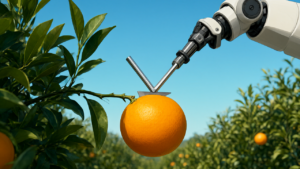
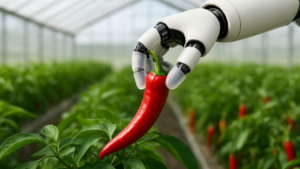
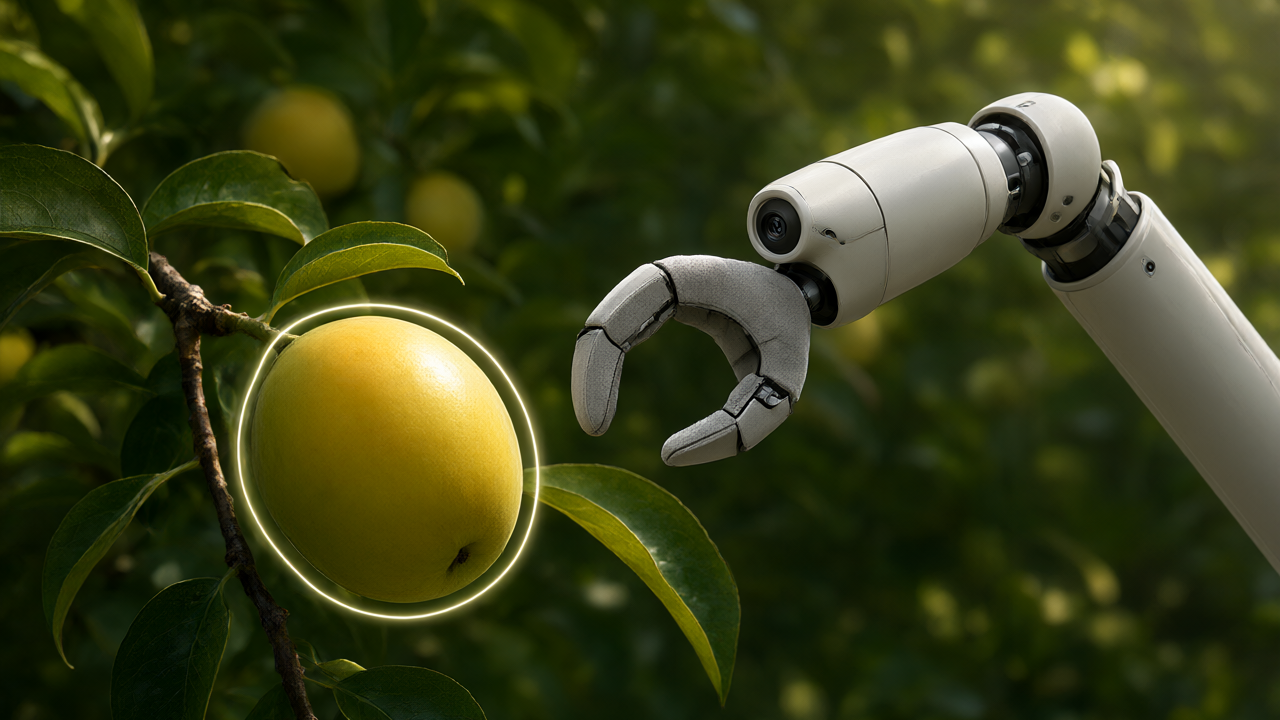
Junyu Hao氏らの研究チームは、単一の画像から新しいターゲットを学習し、後続のシーンで同一の果実を検出するOne-Shot物体検出手法を開発しました。この手法は、COCOデータセットを用いたベンチマークで29.93 mAPを記録し、HallucやSFOT、Norm-VAEなどの既存手法を上回る最高値を達成しています。特に農業現場を想定したクロスフルーツ検出では、事前学習をCOCOデータセットのみに限定し、ターゲットとなる果実データでのファインチューニングを一切行わなかったにもかかわらず、57.78 mAP、79.10 AP50、48.72 AP75を記録しました。これは、ターゲットカテゴリで直接学習させた完全教師ありモデルであるYOLO11nを、mAPで4.00ポイント上回る性能です。
技術・詳細
本システムは以下の4段階のワークフローで動作します。
- 情報収集:作業者が指定したサポート画像、ターゲットを示すクリック位置、およびロボットアームのカメラによるクエリ画像を取得します。
- マスク生成と候補抽出:Segment Anythingスタイルのアーキテクチャを用いて、クリック位置から果実の正確なセグメンテーションマスクを生成します。同時に、クエリ画像からゼロショットセグメンテーションで候補領域を抽出し、アスペクト比でフィルタリングします。
- 特徴マッチング:ResNet-50をバックボーンとした深層サイアミーズネットワーク(オートエンコーダーベース)により、サポートオブジェクトと候補領域を1024次元のベクトルに変換します。その後、多層パーセプトロンで128次元まで圧縮し、ユークリッド距離が閾値0.71未満であれば同一クラスと判定します。
- 精緻化:位置オフセットを予測するリファインメントネットワークにより、粗い提案領域を精密なバウンディングボックスへと修正します。
計算コスト面では、NVIDIA RTX 4090 GPUにおいて1枚あたり平均34.42ミリ秒(約29.06 fps)で処理でき、ピーク時のGPUメモリ使用量は0.24ギガバイトに抑えられています。
背景・業界の文脈
従来の収穫ロボットの視覚システムは、固定された作物のセットで学習されており、未知の作物を認識させるには数千枚の画像収集、手動でのアノテーション、そしてモデルの再学習という膨大なコストが必要でした。本研究では、実環境のデータセット(広西の金柑1100枚、北京のリンゴ890枚、海淀区のトマト900枚、スペインのイチゴ、日本の筑波大学の梨)を用いて検証し、実用的な汎用性を証明しています。
今後の展望
実機への導入試験では、UR5およびFR5アームを搭載したロボットを用い、金柑で91.53%、リンゴで96.33%の認識率を達成しました。一方で、課題も明確になっています。特に小さな果実の検出(mAP 38.92%)や、激しいモーションブラー(mAP 46.85%)、密集した遮蔽状態(mAP 51.87%)での性能低下が確認されました。また、個別の果実検出は可能ですが、トマトの房のような「クラスター全体」を一つの収穫単位として認識させることは依然として困難であり、今後の改善点として挙げられています。また、組み込みデバイスへの展開にはモデルの圧縮とハードウェア加速が必要であるとしています。
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます