主要成果
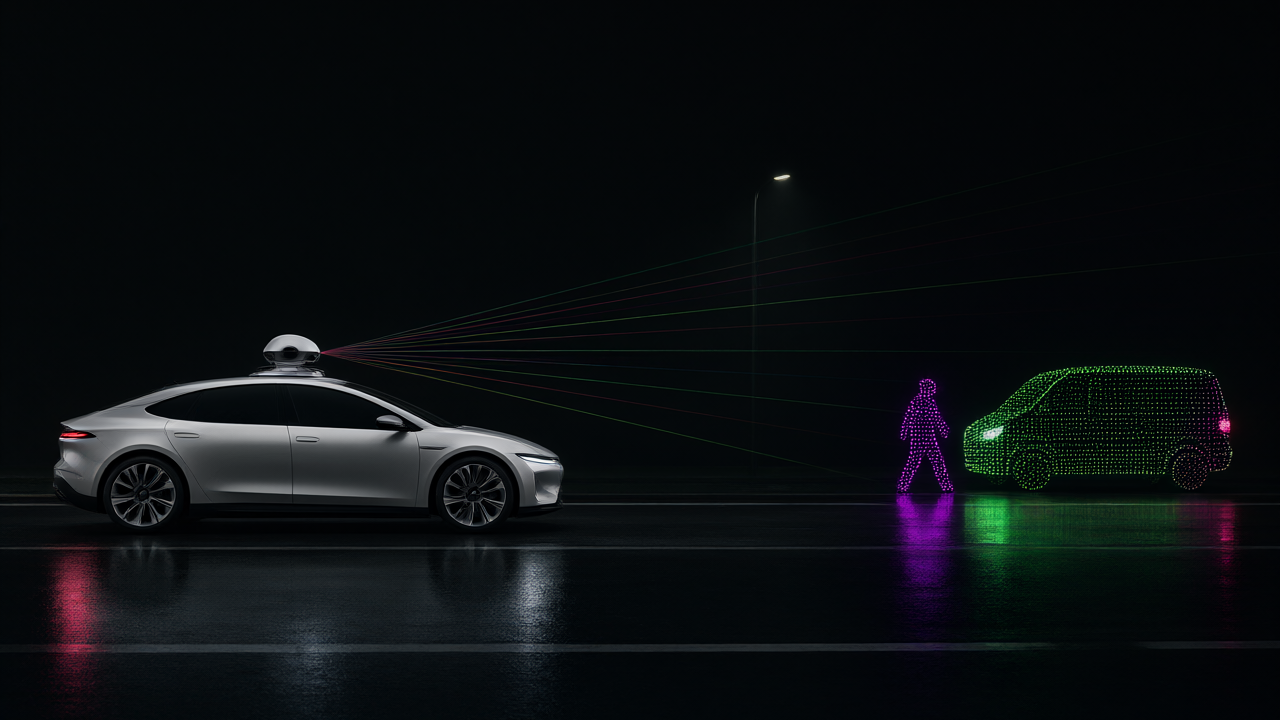
黄河交通大学の研究チームは、自動運転車が直面する「低照度環境でのカメラの視認性低下」と「LiDARデータの疎性(データの少なさ)」という課題を解決する、新しい物体検知システムを開発しました。本システムは、改良されたYOLOv12アルゴリズムとLiDARの点群コラボレーションを組み合わせたシングルステージ物体検知モデルであり、歩行者や交通コーンのような細長い小型ターゲットの認識精度を向上させています。特に、LiDAR側の処理において0.3メートルのクラスタリング閾値を採用することで、94.7%という高いクラスタリング精度を達成しました。
技術・詳細
本システムの核心は、視覚情報と距離情報の効率的な融合にあります。まずカメラ側では、エンドツーエンドの検知アーキテクチャであるYOLOv12をベースに、軽量なCoordinate Attention(CA)モジュールを階層的に組み込みました。これにより、従来のArea Attentionでは困難だった水平・垂直方向の空間座標モデリングが可能になり、遮蔽物がある状況や暗所での特徴応答が強化されています。また、損失関数にComplete IoU(CIoU)を採用し、バウンディングボックスの重なり、中心点距離、アスペクト比の一貫性を考慮することで、よりタイトな物体囲い込みを実現しました。
LiDAR側では、以下の4ステップで処理が行われます。
- パススルーフィルタリングによる地面や遠距離ノイズの除去と、ボクセルグリッドダウンサンプリングによるデータ冗長性の削減。
- 垂直方向の高さ、点群密度、表面法線ベクトル、車両までの平均距離といった幾何学的特徴の算出。
- ユークリッド距離クラスタリングによる独立した物体群の分離(閾値0.3メートル)。
- 有効な一致点数に基づくターゲットマッチング信頼度の算出と、3次元バウンディングボックス座標の出力。
特筆すべきは、LiDARブランチに深層学習ネットワークを使用せず、PCLライブラリに基づいた実装としたことで、システム全体の計算負荷を低減させている点です。
背景・業界の文脈
自動運転車の「視覚神経」にあたる環境認識システムでは、これまで単一のセンサーのみを用いるシングルモーダル検知と、複数のセンサーを組み合わせるマルチモーダル融合の2つのアプローチが主流でした。しかし、シングルモーダルでは複雑なシーンへの適応力が低く、既存のマルチモーダル融合アルゴリズムでは特徴量の結合が弱いため、走行条件の動的な変化に対して堅牢性に欠けるという課題がありました。カメラは低コストで詳細な分類が可能ですが光量変化に弱く、LiDARは精密な3次元計測が可能ですが点群が疎であるため、微細な物体認識が困難であるという相互の弱点が存在していました。
今後の展望
本研究では、低レベルでの特徴結合ではなく、独立したシングルモーダル検知結果を後段で統合する「シーン適応型決定レベル動的重み融合戦略」を導入しています。これにより、環境に応じて最適なセンサーの判断を優先させることが可能になります。計算コストを抑えつつ、低照度や悪天候といった困難な条件下でも信頼性の高い物体検知を実現するこの手法は、次世代の高度自動運転システムの安全性向上に寄与すると期待されます。
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます