主要成果
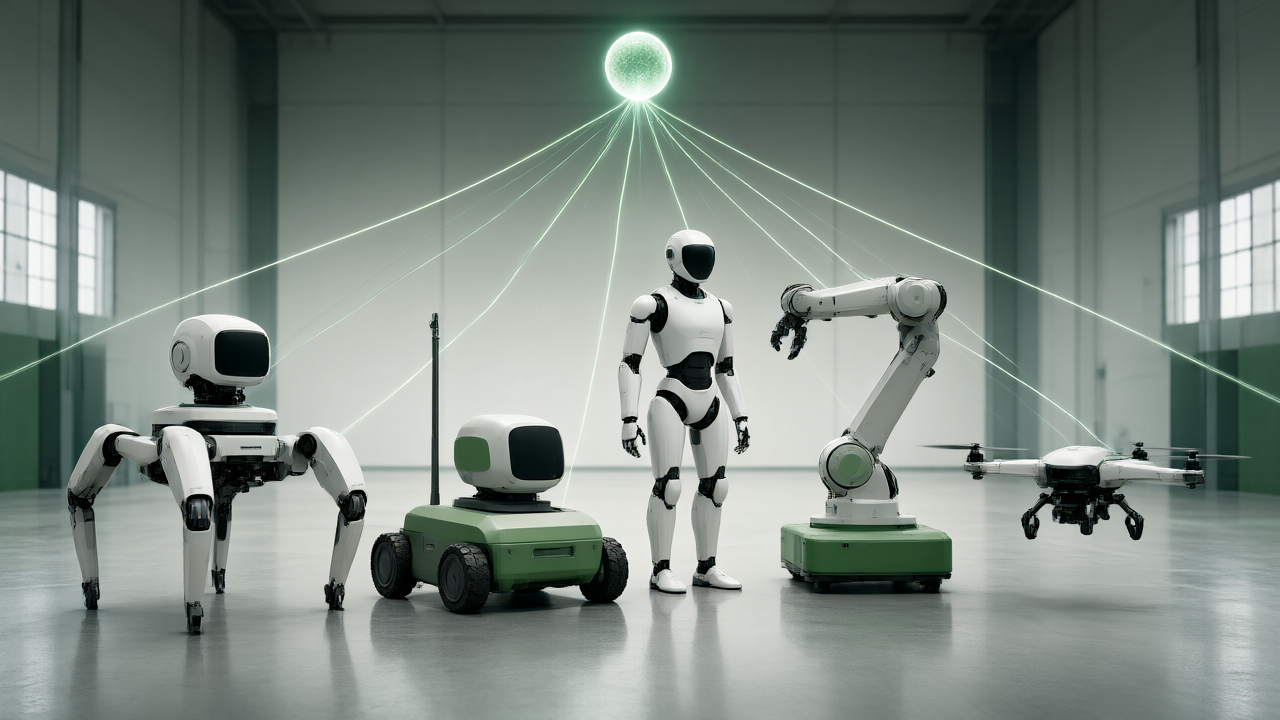
GreenWAMは、双腕アームから器用なヒューマノイドまで、20のロボットファミリーにまたがって動作する統合的な世界基盤モデルです。本モデルは、アクション条件付きの世界モデルとして機能すると同時に、制御ポリシーとしても動作することを実現しました。性能評価において、WorldArena 1.0では比較対象となったすべての世界アクションモデルやビデオジェネレーターを上回り、軌跡、深度、3D精度の面でトップティアの精度を達成しています。
技術・詳細
GreenWAMの構築には、以下の3つの主要なレシピが採用されています。
- 共通の解剖学的アクションスペース: 20のロボットファミリーを共通の関節座標で記述し、身体的な差異を吸収しています。
- 共同トレーニング: 視覚、アクション条件付き、およびワールドアクションの各モードで、複数のロボットファミリーを用いて共同学習を行っています。
- ポリシーの分離: ジェネレーターからアクションエキスパートを切り離すことで、制御ポリシーとして機能させています。
ベンチマークにおいては、RoboTwin 2.0リーダーボードでトップクラスのスコアを記録したほか、LIBERO-plusでは比較手法の中で最高のゼロショット成功率を達成しました。また、CALVINおよびLIBEROにおいても、専用のVision-Language-Action(VLA)モデルや世界アクションポリシーと同等の競争力を示しています。
背景・業界の文脈
一般的に、ロボットには「アクションがシーンをどう変化させるか」を予測する世界モデルと、「どのアクションを選択するか」を決定するポリシーの2つが必要ですが、従来はこれらが個別のモデルとして構築され、評価されてきました。さらに、ロボットごとにアクションの記録形式が異なることが、汎用的なモデル構築の障壁となっていました。GreenWAMは、共通の座標系と統合的な学習アプローチを用いることで、単一のモデルにこれら両方の役割を持たせ、異なる身体構造を持つロボット間での互換性を解決しようとしています。
今後の展望
実機への適用試験では、実際のヒューマノイドにおいて、π0.5やCosmos 3 Edgeから適応させたポリシーよりも高い成功率を記録しました。また、リアルタイム制御を実現するために、モデルをシングルステップポリシーへと蒸留することにも成功しています。制御実験の結果、ロボットの専門化が世界予測と制御の両方を向上させることや、ポリシー適応時に世界モデルモードを維持することがシーン変更に対する堅牢性を保持することが明らかになりました。
元記事: https://huggingface.co/papers/2610.18774
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます