主要成果
新たなVision-Language-Action (VLA) モデル「TurboVLA」が発表され、NVIDIA RTX 4090 GPU上で平均97.6%という高い成功率を維持しつつ、31.2ms(約32Hz)の超低推論レイテンシと1GB未満のVRAM消費でリアルタイム性能を達成しました。この成果は、ロボットの行動計画における効率性と実用性を大きく向上させます。
技術・臨床詳細
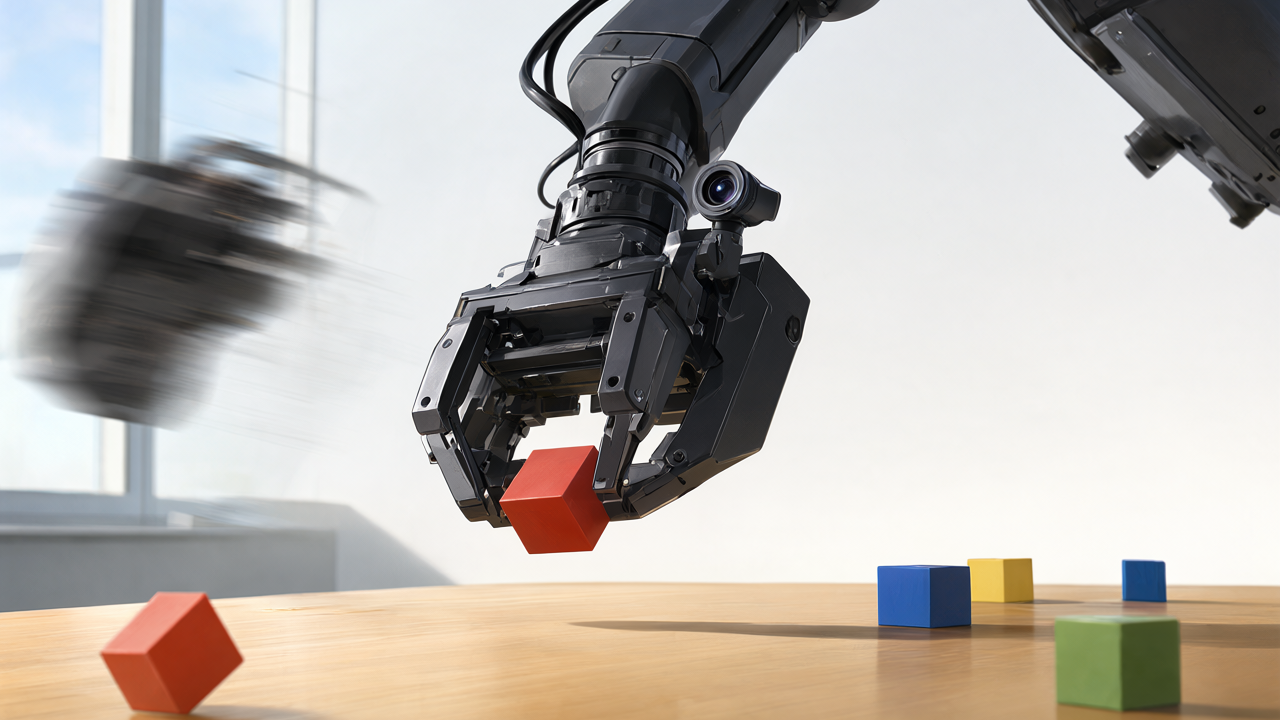
TurboVLAは、従来のLLM(大規模言語モデル)中心のVision→Language→Action(V→L→A)経路とは異なり、より直接的なVision+Language→Action(V+L→A)マッピングを採用することで、優れた効率性を実現しています。この設計アプローチにより、推論ステップが簡素化され、計算リソースの消費が大幅に削減されます。LIBEROベンチマーク(ロボットの器用さを評価する標準的なタスクセット)における評価では、TurboVLAは平均97.6%という非常に高いタスク成功率を達成しました。さらに、RTX 4090グラフィックカード上での実行において、わずか31.2msの推論レイテンシ(これは約32フレーム/秒に相当し、リアルタイム応答に十分な速さ)と、0.9GiB未満という極めて少ないVRAM(ビデオメモリ)使用量で動作することを示しました。この低レイテンシと低リソース消費は、高性能なVLAモデルを、より広範なハードウェアプラットフォーム、特にエッジデバイスや電力制約のあるシステムへ展開する上で決定的な優位性をもたらします。
背景・業界文脈
Vision-Language-Action (VLA) モデルは、ロボットが視覚情報と自然言語指示を理解し、複雑なタスクを実行するための強力な枠組みを提供します。しかし、既存のVLAモデルの多くは、大規模な計算リソースと高い推論レイテンシを必要とするため、産業用途や実時間性が求められる環境での導入が課題となっていました。TurboVLAは、これらの制約を克服し、リアルタイムかつ効率的なロボットの行動計画と制御を実現するための重要なブレークスルーです。これは、人型ロボット、サービスロボット、産業用マニピュレータなど、さまざまな自律システムにおける実用化への道を大きく開くものです。
今後の展望
TurboVLAの登場は、高効率かつ低リソースで動作するVLAモデルの実現可能性を示し、ロボットAIの新たな標準を打ち立てる可能性があります。この技術は、工場や倉庫での迅速なピッキング作業、家庭でのアシスタントロボット、さらには災害現場での探索・救助ロボットなど、幅広いアプリケーションでのリアルタイム性と信頼性を向上させます。将来的に、このような最適化されたVLAモデルは、より安価でエネルギー効率の高いロボットシステムを可能にし、自律ロボットの普及を加速させるでしょう。
元記事: https://www.alphaxiv.org/abs/2607.27205
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます