主要成果
自動運転システムにおいて、4Dレーダーが提供する幾何学的および運動学的キューは、従来の視覚的セマンティクスを補完し、より堅牢な環境認識を可能にします。本研究では、この4Dレーダーの利点をVision-Language-Action(VLA)モデルに統合する新しいフレームワーク「RCVLA」を提案し、自動運転の計画精度と安全性を向上させることに成功しました。RCVLAは、Cap4DRおよびOmniHD-QAデータセットで評価され、その有効性が実証されています。
技術・臨床詳細
RCVLAフレームワークは、主に以下の2つの革新的なステージで構成されています。
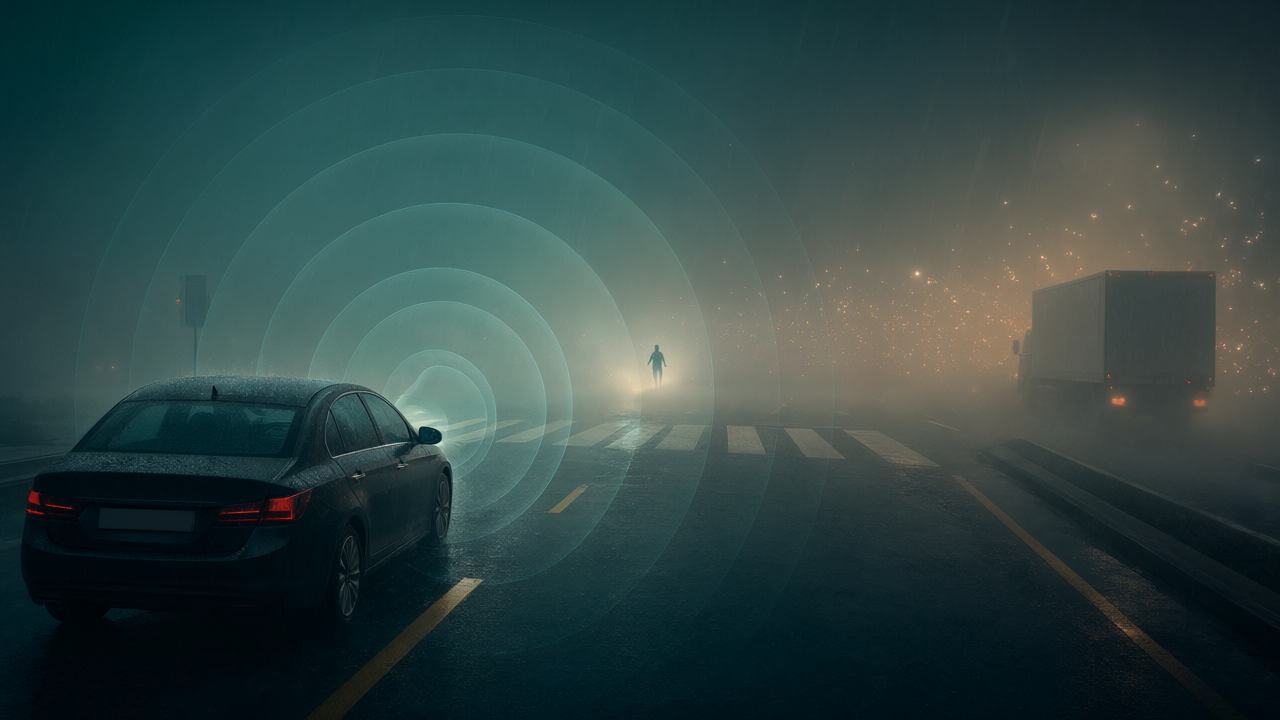
- レーダーに基づく意味推論ステージ: 4Dレーダーデータは、その点群情報から物体の位置、速度、方向といった詳細な幾何学的・運動学的情報を抽出できます。RCVLAでは、このレーダーデータを視覚情報と連携させ、VLAモデルが周囲の環境に対するより深い「意味的理解」を得るための推論を行います。例えば、遠方の車両の速度変化や、雨霧などの悪天候下での車両や歩行者の検出精度が向上します。
- 軌道仲裁ステージ: 意味推論の結果に基づき、RCVLAは複数の可能な走行軌道を評価し、最も安全で効率的な軌道を決定するための「仲裁」を行います。これは、衝突リスクの低減、スムーズな車線変更、最適な速度プロファイルの維持といった、実際の運転における重要な決定に直結します。特に、不確実性の高い状況や、視覚情報だけでは判断が難しいシナリオにおいて、レーダーの堅牢な情報が最終的な軌道選択の信頼性を高めます。
この統合されたアプローチにより、RCVLAは、Cap4DRやOmniHD-QAといったデータセットにおけるテストで、既存の純粋な視覚ベースVLAモデルと比較して、特に悪条件下での頑健性と計画性能において優位性を示しました。
背景・業界文脈
自動運転技術の進化は、センサーフュージョンと高度なAIモデルに大きく依存しています。カメラは豊富な視覚情報を提供しますが、悪天候や照明条件に弱く、距離測定の精度にも限界があります。LiDARは高精度な3D点群を提供しますが、高価であり、雨や雪の影響を受けやすい側面があります。一方、4Dレーダーは、悪天候下でも比較的安定した性能を発揮し、物体の速度情報を直接測定できるという独自の利点を持っています。RCVLAは、この4Dレーダーの強みをVLAモデルに統合することで、単一センサーの限界を克服し、より信頼性の高い全天候型自動運転システムへの道を開きます。これは、自動運転の普及を加速する上で不可欠な技術進歩と言えます。
今後の展望
RCVLAフレームワークは、自動運転技術の次の段階を牽引する可能性を秘めています。4DレーダーとVLAモデルのシームレスな統合は、実世界での自動運転車の安全性と信頼性を大幅に向上させ、より複雑な環境での自律走行を可能にするでしょう。将来的には、この技術が量産車に実装され、雨、雪、霧といった悪条件下でも安全な自動運転を実現するのに役立つことが期待されます。さらなる研究では、RCVLAのリアルタイム処理能力の最適化や、さまざまな車種や運転スタイルへの適応性が検証されることになります。この進歩は、自動運転車が真の意味で全天候型・全環境型となるための重要なマイルストーンとなるでしょう。
元記事: https://arxiv.org/abs/2609.32681
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます