TECHNOLOGY EXPLAINER
ソフトウェアとクラウドアクセス
― 量子コンピュータを「使う」ための道具と、利用の流れ
量子コンピュータは、遠くの研究所や、データセンターの冷凍機の中にあります。では、私たちはどうやって使うのでしょうか。 答えは、手元のパソコンで「回路」を書き、ネットワーク越し(クラウド)に送り、結果を受け取る、という流れです。 この記事は、①量子プログラムとは何か(「回路を書く」ことの意味)、②Qiskit、Cirq、CUDA-Q などのソフトウェア開発キット(SDK)の地図、③理想の回路を機械向けに直すコンパイラ(トランスパイラ)、④クラウドの使い方と、「shots」の意味、⑤量子と古典を組み合わせるハイブリッド実行を、図と、実際に動かした小さな例で説明します。 特定の製品の優劣は論じません。素材技術者の方に向けて、材料計算とのつながりと、データ管理の注意も添えます。
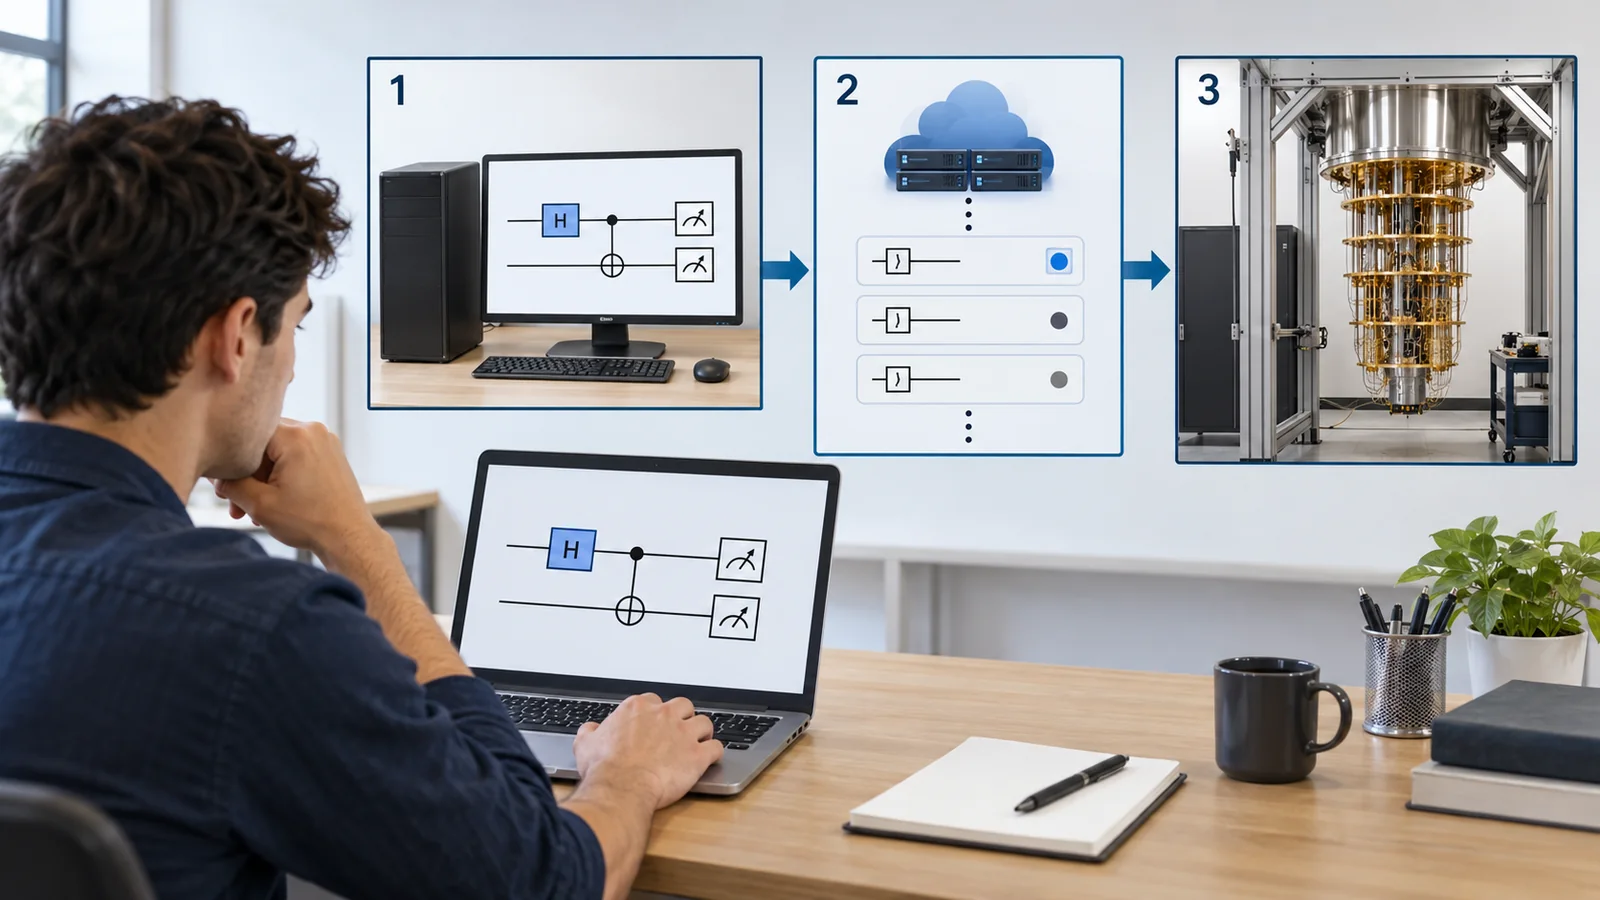
- 3行でつかむ/前提/シリーズの中での位置
- 量子プログラムとは ― 「回路を書く」
- SDKの地図 ― Qiskit、Cirq、CUDA-Q ほか
- コンパイラとトランスパイラ ― 「理想の回路」を「その機械の言葉」へ
- クラウド経由の利用 ― 注文から結果まで
- 量子と古典のハイブリッド実行
- 素材技術者の視点 ― 材料計算とのつながり、データの扱い
- 確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出・実行した値
未確定/将来=企業の計画、標準案など、確定していない事項
このほか、読み取りや説明は「解説」として区別しています。推測は太字で示します。
ソフトウェアの版(バージョン)、サービスのプラン、料金体系は頻繁に変わります。本稿の版の数字は2026年10月16日に PyPI で確認した最新版(Qiskit 2.6.0、Cirq 1.7.0、CUDA-Q 0.16.0、PennyLane 0.45.1)です。 図と文中のコードの実行結果は、本稿が手元のシミュレータで実際に動かした値で、実機の結果ではありません。サービスの料金は、変わりやすいので金額は書きません。特定の SDK・サービスの優劣は論じません。
1. 3行でつかむ/前提/シリーズの中での位置
- 量子プログラム=回路:量子コンピュータへの命令は、「量子ビットにどのゲートをどの順にかけ、最後に測るか」を並べた回路で書きます。結果は1つの答えではなく、何回も測った0と1の並びの分布(shots)として返ります。
- 使い方の流れ:手元で回路を書いて試し(シミュレータ)、トランスパイラでその機械のゲートとつなぎ方に直し、クラウドへ送り、順番を待ち、実行された結果を受け取ります。最先端の用途では、量子と古典をハイブリッドに何度も往復させます
- 見るべき点:同じ回路でも、つなぎ方と最適化の強さで、2量子ビットゲートの数が大きく変わります(本稿の実行では、5量子ビットの例で56個から30個、全結合なら20個)。「量子ビットの数」だけでなく、変換後の回路の大きさと、実行の速さが実質の性能を決めます本稿の計算
量子ビットは「矢印」で表せ、測ると0か1のどちらかに決まり、元の状態は戻らないこと、量子ゲートは矢印の向きを変える操作であること、が分かれば足ります。 くわしくは本シリーズ「量子コンピュータの基礎」「量子ゲートと量子回路」編で説明します。ここでも、必要な場面で短く言い直します。プログラミングの経験は、あると読みやすいですが、必須ではありません。
「量子ゲートと量子回路」を読んだあとに読むと、分かりやすい記事です。この記事の話の裏側にある冷凍機と配線は「極低温と制御」編、機械の性能の見かたは「コヒーレンスとフィデリティ」「量子優位性の読み方」編で扱います。量子と古典の組み合わせは「NISQとハイブリッド計算」編とも関連します。
2. 量子プログラムとは ― 「回路を書く」
(1) 身近な例:楽譜と、演奏の録音
楽譜は、「どの音を、どの順に鳴らすか」を並べたものです。量子プログラムの回路も同じで、「どの量子ビットに、どのゲートを、どの順にかけるか」を並べたものです。 違いは、演奏の結果です。普通のプログラムは、同じ入力なら同じ出力を返します。量子プログラムは、最後に測ると、結果が確率で決まります。そこで、同じ回路を何百回、何千回と実行し、出た結果を数えます。この繰り返しの回数を shots(ショット)と呼びます。
(2) 最小の例:ベル状態を作って、測る
最もよく使われる小さな例を見てみましょう。2つの量子ビットで、①最初の量子ビットにHゲート(矢印を斜めにして、重ね合わせにする)、②CNOTゲート(1つ目が1のときだけ、2つ目を反転する。2つを「もつれ」させる)、③両方を測る、という3つの命令です。
理想的には、測った結果は「00」か「11」で、半々の確率で出ます。「01」や「10」は出ません。2つの量子ビットが、1つのまとまりとして振る舞っているからです。これが量子もつれです。 本稿が手元のシミュレータで1000回測ったところ、「00」が502回、「11」が498回でした本稿の計算(実行結果。コードは下の折りたたみ)。
実際のコード:同じ回路を、4つの SDK で書く(本稿が実行して確認。クリックで開く)
Qiskit(2.6.0):回路を作り、StatevectorSampler(手元の理想的なシミュレータ)で1000回測ります。
from qiskit import QuantumCircuit
from qiskit.primitives import StatevectorSampler

qc = QuantumCircuit(2, 2)
qc.h(0)                      # q0 を重ね合わせに
qc.cx(0, 1)                  # q0 を制御に、q1 をもつれさせる
qc.measure([0, 1], [0, 1])   # 2つを測って、古典ビットに書く

result = StatevectorSampler(seed=7).run([qc], shots=1000).result()
print(result[0].data.c.get_counts())   # {'11': 498, '00': 502}(辞書の順は不定)
Cirq(1.7.0)
import cirq

q0, q1 = cirq.LineQubit.range(2)
c = cirq.Circuit(cirq.H(q0), cirq.CNOT(q0, q1), cirq.measure(q0, q1, key='m'))
r = cirq.Simulator(seed=7).run(c, repetitions=1000)
print(r.histogram(key='m'))   # Counter({0: 512, 3: 488})(0 は「00」、3 は「11」を整数で読んだ値)
CUDA-Q(0.16.0)
import cudaq

@cudaq.kernel
def bell():
    q = cudaq.qvector(2)
    h(q[0])
    x.ctrl(q[0], q[1])
    mz(q)

cudaq.set_random_seed(7)
print(cudaq.sample(bell, shots_count=1000))   # { 00:499 11:501 }
PennyLane(0.45.1)
import pennylane as qml

dev = qml.device('default.qubit', wires=2, shots=1000, seed=7)

@qml.qnode(dev)
def bell():
    qml.Hadamard(wires=0)
    qml.CNOT(wires=[0, 1])
    return qml.counts()

print(bell())   # 「00」が502回、「11」が498回(数値は NumPy の型で表示される)
4つとも、同じ内容(H → CNOT → 測定)で、結果は「00」と「11」が半々に近い値でした(本稿の計算。乱数の種が違えば、回数は少し変わります)。書き方の違い(Python のクラスか、関数か、デコレータか)は、SDK の設計の違いです。本稿の実行では、PennyLane は「デバイスに shots を直接渡す書き方は非推奨」という警告を、CUDA-Q は「sample と observe の仕様が将来変わりうる」という警告を出しました。SDK は版が上がると書き方が変わるので、コードには版の番号を添えて残します。
OpenQASM 3 での表現(Qiskit の出力):
OPENQASM 3.0;
include "stdgates.inc";
bit[2] c;
qubit[2] q;
h q[0];
cx q[0], q[1];
c[0] = measure q[0];
c[1] = measure q[1];誤りです。上のベル回路でも、測ると「00」か「11」のどちらか1つが出ます。重ね合わせの全部を取り出すことはできません。 量子アルゴリズムの腕の見せどころは、正しい答えの確率が強め合い、間違った答えの確率が弱め合う(干渉)ように回路を設計することです(本シリーズ「量子アルゴリズム」編)。 また、「量子コンピュータでは普通のプログラム(if や for)がそのまま速く動く」というのも誤りです。プログラム全体の司令塔は古典のコンピュータで、量子チップは、その中の「回路を実行する」という一部の仕事だけを受け持ちます。
回路図では、q₀ が上、q₁ が下です。でも、Qiskit の結果の文字列「00」「11」は、右端が q₀、左端が q₁(リトルエンディアン)の並びで書かれます(本記事による解説)。 ベル状態では「00」と「11」だけなので、どちらでも同じですが、一般の回路では、並びの向きを取り違えて解釈を誤る失敗が起こりやすい点です。SDK ごとに並びの約束が違うので、使う SDK の文書で確認します。
3. SDKの地図 ― Qiskit、Cirq、CUDA-Q ほか
回路を書く道具が、SDK(ソフトウェア開発キット)です。多くは、Python で回路を組み立て、シミュレータや実機に送れます。次の表は、確認できた主な SDK の整理です。優劣を示すものではありません。
| SDK | 公式の説明(要旨) | ライセンス | 最新版(2026年10月16日、PyPI) |
|---|---|---|---|
| Qiskit | 拡張された量子回路、演算子、「プリミティブ」の水準で、量子コンピュータを扱うためのオープンソース SDK[参考資料18]。設計と構成、実行環境の組み立てを論文で解説[参考資料1] | Apache-2.0 | 2.6.0 |
| Cirq | ノイズのある中規模量子(NISQ)回路を作り、編集し、実行する Python のフレームワーク[参考資料19] | Apache-2.0 | 1.7.0 |
| CUDA-Q | 量子と古典の混在(ヘテロジニアス)の作業のために、C++ と Python で書ける CUDA Quantum のプログラミングモデル[参考資料20]。GPU でのシミュレーションと、QPU への接続を扱う[参考資料16] | Apache-2.0 | 0.16.0 |
| PennyLane | 量子コンピュータの「微分可能プログラミング」。変分量子回路の勾配を、機械学習の逆伝播と互換な形で計算でき、各社のハードウェアへのプラグインを持つ[参考資料15・21] | Apache-2.0 | 0.45.1 |
| tket | 言語に依存しない最適化コンパイラ。多様な NISQ 機向けのコードを生成[参考資料14・22] | Apache-2.0 | (確認していない) |
| Q#/Microsoft Quantum Development Kit | Q# 言語、資源見積もりツール、教材(Katas)を含む開発キット[参考資料23] | MIT | (確認していない) |
| Amazon Braket SDK | Amazon Braket 上の量子デバイスを操作するための Python SDK[参考資料24] | Apache-2.0 | (確認していない) |
| OQTOPUS | 日本で開発された、クラウド型の量子計算システムの運用までを含むオープンソースの全体構成。トランスパイラ、マルチプログラミング、誤り抑制を実装[参考資料26] | (確認できなかった) | ― |
各 SDK の説明は、GitHub の公式リポジトリの記載、論文の要旨、PyPI の公開情報によります(確認日 2026年10月16日)[参考資料18〜25]事実。表の整理は本記事の解説です。tket の開発元は、リポジトリが Quantinuum の組織に移っています。
回路の「共通語」:OpenQASM と QIR
SDK が違っても、回路を機械に伝えるには、共通の書き方が要ります。 OpenQASM(オープンな量子アセンブリ言語)は、その代表です。OpenQASM 3 は、回路を書くだけでなく、「量子ビットのコヒーレンス時間内に行う実時間の古典計算」と「それより緩い近時間の計算」を区別し、制御の流れ(if など)や外部の古典関数の呼び出しも書けるようにしました[参考資料9]事実。公開されている仕様は v3.1.0(2024年5月公開)です[参考資料10]。 QIR(量子中間表現)は、量子プログラムを、一般のコンパイラが使う LLVM の中間表現の上で表す仕様で、QIR Alliance という共同の取り組みが仕様を作っています[参考資料11]事実。 どちらも、国際標準化機構(ISO)などの規格ではなく、コミュニティや企業が管理する仕様です(本稿では、規格化は確認できなかった)。
たとえば、料理のレシピを、日本語、英語、フランス語で書けても、厨房(実機)が理解するのは、その厨房の「社内用語」だけ、という状況を想像してください。SDK は「レシピを書く言語」、OpenQASM や QIR は、各国語に翻訳しやすい「共通の中間言語」、トランスパイラは「その厨房の社内用語への翻訳者」にあたります(たとえの限界:実機の「社内用語」は、機械ごとに違う、使えるゲートとつなぎ方の組です)。
4. コンパイラとトランスパイラ ― 「理想の回路」を「その機械の言葉」へ
(1) 身近な例:直通の道が限られた街での配送
荷物を、ある家から遠い別の家へ届けたいとします。ところが、その街では、隣り合う家の間にしか、道がつながっていません。遠い家へは、隣へ隣へと、手渡しで運ぶしかありません。手渡しが増えるほど、時間がかかり、荷物が傷む(誤りが増える)おそれも増えます。 量子コンピュータのチップも、似た事情を持っています。2量子ビットゲート(2つの量子ビットにまたがる操作)は、物理的につながった組にしかかけられないのが普通です。そこで、書いた回路を、そのチップのつながり方と使えるゲートの種類に合わせて書き直す必要があります。この書き直しをするプログラムが、トランスパイラ(コンパイラの一種)です。 (たとえの限界:配送は荷物そのものを運びますが、量子ビットの場合は、状態を隣へ移す「SWAP」という操作を使います。SWAP 1回は CNOT 3回分に相当し、手渡しのたびに、誤りの種が増えます。)
(2) なぜ書き直しが要るのか
- 使えるゲートが決まっている:実機は、少数の「基底ゲート」だけを直接実行します。それ以外のゲートは、基底ゲートの組み合わせに分解します
- つながりが限られる:2量子ビットゲートをかけたい2つの量子ビットが、直接つながっていなければ、SWAP で隣へ動かします。つながりの自由度は、量子ビットの方式で違います(方式ごとの記事を参照)
- ゲートは少ないほど、誤りが少ない:特に2量子ビットゲートは誤りが大きいので、減らす価値があります(本記事による解説)
(3) Qiskit のトランスパイラの6つの段階
Qiskit の公式文書は、トランスパイルを6つの段階に分けて説明しています[参考資料2]事実。
図の「layout」は、回路の量子ビット(論理的な番号)を、チップ上の物理量子ビットに割り当てる段階です。「routing」は、離れたペアを SWAP でつなぐ段階です。 最適化のレベルは 0〜3 で、数が大きいほど重い処理で、ゲートの数を減らそうとします[参考資料2]。 この SWAP の入れ方を最小にする問題は、NP困難(量子ビットが増えると、正確に解くための計算量が急増する種類の問題)として知られ、実用的には近似的な方法が使われます。Qiskit の標準は SABRE という方法で、初期の配置を乱数で変えながら探すため、確率的に決まります(Li、Ding、Xie が2019年に提案[参考資料12])。 Qiskit の開発者らは、SABRE を改良した LightSABRE について、「約200倍速く、SWAP を18.9%減らせた」と報告しています[参考資料13]事実(論文の著者らの報告。条件や比較の対象は論文を確認してください)。 別の開発系の tket も、特定の機械に依存せずに回路を最適化するコンパイラとして知られています[参考資料14]。
(4) 実際にやってみた:同じ回路が、条件で何倍も変わる
5量子ビットの量子フーリエ変換(QFT)を例にしました。QFT は多くの量子アルゴリズムの部品で、ほぼすべての量子ビットの組が絡むため、つながりの制約の影響が見えやすい回路です。Qiskit 2.6.0 の transpile で、基底ゲートを rz・sx・x・cz に指定し、変換しました(乱数の種は11)本稿の計算。
| 条件 | CZ ゲートの数(2量子ビットゲート) | 回路の深さ |
|---|---|---|
| 変換前(基底を p・cx・u にしただけ。つながりの制約なし) | 26個(CNOT) | 34 |
| 一列につながったチップ・最適化レベル0 | 56個 | 194 |
| 一列・レベル1 | 50個 | 123 |
| 一列・レベル2、レベル3 | 30個 | 82 |
| 全結合(どの2つも直接つながる)・レベル3 | 20個 | 56 |
本稿の計算。「深さ」は、並列に実行できるゲートを同じ段にまとめたときの段数で、実行時間の目安になります。乱数の種を20通り(0〜19)に変えて試したところ、CZ の数は条件ごとに一定で、レベル1の一列の深さだけが120〜130の範囲で動きました(本稿の例に限った結果。他の回路では、数が変わりうる)。「一列」「全結合」は例であり、実在のチップの接続ではありません。
読み取り:同じ回路でも、一列につながったチップでは、最適化を弱くすると CZ が56個、強くすると30個になりました。全結合なら20個です(本稿の計算)。 2量子ビットゲートが多いほど、結果に誤りが積み重なりやすいので、「量子ビットの数」より前に、「変換後の回路がどれだけ大きくなるか」が、実際に動くかどうかを左右します。ここで、チップの接続の自由度と、トランスパイラの賢さの両方が効いてきます。
この章の「論理量子ビット」は、回路の上での番号(プログラムの変数名のようなもの)という意味です。「物理量子ビット」は、チップ上の実体の量子ビットです。トランスパイラは、この対応表(layout)を決めます。 一方、誤り訂正の記事(本シリーズ「量子誤り訂正と表面符号」「論理量子ビットと耐故障量子計算」)で出てくる「論理量子ビット」は、多数の物理量子ビットを束ねて作る、誤りに強い量子ビットのことで、同じ言葉でも別の意味です。この記事の layout は、誤り訂正の話ではありません。
(5) もっと広い「コンパイル」
トランスパイルは、回路の水準の変換です。その下には、パルス(マイクロ波の波形)の水準の制御があり、その上には、アルゴリズムを回路に落とす段階があります。 誤り訂正を行う機械では、さらに、論理ゲートを物理ゲートの列に展開する段階(格子手術など。論理量子ビットの記事を参照)や、誤りを読み取って訂正を決める「デコード」が加わります。これらは、ソフトウェアにも、非常に速い古典処理(第6章)にも関わります。
5. クラウド経由の利用 ― 注文から結果まで
(1) 身近な例:共同利用の装置に、試料と測定条件を送る
素材の分野では、高価な電子顕微鏡や放射光施設を、共同利用することがあります。試料と測定の条件を送ると、順番が来たときに、施設の人が測定し、データが返ってきます。 量子コンピュータのクラウド利用は、これによく似ています。「試料」にあたるのが回路、「測定条件」にあたるのが実行回数(shots)などの設定です。順番を待つ列をキュー、1回の依頼をジョブと呼びます。
(2) 利用の流れ
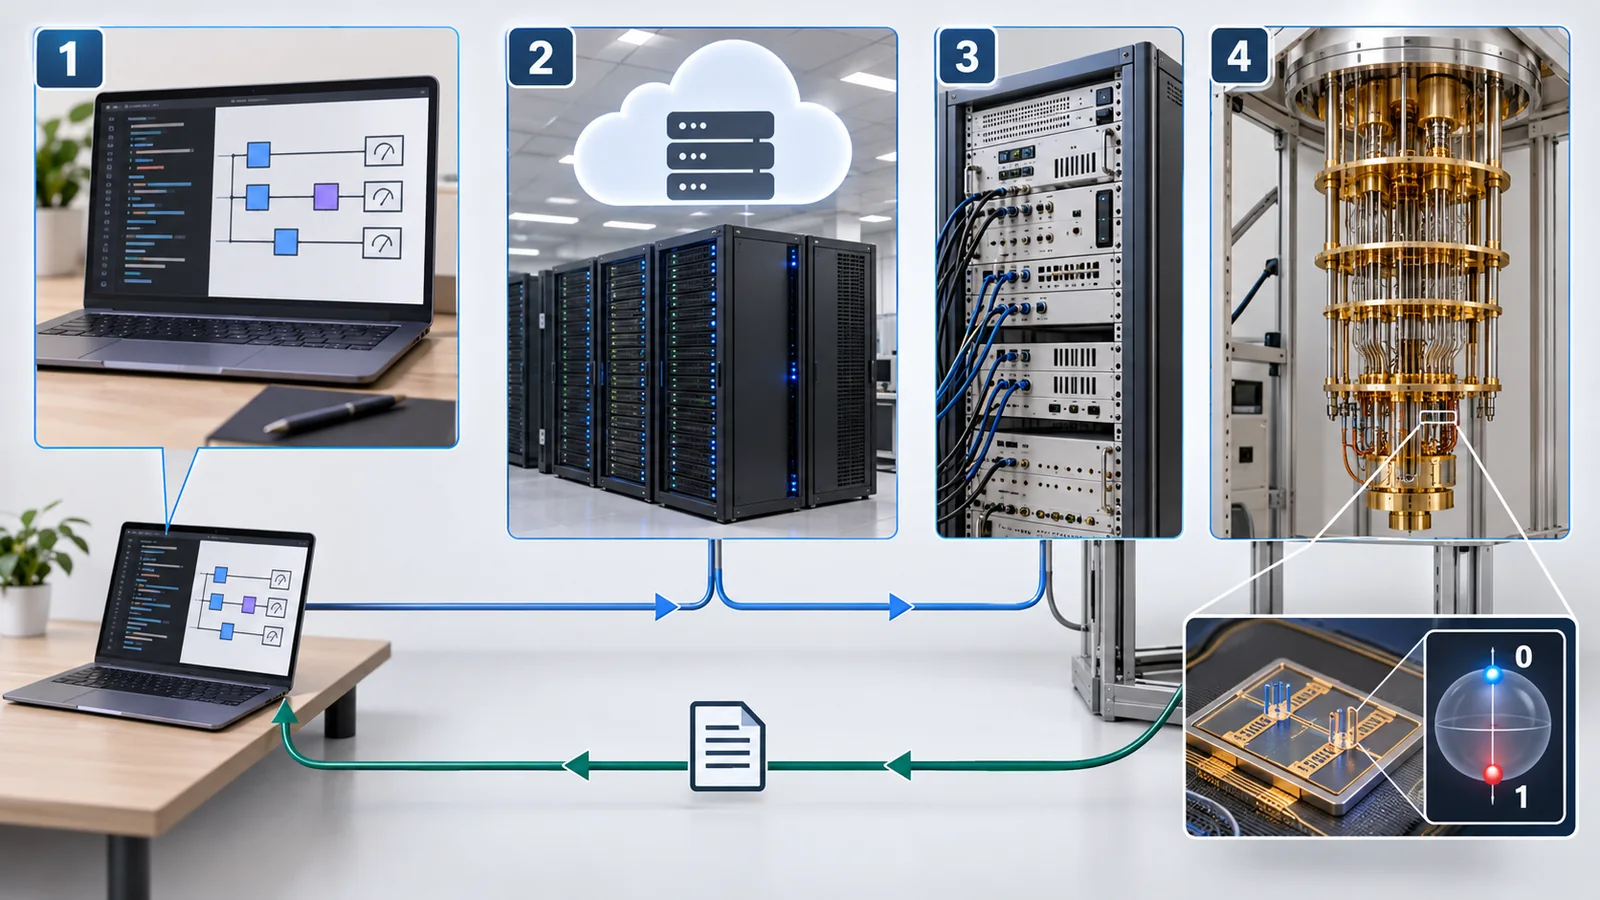
元のSVG・数値・出典を確認する
元SVGの説明:概念図(ベクター作図)。クラウドで量子コンピュータを使う流れの概念図です。利用の数え方は IBM と Amazon Braket の公式資料[参考資料5・6]によります。実際のサービスの流れは異なる場合があります。
8つの手順のうち、1〜3と8は手元の古典コンピュータで行います。4〜7がクラウドと量子チップの仕事です。2の「小さく試す」が重要です。実機は貴重で、待ち時間も、利用の量の数え方(課金)もあるので、書いた回路が意図どおりか、まず手元のシミュレータで確かめるのが定石です(本記事による解説)。
(3) shots ― 同じ回路を何回も実行する理由
量子ビットを測ると、結果は確率で決まります。そこで、同じ回路をN回実行して、出た結果の頻度を数えます。この回数 N が shots です。ある結果が出る確率 p を、頻度で見積もると、見積もりには統計的な誤差(標準誤差)が残り、その大きさは √(p(1−p)/N) です。N を100倍にしても、誤差は10分の1にしか減りません。
統計的な揺らぎは減りますが、ハードウェアの誤りは減りません。shots を増やして減るのは、「回数が少ないために生じる偶然のばらつき」だけです。ゲートや測定の誤り、ノイズによる偏りは、何回測っても残ります(これを系統的な誤りと呼びます)。 たとえば、ベル回路の「01」と「10」が、実機では少し出るのは、このハードウェアの誤りによるものです。誤りを減らすには、機械そのものの改善、誤り抑制(ソフトウェアで後から補正する方法)、誤り訂正が要ります。 また、shots を増やすと、実行時間も、場合によっては料金も増えます。たとえば、Amazon Braket は「依頼1件ごとの料金」と「shot 1回ごとの料金」の両方で、量子コンピュータの利用を数えます[参考資料6]。
(4) どのサービスで、どう使えるか
次の表は、本稿が公式の資料で確認できた内容の整理です。料金は変わりやすいので、金額は書いていません。サービスの優劣も論じません。
| サービス | 公式資料の説明(要旨) | 利用の数え方・プラン |
|---|---|---|
| IBM Quantum Platform | Qiskit から使うクラウド。プリミティブ(Estimator と Sampler)を通じて実行[参考資料3] | Open(無料。28日間の移動期間で最大10分)、Flex(400分以上を事前購入し、1年以内に使用)、従量課金(Pay-As-You-Go)、Premium、On-Prem(専用の設置型)[参考資料5]事実 |
| Amazon Braket | 量子コンピュータ、回路シミュレータ、ハイブリッド実行の管理サービス、ノートブック環境を提供[参考資料6]。ゲート型は AQT、IonQ、IQM、Rigetti、アナログ型は QuEra のデバイスを、同じ枠組みから利用できる[参考資料6] | オンデマンドは「依頼1件ごと」と「shot 1回ごと」の料金、または時間予約(1時間単位)[参考資料6]。シミュレータ SV1・DM1・TN1 は実行時間で課金[参考資料6]。ハイブリッドジョブでは PennyLane、CUDA-Q、Braket SDK を使える[参考資料6・7]事実 |
| Azure Quantum | Microsoft Azure の量子クラウド。実機、シミュレーション、将来の大規模機に必要な資源の見積もりを提供[参考資料8]。開発キット QDK は Q#、Qiskit、Cirq、OpenQASM に対応[参考資料8] | Azure アカウントと「ワークスペース」が必要[参考資料8]事実 |
| Quantinuum | 同社のサイトは、Helios を「オンプレミス、クラウド、またはその両方で使えるハードウェア・サービス」と案内[参考資料44] | (詳細は確認していない)事実 |
| IonQ | 同社のサイトは「Quantum Cloud」を案内[参考資料45] | (詳細は確認していない)事実 |
| OQTOPUS(オープンソース) | 日本で開発された、クラウド型の量子計算システムの運用基盤[参考資料26] | ― |
確認日 2026年10月16日。表の要旨は、各社の公式文書・ページによります。サービスの提供範囲、デバイスの種類、プラン名は、変わることがあります。Quantinuum と IonQ の利用条件は、本稿では確認していません。
(5) IBM の「実行モード」:ジョブ、バッチ、セッション
量子と古典を何度も往復する仕事(第6章)では、毎回キューに並び直すと、時間がかかります。そこで IBM のサービスには、並び方の違う3つの実行モードがあります[参考資料4]事実。
| モード | 公式文書の説明(要旨) | 向く仕事(本記事による整理) |
|---|---|---|
| ジョブ | 1回の依頼を、まとまりなしで送る | 1回の実行で済む仕事 |
| バッチ | 互いに独立な複数のジョブを、まとめて一度に送る。実行順は保証されず、他の利用者のジョブと並行して走ることがある。最初のジョブの待ち時間は短くならない | 条件を変えた回路を多数実行する仕事 |
| セッション | 一定の時間、システムを専有する窓。この間、他のジョブは走らず、較正のジョブも走らない。Open プランの利用者は、セッションのジョブを送れない | 結果に応じて次の回路を決める、反復的な仕事 |
出典:IBM Quantum の公式文書(参考資料4)。「専有」の意味や、時間の上限(TTL)の詳細は、同文書を確認してください。
バックエンドは、回路を実行する相手(実機やシミュレータ)。ジョブは、その相手に送る1件の依頼。プリミティブは、依頼の「型」で、Qiskit では、回路を何回も測って分布を得る Sampler と、観測量(エネルギーなど)の期待値を求める Estimator の2つです[参考資料3]。
Qiskit の文書は、従来の backend.run は、プリミティブに置き換えられた(Sampler が同じ直接の実行を提供する)と説明しています[参考資料3]事実。古い解説記事のコードが、今の版で動かない原因の1つです。
6. 量子と古典のハイブリッド実行
(1) 身近な例:味見をしながら、味を整える
料理で、鍋の味を整えるとき、あなたは「味見をして、調味料を足し、また味見をする」を繰り返します。ここで、味見をする役が量子チップ、どれだけ足すかを考える役が古典コンピュータです。 このように、量子の回路を「評価」に使い、古典コンピュータが結果を見て回路のパラメータ(回路の中の調整つまみ)を決め直す、という往復を繰り返す方式をハイブリッド(量子・古典混合)の実行といいます。
最も有名な例が、変分量子固有値ソルバー(VQE)です。分子のエネルギーを求めるために、パラメータ付きの回路で「試しの状態」を作り、そのエネルギーの期待値を量子チップで測ります。古典コンピュータが、期待値が小さくなる方向にパラメータを更新し、これを繰り返します。エネルギーの期待値が小さいほど、本当の最低エネルギーの状態に近い、という考え方(変分原理)に基づきます(本記事による解説)。 Peruzzo らが2014年に光量子プロセッサで原理を実演し[参考資料27]、Kandala らが2017年に、超伝導量子ビットで小さな分子などの基底状態のエネルギーを求めました[参考資料28]事実。
(2) 量子チップのそばの古典処理は、マイクロ秒の世界
ハイブリッドには、2つの時間の世界があります。
- 近時間(クラウド経由):回路を送って結果を受け取る往復で、待ち時間を含めて、秒〜分以上かかります。VQE のような往復は、この時間の世界で行います
- 実時間(量子ビットのコヒーレンス時間内):量子ビットが壊れる前に、測定結果を見て次の操作を決める古典処理です。誤り訂正のデコードなど、マイクロ秒の応答が要る処理がここに入ります
OpenQASM 3 の論文は、まさにこの区別を設計の柱に置いています。「量子ビットのコヒーレンス時間内に行う実時間の古典計算」と、それより緩い「近時間」の古典計算を扱えるようにし、制御の流れや外部の古典関数の呼び出しを書けるようにした、と述べています[参考資料9]事実。
図の数値は、各資料に書かれた値です。表面符号の1周期は約1.1 μs、デコーダの平均遅延は63 μs(距離5)と、Google の論文に報告されています[参考資料31]事実。 IBM は、qLDPC 符号のデコードを、古典のハードウェアで480ナノ秒未満の実時間で行えると発表しました[参考資料32]。NVIDIA は、量子チップとGPUをつなぐ NVQLink で、GPU と QPU の間のスループットが400 Gb/s、遅延が4マイクロ秒未満と説明し、Quantinuum の Helios でのデコードの反応時間が67マイクロ秒だったと述べています[参考資料17]。いずれも企業の発表(企業の主張)であり、測る対象や条件の違う数字を、単純に比べることはできません。
量子ビットの寿命(コヒーレンス時間)は限られ、誤り訂正では、測定結果を読んでからすぐ次の操作を決める必要があります。決めるのが遅いと、その間に量子ビットが誤りを溜めてしまいます。
そこで、制御の電子回路(FPGA など)と、デコード用の GPU やCPUを、量子チップのすぐそばに置き、専用の高速な通信でつなぐ設計が研究されています。NVIDIA のブログは、CUDA-Q のプログラムの中で、量子の処理から GPU や CPU の関数を直接呼び出す cudaq::device_call という仕組みを説明しています[参考資料46]。
通信の遅延、プログラミングの言語、制御ハードウェアが、ひとつながりの設計になるわけです。ソフトウェアとハードウェアの境界は、固定ではありません(本記事による解説)。
(3) スーパーコンピュータと組み合わせる例
量子チップの測定結果は、そのままでは雑音を含みます。そこで、測定結果を大規模な古典計算で処理して、化学の問題を解く方法が研究されています。 Robledo-Moreno らの研究(サンプルベース量子対角化、SQD と呼ばれる方法)は、超伝導プロセッサ Heron で得た測定結果(量子サンプル)を、スーパーコンピュータ「富岳」で処理し、窒素分子の解離と、鉄と硫黄を含む2種類のクラスター([2Fe-2S] と [4Fe-4S])の基底状態を計算したものです。最大77量子ビット、10,570ゲートの回路を使い、この方法は基底状態のエネルギーの上限値を与える、と述べています[参考資料29]事実。 また、Alexeev らは、量子とスーパーコンピュータを緊密に統合する「量子中心のスーパーコンピューティング」という構想を、材料科学の観点から整理した展望の論文を発表しています[参考資料30]。 IBM は、HPC(高性能計算)の環境から量子を直接プログラムできるよう、Qiskit に C API と、それを土台にした C++ のインターフェースを提供する、と2025年11月に発表しています[参考資料32](企業の説明)。
可能性の1つですが、実用上の優位が確立したとは言えません。上の研究は、量子と古典を組み合わせる方法の実演です。「古典コンピュータだけでは解けない問題を解けた」と結論づけているわけではありません(優位性の読み方は、本シリーズ「量子優位性の読み方」編を参照)。 また、ハイブリッドでは、古典側の計算量が大きいことも多く、「どこまでが量子の貢献か」を見分けにくい点にも注意が要ります(本記事による解説)。
7. 素材技術者の視点 ― 材料計算とのつながり、データの扱い
ソフトウェアの記事に、なぜ素材の視点があるのでしょうか。理由は3つあります。①量子コンピュータの用途の本命の1つが材料・化学の計算であること、②手元の古典コンピュータでシミュレーションする限界が、材料計算の現場の感覚に近いこと、③実験データと同じように、量子計算の結果にも記録と再現性の規律が要ることです。
手元のコンピュータで量子回路をそのまま模擬する「状態ベクトル法」では、n個の量子ビットの状態を2n個の複素数で覚えます。倍精度(16バイト)で数えると、必要なメモリは 16×2n バイトです(本稿の計算)。
量子ビットが1個増えるたびに、メモリは2倍になります。30量子ビットで16 GiB、40量子ビットで16 TiB、50量子ビットで16 PiBです(本稿の計算)。 材料計算の経験がある方は、電子の数が増えると、厳密な計算の規模が指数的に増えるという事情を思い出すでしょう。量子コンピュータが期待される理由も、同じ壁にあります。 Robledo-Moreno らは、現在の量子プロセッサ単独では、深い回路と多数の測定のために、実行時間が膨大になるため、量子でなければならない部分以外を、古典の分散計算に任せる方法を実演しました[参考資料29]事実。 「材料全体を量子コンピュータに載せる」のではなく、重要な部分に絞って小さな問題にし、残りは古典で処理する、という分担が現実的な見取り図です(本記事による解説。具体的な手順は各論文を参照)。 ただし、状態ベクトル法を使わない古典の方法(テンソルネットワークなど)は、一部の回路では、もっと大きな規模を扱えます。「50量子ビットなら古典では絶対に無理」という意味ではありません。
材料の測定結果を、試料のロット、装置、条件の記録なしに論文へ載せることは、まずありません。量子計算の結果も、同じ回路でも、機械、日時、ソフトウェアの設定で結果が変わるため、同じ規律が要ります。次の項目は、本稿の提案する記録の例です(本記事による整理。各サービスの必須項目ではありません)。
| 記録しておく項目 | なぜ必要か |
|---|---|
| 機械(バックエンド)の名前と、実行日時 | 機械ごとに、使えるゲートも、つながり方も、誤りの大きさも違う。IBM の文書は、バッチの途中で較正のジョブが走ることがあると述べており[参考資料4]、機械の状態が時間とともに更新されることが分かる |
| SDK とトランスパイラの版、最適化レベル、乱数の種 | トランスパイラは確率的な部分を含む。本稿の例では、種を変えても CZ の数は同じだったが、深さは変わった(第4章)。版が上がると、アルゴリズムが改良される(LightSABRE[参考資料13]) |
| 変換後の回路(OpenQASM 3 などで保存) | 「書いた回路」と「実際に実行された回路」は別物。後者を保存すれば、再実行や検証ができる |
| shots の数と、生のカウント(頻度) | 期待値に直した後では、統計的な誤差を後から見積もれない(第5章) |
| 誤り抑制などの後処理の設定 | 同じ測定データでも、後処理で結果が変わる |
| ジョブの識別番号、プラン(共有か専有か) | 問い合わせや再取得に必要。専有(セッション)かどうかで、較正の影響が違いうる[参考資料4] |
また、量子クラウドに送る回路や入力データは、外部のサービスに渡すデータです。素材メーカーの未公開の分子構造や組成を、回路のパラメータに含めて送る場合は、社内のデータ管理の規則に照らして扱ってください。IBM のプランには、専用の設置型(On-Prem)が用意されており、「資源とデータを強く管理したい」場合を想定した説明があります[参考資料5]事実。
トランスパイラは、回路の2量子ビットゲートの数を減らし、機械の状態に合わせた配置を選ぶことで、結果を改善できます(第4章)。でも、1つのゲートの誤りそのものは、チップの材料・加工・冷凍機・配線で決まります(本シリーズ「超伝導量子ビット」「極低温と制御」編)。回路を短くしても、1ゲートの誤りは変わりません。ソフトウェアとハードウェア(材料)は、両輪です(本記事による解説)。
もう1つ、素材分野に近い接点があります。PennyLane は、変分回路の勾配を、機械学習ライブラリと互換の形で計算できます[参考資料15]事実。材料のデータ解析や機械学習ポテンシャルと同じ Python の世界の道具と、量子の回路を、つなげられることを意味します(本記事による解説)。 さらに、OQTOPUS のように、運用基盤をオープンにする取り組みは、研究機関が自前の量子計算システムを運営するときの敷居を下げる、と提案者は述べています[参考資料26]。
8. 確認できなかったこと/まとめ
確認できなかったこと
- 待ち時間(キュー)の実測値と、料金の金額:変わりやすく、条件にも依存するため、数値を載せていません。
- tket、Q#/QDK、Braket SDK の最新版の番号:本稿が PyPI で確認したのは、Qiskit、Cirq、CUDA-Q、PennyLane の4つです。
- QIR の仕様のライセンス、OQTOPUS のライセンス:GitHub の表示では確認できませんでした(QIR の仕様のリポジトリは、ライセンスを「判定不能」と表示)。
- QIR と OpenQASM の国際規格化:ISO などの規格になっている記載は、確認できませんでした。
- Quantinuum と IonQ の、クラウド利用の条件や料金:公式サイトの案内の存在にとどめ、詳細は確認していません。
- IBM の「480ナノ秒未満のデコード」、NVIDIA の NVQLink の遅延・Quantinuum のデコード時間の第三者検証:企業の発表として扱い、独立の検証は確認していません。
- Qiskit の C API と C++ インターフェースの、2026年10月時点の公開状況:2025年11月の発表の記述にとどまります。
- 各ベンチマークの、機械ごとの最新の測定値:本稿では、指標の読み方に絞り、数値の一覧は載せていません。
- ISO/IEC 4879:2024 の本文、IEEE P7131 の発行状況:本文は有料、発行状況は確認できませんでした。
- SDK の利用者数・シェアの統計:確認できなかったため、「よく使われる」といった序列は書いていません。
- 量子プログラムは「回路」:H、CNOT、測定を並べた回路を、何回も実行して、出た結果の頻度を数える。ベル回路の実行では、「00」502回、「11」498回だった本稿の計算
- SDKは複数ある:Qiskit、Cirq、CUDA-Q、PennyLane などが、同じベル回路を書ける。回路の共通語として OpenQASM 3 と QIR がある(いずれも ISO などの規格ではない)事実
- トランスパイラが効く:5量子ビットのQFTは、一列につながったチップで、最適化の強さにより CZ が56個から30個になり、全結合なら20個だった本稿の計算
- クラウド利用:ジョブを送り、順番を待ち、結果を受け取る。shots を増やして減るのは統計的な揺らぎだけで、ハードウェアの誤りは減らない事実/本稿の計算
- ハイブリッド:近時間(秒〜分)の往復と、実時間(マイクロ秒)の古典処理が分かれる。後者の高速化を、企業が競っている(企業の主張)事実
- 素材技術者へ:シミュレータのメモリは、量子ビット1個ごとに2倍。実験ノートと同じ規律で、機械、版、乱数の種、shots、変換後の回路を記録する本稿の計算
9. 評価・標準の読み方
ソフトウェアとクラウドの「ものさし」は、①回路をどう書き、どう伝えるか(記述の仕様)、②機械の質、③速さ、④規模、⑤応用での性能です。ハードウェアの性能は、別の記事(「コヒーレンスとフィデリティ」「量子優位性の読み方」)でくわしく扱うので、ここでは、ソフトウェアと実行の側から見える指標を中心に整理します。確認日は2026年10月16日です。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・版・出典) | 標準・指針(ISO/IEC・IEEE など) | 読み方の注意 |
|---|---|---|---|
| 回路の記述・互換性 | OpenQASM 3:論文(ACM Trans. Quantum Comput. 3, 2022)[参考資料9]、仕様 v3.1.0(2024年5月15日公開)[参考資料10]。QIR:QIR Alliance の仕様[参考資料11]事実 | ISO などの規格になっている記載は確認できなかった。コミュニティ・企業が管理する仕様 | 仕様の版によって使える機能が違う。SDK が書き出す OpenQASM の版と、機械が受け付ける版が合うか確認する |
| 質(総合) | 量子体積(Quantum Volume):ランダムな回路で機械を検証する方法(Cross ら、Phys. Rev. A 100, 2019)[参考資料33]。Quantinuum は、2024年9月のブログで、量子体積が200万を超えたと述べている(企業の主張)[参考資料44]事実 | 確認できなかった | 量子体積は、機械の中の最も質の高い部分に注目し、合格・不合格の離散的な指標で、大規模機の平均の質を表しにくい、とされる(McKay らの指摘)[参考資料35] |
| 質(規模のある機械) | 層の忠実度(layer fidelity)と EPLG:つながった2量子ビットゲートの層の忠実度を、同時のランダム化ベンチマークで測る(McKay ら、arXiv:2311.05933)[参考資料35]事実 | 確認できなかった | どの量子ビットの鎖を選んだかで値が変わる。ここでは指標の考え方のみ紹介し、機械ごとの値は載せていない |
| 速さ | CLOPS(1秒あたりの回路の層の実行数):Wack ら(2021、arXiv:2110.14108)[参考資料34]。CLOPS_h:層状のハードウェア向き回路で持続的な処理率を測る定義(Wack、2026年8月、arXiv:2608.18044。プレプリント)[参考資料38]事実 | 確認できなかった | 古典の処理(変換、通信)も含んだ、利用者の体験に近い速さを測る意図。古い CLOPS と CLOPS_h は定義が違うので、混ぜて比べない |
| 3つの指標(規模・質・速さ) | IBM のブログ(2026年7月16日):プログラム可能な量子ビット、量子ビットの操作、1秒あたりの最大回路数[参考資料40](企業の説明) | 確認できなかった | 提案は機械の作り手によるもの。複数の方式に使えると説明されているが、他社が同じ定義で測っているかは、確認していない |
| 応用での性能 | QED-C の応用指向ベンチマーク(Lubinski ら、IEEE Trans. Quantum Eng. 4, 2023)[参考資料36]事実 | 確認できなかった | アルゴリズムごとの結果で、1つの数にまとまらない。SDK とトランスパイラの設定で結果が変わりうる |
| 計算能力(回路の大きさ×速さ) | QUOPS(Proctor ら、2026年9月、arXiv:2609.12146。プレプリント):成功裏に実行できる、計算上意味のある最大の回路の大きさと、実行の速さを測る。Quantinuum、Google、IBM のプロセッサに適用し、有用な計算に必要な能力は約5桁の増加が要ると述べる[参考資料37]事実 | 確認できなかった | 査読前のプレプリント。物理量子ビット上と論理量子ビット上の結果が混ざるので、どちらかを確かめる |
| 比較の基盤・標準化の提案 | Metriq:複数の機械の結果を集める、オープンソースの共同プラットフォーム(Cosentino ら、2026年3月、arXiv:2603.08680)[参考資料39]。Acuaviva ら:標準的な性能評価の方式を目指す提案(Quantum Sci. Technol. 11, 025004, 2026)[参考資料41]事実 | 提案の段階であり、国際規格ではない | 誰が、どの条件で測ったか、公開データか、を確かめる |
| 用語 | ―(評価ではなく用語の標準) | ISO/IEC 4879:2024 "Information technology — Quantum computing — Vocabulary"(2024年5月発行。本文は有料)[参考資料42]事実 | 用語を揃える標準。ソフトウェアの品質や性能の合否を決めるものではない。本文は未確認 |
| 性能指標・ベンチマークの標準案 | ― | IEEE P7131 の作業グループのサイト[参考資料43]未確定/将来 | 標準案の段階。発行状況は確認できなかった |
表の整理は解説(本記事による)。各指標の名称・出典・日付は、論文・公式ページで確認しました(確認日 2026年10月16日)。規格本文は有料のため、題名・適用範囲にとどめています。
読み方の注意(素材技術者向け)
- 「ベンチマークの数」は、条件込みの値です:同じ機械でも、トランスパイラの設定、ソフトウェアの版、較正の時刻で変わりえます。記録を添えない数字は、比べられません(第7章)
- 提案者と測定対象の関係を見てください:量子体積、CLOPS、層の忠実度は、IBM の研究者が提案した指標が中心です[参考資料33・34・35]。他社も使っているか、独立の第三者が測っているかは、別に確かめます
- プレプリントと査読済みを分けてください:CLOPS_h、QUOPS、Metriq は、2026年のプレプリントです[参考資料37・38・39]
- 物理量子ビットか、論理量子ビットか:QUOPS の論文には、物理量子ビット上の評価と、論理量子ビット上の評価の両方があります[参考資料37]。数の意味が全く違います
- 標準は、まだ用語の段階です:ISO/IEC 4879 は用語の標準で、法的拘束力はありません(一般に、規格は法令や契約で引用されて初めて拘束力を持ちます。本記事による解説)。性能指標の標準は、IEEE P7131 などの標準案の段階で、確立した合意はまだ確認できません
10. 用語集
- 量子回路
- 量子ビットにかけるゲートと測定を、順に並べた命令の列。
- ゲート
- 量子ビットの状態を変える操作。H、CNOT など。
- 基底ゲート
- その機械が直接実行できる、少数のゲートの組。他のゲートは、これに分解する。
- 測定
- 量子ビットを読み出し、0か1に決めること。結果は確率で決まる。
- shots
- 同じ回路を繰り返し実行して測る回数。
- 標準誤差
- 頻度から確率を見積もるときの、統計的な誤差の目安。√(p(1−p)/N)。
- SDK
- ソフトウェア開発キット。回路を書き、シミュレータや実機へ送る道具。
- Qiskit/Cirq/CUDA-Q/PennyLane
- 代表的な量子の SDK。いずれもオープンソース(Apache-2.0)。
- OpenQASM
- 量子回路を書くためのアセンブリ風の言語。第3版は実時間の古典処理も扱う。
- QIR
- 量子プログラムを、LLVM の中間表現の上で表す仕様。
- トランスパイラ
- 回路を、その機械のゲートとつなぎ方に合わせて書き直すプログラム。
- layout/routing
- 回路の量子ビットを物理量子ビットに割り当てる段階/離れたペアを SWAP でつなぐ段階。
- SWAP
- 2つの量子ビットの状態を入れ替える操作。CNOT 3回分に相当。
- 回路の深さ
- 並列に実行できるゲートを同じ段にまとめたときの段数。実行時間の目安。
- NP困難
- 規模が増えると、厳密に解く計算量が急増する種類の問題。
- QFT
- 量子フーリエ変換。多くの量子アルゴリズムの部品。
- バックエンド
- 回路を実行する相手。実機またはシミュレータ。
- ジョブ/キュー
- 1件の実行依頼/順番待ちの列。
- プリミティブ
- Qiskit の依頼の型。Sampler(サンプリング)と Estimator(期待値の推定)。
- バッチ/セッション
- 複数ジョブをまとめて送る方式/一定時間システムを専有する方式(IBM)。
- 較正(キャリブレーション)
- 機械の動作の調整と、誤りなどの測定。定期的に更新される。
- 状態ベクトル法
- 古典コンピュータで量子状態を2n個の数で持って模擬する方法。
- ハイブリッド(量子・古典混合)
- 量子の回路と古典の計算を、往復させて使う方式。
- VQE/SQD
- 変分量子固有値ソルバー/サンプルベース量子対角化。化学の問題に使う、量子・古典混合の方法。
- 実時間/近時間
- 量子ビットのコヒーレンス時間内の古典処理/それより緩い時間の古典処理。
- QPU
- 量子処理装置(量子チップ)。
- デコード
- 誤り訂正で、測定結果から誤りの場所を推定する古典処理。
- HPC
- 高性能計算。スーパーコンピュータによる計算。
- 量子体積/CLOPS/EPLG
- 機械の質/速さ/規模での質を表すベンチマーク(第9章)。
11. 参考資料(一次情報)
- Javadi-Abhari A. ほか "Quantum computing with Qiskit", arXiv:2405.08810 (2024) — arxiv.org/abs/2405.08810
- IBM Quantum "Transpiler stages"(Qiskit の公式文書。確認日 2026年10月16日) — quantum.cloud.ibm.com/docs/en/guides/transpiler-stages
- IBM Quantum "Introduction to primitives"(公式文書。確認日 2026年10月16日) — quantum.cloud.ibm.com/docs/en/guides/primitives
- IBM Quantum "Introduction to Quantum Compute execution modes"(公式文書。確認日 2026年10月16日) — quantum.cloud.ibm.com/docs/en/guides/execution-modes
- IBM Quantum "Plans overview"(公式文書。確認日 2026年10月16日) — quantum.cloud.ibm.com/docs/en/guides/plans-overview
- Amazon Web Services "Amazon Braket pricing"(公式ページ。確認日 2026年10月16日) — aws.amazon.com/braket/pricing/
- Amazon Web Services "What is Amazon Braket?"(公式文書) — docs.aws.amazon.com/braket/…/braket-what-is-Braket.html
- Microsoft "What is Azure Quantum?"(公式文書。確認日 2026年10月16日) — learn.microsoft.com/…/overview-azure-quantum
- Cross A. ほか "OpenQASM 3: A Broader and Deeper Quantum Assembly Language", ACM Transactions on Quantum Computing 3, 1–50 (2022), DOI 10.1145/3505636 — doi.org/10.1145/3505636
- OpenQASM GitHub リポジトリ(仕様 v3.1.0、2024年5月15日。公式サイトは openqasm.com。ライセンス Apache-2.0。確認日 2026年10月16日) — github.com/openqasm/openqasm
- QIR Alliance "Quantum Intermediate Representation"(公式サイト。確認日 2026年10月16日) — qir-alliance.org
- Li G.、Ding Y.、Xie Y. "Tackling the Qubit Mapping Problem for NISQ-Era Quantum Devices", ASPLOS '19, 1001–1014 (2019), DOI 10.1145/3297858.3304023 — doi.org/10.1145/3297858.3304023
- Zou H. ほか "LightSABRE: A Lightweight and Enhanced SABRE Algorithm", arXiv:2409.08368 (2024) — arxiv.org/abs/2409.08368
- Sivarajah S. ほか "t|ket⟩: a retargetable compiler for NISQ devices", Quantum Sci. Technol. 6, 014003 (2020), DOI 10.1088/2058-9565/ab8e92 — doi.org/10.1088/2058-9565/ab8e92
- Bergholm V. ほか "PennyLane: Automatic differentiation of hybrid quantum-classical computations", arXiv:1811.04968 (2018) — arxiv.org/abs/1811.04968
- NVIDIA "CUDA-Q"(公式文書。確認日 2026年10月16日) — nvidia.github.io/cuda-quantum/latest/
- NVIDIA "World's Leading Scientific Supercomputing Centers Adopt NVIDIA NVQLink to Integrate Grace Blackwell Platform With Quantum Processors", プレスリリース (2025年11月17日)(企業の発表) — nvidianews.nvidia.com/news/scientific-supercomputing-centers-nvqlink-…
- Qiskit GitHub リポジトリ(ライセンス Apache-2.0。確認日 2026年10月16日) — github.com/Qiskit/qiskit
- Cirq GitHub リポジトリ(Apache-2.0) — github.com/quantumlib/Cirq
- CUDA-Q GitHub リポジトリ(Apache-2.0) — github.com/NVIDIA/cuda-quantum
- PennyLane GitHub リポジトリ(Apache-2.0) — github.com/PennyLaneAI/pennylane
- tket GitHub リポジトリ(Quantinuum の組織。Apache-2.0) — github.com/Quantinuum/tket
- Microsoft Quantum Development Kit(Q#)GitHub リポジトリ(MIT) — github.com/microsoft/qdk
- Amazon Braket SDK GitHub リポジトリ(Apache-2.0) — github.com/amazon-braket/amazon-braket-sdk-python
- PyPI の各パッケージのページ(qiskit 2.6.0、cirq 1.7.0、cudaq 0.16.0、pennylane 0.45.1。確認日 2026年10月16日) — pypi.org/project/qiskit/、pypi.org/project/cirq/、pypi.org/project/cudaq/、pypi.org/project/pennylane/
- Kakuko N. ほか "A Practical Open-Source Software Stack for a Cloud-Based Quantum Computing System"(OQTOPUS), arXiv:2507.23165 (2025)、IEEE QCE 2025, DOI 10.1109/QCE65121.2025.00092 — arxiv.org/abs/2507.23165
- Peruzzo A. ほか "A variational eigenvalue solver on a photonic quantum processor", Nature Communications 5, 4213 (2014), DOI 10.1038/ncomms5213 — doi.org/10.1038/ncomms5213
- Kandala A. ほか "Hardware-efficient variational quantum eigensolver for small molecules and quantum magnets", Nature 549, 242–246 (2017), DOI 10.1038/nature23879 — doi.org/10.1038/nature23879
- Robledo-Moreno J. ほか "Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer", Science Advances 11, eadu9991 (2025), DOI 10.1126/sciadv.adu9991(arXiv:2405.05068) — doi.org/10.1126/sciadv.adu9991
- Alexeev Y. ほか "Quantum-centric Supercomputing for Materials Science: A Perspective on Challenges and Future Directions", Future Generation Computer Systems (2024), DOI 10.1016/j.future.2024.04.060(arXiv:2312.09733) — arxiv.org/abs/2312.09733
- Google Quantum AI and Collaborators "Quantum error correction below the surface code threshold", Nature 638, 920–926 (2025), DOI 10.1038/s41586-024-08449-y(arXiv:2408.13687) — doi.org/10.1038/s41586-024-08449-y
- IBM "IBM Delivers New Quantum Processors, Software, and Algorithm Breakthroughs on Path to Advantage and Fault Tolerance", プレスリリース (2025年11月12日)(企業の発表) — newsroom.ibm.com/2025-11-12-ibm-delivers-new-quantum-processors,->newsroom.ibm.com/2025-11-12-ibm-delivers-new-quantum-processors
- Cross A. W. ほか "Validating quantum computers using randomized model circuits", Phys. Rev. A 100, 032328 (2019), DOI 10.1103/PhysRevA.100.032328 — doi.org/10.1103/PhysRevA.100.032328
- Wack A. ほか "Quality, Speed, and Scale: three key attributes to measure the performance of near-term quantum computers", arXiv:2110.14108 (2021) — arxiv.org/abs/2110.14108
- McKay D. C. ほか "Benchmarking Quantum Processor Performance at Scale", arXiv:2311.05933 (2023) — arxiv.org/abs/2311.05933
- Lubinski T. ほか "Application-Oriented Performance Benchmarks for Quantum Computing", IEEE Transactions on Quantum Engineering 4, 1–32 (2023), DOI 10.1109/TQE.2023.3253761 — doi.org/10.1109/TQE.2023.3253761
- Proctor T. ほか "Benchmarking the computational power of quantum computers", arXiv:2609.12146 (2026年9月)(プレプリント) — arxiv.org/abs/2609.12146
- Wack A. "CLOPS: Benchmarking System Speed at Utility Scale", arXiv:2608.18044 (2026年8月)(プレプリント) — arxiv.org/abs/2608.18044
- Cosentino A. ほか "Metriq: A Collaborative Platform for Benchmarking Quantum Computers", arXiv:2603.08680 (2026年3月)(プレプリント) — arxiv.org/abs/2603.08680
- McKay D. ほか(IBM) "How to measure the performance of a quantum computer", IBM Quantum ブログ (2026年7月16日)(企業の説明) — ibm.com/quantum/blog/hardware-metrics-2026
- Acuaviva A. ほか "Benchmarking quantum computers: towards a standard performance evaluation approach", Quantum Sci. Technol. 11, 025004 (2026), DOI 10.1088/2058-9565/ae4269 — doi.org/10.1088/2058-9565/ae4269
- ISO/IEC 4879:2024 "Information technology — Quantum computing — Vocabulary"(2024年5月発行)。セルビア規格協会(ISS)の掲載ページで、番号・題名・発行日・「Published」を確認 — iss.rs/en/project/show/iso:proj:80432
- IEEE P7131 作業グループ "Quantum Benchmarking Working Group P7131"(量子コンピューティングの性能指標とベンチマークの標準案を扱う作業グループのサイト) — sagroups.ieee.org/7131
- Quantinuum "Technical perspective: By the end of the decade, we will deliver universal, fully fault-tolerant quantum computing", 公式ブログ (2024年9月)。サイトの案内に Helios の提供形態(オンプレミス/クラウド)、本文に量子体積200万超の記述 — quantinuum.com/blog/technical-perspective…
- IonQ "IonQ roadmap"(公式ページ。サイトの案内に Quantum Cloud。確認日 2026年10月16日) — ionq.com/roadmap
- NVIDIA "NVIDIA NVQLink Architecture Integrates Accelerated Computing with Quantum Processors", NVIDIA Technical Blog(企業の説明) — developer.nvidia.com/blog/nvidia-nvqlink-architecture-…
12. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| Qiskit が、量子情報科学のための SDK であり、回路の表現と最適化、新しいゲートへの対応、動的回路による量子・古典の混合計算、周辺のツールとプラグインを扱うこと | Javadi-Abhari ら(2024)の要旨 出典1 https://arxiv.org/abs/2405.08810 | 事実 |
| トランスパイルの6つの段階(init、layout、routing、translation、optimization、scheduling)、最適化レベル0〜3、SabreSwap が確率的であること | IBM Quantum の公式文書 出典2 https://quantum.cloud.ibm.com/docs/en/guides/transpiler-stages | 事実 |
| プリミティブ(Sampler と Estimator)が backend.run に置き換わる位置づけであること | IBM Quantum の公式文書 出典3 https://quantum.cloud.ibm.com/docs/en/guides/primitives | 事実 |
| ジョブ、バッチ、セッションの3つの実行モードの説明(バッチの実行順は保証されない、セッションは専有で較正のジョブも走らない、Open プランはセッション不可) | IBM Quantum の公式文書 出典4 https://quantum.cloud.ibm.com/docs/en/guides/execution-modes | 事実 |
| IBM のプラン(Open:28日間の移動期間で最大10分、Flex:400分以上の事前購入、従量課金、Premium、On-Prem:専用の設置型) | IBM Quantum の公式文書 出典5 https://quantum.cloud.ibm.com/docs/en/guides/plans-overview | 事実 |
| Amazon Braket の料金の考え方(依頼1件ごと+shot 1回ごと、または時間予約。シミュレータ SV1・DM1・TN1、ハイブリッドジョブ、AQT・IonQ・IQM・Rigetti・QuEra のデバイス、IonQ の誤り緩和では1依頼あたり2,500 shots 以上) | AWS の料金ページ 出典6 https://aws.amazon.com/braket/pricing/ 出典7 https://docs.aws.amazon.com/braket/latest/developerguide/braket-what-is-Braket.html | 事実 |
| Azure Quantum が、実機、シミュレーション、資源見積もりを提供すること。QDK が Q#、Qiskit、Cirq、OpenQASM に対応し、無料でオープンソースであること | Microsoft の公式文書 出典8 https://learn.microsoft.com/en-us/azure/quantum/overview-azure-quantum | 事実 |
| OpenQASM 3 が、実時間と近時間の古典計算、制御の流れ、外部の古典関数の呼び出しを扱うこと。仕様 v3.1.0(2024年5月15日) | Cross ら(2022)、公式サイトと GitHub 出典9 https://doi.org/10.1145/3505636 出典10 https://github.com/openqasm/openqasm | 事実 |
| QIR が LLVM の中間表現の上で量子プログラムを表す仕様であり、QIR Alliance が仕様を作っていること | QIR Alliance の公式サイト 出典11 https://www.qir-alliance.org/ | 事実 |
| SABRE(確率的な量子ビット割り当てとルーティング)の提案。LightSABRE が約200倍速く、SWAP を平均18.9%減らしたとの報告(著者らの報告)。tket が特定の機械に依存しないコンパイラであること | Li ら(2019)、Zou ら(2024)の要旨、Sivarajah ら(2020)の題名 出典12 https://doi.org/10.1145/3297858.3304023 出典13 https://arxiv.org/abs/2409.08368 出典14 https://doi.org/10.1088/2058-9565/ab8e92 | 事実 |
| PennyLane が、変分回路の勾配を機械学習の逆伝播と互換な形で計算できること。ハードウェアへのプラグインがあること | Bergholm ら(2018)の要旨 出典15 https://arxiv.org/abs/1811.04968 | 事実 |
| CUDA-Q が量子と古典の混在の作業のためのプログラミングモデルであること。NVQLink の GPU–QPU スループット400 Gb/s、遅延4マイクロ秒未満、Quantinuum Helios でのデコード反応時間67マイクロ秒(企業の発表)。cudaq::device_call の説明 | NVIDIA の文書、プレスリリース、技術ブログ 出典16 https://nvidia.github.io/cuda-quantum/latest/ 出典17 https://nvidianews.nvidia.com/news/scientific-supercomputing-centers-nvqlink-grace-blackwell-quantum-processors 出典46 https://developer.nvidia.com/blog/nvidia-nvqlink-architecture-integrates-accelerated-computing-with-quantum-processors/ | 事実 |
| Qiskit、Cirq、CUDA-Q、PennyLane、tket、Braket SDK のライセンスが Apache-2.0、Microsoft QDK が MIT であること | 各 GitHub リポジトリの表示(確認日 2026年10月16日) 出典18 https://github.com/Qiskit/qiskit 出典19 https://github.com/quantumlib/Cirq 出典20 https://github.com/NVIDIA/cuda-quantum 出典21 https://github.com/PennyLaneAI/pennylane 出典22 https://github.com/Quantinuum/tket 出典23 https://github.com/microsoft/qdk 出典24 https://github.com/amazon-braket/amazon-braket-sdk-python | 事実 |
| 2026年10月16日時点の PyPI の最新版(Qiskit 2.6.0、Cirq 1.7.0、CUDA-Q 0.16.0、PennyLane 0.45.1) | PyPI の各ページ 出典25 https://pypi.org/project/qiskit/ | 事実 |
| OQTOPUS が、クラウド型の量子計算システムの運用基盤で、トランスパイラ、マルチプログラミング、誤り抑制を実装し、GitHub で公開されていること | Kakuko ら(2025)の要旨 出典26 https://arxiv.org/abs/2507.23165 | 事実 |
| VQE を2014年に光量子プロセッサで実演、2017年に超伝導量子ビットで BeH₂ までの分子(最大6量子ビット)の基底状態エネルギーを決定 | Peruzzo ら(2014)、Kandala ら(2017) 出典27 https://doi.org/10.1038/ncomms5213 出典28 https://doi.org/10.1038/nature23879 | 事実 |
| Heron と富岳で、N₂ の解離と [2Fe-2S]・[4Fe-4S] クラスターを、最大77量子ビット・10,570ゲートの回路で計算。基底状態エネルギーの上限値を与える。量子単独では、深い回路と多数の測定で実行時間が膨大になること。量子中心のスーパーコンピューティングの材料科学での展望 | Robledo-Moreno ら(2025)、Alexeev ら(2024)の要旨 出典29 https://doi.org/10.1126/sciadv.adu9991 出典30 https://arxiv.org/abs/2312.09733 | 事実 |
| 表面符号の1周期約1.1 μs、リアルタイムデコーダの平均遅延63 μs(距離5) | Google(2025) 出典31 https://doi.org/10.1038/s41586-024-08449-y | 事実 |
| IBM が qLDPC 符号のデコードを480ナノ秒未満の実時間で行えたとの発表。Qiskit の C API と C++ インターフェースの提供(2025年11月の発表)(企業の発表) | IBM のプレスリリース 出典32 https://newsroom.ibm.com/2025-11-12-ibm-delivers-new-quantum-processors,-software,-and-algorithm-breakthroughs-on-path-to-advantage-and-fault-tolerance | 事実 |
| 量子体積、CLOPS(2021)、層の忠実度・EPLG、QED-C の応用指向ベンチマークの提案 | Cross ら(2019)、Wack ら(2021)、McKay ら(2023)、Lubinski ら(2023) 出典33 https://doi.org/10.1103/PhysRevA.100.032328 出典34 https://arxiv.org/abs/2110.14108 出典35 https://arxiv.org/abs/2311.05933 出典36 https://doi.org/10.1109/TQE.2023.3253761 | 事実 |
| QUOPS(Quantinuum、Google、IBM に適用。約5桁の能力向上が要るとの結論。Helios-1 の最大8個の [[7,1,3]] 論理量子ビットでの評価)、CLOPS_h、Metriq、IBM の3つの指標、Acuaviva らの提案 | 各プレプリント・ブログ・論文 出典37 https://arxiv.org/abs/2609.12146 出典38 https://arxiv.org/abs/2608.18044 出典39 https://arxiv.org/abs/2603.08680 出典40 https://www.ibm.com/quantum/blog/hardware-metrics-2026 出典41 https://doi.org/10.1088/2058-9565/ae4269 | 事実 |
| ISO/IEC 4879:2024 "Information technology — Quantum computing — Vocabulary" が2024年5月に発行(Published)されたこと | セルビア規格協会(ISS)の掲載ページ 出典42 https://iss.rs/en/project/show/iso:proj:80432 | 事実 |
| IEEE P7131 の作業グループが、量子コンピューティングの性能指標とベンチマークの標準案を技術範囲としていること。発行状況は確認できなかった | 作業グループのサイト 出典43 https://sagroups.ieee.org/7131 | 未確定/将来 |
| Quantinuum が Helios を、オンプレミス、クラウド、その両方で提供すると案内していること。量子体積200万超の記述(企業の主張)。IonQ のサイトが Quantum Cloud を案内していること | 各社の公式ページ 出典44 https://www.quantinuum.com/blog/technical-perspective-by-the-end-of-the-decade-we-will-deliver-universal-fault-tolerant-quantum-computing 出典45 https://www.ionq.com/roadmap | 事実 |
| ベル回路の結果(Qiskit:「00」502回・「11」498回、Cirq:512・488、CUDA-Q:499・501、PennyLane:502・498。乱数の種7、1000 shots)、OpenQASM 3 の出力。5量子ビット QFT の変換結果(変換前:p30・cx26・u5、深さ34。一列:レベル0で CZ 56・深さ194、レベル1で50・123、レベル2と3で30・82、全結合・レベル3で20・56。種0〜19で CZ は一定、レベル1の深さは120〜130)。標準誤差(100 shots で±5%、1000 で1.6%、10⁴で0.5%、10⁵で0.16%、10⁶で0.05%)。状態ベクトルのメモリ(16×2ⁿ バイト:20量子ビットで16 MiB、30で16 GiB、40で16 TiB、50で16 PiB) | 本稿の計算(Python 3、Qiskit 2.6.0、Cirq 1.7.0、CUDA-Q 0.16.0、PennyLane 0.45.1。ローカルのシミュレータ。仮定は本文に明記)。実機の結果ではない | 本稿の計算 |
| 待ち時間と料金の金額、tket・QDK・Braket SDK の最新版、QIR と OQTOPUS のライセンス、QIR・OpenQASM の国際規格化、Quantinuum と IonQ の利用条件、企業発表の遅延・速度の第三者検証、Qiskit C API の2026年10月時点の公開状況、機械ごとの最新のベンチマーク値、ISO/IEC 4879 の本文、IEEE P7131 の発行状況、SDK の利用者数・シェア | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「楽譜と演奏」「共同利用の装置」「味見をしながら味を整える」「直通の道が限られた街での配送」というたとえ、素材の観点の読み取り(次元の壁との類似、実験ノートと同じ記録の規律、ソフトとハードの両輪、記録項目の例)、ベンチマークの読み方の注意 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図1と図7がImageGen生成の概念画像であること。他の図が実データの観察ではなく説明のための作図であること | 本記事による注記 | 解説 |
最終更新:2026年10月16日/出典は一次情報(公式文書、査読論文、arXiv の論文、GitHub・PyPI の公開情報、各社の公式ページ、ISO 規格の掲載ページ)に限定しています。企業の発表・計画は区別しました。 ソフトウェアの版、サービスのプラン、料金は頻繁に変わります。コードの実行結果と数値の試算は、本稿の計算(ローカルのシミュレータ)で、実機の結果ではありません。 待ち時間と料金の金額、一部の SDK の最新版、QIR と OQTOPUS のライセンス、国際規格化の状況、Quantinuum と IonQ の利用条件、企業発表の速度の第三者検証、Qiskit C API の公開状況、機械ごとの最新のベンチマーク値、ISO/IEC 4879 の本文、IEEE P7131 の発行状況、SDK の利用者数については、確認できなかったため記載していません。 図はすべて説明用の概念図または本稿の計算を含む作図で、図1と図7はImageGen生成の概念画像です。