TECHNOLOGY EXPLAINER
ロボット基盤モデルとVLA
― 「見て、言葉を聞いて、動く」AIのしくみと、その成績の読み方
近年、画像と言葉の指示を入力して、ロボットの行動を直接出力するAI(VLA:視覚・言語・行動モデル)が次々に発表されています。RT-2、OpenVLA、π0、GR00T N1、Gemini Robotics など、名前は多いのですが、中身は「ウェブの画像と文章で学んだ大きなモデルに、ロボットの行動を出させる」という共通の考え方です。 この記事では、素材技術者にもなじみやすいたとえで、VLAの基本の形、行動を出す3通りの方法、主なモデルの位置づけを説明します。後半では、ベンチマーク(LIBERO など)の成功率をどう読むか、実演動画をどう見るか、そして評価と標準の読み方を、論文と本稿の小さな計算で確かめます。特定のモデルの優劣は論じません。
- ロボット基盤モデルとVLAとは何か(3行でつかむ)
- 「基盤モデル」というたとえ ― 多くのロボットの経験から学ぶ
- VLAの中身 ― 画像・言葉・状態から行動へ
- 行動の「出し方」3通りと、速さの話
- 主なモデルを読む ― 何を報告し、どう公開されているか
- ベンチマークの読み方 ― LIBERO を例に
- 実演動画と「汎用」の言葉をどう見るか
- 素材技術者の視点②:「機体の違い」は、材料と部品の違い
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・草案・策定中などで、確定していない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
この分野は変化が速く、モデルや評価の状況は数か月で変わります。本記事のモデル名・日付・状況は2026年10月25日に公開資料で確認した範囲です。ロボットの成功率や処理速度は、各論文が選んだロボット・課題・環境・試行回数・計算機での報告値で、多くは開発した研究グループ自身の測定です。異なる設定の数字を並べて、モデルの優劣は論じません。「汎用」「世界初」といった言葉は、開発元の主張として扱います。 第4章・第6章の計算は、論文の値を使った算術です(実在の機体の性能ではありません)。規格(ISO)は番号・題名・段階の確認にとどめ、本文は確認していません。
1. ロボット基盤モデルとVLAとは何か(3行でつかむ)
- VLAは「見て・言葉を聞いて・動く」モデル:カメラ画像と言葉の指示(例:「赤いコップを皿へ」)、ロボットの状態を入力すると、数ステップ分の行動が出てきます。ウェブの画像・文章で事前に学んだ視覚言語モデル(VLM)を土台にする点が共通です事実[参考資料2]
- 行動の出し方が設計の要:各次元を256段階に区切って「文字」として出す方式(RT-2、OpenVLA)、圧縮して少ない文字にする方式(FAST)、連続の値をなめらかに生成する方式(π0、GR00T N1)があります事実[参考資料2・5・8・7・11]。高い周波数(50 Hz など)の器用な作業では、この選び方が効きます
- ベンチマークの97%は、現場の97%ではない:同じ LIBERO でも、入力や微調整の設定で数字が変わります事実[参考資料6]。さらに、条件を少し変えると成績が大きく下がるという報告(プレプリント)もあります事実[参考資料16・17]。成功率は、ロボット・課題・試行回数・微調整の有無・自律かどうか、を添えて読みます
シリーズ共通のたとえでは、物理AI・ロボット基盤モデルは「多くのロボットの経験から、一般的な動かし方を学んだAI」です。たとえの限界は、一般的に見えても、学習していない状況には弱いことです。 もう一つ、方策という言葉を使います。見えているもの(観測)から次の行動を返す関数で、VLAは、それをとても大きなニューラルネットワークで作ったものです。ロボットは「感じる(センサー)・考える(制御と知能)・動く(アクチュエータ)」の組合せで、VLAは「考える」の中心にあたります。
本シリーズ「世界モデルと身体性AI」編は、世界モデルとあわせてVLAの流れと主なモデルの一覧を概観しています。この記事は、その続きとして、VLAの中身(行動の出し方)とベンチマークの読み方を深掘りします。「模倣学習と強化学習」編は学び方の二大系統を、「遠隔操作とデータ収集」編は学習データの集め方を、「ロボットシミュレーションとデジタルツイン」編は評価にも使うシミュレータを、「ロボット制御の基礎」編はVLAが出した目標を動かす低い層を扱います。
成功率の数字は、「どのロボットで、どの課題を、何回、どんな設定で」を添えて初めて意味を持ちます。 条件の書かれていない「汎用ロボットが○○%」は、比較にも期待にも使えません。
2. 「基盤モデル」というたとえ ― 多くのロボットの経験から学ぶ
ロボットを動かすAIは、これまで機体と作業ごとに作り直すのが普通でした。1台のロボットの1つの作業のために、データを集めて学習する、という具合です。基盤モデルの考え方は、これを変えます。先に、多様で大量のデータで一般的な能力を学び(事前学習)、あとで自分のロボット・自分の作業のデータで調整する(微調整)のです。
たとえば、Open X-Embodiment は、21機関が22種類のロボットで集めた527のスキル(160,266の課題)のデータを標準の形式にまとめ、そこで学習したモデルが、他のロボットの経験から「正の転移」を示したと報告しています[参考資料3]事実。Octo は、そのデータの80万の軌跡で学習したオープンなモデルで、新しいセンサーや行動空間に、消費者向けのGPUで数時間で微調整できると述べています[参考資料4]事実。
事前学習は「出発点」です。自分のロボットの手の形、摩擦、カメラの位置、作業台の様子は、事前学習のデータと違うので、たいてい微調整が必要です。OpenVLA の論文も、VLA は新しいロボットの設定では微調整が必要になる、という問題意識から、効率のよい微調整の方法を研究しています[参考資料5](本記事による解説を含む)。
3. VLAの中身 ― 画像・言葉・状態から行動へ
VLAの基本の形を、図で見ます。入力は3種類で、画像、言葉の指示、ロボットの状態(関節の角度など)です。これを、ウェブの画像・文章で事前学習した視覚言語モデル(VLM)が受け取り、最後に行動を出す部分が、数ステップ分の行動を出します。
元のSVG・補足説明・出典を確認
元SVGの説明:概念図(ベクター作図)。画像・言葉・ロボットの状態を入れると、数ステップ分の行動が出てくるモデルです。ウェブの画像・文章で学んだ知識を土台にする点が、RT-2[参考資料2]以降の VLA の共通点です。図は大づかみな整理で、特定のモデルの内部構造ではありません。
(1) RT-2:行動を「言葉の一種」として扱う
RT-2 は、ウェブ規模のVLMを、ロボットの軌跡データとウェブの視覚言語課題(画像についての質問応答など)で一緒に微調整し、ロボットの行動をテキストのトークンとして、言葉と同じ形式で出すようにしました。このようなモデルを VLA と呼んだ、と論文は述べています。6,000回の評価試行で、新しい物体への汎化や、学習データにない指示の解釈などを報告しています[参考資料2]事実。
(2) OpenVLA:オープンな7BのVLA
OpenVLA は、97万の実ロボットの実演で学習した7B(70億)パラメータのオープンなVLAです。Llama 2 の言語モデルに、DINOv2 と SigLIP の視覚特徴を組み合わせています。29課題で、55BのRT-2-Xを絶対成功率で16.5%上回り(パラメータは7分の1)、新しい設定への微調整では Diffusion Policy を20.4%上回ったと報告しています(論文の設定での値)[参考資料5]事実。
(3) π0 と GR00T N1:行動を出す専用の部分を持つ
- π0は、3BのVLM(PaliGemma)に、約3億パラメータの行動エキスパートを加えた、計33億パラメータのモデルです。行動はフローマッチングで連続値として生成し、50ステップ分の行動の塊(行動チャンク)を、最大50 Hzで扱えるとしています[参考資料7]事実
- GR00T N1は、2つの系を持ちます。VLMの System 2 が環境と指示を解釈し(10 Hz、L40 GPU)、拡散トランスフォーマーの System 1 が、なめらかな動作を高い周波数(120 Hz)で生成します。公開された GR00T-N1-2B は約22億パラメータです。実ロボットの軌跡、人の動画、合成データの混合で学習したと報告しています[参考資料11]事実
言語モデルは、もともと「次の文字」を出す仕組みです。ロボットの行動は、関節の角度のような連続した数値なので、そのままでは出せません。そこで、(1) 数値を段階に区切って「文字」に直す、(2) 圧縮して少ない文字にする、(3) 行動を出す専用の部分を足して数値を直接つくる、という工夫が生まれました。次の章で、この3通りを確かめます(本記事による整理)。
4. 行動の「出し方」3通りと、速さの話
(1) 文字として出す:256段階に区切る
RT-2 は、行動の各次元(終了の命令を除く)を256段階に区切り、1回の行動を8個の整数で表します[参考資料2]事実。OpenVLA も、各次元を256段階に区切ります。このとき、学習データの1〜99パーセンタイルの範囲を等分し、極端な外れ値で粗くならないようにしています[参考資料5]事実。
(2) 圧縮して出す:FAST
単純な区切りの方式は、50 Hz のような高い周波数のデータでは文字の数が増えすぎて、うまく学習できないことが分かりました。FAST は、行動の列を離散コサイン変換で周波数成分に直して圧縮し、少ない文字で表す方式です[参考資料8]事実。
論文の表から分かるように、単純な区切りの文字数は次元数×制御周波数に一致します(7次元・5 Hzなら35、14次元・50 Hz なら700)本稿の計算。1秒分の行動を文字で出す場合、周波数が10倍になれば文字も10倍です。FAST では、同じ条件で14次元・50 Hz の700文字が53文字になり、約13倍の差になる、と報告されています[参考資料8]事実。
(3) 連続の値を直接つくる:フローマッチングと拡散
π0 のフローマッチングや、GR00T N1 の拡散トランスフォーマーは、ノイズから出発して、なめらかな行動の列を少しずつ取り出す生成の方法です[参考資料7・11]。文字に直さないので、高い周波数でも行動の塊を一度に出せます。π0 は、搭載機での推論時間(画像の処理、観測の処理、10回の反復による行動の生成、通信を合わせて)が73 msだったと報告しています[参考資料7]事実。
速さを数字で見る
高い周波数で動かすには、モデルの「判断の間隔」が重要です。論文の値から、1回の判断の間隔を計算します(本稿の計算)。
| モデル(出典) | 論文が述べる速さ | 1回の判断の間隔(本稿の計算) | 注意 |
|---|---|---|---|
| RT-2(55B)[参考資料2] | 1〜3 Hz(複数TPUのクラウドサービスに問い合わせ) | 約0.33〜1秒 | 5Bの版は約5 Hz(約0.2秒) |
| OpenVLA(7B)[参考資料5] | 約6 Hz(RTX 4090、最適化なし) | 約0.17秒 | 1回の判断で1ステップの行動 |
| π0[参考資料7] | 50 Hzのロボットでは、25ステップ実行するごとに推論(0.5秒おき) | 0.5秒ごとに25ステップ | 推論は73 ms。判断の回数でなく、行動の塊で高い周波数を実現 |
| GR00T N1[参考資料11] | System 2 が10 Hz、System 1 が120 Hz。16行動の塊の生成は63.9 ms(L40) | System 1:約8.3 msごとの行動 | 2つの系で役割を分ける |
本稿の計算。判断の間隔=1÷周波数。計算機・ロボット・課題が違うため、数字を並べて優劣は言えません。論文が述べる値をそのまま使っています。
ここから分かるのは、「行動の塊を出す」方式は、モデルが遅くても、ロボットを高い周波数で動かせることです。たとえば、毎秒2回の推論でも、1回に25ステップ分を出せば、50 Hz の動作を作れます。ただし、塊の途中で状況が変わっても、その間は新しい観測に反応できません(本記事による解説)。
OpenVLA(7B)は、量子化なしで15 GBのGPUメモリが必要と述べています[参考資料5]。クラウドに問い合わせる RT-2 の方法は、通信の遅れと接続に依存します[参考資料2]。ロボットの中に計算機を載せれば、消費電力、発熱、冷却、電池の重さが増えます(本記事による一般的な見立てで、特定の機体での測定ではありません)。この点は、本シリーズ「エッジAIとオンデバイスAI」編(電力と熱の制約)と「ロボットとドローンの電源」編(電池と重さ)につながります。 小さなVLAを作る試みもあり、SmolVLA は、単一GPUで学習でき、消費者向けのGPUやCPUでも動かせて、10倍大きなVLAに近い性能と報告しています[参考資料14]事実(開発元の報告で、独立した確認は本稿では行っていません)。
5. 主なモデルを読む ― 何を報告し、どう公開されているか
次の表は、主なモデルを、論文が何を報告したかと公開の状況の面で並べたものです。評価の条件が違うため、行どうしの数字を比べてモデルの優劣は言えません。
| モデル(出典) | 要点(論文の記述) | 評価の条件(報告) | 公開の状況 | 読むときの注意 |
|---|---|---|---|---|
| RT-1(Google、2022)[参考資料1] | 実ロボットの大規模データと高容量のトランスフォーマーで、データ量・モデル規模・多様性と汎化の関係を調べた | 実ロボットでの大規模データ収集にもとづく研究 | 本稿では確認していない | VLA ではなく、行動を直接出す初期の例 |
| RT-2(Google DeepMind、2023)[参考資料2] | VLMを共同で微調整し、行動をテキストのトークンで出す。「VLA」という呼び名を使った | 6,000回の評価試行 | 本稿では確認していない | 55Bは1〜3 Hz。大規模で、通信を前提 |
| Octo(2024)[参考資料4] | 80万軌跡で学習したオープンな方策。数時間で微調整 | 9つのロボットで検証 | オープンソース(論文の記載) | VLM を土台にしない方策 |
| OpenVLA(2024)[参考資料5] | 97万の実演、7B。LoRAでの微調整、量子化 | 29課題でRT-2-Xを16.5%上回る(絶対値) | チェックポイントとコードを公開(論文の記載) | 比較は論文の課題・設定 |
| π0(Physical Intelligence、2024)[参考資料7] | PaliGemma+行動エキスパート、フローマッチング、最大50 Hz | 洗濯物たたみ、机の片付け、箱の組み立てなど | 公式リポジトリ openpi は Apache-2.0[参考資料10]。重みの内容は未確認 | 課題は開発元が選んだもの |
| GR00T N1(NVIDIA、2025)[参考資料11] | デュアルシステム。実ロボット・人の動画・合成データの混合 | シミュレーションのベンチマークと、Fourier GR-1での両腕作業 | 「オープンな基盤モデル」と記載。GR00T-N1-2B を公開 | 基準手法は論文が選んだもの |
| Gemini Robotics(Google DeepMind、2025)[参考資料12] | Gemini 2.0 を土台とするVLAと、具現化推論の ER モデル | 追加の微調整で、短い課題を100回ほどの実演から学べると報告 | 本稿では確認していない | 開発元の課題での報告。独立した再現は未確認 |
| π0.5(2025)[参考資料9] | 異種のタスクの共同学習で、新しい家での長い手順の作業 | 新しい家で、キッチンや寝室の片付けなど | 本稿では確認していない | 「新しい家」の条件・人の介入は論文で確認が必要 |
| Gemini Robotics 1.5(2025)[参考資料13] | 複数の機体のデータから学ぶ Motion Transfer、行動の前に考える推論 | 複数ステップの課題の分解・実行が向上と記述 | 本稿では確認していない | 「最先端」は開発元の記述 |
| SmolVLA(Hugging Face、2025)[参考資料14] | 小型。単一GPUで学習、消費者向けGPUやCPUで動作 | 10倍大きなVLAに近い性能と報告 | コード・モデル・学習データを公開(論文の記載) | 開発元の報告 |
表の整理は本記事によるもの(解説)で、すべて各論文・公式資料の記述にもとづく事実です。公開の状況は、論文の記載と GitHub の公開情報の範囲で、2026年10月25日に確認しました。「確認していない」は、存在しないという意味ではありません。
6. ベンチマークの読み方 ― LIBERO を例に
(1) LIBERO とは
LIBERO は、ロボット操作の「生涯学習」を研究するためのシミュレーション・ベンチマークです。4つのタスクスイート(計130課題)と、人の遠隔操作による実演を提供しています。Spatial・Object・Goal の3つは各10課題、LIBERO-100 は100課題です[参考資料15]事実。VLAの論文では、Spatial・Object・Goal・Long の4つのスイートを使い、スイートごとに微調整して成功率を報告することが多く、OpenVLA-OFT の論文では、各スイートに10課題・500の専門家の実演があり、評価は各スイート500試行(10課題×50エピソード)です[参考資料6]事実。
(2) 数字の裏にある「設定」
- 入力が違う:第三者視点の画像だけを使う行と、手首のカメラ画像やロボットの状態を加えた行が、同じ表に並びます[参考資料6]
- 他の論文の値を引用している:表の基準手法の多くは、元の論文の値です。実施者・設定が違います[参考資料6]
- 訓練データの扱い:同じ OpenVLA-OFT でも、不成功の実演などを除いた加工版で平均97.1%、元のデータのままで94.5%と、同じ論文の表に別の値があります[参考資料6]事実
- 最良の結果を報告:50,000ステップごとにチェックポイントを試し、各実行で最良の成績を報告した、と書かれています[参考資料6]事実
- スイートごとに微調整:汎用モデルが「そのまま」解いた成績ではなく、各スイートに合わせた後の成績です[参考資料6]
(3) 試行回数の幅を計算する
各スイート500回の試行で、成功率が97.1%のとき、Wilson の方法の95%信頼区間は約95.4〜98.3%、95.3%のときは約93.0〜96.8%です本稿の計算。試行が独立で条件が同じという理想化で、統計的な幅だけを表します。表の行どうしの差が、この幅より小さければ、「どちらが上か」は言えません。また、設定が違う行どうしは、そもそも同じものさしではありません。
(4) 「ほぼ満点」のあとに分かったこと
LIBERO では90%台の成功率が並ぶようになり、「飽和」が指摘されています。2025年10月には、条件を少し変えて評価し直した2つの報告(プレプリント)が出ました。
- LIBERO-PROは、物体・初期状態・指示・環境を妥当な範囲で変えると、標準の LIBERO で90%超だったモデルの成功率が0.0%まで下がる、と報告し、訓練時の配置や行動の並びの暗記に依存している、と指摘しています[参考資料16]
- LIBERO-Plusは、カメラの視点やロボットの初期状態の小さな変化で、成績が95%から30%未満に下がることを報告し、言葉の指示の変化にはほとんど反応せず、指示を無視している傾向がある、と述べています[参考資料17]
どちらもプレプリントで、査読の状況は本稿では確認していません。また、論文が評価した「モデル」と、あなたの使うモデルは違うかもしれません。ここから言えるのは、ベンチマークの高い成功率は、そのベンチマークの設定での成績であり、条件が変わっても成り立つとは限らない、という一般的な注意です(本記事による解説)。
正しくは:ベンチマークの成功率は、そのシミュレーション環境・課題・微調整の設定での値です。カメラの位置、照明、物体、初期の配置が少し変わるだけで成績が大きく下がる、という報告があります[参考資料16・17]。現場では、自分のロボット・自分の物体・自分の環境で測り直します。
(5) 成功率を読む7つの問い
他のベンチマークも、同じ問いで読みます。CALVIN は、言語で条件づけた長い手順の操作のシミュレーション・ベンチマークです[参考資料18]。SIMPLER は、実機の方策評価に対応するシミュレーション環境で、特定のロボット設定では実機の成績と強い相関を報告しています[参考資料19]。RoboArena は、評価者が課題と環境を自由に選び、2つの方策を二重盲検で比べる分散型の実機評価で、7つの方策を600回超の対比較で順位づけしました[参考資料20]事実。
7. 実演動画と「汎用」の言葉をどう見るか
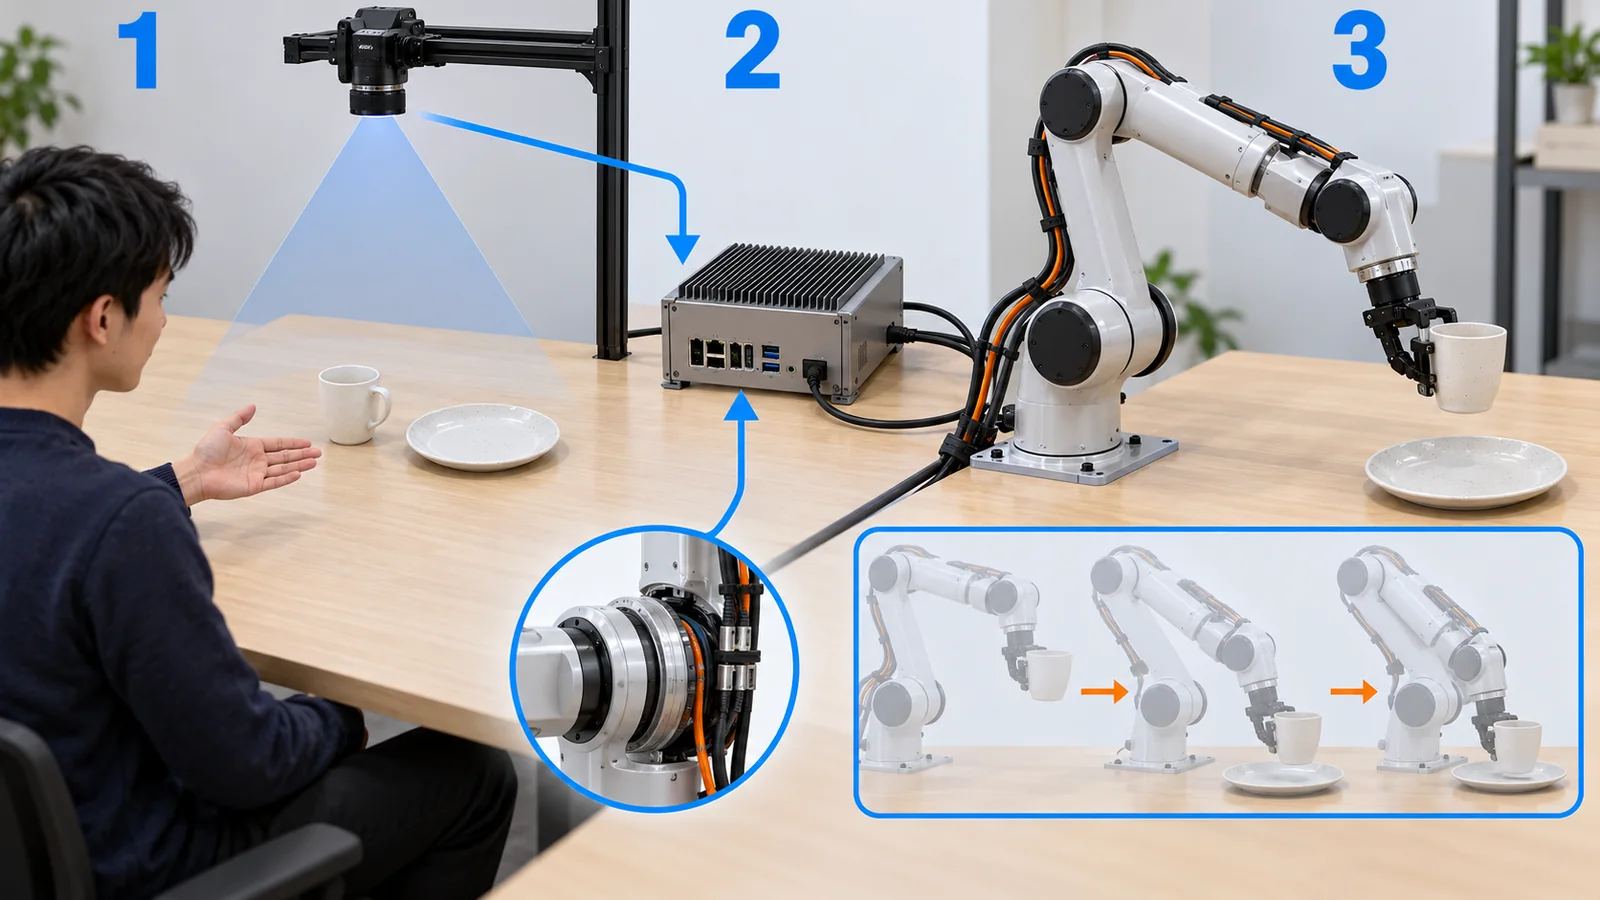
ロボットの紹介では、動画がよく使われます。動画は、見せたい場面を選んで撮れるので、実力の証拠としては扱いません。次の点を確かめます(本記事による整理)。
- 自律か、遠隔操作か:ロボットが方策で自分で動いているのか、人が遠隔操作しているのか、動きは事前に練習した決まったものか。動画の説明に、「自律」「1倍速」「遠隔操作なし」などの記載があるかを確認します
- 何回の中の1回か:成功した1回を切り出していないか。成功率と試行回数が、論文や技術資料に書かれているか
- 編集と速度:早送りや切り貼りがないか
- 環境は初めてか:訓練に使った場所・物と同じではないか。π0.5 は「新しい家」での評価を述べていますが、その条件(人の介入の有無など)は論文で確認が必要です[参考資料9]
実演データの集め方(遠隔操作)と、自律・遠隔操作の見分け方は、本シリーズ「遠隔操作とデータ収集」編で詳しく扱います。なお、GR00T N1 の学習データには、人が装置で操作して集めた遠隔操作のデータが含まれます[参考資料11]。学習データが遠隔操作でも、評価時のロボットが自律で動くなら、それは別の話ですが、「どちらなのか」が書かれているかを確認する価値があります。
正しくは:動画の動きが、方策による自律なのか、人の遠隔操作なのか、事前に練習した決まった動きなのかは、動画だけでは分かりません。主張は企業の発表として扱い、自律の度合い、台数・時間・作業、独立した検証の有無を、論文・技術資料で確認します。
8. 素材技術者の視点②:「機体の違い」は、材料と部品の違い
基盤モデルでは、機体の違いをエンボディメントと呼びます。Open X-Embodiment は22種類のロボットを集めました[参考資料3]。ここで、材料の目で見ると、機体の違いは、指先の素材(ゴム、金属、樹脂)の摩擦、関節の剛性とガタ、アームのたわみ、カメラの取り付けの剛性といった、物性と部品の違いです。同じ「つかむ」指令でも、指先の摩擦が違えば、物が滑るかどうかが変わります。
したがって、微調整のデータは、自分の機体の材料・部品の状態を写したものになります。ゴムの摩耗や関節のガタが進めば、データを取った時の機体とは違う機体になり、再度の微調整が必要になるかもしれません(本記事による一般的な見立てで、特定の機種での測定ではありません)。布のように形が変わる物は、さらに難しい対象です。
9. 限界と、確認できなかったこと/まとめ
(1) モデルの性能の比較
成功率・処理速度は、各論文が選んだロボット・課題・環境・計算機での報告値です。独立した第三者による再現は、本稿では確認していません。モデル間の優劣は論じていません。
(2) 非公開モデルの内部
Gemini Robotics など、重みが公開されていないモデルの内部の詳細は、技術報告の範囲でしか確認できません。公開の状況は、論文の記載と GitHub の公開情報にとどめ、各社のサービスの提供状況は確認していません。
(3) プレプリント
LIBERO-PRO と LIBERO-Plus は、2025年10月のプレプリントで、査読の状況を確認していません。両者の結果は、その論文が評価したモデルについての報告です。
(4) 規格の本文
ISO の規格は、番号・題名・段階の確認にとどめ、本文は確認していません。学習した方策(VLA)の安全性評価の方法を直接定めた、発行済みの規格は確認できませんでした。
(5) 取り上げなかった内容
世界モデルは「世界モデルと身体性AI」編で、人型ロボットの製品や事業は「ヒューマノイドロボット」編で扱います。市場規模、価格、株価は扱いません。
- VLAは、ウェブで学んだVLMを土台に、画像・言葉・状態から行動を出すモデルです。「多くのロボットの経験から学んだAI」というたとえは、学習していない状況に弱いという限界つきで使います事実
- 行動の出し方は、文字(256段階)、圧縮した文字(FAST)、連続の値の生成(フロー・拡散)の3通りです。高い周波数では、単純な区切りの文字数が「次元数×周波数」で増えます事実本稿の計算
- ベンチマークの成功率は、入力・微調整・出典の設定で変わり、条件を少し変えると大きく下がる報告もあります。7つの問いを添えて読みます事実
10. 評価・標準の読み方
VLAの評価は、課題の成功率を、シミュレーションのベンチマークと実機で測るのが基本です。さらに、条件を変えたときの頑健さ、推論の速さ(遅延)、微調整に必要なデータの量が、実用上のものさしになります。共通の標準はまだ少なく、安全は産業用ロボットなどの既存の規格が土台です(確認日 2026年10月25日)。
| 評価項目 | 代表的な試験・ベンチマーク(名称・出典) | 標準・規則・指針(ISO など) | 読み方の注意 |
|---|---|---|---|
| シミュレーションでの成功率 | LIBERO(4スイート、計130課題)[参考資料15]、CALVIN[参考資料18]事実 | 確認できなかった | 入力・微調整・引用元の設定で値が変わる。飽和と暗記の指摘がある(第6章) |
| 頑健さ(条件を変えた評価) | LIBERO-PRO[参考資料16]、LIBERO-Plus[参考資料17](プレプリント)事実 | 確認できなかった | 評価の定義は研究ごと。査読の状況は未確認 |
| シミュレーションと実機の対応 | SIMPLER(特定のロボット設定で実機と強い相関)[参考資料19]事実 | 確認できなかった | 他のロボット・課題への一般化は保証されない |
| 実機での汎用方策の評価 | RoboArena(二重盲検の対比較、7つの方策、600回超)[参考資料20]。RT-2の6,000回の評価試行[参考資料2]事実 | 確認できなかった | 評価者が課題を選ぶ方式は、条件が揃わない代わりに多様性が高い |
| 産業用ロボットの安全 | —(ベンチマークではなく規格) | ISO 10218-1:2025(ロボット本体)、ISO 10218-2:2025(応用とロボットセル)[参考資料21・22]事実 | 学習した方策の評価方法を直接定めたものではない。本文は有料 |
| AIを安全関連機能に使うとき | — | ISO/IEC TR 5469:2024(技術報告)[参考資料23]。ISO/IEC CD TS 22440-1(要求事項。委員会原案の段階)[参考資料24]事実未確定/将来 | 技術報告は情報の提供。TS 22440 は策定中で、確定した内容ではない |
表の整理は本稿の計算(整理)。ISO の番号・題名・段階は公式ページで確認(確認日 2026年10月25日)。規格本文は有料のため、題名・段階の記載にとどめています。
読み方の注意(素材技術者向け)
- デモ・ベンチマーク・現場は別物:動画やベンチマークは、選ばれた課題と整えた環境の値です。自分の物体・照明・床・摩耗した機体で、測り直してください
- 開発元の報告と第三者の検証は別:VLAの成績の多くは、開発した研究グループ・企業自身の報告です。独立した評価(RoboArena のような)があるかを確認してください
- 標準は「要求」か「情報」か「策定中」か:ISO 10218 は安全要求、ISO/IEC TR 5469 は情報提供、ISO/IEC TS 22440 は策定中です。「規格に適合」は、学習した方策が安全であることを意味しません
- 計画・予定は確定ではない:各社の「近く提供」「量産」などは未確定/将来です。本稿では扱っていません
11. 用語集
- 基盤モデル
- 多様で大量のデータで事前に学習し、あとから微調整して多くの用途に使う大きなモデル。
- ロボット基盤モデル
- 多くのロボットの経験から、一般的な動かし方を学んだAI。学習していない状況には弱いことがある。
- VLM(視覚言語モデル)
- 画像と言葉を一緒に扱うモデル。
- VLA(視覚・言語・行動モデル)
- 画像と言葉の指示を入力し、ロボットの行動を出力するモデル。
- 方策
- 観測から次の行動を返す関数。
- トークン
- モデルが扱う文字の最小単位。VLAでは行動もトークンで表すことがある。
- 行動トークン化
- 連続した行動の値を、トークンの並びに直すこと。
- ビン(段階)
- 連続の値を区切った区間。RT-2 と OpenVLA は各次元を256に区切る。
- 行動チャンク
- 数ステップ分の行動をまとめて出すこと。
- フローマッチング/拡散
- ノイズから少しずつ、行動の列を取り出す生成の方法。
- エンボディメント
- ロボットの機体(形、関節、センサー)の違い。
- 事前学習
- 大量のデータで、先に一般的な能力を学ぶこと。
- 微調整(ファインチューニング)
- 事前学習したモデルを、自分のデータで追加学習すること。
- LoRA
- 少ないパラメータだけを追加して微調整する、軽い方法。
- ゼロショット
- 追加の学習なしに、新しい課題や指示に対応すること。
- 具現化推論(ER)
- 空間や時間の理解、物体の指し示しなど、ロボットに必要な推論。
- ベンチマーク/スイート
- 性能を比べるための共通の課題の集まり。スイートはその中の課題群。
- 成功率
- 試行のうち課題を達成した割合。試行回数と条件を伴って読む。
- 暗記(メモライゼーション)
- 課題の本質ではなく、訓練時の配置や動きの並びを覚えて当てること。
- 制御周波数
- 1秒に何回、行動を決めるか(Hz)。
- 推論遅延
- 観測を入れてから行動が出るまでの時間。
12. 参考資料(一次情報)
- Brohan A. ほか “RT-1: Robotics Transformer for Real-World Control at Scale”, arXiv:2212.06817 (2022) — arxiv.org/abs/2212.06817
- Brohan A. ほか “RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control”, arXiv:2307.15818 (2023) — arxiv.org/abs/2307.15818
- Open X-Embodiment Collaboration “Open X-Embodiment: Robotic Learning Datasets and RT-X Models”, arXiv:2310.08864 (2023) — arxiv.org/abs/2310.08864
- Octo Model Team “Octo: An Open-Source Generalist Robot Policy”, arXiv:2405.12213 (2024) — arxiv.org/abs/2405.12213
- Kim M. J. ほか “OpenVLA: An Open-Source Vision-Language-Action Model”, arXiv:2406.09246 (2024) — arxiv.org/abs/2406.09246
- Kim M. J., Finn C., Liang P. “Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success” (OpenVLA-OFT), arXiv:2502.19645 (2025) — arxiv.org/abs/2502.19645
- Black K. ほか (Physical Intelligence) “π0: A Vision-Language-Action Flow Model for General Robot Control”, arXiv:2410.24164 (2024) — arxiv.org/abs/2410.24164
- Pertsch K. ほか “FAST: Efficient Action Tokenization for Vision-Language-Action Models”, arXiv:2501.09747 (2025) — arxiv.org/abs/2501.09747
- Physical Intelligence ほか “π0.5: a Vision-Language-Action Model with Open-World Generalization”, arXiv:2504.16054 (2025) — arxiv.org/abs/2504.16054
- Physical Intelligence GitHub repository “openpi” (Apache License 2.0)。GitHub の公開APIでリポジトリとライセンスを確認(2026年10月25日)。重みの公開内容は本稿では確認していない — github.com/Physical-Intelligence/openpi
- NVIDIA ほか “GR00T N1: An Open Foundation Model for Generalist Humanoid Robots”, arXiv:2503.14734 (2025) — arxiv.org/abs/2503.14734
- Gemini Robotics Team “Gemini Robotics: Bringing AI into the Physical World”, arXiv:2503.20020 (2025) — arxiv.org/abs/2503.20020
- Gemini Robotics Team “Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer”, arXiv:2510.03342 (2025) — arxiv.org/abs/2510.03342
- Shukor M. ほか “SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics”, arXiv:2506.01844 (2025) — arxiv.org/abs/2506.01844
- Liu B. ほか “LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning”, arXiv:2306.03310 (2023; NeurIPS 2023 Datasets and Benchmarks) — arxiv.org/abs/2306.03310
- Zhou X. ほか “LIBERO-PRO: Towards Robust and Fair Evaluation of Vision-Language-Action Models Beyond Memorization”, arXiv:2510.03827 (2025; preprint)。プレプリントで、査読の状況は本稿では確認していない — arxiv.org/abs/2510.03827
- Fei S. ほか “LIBERO-Plus: In-depth Robustness Analysis of Vision-Language-Action Models”, arXiv:2510.13626 (2025; preprint)。プレプリントで、査読の状況は本稿では確認していない — arxiv.org/abs/2510.13626
- Mees O. ほか “CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks”, arXiv:2112.03227 (2021) — arxiv.org/abs/2112.03227
- Li X. ほか “Evaluating Real-World Robot Manipulation Policies in Simulation” (SIMPLER), arXiv:2405.05941 (2024) — arxiv.org/abs/2405.05941
- Atreya P. ほか “RoboArena: Distributed Real-World Evaluation of Generalist Robot Policies”, arXiv:2506.18123 (2025) — arxiv.org/abs/2506.18123
- ISO ISO 10218-1:2025 “Robotics — Safety requirements — Part 1: Industrial robots” (Edition 3, February 2025)。確認日 2026年10月25日 — iso.org/standard/73933.html
- ISO ISO 10218-2:2025 “Robotics — Safety requirements — Part 2: Industrial robot applications and robot cells” (Edition 2, February 2025)。確認日 2026年10月25日 — iso.org/standard/73934.html
- ISO/IEC ISO/IEC TR 5469:2024 “Artificial intelligence — Functional safety and AI systems” (Edition 1, January 2024)。確認日 2026年10月25日 — iso.org/standard/81283.html
- ISO/IEC ISO/IEC CD TS 22440-1 “Artificial intelligence — Functional safety and AI systems — Part 1: Requirements” (committee draft; stage 30.60)。確認日 2026年10月25日 — iso.org/standard/89535.html
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| VLAの定義:ウェブ規模のVLMをロボットの軌跡データとウェブの視覚言語課題で一緒に微調整し、行動をテキストのトークンとして出すこと(RT-2)。6,000回の評価試行、新しい物体への汎化など | Brohan らの論文(RT-2、要旨) 出典2 https://arxiv.org/abs/2307.15818 出典1 https://arxiv.org/abs/2212.06817 | 事実 |
| RT-2:各行動次元(終了の命令を除く)を256の段階に区切り、行動を8個の整数で表すこと。55Bのモデルが1〜3 Hz、5Bのモデルが約5 Hzで動くこと | Brohan らの論文(RT-2、本文) 出典2 https://arxiv.org/abs/2307.15818 | 事実 |
| OpenVLA:7Bパラメータ、97万の実ロボットの実演で学習、Llama 2に DINOv2 と SigLIP の視覚特徴を組み合わせる構成。29課題でRT-2-X(55B)を絶対成功率で16.5%上回ったこと、Diffusion Policy を20.4%上回ったこと、LoRAによる微調整、各次元256段階(学習データの1〜99パーセンタイルで区切る)、RTX 4090で約6 Hz・bf16で15 GB | Kim らの論文(要旨、第3章) 出典5 https://arxiv.org/abs/2406.09246 | 事実 |
| π0:事前学習済みVLM(PaliGemma 3B)に行動エキスパート(約3億)を足した計33億パラメータ。フローマッチング、行動チャンク H=50、最大50 Hz、洗濯物たたみ・机の片付け・箱の組み立てなどの評価。搭載機での推論は73 ms | Black らの論文(要旨、本文、付録) 出典7 https://arxiv.org/abs/2410.24164 | 事実 |
| FAST:単純な区切りによる行動のトークン化は高周波のデータでうまくいかないこと。離散コサイン変換にもとづく圧縮の方式。1秒の行動の塊の文字数(BridgeV2 35→20、DROID 105→29、Bussing 140→28、Shirt Fold 700→53) | Pertsch らの論文(要旨、表I) 出典8 https://arxiv.org/abs/2501.09747 | 事実 |
| 単純な区切りの文字数=次元数×制御周波数(7×5=35、7×15=105、7×20=140、14×50=700)が表の値と一致すること、各行の圧縮倍率の再計算 | 本稿の計算(FAST論文の表Iの値の検算) | 本稿の計算 |
| GR00T N1:デュアルシステム(VLMのSystem 2が10 Hz、拡散トランスフォーマーのSystem 1が120 Hz)、公開されたGR00T-N1-2Bは約22億パラメータ(VLMが13.4億)、16行動の塊を L40 GPUで63.9 ms。実ロボットの軌跡・人の動画・合成データの混合で学習。Fourier GR-1での両腕作業 | NVIDIA らの技術報告 出典11 https://arxiv.org/abs/2503.14734 | 事実 |
| Gemini Robotics:Gemini 2.0 を土台とする VLA と、空間・時間の理解を強めた ER モデルの2つ。追加の微調整で、短い課題を100回ほどの実演から学べること。Gemini Robotics 1.5:複数の機体のデータから学ぶ Motion Transfer、行動の前に考える多段の推論 | Gemini Robotics Team の技術報告(要旨) 出典12 https://arxiv.org/abs/2503.20020 出典13 https://arxiv.org/abs/2510.03342 | 事実 |
| π0.5:異種のタスクでの共同学習により、新しい家での長い手順・器用な作業ができると報告されたこと。SmolVLA:単一GPUで学習でき、消費者向けGPUやCPUでも動かせる小型のVLAで、10倍大きなVLAに近い性能と報告 | Physical Intelligence らの論文、Shukor らの論文(要旨) 出典9 https://arxiv.org/abs/2504.16054 出典14 https://arxiv.org/abs/2506.01844 | 事実 |
| Open X-Embodiment:21機関・22種類のロボット・527スキル(160,266課題)のデータの標準化。Octo:Open X-Embodiment の80万の軌跡で学習したオープンなモデルで、消費者向けGPUで数時間で微調整でき、9つのロボットで検証 | Open X-Embodiment Collaboration、Octo Model Team の論文(要旨) 出典3 https://arxiv.org/abs/2310.08864 出典4 https://arxiv.org/abs/2405.12213 | 事実 |
| openpi のリポジトリが公開され、Apache License 2.0 であること(重みの公開内容は未確認) | GitHub の公開API(2026年10月25日) 出典10 https://github.com/Physical-Intelligence/openpi | 事実 |
| LIBERO:4つのタスクスイート計130課題、人の遠隔操作の実演を提供すること。Spatial・Object・Goal は各10課題、LIBERO-100は100課題 | Liu らの論文(要旨、図1) 出典15 https://arxiv.org/abs/2306.03310 | 事実 |
| OFT論文のLIBERO設定:Spatial・Object・Goal・Long の4スイート、各スイート10課題・500の専門家の実演、各スイート500試行(10課題×50エピソード)。スイートごとに独立に微調整、表の行ごとに入力が違うこと、同じOFTでも訓練データの扱い(不成功の実演などを除いた加工版か元のままか)で平均が97.1%と94.5%になること、各実行の最良のチェックポイントを報告したこと。OpenVLAの平均成功率が76.5%から97.1%に上がったこと、表の各行の値 | Kim らの論文(OFT、要旨、第V章、表) 出典6 https://arxiv.org/abs/2502.19645 | 事実 |
| 500試行での成功率の信頼区間(97.1%で約95.4〜98.3%、95.3%で約93.0〜96.8%)、4列の平均の再計算(76.5、95.35、97.1、94.15) | 本稿の計算(Wilson の方法。試行が独立で条件が同じという理想化) | 本稿の計算 |
| LIBERO-PRO:標準のLIBEROで90%超でも、物体・初期状態・指示・環境を妥当な範囲で変えると0.0%まで下がるという報告、暗記への依存の指摘。LIBERO-Plus:カメラ視点や初期状態の小さな変化で95%から30%未満に下がる、言語の指示の変化には鈍感で、指示を無視する傾向があるという報告(いずれもプレプリント) | Zhou ら、Fei らの論文(要旨。プレプリント) 出典16 https://arxiv.org/abs/2510.03827 出典17 https://arxiv.org/abs/2510.13626 | 事実 |
| CALVIN(言語で条件づけた長い手順の操作のシミュレーション・ベンチマーク)、SIMPLER(実機の方策評価に対応するシミュレーション環境で、実機との相関が強いと報告)、RoboArena(7つの方策を600回超の実機の対比較で順位づけ) | Mees ら、Li ら、Atreya らの論文(要旨) 出典18 https://arxiv.org/abs/2112.03227 出典19 https://arxiv.org/abs/2405.05941 出典20 https://arxiv.org/abs/2506.18123 | 事実 |
| ISO 10218-1:2025・ISO 10218-2:2025(産業用ロボットの安全要求)、ISO/IEC TR 5469:2024(AIの機能安全。技術報告)、ISO/IEC CD TS 22440-1(AIの機能安全:要求事項。委員会原案の段階)の番号・題名・段階 | ISOの公式ページ 出典21 https://www.iso.org/standard/73933.html 出典22 https://www.iso.org/standard/73934.html 出典23 https://www.iso.org/standard/81283.html 出典24 https://www.iso.org/standard/89535.html | 事実 |
| 「多くのロボットの経験から一般的な動かし方を学んだAI」というたとえとその限界、「成功率を読む7つの問い」、「図の3つの出し方の整理」、「微調整が必要になる理由」という読み取り | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 各モデルの独立した第三者による再現、モデル間の優劣、非公開モデルの内部構成、実演動画が自律か遠隔操作か(動画ごとの条件)、規格本文 | 本稿の調査範囲では一次情報で確認できなかったため記載していない(解説) | 解説 |
| 図1・図8がImageGen生成の概念画像であること、図2・図3・図4・図7が説明のための概念図、図5・図6が本稿の計算を含む作図であること | 本記事による注記 | 解説 |
最終更新:2026年10月25日/出典は一次情報(arXiv の論文、GitHub の公開情報、ISO の公式ページ)に限定しています。ISO の規格本文は有料のため確認できていません。LIBERO-PRO と LIBERO-Plus はプレプリントです。 数値例は論文の値を使った算術で、実在の機体の性能ではありません。 各モデルの独立した第三者による再現、モデル間の優劣、非公開モデルの内部構成、学習した方策の安全性評価を直接定める規格については、確認できなかったため記載していません。 図1と図8はImageGen生成の概念画像で、その他の図は説明用の概念図または本稿の計算を含む作図です。