TECHNOLOGY EXPLAINER
学習クラスターとインターコネクト
― 数万のGPUを「1台の計算機」として動かす、並列化・通信・故障の読み方
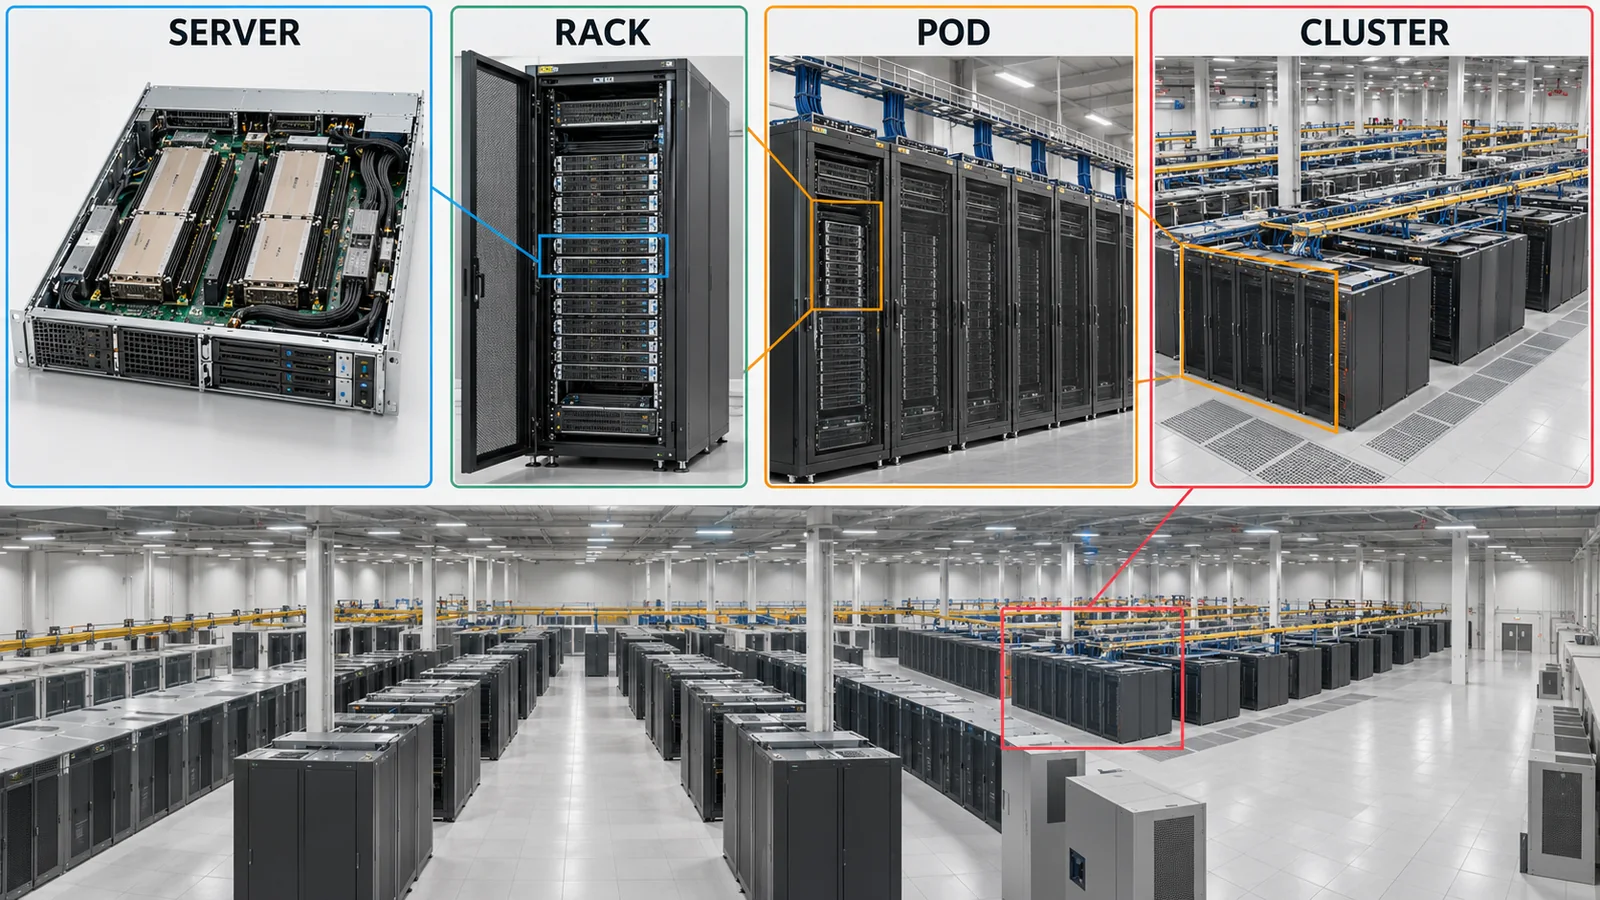
大規模言語モデルの学習は、1台のGPUにも1台のサーバーにも収まりません。モデルとデータを数千〜数万のGPUに分け、毎ステップ、勾配などを交換し合いながら進めます。そのため、速さは「GPUの演算性能」だけでなく、どう分けるか(並列化)、どの通路で運ぶか(NVLink・InfiniBand・Ethernet)、どれだけ無駄なく動かせるか(MFU)、壊れたときにどれだけ失わずに続けられるか(耐障害性)で決まります。 この記事では、データ・テンソル・パイプライン並列、スケールアップとスケールアウト、集団通信、学習の効率(MFU)、故障と耐障害性を、公式資料と論文で確認できた範囲で整理します。『光インターコネクトとSerDes』『Co-packaged Optics』『光トランシーバー』は別編で扱い、本記事では文章で触れるだけにします。
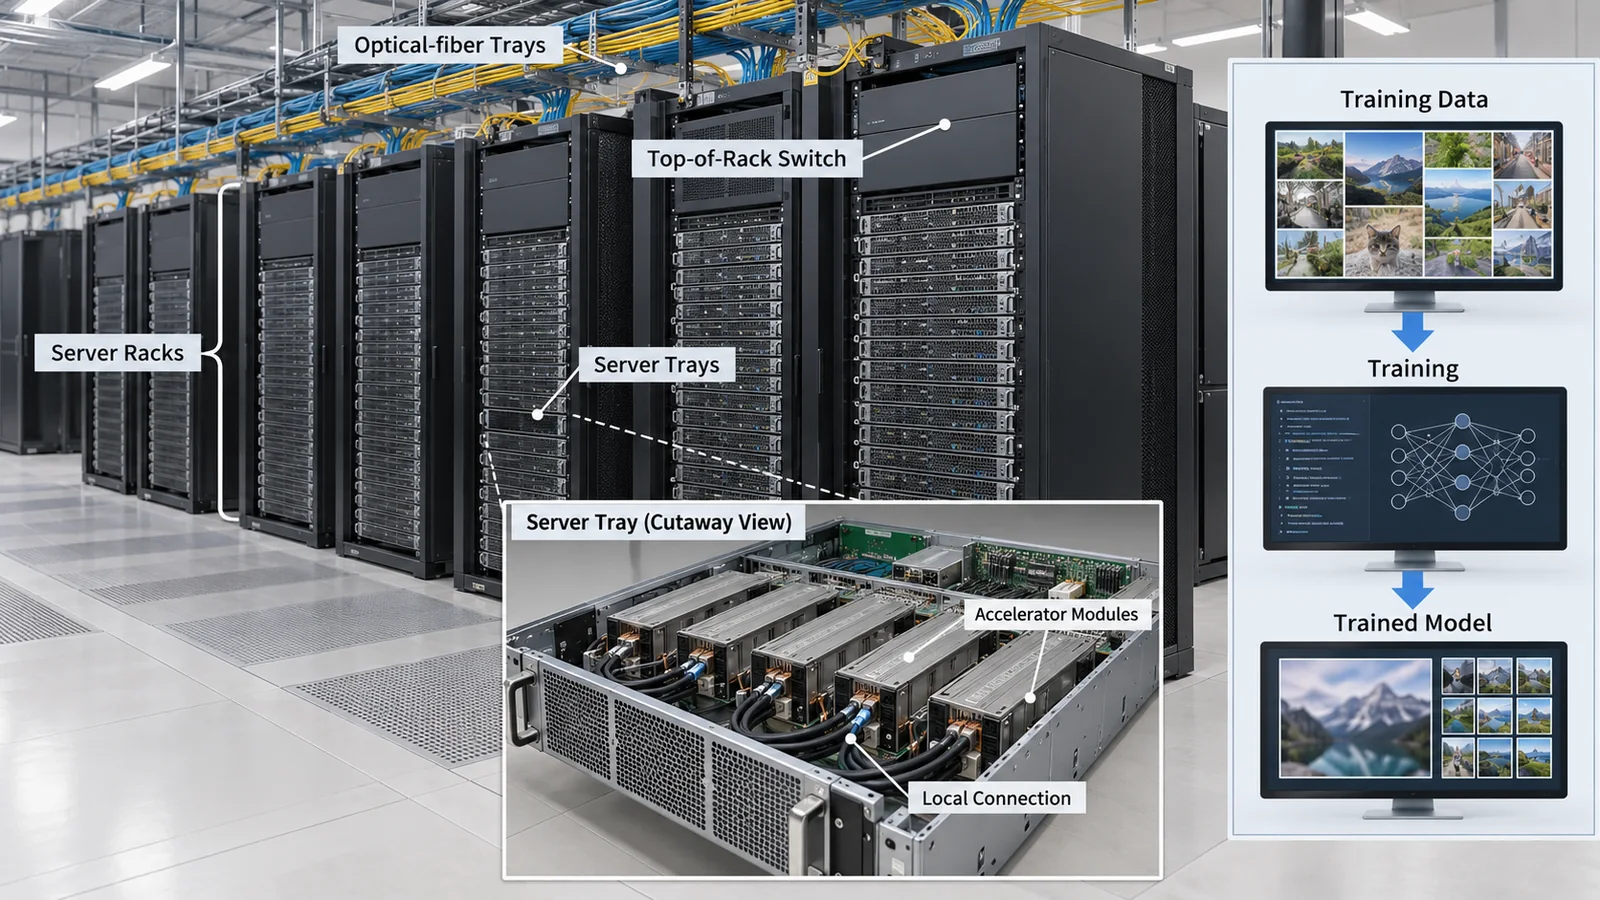
- 学習クラスターとは何か(3行でつかむ)
- 並列化 ― データ・テンソル・パイプライン
- スケールアップとスケールアウト ― NVLink・InfiniBand・Ethernet
- 集団通信 ― all-reduce と通信量の見積り
- 学習の効率 ― MFU の読み方
- 故障と耐障害性
- 素材技術者の視点:故障の内訳、温度、配線
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公式の資料・論文・規格団体のページに記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=策定中・計画・確認できていない状態の事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
学習の効率や故障の数字は、特定の組織の特定のクラスターを、特定の期間に測った結果です。他のクラスターや他のモデルに当てはまるとは限りません。MFU や帯域の値は、チップ・精度・数え方(片方向か双方向か)が違うため、並べて優劣をつけません。 本文の「本稿の計算」は、公表値からの概算で、実測ではありません。
1. 学習クラスターとは何か(3行でつかむ)
- モデルが1台に収まらない:GPU のメモリ容量には限りがあり、大きなモデルは多GPUサーバー1台にも載らず、必要な演算の回数も現実的でない学習時間になる、と Narayanan らは整理しています事実[参考資料15]。そこで、モデルとデータを多数のGPUに分けます
- 分けたら、通信が必要になる:分けた断片は、毎ステップ、結果を交換します。Llama 3 405B は最大16K(16,384)個の H100 で学習され、同じサーバーの8個のGPUは NVLink で、サーバー間は400 Gbps のネットワークでつながれました事実[参考資料1]
- 止まらずに動かすのが難しい:同論文は、54日間に466回の中断(うち予期しないものは419回)があったと報告します。同期して進む学習は、1つのGPUの故障でジョブ全体の再起動が要りうるためです事実[参考資料1]
クラスターの速さは、GPUの数×1台の性能では決まりません。通信と待ち時間、故障と復旧で、実際に「学習に使えた時間」と「使えた演算」が決まります。公表された例では、BF16 で38〜43%の MFU(ピーク演算に対する有効な演算の割合)、有効な学習時間は90%超でした[参考資料1]。
2. 並列化 ― データ・テンソル・パイプライン
並列化は、「何を分けるか」で種類が分かれます。それぞれの代表的な論文と、公表された構成の例を整理します。
| 種類 | 仕組みと、代表的な資料の記述 | 通信と置き場所 |
|---|---|---|
| データ並列(DP) | 同じモデルを複数のGPUに置き、データを分けて学習し、ステップごとに勾配を同期する。PyTorch の DDP の論文が実装の経験を整理する[参考資料19]。モデルの状態も分ける ZeRO(メモリの冗長性を除く)[参考資料17]と PyTorch の FSDP(DDP と同等の性能で、より大きなモデルを扱え、TFLOPS がほぼ線形に伸びると報告)[参考資料18]がある | 勾配の集団通信(all-reduce/reduce-scatter)と、FSDP では重みの全収集。最外側に置く(Llama 3:DP=64〜128) |
| テンソル並列(TP) | 1層の重みの行列を複数のGPUに分ける。Megatron-LM は、ネイティブの PyTorch に少数の通信操作を挿入するだけで実装でき、512 GPUで83億パラメータまで学習し、単一GPUを基準に76%のスケーリング効率を保った、と報告する[参考資料14] | 層ごとに集団通信が要るため、最も速い通路に置く(Llama 3:TP=8、同じサーバーの8 GPU) |
| パイプライン並列(PP) | 層を前後の「段」に分け、段ごとにGPUを割り当てる。GPipe がミニバッチをマイクロバッチに分けて流す方式を提案した[参考資料16]。Narayanan らは、TP・PP・DP を組み合わせて数千GPU・兆パラメータ規模へ拡張でき、交互の配置でスループットを10%超改善できると報告する[参考資料15] | 段の境目で活性化を点対点で受け渡す。外側に置く(Llama 3:PP=16)。「待ち時間(バブル)」が課題 |
| 系列・コンテキスト並列(SP/CP) | Korthikanti らは、系列並列と選択的な活性化の再計算で、活性化のメモリを5倍減らし、再計算の時間の上乗せを90%超減らしたと報告する(530Bパラメータを2,240 A100で学習し、MFU 54.2%)[参考資料9]。Llama 3 は、長い系列のためにコンテキスト並列を使う[参考資料1] | 注意の計算で系列の断片を交換する。Llama 3 では131,072トークンの段階で CP=16 |
| 専門家並列(EP) | MoE の専門家を複数GPUに置く。DeepSeek-V3 は2,048個の H800 で学習し、ノードをまたぐ all-to-all の専用実装で InfiniBand と NVLink の帯域を使い切り、高価なテンソル並列を使わずに済ませ、DualPipe で計算と通信を重ねた、と述べる[参考資料2・20] | トークンを専門家に割り振る all-to-all。ノード間の通信が主 |
すべて事実(各論文)。Llama 3 の組み合わせは「4D並列」(TP・CP・PP・DP)で、並列化の順序[TP, CP, PP, DP]の外側ほど遅い通信路に置きます[参考資料1]。
分けるほど1台あたりのメモリは減りますが、通信が増えます。Llama 3 の論文は、各GPUのパラメータ・最適化状態・勾配・活性化がHBMに収まる組み合わせを選ぶと述べ、最適な構成を探すためにメモリ消費の見積りツールと性能予測ツールを作った、と述べています[参考資料1]。最適な構成は、モデル・GPU・ネットワークごとに違い、標準の答えはありません(本記事による解説)。
3. スケールアップとスケールアウト ― NVLink・InfiniBand・Ethernet
元のSVG模式図・数値・出典注記を見る
通信路は、スケールアップ(少数のGPUを非常に太く直結する)とスケールアウト(多数のサーバーをネットワークでつなぐ)の2層に分けて語られます。UALink コンソーシアムは、UALink は効率的なスケールアップの構成を、UEC は主にスケールアウトの構成を扱う、補い合う組織だと述べています事実[参考資料24]。
| 技術 | 役割 | 公式資料の記述・状態(確認日時点) |
|---|---|---|
| NVLink/NVSwitch | スケールアップ。GPU間の直結(NVIDIA 独自) | NVLink 4(H100)は900 GB/s、NVLink 5(Blackwell)は1.8 TB/s、NVLink 6(Rubin)は3.6 TB/s[参考資料3・5・13]。GB200 NVL72 は72個のGPUを1つの NVLink の領域(ドメイン)にまとめ、ラック全体の NVLink の帯域は130 TB/s、液冷と記載[参考資料4]。値の方向(片方向か双方向合計か)は資料で明記されないものがある |
| InfiniBand | スケールアウト。RDMA を前提とした高速ネットワーク | IBTA が InfiniBand と RoCE の仕様(Volume 1 Release 2.1、Volume 2 Release 2.1)を公開[参考資料25]。Llama 3 の小さいモデルは InfiniBand で学習[参考資料1] |
| Ethernet(RoCE) | スケールアウト。標準の Ethernet 上で RDMA を行う | Llama 3 405B は RoCE のネットワーク(24K GPU、3層の Clos、最上層は1:7の過加入)で学習され、流れの分割(GPU間に16本)と拡張された ECMP で負荷を分散し、従来の輻輳制御(DCQCN)なしで24K GPUのクラスターを動かせたと報告[参考資料1・29]。IEEE Std 802.3df-2024(400 Gb/s・800 Gb/s Ethernet)は2024年2月16日に承認[参考資料26]。P802.3dj(200 Gb/s〜1.6 Tb/s)はタスクフォースのページに掲載されているが、確認日時点の状態は確認できなかった未確定/将来[参考資料27] |
| Ultra Ethernet(UEC) | AI・HPC向けに Ethernet を最適化する通信スタック | 仕様1.0は2025年6月11日、確認日の3日前の2026年10月12日に1.1が公開され、「現行の公開版」とされる。UEC は Linux Foundation の関連の Joint Development Foundation のプロジェクト[参考資料21] |
| UALink | スケールアップの業界団体の仕様(accelerator間のload/store) | 200G 1.0 仕様は2025年4月8日に承認・公開、1レーン200Gで最大1,024個のアクセラレータ、銅線ベースで、リピーターなしでは数メートルまで、光の導入は将来の検討[参考資料23・24]。ほかに Common 2.0(ネットワーク内の演算)などの仕様が公開[参考資料22] |
すべて事実(メーカー・団体の公表)。これらは、確定した規格(IEEE)、業界団体の仕様(UEC、UALink、IBTA)、メーカー独自の技術(NVLink)が混在しています。製品としての実装・相互運用の実績は、本記事では確認していません。
Llama 3 は、モデルの並列化の方法も学習のスケジューラも、ネットワークの構造(どのポッドをまたぐか)を意識して作ったと述べます。ネットワークの階層を知って、通信の多い並列化を内側に置くのが、設計の基本です[参考資料1](本記事による整理)。 光のインターコネクトや CPO、光トランシーバーは、本シリーズ『光インターコネクトとSerDes』『Co-packaged Optics』『光トランシーバー』編で扱います。
4. 集団通信 ― all-reduce と通信量の見積り
学習では、全員が持つ勾配を足し合わせて全員に戻す all-reduce、足し合わせた結果を分けて持つ reduce-scatter、断片を全員に集める all-gather、全員が全員に違う断片を送る all-to-all などの集団通信を使います。NVIDIA の通信ライブラリ NCCL の文書は、AllReduce、Broadcast、Reduce、AllGather、ReduceScatter、AlltoAll などを集団操作として挙げています事実[参考資料31]。
リング all-reduce は、データをn個に刻み、輪の上で隣に渡し続けます。Patarasuk と Yuan は、この方式が(クラスターの条件のもとで)帯域最適であることを示しました[参考資料6]。NCCL-tests の文書は、各ランクの帯域をBとして、全データ量S の all-reduce の最良の時間を t=(S/B)×2(n−1)/n と書いています(リング・木など、点対点の送受信による方式に共通)。n が大きくなっても係数は2に近づくだけで、台数に比例して通信量が増えるわけではありません事実[参考資料7]。
この式は帯域だけで決まる理想的な最良の場合です。小さなデータでは、段数に比例する遅延の項が支配的になり、ネットワークの混雑、遅い1台(ストラグラー)、ソフトウェアの実装で、実際はもっと遅くなります。Llama 3 の論文は、最も外側の PP と DP の通信は複数ホップのネットワークを通り、遅延が数十マイクロ秒になりうること、元の NCCL の集団通信は小さな制御メッセージの多さや余計なメモリのコピーが非効率で、通信用に調整した NCCLX を使ったこと、を述べています[参考資料1]。
通信量の概算:Llama 3 405B の勾配の同期
公表された構成から、勾配の同期にかかる時間の下限を見積もります本稿の計算。Llama 3 405B の16K GPU・DP=128 の設定では、1バッチ16Mトークン、1GPUあたり400 TFLOPS(BF16 MFU 41%)と公表されています[参考資料1]。
- 1ステップの演算の時間:演算量を「6×パラメータ数×トークン数」で近似すると、6×405×109×16×106÷(16,384×400×1012)=約5.93秒
- 勾配の断片の大きさ:BF16(2バイト)の勾配の全体は405×109×2=810 GB。TP×PP=8×16=128 で分担して約6.3 GB/GPU
- all-reduce の最良の下限:各GPUの網の帯域を400 Gbps=50 GB/s として、(6.3÷50)×2×127÷128=約0.25秒。ステップの約4%
これは、演算と重ねず、遅延・FSDP の重みの全収集・FP32 での勾配の通信(同論文は reduce-scatter を FP32 で行う)を含まない下限の目安です[参考資料1]。実際には、通信を計算に重ねて隠す工夫(DeepSeek-V3 の DualPipe など)[参考資料2]と、それでも隠しきれない部分の取り合いになります。
5. 学習の効率 ― MFU の読み方
学習の効率の指標として広く使われるのが MFU(Model FLOPs Utilization、モデル演算の利用率)です。PaLM の論文は、MFU を「観測したトークン処理の速さを、ピーク演算で動く系の理論上の最大の速さで割った比」と定義し、分子には順伝播と逆伝播に必要な演算だけを数え、再計算(rematerialization)は数えない、としています事実[参考資料8]。実装に依存せず、系の間の比較が比較的きれいにできる、というのが提案の趣旨です。
- 公表された値:PaLM 540B は6,144個の TPU v4 で MFU 46.2%(ハードウェアの演算の利用率 HFU は57.8%)、GPT-3 は21.3%、Gopher は32.5%、Megatron-Turing NLG は30.2%[参考資料8]。Llama 3 405B は BF16 で38〜43%(8K GPUで43%、16K GPUで41%)[参考資料1]。MegaScale は12,288個の GPU で175Bモデルを学習し、MFU 55.2%(Megatron-LM に対して1.34倍)[参考資料10]。選択的な活性化の再計算を使った530Bの学習は2,240個の A100 で54.2%[参考資料9]
- MFU を並べても、優劣は決まらない:チップ(TPU・GPU)、精度、モデルの構造、年代、数え方(注意の計算を含むか)が違います。PaLM の論文自体も、GPT-3 の値は「注意を除く非注意のモデルのTFLOP/s」から、MT-NLG は注意を含む・含まない両方の値を示すなど、数え方の違いを注記しています[参考資料8]
- MFU は上がるほど良いが、100%にはならない:通信、遅い1台、メモリの読み書き、チェックポイント、故障の復旧が、すべて分母(ピーク)に対する損失になります。次章の「有効な学習時間」も別の損失です
- 通信を計算に重ねる:DeepSeek-V3 の報告は、DualPipe により計算と通信のほとんどを重ねて隠し、計算と通信の比を一定に保つ限り、規模を増やしても、細かい専門家を複数ノードに置けて、all-to-all の通信の負担がほぼゼロにできる、と述べます[参考資料2](著者の主張)
①ピーク演算は精度と疎性の条件つき(本シリーズ『AIアクセラレータ』編)。分母をどの値にしたかで MFU が変わります。②演算量の数え方(注意の計算、再計算の扱い)で分子が変わります。③「チップが違えば1%の差に意味はない」ことが多く、MFU は自分のクラスターで設定を変えたときの改善を見る道具として使うのが無難です(本記事による解説)。
6. 故障と耐障害性
同期して進む学習は、1つのGPUの故障がジョブ全体の再起動につながりうる、と Llama 3 の論文は述べます。論文は、54日間の記録で、466回の中断(うち47回は保守や設定の更新などの計画的なもの、419回は予期しないもの)があり、予期しない中断の約78%が、確認済みまたは疑われるハードウェアの問題(GPU・ホスト部品の故障、サイレントなデータ破損、計画外の保守など)で、大きな手作業の介入は3回だけだった、と報告します事実[参考資料1]。それでも、自動の保守(ファームウェアや Linux カーネルの更新)を含めて、有効な学習時間は90%超でした[参考資料1]。
| 項目 | Llama 3 の記録(54日間、16K GPU) | 読み方 |
|---|---|---|
| 予期しない中断の平均の間隔 | 1,296時間÷419回=約3.1時間本稿の計算 | 規模が大きいほど、部品1つの故障が稀でも、全体では頻繁に起きる。システム全体の故障間隔は、部品の故障間隔を数で割った程度になる(単純化) |
| 原因の内訳(件数) | 故障したGPU 148、GPUのHBM3メモリ 72、ソフトウェアの不具合 54、ネットワーク(スイッチ・ケーブル)35、ホストの計画外の保守 32、GPUのSRAM 19、GPUのシステムプロセッサ 17、GPUの熱界面とセンサ 6、サイレントなデータ破損 6、他30(合計419) | GPU に分類された原因の合計は268件(64.0%)本稿の計算。論文の表の割合のうち「故障したGPU」の30.1%は、件数148÷419の35.3%と一致せず、本文の「GPUが58.7%」もこの30.1%を使った値のようです。本記事は件数を主に使います |
| 対策(論文の記述) | ジョブの起動とチェックポイントの時間を短縮、素早い診断ツール、通信の記録(NCCL のフライトレコーダー)、遅い1台(ストラグラー)の特定。1台の遅いGPUが数千のGPUを遅くしうる | 故障を前提に、検出・切り分け・復旧を自動化する。観測が鍵(MegaScale も、大規模でのみ現れる安定性の問題は詳細な観測で解く、と述べる[参考資料10]) |
| チェックポイント | 1GPUあたり1 MB〜4 GBの状態を保存。ストレージは持続2 TB/s、ピーク7 TB/s[参考資料1] | 最大の大きさを全GPUで保存すると16,384×4 GB=約65.5 TB、ピークの7 TB/sで約9秒、持続の2 TB/sで約33秒本稿の計算(上限の目安) |
「記録」の列は事実(Llama 3 の論文)。右の列のうち本稿の計算と記した部分と、解説の部分は本記事によります。
チェックポイントの間隔の目安
チェックポイント(途中経過の保存)は、頻繁にするほど失う作業は減りますが、保存の時間が増えます。Young と Daly の一次近似では、保存にかかる時間をδ、平均の故障間隔を M として、最適な間隔は τ≈√(2δM) です[参考資料11・12]。M=3.1時間(11,130秒)に、保存時間 δ=60秒(仮定)を当てはめると、τ≈1,155秒(約19分)、無駄になる時間の割合はおよそ δ/τ+τ/(2M)≈10%です本稿の計算。δ を10秒に縮められれば、τ≈472秒(約8分)、割合は約4%になります。保存を速くするほど、故障が頻繁でも無駄が減ることを示す例示で、δ は仮定、式は一次近似です。
規模に特有の問題:電力の揺れと温度
- 電力の揺れ:Llama 3 の論文は、数万のGPUが同時に電力を増減させる(全員がチェックポイントや集団通信の完了を待つ、ジョブの起動・停止など)と、データセンターの電力が数十メガワットの規模で瞬時に変動し、電力網の限界に迫ると述べます[参考資料1]。NVIDIA も、Rubin のラックで電力平滑化を組み込み、50ミリ秒のピーク電力を約20%減らしたと説明します(同社の値)[参考資料5]。電力と冷却は本シリーズ『AIデータセンターの電力と冷却』『データセンターと蓄電』編で扱います
- 温度の影響:Llama 3 405B の学習で、時刻に応じた1〜2%のスループットの日変動があり、日中の高い気温が GPU の動的な電圧・周波数の制御に影響するため、と論文は述べます[参考資料1]
- Kokolis らの分析:Meta の2つの大規模クラスター(11か月、400万ジョブ、1.5億 A100 GPU 時間超)の分析で、大きなジョブほど故障の影響を受けやすいが、数の上では小さなジョブが大半なので最適化の目的に含めるべきこと、故障のモデルから規模ごとの平均故障間隔を予測できること、を報告します[参考資料28]
7. 素材技術者の視点:故障の内訳、温度、配線
Llama 3 の予期しない中断419件の表には、GPU の HBM3 メモリ 72件(17.2%)、GPU の熱界面とセンサ 6件(1.4%)、ネットワークのスイッチ・ケーブル 35件(8.4%)、サイレントなデータ破損 6件(1.4%)が項目として並びます[参考資料1]。件数÷419の割合は本稿の計算です。HBM は本シリーズ『HBM』『CoWoS』編、熱界面は『熱界面材料TIM』編、ケーブルは『光トランシーバー』『光インターコネクトとSerDes』編の対象です。
ただし、この表は故障の「分類」であって、材料の劣化が原因だったかどうかは書かれていません。たとえば、HBM3 の件数が、メモリの素子の問題なのか、積層・封止・熱の問題なのかは、この表から読めません(確認できなかった)。素材技術者にとって読めるのは、規模が大きいほど、部品1つの稀な故障が、全体では「約3時間に1回」の頻度で現れるという点です。16,384個のGPUが各700 W(TDP)なら、GPUだけで約11.5 MWになり本稿の計算、熱サイクルの回数と温度の振れ幅も、部品の信頼性への入力として大きくなります(本記事による解説。推測:故障の増減と、材料・温度の関係は、公開資料では確認できませんでした)。
また、Llama 3 の論文は、時刻による1〜2%のスループットの変動を、日中の気温が GPU の電圧・周波数の制御に影響するためと述べています[参考資料1]。冷却の余裕が、そのまま「学習に使える演算」になる例です。
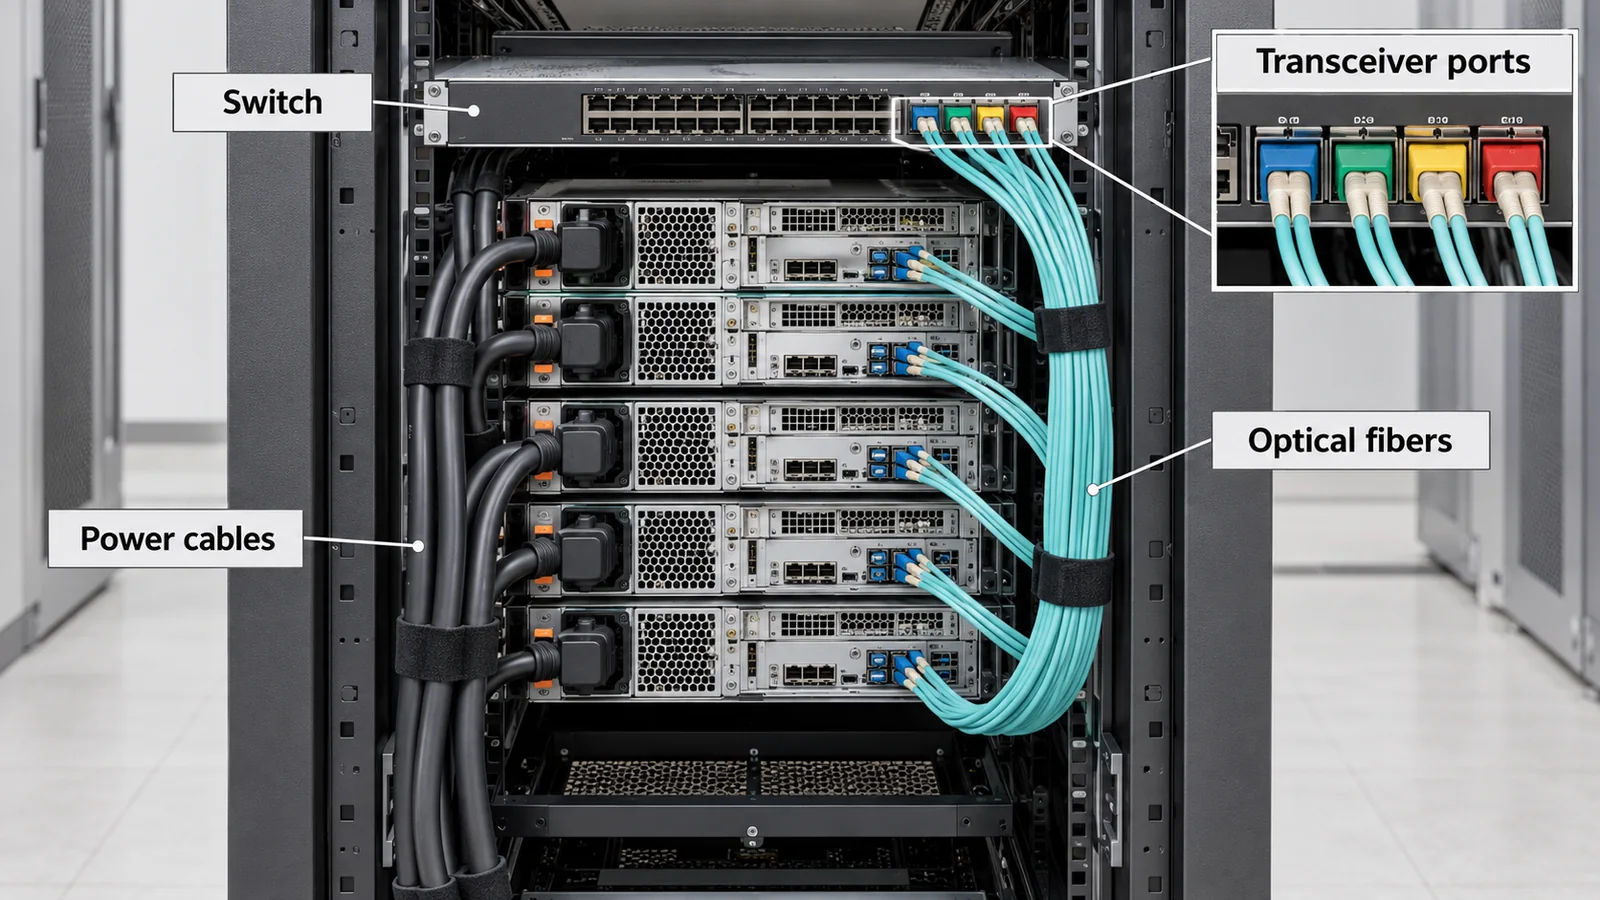
スケールアップの通信は、短い距離を非常に太く結ぶため、銅線が使われてきました。UALink の200G 1.0 仕様は銅線ベースで、リピーターなしの最大の距離は数メートル、光は将来の検討、と同団体は説明しています事実[参考資料24]。NVIDIA の Rubin のラックは、ケーブルのない計算トレイとスイッチトレイ、45 ℃の液冷を備えると説明されます[参考資料5]。
素材から見ると、信号の速度が上がるほど、基板の誘電体、コネクタ、ケーブルの損失が、銅で届く距離(つまり1つのスケールアップの領域に入れられるGPUの数)を決めます。その外側(スケールアウト)では光が使われ、Llama 3 でも、ネットワークのスイッチ・ケーブルが予期しない中断の8.4%を占めました[参考資料1]。光の部品は本シリーズ『光トランシーバー』『Co-packaged Optics』『光インターコネクトとSerDes』編で扱います(本記事による解説。具体的な材料の損失の値は、本記事では評価しません)。
8. 限界と、確認できなかったこと
(1) 公表の範囲
多くの数字は、1つの組織が公表した1つのクラスターの1つの期間の値(Llama 3 の54日間など)です。他社の最新の大規模学習の構成や故障率は、公表資料の範囲で確認できませんでした。
(2) 帯域の方向と定義
NVLink などの帯域は、片方向か双方向合計かが資料で明記されないものがあり、ネットワークの400 Gbps(片方向の線速度)と直接比べられません。図3の「18倍」は目安です。
(3) 規格・仕様の状態
UEC 1.1(2026年10月12日)は確認日の3日前の公開で、実装・相互運用の実績は確認していません。IEEE P802.3dj の状態は確認できませんでした。規格の本文は読んでいません。
(4) 故障の原因
Llama 3 の表は分類で、材料・温度との因果は読めません。また、表の割合の一部に、論文内の不整合(故障したGPUの30.1%と件数148÷419の35.3%)があります。
(5) 計算の前提
通信量・チェックポイントの計算は、公表値からの理想化・仮定(δ=60秒など)を含み、実測ではありません。MFU は設定が違い、並べて優劣をつけられません。
- モデルを分けると通信が要る。データ・テンソル・パイプライン(と系列・専門家)並列を、通信路の階層に合わせて組み合わせます。Llama 3 では TP=8 を同じサーバー内に置きました事実
- 通信路はスケールアップとスケールアウトの2層。NVLink は1.8〜3.6 TB/s、ネットワークは400 Gbps(50 GB/s)の例。UEC 1.1 は2026年10月12日公開、UALink は銅で数メートルまで事実
- all-reduce の通信量は、台数が増えても約2倍で頭打ち(帯域だけで決まる最良の場合)。Llama 3 の勾配の同期の下限は1ステップの約4%の見積り本稿の計算
- MFU は38〜55%の公表例があるが、設定が違い並べて比べない。PaLM が定義した、必要な演算だけを数える指標です事実
- 規模が大きいと、稀な故障が頻繁になる。54日間に419件の予期しない中断(約3.1時間に1回)、有効な学習時間は90%超事実/本稿の計算
9. 評価・標準の読み方
学習クラスターの性能は、①学習の速さ(共通課題で目標精度に達するまでの時間)、②効率(MFU など)、③通信の性能と規格への適合、④信頼性(中断の数、有効な学習時間)、⑤電力・冷却で評価されます。①は MLCommons の MLPerf、②と④は論文での定義と報告が中心で、③は IEEE・IBTA・UEC・UALink の規格・仕様が関わります。確認日(2026年10月15日)時点で、②MFU と④信頼性を直接の対象にした、確定した国際規格(ISO/IEC・IEEE)は確認できませんでした。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(IEEE・IBTA・UEC・UALink・ISO/IEC など) | 読み方の注意 |
|---|---|---|---|
| 学習の速さ 事実 | MLPerf Training v6.0(MLCommons、2026年6月16日):24組織が95システム(60%は複数ノード)、13種類のアクセラレータで提出。DeepSeek V3(総671B・活性37B)と GPT-OSS 20B の課題が追加されたと発表[参考資料30] | MLPerf は業界団体のベンチマークで、ISO/IEC や IEEE の規格ではない | 精度の閾値を満たす提出のみ比較できる。システムの規模・構成・ソフトウェア・版を読む。MFU や故障率は報告しない |
| 効率(MFU) 事実 | PaLM の論文が定義した MFU(必要な順伝播・逆伝播の演算だけを分子に数える)[参考資料8]。公表値:PaLM 46.2%、Llama 3 405B 38〜43%、MegaScale 55.2% など[参考資料1・8〜10] | MFU を定める確定の規格は確認できなかった(論文での定義) | チップ・精度・数え方が違い、並べて優劣をつけない。分母のピーク値は精度・疎性の条件つき。改善の確認に使う |
| 通信の性能 事実 | NCCL-tests の algbw と busbw(NVIDIA の文書):busbw は all-reduce で algbw×2(n−1)/n[参考資料7] | IEEE Std 802.3df-2024(400/800 Gb/s Ethernet、2024-02-16 承認)[参考資料26]。IEEE P802.3dj(200 Gb/s〜1.6 Tb/s、状態は確認できなかった)未確定/将来[参考資料27]。IBTA の InfiniBand・RoCE 仕様(Volume 1・2 Release 2.1)[参考資料25]。UEC 仕様 1.1(2026-10-12、1.0 は2025-06-11)[参考資料21]。UALink 200G 1.0(2025-04-08)ほか[参考資料22・23] | 規格・仕様への適合は、実運用の速さを保証しない。UEC・UALink・IBTA は業界団体の仕様。UEC 1.1 は公開から日が浅く、実装の実績は確認していない。方向(片方向/双方向)と単位(Gbps/GB/s)をそろえて読む |
| 信頼性 事実 | Llama 3:54日間の中断466回(予期しないもの419回)、有効な学習時間90%超[参考資料1]。Kokolis ら:11か月・400万ジョブの分析、有効な学習時間の比(Effective Training Time Ratio)などの指標[参考資料28]。MegaScale:安定性と観測[参考資料10] | 該当する確定の規格は確認できなかった | 1つのクラスター・期間の値で、一般化できない。「故障」の定義と分類は報告ごとに違う |
| 電力・冷却 事実 | Llama 3:電力が数十メガワット規模で瞬時に変動[参考資料1]。NVIDIA:Rubin のラックの電力平滑化と45 ℃の液冷[参考資料5] | 確定の国際規格は、本記事では確認できなかった | メーカー・事業者の公称値で、第三者の測定ではない。詳細は本シリーズ『AIデータセンターの電力と冷却』編 |
表の整理は本稿の計算(本記事による編集)。規格の本文は未確認のため、要求事項の中身は書いていません。
読み方の注意
- ベンチマークの数値は、設定と実施主体で変わります。MLPerf はシステムの規模・構成・版が違い、MFU はチップ・精度・数え方が違います。本記事は、論文や発表の値を転記し、優劣をつけません
- 飽和と汚染:MLPerf は課題を更新して時代の負荷に合わせています(今回は MoE モデルの課題が加わった)[参考資料30]。旧い課題の結果は、最新の学習の負荷を表さないことがあります
- 「規格」と「業界団体の仕様」と「報告」は別です。IEEE Std 802.3df-2024 は規格、UEC・UALink・IBTA は業界団体の仕様、MFU や中断の数は論文の報告です。どれも、それ自体は法令ではありません
- 宣言値と実測値の違い。NVLink の1.8 TB/s や網の400 Gbps は線速度の上限です。実際の学習で得られる通信の速さは、遅延・混雑・ソフトウェアで下がります
10. 用語集
- データ並列/テンソル並列/パイプライン並列
- データを分ける/1層の行列を分ける/層を前後の段に分ける並列化。
- FSDP/ZeRO
- モデル・最適化状態・勾配をGPUに分けて持つデータ並列。
- スケールアップ/スケールアウト
- 少数のGPUの直結/多数のサーバーのネットワーク接続。
- NVLink/NVSwitch
- NVIDIA のGPU間の直結とそのスイッチ。
- InfiniBand/RoCE
- RDMA を使う高速ネットワーク/Ethernet 上の RDMA。
- UEC/UALink
- AI向けEthernetの業界団体/スケールアップ接続の業界団体。
- 集団通信(all-reduce など)
- 多数のGPUが一緒に行う通信。足し合わせ・集める・配る。
- NCCL
- NVIDIA の多GPU向け通信ライブラリ。
- MFU/HFU
- 必要な演算だけで数えた利用率/再計算を含めた利用率。
- 有効な学習時間
- 経過時間のうち、有効な学習に使えた時間の割合。
- ストラグラー
- 動いているが遅い1台。全体を遅くする。
- チェックポイント
- 途中経過の保存。故障時にここから再開する。
- サイレントなデータ破損
- エラーが出ないまま計算結果が誤る故障。
- 過加入(oversubscription)
- 上位の帯域が、下位の合計より細いこと(1:7など)。
11. 参考資料(一次情報)
- Grattafiori A. ほか(Meta) "The Llama 3 Herd of Models", arXiv:2407.21783 — arxiv.org/abs/2407.21783
- DeepSeek-AI "DeepSeek-V3 Technical Report", arXiv:2412.19437 — arxiv.org/abs/2412.19437
- NVIDIA "NVIDIA HGX Platform" (specifications of HGX Rubin NVL8, B300 and B200) — www.nvidia.com/en-us/data-center/hgx/
- NVIDIA "GB200 NVL72" — www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA "Inside NVIDIA Rubin GPU Architecture: Powering the Era of Agentic AI", NVIDIA Technical Blog (2026年7月21日) — developer.nvidia.com/blog/inside-nvidia-rubin-gpu-architecture-powering-the-era-of-agentic-ai/
- Patarasuk P., Yuan X. "Bandwidth optimal all-reduce algorithms for clusters of workstations", J. Parallel Distrib. Comput. 69, 117-124 (2009), DOI 10.1016/j.jpdc.2008.09.002 — doi.org/10.1016/j.jpdc.2008.09.002
- NVIDIA "Performance reported by NCCL tests" (nccl-tests, GitHub) — github.com/NVIDIA/nccl-tests/blob/master/doc/PERFORMANCE.md
- Chowdhery A. ほか(Google) "PaLM: Scaling Language Modeling with Pathways", arXiv:2204.02311 — arxiv.org/abs/2204.02311
- Korthikanti V. ほか "Reducing Activation Recomputation in Large Transformer Models", arXiv:2205.05198 — arxiv.org/abs/2205.05198
- Jiang Z. ほか "MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs", arXiv:2402.15627 — arxiv.org/abs/2402.15627
- Young J. W. "A first order approximation to the optimum checkpoint interval", Commun. ACM 17(9), 530-531 (1974), DOI 10.1145/361147.361115 — doi.org/10.1145/361147.361115
- Daly J. T. "A higher order estimate of the optimum checkpoint interval for restart dumps", Future Gener. Comput. Syst. 22, 303-312 (2006), DOI 10.1016/j.future.2004.11.016 — doi.org/10.1016/j.future.2004.11.016
- NVIDIA "H100 GPU" — www.nvidia.com/en-us/data-center/h100/
- Shoeybi M. ほか "Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism", arXiv:1909.08053 — arxiv.org/abs/1909.08053
- Narayanan D. ほか "Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM", arXiv:2104.04473 — arxiv.org/abs/2104.04473
- Huang Y. ほか "GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism", arXiv:1811.06965 — arxiv.org/abs/1811.06965
- Rajbhandari S. ほか "ZeRO: Memory Optimizations Toward Training Trillion Parameter Models", arXiv:1910.02054 — arxiv.org/abs/1910.02054
- Zhao Y. ほか "PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel", arXiv:2304.11277 — arxiv.org/abs/2304.11277
- Li S. ほか "PyTorch Distributed: Experiences on Accelerating Data Parallel Training", arXiv:2006.15704 — arxiv.org/abs/2006.15704
- Zhao C. ほか "Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures", arXiv:2505.09343 — arxiv.org/abs/2505.09343
- Ultra Ethernet Consortium "Specification History" — ultraethernet.org/specification-history/
- UALink Consortium "Specifications" — ualinkconsortium.org/specification/
- UALink Consortium "UALink Consortium Releases the Ultra Accelerator Link 200G 1.0 Specification" (ニュースリリース、2025年4月8日) — ualinkconsortium.org/wp-content/uploads/2025/04/UALink-1.0-Specification-PR_FINAL.pdf
- UALink Consortium "FAQ" — ualinkconsortium.org/faq/
- InfiniBand Trade Association "InfiniBand Trade Association" (InfiniBand and RoCE Specifications) — www.infinibandta.org/
- IEEE 802.3 "IEEE P802.3df 400 Gb/s and 800 Gb/s Ethernet Task Force" (IEEE Std 802.3df-2024) — www.ieee802.org/3/df/index.html
- IEEE 802.3 "IEEE P802.3dj 200 Gb/s, 400 Gb/s, 800 Gb/s, and 1.6 Tb/s Ethernet Task Force" — www.ieee802.org/3/dj/index.html
- Kokolis A. ほか(Meta) "Revisiting Reliability in Large-Scale Machine Learning Research Clusters", arXiv:2410.21680 — arxiv.org/abs/2410.21680
- Gangidi A. ほか(Meta) "RDMA over Ethernet for Distributed Training at Meta Scale", Proc. ACM SIGCOMM 2024, 57-70, DOI 10.1145/3651890.3672233 — doi.org/10.1145/3651890.3672233
- MLCommons "MLCommons Releases MLPerf Training v6.0 Results" (2026年6月16日) — mlcommons.org/2026/06/mlperf-training-v6-0-results/
- NVIDIA "Collective Operations", NCCL 2.32.3 documentation — docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html
- Liu H. ほか "Ring Attention with Blockwise Transformers for Near-Infinite Context", arXiv:2310.01889 — arxiv.org/abs/2310.01889
12. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| Llama 3 405B の学習(最大16K H100、各700 W TDP・80 GB HBM3、サーバー内8 GPU は NVLink、400 Gbps の接続、RoCE の24K GPU クラスター・3層 Clos・最上層1:7、4D並列 TP・CP・PP・DP、MFU 38〜43%、Table 4 の構成と 400 TFLOPS、NCCLX、54日間の466回の中断と419回の予期しない中断、約78%がハードウェア、有効な学習時間90%超、ストラグラー、1〜2%の日変動、数十メガワットの電力の揺れ、チェックポイントの大きさとストレージの帯域、Table 5 の件数) | Llama 3 の論文 出典1 https://arxiv.org/abs/2407.21783 | 事実 |
| DeepSeek-V3(2,048個の H800、NVLink・NVSwitch と InfiniBand、DualPipe と計算・通信の重ね合わせ、ノード間 all-to-all、高価なテンソル並列なし)、その解説論文 | DeepSeek の技術報告と解説論文 出典2 https://arxiv.org/abs/2412.19437 出典20 https://arxiv.org/abs/2505.09343 | 事実 |
| NVLink の世代別の帯域(H100 900 GB/s、Blackwell 1.8 TB/s、Rubin 3.6 TB/s)、HGX B200 のネットワーク帯域0.8 TB/s・Rubin NVL8 の1.8 TB/s、GB200 NVL72(72 GPU の NVLink 領域、130 TB/s、液冷)、Rubin のラック(ケーブルのない計算・スイッチトレイ、45 ℃の液冷、電力平滑化で50 ms のピーク電力を約20%減) | NVIDIA の製品ページと技術ブログ 出典3 https://www.nvidia.com/en-us/data-center/hgx/ 出典4 https://www.nvidia.com/en-us/data-center/gb200-nvl72/ 出典5 https://developer.nvidia.com/blog/inside-nvidia-rubin-gpu-architecture-powering-the-era-of-agentic-ai/ 出典13 https://www.nvidia.com/en-us/data-center/h100/ | 事実 |
| リング all-reduce の帯域最適性、all-reduce の最良の時間 t=(S/B)×2(n−1)/n と busbw、NCCL の集団操作の一覧 | 論文と NVIDIA の文書 出典6 https://doi.org/10.1016/j.jpdc.2008.09.002 出典7 https://github.com/NVIDIA/nccl-tests/blob/master/doc/PERFORMANCE.md 出典31 https://docs.nvidia.com/deeplearning/nccl/user-guide/docs/usage/collectives.html | 事実 |
| MFU の定義、GPT-3 21.3%・Gopher 32.5%・MT-NLG 30.2%・PaLM 46.2%(HFU 57.8%)、530B の学習54.2%、MegaScale 55.2%(Megatron-LM の1.34倍) | 各論文 出典8 https://arxiv.org/abs/2204.02311 出典9 https://arxiv.org/abs/2205.05198 出典10 https://arxiv.org/abs/2402.15627 | 事実 |
| Young の一次近似と Daly の高次の推定(最適なチェックポイント間隔) | 各論文(DOI) 出典11 https://doi.org/10.1145/361147.361115 出典12 https://doi.org/10.1016/j.future.2004.11.016 | 事実 |
| 並列化の代表的な資料:Megatron-LM(512 GPU・83億・76%)、Narayanan ら(10%超の改善)、GPipe、ZeRO、FSDP、DDP、コンテキスト並列(Ring Attention) | 各論文 出典14 https://arxiv.org/abs/1909.08053 出典15 https://arxiv.org/abs/2104.04473 出典16 https://arxiv.org/abs/1811.06965 出典17 https://arxiv.org/abs/1910.02054 出典18 https://arxiv.org/abs/2304.11277 出典19 https://arxiv.org/abs/2006.15704 出典32 https://arxiv.org/abs/2310.01889 | 事実 |
| UEC の仕様の履歴(1.0 は2025-06-11、1.0.3 は2026-07-16、1.1 は2026-10-12 で現行)と Linux Foundation の関連の組織であること | UEC のページ 出典21 https://ultraethernet.org/specification-history/ | 事実 |
| UALink の仕様(200G 1.0 は2025-04-08に承認・公開、1レーン200G・最大1,024個、Common 2.0 ほか)、銅線で数メートルまで、光は将来の検討、UEC との補完関係 | UALink コンソーシアムの資料 出典22 https://ualinkconsortium.org/specification/ 出典23 https://ualinkconsortium.org/wp-content/uploads/2025/04/UALink-1.0-Specification-PR_FINAL.pdf 出典24 https://ualinkconsortium.org/faq/ | 事実 |
| IBTA の InfiniBand・RoCE 仕様(Volume 1・2 Release 2.1)、IEEE Std 802.3df-2024(2024-02-16 承認)、P802.3dj のページ(状態は確認できなかった)、Meta の RoCE の論文 | IBTA・IEEE 802.3・ACM のページ 出典25 https://www.infinibandta.org/ 出典26 https://www.ieee802.org/3/df/index.html 出典27 https://www.ieee802.org/3/dj/index.html 出典29 https://doi.org/10.1145/3651890.3672233 | 未確定/将来 |
| Kokolis らの分析(11か月、400万ジョブ、1.5億 A100 GPU 時間超、大きなジョブほど故障の影響を受けやすい、平均故障間隔の予測、有効な学習時間の比) | 論文 出典28 https://arxiv.org/abs/2410.21680 | 事実 |
| MLPerf Training v6.0(2026-06-16、24組織・95システム・60%は複数ノード・13種類のアクセラレータ、DeepSeek V3 と GPT-OSS 20B の追加、精度の閾値) | MLCommons の発表 出典30 https://mlcommons.org/2026/06/mlperf-training-v6-0-results/ | 事実 |
| 勾配の同期の下限の計算(演算の時間 約5.93秒、勾配の断片 約6.3 GB、all-reduce 約0.25秒=約4%)、係数 2(n−1)/n の値、中断の間隔 約3.1時間、割合(件数÷419)、GPU分類の合計268件(64.0%)、チェックポイントの時間(約9秒・約33秒)、Young/Daly の例(τ≈19分、約10%、δ=10秒で約8分・約4%)、16,384×700 W=約11.5 MW | 本稿の計算。公表値からの理想化・仮定(δ=60秒など)で実測ではない。演算量は6×パラメータ数×トークン数の近似 | 本稿の計算 |
| 論文内の不整合(「故障したGPU」の件数148÷419=35.3%と、表の30.1%・本文の58.7%の不一致)の指摘 | 本稿による照合(Llama 3 の Table 5 と本文の突き合わせ) 出典1 https://arxiv.org/abs/2407.21783 | 事実 |
| 最新の大規模学習の故障率、帯域の方向の定義がそろった比較、故障と材料の因果、規格の本文、UEC 1.1 の実装の実績 | 本稿の調査範囲では確認していない | 解説 |
| 「故障の表に素材・パッケージの名前が並ぶ」「近い通信は銅、遠い通信は光で、速度が上がるほど届く距離が材料で決まる」「並列化はメモリと通信のトレードオフ」という読み取り、図の整理 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2〜図6が実在の製品の構造やデータではなく説明のための作図であること。図1と図7がAI生成イメージであること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(Llama 3・PaLM・MegaScale・DeepSeek-V3 などの論文、NVIDIA・UEC・UALink・IBTA・IEEE の公式ページ、MLCommons の発表)に限定しています。規格の本文は確認していません。 この分野は変化が速く、規格・仕様の版と状態は確認日(2026年10月15日)のものです。 最新の大規模学習の故障率、帯域の方向の定義が揃った比較、故障と材料の因果、規格の本文については、確認できなかったため記載していません。 図2〜図6はベクター作図、図1と図7はAI生成イメージであり、いずれも実在の施設・製品・測定結果を示すものではありません。