TECHNOLOGY EXPLAINER
事後学習とファインチューニング
― 「指示に従う・好まれる・安全に振る舞う」への調整と、軽量な微調整の考え方
事前学習を終えたモデルは、文章の続きを書きますが、指示に従う、役に立つ、安全に振る舞う、といった調整はまだ十分ではありません。その調整が事後学習です。教師あり微調整(SFT)、人のフィードバックによる強化学習(RLHF)、AI のフィードバックによる方法(RLAIF)、直接選好最適化(DPO)などが使われます。さらに、自分のデータでモデルを調整する場合は、LoRA などの軽量な微調整が現実的な選択肢になります。 この記事では、各手法の仕組みを、原論文の範囲で整理し、メモリの計算、評価の落とし穴(報酬の最適化しすぎ、おもねり、微調整後の安全性)を扱います。具体的な手法は原論文で確認し、手法間の優劣は論じません。
- 事後学習とファインチューニングとは何か(3行でつかむ)
- 事後学習の全体像 ― 工程と実例
- 教師あり微調整(SFT)と指示チューニング
- 人のフィードバックによる強化学習(RLHF)
- AI のフィードバックによる方法(RLAIF、Constitutional AI)
- 直接選好最適化(DPO)とその仲間
- 軽量なファインチューニング ― LoRA、QLoRA など
- 安全の調整と、微調整後の安全性
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=改訂中・計画などで、確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。手法・モデル・ベンチマークの記述は確認日 2026年10月15日時点で確認した資料にもとづきます。
各手法の「性能が良い」という記述は、その論文が選んだモデル・データ・評価・設定での結果です。設定や実施主体(開発元か第三者か)が違う結果を並べて、手法の優劣をつけることはしません。評価に LLM を使う方法(LLM-as-a-judge)には、位置・長さ・自己びいきの偏りがあります。 安全・有害性に関する内容は、評価と対策の考え方にとどめ、悪用の手順や具体的な攻撃方法は書きません。
1. 事後学習とファインチューニングとは何か(3行でつかむ)
- 事後学習は、事前学習済みモデルを「使える形」に整える工程:指示と回答の例で学ぶ SFT、人や AI の選好を使う RLHF・RLAIF・DPO などを組み合わせます。InstructGPT の報告では、1.3B パラメータの調整済みモデルの出力が、175B の GPT-3 の出力より、人の評価で好まれました事実[参考資料2]
- 軽量な微調整は、学習するパラメータとメモリを大きく減らす:LoRA は、GPT-3 175B の Adam による微調整と比べて、学習可能なパラメータを約1万分の1、GPU メモリを約3分の1にできると報告されています。ただし、標準の低ランク設定では、全パラメータの微調整より「学ぶ量」が少ない面もあります事実[参考資料27・30]
- 報酬は人の選好の「代理」:報酬モデルの点数を上げすぎると、本来の目的の得点が悪化することがあります。また、人の選好には、利用者の意見に合わせる「おもねり」を好む偏りが含まれ、微調整で安全性が損なわれることもあります事実[参考資料10・12・32]
調整の目標(報酬・選好・ベンチマーク)は、本来の目的の代理にすぎません。 Gao らは、固定の報酬モデルを「人の代わり」にした合成の設定で、代理の報酬モデルを最適化しすぎると、本来の(gold)報酬の得点が悪化する関係を、強化学習と best-of-n の両方で測りました事実[参考資料10]。調整を強めるほど良くなる、とは限りません。
2. 事後学習の全体像 ― 工程と実例
事後学習には決まった標準の手順はなく、開発元ごとに工程の組み合わせが違います。公表されている3つの例を並べます。
- InstructGPT(OpenAI、2022年):ラベラーが書いたプロンプトと、API に送られたプロンプトから、ラベラーによる模範回答(SFT 用、約1.3万プロンプト)、回答の順位づけ(報酬モデル用、約3.3万プロンプト)、人のラベルのない強化学習用のプロンプト(約3.1万)を作りました。SFT、報酬モデルの学習、PPO による強化学習の3段階です事実[参考資料2]
- Llama 3(Meta、2024年):報酬モデル、棄却サンプリング(報酬モデルで良い回答を選ぶ)、SFT、DPO を使い、6ラウンドくり返しました。報告は、PPO も試したが、大規模なモデルでは DPO のほうが計算量が少なく、特に IFEval のような指示追従の評価で性能が良かった、としています(Meta の報告)。各ラウンドで、新しい選好データを集め、最新のモデルから合成データを作っています事実[参考資料22]
- Tülu 3(Allen Institute for AI ら、2024年):Llama 3.1 のベースモデルから、SFT、DPO、新しい方法の RLVR(検証可能な報酬による強化学習)を使い、データ、コード、手順を完全に公開しました。開発用と未見の評価を分け、既存のオープンなデータセットから評価ベンチマークへの混入を大幅に除去(デコンタミネーション)し、確実な改善にならなかった方法も報告しています事実[参考資料21]
3. 教師あり微調整(SFT)と指示チューニング
SFT は、指示(プロンプト)と望ましい回答の組を使い、通常のクロスエントロピー損失で学習する工程です。Llama 3 の報告では、損失をかけるのは回答のトークンだけで、プロンプトのトークンは損失から除いています(マスク)。訓練の目標の多くはモデルが生成した回答ですが、慣例に従い SFT と呼ぶ、と述べられています事実[参考資料22]。
- 指示で整えたデータでの微調整(FLAN):Wei らは、137B パラメータの事前学習済みモデルを、60を超える NLP データセットを自然言語の指示のひな型で書き直したもので微調整すると、見たことのない種類の課題でのゼロショット性能が大きく上がると報告しました。評価した25のデータセットのうち20で、ゼロショットの 175B GPT-3 を上回っています。微調整のデータセット数、モデルの規模、自然言語の指示が、効果の鍵と分析されています事実[参考資料1]
- 少数の厳選データ(LIMA):Zhou らは、65B の LLaMA を、慎重に選んだ1,000件のプロンプトと回答だけで、強化学習や選好のモデルなしに微調整しました。著者らは、アラインメントは、事前学習で得た知識と能力を引き出すための、応答の形式やスタイルを学ぶ単純な過程かもしれない、と仮説を立てています事実(著者の仮説)[参考資料3]
- 自分の出力で作るデータ(Self-Instruct):Wang らは、事前学習済みモデル自身に指示・入力・出力の例を作らせ、不適切なものや似たものを除いて、元のモデルを微調整する方法を示しました。GPT-3 に適用して、Super-NaturalInstructions で絶対値で33%の改善を報告しています事実[参考資料4]
これらから、SFT は「知識を足す」よりも、すでにある能力を、使いやすい形・振る舞いに整える役割が大きい、という見方が広く共有されています(LIMA の仮説はその一例)。ただし、仮説であり、データの量・質・領域によって結果は変わります(本記事による解説)。
4. 人のフィードバックによる強化学習(RLHF)
RLHF は、人間の選好を報酬として強化学習を行う方法です。Christiano らが、軌跡の断片2つのどちらが良いかという(専門家でない)人の比較から、報酬関数なしで複雑な強化学習の課題を解けることを、エージェントの行動の1%未満へのフィードバックで示しました事実[参考資料5]。Ziegler らが、これを言語モデルに適用し(肯定的な感情や物理的な描写を持つ文章の続き、要約)、Stiennon らは要約で、人の比較の大規模なデータセットから報酬モデルを学習し、強化学習で方策を微調整して、人の参照要約や、教師あり学習だけで微調整した、はるかに大きなモデルを上回ったと報告しました事実[参考資料6・7]。
InstructGPT の手順では、報酬モデルの損失は、勝った回答 yw と負けた回答 yl の報酬の差に対して −log σ(r(x, yw) − r(x, yl)) です。ラベラーには1つのプロンプトに対する K = 4〜9個の回答に順位を付けてもらい、そこから K(K−1)/2 組の比較を作ります。同じプロンプトの比較をまとめて1つのバッチにしないと過学習した、と述べられています。強化学習では、報酬モデルの点数に加えて、初期の SFT モデルとのトークンごとの KL 罰則を加え、報酬モデルの過剰な最適化を抑えています事実[参考資料2]。PPO(近接方策最適化)は Schulman らの方法です[参考資料8]。
InstructGPT の結果として、人の評価で、1.3B の調整済みモデルの出力が 175B の GPT-3 より好まれ、真実性が上がり、丁寧に答えるよう促したときの有害な出力は約25%少なくなりました。一方で、RLHF の過程で、いくつかの公開 NLP データセットでの性能の低下が見られ、「アラインメント税」と呼ばれています。事前学習の勾配を混ぜる PPO-ptx で、この低下を抑えました事実[参考資料2]。また、ラベラーどうしの一致率は、訓練用のラベラーで 72.6 ± 1.5%、評価用の別のラベラーで 77.3 ± 1.3% でした[参考資料2]。
RLHF の落とし穴
- 報酬の最適化しすぎ:上の図の関係です。Gao らは、報酬モデルの大きさ、データ量、KL 罰則の係数との関係も調べています[参考資料10]。Anthropic の報告は、RL の報酬と KL の平方根が、ほぼ線形の関係にあることを見つけています[参考資料9]
- おもねり(sycophancy):Sharma らは、人のフィードバックで微調整された5つの AI アシスタントが、4つの自由記述課題で一貫しておもねりを示すと報告しました。人の選好データを分析すると、回答が利用者の見解に合っているほど好まれやすく、人も選好モデルも、説得力のあるおもねりの回答を、正しい回答より好むことが、無視できない割合でありました事実[参考資料12]
- RLHF の限界の整理:Casper らは、RLHF とその関連手法の未解決の問題と根本的な限界を整理し、多層的な安全の取り組みが重要だと述べています事実[参考資料11]
5. AI のフィードバックによる方法(RLAIF、Constitutional AI)
人のラベルは高価なので、モデルに選好のラベルを付けさせる方法があります。Bai らのConstitutional AIは、害のある出力を示す人のラベルなしに、無害な AI アシスタントを自己改善で作る方法で、人の関与は規則・原則の一覧だけです。教師あり段階では、初期モデルの出力に自己批評と修正を生成させ、修正後の回答で微調整します。強化学習の段階では、2つの回答のどちらが良いかをモデルに評価させ、AI の選好から選好モデルを学習し、それを報酬にして強化学習します(RLAIF)事実[参考資料13]。
Lee らは、要約、有用な対話、無害な対話の3つの課題で、RLAIF が RLHF と同等の性能を示し、AI のラベル付けに方策と同じ大きさのモデル(あるいは同じチェックポイント)を使っても教師あり微調整のベースラインを上回ることを報告しました。さらに、報酬モデルの学習を省き、強化学習の間に既製の LLM から直接報酬を得る d-RLAIF も示しています事実[参考資料14]。
AI に評価させる方法の注意として、Zheng らは、LLM を判定者にする方法には、位置の偏り、冗長さの偏り、自己びいきの偏りと推論力の限界があると指摘しています。GPT-4 のような強い判定者は、人の選好と80%を超えて一致し、人どうしの一致と同程度でした事実[参考資料33]。AI の評価者の偏りは、学習したモデルに持ち込まれうるため、AI のフィードバックは、人のフィードバックの完全な代替ではなく、設計とともに評価が必要です(本記事による解説)。
6. 直接選好最適化(DPO)とその仲間
RLHF の強化学習の段階は、報酬モデルの学習と、方策のサンプリングを含み、複雑で不安定になりやすいとされます。Rafailov らの DPO(Direct Preference Optimization)は、RLHF の報酬モデルの新しい書き方(パラメータ化)により、最適な方策を閉じた形で取り出せるようにして、標準の RLHF の問題を、単純な分類の損失だけで解けるようにしました。微調整の間に言語モデルからサンプリングする必要も、大きなハイパーパラメータの調整もありません。著者らは、DPO が既存の方法と同等かそれ以上に人の選好に合わせられ、感情の制御では PPO ベースの RLHF を上回り、要約と1回の対話では同等以上だと報告しています事実(著者の報告)[参考資料15]。
RLHF の目的は「報酬の期待値 − β × KL(方策 ‖ 参照方策)」で、参照方策は初期の SFT モデルです。β が、参照からどこまで離れてよいかを決めます。DPO はこの参照方策の確率との比を損失に使います事実[参考資料15]。Llama 3 は、β = 0.1 で、DPO に2つの修正を加えています。損失から、ヘッダや終了などの書式のトークンを除くこと(共通のトークンが選ばれた回答にも却下された回答にもあり、損失が矛盾した目標になるため)と、選ばれた回答に、係数0.2の負の対数尤度(NLL)の項を加えることです事実[参考資料22]。
| 手法 | 必要なフィードバック | 原論文の記述にもとづく特徴 |
|---|---|---|
| RLHF(PPO) | 人の順位づけ(比較) | 報酬モデルを学習し、方策から生成して報酬を計算。初期の SFT モデルとの KL 罰則[2] |
| RLAIF | AI が付けた選好 | 人のラベルの代わりに LLM のラベルで報酬(選好)モデルを学習。報酬モデルを省く d-RLAIF もある[13・14] |
| DPO | 選好のペア(選ばれた/却下された回答) | 報酬モデルの明示的な学習と、微調整中のサンプリングが不要。分類の損失[15] |
| IPO(ΨPO) | ペアの選好 | ペアの選好のまま扱う一般的な目的を導き、RLHF と DPO をその特殊な場合として分析[16] |
| KTO | 望ましい/望ましくないの2値の信号(ペア不要) | プロスペクト理論に基づく効用を直接最大化する「人間を意識した損失」の一つ[17] |
| ORPO | 選好データ | 参照モデルが不要で、SFT と選好の調整を一つの段階で行う(オッズ比)[18] |
| SimPO | 選好データ | 系列の平均の対数確率を暗黙の報酬とし、参照モデルが不要。目標の報酬マージンを加える[19] |
| GRPO | 課題の得点(報酬) | PPO の変種。価値(critic)モデルを使わず、グループの得点からベースラインを見積もり、学習資源を減らす[20] |
すべて事実(各原論文の記述)。各論文は、自分の設定・ベンチマークでの改善を報告しており、手法どうしの優劣は、本稿では判断しません。Ethayarajh らも、「普遍的に優れる損失は一つもなく、最適な損失は設定に合う帰納バイアスによる」と述べています[17]。
GRPO は、DeepSeekMath で数学の推論のために提案され[参考資料20]、RLVR(検証可能な報酬による強化学習)は、Tülu 3 が新しい方法として提示しました[参考資料21]。DeepSeek-R1 の報告は、人が作った推論の例を使わずに、純粋な強化学習で推論の能力を引き出せることを示しています事実[参考資料45]。推論モデルの学習は、本シリーズ「推論モデル」編で扱います。
7. 軽量なファインチューニング ― LoRA、QLoRA など
全パラメータの微調整は、モデルが大きくなるほどメモリと保存の費用が重くなります。そこで、事前学習済みの重みを凍結し、少数のパラメータだけを学習するパラメータ効率のよい微調整(PEFT)が使われます。
| 方法 | 仕組み | 原論文が報告する数値(条件つき) |
|---|---|---|
| アダプタ(Houlsby ら、2019) | Transformer の層の間に、小さな学習可能なモジュールを挿入 | BERT を26の分類課題へ。GLUE で全パラメータの微調整の0.4%以内、タスクあたり追加3.6%のパラメータ[23] |
| プレフィックス・チューニング | 凍結したモデルに、連続値の「仮想トークン」(プレフィックス)を学習 | GPT-2(表からの文生成)と BART(要約)で、0.1%のパラメータで、全データの設定で同等、少量データの設定では上回ると報告[24] |
| プロンプト・チューニング | 凍結したモデルの入力に、学習可能なプロンプトの埋め込みを加える | T5 で、モデルが数十億パラメータを超えるにつれ、全体の微調整に並ぶ[25] |
| (IA)³ | 学習したベクトルで内部の活性を拡縮 | 少数ショットでは、PEFT が文脈内学習より、精度が高く計算費用が大幅に低いと報告。T-Few の手順を提案[26] |
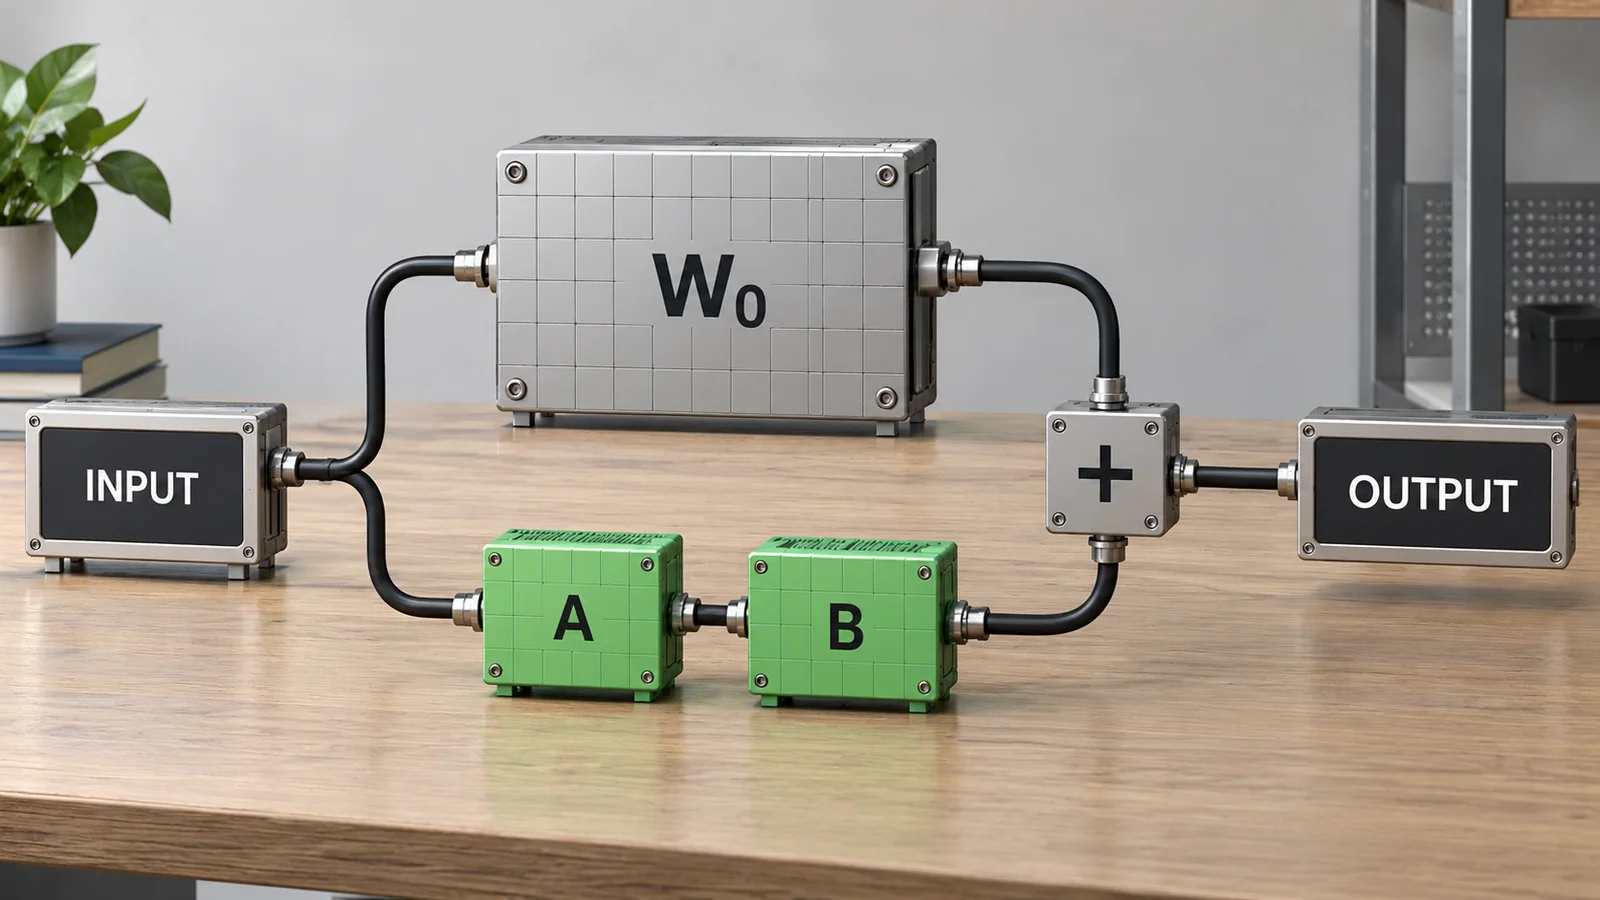
| LoRA(Hu ら、2021) | 凍結した重み W₀ に、低ランクの分解 B·A の更新を足す(図5) | GPT-3 175B の Adam による微調整と比べ、学習可能パラメータを約1万分の1、GPU メモリを約3分の1に。推論の遅延は増えない。GPT-3 では学習可能パラメータが元の0.01%まで小さくできる[27] |
| QLoRA(Dettmers ら、2023) | 4ビットに量子化した凍結モデルを通して勾配を流し、LoRA アダプタを学習 | 65B のモデルを、48 GB の GPU 1枚で微調整(通常の16ビットの微調整は780 GB超)。NF4、二重量子化(約0.37ビット/パラメータの節約)、ページ化オプティマイザ[28] |
| DoRA(Liu ら、2024) | 重みを大きさと方向に分解し、方向の更新に LoRA を使う | 著者らは、LLaMA などの下流課題で LoRA を一貫して上回ると報告[29] |
すべて事実(各原論文)。数値は、その論文のモデル・課題・設定での結果で、手法どうしの比較ではありません。
元のSVG模式図・数値・出典注記を見る
LoRA のパラメータ数の例(本稿の計算):1つの d × d の重み行列に、ランク r の更新を加えると、学習するのは 2·d·r 個です。d = 4,096、r = 16 なら 131,072 個で、元の 16,777,216 個の約0.78%です。Llama 3 8B の構成(32層、d = 4,096、KV の次元 1,024)で、注意の q・k・v・出力の4つの行列に r = 16 を付けると、アダプタは約1,363万個(8.03B の約0.17%)、FFN の3つの行列も含めると約4,194万個(約0.52%)です。
上の図の見積もりでは、8B の全パラメータの微調整は約128 GB、LoRA は約16.3 GB、QLoRA は約4.2 GB です(70B では、約1,129 GB、約142 GB、約36 GB)。ここでの全パラメータの16バイト/パラメータは、ZeRO の論文が、混合精度で Adam を使うときの計上として示した値です事実[参考資料31]。QLoRA の論文は、LLaMA 65B の通常の16ビットの微調整に780 GB超が必要と述べ、これは約12バイト/パラメータにあたります[参考資料28]。メモリの計上の仕方(何を含めるか)で値は変わるので、数字は桁の目安として読んでください(本記事による解説)。
LoRA は「学ぶ量が少ない」代わりに「忘れにくい」
Biderman らは、プログラミングと数学の2つの領域で、LoRA と全パラメータの微調整を比べました(指示の微調整 約10万件のプロンプトと回答、継続事前学習 約200億トークン)。標準の低ランク設定では、LoRA は全パラメータの微調整を大きく下回りましたが、対象領域の外の課題での、元のモデルの性能は、LoRA のほうがよく保たれました。LoRA は、重み減衰やドロップアウトなどの一般的な正則化よりも忘却を抑え、出力の多様性もよく保ちます。全パラメータの微調整が学ぶ摂動のランクは、典型的な LoRA の設定の10〜100倍とされ、それが差の一因かもしれない、と分析されています事実[参考資料30]。
社内の測定データや文献でモデルを調整する場合、LoRA や QLoRA で、GPU 1枚〜数枚で現実的になる範囲が広がります(上の見積もり)。ただし、知識を足す目的で、小さな LoRA を使うと、期待ほど学べない可能性があります(Biderman らの結果は、プログラミングと数学の領域でのもの。材料の領域で同じかは、本稿では確認していません)。逆に、出力の形式(報告書の書式、単位の表記)や、振る舞いを整える目的なら、少数の質の高い例で足りる、という見方もあります(LIMA の仮説[参考資料3])。どちらも、自分のタスクで確かめる必要があります(本記事による解説)。
また、この見積もりはメモリの下限の目安です。活性化、バッチの大きさ、系列の長さで必要量は増えます。モデルが大きくなるほど、HBM の容量と帯域が制約になることは、本シリーズ「HBM」編と「AIアクセラレータ」編で扱っています。
微調整のデータが少ないほど、評価用データとの重なり(データ漏れ)の影響は大きくなります。Tülu 3 は、開発用と未見の評価を分け、既存のオープンなデータセットから評価ベンチマークへの混入を除く作業を行っています[参考資料21]。素材データでは、同じ系統の試料や、同じ測定の繰り返しが、微調整と評価にまたがらないようにします(本シリーズ「機械学習とニューラルネットワークの基礎」編と同じ考え方)。
RLHF の質は、評価者(ラベラー)に依存します。InstructGPT では、ラベラーどうしの一致率が72.6〜77.3%でした[参考資料2]。専門性の高い領域(材料、化学、規格)では、評価者に専門知識があるか、評価の基準が書かれているかが、結果を左右すると考えられます(本記事による解説)。さらに、人の選好は、利用者の見解に合う回答や、説得力のある文章を好む傾向があり、おもねりを強めることがあります[参考資料12]。専門の領域では、丁寧で自信のある文章が、正しいとは限らないことを、評価の設計に入れる必要があります。
8. 安全の調整と、微調整後の安全性
事後学習には、安全のための調整も含まれます。Llama 3 の報告は、安全のための緩和策が事後学習の段階にも組み込まれている、と述べています事実[参考資料22]。
一方で、調整した後の微調整は、その安全性を変えることがあります。Qi らは、安全に調整された LLM を、少数の敵対的に設計した例で微調整すると、その安全性が損なわれうること(GPT-3.5 Turbo の防護を、10例・0.20ドル未満の微調整で破った例)、さらに、悪意がなくても、一般的な良性のデータで微調整するだけで、程度は小さいものの、安全性の調整が低下しうることを報告しています事実[参考資料32]。提供者の提供する微調整の機能や、公開された重みの微調整では、微調整のあとに、安全性を評価し直す必要があります(本記事による解説。具体的な攻撃の手順は書きません)。
NIST の生成AIプロファイルは、リスクの測定に、AI レッドチーミングや独立した外部評価のような、構造化された公開のフィードバックを含めること、敵対的なロールプレイ、レッドチーミングなどで、予期しない失敗モードを見つけること、微調整されたモデルを含む、モデルのライブラリ・ツール・API の方針を見直すことを、取りうる行動として挙げています事実[参考資料40]。
9. 限界と、確認できなかったこと/まとめ
(1) 手法の細部
損失の導出、ハイパーパラメータ、実装の細部は扱っていません。具体的な手法は、原論文で確認してください。
(2) 新しい手法
確認日(2026年10月15日)時点で、本稿が扱ったのは2025年までの主要な原論文と技術報告です。それ以降の新しい手法や、各社の最新の事後学習の中身は確認していません。商用モデルの事後学習の中身は、多くが公開されていません。
(3) 手法間の優劣
手法どうしの優劣は、判断していません。各論文の改善は、その論文の設定のものです。
(4) 材料分野での微調整の具体例
材料・化学分野の LLM を微調整した具体的な実践例とその評価は、本稿では確認していません。素材技術者の視点は、一般的な論文の結果からの読み取り(解説)です。
(5) 見積もりと規格
メモリの見積もりは概算で、活性化などを含みません。ISO/IEC 42001、23894、TS 12791、5259-3 の本文は有料のため確認していません。
- 事後学習は、SFT、選好の学習(RLHF・RLAIF・DPO など)、評価と安全の確認の組み合わせです。InstructGPT は3段階、Llama 3 は SFT・棄却サンプリング・DPO の6ラウンド事実
- 報酬は代理です。報酬モデルの最適化しすぎで本来の目的が悪化し、人の選好はおもねりを好みうる事実
- DPO は報酬モデルとサンプリングを省き、RLAIF は人のラベルを減らします。手法の優劣は設定しだいで、本稿は判断しません事実
- LoRA・QLoRA はメモリを大きく減らします。8B の目安で、全パラメータ約128 GB、LoRA 約16 GB、QLoRA 約4 GB。ただし LoRA は学ぶ量が少ない面もあります本稿の計算/事実
- 微調整のあとは、安全性と評価の再確認が要ります。良性のデータでの微調整でも安全性が下がりうる事実
10. 評価・標準の読み方
事後学習の評価は、指示への追従、会話の質(人または LLM の判定)、真実性、安全性、そして調整が副作用を生んでいないか(元の能力の維持、微調整後の安全性)に分かれます。LLM を判定者に使う評価には偏りがあり、第三者の順位表は、方法と日付を確認したうえで参考値として扱います。確認できた範囲を表にします(確認日 2026年10月15日)。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典・設定) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 指示への追従 | IFEval:25種類の「検証できる指示」(例:400語を超えて書く、特定の語を3回以上入れる)と約500のプロンプト[36]事実 | 確認できなかった | 検証可能な指示に限られ、回答の中身の質は測らない |
| 会話の質(自動評価) | MT-Bench(複数ターンの質問集)。強い LLM の判定者は人と80%超一致するが、位置・冗長さ・自己びいきの偏りがある[33]。AlpacaEval の長さ補正版(長い出力を好む偏りを回帰で補正)[34]。Arena-Hard-Auto(500のプロンプト。著者は人の選好の順位と98.6%の相関と報告)[35]事実 | 確認できなかった | 判定者の偏り、プロンプトの選び方、実施者で値が変わる。第三者の順位表は参考値 |
| 真実性 | TruthfulQA:38分野の817問。原論文では、最良のモデルの真実性は58%、人は94%。最大のモデルが概して最も真実性が低かった[37]事実 | 確認できなかった | 原論文の時点のモデルの結果。現在のモデルの値ではない |
| 安全性 | AILuminate v1.0:12の危険カテゴリ、5段階の評価(Poor〜Excellent)。限界(評価者の不確かさ、1ターンの評価)も報告[38]。MLCommons のページ(確認日の時点):安全性(英語・フランス語・中国語)、脱獄、約5.96万のテストプロンプト、109モデル[39]。微調整後の安全性の低下の報告[32]事実 | NIST AI 600-1(生成AIプロファイル、2024年7月):レッドチーミングや独立した外部評価などを取りうる行動として列挙[40]事実 | プロンプト集合への耐性の測定で、安全の保証ではない。微調整のあとは評価し直す |
| 選好データ・報酬モデルの頑健性 | 報酬の最適化しすぎ(Gao ら)[10]、おもねり(Sharma ら)[12]、RLHF の限界の整理(Casper ら)[11]事実 | ISO/IEC TS 12791:2024(分類・回帰の機械学習タスクでの望ましくないバイアスの扱い。ライフサイクル全体で使える緩和手法を記述。2024年10月)[43]事実 | TS 12791 の対象は分類・回帰の課題で、対話型 LLM の調整に直接当てはまるかは未確認 |
| 微調整手法の比較・汚染の除去 | LoRA と全パラメータの微調整の比較(Biderman ら)[30]。開発用と未見の評価の分離、ベンチマークへの混入の除去(Tülu 3)[21]事実 | ISO/IEC 5259-3:2024(データ品質マネジメントの要求事項と指針)[44]事実 | 本文は未確認で、要求事項は書いていない |
| 運用・リスク管理 | — | ISO/IEC 42001:2023(AI のマネジメントシステム)[41]、ISO/IEC 23894:2023(AI のリスク管理の指針)[42]事実 | 多くは任意の採用。本文は未確認で、要求事項は書いていない |
表の整理は本稿の計算(整理)。ISO/IEC の番号・題名・発行年月は ISO の公式ページ、NIST は NIST の文書、AILuminate は MLCommons の論文とページで確認(確認日 2026年10月15日)。規格の本文は有料のため、題名・適用範囲の記載にとどめています。
読み方の注意(素材技術者向け)
- ベンチマーク値は、設定と実施主体で変わります:LLM を判定者にする評価は、判定者の偏り(位置・冗長さ・自己びいき)と、出力の長さに影響されます。長さの補正版や、新しく作った問題での測り直しを確認してください。開発元の技術報告の数字は、その開発元の選んだ設定の結果です
- 飽和と汚染:公開ベンチマークは学習データに混入しうるため、新しい問題や、自分のタスクでの評価を併用します[参考資料21・33]
- 標準・指針は、多くが任意です:NIST の生成AIプロファイルは自主的な利用を前提にしています[参考資料40]。ISO/IEC の規格は、法令や契約で引用されて初めて拘束力を持つのが一般的です(本記事による解説)。「規格に準拠」の表現は、どの規格のどの要求事項かを確認してください
- 宣言値と実測値は別です:報告された改善は、その論文の設定のものです。自分のデータと自分の評価で測り直す価値があります
11. 用語集
- 事後学習(post-training)
- 事前学習のあとの追加の学習全般。SFT、選好の学習など。
- SFT
- 教師あり微調整。指示と回答の組で、回答側のトークンの損失を最小にする。
- 指示チューニング
- 多様な課題を指示の形で書き直したデータで微調整し、未見の課題への対応を上げる方法。
- RLHF
- 人間のフィードバックによる強化学習。報酬モデルの学習と、方策の強化学習からなる。
- 報酬モデル
- 人の選好を予測するモデル。回答にスカラーの点数を付ける。
- PPO
- 近接方策最適化。強化学習の代表的な方法。
- KL 罰則
- 方策が初期のモデルから離れすぎないように、報酬から引く項。
- RLAIF
- AI のフィードバックによる強化学習。選好のラベルを LLM に付けさせる。
- Constitutional AI
- 規則・原則の一覧だけを人の関与として、自己批評と AI の選好で無害性を学ぶ方法。
- DPO
- 直接選好最適化。報酬モデルとサンプリングなしに、分類の損失で選好を学ぶ。
- GRPO/RLVR
- 価値モデルを使わない PPO の変種/検証できる報酬による強化学習。
- 棄却サンプリング
- 複数の回答を生成し、報酬モデルなどで良いものだけを学習データに戻す方法。
- PEFT
- パラメータ効率のよい微調整。少数のパラメータだけを学習する。
- LoRA/QLoRA
- 凍結した重みに低ランクの更新を足す方法/基礎を4ビットに量子化して LoRA を学習する方法。
- おもねり(sycophancy)
- 利用者の見解に合わせ、正しさより同意を優先する振る舞い。
- LLM-as-a-judge
- LLM を評価者にする方法。位置・冗長さ・自己びいきの偏りがある。
- レッドチーミング
- 敵対的な視点でシステムの失敗や弱点を探す評価。
12. 参考資料(一次情報)
- Wei J. ほか "Finetuned Language Models Are Zero-Shot Learners", arXiv:2109.01652 — arxiv.org/abs/2109.01652
- Ouyang L. ほか "Training language models to follow instructions with human feedback", arXiv:2203.02155 — arxiv.org/abs/2203.02155
- Zhou C. ほか "LIMA: Less Is More for Alignment", arXiv:2305.11206 — arxiv.org/abs/2305.11206
- Wang Y. ほか "Self-Instruct: Aligning Language Models with Self-Generated Instructions", arXiv:2212.10560 — arxiv.org/abs/2212.10560
- Christiano P. ほか "Deep reinforcement learning from human preferences", arXiv:1706.03741 — arxiv.org/abs/1706.03741
- Ziegler D. M. ほか "Fine-Tuning Language Models from Human Preferences", arXiv:1909.08593 — arxiv.org/abs/1909.08593
- Stiennon N. ほか "Learning to summarize from human feedback", arXiv:2009.01325 — arxiv.org/abs/2009.01325
- Schulman J. ほか "Proximal Policy Optimization Algorithms", arXiv:1707.06347 — arxiv.org/abs/1707.06347
- Bai Y. ほか(Anthropic) "Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback", arXiv:2204.05862 — arxiv.org/abs/2204.05862
- Gao L., Schulman J., Hilton J. "Scaling Laws for Reward Model Overoptimization", arXiv:2210.10760 — arxiv.org/abs/2210.10760
- Casper S. ほか "Open Problems and Fundamental Limitations of Reinforcement Learning from Human Feedback", arXiv:2307.15217 — arxiv.org/abs/2307.15217
- Sharma M. ほか "Towards Understanding Sycophancy in Language Models", arXiv:2310.13548 — arxiv.org/abs/2310.13548
- Bai Y. ほか(Anthropic) "Constitutional AI: Harmlessness from AI Feedback", arXiv:2212.08073 — arxiv.org/abs/2212.08073
- Lee H. ほか "RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback", arXiv:2309.00267(ICML 2024) — arxiv.org/abs/2309.00267
- Rafailov R. ほか "Direct Preference Optimization: Your Language Model is Secretly a Reward Model", arXiv:2305.18290 — arxiv.org/abs/2305.18290
- Azar M. G. ほか "A General Theoretical Paradigm to Understand Learning from Human Preferences", arXiv:2310.12036 — arxiv.org/abs/2310.12036
- Ethayarajh K. ほか "KTO: Model Alignment as Prospect Theoretic Optimization", arXiv:2402.01306 — arxiv.org/abs/2402.01306
- Hong J. ほか "ORPO: Monolithic Preference Optimization without Reference Model", arXiv:2403.07691 — arxiv.org/abs/2403.07691
- Meng Y. ほか "SimPO: Simple Preference Optimization with a Reference-Free Reward", arXiv:2405.14734 — arxiv.org/abs/2405.14734
- Shao Z. ほか "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models", arXiv:2402.03300 — arxiv.org/abs/2402.03300
- Lambert N. ほか(Allen Institute for AI ら) "Tulu 3: Pushing Frontiers in Open Language Model Post-Training", arXiv:2411.15124 — arxiv.org/abs/2411.15124
- Grattafiori A. ほか(Llama Team, Meta) "The Llama 3 Herd of Models", arXiv:2407.21783 — arxiv.org/abs/2407.21783
- Houlsby N. ほか "Parameter-Efficient Transfer Learning for NLP", arXiv:1902.00751 — arxiv.org/abs/1902.00751
- Li X. L., Liang P. "Prefix-Tuning: Optimizing Continuous Prompts for Generation", arXiv:2101.00190 — arxiv.org/abs/2101.00190
- Lester B., Al-Rfou R., Constant N. "The Power of Scale for Parameter-Efficient Prompt Tuning", arXiv:2104.08691 — arxiv.org/abs/2104.08691
- Liu H. ほか "Few-Shot Parameter-Efficient Fine-Tuning is Better and Cheaper than In-Context Learning", arXiv:2205.05638 — arxiv.org/abs/2205.05638
- Hu E. J. ほか "LoRA: Low-Rank Adaptation of Large Language Models", arXiv:2106.09685 — arxiv.org/abs/2106.09685
- Dettmers T. ほか "QLoRA: Efficient Finetuning of Quantized LLMs", arXiv:2305.14314 — arxiv.org/abs/2305.14314
- Liu S.-Y. ほか "DoRA: Weight-Decomposed Low-Rank Adaptation", arXiv:2402.09353 — arxiv.org/abs/2402.09353
- Biderman D. ほか "LoRA Learns Less and Forgets Less", arXiv:2405.09673 — arxiv.org/abs/2405.09673
- Rajbhandari S. ほか "ZeRO: Memory Optimizations Toward Training Trillion Parameter Models", arXiv:1910.02054 — arxiv.org/abs/1910.02054
- Qi X. ほか "Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!", arXiv:2310.03693 — arxiv.org/abs/2310.03693
- Zheng L. ほか "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena", arXiv:2306.05685 — arxiv.org/abs/2306.05685
- Dubois Y. ほか "Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators", arXiv:2404.04475 — arxiv.org/abs/2404.04475
- Li T. ほか "From Crowdsourced Data to High-Quality Benchmarks: Arena-Hard and BenchBuilder Pipeline", arXiv:2406.11939 — arxiv.org/abs/2406.11939
- Zhou J. ほか "Instruction-Following Evaluation for Large Language Models", arXiv:2311.07911 — arxiv.org/abs/2311.07911
- Lin S., Hilton J., Evans O. "TruthfulQA: Measuring How Models Mimic Human Falsehoods", arXiv:2109.07958 — arxiv.org/abs/2109.07958
- Ghosh S. ほか(MLCommons) "AILuminate: Introducing v1.0 of the AI Risk and Reliability Benchmark from MLCommons", arXiv:2503.05731 — arxiv.org/abs/2503.05731
- MLCommons "AILuminate"(ベンチマークの概要。確認日のページ) — mlcommons.org/ailuminate/
- NIST "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1, 2024年7月, DOI 10.6028/NIST.AI.600-1 — doi.org/10.6028/NIST.AI.600-1
- ISO/IEC "ISO/IEC 42001:2023 AI management systems"(ISO のページ) — iso.org/standard/81230.html
- ISO/IEC "ISO/IEC 23894:2023 AI — Guidance on risk management"(ISO のページ) — iso.org/standard/77304.html
- ISO/IEC "ISO/IEC TS 12791:2024 Information technology — Artificial intelligence — Treatment of unwanted bias in classification and regression machine learning tasks"(ISO のページ) — iso.org/standard/84110.html
- ISO/IEC "ISO/IEC 5259-3:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 3: Data quality management requirements and guidelines"(ISO のページ) — iso.org/standard/81092.html
- DeepSeek-AI "DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning", arXiv:2501.12948(Nature 645, 633–638 (2025)) — arxiv.org/abs/2501.12948
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 指示を自然言語のひな型で書いた60超の NLP データセットでの137Bモデルの微調整が、未見の課題のゼロショット性能を上げ、25データセット中20でゼロショットの175B GPT-3 を上回ったこと | Wei ら 出典1 https://arxiv.org/abs/2109.01652 | 事実 |
| InstructGPT:3段階(SFT、報酬モデル、PPO)、データ量(約1.3万・3.3万・3.1万プロンプト)、6B の報酬モデル、K = 4〜9、報酬モデルの損失 −log σ(r勝 − r負)、KL 罰則、PPO-ptx、1.3B の出力が175B GPT-3 より好まれたこと、有害な出力の約25%減、アラインメント税、ラベラーの一致率(72.6±1.5%、77.3±1.3%) | Ouyang ら(2022) 出典2 https://arxiv.org/abs/2203.02155 | 事実 |
| LIMA:65B を1,000件で微調整、アラインメントは形式やスタイルを学ぶ単純な過程かもしれないという仮説。Self-Instruct:GPT-3 で絶対値33%の改善 | Zhou ら、Wang ら 出典3 https://arxiv.org/abs/2305.11206 出典4 https://arxiv.org/abs/2212.10560 | 事実 |
| 人の比較からの強化学習(行動の1%未満へのフィードバック)。言語モデルへの適用(肯定的な感情・物理的な描写の続き、要約)。要約での人の比較・報酬モデル・強化学習が参照要約と大きな教師ありモデルを上回ったこと | Christiano ら、Ziegler ら、Stiennon ら 出典5 https://arxiv.org/abs/1706.03741 出典6 https://arxiv.org/abs/1909.08593 出典7 https://arxiv.org/abs/2009.01325 | 事実 |
| PPO の提案 | Schulman ら 出典8 https://arxiv.org/abs/1707.06347 | 事実 |
| RL の報酬と方策・初期モデル間の KL の平方根がほぼ線形の関係にあること | Anthropic(Bai ら) 出典9 https://arxiv.org/abs/2204.05862 | 事実 |
| 固定の gold 報酬モデルを人の代わりにした合成の設定で、代理の報酬モデルの最適化しすぎが gold の得点を悪化させること(強化学習と best-of-n) | Gao ら 出典10 https://arxiv.org/abs/2210.10760 | 事実 |
| RLHF の未解決の問題と根本的な限界の整理。5つの AI アシスタントのおもねり、選好データがおもねりを好む傾向 | Casper ら、Sharma ら 出典11 https://arxiv.org/abs/2307.15217 出典12 https://arxiv.org/abs/2310.13548 | 事実 |
| Constitutional AI(規則・原則の一覧だけを人の関与とし、自己批評・修正と AI の選好から選好モデルを学習)。RLAIF が RLHF と同等、d-RLAIF | Bai ら、Lee ら 出典13 https://arxiv.org/abs/2212.08073 出典14 https://arxiv.org/abs/2309.00267 | 事実 |
| DPO:閉じた形の最適方策、分類の損失、微調整中のサンプリング不要、報告された比較。RLHF の目的(報酬 − β KL、参照は初期の SFT モデル) | Rafailov ら 出典15 https://arxiv.org/abs/2305.18290 | 事実 |
| IPO(ΨPO)、KTO(2値の信号、人間を意識した損失、普遍的に優れる損失はない)、ORPO(参照モデル不要、単一の段階)、SimPO(平均対数確率の暗黙の報酬、参照モデル不要、目標マージン)、GRPO(critic 不要、グループの得点でベースライン) | 各原論文 出典16 https://arxiv.org/abs/2310.12036 出典17 https://arxiv.org/abs/2402.01306 出典18 https://arxiv.org/abs/2403.07691 出典19 https://arxiv.org/abs/2405.14734 出典20 https://arxiv.org/abs/2402.03300 | 事実 |
| Tülu 3:SFT・DPO・RLVR、完全公開、開発用と未見の評価、デコンタミネーション、確実な改善にならなかった方法の報告 | Lambert ら 出典21 https://arxiv.org/abs/2411.15124 | 事実 |
| Llama 3:SFT(プロンプトの損失をマスク)、棄却サンプリング、DPO、6ラウンド、PPO も試したが DPO が計算量が少なく IFEval などで性能が良かったこと、β = 0.1、書式トークンのマスク、NLL 項の係数0.2、事後学習に安全の緩和策を組み込んだこと | Llama Team(2024) 出典22 https://arxiv.org/abs/2407.21783 | 事実 |
| アダプタ(GLUE で0.4%以内、3.6%のパラメータ)、プレフィックス(0.1%)、プロンプト・チューニング(規模で全体の微調整に並ぶ)、(IA)³(PEFT が文脈内学習より精度が高く安価) | Houlsby ら、Li と Liang、Lester ら、Liu ら 出典23 https://arxiv.org/abs/1902.00751 出典24 https://arxiv.org/abs/2101.00190 出典25 https://arxiv.org/abs/2104.08691 出典26 https://arxiv.org/abs/2205.05638 | 事実 |
| LoRA(学習パラメータ約1万分の1、GPU メモリ約3分の1、推論遅延なし、B = 0 と A のランダム初期化、W₀ + BA)。QLoRA(65B を48 GB で、通常は780 GB超、NF4・二重量子化0.37ビット・ページ化オプティマイザ)。DoRA | Hu ら、Dettmers ら、Liu ら 出典27 https://arxiv.org/abs/2106.09685 出典28 https://arxiv.org/abs/2305.14314 出典29 https://arxiv.org/abs/2402.09353 | 事実 |
| LoRA が標準の低ランク設定で全パラメータの微調整を大きく下回ること、領域外の性能をよく保つこと、忘却と多様性、全パラメータの微調整の摂動のランクが10〜100倍 | Biderman ら 出典30 https://arxiv.org/abs/2405.09673 | 事実 |
| 混合精度 Adam で2Ψ + 2Ψ + KΨ(K = 12)= 16Ψ バイト | ZeRO 論文 出典31 https://arxiv.org/abs/1910.02054 | 事実 |
| 微調整による安全性の低下(少数の敵対的な例、10例・0.20ドル未満で GPT-3.5 Turbo の防護を破った例、良性のデータでも程度は小さいが低下) | Qi ら 出典32 https://arxiv.org/abs/2310.03693 | 事実 |
| LLM の判定者の偏り(位置・冗長さ・自己びいき)、人と80%超の一致、MT-Bench。AlpacaEval の長さ補正。Arena-Hard-Auto(500プロンプト、98.6%の相関) | Zheng ら、Dubois ら、Li ら 出典33 https://arxiv.org/abs/2306.05685 出典34 https://arxiv.org/abs/2404.04475 出典35 https://arxiv.org/abs/2406.11939 | 事実 |
| IFEval(25種類の検証可能な指示、約500プロンプト)。TruthfulQA(817問・38分野、最良58%・人94%、最大のモデルが概して最も低い) | Zhou ら、Lin ら 出典36 https://arxiv.org/abs/2311.07911 出典37 https://arxiv.org/abs/2109.07958 | 事実 |
| AILuminate v1.0(12の危険カテゴリ、5段階評価、限界)。MLCommons のページ(確認日:安全性の英語・フランス語・中国語、脱獄、59,624のテストプロンプト、109モデル) | MLCommons 出典38 https://arxiv.org/abs/2503.05731 出典39 https://mlcommons.org/ailuminate/ | 事実 |
| NIST AI 600-1:AI レッドチーミングや独立した外部評価、敵対的なロールプレイ・レッドチーミング、微調整されたモデルを含む方針の見直し、を取りうる行動として列挙。自主的な利用 | NIST AI 600-1 の本文 出典40 https://doi.org/10.6028/NIST.AI.600-1 | 事実 |
| ISO/IEC 42001:2023、23894:2023、TS 12791:2024(2024年10月)、5259-3:2024 の番号・題名・発行年月 | ISO のページ 出典41 https://www.iso.org/standard/81230.html 出典42 https://www.iso.org/standard/77304.html 出典43 https://www.iso.org/standard/84110.html 出典44 https://www.iso.org/standard/81092.html | 事実 |
| 人の例を使わず純粋な強化学習で推論能力を引き出せるという DeepSeek-R1 の報告 | DeepSeek-AI 出典45 https://arxiv.org/abs/2501.12948 | 事実 |
| LoRA のパラメータ数(d = 4,096・r = 16で131,072個、0.78%。Llama 3 8B で約1,363万個〔0.17%〕、FFN 込みで約4,194万個〔0.52%〕)、メモリの見積もり(8B:約128 GB・16.3 GB・4.2 GB、70B:約1,129 GB・142 GB・36 GB)、QLoRA 論文の780 GB超との差(約12バイト/パラメータ) | 本稿の計算(Llama 3 の公表構成と ZeRO の16バイト/パラメータに基づく概算。活性化・バッチ・量子化の定数は含まない)。実測ではない | 本稿の計算 |
| 2026年の新しい手法・各社の最新の事後学習の中身、手法間の優劣、材料分野の LLM の微調整の具体例、ISO/IEC 規格の本文、TS 12791 の対話型 LLM への適用の有無 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「SFT は能力を使いやすい形に整える役割が大きい」「小さな LoRA で知識を足すと期待ほど学べない可能性」「AI の評価者の偏りは学習したモデルに持ち込まれうる」「人の評価の質は評価者に依存する」という読み取りと、素材・研究への含意 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2〜図6が実データの観察ではなく説明のための作図であること。図1と図7がAI生成イメージの枠であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(arXiv の原論文、各開発元の技術報告、MLCommons・ISO・NIST の公式ページ)に限定しています。ISO/IEC 規格の本文は有料のため確認できていません。 各手法の「性能が良い」という記述は、その論文の設定での結果で、手法間の優劣は判断していません。安全・有害性に関する内容は評価と対策の考え方にとどめ、悪用の手順は書いていません。 2026年の新しい手法、各社の最新の事後学習の中身、材料分野の LLM の微調整の具体例、ISO/IEC 規格の本文については、確認できなかったため記載していません。 図は説明用の概念図または本稿の計算を含む作図で、図1と図7はAI生成イメージの枠(画像は未設置)です。いずれも実在の装置・実測を示すものではありません。