TECHNOLOGY EXPLAINER
モデルの効率化
― 混合専門家・蒸留・量子化・剪定・小型モデルで、何が縮み、何を払うのか
大規模言語モデルは、パラメータ数が増えるほどメモリと計算が増えます。これを抑える主な手段が、混合専門家(MoE)、知識蒸留、量子化(INT8・FP8・FP4)、剪定、小型モデルです。ただし、それぞれが縮めるものは違い、たとえば MoE が減らすのは1トークンあたりの計算と読み出しで、メモリに載せる量(総パラメータ)は減りません。 この記事は、各手段の仕組みと、公式資料・原論文で確認できた数値、メモリと速度の試算(本稿の計算)、オープンウェイトモデルの仕様とライセンス条件を、精度・速度・メモリのトレードオフを条件つきで整理します。
- 効率化の地図(3行でつかむ)
- 混合専門家(MoE)― 総パラメータと活性パラメータ
- 知識蒸留 ― 大きなモデルの知識を小さなモデルへ
- 量子化 ― INT8・FP8・FP4 と、ブロック共有スケール
- 剪定(プルーニング)
- 小型モデルと、オープンウェイトモデルの仕様
- メモリ・速度・精度のトレードオフ(本稿の計算)
- ライセンス条件の読み方
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=制定途中・改訂中・提案段階であり、確定していない事項
このほか、仕組みの読み取りは「解説」として区別しています。推測は太字で示します。
精度・速度・メモリの数値は、特定のモデル・版、量子化の方式、バッチサイズ、入出力長、ハードウェア、ソフトウェアの条件での値です。条件の違う数値を並べて、手法やモデルの優劣をつけることはしません。パラメータ数・文脈長・ライセンスは公式資料の記載(確認日 2026年10月15日)で、変更されうるため、利用前に必ず最新の公式ページとライセンス全文を確認してください。ライセンスの説明は一般的な情報で、法的助言ではありません。
1. 効率化の地図(3行でつかむ)
- 手段ごとに、縮めるものが違う:MoE は1トークンあたりの計算と重みの読み出し、量子化は1パラメータあたりのバイト数、蒸留と剪定は(学習し直して)モデルの大きさそのもの、を縮めます(本記事による整理)。
- MoE は「全体を載せ、一部だけ使う」:gpt-oss-120b は総パラメータ116.83B のうち、1トークンあたり5.13B が活性です。重みの大半(MoE の部分、90%超)を MXFP4(4.25ビット/パラメータ)にすることで、80GB の GPU 1枚に収まる、と公式資料は述べています事実[参考資料9・10]。
- 精度の代償は条件つき:Llama-3.1 の全サイズで50万回超の評価をした研究は、FP8 は実質的に劣化なし、よく調整した INT8 は1〜3%の劣化、4ビットの重みのみの量子化も8ビットに匹敵しうると報告しています事実[参考資料21]。ただしこれは一つのモデル系列と評価設定での結果です。
「どのパラメータ数か」「どの精度の形式か」「どの条件で測った速度か」を書かない効率化の数字は、比べられません。 MoE の「120B」は総パラメータ(メモリに載せる量)で、速度に効くのは活性パラメータです。量子化後のメモリは、重みだけでなく、KV キャッシュと活性化(本シリーズ『検索拡張生成とコンテキストウィンドウ』編)を別に見積もる必要があります。
2. 混合専門家(MoE)― 総パラメータと活性パラメータ
(1) 仕組み
Transformer の各層の前向きネットワーク(FFN)を、複数の「専門家」に分け、ルーター(ゲート)がトークンごとに使う専門家を少数選ぶ方式が MoE です。Shazeer らは、条件つき計算(入力ごとにネットワークの一部だけを動かす)を実用化し、計算効率をほとんど落とさずにモデル容量を1000倍超に増やせることを示し、最大1,370億(137 billion)パラメータの MoE を、積み重ねた LSTM の層の間に適用した例を報告しています事実[参考資料1]。Mixtral 8x7B は、各層に8個の FFN(専門家)を持ち、トークンごとに2個を選ぶ設計で、各トークンは47B のパラメータにアクセスできるが、推論で使う活性は13B だと述べています[参考資料2]。
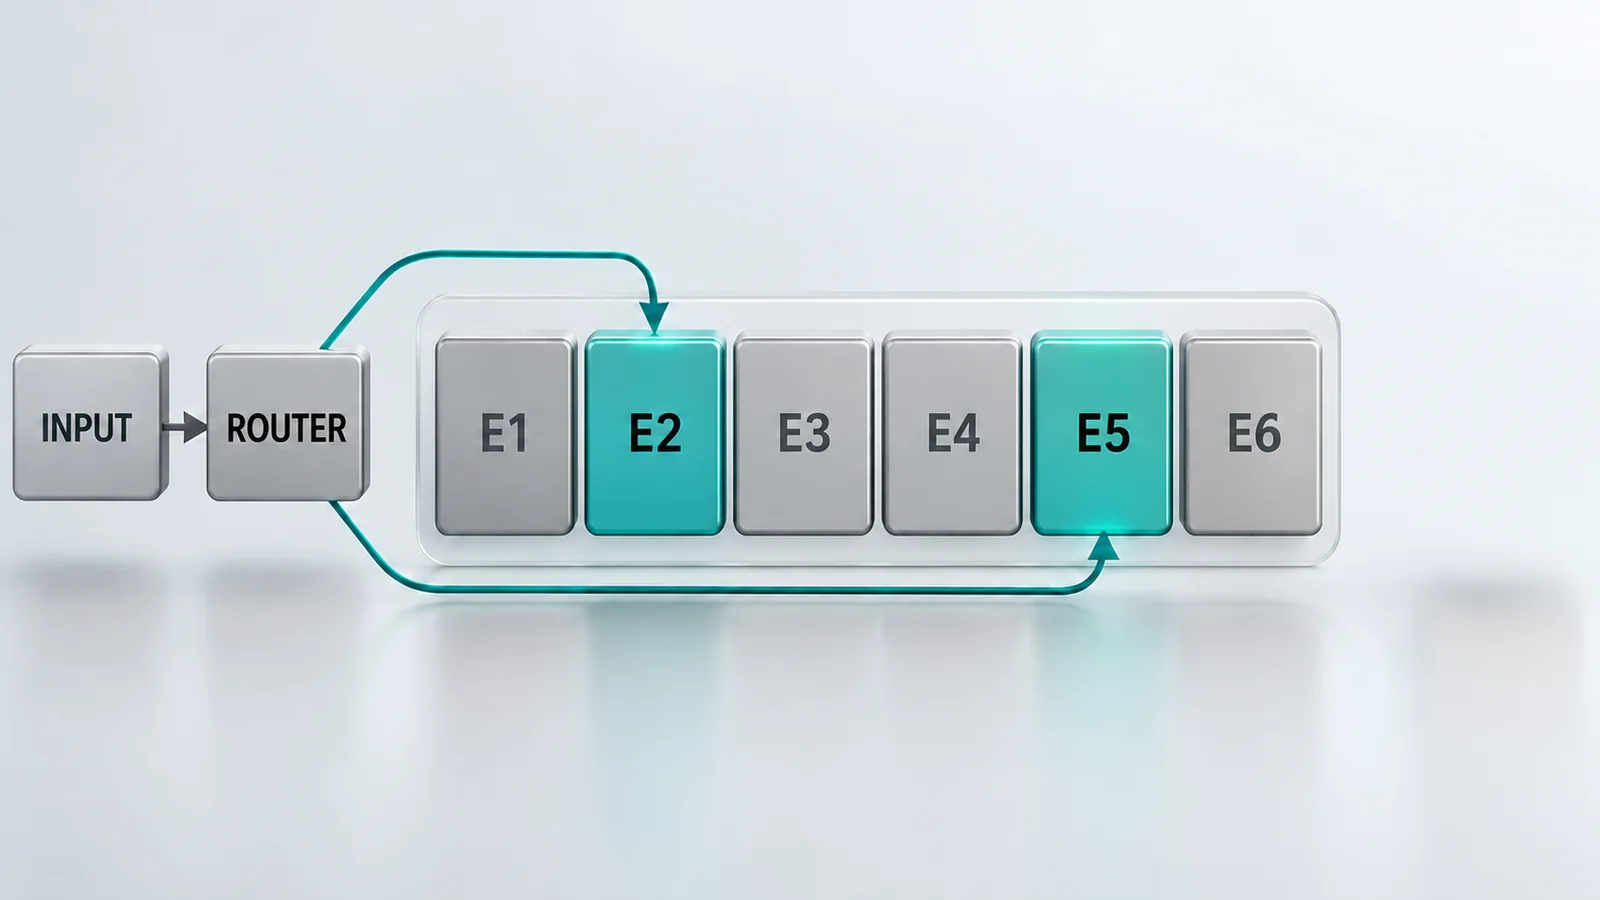
元のSVG模式図・数値・出典注記を見る
(2) 主なモデルの総パラメータと活性パラメータ
公式資料で確認できた値を図3にまとめました。同じ「活性」でも数え方(埋め込み、共有する専門家、出力側の行列を含むか)は提供元で異なります。たとえば gpt-oss のモデルカードは、出力側(unembedding)は活性に数え、入力側の埋め込みは数えない、と注記しています[参考資料9]。Gemma 4 の「E2B」「E4B」の「E」は effective(有効)パラメータで、各層に小さな埋め込み(Per-Layer Embeddings)を持たせ、大きな埋め込み表は参照だけに使うため、有効パラメータ数が総数よりずっと小さい、と説明されています[参考資料14]事実。
| モデル(出典) | 総/活性パラメータ | 専門家の構成 | 文脈長(公式資料の記載) |
|---|---|---|---|
| Mixtral 8x7B(論文)[2] | 約47B/約13B | 各層8専門家、2つを選択 | 学習時の文脈サイズ32k |
| DeepSeek-V3(技術報告・モデルカード)[3・4] | 671B/37B(HF 上の合計は685B=本体671B+MTP 14B) | DeepSeekMoE、MLA を併用。config の n_routed_experts は256 | 128K |
| Qwen3-235B-A22B(モデルカード)[7] | 235B/22B | 128専門家のうち8つを活性。94層、GQA(Q 64・KV 4) | 標準32,768、YaRN で131,072 |
| Qwen3-30B-A3B(モデルカード)[8] | 30.5B/3.3B | 128専門家のうち8つ。48層 | 標準32,768、YaRN で131,072 |
| gpt-oss-120b/20b(モデルカード)[9] | 116.83B/5.13B、20.91B/3.61B | 128専門家(20b は32)、上位4つを選択。MoE 部分が総パラメータの90%超 | 131,072(全体注意の層を YaRN で拡張) |
| Gemma 4 26B A4B(モデルカード)[14] | 25.2B/3.8B | 128専門家のうち8つ+共有1つ。30層。窓1024の局所注意と全体注意を交互に使う | 256K |
すべて事実(各論文・公式モデルカード・config.json、確認日 2026年10月15日)。「活性」の数え方は提供元で異なります。
(3) メモリと速度への効き方
MoE の利点は、1トークンあたりの計算と重みの読み出しが活性パラメータ分で済むことです。DeepSeek-V3 の技術報告は、MLA と DeepSeekMoE を採用して、効率的な推論と費用効率のよい学習を狙い、14.8兆トークンの事前学習に278.8万 H800 GPU 時間を要した、と述べています[参考資料3]。Qwen3 の技術報告は、Qwen3 の MoE のベースモデルが、活性パラメータが Qwen2.5 の密結合モデルの1/10でも同程度の性能を達成でき、推論と学習の費用で大きな利点がある、と述べています[参考資料6]事実(開発元の評価)。 一方で、メモリに載せる量は総パラメータで決まります。全専門家の重みを GPU のメモリ(または複数 GPU)に置く必要があり、gpt-oss-120b が単一の80GB GPU に収まるのは、MoE 部分を MXFP4 にしたためです[参考資料9]。また、バッチを大きくすると、トークンごとに別々の専門家が選ばれ、1ステップで読む専門家の数が増えるため、バッチ1の速度の見積りほど、MoE の利点は大きく出ません(本記事による解説。数値は第7章の試算を参照)。
材料の分野で言えば、MoE は材料倉庫に全部の試薬を置いておき、1回の実験では数種類だけを使うようなものです(本記事による喩え)。倉庫(メモリ)の広さは全試薬の量で決まり、1回の実験の手間(計算と読み出し)は使う試薬の量で決まります。AI を自社で動かす計画では、メモリ(総パラメータ)と速度(活性パラメータ)を別々に見積もることが、機器の選定の出発点です。HBM などの高帯域メモリが容量と帯域の制約を決める点は、本シリーズ『HBM』『推論の最適化とサービング』編で扱います。
3. 知識蒸留 ― 大きなモデルの知識を小さなモデルへ
(1) 原理と古典的な例
Hinton らの蒸留は、大きなモデルやモデルの集団(アンサンブル)の知識を、デプロイしやすい1つの小さなモデルに圧縮する方法を発展させたものです[参考資料11]。DistilBERT は、事前学習の段階で蒸留を使い、BERT のサイズを40%小さく、速度を60%速くしつつ、言語理解能力の97%を保てた、と報告しています事実[参考資料12]。
(2) 最近のモデルでの使われ方
- Gemma 2:2Bと9Bのモデルを、次トークン予測ではなく知識蒸留で学習した、と述べています[参考資料13]。
- Qwen3:大きなモデルから軽量モデルへの「strong-to-weak 蒸留」を使い、Qwen3-8B での比較では、オンポリシー蒸留が強化学習より大幅に良い性能を、約1/10の GPU 時間で達成した、と報告しています(開発元の実験)[参考資料6]。
- 枝刈りと蒸留の併用(Minitron):既存の15Bモデルを剪定して再学習(蒸留)し、8Bと4Bを得ると、ゼロから学習するのに比べて必要なトークンが最大40分の1になり、モデルファミリー全体の学習費用が1.8倍節約できた、と報告しています[参考資料28]。
(3) 注意:蒸留のライセンス上の扱い
蒸留では、教師モデルの出力を使って別のモデルを作るため、教師側のライセンスや利用規約が、生成物(学生モデル)に及ぶことがあります。たとえば、DeepSeek-V3 のモデルライセンスは、「モデルの派生物」に、モデルの重み・パラメータ・活性化・出力のパターンの移転によって作られた別のモデルを含めると定義し、派生物にも元と同じ使用制限(Attachment A)を含めることを求めています[参考資料36]。Llama 3.1 のライセンスは、Llama の資料や出力を使って AI モデルを作成・学習・微調整・改善して配布する場合、そのモデル名の先頭に「Llama」を含めることを求めています[参考資料33]。Gemma Terms of Use(Gemma 4 より前)は、Outputs は Model Derivatives ではない、と定めています[参考資料34]事実。同じ「蒸留」でも、どの教師を使うかで、成果物に課される条件が違います。商用のサービスの出力を教師に使う場合は、そのサービスの利用規約も確認が必要です(本稿では個別の規約は扱いません)。
4. 量子化 ― INT8・FP8・FP4 と、ブロック共有スケール
(1) 何を量子化するか
量子化は、数値を少ないビット数で表して、メモリと計算を減らす方法です。対象は、重み(W)、活性化(A、層の間を流れる値)、KV キャッシュの三つに分けられます。「W8A8」は重みと活性化の両方を8ビット、「W4A16」は重みを4ビット・活性化を16ビットにする、という表記です。Kurtic らの研究は、この表記で FP8(W8A8-FP)、INT8(W8A8-INT)、INT4 の重みのみ(W4A16-INT)を比べています事実[参考資料21]。
(2) 数値形式:ビット配置
浮動小数点は、符号・指数部・仮数部からなります。FP8 の論文は、E4M3(指数4ビット・仮数3ビット)と E5M2(指数5ビット・仮数2ビット)の2つの符号化を提案し、E5M2 は特殊値の表現で IEEE 754 の慣習に従う一方、E4M3 は無限大を表さず、NaN の仮数のパターンを1つだけにして、ダイナミックレンジを広げた、と説明しています[参考資料15]。Microscaling(MX)形式は、ブロックごとに1つの共有スケールと、狭いビット幅の要素(FP8・FP6・FP4・INT8)を組み合わせるもので、論文の表では、MXFP4 はブロックサイズ32、スケールは8ビットの E8M0、要素は4ビットの FP4(E2M1)です[参考資料16]。したがって、MXFP4 は 4+8/32=4.25ビット/要素で、gpt-oss のモデルカードが述べる「MoE の重みを4.25ビット/パラメータに量子化」と一致します[参考資料9]事実。
(3) 量子化の手法
- LLM.int8():外れ値の特徴次元だけを16ビットで計算し、99.9% 超の値を8ビットで掛け算することで、推論のメモリを半分にしつつ、175B パラメータのモデルでも性能の低下がなかったと報告しています[参考資料17]。
- GPTQ:近似的な2次情報を使う一括(one-shot)の重み量子化で、175B のモデルを約4 GPU 時間で、重みあたり3〜4ビットに、精度劣化をほとんど出さずに量子化できる、と報告しています[参考資料18]。
- AWQ:すべての重みが同じ重要さではなく、重要な1% の重みを守るだけで量子化誤差を大きく減らせるとし、重要な重みは重みではなく活性化の分布から見つける、としています[参考資料19]。
- SmoothQuant:活性化の外れ値を重みに移して、W8A8(重み・活性化とも8ビット)の量子化を可能にし、最大1.56倍の高速化と2倍のメモリ削減を、精度の低下を無視できる程度で達成したと報告しています[参考資料20]。
- 学習の段階から低精度:DeepSeek-V3 は FP8 の混合精度学習を、超大規模モデルで初めて検証したとし、FP8 の重みだけを配布しています[参考資料4]。gpt-oss は MoE の重みを MXFP4 で後学習しました[参考資料9]。NVIDIA の論文は、NVFP4 形式で120億パラメータのモデルを10兆トークンで学習する手法を示しています(著者らの報告)[参考資料23]事実。
(4) 精度の代償:一次情報で確認できたこと
Kurtic らは、Llama-3.1 の全サイズを対象に、学術ベンチマークと実世界のタスクで、FP8・INT8・INT4 の量子化を50万回超の評価で比べました。結果は、(1) FP8(W8A8-FP)はすべての規模で実質的に劣化がない、(2) よく調整した INT8(W8A8-INT)は精度の劣化が1〜3%と低い、(3) 4ビットの重みのみ(W4A16-INT)は予想以上に競争力があり、8ビットに匹敵しうる、です。また、vLLM での推論性能の分析から、同期的な設定では W4A16 が最も費用効率が高く、非同期の連続バッチ処理では W8A8 が優位で、混在する負荷では用途で最適が変わる、と述べています事実[参考資料21]。Dettmers と Zettlemoyer は、BLOOM・OPT・NeoX/Pythia・GPT-2 の3〜8ビットで3.5万回超の実験を行い、総ビット数とゼロショット精度の関係では4ビットがほぼ普遍的に最適だった、と報告しています[参考資料22]。 これらは特定のモデル系列・ベンチマーク・実装での結果で、他のモデルや課題には当てはまらない場合があります(解説)。
(5) 重みのメモリ:本稿の計算
重みが占めるメモリは「パラメータ数 × 1パラメータあたりのバイト数」です。公称のパラメータ数(総パラメータ)と形式ごとの値を計算しました。KV キャッシュと活性化は含みません。
| モデル | 総パラメータ | BF16(2バイト) | 8ビット(1バイト) | 4ビット(0.5バイト) | MX の4.25ビット |
|---|---|---|---|---|---|
| Llama 3.1 8B | 8B | 16 GB | 8 GB | 4 GB | 4.3 GB |
| Llama 3.1 70B | 70B | 140 GB | 70 GB | 35 GB | 37.2 GB |
| Llama 3.1 405B | 405B | 810 GB | 405 GB | 203 GB | 215 GB |
| Qwen3-30B-A3B | 30.5B | 61 GB | 30.5 GB | 15.3 GB | 16.2 GB |
| Qwen3-235B-A22B | 235B | 470 GB | 235 GB | 118 GB | 125 GB |
| DeepSeek-V3 | 671B | 1,342 GB | 671 GB | 336 GB | 357 GB |
| gpt-oss-120b | 116.83B | 234 GB | 117 GB | 58 GB | 62 GB |
本稿の計算(GB=109バイト、重みのみ)。パラメータ数は公式資料の値[参考資料2〜9]。実際には、全パラメータを同じ精度にするとは限りません(gpt-oss は MoE のみ MXFP4、他は BF16)。ブロックのスケール、埋め込み、量子化のメタデータ、KV キャッシュ、活性化は含みません。
計算の妥当性を、gpt-oss で確かめました。モデルカードの Table 1 は、120b の MLP(MoE)が114.71B、注意が0.96B、埋め込みと出力側が1.16B、チェックポイントサイズが60.8 GiB だと示します[参考資料9]。MoE を4.25ビット、残りを BF16(2バイト)とすると、114.71B×4.25/8+(0.96+1.16)B×2=約65.2 GB=約60.7 GiB で、表の60.8 GiB とほぼ一致します本稿の計算。つまり、「全部を4ビットにした」のではなく、重みの大半(MoE)だけを4ビット化して、残りは16ビットのまま、という構成が数字から確認できます。
量子化の精度劣化の研究は、一般の言語理解や数学・コードのベンチマークが中心です[参考資料21・22]。単位換算、桁の扱い、規格番号、数式、表の数値の読み取りのような素材・プロセスの業務で、劣化が同じ程度かは、確認できませんでした。推測として、桁や符号を扱う処理は、小さな精度の低下でも結果に響きやすい可能性があります。 量子化したモデルを導入するときは、元の精度のモデルと、量子化後のモデルに、自社の代表的な質問で同じ評価(本シリーズ『ベンチマークと評価の読み方』編)をして、差が許容範囲かを測ってください。
5. 剪定(プルーニング)
剪定は、重要でない重みや構造を取り除く方法です。大きく、任意の重みをゼロにする非構造化、層・ヘッド・次元などをまとめて取り除く構造化、一定の並びでゼロにする半構造化(2:4 など)があります(本記事による整理)。
- 半構造化(2:4):NVIDIA の Ampere GPU は、2:4(50%)のスパース性のパターンを活かすスパース Tensor Core を持ち、行列演算の処理量が2倍になる、と論文は説明しています。同論文は、スパース性の研究が高い疎性に集中する一方、精度を維持しつつ現代の行列演算ハードウェアで大きな高速化を得ることには課題がある、とも述べています[参考資料24]。
- SparseGPT:GPT 系の大規模モデルを、再学習なしの1回の処理で50%以上の疎性に剪定でき、OPT-175B と BLOOM-176B で、60% の非構造化の疎性でもパープレキシティの増加がわずかだった、と報告しています[参考資料25]。
- Wanda:重みの大きさと入力の活性化の積が小さい重みを、出力ごとに取り除く方法で、再学習も重みの更新も不要です[参考資料26]。
- 構造化と再学習(Sheared LLaMA、Minitron):LLaMA2-7B を1.3B・2.7B に剪定した Sheared-LLaMA[参考資料27]、15B を8B・4B に剪定して蒸留で再学習した Minitron[参考資料28]が報告されています。
すべて事実(各論文の記述)。性能の数値は各論文の条件での値です。
注意:重みの50% をゼロにしても、それだけで速度が上がるとは限りません。非構造化の疎性は、専用のハードウェアとソフトウェアの対応がなければ、実際の高速化に結びつかないことがあります(本記事による解説。上の Mishra らの記述を参照)。メモリの削減も、疎な形式で保存して初めて得られます。
6. 小型モデルと、オープンウェイトモデルの仕様
(1) なぜ小型モデルか:推論の需要を見込む
Sardana らは、Hoffmann らの Chinchilla の学習則(計算最適な学習)[参考資料32]に推論の費用を加え、推論の需要が大きい(約10億回の要求)と見込む場合は、Chinchilla の最適より小さいモデルを、より長く学習すべきだと示しました。パラメータあたりのトークン数を1万まで増やしても品質が向上し続けることも報告しています[参考資料31]。Llama 3 の論文も、旗艦モデルは計算最適に近い大きさだが、小さいモデルは計算最適よりずっと長く学習し、同じ推論予算で計算最適のモデルより良い性能になる、と述べています[参考資料5]事実。Phi-3 の技術報告は、3.8B パラメータの phi-3-mini を3.3兆トークンで学習し、MMLU 69% を含む性能(開発元の評価)が Mixtral 8x7B や GPT-3.5 に匹敵しつつ、スマートフォンに載せられる大きさだと述べています[参考資料29]。
(2) オープンウェイトモデルの仕様(2026年10月15日確認)
| モデル | 規模 | 重みの配布形式・精度 | 文脈長 | ライセンス(概要) |
|---|---|---|---|---|
| gpt-oss-120b/20b [9・10] | 116.83B/5.13B活性、20.91B/3.61B活性 | MoE の重みを MXFP4(4.25ビット)で後学習。120b は単一の80GB GPU、20b は16GB のメモリに収まる、とモデルカードが記載 | 131,072 | Apache 2.0。利用ポリシーに従い、適用される法令を守ること |
| Qwen3-235B-A22B/30B-A3B [7・8] | 235B/22B活性、30.5B/3.3B活性 | モデルカード上は bf16(config の torch_dtype) | 標準32,768、YaRN で131,072 | Apache 2.0 |
| DeepSeek-V3 [3・4・36] | 671B/37B活性 | FP8 の重みのみ配布(BF16 への変換スクリプトを提供) | 128K | コードは MIT、モデルは「DeepSeek Model Agreement」(使用制限つき、第8章) |
| Mixtral 8x7B [2] | 約47B/約13B活性 | 公式の config は bf16 | 学習時32k | Apache 2.0 |
| Llama 3.1 8B/70B/405B [5・33] | 密結合 8B/70B/405B | 論文は BF16 を基準とし、推論では H100 の FP8 で多くの行列積を量子化する実装を説明 | 128K | Llama 3.1 Community License(月間利用者7億人超の条件、表示義務、利用ポリシー) |
| Gemma 4(E2B/E4B/12B/26B A4B/31B)[14・35] | E2B 有効2.3B(埋め込み込み5.1B)、E4B 有効4.5B(同8B)、12B(11.95B)、26B A4B(総25.2B・活性3.8B)、31B(30.7B) | 事前学習版と指示調整版 | 小型128K、中型256K | Apache 2.0(Gemma 3 までは Gemma Terms of Use[34]) |
| Phi-3-mini [29・30] | 3.8B | — | 4K/128K の2種 | MIT |
すべて事実(各モデルカード・論文・config.json・ライセンスの記載。確認日 2026年10月15日)。Llama 3.1 の FP8 の記述は Llama 3 論文[5]の「FP8 Quantization」の節による(量子化の詳細は本稿では扱いません)。数値は仕様の記載で、性能の優劣を示すものではありません。
7. メモリ・速度・精度のトレードオフ(本稿の計算)
(1) デコード速度の上限を、重みの読み出しから見積もる
文章を1トークンずつ生成するデコードでは、1トークンごとに重みをメモリから読み出すため、メモリ帯域が速度の上限を決めます(本記事による解説。本シリーズ『推論の最適化とサービング』編)。バッチ1で、メモリ帯域を3 TB/s と仮定すると、上限の速度=帯域÷(1トークンで読む重みのバイト数)です。MoE では、読むのは活性の部分だけで、gpt-oss-120b のモデルカードの内訳から読み出し量を見積もりました。活性の MoE は 114.71B×4/128=約3.58B(4.25ビット=約1.90 GB)、注意の0.96B(BF16=1.92 GB)、出力側の約0.58B(BF16=1.16 GB)で、合計約4.98 GB です本稿の計算(活性5.13B のモデルカードの値と一致)。
| モデル・形式 | 1トークンで読む重み | 速度の上限(3 TB/s 仮定) |
|---|---|---|
| Llama 3.1 70B・BF16 | 140 GB | 約21トークン/秒 |
| Llama 3.1 70B・FP8 | 70 GB | 約43トークン/秒 |
| Llama 3.1 70B・4ビット | 35 GB | 約86トークン/秒 |
| Llama 3.1 405B・FP8 | 405 GB | 約7トークン/秒 |
| DeepSeek-V3・FP8(活性37B) | 37 GB | 約81トークン/秒 |
| Qwen3-235B-A22B・FP8(活性22B) | 22 GB | 約136トークン/秒 |
| gpt-oss-120b・MXFP4(活性5.13B) | 約4.98 GB | 約602トークン/秒 |
本稿の計算(速度=3,000 GB/s÷読む重み)。前提(仮定):バッチ1、メモリ帯域3 TB/s、重みの読み出しのみ。KV キャッシュ、活性化、通信、バッチ内での専門家の重なり、演算のオーバーヘッドは含まない。実際の速度は、バッチサイズ・精度・ハードウェア・入出力長・ソフトウェアで大きく変わります。
(2) 状況ごとに、どの手段が効きやすいか(条件つきの整理)
| 状況 | 効きやすい手段 | 条件・注意(一次情報にもとづく部分は出典つき) |
|---|---|---|
| 単一の GPU・PC に載せたい(メモリ) | 4ビット量子化、小型モデル、MoE の重みの量子化(gpt-oss) | MoE は総パラメータ分のメモリが要る。4ビットの精度への影響は条件つき[21・22]。KV キャッシュと活性化の分を別に確保(『検索拡張生成とコンテキストウィンドウ』編) |
| 1人の利用者向けの低遅延(バッチ1) | 重みの量子化(W4A16)、MoE(活性が少ない) | Kurtic らは、同期的な設定では W4A16 が最も費用効率が高いと報告[21] |
| 多数の同時リクエスト(大バッチ) | W8A8(FP8・INT8) | 非同期の連続バッチでは W8A8 が優位と報告[21]。バッチが大きいと、MoE は読む専門家が増え、バッチ1の見積りほど有利ではない(解説) |
| 精度を最優先する | BF16、FP8 | FP8(W8A8-FP)は Llama-3.1 の全サイズで実質的に劣化なしと報告[21]。自社の課題で確認 |
| 学習・開発の費用を減らす | 蒸留、剪定+蒸留 | Qwen3 は蒸留が強化学習の約1/10の GPU 時間と報告(開発元)[6]、Minitron は必要トークンが最大40分の1と報告[28] |
出典のある部分は事実(各論文)。表の整理と「条件・注意」は本記事の解説です。
現場の機器の近くで小さなモデルを動かす構想は魅力的ですが、速度とメモリの数字は、バッチ、精度形式、入出力長、ハードウェア、ソフトウェアで変わります(第7章)。クラウドで評価した結果を、そのまま現場の小型機に当てはめず、現場の機器で、自社の代表的な質問を使って、精度・速度・メモリ・発熱を測るのが確実です。電力・冷却・パッケージの制約は、本シリーズ『エッジAIとオンデバイスAI』『AIデータセンターの電力と冷却』編で扱います。
8. ライセンス条件の読み方
「オープンウェイト」は、重みが公開されていることを指し、使用・改変・再配布の条件はモデルごとに違います。OSI(Open Source Initiative)の Open Source AI Definition 1.0 は、オープンソースの AI に、学習データの十分に詳細な情報(Data Information)、学習と実行の完全なソースコード(Code)、モデルのパラメータ(Parameters)を OSI 承認の条件で提供することを求め、「オープンソースのモデル・重み」には、そのパラメータを導いたデータ情報とコードが含まれなければならない、としています[参考資料38]事実。したがって、重みが公開されていること(オープンウェイト)と、OSI の定義でのオープンソース AI であることは別です。本稿は、各モデルがこの定義を満たすかは判定しません。
| ライセンス | 原文で確認できた主な条件 | 例(本稿で扱ったモデル) |
|---|---|---|
| Apache License 2.0[37] | 著作権と特許の実施許諾(無償・取消不能・世界的)を与える。特許訴訟を起こすと、その特許許諾は終了する(第3条)。再配布には、ライセンスの写しを渡す、改変したファイルにその旨を明記する、著作権・特許・商標・帰属の表示を保持する、NOTICE ファイルの表示を含める、などが必要(第4条) | gpt-oss[9・10]、Qwen3[7・8]、Mixtral[2]、Gemma 4[14・35] |
| MIT License | ソフトウェアの複製・利用・改変・配布などを制限なく許可し、著作権表示と許諾表示を保持することを条件とする(Phi-3-mini のライセンスファイルを確認)[30] | Phi-3-mini[30]、DeepSeek-V3 のコード[4] |
| DeepSeek のモデルライセンス(Model Agreement)[36] | 著作権と特許の実施許諾(無償・世界的・取消不能)を与えるが、使用ベースの制限(Attachment A)を、モデルや派生物の使用・配布を定めるあらゆる契約に強制力のある条項として含めることを求める。「派生物」には、モデルの重み・パラメータ・活性化・出力のパターンの移転によって作られた別のモデルを含む。「配布」には、API などで第三者にホストして提供することを含む | DeepSeek-V3 のモデル[3・4] |
| Llama 3.1 Community License[33] | 再配布や、Llama を含む製品・サービス(別の AI モデルを含む)の提供では、契約の写しを渡し、「Built with Llama」を表示する。Llama の資料や出力を使って AI モデルを作成・学習・微調整・改善して配布する場合は、モデル名の先頭に「Llama」を含める。利用ポリシーを守る。提供開始時点で自社と関連会社の月間利用者が7億人を超える場合は、Meta に別途ライセンスを求める必要がある。Meta または Llama の出力が知的財産を侵害すると訴訟を起こした場合の終了条項がある | Llama 3.1[5] |
| Gemma Terms of Use(Gemma 3 まで)[34] | 再配布には、使用制限(Prohibited Use Policy)を下流の契約に強制力のある条項として含め、契約の写しと Notice ファイルを添える。Google は、規約違反と合理的に考える利用を、遠隔などで制限する権利を留保する。Gemma を随時更新しうる。Outputs は Model Derivatives ではなく、Google は Outputs に権利を主張しない | Gemma 3 まで[34] |
| Gemma 4 のライセンス[14・35] | モデルカードに License: Apache 2.0 と記載され、Gemma のサイトに Apache License 2.0 のページがある。同じ Gemma の名でも、世代でライセンスが変わる | Gemma 4[14] |
すべて事実(各ライセンス原文・公式ページ、確認日 2026年10月15日)。要約は本記事によるもので、法的助言ではありません。条件の正確な意味は、ライセンス全文と、必要なら専門家の助言で確認してください。
オープンウェイトのモデルを、自社のデータで微調整したり、社内システムに組み込んだり、取引先に提供したりする前に、次を確認します(本記事による一般的なチェックリストで、法的助言ではありません)。
- 派生物の定義:微調整・量子化・蒸留で作ったモデルが派生物に当たるか(DeepSeek のように、出力を使った蒸留も派生物に含めるものがある)。
- 表示・名称の義務:「Built with Llama」の表示や、モデル名の先頭の「Llama」のような条件。
- 利用者の規模・用途の制限:月間利用者7億人の条件、使用ベースの制限(禁止される用途)。
- 下流への条項の引き継ぎ:再配布や、サービスとして提供する場合に、同じ使用制限を契約に入れる必要があるか。
- 提供側が変更・制限できる条項:Gemma Terms of Use のように、利用を遠隔などで制限する権利の留保や、更新の条項。
- 世代による変更:Gemma 3 までと Gemma 4 のように、世代でライセンスが変わる。使うバージョンのライセンス原文を保存する。
9. 限界と、確認できなかったこと
(1) モデルの性能比較
本稿は、モデル間の性能の優劣を扱いません。パラメータ数・文脈長・ライセンスは公式資料の記載(確認日 2026年10月15日)で、各社の最新モデルや、これらのモデルの更新版は、個別に確認していません。
(2) 試算の前提
第4章・第7章の試算は、公称のパラメータ数と、メモリ帯域3 TB/s、バッチ1、重みの読み出しのみ、という説明用の仮定にもとづきます。実際の速度は、バッチ・並列化・KV キャッシュ・演算のオーバーヘッド・ソフトウェアで変わります。gpt-oss の活性パラメータの読み出し量(約4.98 GB)は、モデルカードの内訳から導いた本稿の推定で、実装の実測ではありません。
(3) 精度の劣化の一般性
量子化・剪定・蒸留の精度への影響は、各論文の特定のモデル・ベンチマーク・実装での結果です。素材・プロセスの業務での影響を測った一次情報は、確認できませんでした(第4章の素材技術者の視点②は本記事の推測を含みます)。蒸留の効果(Qwen3 の約1/10の GPU 時間、Minitron の最大40分の1のトークン)は、開発元・著者の報告で、独立の再現は確認できませんでした。
(4) 規格・仕様書の本文
ISO/IEC の規格は題名・発行年月・適用範囲の要旨のみを確認し、本文は未確認です。OCP の MX 仕様書(Microscaling Formats Specification)は、本稿では原文を確認できず、MX の論文の表で形式を確認しました。IEEE P3109 は作成中のプロジェクトで、本文は確認していません。
(5) ライセンス
第8章のライセンスの要約は、公開されている原文の記述に基づく一般的な説明で、法的助言ではありません。Llama 3.1 の最新の版や、他の世代のライセンス、各モデルの利用ポリシーの全文は、確認していません。
- 効率化の手段は、縮めるものが違います。MoE は計算と読み出し、量子化はバイト数、蒸留・剪定はモデルの大きさ(再学習を伴う)です(解説)
- MoE の「総」と「活性」を区別します。メモリは総パラメータ、速度は活性パラメータで決まります。gpt-oss-120b は総116.83B・活性5.13B で、MoE 部分を4.25ビットにして80GB の GPU に収まります事実
- 量子化の精度の代償は条件つきです。Llama-3.1 では FP8 は実質劣化なし、INT8 は1〜3%、4ビットの重みのみも競争力がある、と報告されています事実
- 速度の上限は、読む重みの量で決まります。仮定つきの試算で、gpt-oss-120b(MXFP4)は約600トークン/秒、Llama 3.1 70B(BF16)は約21トークン/秒です本稿の計算
- 「オープンウェイト」はライセンス条件の違いを含みます。Apache 2.0、MIT、使用制限つきのライセンス、Llama の条件、世代で変わる Gemma など、原文で確認します事実
- 自社の課題で、元のモデルと効率化後のモデルを同じ評価で比べます。数値を扱う業務ほど、量子化の影響を確かめます(解説)
10. 評価・標準の読み方
モデルの効率化の評価は、精度の維持(元のモデルとの差)、速度・スループット、メモリ・エネルギー、そして仕様とライセンスの記載の4つに分けて考えます。数値形式には国際標準がありますが、効率化の評価そのものを定める国際規格は確認できませんでした。次の表は、確認できたものを区分つきで並べたものです。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・IEEE・NIST など) | 読み方の注意 |
|---|---|---|---|
| 精度の維持(量子化・剪定・蒸留後) | 元のモデルと同じベンチマーク・同じ設定で比べる。Kurtic らの Llama-3.1 全サイズ・50万回超の評価(FP8・INT8・INT4)[21]。Dettmers らの k ビット推論のスケーリング則[22]事実 | 確認できなかった(量子化・剪定の精度評価の手順を定めた規格は確認できなかった) | モデル系列・ベンチマーク・実装が違うと劣化は変わる。自社の課題で、元のモデルと同じ評価をする(『ベンチマークと評価の読み方』編) |
| 数値形式 | FP8(E4M3・E5M2)の提案[15]。MX 形式(ブロック32、E8M0 スケール、MXFP4=4.25ビット)[16]事実 | IEEE 754-2019「浮動小数点演算」(2019年7月22日発行。二進・十進の浮動小数点の交換形式と演算を規定)[40]。IEEE P3109「機械学習のための算術形式」は作成中(PAR 承認2023年2月15日)[41]未確定/将来。FP8 の E5M2 は IEEE 754 の慣習に従う(FP8 論文)[15] | FP8・FP4 などの形式が IEEE 754 の本体に含まれるかは確認していない。P3109 は成立前で、準拠を主張できない。同じ名前の形式でも、スケールの付け方・丸めが実装で違う |
| 速度・スループット | MLPerf Inference: Datacenter(MLCommons)。各ベンチマークはデータセットと品質目標で定義され、Closed 部門は参照実装と同じモデルを使い、ハードウェアやフレームワークを「同条件」で比べる。Open 部門は別のモデルや再学習を許す。結果は Available/Preview/RDI の区分で出る(ページ表示は V6.1)[39]事実 | ISO/IEC TR 17903:2024(機械学習の計算デバイスの概観。用語と特性、性能を最適化する特性の設定と使い方、2024年5月、TR=技術報告書)[42]事実 | 提出区分(Closed/Open、Available/Preview)、システム構成、版を確認。開発元が公表する速度は、バッチ・精度・入出力長・ハードウェア・ソフトウェアの記載がなければ比べられない。TR は要求事項ではない |
| メモリ・エネルギー・環境 | 公称パラメータ数と形式からの重みメモリの計算(第4章)。KV キャッシュは『検索拡張生成とコンテキストウィンドウ』編事実 | ISO/IEC TR 20226:2025(AI システムの環境面の側面と関連しうる指標の概観、2025年7月、TR)[43]。ISO/IEC TS 42112:2026(機械学習モデルの学習効率の最適化に関するガイダンス、2026年6月、TS)[44]事実 | TS 42112 は学習の効率が対象で、推論の効率化(量子化・MoE の推論)を直接扱うかは、要旨からは確認できなかった。推論時のエネルギーの標準測定法は確認できなかった |
| 仕様の記載・オープン性・ライセンス | 各モデルの公式モデルカード・config.json・技術報告書(本稿の第6章の表) | OSI Open Source AI Definition 1.0(Data Information・Code・Parameters を OSI 承認の条件で提供)[38]事実。「オープンウェイト」の仕様記載やライセンスを定めた国際規格は確認できなかった | OSI の定義は業界団体の定義で、法的拘束力のある規格ではない。ライセンスは各社が個別に定め、世代で変わる(第8章)。モデルカードの活性パラメータの数え方は提供元で異なる |
| リスク管理・マネジメント | 確認できなかった(これらは評価手法ではなく管理の枠組み) | NIST AI 100-1(AI RMF 1.0、2023年1月、自主的な枠組み)[46]。ISO/IEC 42001:2023(AI マネジメントシステムの要求事項)[45]事実 | NIST は任意の枠組み。ISO/IEC 42001 は認証の対象になりうる要求事項を持つが、モデルの効率化の方法は定めない |
規格の番号・題名・発行年月・段階は ISO・IEEE・NIST・OSI・MLCommons の公式ページで確認した事実(確認日 2026年10月15日)。表の並べ方と「読み方の注意」は本稿の計算(本記事による整理)です。
読み方の注意
- ベンチマークの値は、設定と実施主体で変わります。速度・メモリの数字は、バッチ、精度形式、入出力長、ハードウェア、ソフトウェアで変わり、MLPerf も提出区分とシステム構成を添えて読みます。精度の劣化の数字は、モデル系列と評価設定が限定されています。
- 飽和と汚染に注意します。量子化・剪定の精度は、公開ベンチマークの小さな差で議論されることが多く、その差が誤差の範囲か(『ベンチマークと評価の読み方』編の第5章)を確認します。
- 標準・指針は、推奨か要求か、法的拘束力があるかで読み分けます。IEEE 754 は発行済みの標準、IEEE P3109 は作成中、ISO/IEC の TR・TS は報告書・仕様書、NIST は任意の枠組み、OSI の定義は業界団体の定義、MLCommons のベンチマークは業界のベンチマークです。いずれも、特定の効率化手法やモデルの優劣を定めてはいません。
- 宣言値と実測値を区別します。開発元が示す「単一の80GB GPU に載る」「約何倍高速」といった値は宣言値です。自社の機器・設定で、メモリ・速度・精度を測った値が実測値です。
11. 用語集
- 混合専門家(MoE)
- FFN を複数の専門家に分け、ルーターがトークンごとに少数を選んで使う方式。
- 総パラメータ/活性パラメータ
- 全体の重みの数/1トークンの計算で実際に使う重みの数。MoE では大きく違う。
- 知識蒸留
- 大きなモデル(教師)の出力を使って、小さなモデル(学生)を学習させる方法。
- 量子化
- 数値をより少ないビット数で表し、メモリと計算を減らす方法。
- W8A8/W4A16
- 重みと活性化のビット数の表記。W8A8=両方8ビット、W4A16=重み4ビット・活性化16ビット。
- FP8(E4M3/E5M2)
- 8ビットの浮動小数点。指数と仮数のビット数の配分が違う2種類。
- MX 形式(MXFP4 など)
- ブロック(32要素)ごとに共有スケール(E8M0)を持つ狭いビット幅の形式。MXFP4 は4.25ビット/要素。
- 剪定(プルーニング)
- 重要でない重みや構造を取り除くこと。非構造化・構造化・半構造化(2:4)がある。
- 2:4 スパース性
- 連続する4つの重みのうち2つをゼロにするパターン。対応するハードウェアで演算が速くなる。
- オープンウェイト
- モデルの重みが公開されていること。使用・改変・再配布の条件は個別。OSI の「オープンソース AI」とは別。
- Per-Layer Embeddings(PLE)
- 各層に小さな埋め込みを持たせ、有効パラメータ数を抑える Gemma 4 の方式。
- MLPerf Inference
- MLCommons の推論性能のベンチマーク。Closed/Open の部門と、提出区分がある。
- TR/TS
- ISO/IEC の技術報告書/技術仕様書。要求事項を持つ国際規格(IS)とは別。
- PAR
- IEEE の標準化プロジェクトの承認(Project Authorization Request)。承認は標準の成立を意味しない。
12. 参考資料(一次情報)
- Shazeer N. ほか "Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer", arXiv:1701.06538 (2017年1月) — arxiv.org/abs/1701.06538
- Jiang A. Q. ほか "Mixtral of Experts", arXiv:2401.04088 (2024年1月) — arxiv.org/abs/2401.04088
- DeepSeek-AI "DeepSeek-V3 Technical Report", arXiv:2412.19437 (2024年12月; v2 2025年2月) — arxiv.org/abs/2412.19437
- DeepSeek-AI "deepseek-ai/DeepSeek-V3"(Hugging Face の公式モデルカード。FP8 重みのみの配布、ライセンスの記載、確認日 2026年10月15日) — huggingface.co/deepseek-ai/DeepSeek-V3
- Llama Team(Grattafiori A. ほか) "The Llama 3 Herd of Models", arXiv:2407.21783 (2024年7月; v3 2024年11月) — arxiv.org/abs/2407.21783
- Qwen Team(An Yang ほか) "Qwen3 Technical Report", arXiv:2505.09388 (2025年5月) — arxiv.org/abs/2505.09388
- Qwen "Qwen/Qwen3-235B-A22B"(Hugging Face の公式モデルカード、確認日 2026年10月15日) — huggingface.co/Qwen/Qwen3-235B-A22B
- Qwen "Qwen/Qwen3-30B-A3B"(Hugging Face の公式モデルカード、確認日 2026年10月15日) — huggingface.co/Qwen/Qwen3-30B-A3B
- OpenAI "gpt-oss-120b & gpt-oss-20b Model Card", arXiv:2508.10925 (2025年8月8日) — arxiv.org/abs/2508.10925
- OpenAI "openai/gpt-oss-120b"(Hugging Face の公式モデルカード。MXFP4、80GB GPU、Apache 2.0 の記載、確認日 2026年10月15日) — huggingface.co/openai/gpt-oss-120b
- Hinton G. ほか "Distilling the Knowledge in a Neural Network", arXiv:1503.02531 (2015年3月) — arxiv.org/abs/1503.02531
- Sanh V. ほか "DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter", arXiv:1910.01108 (2019; v4 2020年3月) — arxiv.org/abs/1910.01108
- Gemma Team "Gemma 2: Improving Open Language Models at a Practical Size", arXiv:2408.00118 (2024年7月; v3 2024年10月) — arxiv.org/abs/2408.00118
- Google DeepMind "Gemma 4 model card"(Google AI for Developers、確認日 2026年10月15日) — ai.google.dev/gemma/docs/core/model_card_4
- Micikevicius P. ほか "FP8 Formats for Deep Learning", arXiv:2209.05433 (2022年9月) — arxiv.org/abs/2209.05433
- Rouhani B. D. ほか "Microscaling Data Formats for Deep Learning", arXiv:2310.10537 (2023年10月) — arxiv.org/abs/2310.10537
- Dettmers T. ほか "LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale", arXiv:2208.07339 (2022年8月) — arxiv.org/abs/2208.07339
- Frantar E. ほか "GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers", arXiv:2210.17323 (2022年10月; v2 2023年3月) — arxiv.org/abs/2210.17323
- Lin J. ほか "AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration", arXiv:2306.00978 (2023年6月) — arxiv.org/abs/2306.00978
- Xiao G. ほか "SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models", arXiv:2211.10438 (2022年11月) — arxiv.org/abs/2211.10438
- Kurtic E. ほか "Give Me BF16 or Give Me Death"? Accuracy-Performance Trade-Offs in LLM Quantization, arXiv:2411.02355 (2024年11月) — arxiv.org/abs/2411.02355
- Dettmers T., Zettlemoyer L. "The case for 4-bit precision: k-bit Inference Scaling Laws", arXiv:2212.09720 (2022年12月; v2 2023年2月) — arxiv.org/abs/2212.09720
- NVIDIA "Pretraining Large Language Models with NVFP4", arXiv:2509.25149 (2025年9月; v2 2026年3月) — arxiv.org/abs/2509.25149
- Mishra A. ほか "Accelerating Sparse Deep Neural Networks", arXiv:2104.08378 (2021年4月) — arxiv.org/abs/2104.08378
- Frantar E., Alistarh D. "SparseGPT: Massive Language Models Can Be Accurately Pruned in One-Shot", arXiv:2301.00774 (2023年1月) — arxiv.org/abs/2301.00774
- Sun M. ほか "A Simple and Effective Pruning Approach for Large Language Models", arXiv:2306.11695 (2023年6月、Wanda) — arxiv.org/abs/2306.11695
- Xia M. ほか "Sheared LLaMA: Accelerating Language Model Pre-training via Structured Pruning", arXiv:2310.06694 (2023年10月) — arxiv.org/abs/2310.06694
- Muralidharan S. ほか "Compact Language Models via Pruning and Knowledge Distillation", arXiv:2407.14679 (2024年7月; v2 2024年11月、Minitron) — arxiv.org/abs/2407.14679
- Abdin M. ほか "Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone", arXiv:2404.14219 (2024年4月; v4 2024年8月) — arxiv.org/abs/2404.14219
- Microsoft "microsoft/Phi-3-mini-4k-instruct"(Hugging Face の公式モデルカードと LICENSE(MIT)、確認日 2026年10月15日) — huggingface.co/microsoft/Phi-3-mini-4k-instruct
- Sardana N. ほか "Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws", arXiv:2401.00448 (2023年12月; v3 2025年4月) — arxiv.org/abs/2401.00448
- Hoffmann J. ほか "Training Compute-Optimal Large Language Models", arXiv:2203.15556 (2022年3月) — arxiv.org/abs/2203.15556
- Meta "Llama 3.1 Community License Agreement"(2024年7月23日。llama-models リポジトリの LICENSE) — github.com/meta-llama/llama-models/blob/main/models/llama3_1/LICENSE
- Google "Gemma Terms of Use"(Google AI for Developers、確認日 2026年10月15日) — ai.google.dev/gemma/terms
- Google "Apache License 2.0 | Gemma"(Gemma 4 のライセンスのページ、確認日 2026年10月15日) — ai.google.dev/gemma/apache_2
- DeepSeek-AI "DeepSeek License Agreement"(DeepSeek-V3 の LICENSE-MODEL) — github.com/deepseek-ai/DeepSeek-V3/blob/main/LICENSE-MODEL
- Apache Software Foundation "Apache License, Version 2.0" — www.apache.org/licenses/LICENSE-2.0
- Open Source Initiative "The Open Source AI Definition – 1.0"(確認日 2026年10月15日) — opensource.org/ai/open-source-ai-definition
- MLCommons "MLPerf Inference: Datacenter"(公式ページ、表示は V6.1、確認日 2026年10月15日) — mlcommons.org/benchmarks/inference-datacenter/
- IEEE "IEEE 754-2019 IEEE Standard for Floating-Point Arithmetic"(2019年7月22日発行) — standards.ieee.org/ieee/754/6210/
- IEEE "P3109 Standard for Arithmetic Formats for Machine Learning"(Active PAR、PAR 承認 2023年2月15日、確認日 2026年10月15日) — standards.ieee.org/ieee/3109/11165/
- ISO/IEC "ISO/IEC TR 17903:2024 Information technology — Artificial intelligence — Overview of machine learning computing devices"(2024年5月、技術報告書) — www.iso.org/standard/85078.html
- ISO/IEC "ISO/IEC TR 20226:2025 Information technology — Artificial intelligence — Environmental sustainability aspects of AI systems"(2025年7月、技術報告書) — www.iso.org/standard/86177.html
- ISO/IEC "ISO/IEC TS 42112:2026 Information technology — Artificial intelligence — Guidance on machine learning model training efficiency optimization"(2026年6月) — www.iso.org/standard/42112
- ISO/IEC "ISO/IEC 42001:2023 Information technology — Artificial intelligence — Management system"(2023年12月) — www.iso.org/standard/81230.html
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1(2023年1月), DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| MoE:Shazeer らの1000倍超の容量と最大137B パラメータ。Mixtral の8専門家・2つ選択・47B/13B・32k・Apache 2.0 | Shazeer ら、Mixtral の論文 出典1 https://arxiv.org/abs/1701.06538 出典2 https://arxiv.org/abs/2401.04088 | 事実 |
| DeepSeek-V3:671B/37B、MLA・DeepSeekMoE、14.8兆トークン、278.8万 H800 時間、FP8 混合精度学習、FP8 重みのみの配布、685B の内訳、コードは MIT・モデルは Model Agreement | 技術報告、HF のモデルカード 出典3 https://arxiv.org/abs/2412.19437 出典4 https://huggingface.co/deepseek-ai/DeepSeek-V3 | 事実 |
| Llama 3:8B/70B/405B、128K、GQA、405B の FP8 量子化の記述、計算最適より長く学習した小型モデル | Llama 3 の論文 出典5 https://arxiv.org/abs/2407.21783 | 事実 |
| Qwen3:MoE の活性が1/10でも同等、strong-to-weak 蒸留、オンポリシー蒸留が強化学習の約1/10 GPU 時間。Qwen3-235B-A22B・30B-A3B の規模・専門家・層・文脈長・Apache 2.0 | Qwen3 の技術報告、公式モデルカード 出典6 https://arxiv.org/abs/2505.09388 出典7 https://huggingface.co/Qwen/Qwen3-235B-A22B 出典8 https://huggingface.co/Qwen/Qwen3-30B-A3B | 事実 |
| gpt-oss:116.83B/5.13B、20.91B/3.61B、Table 1 の内訳、チェックポイント60.8 GiB、MXFP4 は4.25ビットで MoE が90%超、128専門家・上位4つ、80GB と16GB、Apache 2.0 | gpt-oss モデルカード、HF のモデルカード 出典9 https://arxiv.org/abs/2508.10925 出典10 https://huggingface.co/openai/gpt-oss-120b | 事実 |
| 蒸留:Hinton の原理、DistilBERT(40%小さく・60%速く・97%)、Gemma 2(2B・9B を蒸留で学習) | 各論文 出典11 https://arxiv.org/abs/1503.02531 出典12 https://arxiv.org/abs/1910.01108 出典13 https://arxiv.org/abs/2408.00118 | 事実 |
| Gemma 4:E2B/E4B/12B/26B A4B/31B の規模、有効パラメータと PLE、MoE の構成、局所・全体注意、文脈長、Apache 2.0 | Gemma 4 のモデルカード 出典14 https://ai.google.dev/gemma/docs/core/model_card_4 | 事実 |
| FP8(E4M3・E5M2、IEEE 754 の慣習)、MX 形式(ブロック32、E8M0、MXFP4=FP4 要素) | FP8 論文、MX 論文 出典15 https://arxiv.org/abs/2209.05433 出典16 https://arxiv.org/abs/2310.10537 | 事実 |
| LLM.int8()、GPTQ、AWQ、SmoothQuant の内容と数値 | 各論文 出典17 https://arxiv.org/abs/2208.07339 出典18 https://arxiv.org/abs/2210.17323 出典19 https://arxiv.org/abs/2306.00978 出典20 https://arxiv.org/abs/2211.10438 | 事実 |
| Llama-3.1 全サイズ・50万回超の評価(FP8 劣化なし、INT8 1〜3%、W4A16 の競争力、同期・非同期の推奨)。4ビットのスケーリング則(35,000回超の実験) | Kurtic ら、Dettmers ら 出典21 https://arxiv.org/abs/2411.02355 出典22 https://arxiv.org/abs/2212.09720 | 事実 |
| NVFP4 での120億パラメータ・10兆トークンの学習 | NVIDIA の論文 出典23 https://arxiv.org/abs/2509.25149 | 事実 |
| 剪定:2:4 のスパース Tensor Core、SparseGPT(50%以上、60%)、Wanda、Sheared-LLaMA、Minitron(最大40分の1のトークン、1.8倍の節約) | 各論文 出典24 https://arxiv.org/abs/2104.08378 出典25 https://arxiv.org/abs/2301.00774 出典26 https://arxiv.org/abs/2306.11695 出典27 https://arxiv.org/abs/2310.06694 出典28 https://arxiv.org/abs/2407.14679 | 事実 |
| 小型モデル:phi-3-mini(3.8B、3.3兆トークン、MMLU 69%、MIT)、推論の需要を見込むと小さく長く学習、Chinchilla | Phi-3 の報告・モデルカード、Sardana ら、Hoffmann ら 出典29 https://arxiv.org/abs/2404.14219 出典30 https://huggingface.co/microsoft/Phi-3-mini-4k-instruct 出典31 https://arxiv.org/abs/2401.00448 出典32 https://arxiv.org/abs/2203.15556 | 事実 |
| ライセンス:Llama 3.1(Built with Llama、名称の先頭、7億人、AUP、訴訟条項)、Gemma Terms of Use(使用制限、遠隔制限、Outputs)、Gemma 4(Apache 2.0)、DeepSeek Model Agreement(使用ベースの制限、派生物の定義)、Apache 2.0(第3・4条) | 各ライセンス原文・公式ページ 出典33 https://github.com/meta-llama/llama-models/blob/main/models/llama3_1/LICENSE 出典34 https://ai.google.dev/gemma/terms 出典35 https://ai.google.dev/gemma/apache_2 出典36 https://github.com/deepseek-ai/DeepSeek-V3/blob/main/LICENSE-MODEL 出典37 https://www.apache.org/licenses/LICENSE-2.0 | 事実 |
| OSI の Open Source AI Definition 1.0(Data Information・Code・Parameters) | OSI 出典38 https://opensource.org/ai/open-source-ai-definition | 事実 |
| MLPerf Inference: Datacenter(シナリオ、品質目標、Closed/Open、Available/Preview/RDI、V6.1) | MLCommons のページ 出典39 https://mlcommons.org/benchmarks/inference-datacenter/ | 事実 |
| IEEE 754-2019、IEEE P3109(Active PAR、2023年2月15日) | IEEE のページ 出典40 https://standards.ieee.org/ieee/754/6210/ 出典41 https://standards.ieee.org/ieee/3109/11165/ | 事実 |
| ISO/IEC TR 17903:2024、TR 20226:2025、TS 42112:2026、42001:2023 の番号・題名・発行年月 | ISO の標準ページ 出典42 https://www.iso.org/standard/85078.html 出典43 https://www.iso.org/standard/86177.html 出典44 https://www.iso.org/standard/42112 出典45 https://www.iso.org/standard/81230.html | 事実 |
| NIST AI 100-1(自主的な枠組み) | NIST 出典46 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| 重みメモリの計算(BF16/8ビット/4ビット/4.25ビットの GB)、gpt-oss のチェックポイントの再現(約65.2 GB=約60.7 GiB)、活性の読み出し量(約4.98 GB)、デコード速度の上限(約21/43/86/7/81/136/602トークン/秒) | 本稿の計算。メモリ帯域3 TB/s、バッチ1、重みの読み出しのみは説明用の仮定で、特定の製品の値ではない | 本稿の計算 |
| 「効率化の手段は縮めるものが違う」「状況ごとに効きやすい手段」「ライセンスで確認する六つのこと」、素材技術者の視点①〜④、MoE の「載せる量と動かす量」の喩え | 公表内容にもとづく本記事の整理・解説。法的助言ではなく、各機関が表明した見解でもない | 解説 |
| 図2・図3・図4・図6が説明用の作図であること、図1・図5がAI生成イメージ(画像未設置の枠)であること | 本記事による注記 | 解説 |
| 素材・プロセス業務での量子化・剪定の精度への影響、効率化の評価手順を定めた国際規格、OCP の MX 仕様書の原文、IEEE P3109 の本文、各社最新モデルの個別の性能、他世代のライセンス全文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない(本稿) | 解説 |
最終更新:2026年10月15日(確認日)/出典は一次情報(原論文、開発元の公式モデルカード・ライセンス・config.json、MLCommons・IEEE・OSI・ISO・NIST の公式ページ)に限定しています。規格の本文は有料のため確認できていません。パラメータ数・文脈長・ライセンスは変更されうるため、確認日より後の状態は保証しません。ライセンスの要約は一般的な説明で、法的助言ではありません。 素材・プロセス業務での量子化・剪定の精度への影響、効率化の評価手順を定めた国際規格、OCP の MX 仕様書の原文、IEEE P3109 の本文、各社最新モデルの個別の性能、他世代のライセンス全文は、確認できなかったため記載していません。 速度・メモリの試算は、公称パラメータ数と説明用の仮定(メモリ帯域3 TB/s、バッチ1)にもとづく概算で、実際の速度ではありません。 図2〜図4と図6はベクター作図、図1と図5はAI生成イメージ(画像未設置の枠)であり、いずれも実際の製品内部や実機の測定画面を示すものではありません。