TECHNOLOGY EXPLAINER
学習データとスケーリング則
― 「どれだけ大きく、どれだけ読ませるか」と、データの質・枯渇・計算量
大規模言語モデルの性能は、モデルの大きさ、読ませるデータの量、使う計算量で、おおむねなめらかに決まることが経験的に示されてきました。これがスケーリング則です。ただし、それは条件つきの当てはめで、データの質、重複、公開データの量、そして計算量がエネルギーと設備に与える負担を抜きには読めません。 この記事では、学習データの中身と整備、スケーリング則(Kaplan 型と Chinchilla 型の考え方と、その後の検証)、計算量(FLOP)からエネルギーを見積める連鎖、データ枯渇と合成データの議論を、一次情報の範囲で整理します。数値は確認日つきで示し、推計と公表値を区別します。
- 学習データとスケーリング則とは何か(3行でつかむ)
- 学習データの中身と整備 ― コーパス、重複除去、品質の選別
- データの質と記憶 ― 重複が何を引き起こすか
- スケーリング則 ― Kaplan 型、Chinchilla 型、その後の検証
- 計算量とエネルギー ― FLOP から GPU 時間、電力量へ
- データの枯渇・同意・合成データ
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=将来の見通し、推計、改訂中などで、確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。モデル名・規模・日付は確認日 2026年10月15日時点の公式資料の記載です。
スケーリング則の指数や定数は、特定のモデル群・データ・範囲で当てはめた経験式で、自然法則ではありません。研究によって値が異なり、範囲の外への外挿は保証されません。損失(クロスエントロピー)の改善は、課題の正解率の改善と同じではありません。 エネルギーの数値は、公表値と、本稿の見積りと、第三者の推計を区別して示します。電力の定義(TDP、システム平均、設備全体)が違う数値を、並べて比較しません。
1. 学習データとスケーリング則とは何か(3行でつかむ)
- 性能は規模で予測できる範囲がある:言語モデルの損失は、パラメータ数、データ量、計算量のそれぞれに対して、べき乗則でなめらかに下がります。Kaplan らは、傾向が7桁以上にわたって続く場合があると報告しました事実[参考資料12]
- モデルとデータは一緒に増やす:Hoffmann らは、決まった計算量で損失を最小にするには、モデルの大きさと学習トークン数を同じ割合で増やすのがよい、と報告しました(Chinchilla)。ただし、推論の費用や、公開データの量の限りを入れると、最適は変わります事実[参考資料13・25・26]
- 計算量はエネルギーに換算できる:学習の計算量はおおよそ 6 × パラメータ数 × トークン数(FLOP)で、GPU 時間と電力を掛けると、電力量が見積もれます。Llama 3 405B は、公表値で、3.8×10²⁵ FLOP、30.84M GPU 時間でした事実[参考資料14・15]
スケーリング則は「予測の道具」であって、「保証」ではありません。 同じ Kaplan と Chinchilla の研究でも、計算量を増やすときのモデル大きさの指数は 0.73 と 0.50 で異なり、その差の主な原因は、Kaplan がパラメータを埋め込みを除いて数えたことと、小さな規模で分析したことだと報告されています事実[参考資料13・24]。 当てはめの定義と範囲が、結論を変えます。
2. 学習データの中身と整備 ― コーパス、重複除去、品質の選別
事前学習のデータは、ウェブ、書籍、論文、コード、百科事典などから集めたテキストです。公開されている主なコーパスと、Llama 3 のデータの記述を整理します。
| コーパス/モデル | 規模・内容(各資料の記載) | 出典 |
|---|---|---|
| C4(T5) | ウェブから集めた、数百 GB のきれいな英語テキスト。「Colossal Clean Crawled Corpus」 | [3] |
| The Pile(2020) | 英語テキスト 825 GiB。学術・専門分野由来が多い22の高品質な部分集合から構成 | [4] |
| Dolma(2024) | 3兆トークンの公開コーパス。約200 TB の生テキストから、整備後は約11 TB。Common Crawl、Semantic Scholar の論文、GitHub のコードなど6つの情報源。トークンは LLaMA のトークナイザで数えた値 | [5] |
| FineWeb(2024) | 96個の Common Crawl スナップショットから作った15兆トークン。50以上の候補フィルタから有効な少数を選定。教育的な文章に絞った FineWeb-Edu は1.3兆トークン | [8] |
| Llama 3(2024) | 約15兆(旗艦は15.6兆)の多言語トークン。知識の期限は2023年末。混合比はおよそ、一般知識50%、数学・推論25%、コード17%、多言語8%。非公開のデータ | [14] |
すべて事実(各論文・技術報告)。トークン数は、トークナイザごとに数え方が違うため、コーパス間・モデル間で厳密には比べられません(本記事による解説)。
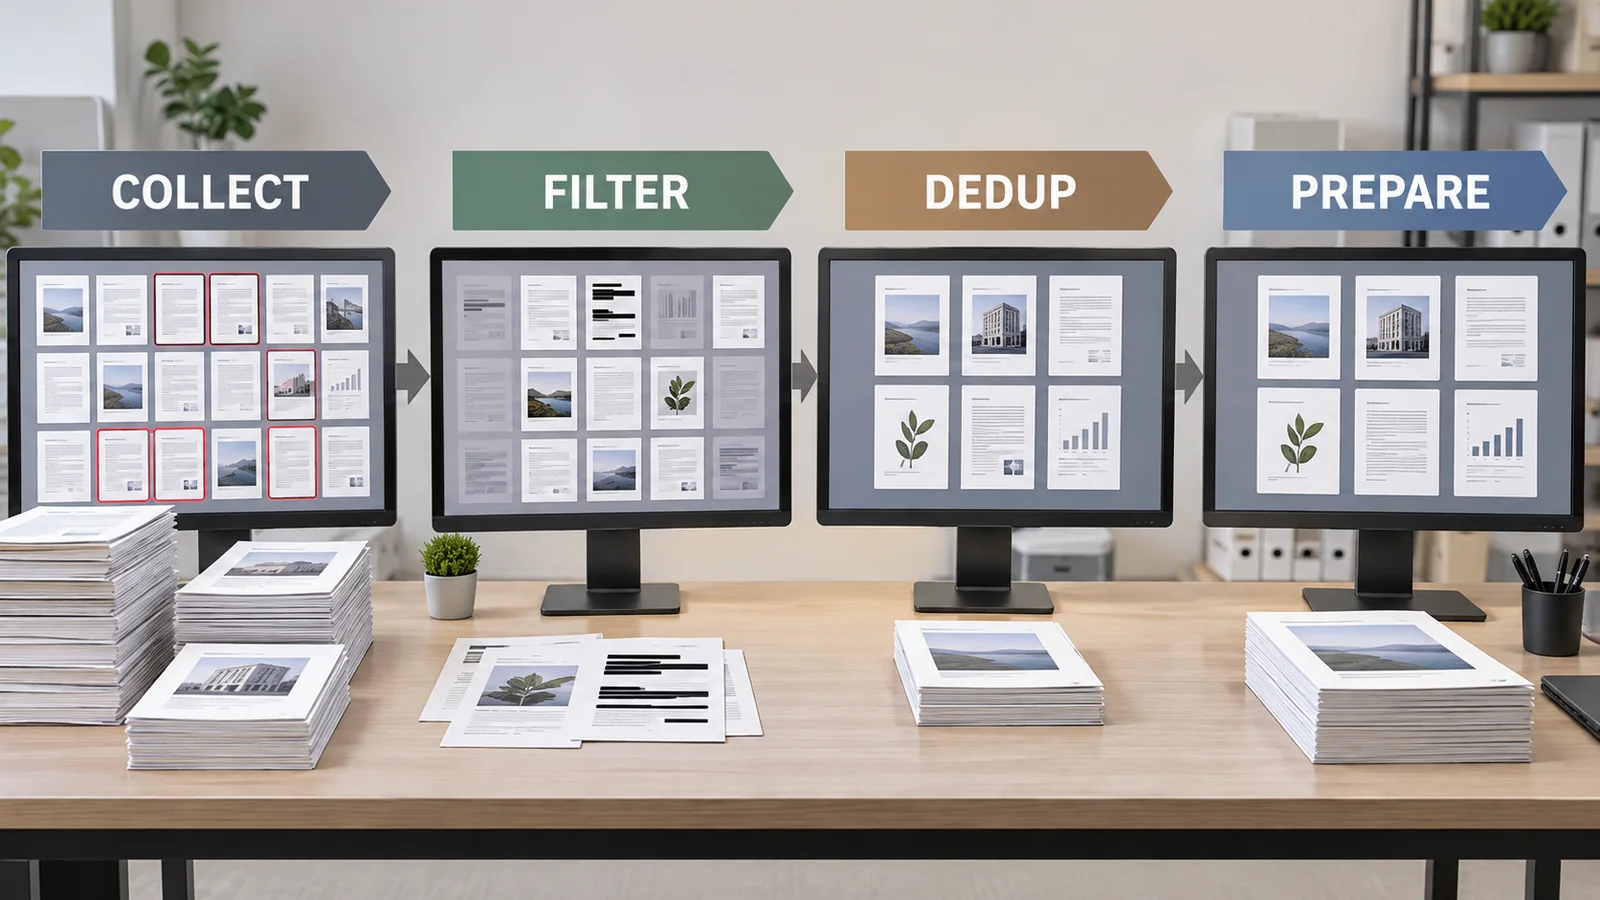
ウェブのデータは、そのままでは学習に使えません。Llama 3 の報告は、ウェブデータの処理を、危険な内容・個人情報(PII)の多いドメインの除外、本文の抽出と清掃、URL・文書・行の3段階の重複除去、ヒューリスティックによる選別、モデルによる品質の選別、コードと数学の専用抽出、176言語の判別を含む多言語処理、データの混合比の決定、という項目で説明しています事実[参考資料14]。
元のSVG模式図・数値・出典注記を見る
- 重複除去:URL 単位、MinHash による文書単位、行単位(30Mの文書の塊で6回を超えて出る行を除去)の順に行っています。報告は、行単位の重複除去が、ナビゲーションメニューなどの定型文だけでなく、頻出する良質な文章も除いてしまう一方で、実験では大きな改善があった、と述べています[参考資料14]
- 本文の抽出:数学やコードを含むページは構造を保って処理し、数式が画像で表されるページのために画像の代替テキストを残しています。マークダウンの記号は、ウェブデータ中心の学習では性能に悪いとして除いています[参考資料14]
- 混合比:知識の分類器と、小さなモデルで予測する「スケーリング則の実験」で決めています[参考資料14]
学習データの整備(重複の除去、ノイズの除去、混合比の調整)は、材料の世界でいえば、原料のロット管理、不純物の除去、配合の調整に近い作業です(本記事による解説)。同じ文章が何万回も入っていれば、モデルはその文章を覚えます(次章)。評価用の問題が学習データに混ざれば、評価は過大になります。これは、素材データの分割で、同じ系統の試料が訓練と評価にまたがる「データ漏れ」(本シリーズ「機械学習とニューラルネットワークの基礎」編)と同じ構造です。
また、材料・化学の文献をコーパスに含めるときは、数式、化学式、表、画像として埋め込まれた式をどう抽出するかが、そのまま品質の問題になります。Llama 3 は、数学の画像に付いた代替テキストを残す工夫をしています[参考資料14]。図表や数式の抽出の品質を、本稿は一次情報で確認していません。
3. データの質と記憶 ― 重複が何を引き起こすか
Lee らは、既存の言語モデリングのデータセットには、ほぼ同じ例や長い繰り返しが多く含まれ、その結果、これらで学習したモデルの、入力なしの出力の1%以上が、学習データからそのまま写されている、と報告しました。C4 からは、6万回以上繰り返されていた61語の英文が見つかっています。重複を除くと、記憶したテキストの出力が10分の1になり、同じかそれ以上の精度に必要な学習ステップが減りました。また、標準データセットの検証用の4%以上に、学習データとの重なりがあったことも示しています事実[参考資料9]。
Carlini らは、記憶の量が、モデルの容量、例が重複した回数、モデルに与える文脈のトークン数の3つで、大きく増えると報告しています事実[参考資料11]。つまり、モデルを大きくするほど、重複したデータの影響は強く出ます(本記事による解説)。
質のよいデータで、小さく強いモデルを作る試みもあります。Gunasekar らの phi-1 は、13億パラメータで、ウェブから選んだ「教科書の質」のデータ(60億トークン)と、GPT-3.5 で合成した教科書と演習(10億トークン)で、8枚の A100 により4日間で学習した、コード向けのモデルです。開発元は、HumanEval で pass@1 が50.6%、MBPP で55.5%と報告しています事実(開発元の公表値)[参考資料6]。Sorscher らは、データ削減の指標が良ければ、べき乗則よりも速く誤差が下がりうることを、理論と、画像分類(CIFAR-10、SVHN、ImageNet)での実験で示しました事実[参考資料7](言語モデルでの結果ではありません)。
これらは、データの量だけでなく質と選び方が性能を左右することを示す報告です。ただし、質の定義(何を「良い」とみなすか)と選別の方法は研究ごとに異なり、一般的な処方としては確立していません(本記事による解説)。
4. スケーリング則 ― Kaplan 型、Chinchilla 型、その後の検証
(1) Kaplan らの報告(2020年)
Kaplan らは、言語モデルの検証損失(クロスエントロピー)が、非埋め込みパラメータ数 N、データ量 D(トークン)、計算量 C のそれぞれに対して、べき乗則に従うと報告しました。ほかの条件で制限されない場合の指数は、N で約0.076、D で約0.095、最適に配分した計算量 C で約0.050です。傾向は7桁以上にわたる場合があり、モデルの形(深さと幅の比など)への依存は弱いとされています事実[参考資料12]。
指数 α のべき乗則では、規模を10倍にすると、損失は 10−α 倍になります。N では約0.84倍(16%減)、D では約0.80倍、C では約0.89倍です(本稿の計算)。損失の下がり方は、規模を増やすほど、対数で見て一定の割合で、決して急にはなりません。コストは10倍で、損失は1〜2割しか下がらない、とも読めます(本記事による解説)。 Kaplan らは、計算量が決まっているときは、非常に大きなモデルを、比較的少ないデータで、収束のかなり前で止めるのが、計算効率が最も良いと結論しました。計算量を10倍にするとき、モデルを約5.5倍にし、学習トークンは約1.8倍にすればよい、という配分です事実[参考資料12・13]。
(2) Hoffmann らの報告(Chinchilla、2022年)
Hoffmann らは、7,000万から160億超のパラメータ、50億から5,000億トークンの400以上のモデルを訓練し、計算最適の学習では、モデルの大きさと学習トークン数を等しく増やすべき(モデルを2倍にするなら、トークンも2倍)と報告しました。3つの異なる方法で、計算量 C に対する最適なパラメータ数 Nopt ∝ Ca、最適なトークン数 Dopt ∝ Cb の指数を見積もり、結果はほぼ等分でした事実[参考資料13]。
| 研究・方法 | Nopt ∝ Ca の a | Dopt ∝ Cb の b |
|---|---|---|
| Hoffmann ら 方法1(訓練曲線の下側包絡) | 0.50 | 0.50 |
| Hoffmann ら 方法2(IsoFLOP プロファイル) | 0.49 | 0.51 |
| Hoffmann ら 方法3(損失のパラメトリックなモデル) | 0.46 | 0.54 |
| Kaplan ら(2020) | 0.73 | 0.27 |
すべて事実(Hoffmann ら[参考資料13]の表2)。a と b の和は、計算量 C ≈ 6ND により、ほぼ1になります。
Hoffmann らは、検証として、Gopher(2800億パラメータ、3,000億トークン)と同じ計算量で、700億パラメータの Chinchilla を1.4兆トークンで学習しました。報告は、Chinchilla が下流の評価課題で Gopher などを上回ったと述べます[参考資料13]。また、当時の大きなモデルの多くは、約3,000億トークンで学習されていました(下の図と表)。
| モデル | パラメータ数 | 学習トークン数 | トークン/パラメータ | 出典 |
|---|---|---|---|---|
| GPT-3 | 175 B | 300 B | 1.7 | [10] |
| Gopher | 280 B | 300 B | 1.1 | [13] |
| Megatron-Turing NLG | 530 B | 270 B | 0.5 | [13] |
| Chinchilla | 70 B | 1.4 T | 20 | [13] |
| LLaMA 65B | 65.2 B | 1.4 T | 21.5 | [17] |
| Llama 2 70B | 70 B | 2 T | 28.6 | [19] |
| Llama 3 405B | 405 B | 15.6 T | 38.5 | [14] |
| Llama 3 8B | 8 B | 約15 T | 約1,900 | [14・15] |
| DeepSeek-V3(MoE) | 総 671 B/活性 37 B | 14.8 T | 総数基準 22/活性基準 400 | [18] |
本稿の計算(トークン÷パラメータ)。パラメータ数とトークン数は各資料の記載(事実)。Llama 3 8B のトークン数は、モデルカードの「約15兆」(Llama 3.1)。MoE は、総数と活性数のどちらで割るかで比が大きく変わります。「20トークン/パラメータ」は、Chinchilla の1点から求めた目安で、普遍の値ではありません。
Chinchilla の考え方を、計算量 C ≈ 6ND と D = 20N で組み合わせると、C = 120N² なので、N = √(C/120) です。Chinchilla が使った計算量 5.76×10²³ FLOP を入れると、N ≈ 6.9×10¹⁰(約690億)となり、実際の70Bとほぼ一致します(本稿の計算)。一方、Llama 3 の計算量 3.8×10²⁵ FLOP を入れると、N ≈ 5.6×10¹¹(約5,600億)、D ≈ 11.3兆トークンになり、実際の 405B・15.6T とは異なります。Meta の報告は、自社のデータでの別の当てはめにより、405B が計算量にほぼ最適としています[参考資料14]。簡便な比を、別のデータ・別の当てはめにそのまま使うと、最適点がずれることを示す例です(本記事による解説)。
(3) その後の検証と拡張
- Chinchilla の再現:Besiroglu らは、Hoffmann らの3つ目の方法を再現しようとして、報告された推定値が最初の2つの方法と整合せず、データへの当てはめも悪く、信頼区間が非現実的に狭いことを見つけました。原因は、最適化が収束前に止まったことと、本文の推定値の丸めだと分析し、再導出した値は最初の2つの方法と整合するとしています事実[参考資料23]
- Kaplan と Chinchilla の食い違い:Pearce と Song は、食い違いの多くが、Kaplan が埋め込みを除いてパラメータを数えたことと、小さな規模での分析によると説明し、Chinchilla の係数を支持しました。今後は、総パラメータと総計算量を使うことを勧めています事実[参考資料24]
- 推論も含めた最適化:Sardana らは、Chinchilla の式が推論の費用を含まないとして、推論の需要(約10億リクエスト規模)が大きいと見込む場合は、Chinchilla 最適より、小さいモデルを長く学習するのがよいと報告しました。1パラメータあたり最大1万トークンまで、モデルの品質が上がり続けたとも報告しています事実[参考資料25]
- データが限られるとき:Muennighoff らは、固定の計算量で、データが限られる場合、最大4エポックまでの繰り返しは、新しいデータと比べて損失の変化がごくわずかで、それ以上の繰り返しでは、計算を足す価値が最終的にゼロに近づく、と報告しました(最大9000億トークン、90億パラメータの400回の学習)事実[参考資料26]
- 言語以外の領域:Henighan らは、画像、動画、画像と言語、数学の問題解決でも、自己回帰 Transformer の損失が、べき乗則に定数を加えた形でなめらかに改善し、最適なモデルの大きさの計算量への依存の指数は、ほぼ共通だと報告しました事実[参考資料2]。Hestness らも、機械翻訳、言語モデリング、画像処理、音声認識の4領域で、汎化誤差が学習データの量に対してべき乗則に従うと報告しています[参考資料1]
① 損失(クロスエントロピー)の当てはめで、課題の正解率そのものではない。② 指数は研究・データ・パラメータの数え方で変わる(Kaplan 0.73、Chinchilla 0.50)。③ 当てはめた範囲の外への外挿は保証されない。④ 学習の最適点は、推論の費用、データの量、繰り返しの回数を入れると変わる。⑤ 「Chinchilla 最適」は、学習の計算量だけを最小にする条件で、運用全体の最適ではない。
5. 計算量とエネルギー ― FLOP から GPU 時間、電力量へ
Sevilla らは、機械学習の学習計算量が、2010年より前はムーアの法則と同じく約20か月で倍増していたのに対し、深層学習が始まった2010年代の初めからは、約6か月で倍増するようになり、2015年の末には、10〜100倍の計算量を要する大規模モデルが現れた、と整理しています事実[参考資料27](2022年の論文の整理で、その後の動向は本稿では確認していません)。
学習の計算量から電力量までは、次の連鎖で見積もれます。計算量 ≈ 6 × N × D(第4章)→ ÷ 実効の演算速度 → GPU 時間 → × 電力 × PUE → 電力量。実効の演算速度は、ピーク性能に MFU(model FLOPs utilization)を掛けたものです。MFU は、PaLM の報告が、観測したスループットを、ピーク FLOP で動くシステムの理論上の最大スループットで割った比として定義しました(再計算などの余計な演算は含めません)事実[参考資料22]。
| モデル | 計算量 | ハードウェアと時間 | 電力の定義 | 電力量・排出量 | 由来 |
|---|---|---|---|---|---|
| GPT-3 175B | 3.14×10²³ FLOP | V100 1万個、14.8日(約355万チップ時間) | システム平均 330 W/個、データセンターの PUE 1.10 | 1,287 MWh、552 tCO₂e | Patterson らの見積り[20] |
| BLOOM 176B | —(本稿では確認せず) | A100 80GB、118日、1,082,990 GPU 時間 | 論文の表に載る電力量(含む範囲の定義は本稿では確認せず) | 433,196 kWh。排出は動的電力のみで約24.7 t、機器製造まで含めて約50.5 tCO₂eq | Luccioni らの報告[21] |
| Llama 3.1 405B | 3.8×10²⁵ FLOP[14] | 最大1.6万個の H100、30.84M GPU 時間 | 700 W(TDP)。カードは、GPU のピーク電力容量に PUE を掛けた値と説明 | 排出(所在地基準)8,930 tCO₂eq、(市場基準)0。電力量は未掲載 | Meta のモデルカード[15] |
事実(各資料の記載)。GPT-3 は著者らが公表情報から見積もった値で、運用の実測ではありません。電力の定義が3行で違う(システム平均、全体の測定、TDP に基づく容量)ため、行どうしを直接比べないでください。市場基準の排出が0なのは、Meta が電力を再生可能エネルギーで100%相殺していると説明しているためです[15]。
本稿の検算(本稿の計算)
- GPT-3 の電力量:3.55M チップ時間 × 0.33 kW × PUE 1.10 ≈ 1,289 MWh。Patterson らの 1,287 MWh とほぼ一致
- Llama 3 405B の GPU 時間:6·N·D = 3.79×10²⁵ FLOP を、報告された段階ごとの実効演算速度 380〜430 TFLOP/s/GPU(BF16 MFU 38〜43%)[14]の中ほどの 400 TFLOP/s で割ると、約26.3M GPU 時間。モデルカードの30.84M GPU 時間はこの約1.17倍。差には、事前学習以外の工程、中断と再開などが含まれうると推測します
- ピーク性能の逆算:報告の表4で、430 TFLOP/s が MFU 43% なので、基準にしているピーク性能は約1,000 TFLOP/s(430 ÷ 0.43)です。この数字は表から逆算した値で、GPU の仕様書の値は確認していません
- 電力量の下限の目安:30.84M GPU 時間 × 0.7 kW = 約21.6 GWh(TDP × 時間。PUE と、GPU 以外のホスト・ネットワーク・冷却は含まない単純計算)。排出量 8,930 t を 21.6 GWh で割ると約0.41 kgCO₂eq/kWh ですが、モデルカードは電力に PUE を掛けたと説明しているので、この割り算は、電力の原単位の目安にとどまります
- 1枚あたりでなく、クラスタの規模:最大1.6万個 × 700 W ≈ 11.2 MW(GPU の TDP だけの合計)[14]。これだけの熱を除くための電力と冷却が、別に必要になります
- 世代による効率の違い:GPT-3(3.14×10²³ FLOP/1,287 MWh)と Llama 3 405B(3.8×10²⁵ FLOP/約21.6 GWh)を、1 kWh あたりの FLOP で比べると、約2.4×10¹⁷ と約1.8×10¹⁸ で、約7倍の開きです。ただし、世代、数値精度、利用率、電力の定義が違う2つの概算の比で、効率向上の正確な値ではありません
学習1回の電力の大半は、最終的に熱になります。最大1.6万個の GPU の TDP の合計だけで約11.2 MW で、その熱を取り去るために、液冷や空冷の設備、熱界面材料、放熱の部材が必要になります(本記事による解説)。計算量の増加が、HBM の積層、2.5D パッケージ、熱界面材料、電力設備の材料への要求を直接引き上げます。本シリーズ「AIデータセンターの電力と冷却」編、「熱界面材料TIM」編、「HBM」編で扱っています。
規模の感覚として、IEA は、世界のデータセンターの電力消費が2024年に約415 TWh(世界の電力消費の約1.5%)で、2017年から年約12%で増え、基準シナリオでは2030年に約945 TWh に達すると報告しています事実(IEA の見通しは未確定/将来)[参考資料31]。上の約21.6 GWh は、415 TWh の約0.005%(約1.9万分の1)にあたります(本稿の計算)。ただしこれは、1回の学習の、GPU のTDPだけを見た値で、実験の繰り返し、推論、GPU 以外の設備の電力を含みません。学習が電力の全体に占める割合を示すものではありません。
計算量の閾値と規制
EU の AI 規則(Regulation (EU) 2024/1689)の第51条2項は、汎用AIモデルの訓練に使った累積の計算量が 10²⁵ FLOP を超えるとき、高い影響力を持つと推定されると定めています。委員会は、アルゴリズムの改善やハードウェア効率の向上を踏まえ、委任法令でこの閾値を改めることができます(第51条3項)事実[参考資料32]。確認日に EUR-Lex で確認した統合版(2026年7月27日付)[参考資料42]にも、この記述があります。この統合版は、2026年7月8日の Regulation (EU) 2026/1744(AI に関するデジタル・オムニバス)[参考資料33]による改正を反映したものですが、第51条2項の閾値の文言は変わっていません。
公表された学習計算量を、この閾値と並べると、GPT-3(3.14×10²³)は閾値の約3%、Chinchilla(5.76×10²³)は約6%、Llama 3 405B(3.8×10²⁵)は約3.8倍です(本稿の計算)。条文は「訓練に使った累積の計算量」を基準にしており、これは推定の仕組みで、個々のモデルの法的な分類の判断ではありません。適用開始の時期、義務の中身、デジタル・オムニバスの詳細は、本シリーズ「EU AI法」編で扱います。
6. データの枯渇・同意・合成データ
(1) 公開されている人間の文章は、いつまで足りるか
Villalobos らは、公開された人間生成のテキストの量と、学習データの大きさの増加を比べて、現在の傾向が続けば、モデルが、利用できる公開テキストのほぼ全量に近いデータで学習されるのは2026年から2032年の間(中央値は2028年)で、オーバートレーニングが進めば少し早まる、と推計しました。インデックスされたウェブ全体は約510兆トークン(95%区間 130兆〜2,100兆)、Common Crawl は約130兆(同100兆〜260兆)、品質などを考慮した有効ストックはおよそ4×10¹⁴トークンです事実(推計)/未確定/将来[参考資料16]。
この推計は2024年版の論文のもので、確認日の時点では、傾向がその後どうなったかを、本稿は確認していません。有効ストックは、重複や質の選別、繰り返し学習(エポック数)の扱いに依存する推計です。Muennighoff らが示したように、4エポック程度までの繰り返しは新しいデータに近い価値を持つため、実質的な「使える量」は、見かけのトークン数の数倍になりうる、という解釈も成り立ちます(本記事による解説)。
(2) 同意と制限:ウェブの「共有地」が閉じつつある
Longpre らは、C4 などのコーパスの元になった1万4,000のウェブドメインの、利用規約と robots.txt を長期に監査しました。2023年から2024年の1年間で、AI の学習に対する制限が急に増え、C4 のトークンの5%超、特に活発に更新されている重要な情報源では28%超が、完全に制限されたと報告しています。利用規約による取得の制限まで含めると、C4 の45%が制限されています事実(当時の時点の値)[参考資料28]。著者らは、これらの制限が守られる、あるいは強制されるなら、汎用AIのデータの多様性、新しさ、スケーリングの性質が偏りうると述べています。著作権・ライセンスの法的な論点は、本シリーズ「著作権・来歴・ディープフェイク」編で扱います。
(3) 合成データと「モデル崩壊」
不足を補う方法の一つが、モデルが作ったデータ(合成データ)の利用です。phi-1 は、GPT-3.5 で合成した教科書と演習(10億トークン)を学習データに含みました[参考資料6]。Llama 3 のモデルカードは、微調整のデータに、2,500万件を超える合成データが含まれると記載し、報告は、事後学習の各ラウンドで、その時点の最新モデルから合成データを作ったと説明しています事実[参考資料14・15]。 一方、Shumailov らは、モデルが生成した内容を無差別に学習に使うと、元の分布の裾(まれな内容)が消えていく不可逆的な欠陥(モデル崩壊)が起こり、LLM でも変分オートエンコーダでも確認できると報告しました事実[参考資料29](Nature 2024年。2025年3月に訂正が出ています)。Gerstgrasser らは、各世代の合成データで元の実データを置き換えるとモデル崩壊に向かうが、実データに積み重ねていくと避けられる、と複数のモデルの大きさ・構造・ハイパーパラメータで示しました事実[参考資料30]。
つまり、合成データそのものが悪いのではなく、実データとの混ぜ方、質の管理、用途が問題になります(本記事による解説)。結論は、条件(置き換えか積み重ねか、質の選別の有無)によって変わるため、「合成データは使えない」「いくらでも使える」のどちらにも一般化できません。
材料では、ロット、原料の出所、工程条件の記録(トレーサビリティ)がないデータは、再現も比較もできません。学習データも同様に、どこから来たか、どの日付のものか、人が書いたものかモデルが作ったものか、利用が許されているか、の記録(来歴)が重要になります。Longpre らの監査は、来歴と同意の情報が、現在のウェブの仕組みでは十分に扱えていないことを示しています[参考資料28](本記事による解説)。
社内の材料データでモデルを作る場合も、測定条件、装置、日付、試料の系統を、データと一緒に記録しておくことが、後の評価(データの分け方、外挿、汚染の確認)の土台になります(本記事による解説)。
7. 限界と、確認できなかったこと/まとめ
(1) 新しいモデルの学習量
本稿が表にした学習データ量・計算量は、2025年までの主要な公式資料です。2026年に公開されたモデルの値は確認していません。多くの商用モデルは、学習データ、トークン数、計算量を公表しておらず、本稿は推計していません。
(2) 計算量と GPU 時間の対応
Llama 3 405B の 3.8×10²⁵ FLOP と30.84M GPU 時間が、同じ範囲の工程を指すかどうかは、資料から確認できませんでした。本稿の検算(約1.17倍の差)は、その不確かさを含みます。
(3) 推論側のエネルギー
本稿は学習の電力量を扱い、推論(運用)の電力量は扱っていません。データセンター全体の見通しは IEA の報告に頼り、2026年の更新は確認していません。
(4) 規制の詳細
EU の閾値は条文の記載のみを確認しました。適用開始時期、義務の中身、デジタル・オムニバスの全体の内容は、本稿では扱っていません。米国・中国・日本の制度は、本シリーズ「米国・中国・日本のAI政策」編で扱います。
(5) 規格の本文
ISO/IEC TR 20226、30134-2、5259、42001 の本文は有料のため確認していません。題名・発行年月・適用範囲の記載にとどめています。
- スケーリング則は、損失のべき乗則の当てはめです。Kaplan の指数は N 約0.076、D 約0.095、C 約0.050。規模を10倍にしても損失は1〜2割しか下がりません事実/本稿の計算
- 最適な配分は、研究と条件で変わります。Kaplan(N に0.73)と Chinchilla(等分、約0.5)の差は、パラメータの数え方と規模で説明され、推論の費用を入れると、小さいモデルを長く学習する方向に動きます事実
- データは質と重複が効きます。重複を除くと、記憶した出力が10分の1になり、必要な学習ステップが減りました事実
- 計算量はエネルギーと熱に直結します。Llama 3 405B は 3.8×10²⁵ FLOP、30.84M GPU 時間、TDP×時間で約21.6 GWh。電力の定義の違うデータは直接比べません事実/本稿の計算
- 公開データには限りがあるという推計があり(2026〜2032年に使い切る見通し。未確定/将来)、同意の制限が増え、合成データの混ぜ方が論点になっています事実
8. 評価・標準の読み方
学習データとスケーリング則の評価は、検証損失への当てはめの質、データの質(重複、汚染、記憶)の測定、データの来歴と同意の確認、そして計算量とエネルギーの報告に分かれます。どれも、定義(パラメータの数え方、電力の範囲)、範囲、日付によって数字が変わります。確認できた範囲を表にします(確認日 2026年10月15日)。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針・規制(ISO/IEC・NIST・EU など) | 読み方の注意 |
|---|---|---|---|
| スケーリング則の当てはめ | 検証損失(クロスエントロピー)へのべき乗則の当てはめ。Kaplan ら[12]、Hoffmann ら(3つの方法)[13]。再現・整合の検証:Besiroglu ら[23]、Pearce と Song[24]事実 | 確認できなかった | 指数は定義(埋め込みを数えるか)と規模で変わる。当てはめの範囲外は保証されない |
| データの品質・重複・記憶 | 重複除去の効果(Lee ら)[9]、記憶の測定(Carlini ら)[11]、フィルタの比較実験(FineWeb)[8]事実 | ISO/IEC 5259-1:2024(データ品質の概要・用語・例)[36]、ISO/IEC 5259-3:2024(データ品質マネジメントの要求事項と指針)[37]事実 | 「質」の定義は研究ごとに異なる。規格の本文は未確認で、要求事項は書いていない |
| ベンチマーク汚染 | 学習データと検証用データの重なりの測定(Lee ら:標準データセットの検証用の4%超に重なり)[9]。テストデータの暗号化などの対策の提案(Jacovi ら)[41]事実 | 確認できなかった | 外からは汚染の有無を確認しにくい |
| データの来歴・同意 | 1万4,000ドメインの利用規約・robots.txt の長期監査(Longpre ら)[28]事実 | 確認できなかった | 当時の時点の値で、その後も変わる。法的な論点は別の編で扱う |
| 学習の計算量・効率 | FLOP の見積り(6ND)[12]、MFU の定義(PaLM)[22]、報告された BF16 MFU 38〜43%(Llama 3 405B)[14]。MLPerf Training:品質目標に達するまでの時間[40]事実 | EU 規則 2024/1689 第51条2項:訓練の累積計算量が 10²⁵ FLOP 超で、高い影響力を持つと推定(統合版 2026年7月27日付でも維持)[32・42]事実 | FLOP の数え方(MoE、事後学習の計算を含むか)で値が変わる。閾値は推定の仕組みで、個別の分類ではない |
| エネルギー・環境 | 公表値:Meta のモデルカード(GPU 時間、700 W、所在地基準と市場基準の排出)[15]。見積り:Patterson ら[20]、Luccioni ら[21]。データセンター全体:IEA[31]事実 | ISO/IEC TR 20226:2025(AI システムの環境の持続可能性の側面と、関連しうる指標。2025年7月、技術報告)[34]。ISO/IEC 30134-2:2026(データセンター KPI のうち PUE。第2版、2026年1月)[35]。NIST AI 600-1:「環境への影響」を12のリスクの一つに定義[38]事実 | 電力の定義(TDP、システム平均、設備全体)、PUE の有無、排出の基準(所在地・市場)を確認する。TR は情報提供で、認証の対象ではない |
| リスク管理・運用 | — | ISO/IEC 42001:2023(AI のマネジメントシステム)[39]。NIST AI 600-1(生成AIプロファイル、2024年7月)[38]事実 | 多くは任意の採用。本文は未確認で、要求事項は書いていない |
表の整理は本稿の計算(整理)。ISO/IEC の番号・題名・発行年月は ISO の公式ページ、EU 規則は EUR-Lex、NIST は NIST の文書で確認(確認日 2026年10月15日)。規格の本文は有料のため、題名・適用範囲の記載にとどめています。
読み方の注意(素材技術者向け)
- スケーリング則の数字は、定義と範囲つきです:指数や「20トークン/パラメータ」のような目安を、別のデータ・別の規模・別の目的にそのまま使わないでください。損失の改善と、課題の性能の改善は別です
- エネルギーの数字は、電力の定義を確認します:TDP × 時間、システムの平均電力、設備全体(PUE 込み)で値が変わります。排出量は、所在地基準か市場基準かでも変わります。GPT-3 のような第三者の見積りは、公表値と区別します
- 標準・規制の「閾値」や「指針」は、役割が違います:EU 規則の 10²⁵ FLOP は法令上の推定の仕組み、ISO/IEC TR 20226 は情報提供の技術報告、PUE の規格は測定法の規格で、いずれも個々のモデルの優劣や安全を示す数字ではありません。多くの ISO/IEC 規格は任意の採用で、法令や契約で引用されて初めて拘束力を持つのが一般的です(本記事による解説)
- 予測と実績は別です:データ枯渇や電力の見通しは未確定/将来の推計で、前提が変われば結果も変わります
9. 用語集
- スケーリング則
- モデルの大きさ・データ量・計算量と損失の関係を表す、経験的なべき乗則。
- べき乗則
- 損失がスケールの冪(L ∝ x−α)で下がる関係。対数グラフで直線になる。
- 計算最適(Chinchilla 最適)
- 決まった計算量で損失を最小にする、モデルの大きさとトークン数の配分。
- FLOP/FLOP/s
- 浮動小数点演算の回数/1秒あたりの回数。学習の計算量は ≈ 6 × N × D。
- MFU
- モデルFLOPs利用率。観測したスループットを、ピーク性能での理論上の最大で割った比。
- TDP/PUE
- 設計上の熱出力の目安(W)/設備全体の電力を IT 機器の電力で割った効率指標。
- トークン/パラメータ比
- 学習トークン数をパラメータ数で割った値。Chinchilla は約20。
- 重複除去
- 同じ、またはほぼ同じ文書・行を取り除く処理。MinHash などを使う。
- 記憶(memorization)
- 学習データの文章を、そのまま出力できる状態になること。
- オーバートレーニング
- 計算最適より多くのトークンで学習すること。小さいモデルを推論向けに強くするのに使う。
- エポック
- 同じデータを何周学習したか。繰り返しの回数。
- モデル崩壊
- モデルが生成したデータで学習を繰り返すと、元の分布の裾が失われる現象。
- 合成データ
- 人ではなくモデルが生成した学習データ。
- robots.txt
- ウェブサイトが、クローラーに取得してよい範囲を示すファイル。
- 統合版(EUR-Lex)
- 法令と、その改正をまとめた、法的効力のない参照用の版。
10. 参考資料(一次情報)
- Hestness J. ほか(Baidu Research) "Deep Learning Scaling is Predictable, Empirically", arXiv:1712.00409 — arxiv.org/abs/1712.00409
- Henighan T. ほか "Scaling Laws for Autoregressive Generative Modeling", arXiv:2010.14701 — arxiv.org/abs/2010.14701
- Raffel C. ほか "Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer"(C4), arXiv:1910.10683 — arxiv.org/abs/1910.10683
- Gao L. ほか "The Pile: An 800GB Dataset of Diverse Text for Language Modeling", arXiv:2101.00027 — arxiv.org/abs/2101.00027
- Soldaini L. ほか "Dolma: an Open Corpus of Three Trillion Tokens for Language Model Pretraining Research", arXiv:2402.00159 — arxiv.org/abs/2402.00159
- Gunasekar S. ほか "Textbooks Are All You Need", arXiv:2306.11644 — arxiv.org/abs/2306.11644
- Sorscher B. ほか "Beyond neural scaling laws: beating power law scaling via data pruning", arXiv:2206.14486 — arxiv.org/abs/2206.14486
- Penedo G. ほか "The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale", arXiv:2406.17557 — arxiv.org/abs/2406.17557
- Lee K. ほか "Deduplicating Training Data Makes Language Models Better", arXiv:2107.06499 — arxiv.org/abs/2107.06499
- Brown T. B. ほか "Language Models are Few-Shot Learners", arXiv:2005.14165 — arxiv.org/abs/2005.14165
- Carlini N. ほか "Quantifying Memorization Across Neural Language Models", arXiv:2202.07646 — arxiv.org/abs/2202.07646
- Kaplan J. ほか "Scaling Laws for Neural Language Models", arXiv:2001.08361 — arxiv.org/abs/2001.08361
- Hoffmann J. ほか "Training Compute-Optimal Large Language Models", arXiv:2203.15556 — arxiv.org/abs/2203.15556
- Grattafiori A. ほか(Llama Team, Meta) "The Llama 3 Herd of Models", arXiv:2407.21783 — arxiv.org/abs/2407.21783
- Meta "Llama 3.1 Model Card"(GitHub: meta-llama/llama-models) — github.com/meta-llama/llama-models/…/MODEL_CARD.md
- Villalobos P. ほか(Epoch AI ほか) "Will we run out of data? Limits of LLM scaling based on human-generated data", arXiv:2211.04325 — arxiv.org/abs/2211.04325
- Touvron H. ほか "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971 — arxiv.org/abs/2302.13971
- DeepSeek-AI "DeepSeek-V3 Technical Report", arXiv:2412.19437 — arxiv.org/abs/2412.19437
- Touvron H. ほか "Llama 2: Open Foundation and Fine-Tuned Chat Models", arXiv:2307.09288 — arxiv.org/abs/2307.09288
- Patterson D. ほか "Carbon Emissions and Large Neural Network Training", arXiv:2104.10350 — arxiv.org/abs/2104.10350
- Luccioni A. S., Viguier S., Ligozat A.-L. "Estimating the Carbon Footprint of BLOOM, a 176B Parameter Language Model", arXiv:2211.02001 — arxiv.org/abs/2211.02001
- Chowdhery A. ほか "PaLM: Scaling Language Modeling with Pathways", arXiv:2204.02311 — arxiv.org/abs/2204.02311
- Besiroglu T. ほか "Chinchilla Scaling: A replication attempt", arXiv:2404.10102 — arxiv.org/abs/2404.10102
- Pearce T., Song J. "Reconciling Kaplan and Chinchilla Scaling Laws", arXiv:2406.12907(TMLR 2024) — arxiv.org/abs/2406.12907
- Sardana N. ほか "Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws", arXiv:2401.00448 — arxiv.org/abs/2401.00448
- Muennighoff N. ほか "Scaling Data-Constrained Language Models", arXiv:2305.16264 — arxiv.org/abs/2305.16264
- Sevilla J. ほか "Compute Trends Across Three Eras of Machine Learning", arXiv:2202.05924(IJCNN 2022) — arxiv.org/abs/2202.05924
- Longpre S. ほか "Consent in Crisis: The Rapid Decline of the AI Data Commons", arXiv:2407.14933 — arxiv.org/abs/2407.14933
- Shumailov I. ほか "AI models collapse when trained on recursively generated data", Nature 631, 755–759 (2024), DOI 10.1038/s41586-024-07566-y(オープンアクセス) — nature.com/articles/s41586-024-07566-y
- Gerstgrasser M. ほか "Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data", arXiv:2404.01413 — arxiv.org/abs/2404.01413
- IEA "Energy and AI"(2025年4月10日公開) — iea.org/reports/energy-and-ai
- 欧州議会・理事会 Regulation (EU) 2024/1689(AI 規則)、2024年6月13日、OJ L 2024/1689(EUR-Lex、原文版) — eur-lex.europa.eu/eli/reg/2024/1689/oj/eng
- 欧州議会・理事会 Regulation (EU) 2026/1744、2026年7月8日(AI に関するデジタル・オムニバス。Regulation (EU) 2024/1689 等を改正。OJ 2026年7月24日) — eur-lex.europa.eu/eli/reg/2026/1744/oj/eng
- ISO/IEC "ISO/IEC TR 20226:2025 Information technology — Artificial intelligence — Environmental sustainability aspects of AI systems"(ISO のページ) — iso.org/standard/86177.html
- ISO/IEC "ISO/IEC 30134-2:2026 Information technology — Data centres key performance indicators — Part 2: Power usage effectiveness (PUE)"(ISO のページ) — iso.org/standard/85172.html
- ISO/IEC "ISO/IEC 5259-1:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 1: Overview, terminology, and examples"(ISO のページ) — iso.org/standard/81088.html
- ISO/IEC "ISO/IEC 5259-3:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 3: Data quality management requirements and guidelines"(ISO のページ) — iso.org/standard/81092.html
- NIST "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1, 2024年7月, DOI 10.6028/NIST.AI.600-1 — doi.org/10.6028/NIST.AI.600-1
- ISO/IEC "ISO/IEC 42001:2023 AI management systems"(ISO のページ) — iso.org/standard/81230.html
- MLCommons "MLPerf Training"(確認日に表示の最新版 v6.0) — mlcommons.org/benchmarks/training/
- Jacovi A. ほか "Stop Uploading Test Data in Plain Text: Practical Strategies for Mitigating Data Contamination by Evaluation Benchmarks", arXiv:2305.10160 — arxiv.org/abs/2305.10160
- 欧州議会・理事会 Regulation (EU) 2024/1689 の統合版(2026年7月27日付。EUR-Lex、法的効力のない参照用) — eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:02024R1689-20260727
11. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 4領域(機械翻訳・言語モデリング・画像・音声)で汎化誤差がデータ量に対しべき乗則に従うこと。画像・動画・画像と言語・数学でも自己回帰 Transformer の損失がべき乗則に定数を加えた形で改善し、最適サイズの計算量への指数がほぼ共通なこと | Hestness ら、Henighan ら 出典1 https://arxiv.org/abs/1712.00409 出典2 https://arxiv.org/abs/2010.14701 | 事実 |
| C4(数百GBの英語テキスト)、The Pile(825 GiB、22の部分集合)、Dolma(3兆トークン、約200 TB→約11 TB、6つの情報源、LLaMA のトークナイザで計数)、FineWeb(96スナップショット、15兆トークン、50以上の候補フィルタ、FineWeb-Edu 1.3兆) | 各原論文 出典3 https://arxiv.org/abs/1910.10683 出典4 https://arxiv.org/abs/2101.00027 出典5 https://arxiv.org/abs/2402.00159 出典8 https://arxiv.org/abs/2406.17557 | 事実 |
| phi-1(13億パラメータ、教科書の質のデータ60億トークン+合成10億トークン、8枚の A100 で4日、HumanEval 50.6%・MBPP 55.5%)。データ削減でべき乗則を超える可能性(理論と ResNet の実験) | Gunasekar ら、Sorscher ら 出典6 https://arxiv.org/abs/2306.11644 出典7 https://arxiv.org/abs/2206.14486 | 事実 |
| 重複の多さ(出力の1%超が学習データのそのままの写し、61語の英文が6万回超)、重複除去で記憶した出力が10分の1、検証用の4%超に重なり。記憶が容量・重複回数・文脈長で増えること | Lee ら、Carlini ら 出典9 https://arxiv.org/abs/2107.06499 出典11 https://arxiv.org/abs/2202.07646 | 事実 |
| GPT-3:175B、300Bトークン、3.14×10²³ FLOP(Patterson ら表と一致) | Brown ら 出典10 https://arxiv.org/abs/2005.14165 | 事実 |
| 損失のべき乗則の指数(N 約0.076、D 約0.095、C 約0.050)、7桁以上の傾向、形への弱い依存、C ≈ 6N/トークン、C ≈ 6NBS、計算最適では大きなモデルを少ないデータで収束前に止めること | Kaplan ら(2020) 出典12 https://arxiv.org/abs/2001.08361 | 事実 |
| Chinchilla:400超のモデル、モデルとトークンを等しく増やす、3つの方法の指数(0.50/0.50、0.49/0.51、0.46/0.54)、Kaplan の0.73/0.27、10倍の計算量でモデル5.5倍・トークン1.8倍(Kaplan の含意)、Gopher 280B・300B、Chinchilla 70B・1.4T、Gopher の計算量 5.76×10²³、表1のモデルの規模 | Hoffmann ら(2022) 出典13 https://arxiv.org/abs/2203.15556 | 事実 |
| Llama 3:約15T(旗艦15.6T)トークン、Llama 2 は1.8T、3.8×10²⁵ FLOP、405B はほぼ計算最適、最大16K の H100(700 W TDP)、BF16 MFU 38〜43%(表4:430/400/380 TFLOP/s)、データの混合比(一般知識50%・数学推論25%・コード17%・多言語8%)、知識の期限(2023年末)、データ処理の項目(PII・安全フィルタ、抽出、URL・文書・行の重複除去、ヒューリスティック、品質分類器、コード・数学、176言語)、事後学習の合成データ | Llama Team(2024) 出典14 https://arxiv.org/abs/2407.21783 | 事実 |
| Llama 3.1 のモデルカード:約15兆トークン、GPU 時間(8B 1.46M、70B 7.0M、405B 30.84M、計39.3M)、700 W、排出(405B:所在地基準8,930 tCO₂eq、市場基準0)、電力は GPU のピーク容量に PUE を掛けた値、2,500万件超の合成データ | Meta のモデルカード 出典15 https://github.com/meta-llama/llama-models/blob/main/models/llama3_1/MODEL_CARD.md | 事実 |
| 公開人間生成テキストの推計(インデックス済みウェブ約510兆、Common Crawl 約130兆、有効ストック約4×10¹⁴)、2026〜2032年(中央値2028年)に利用が完全に近づくという見通し | Villalobos ら(推計) 出典16 https://arxiv.org/abs/2211.04325 | 未確定/将来 |
| LLaMA 65B:65.2B・1.4T。Llama 2:2兆トークン。DeepSeek-V3:14.8Tトークン | 各報告 出典17 https://arxiv.org/abs/2302.13971 出典19 https://arxiv.org/abs/2307.09288 出典18 https://arxiv.org/abs/2412.19437 | 事実 |
| GPT-3 の見積り(V100 1万個、14.8日、1,287 MWh、552 tCO₂e、330 W、PUE 1.10) | Patterson ら(著者らの見積り) 出典20 https://arxiv.org/abs/2104.10350 | 事実 |
| BLOOM:1,082,990 GPU 時間、433,196 kWh、118日、A100 80GB、排出約24.7 t(動的電力のみ)/約50.5 t(全工程) | Luccioni ら 出典21 https://arxiv.org/abs/2211.02001 | 事実 |
| MFU の定義(観測スループット÷理論上の最大スループット) | Chowdhery ら(PaLM) 出典22 https://arxiv.org/abs/2204.02311 | 事実 |
| Chinchilla の3つ目の方法の再現(推定値の不整合、収束前の停止と丸めの影響)、Kaplan と Chinchilla の食い違いの原因(埋め込みの除外と小規模) | Besiroglu ら、Pearce と Song 出典23 https://arxiv.org/abs/2404.10102 出典24 https://arxiv.org/abs/2406.12907 | 事実 |
| 推論の需要(約10億リクエスト)を見込むと Chinchilla 最適より小さく長く学習、1パラメータあたり最大1万トークンまで改善。データが限られるとき4エポックまでの繰り返しは新データとほぼ同等 | Sardana ら、Muennighoff ら 出典25 https://arxiv.org/abs/2401.00448 出典26 https://arxiv.org/abs/2305.16264 | 事実 |
| 学習計算量の倍増時間(2010年前は約20か月、以後約6か月)、2015年末の大規模モデル | Sevilla ら(2022年の整理) 出典27 https://arxiv.org/abs/2202.05924 | 事実 |
| 利用規約・robots.txt の監査(1万4,000ドメイン、C4 の5%超・重要な情報源の28%超が完全制限、利用規約まで含めて45%) | Longpre ら 出典28 https://arxiv.org/abs/2407.14933 | 事実 |
| モデルが生成した内容の無差別な使用で、元の分布の裾が消えるモデル崩壊(2025年3月に訂正)。実データへの積み重ねでは崩壊を避けられること | Shumailov ら、Gerstgrasser ら 出典29 https://www.nature.com/articles/s41586-024-07566-y 出典30 https://arxiv.org/abs/2404.01413 | 事実 |
| IEA:データセンターの電力消費が2024年に約415 TWh(世界の約1.5%)、2017年から年約12%で増加、基準シナリオで2030年に約945 TWh(見通し) | IEA「Energy and AI」(2025年4月10日) 出典31 https://www.iea.org/reports/energy-and-ai | 事実 |
| EU 規則 2024/1689 第51条2項(累積計算量が 10²⁵ FLOP 超で高い影響力を推定)、第51条3項(委任法令で閾値を改正可)。統合版(2026年7月27日付)にも同文。Regulation (EU) 2026/1744(2026年7月8日、AI に関するデジタル・オムニバス)が改正していること | EUR-Lex 出典32 https://eur-lex.europa.eu/eli/reg/2024/1689/oj/eng 出典33 https://eur-lex.europa.eu/eli/reg/2026/1744/oj/eng 出典42 https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:02024R1689-20260727 | 事実 |
| ISO/IEC TR 20226:2025(2025年7月、環境の持続可能性の側面と関連しうる指標)、ISO/IEC 30134-2:2026(2026年1月、第2版、PUE)、5259-1/5259-3:2024、42001:2023 の番号・題名・発行年月 | ISO のページ 出典34 https://www.iso.org/standard/86177.html 出典35 https://www.iso.org/standard/85172.html 出典36 https://www.iso.org/standard/81088.html 出典37 https://www.iso.org/standard/81092.html 出典39 https://www.iso.org/standard/81230.html | 事実 |
| NIST AI 600-1:12のリスク、「環境への影響」の定義(学習・運用での高い計算資源の利用による影響) | NIST AI 600-1 の本文 出典38 https://doi.org/10.6028/NIST.AI.600-1 | 事実 |
| MLPerf Training(品質目標までの学習時間、確認日の最新版 v6.0)。テストデータの暗号化などの汚染対策の提案 | MLCommons、Jacovi ら 出典40 https://mlcommons.org/benchmarks/training/ 出典41 https://arxiv.org/abs/2305.10160 | 事実 |
| 規模10倍での損失の倍率(0.84・0.80・0.89)、トークン/パラメータ比の表、D=20N と C=120N² による N の見積り(約690億、約5,600億)、GPT-3 の電力量の検算(約1,289 MWh)、Llama 3 405B の GPU 時間の逆算(約26.3M)・約21.6 GWh・約11.2 MW・1 kWh あたり FLOP の比(約7倍)・IEA の約1.9万分の1、EU 閾値との比(約3%、約6%、約3.8倍) | 本稿の計算(各資料の公表値を使った概算。TDP×時間は PUE 未補正。電力の定義が違う値は直接比べていない)。実測ではない | 本稿の計算 |
| 2026年のモデルの学習量・計算量、非公表のモデルの学習データ・計算量、Llama 3 405B の FLOP と GPU 時間の対応の範囲、推論側の電力量、デジタル・オムニバスの全体の内容、規格の本文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「学習データの整備は材料のロット管理・不純物管理に似る」「FLOP の数字は熱と設備の数字になる」「データの来歴は材料のトレーサビリティに相当」「スケーリング則は予測の道具で保証ではない」という読み取りと、素材・研究への含意 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2〜図5・図7が実データの観察ではなく説明のための作図であること。図1と図6がAI生成イメージの枠であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(arXiv の原論文、Nature 論文、Meta のモデルカード、IEA の報告、EUR-Lex、ISO・NIST の公式ページ)に限定しています。ISO/IEC 規格の本文は有料のため確認できていません。 モデルの規模・計算量・エネルギーは確認日時点の公表資料の記載で、第三者の見積りと公表値を区別しています。 2026年のモデルの学習量、非公表モデルの学習データ・計算量、Llama 3 405B の FLOP と GPU 時間の対応の範囲、推論側の電力量、デジタル・オムニバスの全体の内容、ISO/IEC 規格の本文については、確認できなかったため記載していません。 図は説明用の概念図または本稿の計算を含む作図で、図1と図6はAI生成イメージの枠(画像は未設置)です。いずれも実在の施設・データの実測を示すものではありません。