TECHNOLOGY EXPLAINER
コーディングエージェントとコンピュータ操作
― コード生成から自律的な開発・画面操作まで、できることと、測り方の落とし穴
AIがコードを書く、テストを走らせて直す、ブラウザや画面を見ながらマウスとキーボードを操作する。「任せられる範囲」は急速に広がっていますが、その評価は難しく、ベンチマークの値は、問題の質・テストの弱さ・学習データへの混入で大きく動きます。 この記事では、コード生成から自律的なソフトウェア開発への段階、SWE-bench などの評価と限界、画面を見て操作するエージェントの仕組みと課題、そして権限とサンドボックスの考え方を、一次情報の範囲で整理します。
- コーディングエージェントと画面操作とは何か(3行でつかむ)
- コード生成から自律的な開発まで
- コーディングエージェントの仕組み
- 評価と限界 ― SWE-bench を中心に
- ブラウザ・画面を操作するエージェント
- 権限とサンドボックス
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定・策定中であり、実績や確定が確認できていない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
この分野は変化が非常に速く、ベンチマーク自体が数か月で作り直されます。本記事の日付・数値は2026年10月15日に公開資料で確認した範囲で、ベンチマークの数値はその論文や報告の時点のモデル・設定での値です。現在のモデルの性能ではなく、異なる設定・実施主体の数値を並べて優劣は論じません。 開発元が自社の製品について述べた数値は「開発元の記述」として扱い、特定の製品や企業の優劣は論じません。悪用の具体的な手順は書きません。
1. コーディングエージェントと画面操作とは何か(3行でつかむ)
- コーディングエージェントは「コードを読む→編集→テストを実行→結果を見る」をループで回す:1つの関数を書くコード補完から、複数ファイルにまたがる課題をテストが通るまで直すところまで、作業の単位が広がってきました。評価は、関数単位のベンチマークから、実際のリポジトリの課題、端末での長い作業へ移っています事実[参考資料1・8・16]
- 画面操作エージェントは「スクリーンショットを見て、座標をクリックし、また画面を見る」ループ:APIのないアプリも操作できる反面、遅く、座標を誤り、画面の中の指示に従ってしまう危険があります。2025年1月の報告で OSWorld 38.1%(人間72.4%)だったものが、2026年の OSWorld 2.0 では、長い作業で最良でも約2割の完了にとどまっています事実[参考資料27・21]
- ベンチマークの値は、問題とテストの質で大きく動く:SWE-bench は、解答の漏洩と弱いテストが見つかり、OpenAI は2026年2月に Verified の報告をやめました。権限は最小限にし、サンドボックスの中で動かし、取り消せない操作は人が確認します事実[参考資料11・10・30]
「AIが書いたコードがテストに通った」ことと、「正しい」ことは違い、「体感で速くなった」ことと「実際に速くなった」ことも違います。 METR の対照実験では、経験豊富な開発者が、AIを使う前は作業時間が24%短縮すると予想し、使った後も20%短縮したと見積もりましたが、実測では、AIを許可した課題は19%長くかかりました(2025年前半のツールと条件での結果)事実[参考資料5]。
2. コード生成から自律的な開発まで
「AIがコードを書く」は、作業の単位で段階に分けると整理できます(本記事の整理)。段階が上がるほど、人が確認すべき範囲と、失敗の影響が広がります。
(1) 関数の補完:HumanEval と pass@k
Codex(Chen ら、2021年)は、GitHub の公開コードで微調整した GPT 系のモデルで、製品版は GitHub Copilot を支えるとされます。関数の説明文から機能的な正しさを測る HumanEval で、Codex は問題の28.8%を解き(GPT-3は0%、GPT-J は11.4%)、問題ごとに100個を生成して試す「繰り返しサンプリング」では70.2%を解いたと報告しています。長い連鎖の操作を説明した文や、操作と変数の結びつけに弱いことも挙げています事実[参考資料1]。 MBPP(Austin ら)は、初級のプログラマーが解ける974のプログラミング課題で、最大のモデルが少数例の提示だけで59.6%を解き、人の自然言語のフィードバックで誤りが半減した、と報告しています[参考資料2]。 AlphaCode は、競技プログラミングの Codeforces の模擬評価で、参加者5,000人超の大会で平均して上位54.3%に入り、大規模なサンプリングと、プログラムの動作によるフィルタリングが鍵だったと述べています[参考資料3]事実。
本稿の計算 Codex の HumanEval での pass@1 は28.8%です。もしすべての問題で1回の成功率が0.288で、試行が独立なら、100回のうち1回でも成功する確率は 1−(1−0.288)100=1−0.712100(約 1.8×10⁻¹⁵ を引く)で、ほぼ100%になります。しかし論文の100個サンプリングでの解決率は70.2%でした。
この差は、問題ごとに成功率が大きく違う(簡単な問題は毎回解け、難しい問題は何回やっても解けない)ことを示します。平均の成功率 p を全問題に当てはめる計算は成り立ちません。前提と限界:独立と同一の成功率という仮定の帰結を示す単純な計算で、Codex の問題別の成功率の分布は論文以上には確認していません。
(2) 対話での生成・修正:生産性の実験
Peng らの対照実験では、JavaScript で HTTP サーバーを実装する課題を、AIペアプログラマー(GitHub Copilot)を使うグループが、使わないグループより55.8%速く完了したと報告しています事実[参考資料4]。ただし、これは単純で定義の明確な課題での実験で、第4章で扱う別の実験は、異なる結果を示しました。
(3) リポジトリ単位の課題解決:SWE-bench と、エージェント向けの設計
SWE-bench(Jimenez ら、2023年)は、12の有名な Python リポジトリの実際の GitHub の課題(issue)と、それを直したプルリクエストから作った2,294問です。コードベースと課題の説明を与え、コードを編集して課題を解決させます。複数の関数・クラス・ファイルにまたがる変更の理解と調整が必要で、論文時点で最良のモデルの Claude 2 が解けたのは1.96%でした事実[参考資料8]。
SWE-agent(Yang ら)は、エージェント向けに設計したエージェント・コンピュータ・インターフェース(ACI)が、ファイルの作成・編集、リポジトリの探索、テストの実行の能力を大きく高めると論じ、SWE-bench と HumanEvalFix で pass@1 が12.5%、87.7%だったと報告しています(当時の最先端)[参考資料17]。 一方、Agentless(Xia ら)は、LLM に次の行動を決めさせず、「位置の特定、修正、パッチの検証」の3段階だけの単純な方法で、SWE-bench Lite で32.00%(96件)という、当時のオープンソースのエージェントの中で最高の性能を、0.70ドルの費用で達成したと報告し、複雑な自律エージェントが本当に必要かを問いました[参考資料18]。OpenHands は、人間の開発者のように、コードを書き、コマンドラインを操作し、ウェブを閲覧するエージェントを開発するための、MIT ライセンスのオープンなプラットフォームです[参考資料19]事実。
3. コーディングエージェントの仕組み
コーディングエージェントの基本は、「AIエージェントの仕組み」編で扱ったLLM+ツール+ループです。ツールの中身が、ファイルの読み書き、検索、コマンドの実行(テストを含む)になります。
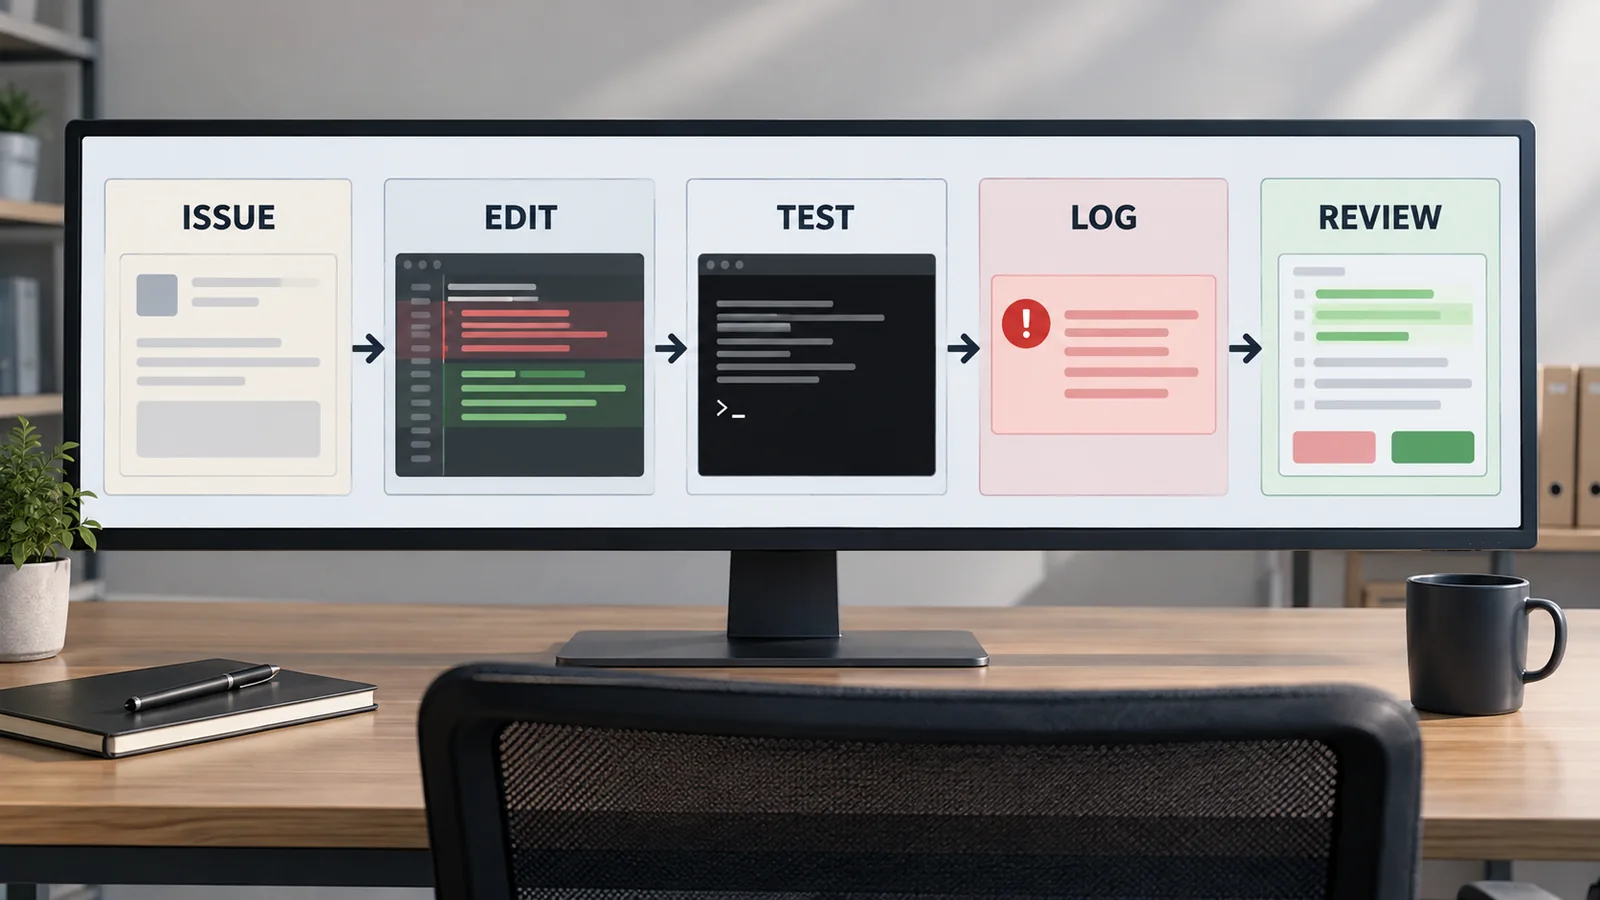
元のSVG模式図・数値・出典注記を見る
- ループ:コードを読む・検索する → 編集する → テストやコマンドを実行する → 結果(失敗ログ)を見る、をテストが通るまで、または最大回数まで繰り返します(概念図)。SWE-agent の論文は、このとき道具(ACI)の設計が性能を左右すると述べています[参考資料17]
- 権限:Claude Code のドキュメントによれば、手動モードでは読み取り専用から始まり、ファイルの編集やコマンドの実行の前に、一度だけ許可するか、以後許可するかを尋ねます。同じドキュメントは、作業ディレクトリの境界は「許可の確認」であって、承認した Bash のコマンドは、ユーザーのアカウントが書けるところには書ける、とも注意しています事実[参考資料31]
- サンドボックス:Anthropic は、確認を毎回求めると「承認疲れ」で、人が内容をよく見なくなる問題があると述べ、ファイルとネットワークの境界を決めたサンドボックスの内側では自由に動かし、外側にアクセスしようとしたら通知する方式を紹介しています(同社の内部での利用で、許可の確認が84%減ったと記述)事実[参考資料30]。第6章で詳しく扱います
- 端末での長い作業:Terminal-Bench(Merrill ら、2026年)は、実際のワークフローに着想を得た、コンピュータの端末環境での89の難しい課題(Terminal-Bench 2.0)で、各課題に固有の環境、人が書いた解答、検証用の網羅的なテストがあります。論文は、最先端のモデルとエージェントの得点が65%未満だったと報告しています事実[参考資料16]
4. 評価と限界 ― SWE-bench を中心に
(1) SWE-bench の歩みと、その欠陥の指摘
SWE-bench は、評価の「標準」になる一方で、質の問題が次々に指摘されてきました。時系列で整理します事実。
| 時期(出典) | 何が起きたか(資料の記述) | 読み取り |
|---|---|---|
| 2023年10月 SWE-bench [参考資料8] | 2,294問。論文時点の最良は Claude 2 の1.96% | 当初は「ほとんど解けない」課題集 |
| 2024年8月13日 SWE-bench Verified(OpenAI)[参考資料9] | 93人の Python 経験者が1,699件の標本を人手で選別。課題の説明が不十分な標本(38.3%が指摘)や、有効な解答を誤って落とすテスト(61.1%が指摘)などで、68.3%が除外された(過剰に除外している可能性が高いと断り書き)。残した500件が Verified。GPT-4o は最良の足場で33.2%、元の SWE-bench の16%の2倍以上。OpenAI は、元のデータセットが能力を過小評価していたと記述 | 問題の質を直すと、値は上がった |
| 2024年10月 SWE-Bench+(Aleithan ら)[参考資料11] | 当時の最上位の SWE-Agent+GPT-4 が解いた課題を人手で調べ、成功したパッチの32.67%で解答が課題の記述やコメントに書かれていた(解答の漏洩)、31.08%はテストが弱い疑いがあると報告。これらを除くと解決率は12.47%から3.97%に低下。Lite と Verified にも同じ問題があり、課題の94%超が LLM の知識の期限より前に作られていた | 問題の質を直すと、値が下がった(解答が漏れていた分) |
| 2025年6月 UTBoost(Yu ら、ACL 2025)[参考資料12] | テストを自動で補強し、元の SWE-bench で、テストが不十分な36件の課題と、通過と誤判定された345件の誤ったパッチを特定。Lite の40.9%、Verified の24.4%のリーダーボードの項目に影響し、順位がそれぞれ18件、11件入れ替わった | テストの弱さが順位まで変える |
| 2025年9月 SWE-Bench Pro(Deng ら)[参考資料13] | 1,865問、41の維持されているリポジトリ(公開11、非公開の保持12、商用18)。数時間から数日かかる長い課題を含み、人が検証。汚染への耐性を謳う | より難しく、汚染されにくくする試み |
| 2026年2月23日 OpenAI の報告[参考資料10] | Verified は「ますます汚染されている」。モデルが解けない部分(全体の27.6%)を監査し、少なくとも59.4%の問題に、機能的に正しい解答を落とす欠陥のあるテストがあった。検証した最先端のモデルすべてが、人が書いた正解のパッチや課題文の細部を再現でき、問題と解答を学習中に見ていると示唆。Verified の最新の最先端の成績が6か月で74.9%から80.9%と伸び悩んでいたとも記述。Verified の得点の報告をやめ、他の開発元にも勧め、当面は SWE-bench Pro の報告を勧める | 「改善」が、モデルの力より、ベンチマークへの触れ方を反映する |
すべて事実(各論文・報告の記述)。OpenAI の2つのページは、公式ページが自動取得を拒否するため、インターネットアーカイブの保存版で確認しました。
本稿の計算 資料の値から、変化の大きさを計算します。
- SWE-Bench+:12.47%→3.97%。低下は (12.47−3.97)÷12.47=約68%、新旧の比は 3.97÷12.47=約0.32
- SWE-bench Verified(OpenAI):16%→33.2%。比は 33.2÷16=約2.1倍
- 実験の食い違い(METR):開発者の事後の見積もりは「20%短縮」、実測は「19%延長」。見積もりと実測の差は、約39ポイント(20+19)
前提と限界:3つの例は、モデル・足場・対象・時期が違い、並べて比較するものではありません。同じ「SWE-bench」という名前でも、版(元、Lite、Verified、Pro)と、評価の設定で、値の意味が変わることを示す例です。
(2) そのほかの評価
LiveCodeBench(Jain ら)は、LeetCode、AtCoder、CodeForces の大会から時間とともに新しい問題を集めて、学習データへの混入を避ける評価で、コードの生成だけでなく、自己修復、コードの実行、テスト出力の予測も測り、HumanEval と MBPP のような既存のベンチマークで過学習の可能性があると論じています[参考資料14]。SWE-Lancer(Miserendino ら)は、Upwork の1,400件超のフリーランスの課題(実際の報酬の合計100万ドル相当)で、最先端のモデルが課題の大半をまだ解けないと報告しています[参考資料15]事実。
(3) 生産性とセキュリティ:コードの「質」の別の側面
METR の対照実験(Becker ら、2025年)は、経験豊富なオープンソース開発者16人が、平均5年の経験がある成熟したプロジェクトの246課題で、各課題をランダムに「AIを許可」か「禁止」に割り当てて測ったところ、AIを許可すると作業時間が19%増えたと報告しました。開発者の事前の予想は24%短縮、事後の見積もりは20%短縮で、経済学・機械学習の専門家の予想(39%、38%の短縮)とも逆でした。実験の工夫による影響を完全には排除できないが、効果の頑健さからは、主に実験設計によるものとは考えにくいと述べています事実[参考資料5]。
METR は2026年2月24日に、この実験の設計を変更する、と発表しました。2025年8月に始めた新しい実験(元の開発者10人+新規47人)のデータは、AIなしでは働きたくない開発者が参加を辞退する増加などの選択効果で、現在の効果の信頼できる信号にならない、と判断しています。生の結果は、元の開発者の部分集合で18%の短縮(信頼区間は38%短縮から9%延長)、新規の開発者で4%の短縮(15%短縮から9%延長)と、いずれも区間が0をまたぎます。同社は、2026年初頭の開発者は2025年より速くなっている可能性が高いと考えるが、データは増加の大きさの非常に弱い証拠にすぎない、と述べています事実[参考資料6]。 つまり、AIコーディング支援の生産性への影響は、2025年前半では延長、2026年は「測れていない(短縮の可能性が高いが大きさは不明)」というのが、一次資料にもとづく整理です。
セキュリティの面では、Pearce らが、Copilot に高リスクの CWE に関する89の場面でコードを生成させ、1,689本のプログラムのうち約40%に脆弱性があったと報告しています(2021年のツールでの結果で、現在のツールの結果ではありません)事実[参考資料7]。
SWE-bench の教訓は、テストが弱いと、間違った変更が「合格」することです(SWE-Bench+、UTBoost)[参考資料11・12]。測定データの解析スクリプトをAIに書かせるときも同じで、「テストが通った」は、テストが十分に厳しいときにだけ意味を持ちます。 材料・プロセスの分野では、既知の標準試料の測定値、手計算した代表値、単位や桁の検査、境界条件などを、AIにコードを書かせる前に「期待値のテスト」として用意しておきます。テスト設計の一般的な枠組みは ISO/IEC/IEEE 29119-1:2022 に、AIシステムの試験の概観は ISO/IEC TS 42119-2:2025 にあります(いずれも本文は有料で未確認。題名と範囲にとどめます)[参考資料38・39]。 テストの設計は、AIには任せにくく、領域の知識を持つ人の仕事です(本記事による解説)。
METR の実験で、開発者の「20%速くなった」という体感と、実測の「19%遅くなった」は逆でした[参考資料5]。AIで解析やスクリプト作成を効率化したいときは、体感ではなく、同じ種類の作業を、AIを使う場合と使わない場合で、作業時間と誤りの数を測って比べます(解説)。 また、AIが書いた解析コードは、研究データの再現性にかかわります。コードの版、使ったモデルと設定、入力データ、出力結果、人が確認した範囲を一緒に保存します。この分野ではモデルが短期間で入れ替わるため、同じ指示でも将来は同じコードが出ない可能性があります(解説)。
5. ブラウザ・画面を操作するエージェント
(1) 仕組み:画面を見て、座標を操作する
Claude の「コンピュータ使用」ツールのドキュメントは、スクリーンショットとマウス・キーボードの制御で、デスクトップ環境を操作させるものと説明します。モデルが、ツール呼び出し(クリックの座標など)を返し、アプリが自分の環境で実行して、結果とスクリーンショットを返す、という往復のループです[参考資料28]。 Gemini API の Computer Use も同様で、ブラウザ・モバイル・デスクトップの環境に対応し、各操作に、モデルの判断理由を示す intent を付け、内部の安全システムが各操作を「通常/ユーザーの承認が必要/ブロック」に分類する、とドキュメントは記述しています(ページの最終更新 2026年10月13日)[参考資料29]。OpenAI の Computer-Using Agent(2025年1月23日付)は、GPT-4o の視覚と強化学習による推論を組み合わせ、ボタン・メニュー・テキスト欄といった GUI を人のように操作するモデルで、ログイン情報の入力や CAPTCHA のような機微な操作ではユーザーに確認を求める、と述べています[参考資料27]事実。
(2) 「画面のどこ」を特定する難しさ(グラウンディング)
画面の中のどこを操作するかを特定する「グラウンディング」は、中心的な課題です。Set-of-Mark(Yang ら)は、画像を領域に分割して、英数字・マスク・枠などの目印を重ねて入力すると、GPT-4V の視覚的な特定能力が引き出される、という提示方法です[参考資料26]。UI-TARS(Qin ら)は、スクリーンショットだけを入力とし、キーボードとマウスの操作を行う「ネイティブな GUI エージェント」モデルで、OSWorld で50ステップなら24.6、15ステップなら22.7を報告しています(論文時点)[参考資料25]事実。
(3) ベンチマークと、その移り変わり
| ベンチマーク(出典) | 内容(資料の記述) | 報告された値(公表時点) | 注意 |
|---|---|---|---|
| Mind2Web(Deng ら、2023)[参考資料22] | 31領域・137のウェブサイトの2,000件超の課題と、クラウドソースの操作列 | 著者は「まだ大きな改善の余地」と述べる | 生の HTML は大きすぎるため、小さな LM で絞る方法を提案 |
| WebArena(Zhou ら、2023)[参考資料24] | 4領域の実際に動くサイトでの長い課題 | 最良の GPT-4 ベースのエージェント14.41%、人間78.24% | OpenAI の CUA は58.1%を報告(2025年1月、別の設定)[参考資料27] |
| VisualWebArena(Koh ら、2024)[参考資料23] | 視覚情報が必要なウェブ課題 | テキストのみのエージェントの限界、マルチモーダルのエージェントとの差を分析 | — |
| OSWorld(Xie ら、2024)[参考資料20] | 実際のコンピュータ環境(Ubuntu・Windows・macOS)で、369課題。実行にもとづく評価スクリプト | 人間は72.36%以上、最良のモデルは12.24%。主な弱点は GUI の特定と操作の知識 | 2025年7月に OSWorld-Verified、2026年6月26日に OSWorld 2.0 が公開された(公式ページの記載) |
| OSWorld 2.0(Yuan ら、2026)[参考資料21] | 108の長い作業の流れ。人間の中央値で約1.6時間。ツール呼び出しは平均318回(OSWorld 1.0 は約30回) | 最良のモデルで、500ステップでの完了が20.6%(部分点は54.8%) | 失敗は基本的な操作より、制約を見失う、途中の情報を見逃す、聞かずに推測する、検証を省く、などと論文は整理 |
すべて事実(各論文・ページの記述)。数値は公表時点のものです。OpenAI の CUA の値は、OSWorld 38.1%、WebArena 58.1%、WebVoyager 87%(人間は OSWorld 72.4%、WebArena 78.2%)と、同社の2025年1月のページに記載があります。
本稿の計算 OSWorld 2.0 の論文は、1課題あたりのツール呼び出しが、OSWorld 1.0 の約30回に対し、平均318回だと述べます。各操作が独立に成功率 r で成功するとすると、全部成功する確率は r の n 乗です。
- r=0.99:30回で 0.9930=約74%、318回で 0.99318=約4.1%
- r=0.999:30回で約97%、318回で約73%
前提と限界:操作が独立で失敗が許されない、という理想化です。実際は途中で修正できる操作も、失敗しても結果に影響しない操作もあり、論文の完了率(20.6%)はこの計算とは別の測定です。操作の成功率 r の実際の値は、確認できていません。
(4) ドキュメントが挙げる限界
Claude のドキュメントは、コンピュータ使用の限界として、(1) 人が直接操作するより遅いことがあり、速度が重要でない用途(背景での情報収集、ソフトウェアの自動テスト)で、信頼できる環境に絞ること、(2) 具体的な座標を出力するときに誤ったりハルシネーションを起こしたりすること、(3) ツールの選択を誤ったり、問題解決のために予想外の行動をとったりすること、(4) 専門的なアプリでは信頼性が下がりうること、を挙げています事実[参考資料28]。
6. 権限とサンドボックス
画面操作とコード実行を持つエージェントは、外から入った指示と過剰な権限が組み合わさると、被害が大きくなります。一次資料が示す対策を、層ごとに整理します(層の分け方は本記事のもの)。
| 層 | 対策の考え方(資料の記述) | 出典 |
|---|---|---|
| 実行環境の隔離 | 権限の最小な専用の仮想マシンやコンテナで動かし、システムへの直接の攻撃や事故を防ぐ。Gemini のドキュメントも、サンドボックスの VM かコンテナでの実行を求める | [参考資料28][参考資料29] |
| ファイルとネットワークの境界 | OS の機能の上に、ファイル隔離(決めたディレクトリだけ)とネットワーク隔離(承認済みのサーバーだけ)の両方を置く。片方だけでは、侵害されたエージェントが秘密鍵などを持ち出したり、サンドボックスを抜けたりしうる、と Anthropic は述べる | [参考資料30] |
| データとアクセス先の限定 | アカウントのログイン情報のような機微なデータを渡さない。インターネットのアクセスを許可したドメインに限る | [参考資料28] |
| 人の確認 | 実世界で意味のある結果を生む決定、同意が必要な作業(クッキーの承諾、金融取引、規約への同意)は人が確認する。Gemini は、操作を「通常/要確認/ブロック」に分類し、金融取引、機微なデータの変更、メッセージの送信、アカウント作成、データの変更・削除、同意の管理、法的な規約の承諾などの方針カテゴリーを持つ | [参考資料28][参考資料29] |
| 権限モード | 手動モードでは読み取り専用から始め、編集・実行の前に尋ねる。ただし作業ディレクトリの境界は確認の仕組みで、承認したコマンドはユーザーが書ける場所に書ける。確認を毎回求めると、承認疲れで内容を見なくなる問題がある | [参考資料31][参考資料30] |
| 画面・外部データ経由の指示への備え | ウェブページや画像の中の指示が、利用者の指示に反して従われうる、と Claude のドキュメントは述べる。分類器でスクリーンショットを検査する層があるが、「人が見ていない」用途には向かない場合もあり、上の対策は分類器があっても重要とする。Gemini は、スクリーンショットの検査を任意の機能として提供 | [参考資料28][参考資料29][参考資料33] |
| 過剰な代理権限の防止 | 過剰な機能、過剰な権限、過剰な自律性を避ける(OWASP LLM06:2025) | [参考資料32] |
すべて事実(各資料の記述)。Claude Code と Claude のドキュメント、Anthropic のブログは開発元自身の説明で、他社製品との優劣ではありません。
AIが書いたコードの安全性には、一般的なソフトウェア開発の枠組みも参考になります。NIST SP 800-218(SSDF)は、ソフトウェアの脆弱性のリスクを下げる、安全なソフトウェア開発の中核の実践を示し、SP 800-218A(2024年7月)は、それに生成AIとデュアルユースの基盤モデルのモデル開発に特有の実践を加えた「コミュニティプロファイル」です事実[参考資料34・35]。ただし、これらは主にモデルを作る側・ソフトウェアを作る側の実践で、「AIエージェントが書いたコードを受け入れるときの手順」を直接定めたものとは、本稿は確認していません。
測定装置や制御システムに、AIが書いたコードを直接つなぐのは避け、検証用の環境で試験してから、人がレビューした版だけを本番に移します(図6のように、本番の装置制御用の環境と検証用を物理的にも分ける)。 また、API のない古い装置ソフトの操作に画面操作エージェントを使いたくなりますが、座標の誤りや予想外の操作が、装置の条件や試料に影響する恐れがあります。使うなら、隔離した仮想マシンで、ログイン情報を渡さず、速度が重要でない用途から始め、取り消せない操作(条件の上書き、データの削除)は人が確認します[参考資料28・32]。 可能なら、装置のメーカーが提供する正式な制御のインターフェースを優先します(本記事による解説)。
7. 限界と、確認できなかったこと
(1) 現在のモデルの性能
本記事のベンチマークの数値は、各論文・報告の公表時点のモデルと設定での値です。2026年10月15日時点の最新モデルでの結果や、現在のリーダーボードの順位は網羅していません。SWE-bench Verified は、OpenAI が2026年2月に報告をやめており、本記事は当時の成績の優劣を論じません。OSWorld 2.0 の論文は、版によって他社モデルの得点が異なる記述があり(約13%、約14%)、数値は引用しませんでした。
(2) 開発元の記述
Anthropic の内部での許可の確認の削減(84%)、OpenAI の CUA の得点、各社のドキュメントの安全機能の説明は、開発元自身の記述で、第三者の再現は確認していません。SWE-Bench Pro の評価の妥当性については、独立した検証が続いていると考えられますが、本稿は一次資料で確認できた範囲にとどめています。
(3) 資料の取得
OpenAI の3つのページ(SWE-bench Verified の発表、2026年の報告、Computer-Using Agent)は、自動取得が拒否されたため、インターネットアーカイブの保存版で全文を確認しました。ISO の規格ページは、題名・版・発行時期を検索結果に表示された公式ページの記載で確認しており、本文は確認していません。ISO/IEC TS 42119-2:2025 は題名のみを確認しています。
(4) 規格
AIが書いたコードの受け入れや、コーディングエージェントの評価を直接定める国際規格は、確認できませんでした。ISO/IEC 25010:2023 や 29119-1:2022 は、ソフトウェア一般の品質モデルと試験の概念の規格です。
(5) 取り上げなかった内容
Model Context Protocol とエージェント連携、エージェントの評価と安全の詳細、AIエージェントの一般的な仕組みは、本シリーズの別編で扱います。特定製品(Claude Code、Copilot、Cursor、Codex など)の機能比較・価格・優劣は扱いません。攻撃やセキュリティの回避の具体的な手順は書きません。コード生成AIの著作権・ライセンスの問題は本記事の範囲外です。
- 作業の単位が広がっています。関数の補完からリポジトリの課題、端末や画面での長い作業へ。広がるほど、人の確認範囲と失敗の影響も広がります事実
- ベンチマークは質で動きます。SWE-bench は、解答の漏洩と弱いテストで値が下がり、不適切な課題の除外で値が上がり、2026年2月に OpenAI が Verified の報告をやめました事実/本稿の計算
- 体感と実測は違います。METR の2025年の実験は19%延長、2026年の更新は「測れていない」。生産性は自分の作業で測ります事実
- 画面操作は、遅く、座標を誤り、画面の中の指示に従う危険があります。長い作業の完了率は、2026年の OSWorld 2.0 で最良でも約2割です事実
- 権限は最小に、隔離して、取り消せない操作は人が確認します。ファイルとネットワークの両方の境界が必要です事実
8. 評価・標準の読み方
コーディングエージェントと画面操作の評価には、(1)課題の達成(テストの合否、タスクの完了)、(2)作業時間などの生産性、(3)出力されたコードの質・安全性、(4)操作の安全性(権限・隔離)の4つの面があります。ベンチマークは問題とテストの質、学習データへの混入、版と設定で値が大きく動き、ソフトウェア一般の規格は土台になるものの、AIエージェントを直接扱う規格は確認できませんでした。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 関数単位のコード生成 | HumanEval(Chen ら)[参考資料1]、MBPP(Austin ら)[参考資料2]、LiveCodeBench(汚染を避ける、時間とともに問題を追加)[参考資料14] | 確認できなかった | pass@k は試行回数 k に依存し、問題ごとに成功率が違う(第2章の計算)。HumanEval と MBPP は、既存のベンチマークで過学習の可能性があると LiveCodeBench の論文が指摘 事実 |
| リポジトリの課題解決 | SWE-bench(2,294問)[参考資料8]、SWE-bench Verified(500件)[参考資料9]、SWE-Bench Pro(1,865問)[参考資料13]、SWE-Bench+(欠陥の分析)[参考資料11]、UTBoost(テスト補強)[参考資料12] | 確認できなかった | 版・足場・設定で値の意味が変わる。OpenAI は2026年2月に Verified の報告をやめ、汚染と欠陥のあるテストを理由に挙げた[参考資料10]。順位をそのまま信頼しない 事実 |
| 端末での長い作業・実務案件 | Terminal-Bench 2.0(89課題)[参考資料16]、SWE-Lancer(1,400件超、報酬の合計100万ドル相当)[参考資料15] | 確認できなかった | 公表時点のモデルでの値。課題は選ばれたもので、実務全体の代表ではない 事実 |
| 生産性(作業時間) | Copilot の対照実験(55.8%速い)[参考資料4]、METR の対照実験(2025年:19%延長)[参考資料5]、METR の2026年2月の更新(選択効果で信頼できない)[参考資料6] | 確認できなかった | 課題の種類・参加者の経験・ツールの世代で結果が逆になる。体感の見積もりは実測と食い違う 事実 |
| 出力コードの安全性 | Pearce らの場面別の評価(89場面・1,689本のうち約40%に脆弱性、2021年のツール)[参考資料7] | NIST SP 800-218(SSDF、2022年2月)[参考資料34]、SP 800-218A(生成AIとデュアルユース基盤モデルの開発、2024年7月)[参考資料35]。推奨の実践であり、AI生成コードの受け入れ手順を直接定めたものではない | 古いツールでの値を現在に当てはめない。コードは人が確認し、テストと静的な検査を通す(解説)事実 |
| 画面・ブラウザの操作 | Mind2Web[参考資料22]、WebArena[参考資料24]、VisualWebArena[参考資料23]、OSWorld(369課題)[参考資料20]、OSWorld 2.0(108課題)[参考資料21] | 確認できなかった | 版が更新されるたびに値の基準が変わる(OSWorld-Verified、OSWorld 2.0)。人間の成績は条件で変わる 事実 |
| 操作の安全性 | エージェントのハイジャックの評価(NIST CAISI の技術ブログ)[参考資料33] | OWASP LLM06:2025 過剰な代理権限(業界団体の文書で、法令・規格ではない)[参考資料32] | 評価は適応的に、複数回の試行で。権限の設計が中心 事実 |
| ソフトウェアの品質・試験の一般的な枠組み | (ベンチマークではなく規格) | ISO/IEC 25010:2023(製品品質モデル、9特性で「安全性」を新設)[参考資料37]。ISO/IEC/IEEE 29119-1:2022(ソフトウェア試験の一般概念)[参考資料38]。ISO/IEC TS 42119-2:2025(AIの試験の概観。題名のみ確認)[参考資料39] | AIが書いたコードにも使える一般的な枠組みだが、AIエージェントの評価を直接定めるものではない。本文は有料のため未確認 事実 |
| AIのマネジメントとリスク | (ベンチマークではなく枠組み) | ISO/IEC 42001:2023(AIマネジメントシステム)[参考資料40]。NIST AI RMF 1.0(NIST AI 100-1、2023年1月)[参考資料36] | NIST の枠組みは自主的な利用を意図。ISO/IEC 42001 は組織の管理体制の規格で、個々のエージェントの安全を保証しない 事実 |
表の整理は本記事のもの(解説)です。ISO/IEC の本文は有料で確認していません。確認日 2026年10月15日。
読み方の注意(素材技術者向けに3点)
- 数値は、設定・版・実施主体で変わります。同じ「SWE-bench」でも、版、足場、評価の設定で意味が違い、開発元の記述は独立した評価ではありません。公表時点のモデルの値を、現在のモデルの性能として読みません
- 飽和と汚染:公開のベンチマークの問題と解答が、学習データに混ざっている可能性があります。OpenAI は、検証したすべての最先端のモデルが、正解のパッチを再現できたと報告しました[参考資料10]。改善が、能力ではなくベンチマークへの触れ方を反映しうるので、自分の課題と、非公開のテストで確かめます。ベンチマーク一般の飽和・汚染は、本シリーズ「ベンチマークと評価の読み方」編で扱います
- 標準・指針は「要求」「推奨」「業界団体の文書」を区別します。ISO/IEC 25010 と 29119 は一般的なソフトウェアの枠組み、NIST の SSDF は推奨の実践、OWASP は業界団体の文書です。いずれも、AIエージェントを直接扱うものではありません。「規格に適合している」ことは、エージェントが安全であることを意味しません。法的な拘束力のある規制は「EU AI法」編などで扱います
9. 用語集
- コーディングエージェント
- コードを読み、編集し、テストを実行して結果を見る、ループで開発作業を進めるエージェント。
- pass@k
- k個の生成のうち少なくとも1つが正しい確率。
- HumanEval/MBPP
- 関数単位のコード生成を測るベンチマーク。
- SWE-bench
- 実際の GitHub の課題を解決できるかを測るベンチマーク。Lite、Verified、Pro などの版がある。
- ACI(エージェント・コンピュータ・インターフェース)
- エージェント向けに設計した、ソフトウェアとのやり取りの道具立て。
- 足場(スキャフォールド)
- モデルを包んで、ツールの呼び出しやループを管理するプログラム。
- 汚染(contamination)
- 評価の問題や解答が、学習データに混入していること。
- サンドボックス
- ファイルやネットワークへのアクセスを制限した、隔離された実行環境。
- 承認疲れ
- 許可の確認が多すぎて、人が内容をよく見なくなること。
- コンピュータ使用(computer use)
- スクリーンショットを見て、マウスとキーボードを操作させる機能。
- グラウンディング
- 指示と画面上の位置・要素を結びつけること。
- プロンプトインジェクション
- データやWebページの中の指示で、エージェントの動作を乱すこと。
- 過剰な代理権限
- 機能・権限・自律性が必要以上に大きいこと(OWASP)。
- SSDF
- NIST の安全なソフトウェア開発の枠組み(SP 800-218)。
10. 参考資料(一次情報)
- Chen M. ほか "Evaluating Large Language Models Trained on Code", arXiv:2107.03374 (2021) — arxiv.org/abs/2107.03374
- Austin J. ほか "Program Synthesis with Large Language Models", arXiv:2108.07732 (2021) — arxiv.org/abs/2108.07732
- Li Y. ほか "Competition-Level Code Generation with AlphaCode", arXiv:2203.07814 (2022) — arxiv.org/abs/2203.07814
- Peng S. ほか "The Impact of AI on Developer Productivity: Evidence from GitHub Copilot", arXiv:2302.06590 (2023) — arxiv.org/abs/2302.06590
- Becker J. ほか(METR) "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity", arXiv:2507.09089 (2025) — arxiv.org/abs/2507.09089
- METR "We are Changing our Developer Productivity Experiment Design"(2026年2月24日付)。確認日 2026年10月15日 — metr.org/blog/2026-02-24-uplift-update
- Pearce H. ほか "Asleep at the Keyboard? Assessing the Security of GitHub Copilot's Code Contributions", arXiv:2108.09293 (2021) — arxiv.org/abs/2108.09293
- Jimenez C. E. ほか "SWE-bench: Can Language Models Resolve Real-World GitHub Issues?", arXiv:2310.06770 (2023) — arxiv.org/abs/2310.06770
- OpenAI "Introducing SWE-bench Verified"(2024年8月13日付)。公式ページは自動取得が拒否されるため、インターネットアーカイブの保存版で全文を確認 — openai.com/index/introducing-swe-bench-verified
- OpenAI "Why SWE-bench Verified no longer measures frontier coding capabilities"(2026年2月23日付。URL は why-we-no-longer-evaluate-swe-bench-verified)。インターネットアーカイブの保存版で全文を確認 — openai.com/index/why-we-no-longer-evaluate-swe-bench-verified
- Aleithan R. ほか "SWE-Bench+: Enhanced Coding Benchmark for LLMs", arXiv:2410.06992 (2024) — arxiv.org/abs/2410.06992
- Yu B. ほか "UTBoost: Rigorous Evaluation of Coding Agents on SWE-Bench", ACL 2025, arXiv:2506.09289 — arxiv.org/abs/2506.09289
- Deng X. ほか "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", arXiv:2509.16941 (2025) — arxiv.org/abs/2509.16941
- Jain N. ほか "LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code", arXiv:2403.07974 (2024) — arxiv.org/abs/2403.07974
- Miserendino S. ほか "SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering?", arXiv:2502.12115 (2025) — arxiv.org/abs/2502.12115
- Merrill M. A. ほか "Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces", arXiv:2601.11868 (2026)(要旨は「Terminal-Bench 2.0」と記述) — arxiv.org/abs/2601.11868
- Yang J. ほか "SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering", arXiv:2405.15793 (2024) — arxiv.org/abs/2405.15793
- Xia C. S. ほか "Agentless: Demystifying LLM-based Software Engineering Agents", arXiv:2407.01489 (2024) — arxiv.org/abs/2407.01489
- Wang X. ほか "OpenHands: An Open Platform for AI Software Developers as Generalist Agents", arXiv:2407.16741 (2024) — arxiv.org/abs/2407.16741
- Xie T. ほか "OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments", arXiv:2404.07972 (2024) — arxiv.org/abs/2404.07972
- Yuan M. ほか "OSWorld 2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks", arXiv:2606.29537 (2026) — arxiv.org/abs/2606.29537
- Deng X. ほか "Mind2Web: Towards a Generalist Agent for the Web", arXiv:2306.06070 (2023) — arxiv.org/abs/2306.06070
- Koh J. Y. ほか "VisualWebArena: Evaluating Multimodal Agents on Realistic Visual Web Tasks", arXiv:2401.13649 (2024) — arxiv.org/abs/2401.13649
- Zhou S. ほか "WebArena: A Realistic Web Environment for Building Autonomous Agents", arXiv:2307.13854 (2023) — arxiv.org/abs/2307.13854
- Qin Y. ほか "UI-TARS: Pioneering Automated GUI Interaction with Native Agents", arXiv:2501.12326 (2025) — arxiv.org/abs/2501.12326
- Yang J. ほか "Set-of-Mark Prompting Unleashes Extraordinary Visual Grounding in GPT-4V", arXiv:2310.11441 (2023) — arxiv.org/abs/2310.11441
- OpenAI "Computer-Using Agent"(2025年1月23日付)。公式ページは自動取得が拒否されるため、インターネットアーカイブの保存版で全文を確認 — openai.com/index/computer-using-agent
- Anthropic "Computer use tool"(Claude Platform Docs)。確認日 2026年10月15日 — platform.claude.com/docs/en/agents-and-tools/tool-use/computer-use-tool
- Google "Computer Use"(Gemini API。ページの最終更新 2026年10月13日と記載)。確認日 2026年10月15日 — ai.google.dev/gemini-api/docs/computer-use
- Anthropic "Beyond permission prompts: making Claude Code more secure and autonomous"(2025年10月20日付)。確認日 2026年10月15日 — anthropic.com/engineering/claude-code-sandboxing
- Anthropic "Security"(Claude Code Docs)。確認日 2026年10月15日 — code.claude.com/docs/en/security
- OWASP Gen AI Security Project "LLM06:2025 Excessive Agency"(業界団体のプロジェクトの文書。法令・規格ではない)。確認日 2026年10月15日 — genai.owasp.org/llmrisk/llm062025-excessive-agency
- NIST CAISI "Technical Blog: Strengthening AI Agent Hijacking Evaluations"(2025年1月17日付) — nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations
- NIST NIST SP 800-218 "Secure Software Development Framework (SSDF) Version 1.1: Recommendations for Mitigating the Risk of Software Vulnerabilities"(2022年2月) — csrc.nist.gov/pubs/sp/800/218/final
- NIST NIST SP 800-218A "Secure Software Development Practices for Generative AI and Dual-Use Foundation Models: An SSDF Community Profile"(2024年7月) — csrc.nist.gov/pubs/sp/800/218/a/final
- NIST NIST AI 100-1 "Artificial Intelligence Risk Management Framework (AI RMF 1.0)"(2023年1月) — doi.org/10.6028/NIST.AI.100-1
- ISO/IEC ISO/IEC 25010:2023 "Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model"(第2版、2023年11月。9つの特性。「安全性」が新設) — iso.org/standard/78176.html
- ISO/IEC ISO/IEC/IEEE 29119-1:2022 "Software and systems engineering — Software testing — Part 1: General concepts"(第2版、2022年2月) — iso.org/standard/81291.html
- ISO/IEC ISO/IEC TS 42119-2:2025 "Artificial intelligence — Testing of AI — Part 2: Overview of testing AI systems"(題名のみ検索結果の公式ページ記載で確認) — iso.org/standard/84127.html
- ISO/IEC ISO/IEC 42001:2023 "Information technology — Artificial intelligence — Management system"(第1版、2023年12月) — iso.org/standard/81230.html
11. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| Codex(HumanEval 28.8%、GPT-3 0%、GPT-J 11.4%、100サンプルで70.2%、限界の記述)、MBPP(974課題、少数例で59.6%、人のフィードバックで誤り半減)、AlphaCode(Codeforces で上位54.3%、サンプリングとフィルタリング) | 出典1 https://arxiv.org/abs/2107.03374 出典2 https://arxiv.org/abs/2108.07732 出典3 https://arxiv.org/abs/2203.07814 | 事実 |
| Copilot の対照実験(JavaScript の HTTP サーバー、55.8%速い)、METR の対照実験(16人・246課題、事前予想24%短縮・事後見積もり20%短縮・実測19%延長)、METR の2026年2月の更新(選択効果、元の開発者の部分集合で18%短縮〔38%短縮〜9%延長〕、新規で4%短縮〔15%短縮〜9%延長〕) | 出典4 https://arxiv.org/abs/2302.06590 出典5 https://arxiv.org/abs/2507.09089 出典6 https://metr.org/blog/2026-02-24-uplift-update/ | 事実 |
| Pearce ら(89場面・1,689本のうち約40%に脆弱性、2021年のツール) | 出典7 https://arxiv.org/abs/2108.09293 | 事実 |
| SWE-bench(2,294問・12リポジトリ・Claude 2 が1.96%)、SWE-agent(ACI、12.5%と87.7%)、Agentless(3段階、Lite で32.00%・0.70ドル、問題のある課題の指摘)、OpenHands(MIT ライセンスのプラットフォーム)、Terminal-Bench 2.0(89課題、65%未満) | 出典8 https://arxiv.org/abs/2310.06770 出典17 https://arxiv.org/abs/2405.15793 出典18 https://arxiv.org/abs/2407.01489 出典19 https://arxiv.org/abs/2407.16741 出典16 https://arxiv.org/abs/2601.11868 | 事実 |
| SWE-bench Verified の発表(2024年8月13日、93人・1,699件の選別、38.3%と61.1%の指摘、68.3%除外、500件、GPT-4o が33.2%、元の16%の2倍以上、過小評価)、SWE-Bench+(32.67%の漏洩、31.08%の弱いテスト、12.47%→3.97%、94%超が知識の期限より前)、UTBoost(36件・345件、40.9%と24.4%、順位の入れ替え18件と11件)、SWE-Bench Pro(1,865問・41リポジトリ)、OpenAI の2026年2月23日の報告(27.6%の監査で59.4%に欠陥、正解パッチの再現、74.9%→80.9%、報告の停止と Pro の推奨) | 出典9 https://openai.com/index/introducing-swe-bench-verified/ 出典11 https://arxiv.org/abs/2410.06992 出典12 https://arxiv.org/abs/2506.09289 出典13 https://arxiv.org/abs/2509.16941 出典10 https://openai.com/index/why-we-no-longer-evaluate-swe-bench-verified/ | 事実 |
| LiveCodeBench(汚染を避ける、400問、過学習の可能性)、SWE-Lancer(1,400件超・100万ドル相当、大半を解けない) | 出典14 https://arxiv.org/abs/2403.07974 出典15 https://arxiv.org/abs/2502.12115 | 事実 |
| Claude の computer use(スクリーンショットとマウス・キーボード、アプリが実行して返すループ、限界:遅延・座標の誤り・ツール選択・専門アプリ、セキュリティ:専用の仮想マシン・機微なデータを渡さない・許可リスト・人の確認・画面内の指示)、Gemini Computer Use(intent、安全判断の3分類、方針カテゴリー、スクリーンショット検査は任意、サンドボックス、最終更新2026年10月13日)、OpenAI の CUA(2025年1月23日、OSWorld 38.1%・WebArena 58.1%・WebVoyager 87%、人間72.4%・78.2%、機微な操作で確認) | 出典28 https://platform.claude.com/docs/en/agents-and-tools/tool-use/computer-use-tool 出典29 https://ai.google.dev/gemini-api/docs/computer-use 出典27 https://openai.com/index/computer-using-agent/ | 事実 |
| Set-of-Mark(目印を重ねる提示)、UI-TARS(スクリーンショットのみのネイティブな GUI エージェント、OSWorld 24.6 と 22.7)、Mind2Web(2,000件超・137サイト・31領域)、VisualWebArena、WebArena(14.41%と78.24%)、OSWorld(369課題、人間72.36%以上・最良12.24%、OSWorld-Verified と OSWorld 2.0 の公開)、OSWorld 2.0(108の作業、中央値1.6時間、ツール呼び出し平均318回、最良の完了20.6%、失敗の整理) | 出典26 https://arxiv.org/abs/2310.11441 出典25 https://arxiv.org/abs/2501.12326 出典22 https://arxiv.org/abs/2306.06070 出典23 https://arxiv.org/abs/2401.13649 出典24 https://arxiv.org/abs/2307.13854 出典20 https://arxiv.org/abs/2404.07972 出典21 https://arxiv.org/abs/2606.29537 | 事実 |
| Anthropic のサンドボックス(2025年10月20日、承認疲れ、ファイルとネットワークの両方の隔離、内部で許可の確認が84%減)、Claude Code のセキュリティ(手動モードは読み取り専用から、作業ディレクトリの境界は確認の仕組み)、OWASP LLM06:2025、NIST CAISI のハイジャック評価、NIST SP 800-218(2022年2月)と SP 800-218A(2024年7月) | 出典30 https://www.anthropic.com/engineering/claude-code-sandboxing 出典31 https://code.claude.com/docs/en/security 出典32 https://genai.owasp.org/llmrisk/llm062025-excessive-agency/ 出典33 https://www.nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations 出典34 https://csrc.nist.gov/pubs/sp/800/218/final 出典35 https://csrc.nist.gov/pubs/sp/800/218/a/final | 事実 |
| ISO/IEC 25010:2023(第2版、2023年11月、9特性、安全性を新設)、ISO/IEC/IEEE 29119-1:2022(第2版、2022年2月)、ISO/IEC TS 42119-2:2025(題名のみ)、ISO/IEC 42001:2023、NIST AI 100-1(2023年1月)。番号・題名・版は公式ページの記載、ISO の本文は未確認 | 出典37 https://www.iso.org/standard/78176.html 出典38 https://www.iso.org/standard/81291.html 出典39 https://www.iso.org/standard/84127.html 出典40 https://www.iso.org/standard/81230.html 出典36 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| pass@k と独立試行の食い違い(1−0.712の100乗は約1に対し、論文は70.2%)、SWE-Bench+ の低下率(約68%、比約0.32)、Verified の比(約2.1倍)、METR の見積もりと実測の差(約39ポイント)、長い作業の成功確率(0.99の30乗=約74%、318乗=約4.1%、0.999の30乗=約97%、318乗=約73%) | 本稿の計算。論文・報告の記載値の単純な計算。独立・同一の成功率という理想化を含み、設定の違う例を並べて比較するものではない。操作の実際の成功率 r は未確認 | 本稿の計算 |
| 最新モデルでの結果、開発元の記述の第三者による再現、AIが書いたコードの受け入れやコーディングエージェントの評価を直接定める規格、ISO の規格本文、SWE-Bench Pro の評価の妥当性の独立検証 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「テストが仕様」「体感ではなく測る・解析コードは版と入力と結果を残す」「装置の本番に直結させず検証用と分け、古い装置ソフトの画面操作は隔離する」という読み取りと、表の整理(第4・6・8章)、作業の単位の段階の整理 | 公表内容にもとづく本記事の整理・解説。各社・各機関が表明した見解ではない | 解説 |
| 図2〜図5が説明のための作図(実測データではない)であること。図1と図6がAI生成イメージの枠であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(arXiv の論文、開発元の技術文書・ブログ、METR・NIST・OWASP の公式ページ、ISO/IEC の規格ページ)に限定しています。ISO/IEC の規格本文は有料のため確認できていません。OpenAI の3つのページはインターネットアーカイブの保存版で確認しました。 読み取りや整理を含むため、それらは「解説」として出典付きの事実と区別しています。 最新モデルでの結果、開発元の記述の第三者による再現、AIが書いたコードの受け入れやエージェントの評価を直接定める規格、規格の本文については、確認できなかったため記載していません。 ベンチマークの数値は公表時点・指定の設定のもので、モデルや製品の優劣を示すものではありません。攻撃の具体的な手順は記載していません。 図2〜図5はベクター作図、図1と図6はAI生成イメージの枠です(いずれも実際の測定結果や製品の実物を示すものではありません)。