TECHNOLOGY EXPLAINER
AIと半導体設計・製造
― 実運用の報告と、評価の議論が続く話を、分けて読む
半導体の設計と製造は、AIを使う側であると同時に、AIを使って変わりつつある分野でもあります。チップの配置や設計空間の探索、設計文書やスクリプトの支援、ウェーハ上の欠陥の分類、計算リソグラフィ、工場のデータ基盤など、AIが入る場所は多岐にわたりますが、企業が実運用や顧客の成果を公表しているもの、社内の利用報告、研究や評価の議論が続いているもの、構想や探索の段階のものが混在しています。この記事では、それぞれを公式資料で区別して整理し、本稿の計算で「設計の工夫(ダイ面積)」と「製造の工夫(欠陥密度)」が歩留まりにどう効くかを示します。
- AIと半導体設計・製造とは(3行でつかむ)
- チップ設計の流れと、AIの入る場所 ― 区分をつけて
- 配置・設計空間の探索 ― 企業の報告と、AlphaChip をめぐる議論
- 言語モデルによる設計支援 ― ChipNeMo と、評価の物差し
- 製造:欠陥検査と歩留まり解析 ― 光学検査の「ノイズ」から歩留まりに効く欠陥を選ぶ
- 計算リソグラフィとデジタルツイン ― 実運用と「探索中」を分ける
- 工場のデータと標準 ― 国際半導体製造装置材料協会(SEMI) の通信・データ収集・サイバーの標準
- 本稿の計算:ダイ面積を5%小さくすると、歩留まりと取れる数はどう変わるか
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定・提案であり、実績や確定が確認できていない事項
このほか、読み取りや整理は「解説」として区別しています。推測は太字で示します。
ここに出てくる「○倍」「○%削減」は、企業・研究者が自社の条件で報告した値で、独立した検証を経たものとは限りません。設計の成果は「設計の種類・工程・ツールの版・比較の基準」に依存し、異なる報告の数字を並べて優劣をつけることはしません。実運用(企業が顧客の量産や製造での利用を公表)、社内利用の報告、研究・評価の段階、構想・探索中を区別し、後の二つを「実績」とは書きません。係争・論争中の評価は、結論を出さず双方の主張を示します。特定の企業・製品の優劣は論じません。
1. AIと半導体設計・製造とは(3行でつかむ)
- 設計では「探索」と「支援」:配置配線や設計パラメータの探索を、強化学習などで自動化する(Synopsys DSO.ai、Cadence Cerebrus、Google の AlphaChip)、設計文書・スクリプト・ログ解析を言語モデルで支援する(NVIDIA の ChipNeMo)、の2系統があります事実[参考資料3][参考資料6][参考資料7][参考資料8]
- 製造では「欠陥」と「データ」:Applied Materials は、光学検査の大量の信号から歩留まりに効く欠陥を、電子ビーム観察の少量のサンプルとAIで見分ける技術を公表しています事実[参考資料10]。NVIDIA は2026年5月31日に、TSMC が計算リソグラフィ(cuLitho)などを使っていると発表し、工場のデジタルツイン(FabTwin)は「探索中」としています事実[参考資料13]
- 評価が割れるものがあります:AlphaChip の配置の成果は、Nature の論文と、それを再評価した ISPD 2023 の論文と、双方の反論が併存しています(第3章)事実。本稿は結論を出さず、双方の主張と、確認できなかった点を示します
「AIで設計した」「AIで歩留まりが上がった」は、どの工程の、何と比べた、誰の報告かを書いて初めて読めます。しかも歩留まりは、設計側のダイ面積と、製造側の欠陥密度の両方の指数に入ります(第8章の本稿の計算)。素材・プロセスの技術者は、AIを待たずに、後者のレバーを持っています。
2. チップ設計の流れと、AIの入る場所 ― 区分をつけて
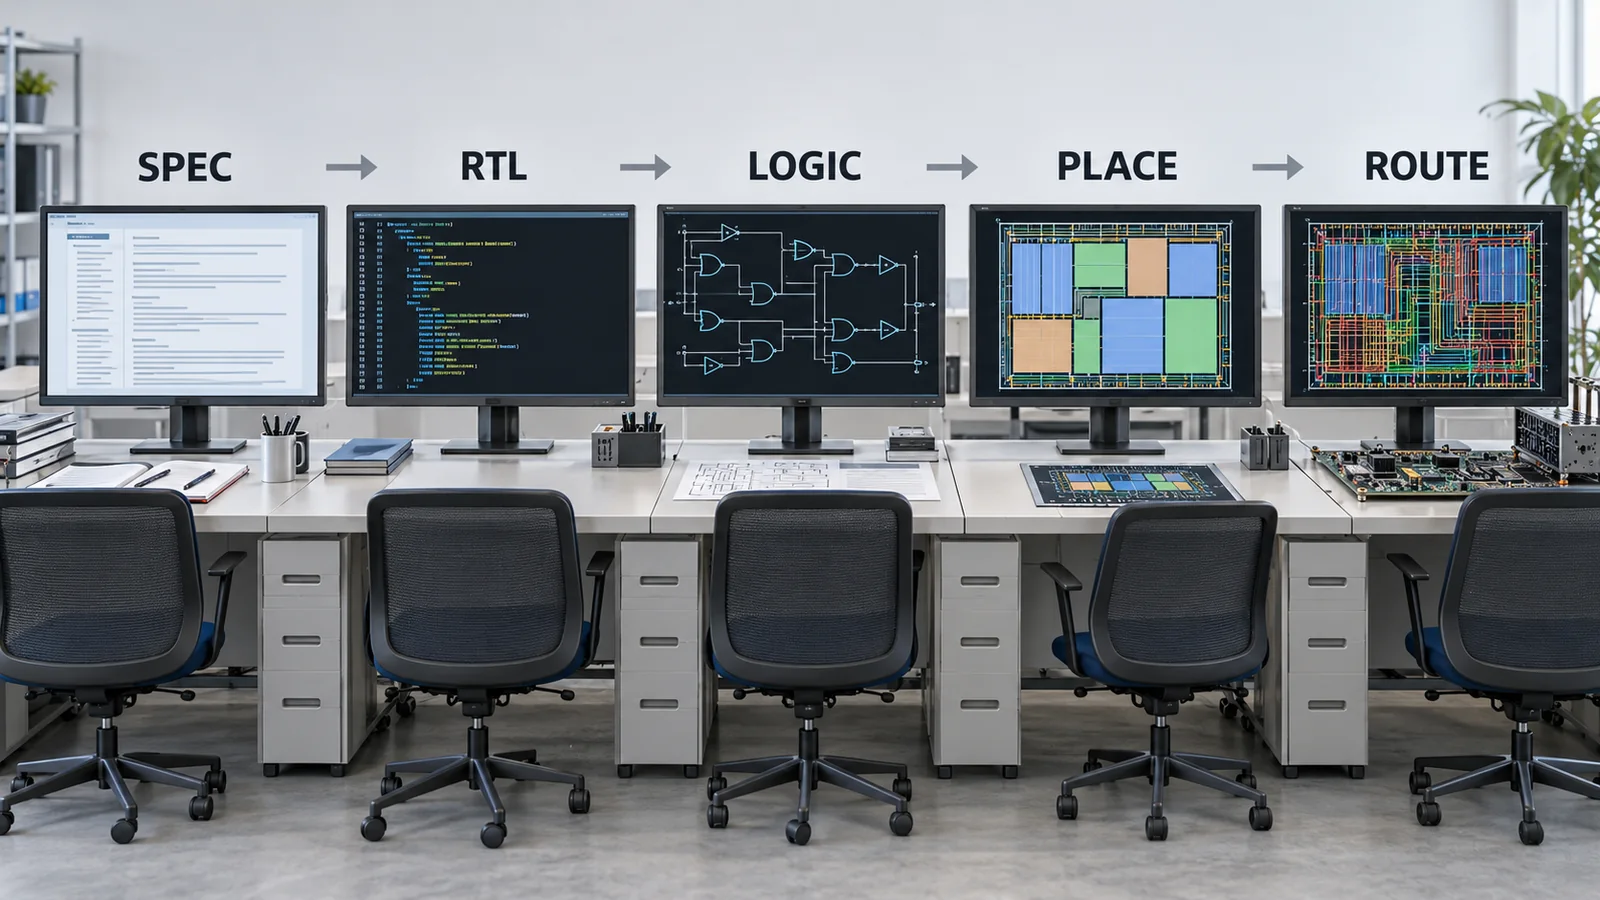
チップの設計は、仕様、RTL(回路の記述)、論理合成、フロアプランと配置、配線、検証とサインオフ、製造データの作成(テープアウト)という流れで進みます(本稿の整理)。AIが入る場所と、公式資料で確認できる状況を次の図と表に整理します。「実運用」は企業が顧客や自社の実チップでの利用を公表しているもの、「社内利用の報告」は企業が自社内での評価・利用を報告したもの、「研究・評価」は論文や評価で議論が続くものです。
元のSVG模式図・数値・出典注記を見る
3. 配置・設計空間の探索 ― 企業の報告と、AlphaChip をめぐる議論
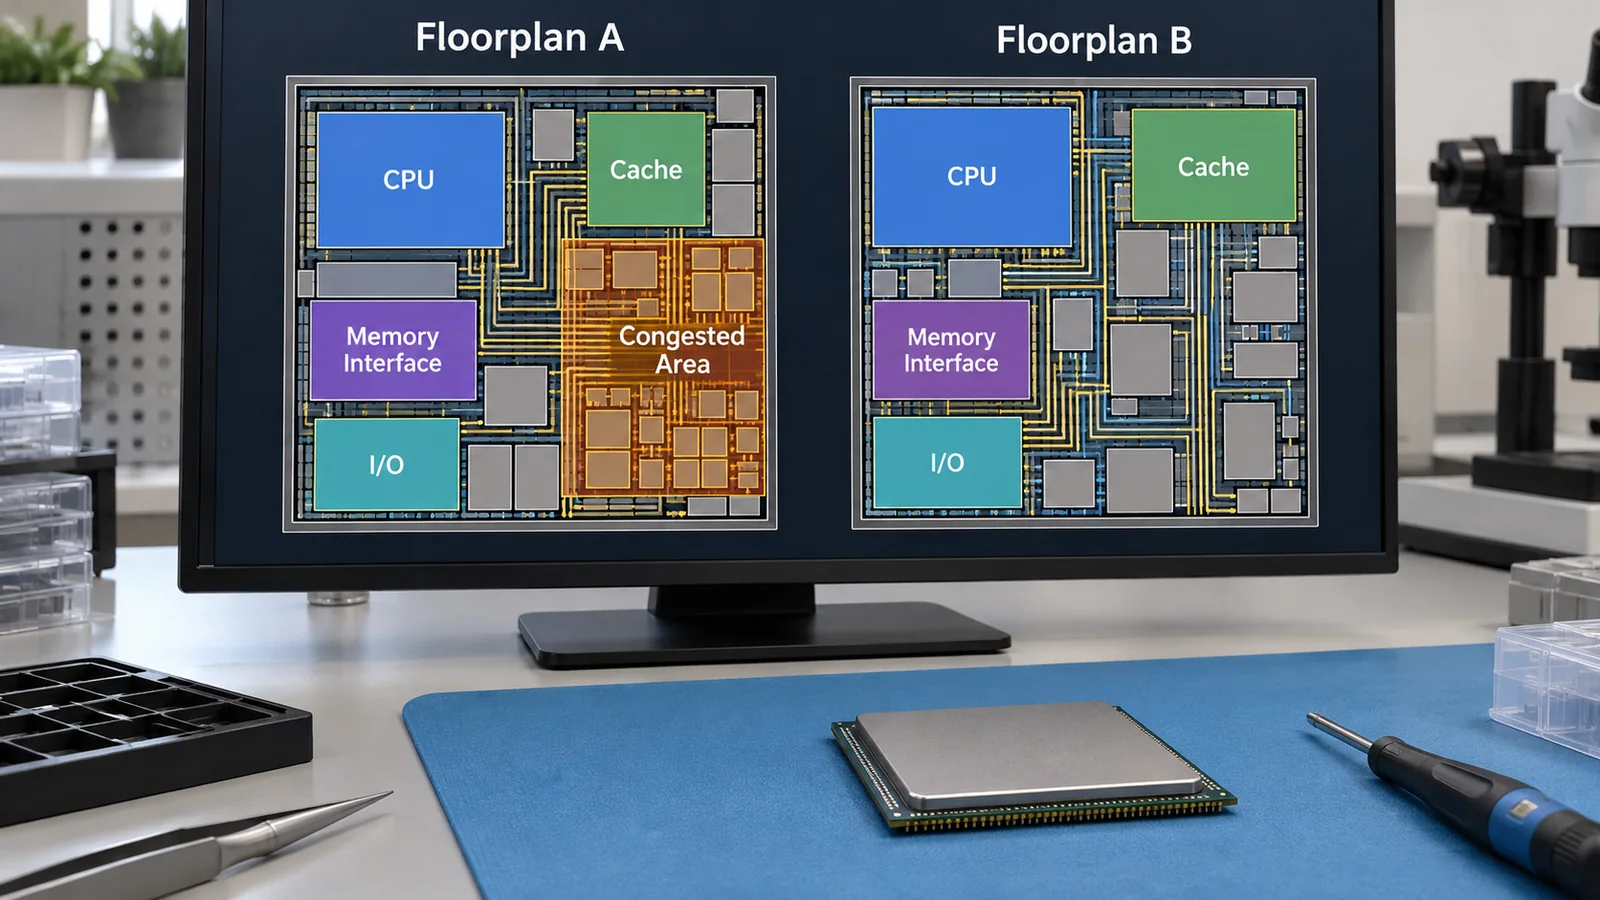
設計空間の探索。Synopsys は2023年2月7日に、DSO.ai(Design Space Optimization AI)を使った商用のテープアウトが100件に達したと発表しています(同社の発表)。DSO.ai は強化学習で、広い解の空間から、消費電力・性能・面積(PPA)のよい解を自律的に探すとされます。同じ発表は、STMicroelectronics が Azure 上の DSO.ai で PPA 探索の生産性が3倍超になったこと、SK hynix が最先端のプロセスでダイ面積を最大5%小さくしたことを、顧客の引用として載せています事実[参考資料6]。Cadence は2022年6月9日の発表で、Cerebrus(強化学習のエンジン)を MediaTek と Renesas が量産フローに採用したと述べ、MediaTek は SoC のブロックでダイ面積5%縮小・消費電力6%超の削減、Renesas は先端ノードのCPU設計で総負のスラック(TNS)が75%改善と述べています(いずれも顧客の引用)事実[参考資料7]。
これらは企業の発表と顧客の引用で、比較の基準(人手の設計か、旧版のツールか)、対象のブロック、プロセス、測り方は発表ごとに異なります。本稿は、倍率や削減率を並べて優劣をつけません。
配置(マクロ配置)への強化学習と、評価の議論。Google の Mirhoseini らは、チップの配置を強化学習の問題として扱い、「6時間未満で、最新のアクセラレータのネットリストに対して、超人的または同等の配置を作れる。既存のベースラインは人間の専門家が介在し数週間かかる」と報告しました(2020年のプレプリント、2021年に Nature で刊行)事実[参考資料1]。2024年9月26日の Nature の追補と、Google DeepMind の公式ブログは、この手法を AlphaChip と呼び、公開した事前学習のチェックポイントとともに、TPU の複数世代、Axion プロセッサ、MediaTek などでの利用を述べています(同社の説明。ブログには独立した批判は含まれていません)事実[参考資料2][参考資料3]。
| 論点 | Google 側の記述 | 再評価した側の記述 |
|---|---|---|
| 評価の位置づけ | Nature の査読論文。ISPD 2023 の論文は「査読されていない招待論文」で、Nature に記した方法どおりに実行していない、と述べる[5] | Cheng らは「Google Brain の強化学習によるマクロ配置と、更新された Circuit Training の実装」の評価を改善して再評価し、公開ベンチマークと評価の流れ・スクリプトをすべて公開したと述べる[4] |
| 具体的な食い違い | 事前学習をしていない、計算資源が少ない(強化学習の経験収集が20分の1、GPUが半分)、収束まで学習していない、現代のチップを代表しないテストケースを使った、と述べる[5] | より強い焼きなまし法のベースラインを用い、商用の配置配線ツールで配線後の電力・性能・面積という「真の報酬」を評価。再現性と報告のしかたの洞察を示し、スケーラビリティや事前学習の方法について「確認が足りない点が残る」と述べる[4] |
| 本稿の扱い | 実運用の報告(企業の説明)として記載 | 評価の議論として記載。どちらの結論も本稿は採らない |
すべて事実(各文書の著者の記述の整理。どちらの主張が正しいかは本稿では判断しません)。ISPD 2023 の論文の正式な書誌は DOI 10.1145/3569052.3578926(Assessment of Reinforcement Learning for Macro Placement)、更新版が arXiv 2302.11014[4]です。
配置配線の最適化は、数値としては消費電力・性能・面積の探索ですが、その裏にあるのは、配線の抵抗・容量、層の厚み、遅延、発熱という材料とプロセスの物理量です。商用の配置配線ツールが評価の「真の報酬」として使われること(Cheng らの評価)事実[参考資料4]は、設計のAIの良し悪しを、結局はプロセスのモデル(遅延・電力のライブラリ)で測っていることを意味します。プロセスのモデルが実物とずれていれば、最適化も一緒にずれます(本記事による解説)。
その意味で、素材・プロセスの技術者が持つ実測(配線抵抗、誘電体の誘電率、薄膜の厚み分布)は、設計AIの入力の質を決めます。AIが設計側で探索を高速にするほど、プロセス側の特性評価の精度がボトルネックになりやすい、というのは本記事の推測です(出典なし)。
4. 言語モデルによる設計支援 ― ChipNeMo と、評価の物差し
NVIDIA の ChipNeMo は、市販や公開の汎用モデルをそのまま使う代わりに、チップ設計向けにドメイン適応(専用のトークナイザー、継続事前学習、指示への調整、検索モデルの適応)した言語モデルです。評価した3つの用途は、エンジニア向けの質問応答チャット、EDAスクリプトの生成、不具合の要約と分析で、著者らは最大の ChipNeMo-70B が、うち2つの用途で GPT-4 を上回り、残る1つでも競合する性能だったと報告しています(NVIDIA が自社の用途で、自社で評価した結果)事実[参考資料8]。社内利用の報告であり、第三者の再現や、量産チップの成果の数字は確認できませんでした。
公開の評価の物差しとしては、VerilogEval が、Verilog(ハードウェア記述言語)のコード生成を評価する枠組みで、Verilog の学習サイト HDLBits の156問からなり、生成したコードをシミュレーションの出力と正解を比べて機能の正しさを自動で確かめます事実[参考資料9]。これは小さな回路の課題が中心で、数百万ゲート規模の実設計の品質を示すものではありません(本記事による注意)。
言語モデルが書いたRTLやスクリプトは、人が書いたものと同じく、シミュレーション・形式検証・サインオフで確かめる必要があります。VerilogEval が機能の正しさをシミュレーションで確認する作りになっていること事実[参考資料9]は、その考え方の表れです。生成の品質を上げる話と、検証の工程を省ける話は別で、後者を示す公式資料は、本稿の調査では確認できませんでした。
5. 製造:欠陥検査と歩留まり解析 ― 光学検査の「ノイズ」から歩留まりに効く欠陥を選ぶ
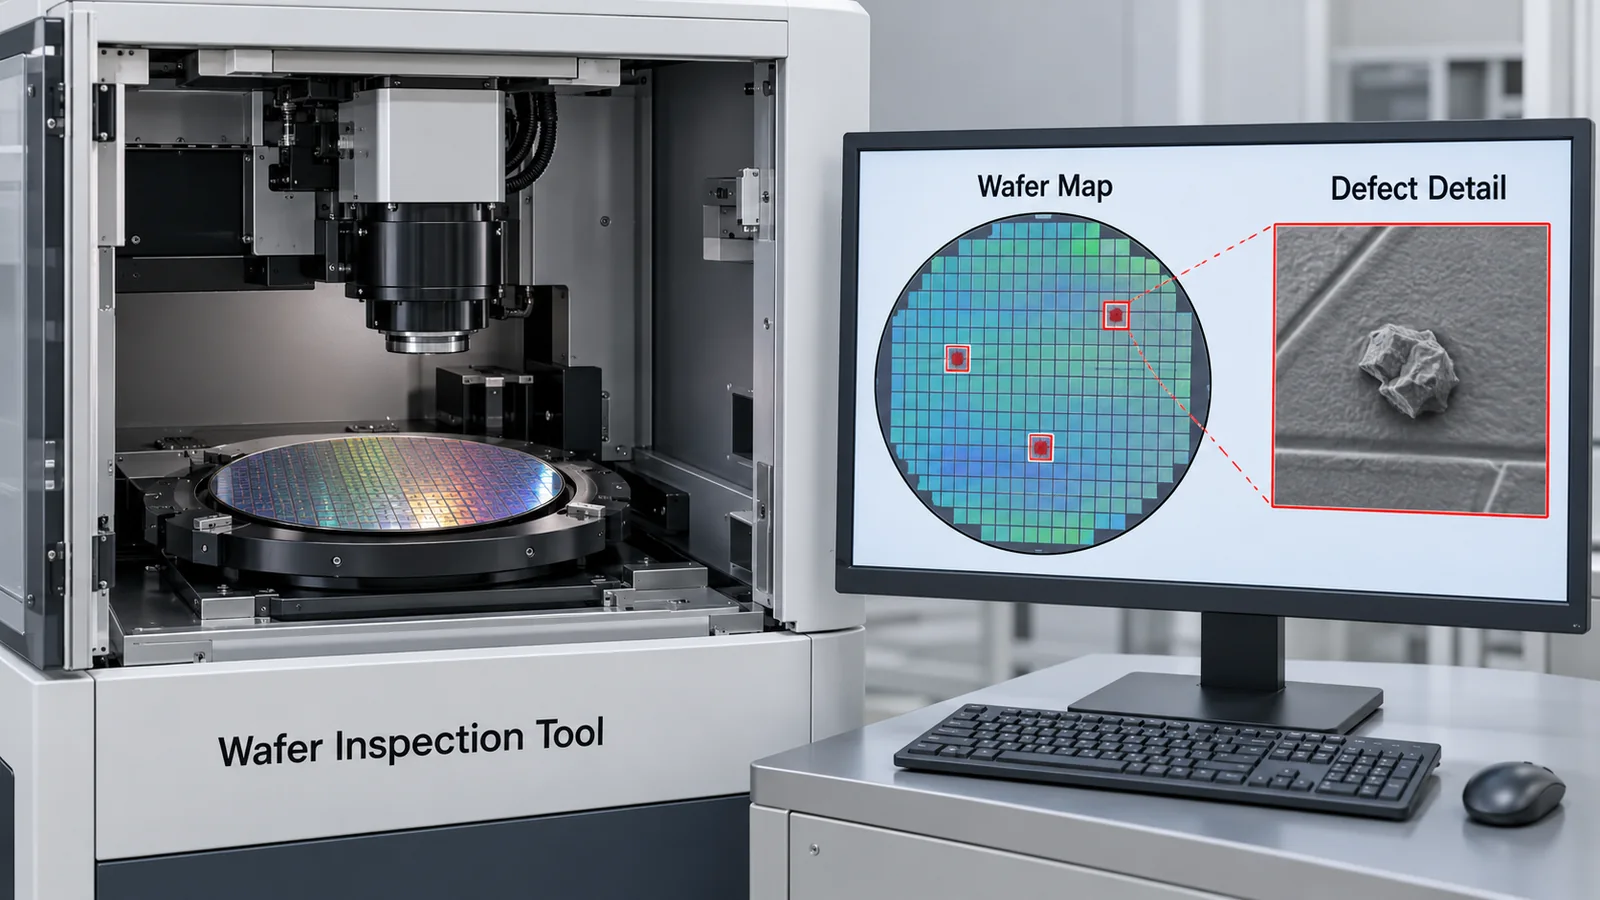
Applied Materials は2021年3月16日の発表で、プロセス制御へのビッグデータとAIの活用を発表しました。光学のウェーハ検査装置(Enlight)が大量に出す信号の中から、歩留まりに効く欠陥と、ノイズ(問題のない信号)を見分けるのが難しい、という課題に対し、ExtractAI は、光学検査の大量のデータと、電子ビームで個々の欠陥を観察して分類する装置(SEMVision)をリアルタイムでつなぎ、サンプルの0.001倍だけを電子ビームで観察して、ウェーハマップ上のすべての欠陥候補を分類できる、と述べています。さらに、AIは量産中に新しい欠陥に適応し、スキャンするウェーハが増えるほど性能が上がる、とも述べています(同社の主張。独立した検証は確認できていません)事実[参考資料10]。
歩留まり解析のためのウェーハマップの分類は、研究でも広く扱われています。Wu らの IEEE Transactions on Semiconductor Manufacturing の論文(2015)は、大規模なウェーハマップの故障パターンの認識と類似検索を扱い、ここで使われたデータは WM-811K と呼ばれて、その後の多くの研究で標準的に使われています(後続の研究の記述による。原論文の本文は未確認)事実[参考資料11]。ただし、公開データは特定の製造環境の特定の時期のものであり、自社の工程に当てはまるかは別に確認が必要です(本記事による注意)。
ExtractAI の考え方は、大量の信号を少量の確かな観察で補正することですが、Applied の発表自身が、課題を「3次元のトランジスタの形成や複数工程が作る小さなばらつきが、歩留まりを損なう欠陥になり、原因の特定に時間がかかる」ことと説明しています事実[参考資料10]。分類の精度を上げても、その欠陥が、どの膜・どの洗浄・どのエッチングの、どの条件で出たかが分からなければ、歩留まりは改善しません。ウェーハマップのパターン(中心に集まる、縁に出る、線状に出る)は、材料・プロセスの原因を絞る手がかりです(本記事による解説)。
もう一つはデータの質と再現性です。装置ごとの個体差、材料のロット、校正のずれは、分類モデルの性能を変えます。公開データで高い精度が出ても、自社の工程で同じ精度が出るとは限りません。評価は自社データで、実際に使う装置の条件で行うのが筋です(本記事による解説)。
6. 計算リソグラフィとデジタルツイン ― 実運用と「探索中」を分ける
マスクのパターンを、ウェーハ上で狙いどおりの形になるよう補正する計算(計算リソグラフィ)は、膨大な計算を要します。NVIDIA は2024年3月18日の発表で、cuLitho により、この計算が40〜60倍に加速される(共同の試験で、曲線形状のフローで45倍、従来の直線形状のフローでほぼ60倍)、350台の H100 システムが4万台の CPU システムを置き換えうる、TSMC のC.C. Wei CEO が「cuLitho を TSMC の量産に移している」と述べた、としています(NVIDIA の発表と引用された幹部の発言)事実[参考資料12]。
2026年5月31日(GTC Taipei)の NVIDIA の発表は、TSMC が cuLitho を使っていること、cuLitho が CPU による従来の計算リソグラフィに比べて、費用対効果または所要時間を20〜50%改善すること(出所となる条件の記載はなし)、cuEST(化学シミュレーション)が半導体材料の設計向けに平均50倍速いこと、プロセス制御に cuML、検査に Metropolis・TAO Toolkit、工場のスケジューリングに H200 を使っていることを述べています。一方、仮想の工場環境「FabTwin」(Omniverse のライブラリを使ったデジタルツイン)は、「探索している(exploring)」段階と記しています(NVIDIA の発表。独立の検証は確認できていません)事実[参考資料13]。2024年の「40〜60倍」と2026年の「20〜50%」は、比べる対象・指標が異なり、同じ数字の更新ではありません。
デジタルツインの用語と枠組みについては、国際規格 ISO 23247-1:2021「Automation systems and integration — Digital twin framework for manufacturing — Part 1: Overview and general principles」が、製造向けのデジタルツインの枠組みの概要・一般原則として、用語と定義、要求事項を定めています(ISO のページで題名・版・状態を確認。本文は未確認)事実[参考資料15]。リソグラフィそのもの(EUV、マスク、レジスト)は本シリーズ「リソグラフィとEUV」編、エッチングは「エッチング」編で詳しく扱います。
| 項目 | 公式資料の記載 | 区分 |
|---|---|---|
| cuLitho(計算リソグラフィ) | TSMC が量産に移していると、TSMC のCEOが述べたと NVIDIA が記す(2024年)。2026年にも TSMC が使用中と記す[12・13] | 実運用(企業の報告) |
| cuML・Metropolis・TAO・H200(工場のプロセス制御・検査・スケジューリング) | 使用中と記すが、数値は定性的で記載なし[13] | 実運用(企業の報告・数値なし) |
| cuEST(半導体材料向けの化学シミュレーション) | 「平均50倍速い」と記す。比較の基準は記載なし[13] | 企業の主張 |
| FabTwin(工場のデジタルツイン) | TSMC が Omniverse のライブラリを使って「探索している」と記す[13] | 未確定/将来 構想・探索中 |
第2列は NVIDIA の発表(2024年3月18日、2026年5月31日)の記述の整理で、独立した検証は確認できていません。TSMC 自身の公式の発表の確認は、本稿では行っていません。
7. 工場のデータと標準 ― 国際半導体製造装置材料協会(SEMI) の通信・データ収集・サイバーの標準
SEMI の「スマート製造」のページは、現代の工場は何百ものセンサーから絶え間なくデータを集め、歩留まりの向上・欠陥の抑制・生産性の向上に使っている、と述べ、その基盤となる標準を一覧にしています事実[参考資料14]。AIが使うデータの流れは、装置の通信(SECS-I・SECS-II・HSMS、GEM)、装置のデータ収集(EDA:Interface A)、工程制御、データ品質、サイバーセキュリティの標準の上に載っています。確認日 2026年10月15日の一覧では、次の版が示されています事実[参考資料14]。
| 分野 | SEMI 標準(番号・版・題名) | AI・データ活用との関係(本稿の整理) |
|---|---|---|
| 装置の通信・制御 | E5-0622(SECS-II メッセージ内容)、E30-0423(GEM)、E37-0222(HSMS) | 装置からデータを取り出し、条件を送る従来からの基本的な通信 |
| 装置のデータ収集(EDA) | E120-0922(共通装置モデル)、E125-1022(装置の自己記述)、E134-1022(データ収集管理)、E164-0414(EDA 共通メタデータ)、E132-0922(クライアント認証)、E178-0120(フリーズ版の指針)、E179-0822(Protocol Buffers 共通部品) | 高速に多数のセンサーデータを集める枠組み。AIの学習・推論の入力の元になる |
| 予測分析・工程制御 | E116-0518(装置の性能追跡)、E126-0708(装置の品質情報パラメータ)、E133-1218(自動工程制御システムのインターフェース)、E157-0611(モジュール工程追跡) | 仮想計測や工程制御の入出力をつなぐ枠組み |
| データの質 | E151-1211(データ品質を理解する指針)、E160-1211(データ品質の通信) | AIに入るデータの質を伝える仕組み |
| サイバーセキュリティ | E187-0122(工場装置のサイバーセキュリティ)、E188-0222(マルウェアのない装置の統合) | データをAI基盤につなぐと攻撃対象が増えるため、装置側の要求として整理される |
第2列は SEMI の標準一覧ページの記載(番号・版・題名)。第3列は本稿の整理で、標準の本文は有料のため確認しておらず、要求事項を推測していません。
8. 本稿の計算:ダイ面積を5%小さくすると、歩留まりと取れる数はどう変わるか
設計のAIの成果として、Synopsys の発表は SK hynix の「ダイ面積を最大5%小さくした」を、Cadence の発表は MediaTek の「ダイ面積5%縮小」を、顧客の引用として載せています事実[参考資料6][参考資料7]。ダイが小さくなると、(1) 1枚のウェーハから取れるダイの数が増え、(2) 欠陥が1個のダイに入る確率が下がって歩留まりが上がります。単純なモデルで、その大きさを試算します。
本稿の計算 モデル:300 mm ウェーハ、取れるダイの総数 ≒ π(d/2)²÷A − πd÷√(2A)(d=300 mm、A=ダイ面積。端の欠けを引く一般的な近似)。歩留まり Y = exp(−A × D0)(ポアソンモデル。A はcm²、D0 は欠陥密度[個/cm²])。
ダイ面積:100 mm²(10 mm 角)から5%減の95 mm²へ。取れる総数は約640個から約676個(+5.5%)。
歩留まりと良品の数(欠陥密度 D0 ごと):D0=0.10個/cm² では、Y が 90.5% → 90.9%、良品が 579 → 614個(+6.1%)。D0=0.50個/cm² では、Y が 60.7% → 62.2%、良品が 388 → 420個(+8.2%)。
もう一つのレバー:同じ100 mm²のダイで、D0 を 0.5 から 0.1 個/cm² に下げると、Y は 60.7% から 90.5%(約1.49倍)で、ダイ面積5%縮小の効果(良品で約+6〜+8%)より大きい。
前提と限界:D0(0.05〜0.5個/cm²)は完全に仮定の値で、特定のプロセス・製品の欠陥密度ではありません。ポアソンモデルは欠陥が互いに独立で一様に散らばると仮定した単純化で、実際の欠陥は偏って集まり(クラスタリング)、歩留まりはこれより高めに出る傾向があるとされますが、本稿はその補正をしていません(これは一般的な知識で、本稿では出典を確認していません)。冗長回路による救済、パラメトリックな歩留まり損失、ウェーハ端の除外、スクライブ線の幅は含みません。設計の5%縮小が、他の性能・コストのトレードオフなしに得られるわけではありません。
Y=exp(−A×D0) では、設計のAIが A を5%小さくしても、D0 が大きければ、歩留まりはなお低いままです。D0 を下げる側(材料の純度、薄膜の均一性、洗浄・研磨の条件、装置の清浄度)は、素材・プロセスの技術者の領域で、設計のAIの成果と掛け算になります(本稿の計算に基づく解説)。AIは、ここでも「欠陥の分類」(第5章)という形で、D0 を下げる作業を速める側に入ります。
AIチップ(GPUやHBM)の需要が、ダイの大型化と先端パッケージへの要求を強めている点は、本シリーズ「AIアクセラレータ」「HBM」「CoWoS」編で扱っています。ダイが大きいほど A×D0 の指数が効くため、欠陥密度の管理の重みも増します(本記事による解説)。
9. 限界と、確認できなかったこと
- 独立した検証:Synopsys・Cadence・Applied Materials・NVIDIA の数値(3倍、5%、0.001X、40〜60倍、20〜50%など)は、企業の発表と顧客・幹部の引用で、独立の検証を確認できませんでした。TSMC 自身の公式の発表は確認していません
- AlphaChip の評価:Nature の論文、追補、ISPD 2023 の評価、双方の反論が併存し、本稿は結論を出していません。論文の本文(Nature)は確認しておらず、プレプリントの要旨、追補の書誌、DeepMind のブログ、ISPD の要旨、反論の要旨を読んだ範囲です
- 実運用の範囲:どのチップのどの設計でAIツールが使われ、どの割合を占めるかは、公式資料では確認できませんでした。テープアウトの件数(Synopsys の100件、2023年2月)は、2023年の値で、最新の件数は確認できていません
- 標準の本文:SEMI の各標準、ISO 23247-1、ISO/IEC TS 4213:2022 などは、番号・題名・版(または状態)の確認にとどまり、本文は有料で未確認です。要求事項を推測していません
- 扱っていない分野:リソグラフィ(EUV)、エッチング、成膜、洗浄・CMP、後工程(パッケージ)の個別のAI活用は、本シリーズの別編で扱います。アナログ・RF設計、DFT・テストのAI、EDAの形式検証へのAIは、本稿では詳しく扱っていません
- 実運用・社内利用・研究・探索中を分けて読みます。設計空間の探索は企業が顧客の引用つきで実運用を報告、ChipNeMo は社内利用の報告、FabTwin は探索中です事実
- AlphaChip の評価は議論が続き、本稿は結論を出しません。双方の主張と確認できなかった点を示しました事実
- 製造では欠陥の分類と、データの標準が基盤です。Applied は光学検査と電子ビーム観察をAIでつなぎ、SEMI の EDA 標準などが工場のデータを支えます事実
- 歩留まりは面積と欠陥密度の両方の指数に入ります。本稿の計算で、ダイ面積5%減は良品数で約+6〜+8%、D0 を0.5→0.1個/cm²にする効果はより大きくなりました本稿の計算
- 評価と標準は、SEMI の標準が通信・データ・サイバーを、ISO 23247 がデジタルツインの枠組みを扱い、AIの成果そのものの合否を定める国際規格は確認できませんでした事実
10. 評価・標準の読み方
設計のAIは、(1) PPA(消費電力・性能・面積)とテープアウトまでの時間、(2) 比較の基準(人手の設計・旧版のツール・別のアルゴリズム)、(3) 再現性(同じ条件で別の主体が再現できるか)、で評価し、製造のAIは、(1) 検出・分類の精度(見逃しと誤報)、(2) 歩留まりやサイクルタイムへの効果、(3) データの質と標準、で評価します。業界全体の合意された「AI設計のベンチマーク」は、本稿の調査では確認できず、各社の自己報告、公開データを用いた研究の評価、規格・標準の3つを組み合わせて読むことになります。
| 評価項目 | 代表的な評価手法・資料(名称・出典) | 標準・指針 | 読み方の注意 |
|---|---|---|---|
| 設計の最適化の成果(PPA) | 企業の発表(Synopsys 2023年2月7日、Cadence 2022年6月9日)[6・7]。研究では、Nature の論文[1]、ISPD 2023 の再評価[4]と、公開ベンチマーク(MacroPlacement リポジトリ)[4]事実 | 確認できなかった(AI設計の成果を判定する国際規格) | 比較の基準・ブロック・プロセス・ツールの版を確認。再現の条件(事前学習、計算資源、収束)が評価を左右する[4・5] |
| 言語モデルの設計支援 | ChipNeMo(NVIDIA の自社評価)[8]、VerilogEval(HDLBits 156問、機能の正しさを自動確認)[9]事実 | ISO/IEC TS 4213:2022(機械学習の分類性能の評価)、ISO/IEC TS 25058:2024(AIシステムの品質評価の指針)。題名・状態のみ確認[16]事実 | 小さな課題の正答率は、実設計の品質ではない。生成物は検証して使う |
| 欠陥検査・歩留まり解析 | Applied Materials ExtractAI(0.001X のサンプル、企業の主張)[10]、ウェーハマップの公開データ(WM-811K、Wu ら)[11]事実 | ISO/IEC TS 4213:2022(分類性能の評価)、ISO/IEC 5259 シリーズ(データ品質)、SEMI E151・E160(データ品質)[14・16]事実 | 見逃しと誤報の両方、自社データ・自社装置での再評価。公開データは特定の環境のもの |
| 工場のデータ・通信・安全 | 確認できなかった(個別の工場の適合状況) | SEMI E5-0622、E30-0423、E120-0922、E125-1022、E134-1022、E164-0414、E133-1218、E151-1211、E160-1211、E187-0122、E188-0222(番号・版・題名を SEMI のページで確認)[14]事実 | 標準は通信・データの取り決めで、AIの性能の合否を決めない。本文は有料で未確認 |
| デジタルツイン | FabTwin(NVIDIA・TSMC の探索中の取り組み)[13]未確定/将来 | ISO 23247-1:2021(製造向けデジタルツインの枠組み・概要と一般原則)[15]事実 | 「デジタルツイン」の語は幅広く使われる。実運用かを、公式資料の記載(探索中・使用中)で区別する |
| 計算リソグラフィの加速 | NVIDIA の発表(2024年3月18日:40〜60倍。2026年5月31日:20〜50%)[12・13]事実(企業の主張) | 確認できなかった | 比較対象・指標が異なる数字は別物。独立の検証は確認できていない |
区分タグは各セルに付けています。SEMI・ISO のページは2026年10月15日にブラウザで確認しました。表の整理は本稿によるものです。
読み方の注意は3つです。
- 誰の報告か:企業の発表と顧客・幹部の引用は、独立の検証ではありません。評価の議論がある成果(AlphaChip)は、双方の主張を読み、再現の条件(事前学習・計算資源・収束)を確認します
- 何と比べたか:人手の設計、旧版のツール、別のアルゴリズム、CPU の計算など、比較の基準が違う倍率は別の数字です。2024年の「40〜60倍」と2026年の「20〜50%」のように、指標が違えば更新ではありません
- 標準は「データと通信」が中心:SEMI の標準は装置・工場のデータ・通信・安全を、ISO 23247 はデジタルツインの枠組みを扱い、AIの成果の合否は定めません。標準は「要求」か「推奨」かを本文で確認する必要がありますが、本稿は本文を未確認です
11. 用語集
- EDA
- Electronic design automation。チップ設計のソフトウェア。
- PPA
- Power, performance, area。消費電力・性能・面積。
- RTL
- Register-transfer level。回路の動きを記述する設計の段階。
- 配置(フロアプラン)
- 回路のブロックをチップ上のどこに置くかを決める工程。
- テープアウト
- 製造のための設計データを完成して送り出すこと。
- 歩留まり
- 作ったダイのうち良品の割合。
- 欠陥密度 D0
- 単位面積あたりの致命的な欠陥の数。
- 計算リソグラフィ
- マスクのパターンを、ウェーハ上で狙いどおりになるよう計算で補正すること。
- デジタルツイン
- 実物の工場・装置を仮想空間に写したモデル。
- SECS/GEM/EDA
- SEMI の装置通信・データ収集の標準群。
- PoC
- Proof of concept。実証の段階(量産・実運用とは区別する)。
- 仮想計測
- 装置のデータから、測っていない品質を予測すること。
12. 参考資料(一次情報)
- Mirhoseini A. ほか(Google) "A graph placement methodology for fast chip design", Nature (2021), DOI 10.1038/s41586-021-03544-w。プレプリント "Chip Placement with Deep Reinforcement Learning", arXiv 2004.10746(6時間未満・超人的または同等という記述) — arxiv.org/abs/2004.10746
- Nature "Addendum: A graph placement methodology for fast chip design", Nature (2024年9月26日), DOI 10.1038/s41586-024-08032-5(書誌の確認のみ) — doi.org/10.1038/s41586-024-08032-5
- Goldie A., Mirhoseini A.(Google DeepMind) "How AlphaChip transformed computer chip design", Google DeepMind ブログ (2024年9月26日)(TPU の複数世代、Axion、MediaTek、事前学習チェックポイントの公開) — deepmind.google/blog/how-alphachip-transformed-computer-c...
- Cheng C.-K. ほか "Assessment of Reinforcement Learning for Macro Placement", ISPD 2023, DOI 10.1145/3569052.3578926。更新版 "An Updated Assessment of Reinforcement Learning for Macro Placement", arXiv 2302.11014 — arxiv.org/abs/2302.11014
- Goldie A. ほか "That Chip Has Sailed: A Critique of Unfounded Skepticism Around AI for Chip Design", arXiv 2411.10053 (2024) — arxiv.org/abs/2411.10053
- Synopsys "AI-designed Chips Reach Scale with First 100 Commercial Tape-outs Using Synopsys Technology"(2023年2月7日。DSO.ai、STMicroelectronics・SK hynix の引用) — news.synopsys.com/2023-02-07-AI-designed-Chips-Reach-Scal...
- Cadence "Cadence Cerebrus AI-Based Solution Delivers Transformative Results on Next-Generation Customer Designs"(2022年6月9日。MediaTek・Renesas の引用) — cadence.com/en_US/home/company/newsroom/press-releases/pr...
- Liu M. ほか(NVIDIA) "ChipNeMo: Domain-Adapted LLMs for Chip Design", arXiv 2311.00176 (2023) — arxiv.org/abs/2311.00176
- Liu M. ほか(NVIDIA) "VerilogEval: Evaluating Large Language Models for Verilog Code Generation", arXiv 2309.07544 (2023) — arxiv.org/abs/2309.07544
- Applied Materials "Applied Materials Introduces New Playbook for Process Control Based on Big Data and AI"(2021年3月16日。Enlight、ExtractAI、SEMVision) — ir.appliedmaterials.com/news-releases/news-release-detail...
- Wu M.-J. ほか "Wafer Map Failure Pattern Recognition and Similarity Ranking for Large-Scale Data Sets", IEEE Trans. Semiconductor Manufacturing 28(1) (2015), DOI 10.1109/TSM.2014.2364237(書誌を Crossref で確認。本文は未確認) — doi.org/10.1109/TSM.2014.2364237
- NVIDIA "NVIDIA cuLitho Accelerates Semiconductor Manufacturing's Most Compute-Intensive Workload by 40-60x" / "TSMC and Synopsys Bring Breakthrough NVIDIA Computational Lithography Platform to Production"(2024年3月18日) — nvidianews.nvidia.com/news/tsmc-synopsys-nvidia-culitho
- NVIDIA "NVIDIA and TSMC Bring AI Into Fabs to Advance Semiconductor Design and Manufacturing"(2026年5月31日、GTC Taipei。cuLitho 20〜50%、cuEST、FabTwin は探索中) — nvidianews.nvidia.com/news/nvidia-and-tsmc-bring-ai-into-...
- SEMI "SEMI Smart Manufacturing Standards"(SECS/GEM、EDA、データ品質、サイバーなどの標準の番号・版・題名の一覧/確認日 2026年10月15日) — semi.org/en/industry-groups/smart-manufacturing/standards
- ISO "ISO 23247-1:2021 Automation systems and integration — Digital twin framework for manufacturing — Part 1: Overview and general principles"(第1版、2021年10月。ISO/TC 184/SC 4) — iso.org/standard/75066.html
- ISO/IEC JTC 1/SC 42 SC 42「Artificial intelligence」の規格一覧(ISO/IEC TS 4213:2022、TS 25058:2024、5259 シリーズなど/確認日 2026年10月15日) — iso.org/committee/6794475/x/catalogue/p/1/u/0/w/0/d/0
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| チップ配置を強化学習で扱い、6時間未満で超人的または同等の配置、既存のベースラインは人間が介在し数週間(プレプリントの要旨) | 出典1 https://arxiv.org/abs/2004.10746 | 事実 |
| Nature の追補(2024年9月26日)の書誌 | 出典2 https://doi.org/10.1038/s41586-024-08032-5 | 事実 |
| Google DeepMind のブログ:AlphaChip の名称、TPU の複数世代(v5e・v5p・Trillium)、Axion、MediaTek、事前学習チェックポイントの公開、時間の主張。独立した批判は含まない | 出典3 https://deepmind.google/blog/how-alphachip-transformed-computer-chip-design/ | 事実 |
| ISPD 2023 の再評価(より強い焼きなまし法のベースライン、商用ツールで配線後のPPA、公開ベンチマーク、再現性と、スケーラビリティ・事前学習の「確認の不足」) | 出典4 https://arxiv.org/abs/2302.11014 | 事実 |
| Google 側の反論(事前学習をしていない、計算資源が少ない、収束まで学習していない、代表的でないテストケース、査読されていない招待論文との記述) | 著者の記述。どちらが正しいかは本稿では判断しない 出典5 https://arxiv.org/abs/2411.10053 | 事実 |
| Synopsys:DSO.ai の商用テープアウト100件(2023年2月7日)、強化学習による探索、STMicroelectronics の PPA 探索の生産性3倍超、SK hynix のダイ面積最大5%縮小 | 出典6 https://news.synopsys.com/2023-02-07-AI-designed-Chips-Reach-Scale-with-First-100-Commercial-Tape-outs-Using-Synopsys-Technology | 事実 |
| Cadence:Cerebrus(強化学習)、MediaTek のダイ面積5%縮小・消費電力6%超削減、Renesas の TNS 75%改善(2022年6月9日)、量産フローへの採用 | 出典7 https://www.cadence.com/en_US/home/company/newsroom/press-releases/pr/2022/cadence-cerebrus-ai-based-solution-delivers-transformative.html | 事実 |
| ChipNeMo:ドメイン適応の手法、3つの用途、ChipNeMo-70B が2用途で GPT-4 を上回る(NVIDIA の自社評価) | 出典8 https://arxiv.org/abs/2311.00176 | 事実 |
| VerilogEval:HDLBits の156問、シミュレーションで機能の正しさを自動確認 | 出典9 https://arxiv.org/abs/2309.07544 | 事実 |
| Applied Materials:ExtractAI、光学検査と電子ビーム観察の連携、サンプルの0.001Xで分類、量産中の適応(2021年3月16日、企業の主張) | 出典10 https://ir.appliedmaterials.com/news-releases/news-release-details/applied-materials-introduces-new-playbook-process-control-based/ | 事実 |
| Wu らの論文の書誌(IEEE TSM 28(1), 2015, DOI)と、ウェーハマップの故障パターン認識・類似検索を扱うこと | 出典11 https://doi.org/10.1109/TSM.2014.2364237 | 事実 |
| NVIDIA(2024年3月18日):cuLitho 40〜60倍(曲線形状で45倍・直線形状でほぼ60倍)、350台のH100が4万台のCPUを置換、TSMC CEO の「量産に移している」発言 | 出典12 https://nvidianews.nvidia.com/news/tsmc-synopsys-nvidia-culitho | 事実 |
| NVIDIA(2026年5月31日):TSMC が cuLitho を使用、20〜50%の改善、cuEST 平均50倍、cuML・Metropolis・TAO・H200の使用、FabTwin は探索中 | 出典13 https://nvidianews.nvidia.com/news/nvidia-and-tsmc-bring-ai-into-fabs-to-advance-semiconductor-design-and-manufacturing | 事実 |
| FabTwin は「探索中」であり、実運用ではないこと | 出典13 https://nvidianews.nvidia.com/news/nvidia-and-tsmc-bring-ai-into-fabs-to-advance-semiconductor-design-and-manufacturing | 未確定/将来 |
| SEMI 標準の番号・版・題名(E5-0622、E30-0423、E37-0222、E116-0518、E120-0922、E125-1022、E126-0708、E132-0922、E133-1218、E134-1022、E151-1211、E157-0611、E160-1211、E164-0414、E178-0120、E179-0822、E187-0122、E188-0222)と、現代の工場が何百ものセンサーからデータを集めるという記述 | 出典14 https://www.semi.org/en/industry-groups/smart-manufacturing/standards | 事実 |
| ISO 23247-1:2021 の題名・版・状態と、概要・一般原則(用語・定義、要求事項) | 出典15 https://www.iso.org/standard/75066.html | 事実 |
| ISO/IEC TS 4213:2022、TS 25058:2024、5259 シリーズの題名・版・状態 | 出典16 https://www.iso.org/committee/6794475/x/catalogue/p/1/u/0/w/0/d/0 | 事実 |
| 300 mm ウェーハの取れるダイ数(100 mm²で約640、95 mm²で約676)、ポアソンモデルでの歩留まりと良品数(D0=0.05・0.1・0.3・0.5個/cm²)、D0 を0.5→0.1にした効果 | 本稿の計算。D0 は仮定の値で、ポアソンモデルは単純化(欠陥の偏りや冗長回路の救済を含まない)。特定のプロセス・製品の予測ではない | 本稿の計算 |
| 「設計のAIは配線と層の物理を探索する道具」「分類は材料の原因につなげて初めて歩留まりになる」「歩留まりの指数に入る面積は設計・欠陥密度は材料とプロセス」という読み取り。プロセス特性評価の精度がボトルネックになりうるという見方(推測) | 公表内容にもとづく本記事の整理・解説。各社が表明した見解ではない | 解説 |
| 企業の数値の独立した検証、AlphaChip 評価の結論、実運用の範囲、標準の本文、TSMC 自身の公式発表 | 本稿の調査範囲では確認できなかったため記載していない。解説 | 解説 |
最終更新:2026年10月15日/出典は一次情報(Nature の書誌、Google DeepMind・Synopsys・Cadence・Applied Materials・NVIDIA の公式発表、論文、SEMI と ISO の公式ページ)に限定しています。企業の数値の独立した検証、AlphaChip 評価の結論、実運用の範囲、標準の本文については、確認できなかったため記載していません。企業の構想・探索中の取り組みは「未確定/将来」です。図2・5はベクター作図、図4は本稿の計算を含む作図、図1と図6はAI生成イメージ(枠のみ)です。