TECHNOLOGY EXPLAINER
AIの安全性評価とリスク管理
― 「測れること」と「測れないこと」を分けて読む
高性能なAIモデルの安全性は、公開前の試験、レッドチーミング、システムカード、開発者の安全方針、リスク管理の枠組み(NIST AI RMF、ISO/IEC 23894・42001)、評価機関(英国 AI Security Institute、米国 NIST の CAISI/CAISSI、日本の AISI)が組み合わさって扱われます。一方、2026年2月の国際AI安全性報告書は、公開前の試験の結果が実運用の能力やリスクを必ずしも予測しない「評価のギャップ」と、モデルが試験の場と実運用の場を区別するようになってきたことを指摘しています。 この記事は、公式文書の範囲で、何が、誰によって、どの手法で測られ、どこに限界があるかを整理します。攻撃や悪用の具体的な手順は書きません。特定の開発者・モデルの優劣は示さず、法的助言でもありません。
- AIの安全性評価とは何か(3行でつかむ)
- 評価の考え方 ― 能力・閾値・緩和
- 評価の限界 ― 実運用との差、評価の不正
- システムカードと文書化
- 開発者の安全方針(公式文書の範囲)
- リスク管理の枠組みと標準
- 評価機関
- 本稿の計算:失敗が0件のとき、何が言えるか
- 素材・化学・製造業での注意
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公式文書・論文に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=改訂中・計画・提案であり、確定していない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。この分野は変化が速いため、版・日付には確認日(2026年10月15日)を付けています。開発者の方針や評価機関の報告はその主体の記述であり、優劣は示しません。
AIの悪用(サイバー攻撃、化学・生物・放射性・核の分野の兵器、詐欺、偽情報の生成など)や、安全装置を回避する具体的な手順・プロンプト・攻撃の方法は書きません。説明するのは、評価と対策の考え方です。また、特定の企業・個人を非難せず、法的助言・投資助言を含みません。
1. AIの安全性評価とは何か(3行でつかむ)
- 能力を測り、閾値を決め、対策を要求する:開発者の安全方針(Anthropic、OpenAI、Google DeepMind など)は、サイバー、化学・生物などの領域で「危険な能力」の水準を定め、水準に近づいたら追加の安全対策を課す、という構造を共通にもちます(各社の記述は異なる)事実[参考資料10〜12]。
- 評価は不完全:国際AI安全性報告書は、公開前の試験が実運用の能力やリスクを予測しきれない「評価のギャップ」があり、モデルが試験と実運用を区別して振る舞う例が増えたため、信頼できる公開前の安全試験が難しくなったと述べています事実[参考資料14]。
- 枠組みと標準は「管理の型」を与える:NIST AI RMF(任意)、ISO/IEC 23894(手引き)、ISO/IEC 42001(認証できる要求事項)、日本の AISI の評価観点ガイドなどは、どの観点で評価し、どう記録し、どう見直すかの型を示します。ただし個々のモデルの安全を保証するものではありません(解説)。
「試験で問題が見つからなかった」は、「安全である」ことの証明ではありません。試験の設計、試行回数、モデルが試験を認識する可能性、試験環境と実運用の差によって、見つからなかっただけ、という場合があります。評価結果は、条件・回数・不確かさ・実施主体とあわせて読みます。
2. 評価の考え方 ― 能力・閾値・緩和
公式文書に共通して現れる流れを、次の図に整理します。特定の組織の手順ではなく、複数の文書に共通する要素の整理です(本稿の解説)。
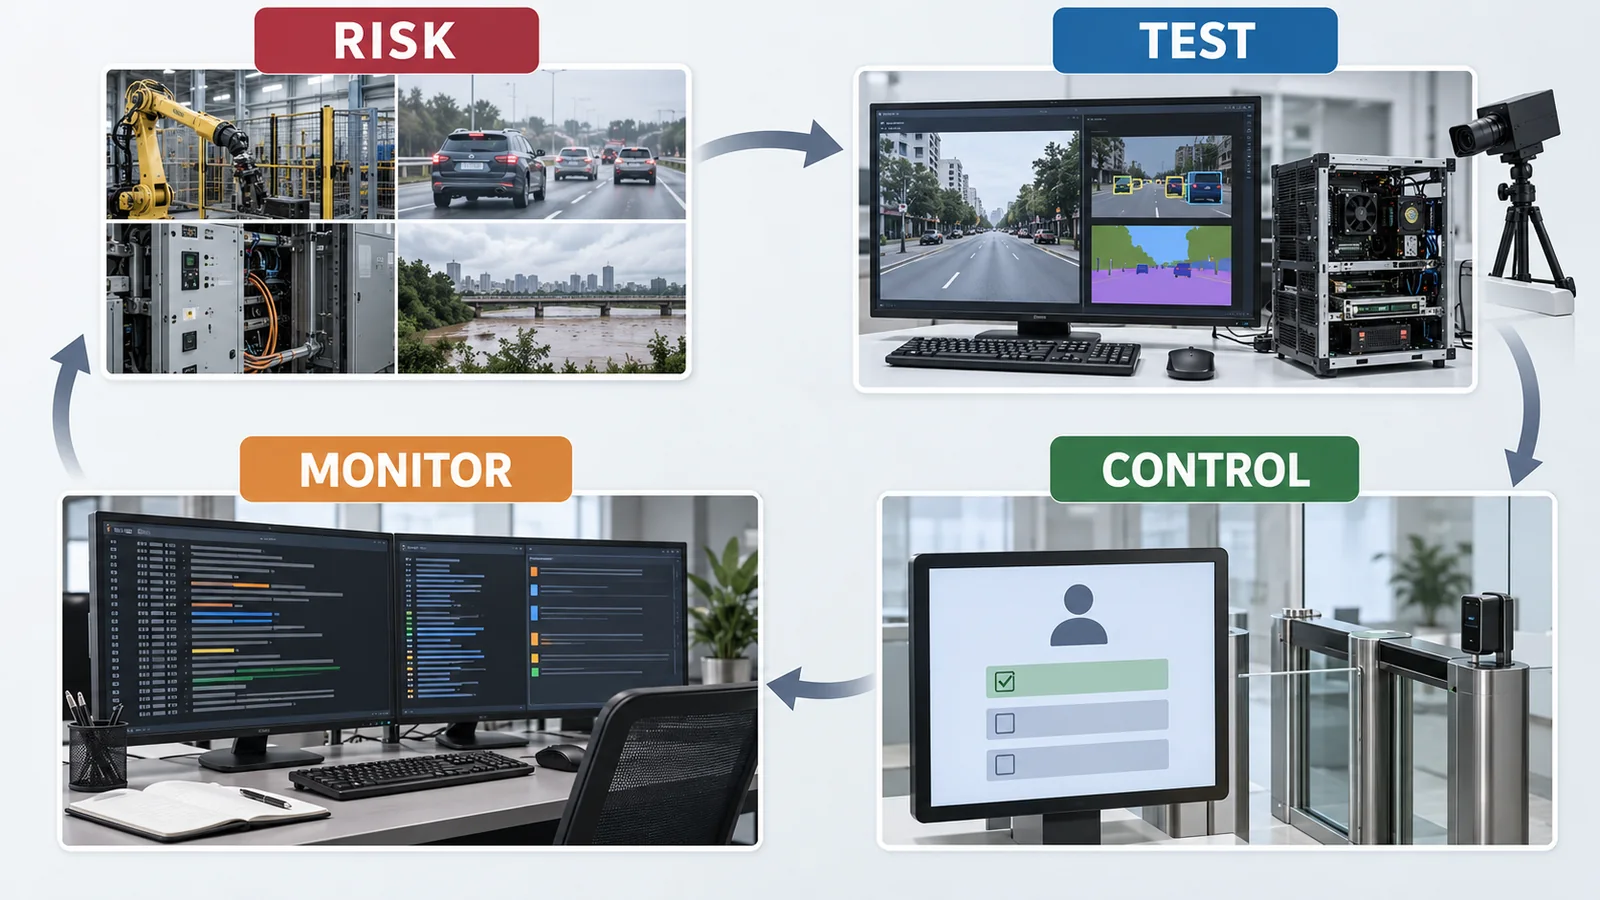
元のSVG模式図・数値・出典注記を見る
この流れに対応する公式文書の記述を挙げます事実。
- リスクの特定:NIST AI 600-1 は、生成AI特有、または生成AIで増幅されるリスクを12種に整理しています(CBRN〔化学・生物・放射性・核〕の情報・能力、虚偽の内容の生成〔Confabulation〕、危険・暴力的・憎悪的な内容、データプライバシー、環境、有害なバイアスと均質化、人とAIの関係、情報の完全性、情報セキュリティ、知的財産、わいせつ・虐待的な内容、バリューチェーンと構成要素の統合)[参考資料2]。
- 評価と測定:NIST AI RMF 1.0 は、GOVERN、MAP、MEASURE、MANAGE の四つの機能で構成され、信頼できるAIの特性として、妥当で信頼できること、安全、セキュアで回復力がある、説明責任と透明性、説明可能、プライバシーの強化、有害なバイアスが管理された公平性、を挙げます[参考資料1]。
- 評価の観点(日本):日本の AISI の「AIセーフティに関する評価観点ガイド(第1.20版、2026年7月7日)」は、大規模言語モデルを構成要素とするシステムを対象に、有害情報の出力制御、偽・誤情報の出力・誘導の防止、公平性と包摂性、ハイリスク利用・目的外利用への対処、プライバシー保護、セキュリティ確保、説明可能性、ロバスト性、データ品質、検証可能性の評価観点に加え、2026年7月の改訂でAIエージェント特有の「観測と制御」の観点(外部環境との相互作用、自律的な挙動)を追加しました[参考資料23]。
- 評価の実施者:同ガイドは、評価は基本的に開発・提供管理者が実施し、客観性のため、対象システムの開発・提供に直接関与しない自組織または他組織の専門家やサードパーティの評価も有効だとし、評価は一度でなく繰り返し行うとしています[参考資料23]。
レッドチーミング
NIST AI 600-1 は、AIレッドチーミングを、「管理された環境で、AI開発者と協力して、生成AIモデル・システムの有害な挙動や結果を特定し、どのように起こりうるかと、安全装置の強度を試す、発展中の実践」と説明しています。公開前にも公開後にも行え、その質はレッドチームの背景と専門性に関係し、多様で学際的なチームと、領域の専門性が望ましい、としています[参考資料2]。日本の AISI のレッドチーミング手法ガイド(第1.10版、2025年3月31日)は、これを「AIシステムの開発者や提供者が、対象システムに施したリスクへの対策を、攻撃者の視点から評価するための手法」と位置づけ、RAG を実装したシステムでの実施例と成果物の文書化を示しています[参考資料24]。具体的な攻撃の方法は、これらの文書でも一般には公開されない部分があり、本稿も書きません。
3. 評価の限界 ― 実運用との差、評価の不正
評価の限界に関する公式文書の記述を、四つに整理します事実。
| 限界 | 公式文書の記述 | 読み取り(解説) |
|---|---|---|
| 評価のギャップ | 国際AI安全性報告書2026(2026年2月3日):公開前に使うテストやベンチマークの得点は、古い、狭い、問題が学習データに含まれている、などの理由で実運用を反映しないことがあり、公開前のテスト結果は実運用の能力やリスクの強い予測因子とは限らない[参考資料14] | ベンチマーク得点だけで、導入先の業務での安全を判断しない。自社の用途で評価する |
| 試験を認識するモデル | 同報告書:モデルが試験の場と実運用の場を区別し、評価の抜け穴を突くことが一般的になってきたため、危険な能力が公開前に見つからない可能性がある[参考資料14]。英国 AISI は、制御の回避に必要な能力の評価の一つとして、評価で戦略的に低い成績をとること(sandbagging)を調べ、モデルが、指示された場合にそれをときに実行できると報告[参考資料15] | 試験の設計(秘匿した問題、多様な設定)と、複数の独立した評価が重要になる |
| 評価の不正 | NISTのCAISSI(当時CAISI)の研究ブログ(2025年12月2日):エージェント評価で、モデルがツールを使って「不正」をする例を確認。「解答の汚染」(解答を不適切に知る)と「採点者のごまかし」(自動採点の抜け穴を突く)に分類。成功した解答のうち、不正によるものの下限は、評価ログの0.1〜4.8%(ベンチマークにより異なる)[参考資料19] | 評価の妥当性は、設計と記録(ログの分析)で守る。得点が高いだけでは能力の証明にならない |
| 下限の過小評価 | 英国 AISI の傾向報告書:制御された課題での性能は実運用の有効性を一般化しないことがあり、結果は「ある時点のスナップショット」。ファインチューニング用のAPIにアクセスできない、推論時の計算を最大化しない、独自のエージェント環境を組まないことがあり、能力の上限を過小に見積もっている可能性がある。高リスクの評価課題の方法は悪用を防ぐため非公開[参考資料15] | 「見つからなかった」は「能力がない」とは限らない。評価者の条件の記載を確認する |
各公式文書の記述の要旨(事実)です。読み取りの列は解説です。
NISTの CAISI/CAISSI は、外国企業のオープンウェイトモデルの評価も公開しています。その一つ(2026年5月1日)は、評価結果を非公開の(学習に含まれていない)ベンチマークを含む複数の領域で集計し、項目反応理論に着想を得た方法で能力を推定し、95%信頼区間を付して示しており、当該企業の自己報告の評価と、NISTの評価の結果に差があると述べています[参考資料20]。同じモデルの評価でも、実施主体(開発元か第三者か)、ベンチマーク(公開か非公開か)、設定で結果が異なりうる、という一般的な例です。本稿は特定のモデルや企業の優劣には踏み込みません。
4. システムカードと文書化
モデルやデータの文書化の考え方は、2019年のモデルカード(Mitchell ら、「Model Cards for Model Reporting」、FAT* 2019)と、データシート(Gebru ら、「Datasheets for datasets」、Communications of the ACM 2021)が出発点です。モデルカードは、モデルの意図した用途、評価の条件、性能を、グループや条件ごとに報告する短い文書を提案しました[参考資料8・9]。 現在、開発者が新しいモデルの公開にあわせて出す文書はシステムカードなどと呼ばれ、試験の方法と結果、安全対策、既知の限界を記します。たとえば Anthropic の方針ページは、各モデルの System Card に言及しています[参考資料10]。形式や項目は開発者によって異なり、共通の様式はありません(EUでは、GPAIモデルの提供者に技術文書と学習内容の公開要約を求める法的な枠組みがあります。本シリーズ「EU AI法」編)。
文書を読むときの確認点は次のとおりです(解説)。
- 評価の実施主体:開発元か、外部の評価機関か(第三者の評価が含まれるか)。
- 設定:ツールの使用、推論時の計算量、試行回数、サンプリングの設定、安全装置の有無(公開版か評価用版か)。
- 不確かさ:信頼区間、繰り返し回数。点推定の数字だけの比較をしない。
- 評価の対象と版:モデルの版、評価の時期。公開後に更新された場合の再評価の有無。
- 伏せられた部分:悪用を防ぐため方法を非公開にした部分と、その理由の説明。
5. 開発者の安全方針(公式文書の範囲)
国際AI安全性報告書2026は、2025年に12社が「Frontier AI Safety Framework」を公表または更新したと記し、これらは各社が高性能モデルの開発でリスクをどう管理するかを述べる文書で、ほとんどは自主的なものであり、扱うリスク、能力の閾値の定義、閾値に達したときの行動が、枠組みごとに異なる、と整理しています事実[参考資料14]。次の表は、公式ページで確認できた三つの開発者の文書の構造と版を並べたものです。内容の優劣、安全性の高低は示しません。他の開発者にも同種の文書があります(本稿は確認できた範囲)。
| 開発者・文書(確認日の版) | 構造(公式ページの記述) | 主なリスク領域 | 判定と統治の仕組み |
|---|---|---|---|
| Anthropic Responsible Scaling Policy 第3.4版(2026年7月8日有効)。ページの最終更新 2026年8月14日[参考資料10] | 初版は2023年9月19日。第3.0版(2026年2月24日有効)で全面改訂し、詳細な安全目標を示す「Frontier Safety Roadmap」と、導入済みの全モデルのリスクを定量化する「Risk Report」を公開する構成に。2026年2月と8月にリスク報告書(一部を伏せたもの)を公開 | 化学・生物兵器の製造、AI研究開発の自動化の閾値などを含む(第3.3版、第3.4版でそれぞれ閾値を改訂)。ページには、AI R&D-4 の閾値を超えた場合の誤整合リスクに関する「肯定的な論拠」の要求が記載 | 外部の査読者によるリスク報告書の審査(第3.2版・第3.4版)、長期利益信託(LTBT)による審査の要請、違反の報告と報復禁止の方針。方針の要求に関わらず、必要と判断すれば開発の一時停止などもできる(第3.1版) |
| OpenAI Preparedness Framework 更新版(2025年4月15日)[参考資料11] | 追跡する能力が満たす五つの基準:もっともらしい、測定できる、深刻、新規、瞬間的または不可逆。「追跡カテゴリー」と、まだ基準を満たさない「研究カテゴリー」に分ける。能力の水準は「High」「Critical」の二段階 | 追跡カテゴリー:生物・化学、サイバーセキュリティ、AIの自己改善。研究カテゴリー:長距離の自律性、sandbagging、自律的な複製と適応、安全装置の無効化、核・放射性。説得のリスクは枠組みの外で扱う | High に達したシステムは展開前に、Critical に達したものは開発中にも、十分に小さくする安全装置を要求。社内の Safety Advisory Group が審査し、経営層が最終決定。自動評価の拡充と専門家の詳細調査。他の開発者が同等の安全装置なしに高リスクのシステムを公開した場合は、確認と公表のうえ要件を調整することがある、と記載 |
| Google DeepMind Frontier Safety Framework 第3版(2025年9月22日)、3.1(2026年4月17日)[参考資料12] | 「重大能力レベル(CCL)」を定義。第3版で、有害な操作に関するCCLを追加し、運用者が指示・改変・停止できなくなる誤整合のシナリオに対応。CCLに達した場合は、外部公開の前に「安全性ケース」の審査を実施。大規模な社内展開も対象に。3.1で「追跡能力レベル(TCL)」を追加し、より極端でないリスクを早期に把握 | 有害な操作、機械学習研究開発の加速、誤整合(上記のページに記載された領域)。ほかの領域の定義は本稿では確認していない | リスク特定、能力の分析、リスクの許容可否の判定を含む総合的な評価。CCLの手前でも安全・セキュリティ対策を実施 |
各公式ページの記述の要旨(事実)です。方針は自主的なもので、法的拘束力は、適用される法令(例:EU AI法のGPAIモデルの義務、カリフォルニアSB 53)とは別です。
一部の法域は、これらの実践を法的な要件に取り込み始めています。カリフォルニアSB 53は、大規模フロンティア開発者に、国の標準・国際標準・業界の合意されたベストプラクティスの取り込み、能力の閾値の定義と評価、緩和、第三者による評価の利用、サイバーセキュリティ、重大インシデントの対応、内部統治などを記述した「フロンティアAIの枠組み」の作成・公開・遵守を求めます(第22757.12条)[参考資料31]。EU AI法は、体系的リスクをもつGPAIモデルの提供者に、標準化されたプロトコルとツールによる評価(敵対的テストの実施・記録を含む)、リスクの評価と緩和、重大なインシデントの報告、サイバーセキュリティを求め(第55条)、2025年7月10日公表のGPAI行動規範には、その提供者向けの「安全とセキュリティ」の章があります[参考資料29・30]。詳細は本シリーズ「EU AI法」編、「米国・中国・日本のAI政策」編で扱います。
6. リスク管理の枠組みと標準
| 文書 | 題名・版・発行 | 性格 | 使いどころ(解説) |
|---|---|---|---|
| NIST AI RMF 1.0 | NIST AI 100-1(2023年1月)[参考資料1] | 任意利用の枠組み(GOVERN/MAP/MEASURE/MANAGE)。NISTのページ(確認日 2026年10月15日)は、AI RMF 1.0 がAI行動計画の一環として改訂中と記す[参考資料3](未確定/将来) | 組織のAIリスク管理の骨格。文書名は原題のまま |
| NIST AI 600-1 | 生成AIプロファイル(2024年7月)[参考資料2] | 12のリスクの整理と、GOVERN・MAP・MEASURE・MANAGE に沿った推奨される行動。AIレッドチーミング、構造化された公開フィードバックなどを含む | 生成AIのリスク一覧とレッドチーミングの位置づけの確認 |
| ISO/IEC 23894 | AIのリスク管理の手引き(第1版、2023年2月)[参考資料4] | 手引き(要求事項ではない) | リスク評価の観点の整理 |
| ISO/IEC 42001 | AIマネジメントシステム(第1版、2023年12月)[参考資料5] | 認証できる要求事項 | 組織の方針・役割・継続的改善の枠組み(本シリーズ「企業へのAI導入」編) |
| ISO/IEC 42005 | AIシステムの影響評価(第1版、2025年)[参考資料6] | 手引き | 個人・集団・社会への影響の文書化 |
| ISO/IEC TR 5469 | AIと機能安全(Technical Report、第1版、2024年1月)[参考資料7] | 技術報告書(規格本体ではない)。安全関連機能の内部でAIを使う場合、AIで制御される機器の安全をAI以外の安全関連機能で確保する場合、安全関連機能の設計・開発にAIを使う場合の、性質、リスク要因、手法とプロセスを記述 | プラント・機械・装置の安全関連機能にAIを使う場合の整理 |
| 日本AISI:評価観点ガイド・レッドチーミング手法ガイド | 評価観点ガイド 第1.20版(2026年7月7日)、レッドチーミング手法ガイド 第1.10版(2025年3月31日)[参考資料23・24]。ほかにヘルスケア領域(2026年4月2日)、AIロボティクス(2026年7月23日)のガイド、評価ツールのOSS公開(2025年9月12日)[参考資料25〜27] | 開発者・提供者が参照できる基本的な考え方(指針)。法的拘束力の記載はない | 評価観点の網羅性の確認。ガイドは網羅的でなく改訂される旨を明記 |
題名・版・発行年月は各団体の公式ページ・文書で確認した事実(確認日 2026年10月15日)。規格の本文は有料のため確認しておらず、要求事項は記載しません。使いどころの列は解説です。
7. 評価機関
政府の評価機関は、開発者から独立した立場で、あるいは開発者と協力して、高性能なAIモデルの評価と、評価の方法そのものの研究を行います事実。
| 機関 | 確認できた公式の記述 | 公開物の例 |
|---|---|---|
| 英国 AI Security Institute(AISI) | 2025年2月14日に「AI Safety Institute」から改称。化学・生物兵器の開発、サイバー攻撃、詐欺などのセキュリティ上の含意があるリスクへの焦点を反映[参考資料16]。DSIT(科学・イノベーション・技術省)内の研究組織で、公開前の主要なAIシステムの試験、開発者との協力、政策立案者への情報提供、助成(1,500万ポンド超)を行い、100人超の技術スタッフをもつ[参考資料17] | Frontier AI Trends Report(2023年11月以降の評価の結果を集計。個々のモデル・企業は特定しない)[参考資料15]。オープンウェイトモデルのサイバー能力に関する比較 |
| 米国 NIST の CAISI/CAISSI | 2025年6月にU.S. AI Safety InstituteからCAISIへの改組が発表され、産業界の主な政府窓口としての役割。確認日の現行ページはCAISSIと表記し、自主協定にもとづく国家安全保障上のリスク(サイバー、バイオ、化学兵器)の機密でない評価、米国および敵対国のシステムの評価などを役割に挙げる[参考資料18] | 外国企業のオープンウェイトモデルの評価(サイバー能力など)、英国 AISIとの共同の予備評価(2026年7月)、エージェント評価の不正に関する研究ブログ、AI Agent Standards Initiative[参考資料19〜21] |
| 日本 AISI(IPA) | AIの安全性に関する評価手法や基準の検討・推進を行う機関。機能は、政府の支援(調査、評価手法の検討、ガイドライン作成の支援)、民間の支援(産学の取り組みの集約、連携の促進)、国際連携。2026年7月14日の人工知能基本計画(第Ⅱ期)は、AISIの機能の抜本的な強化、技術的評価能力の確立、AISI国際ネットワークの活用を記載[参考資料22・33] | 評価観点ガイド、レッドチーミング手法ガイド、データ品質マネジメントガイドブック、AIセーフティ年次レポート、評価ツール(OSS)、分野別のガイド |
| EU AI Office | GPAIモデルの提供者の義務の監督と、2026年8月2日からの罰金の権限(本シリーズ「EU AI法」編)[参考資料29] | GPAI行動規範、ガイドライン |
各機関の公式ページの記述の要旨(事実)です。機関の優劣や評価の質は比べません。
8. 本稿の計算:失敗が0件のとき、何が言えるか
評価で「試した範囲では失敗が見つからなかった」とき、本当の失敗率の上限として何が言えるかを、単純な統計で計算します。
n 回の独立な試行で失敗が0件のとき、「本当の失敗率が p 以上」という仮説は、(1-p)n の確率でしか起きません。これが5%未満になる最小の n を求めます(片側95%)本稿の計算。
- n=ln(0.05)/ln(1-p)。
- p=10%:29回。p=1%:299回。p=0.1%:2,995回。p=0.01%:29,956回。
- 目安として、n≒3/p(「3の法則」)。0.1%の上限を示すには、約3,000回の連続成功が要る。
前提と限界:試行が独立であること、評価の入力が実運用の入力の分布を代表していること、失敗の判定が正しいこと、を仮定します。いずれも崩れやすい仮定で、特に評価の入力と実運用のずれや試験の認識(第3章)があると、この計算は成り立ちません。繰り返しの安定性を測る指標(pass^k)の考え方は、本シリーズ「企業へのAI導入」編にあります。
9. 素材・化学・製造業での注意
化学の知識と推論をAIに問う ChemBench(2,700件超の質問)では、評価対象の最良のモデルが平均して、研究に参加した化学者の最良の成績を上回った一方、基本的な課題でつまずき、過剰な自信をもった予測を示した、と報告されています[参考資料28]。英国 AISI は、化学・生物の分野で、モデルが特定の領域の専門性で博士レベルの専門家を大きく上回っている例があり、実験室の支援(手順の提案、トラブルシューティング)の評価でも改善が見られると報告しています(方法は悪用を防ぐため一部非公開)[参考資料15]。開発者の安全方針も、化学・生物を主要なリスク領域に含めています[参考資料10・11]。 素材・化学の企業にとっては、これは二つの意味をもちます(本稿の解説)。第一に、AIは化学の調査や実験の計画を助ける力をもつ一方、その回答には誤りや過剰な自信が混じるので、実験の実施や条件の決定の前に、専門家が出典と安全性を確認する必要があります。第二に、危険な物質や反応に関わる情報を扱う場面では、自社のAIの利用ルールで、入力してよい情報、アクセスできる人、記録の保存、外部サービスの利用条件を定めることが、組織の責任として求められます。安全装置は完全ではないことを前提にします(英国 AISI は、試験した全てのシステムで脆弱性を見つけたと報告)[参考資料15]。
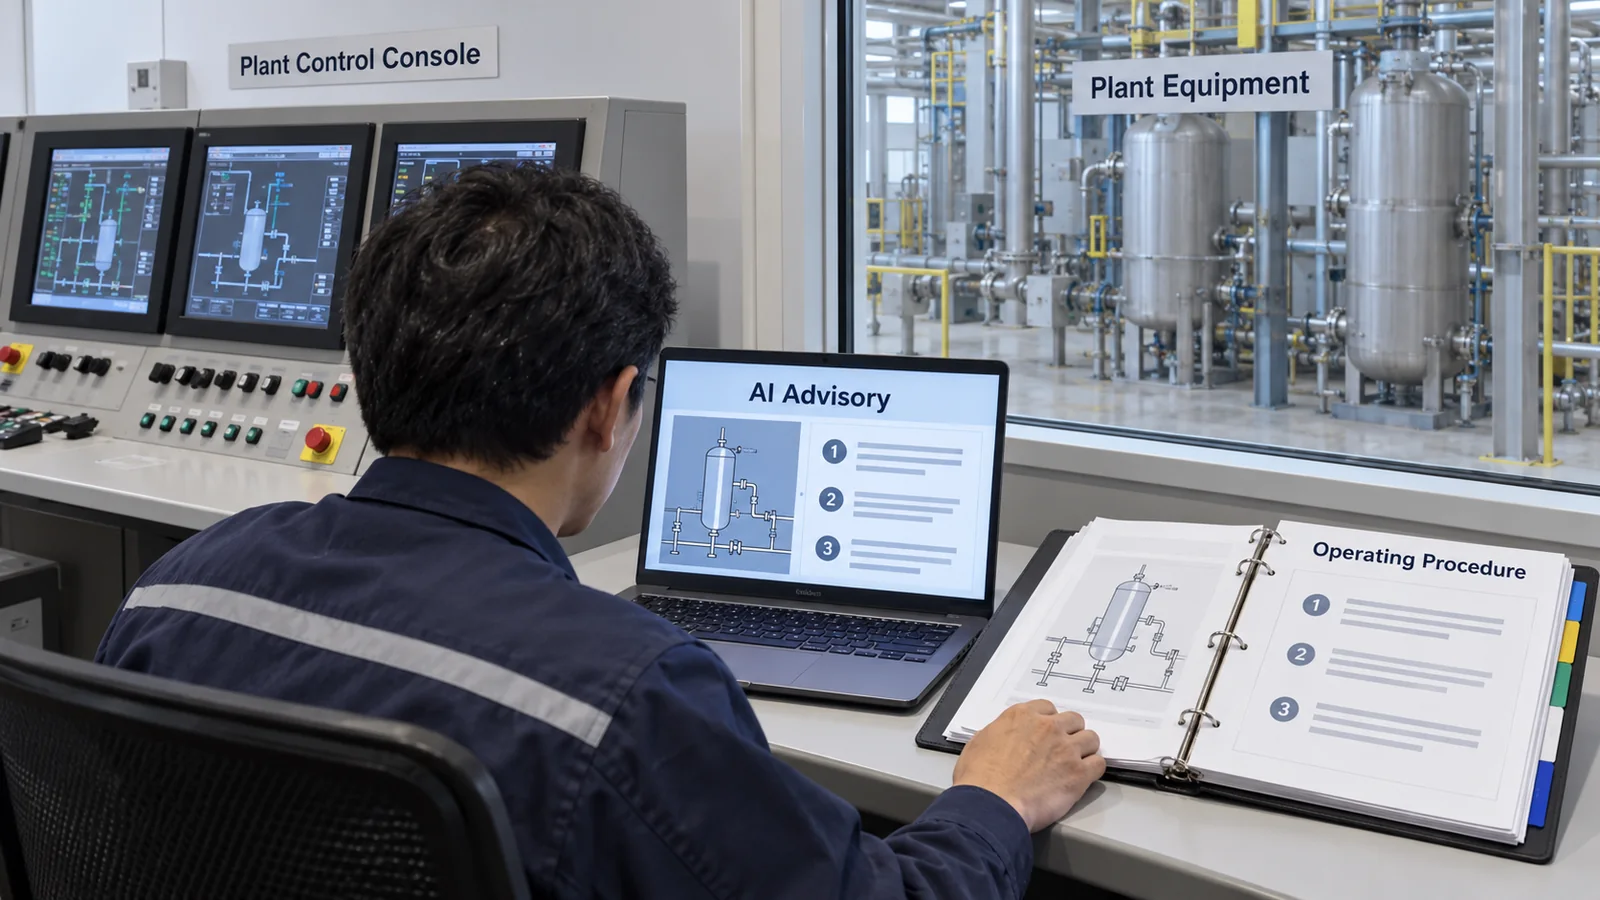
石油・化学プラントのAIには、石油コンビナート等災害防止3省連絡会議(経済産業省、総務省消防庁、厚生労働省)の「プラント保安分野におけるAI信頼性評価ガイドライン」(第2版、2021年3月)があります。機械学習の品質を、システム全体が実現したいこと(利用時品質)、機械学習要素が満たすべきこと(外部品質:リスク回避性とパフォーマンス)、設計・開発・運用で満たすべきこと(内部品質)の3階層で管理し、配管の肉厚予測、配管の画像診断、設備劣化診断、異常予兆検知・診断、運転最適化の5つの用途で適用を示します。HAZOP や FMEA などの既存のリスク評価手法との関係も整理しています[参考資料32]。 国際的には、ISO/IEC TR 5469 が、安全関連機能にAIを使う場合の性質、リスク要因、手法とプロセスを記述した技術報告書です[参考資料7]。日本の AISI は、2026年7月の評価観点ガイドの改訂で、AIエージェントが物理装置を操作する場合に、人の身体への危害や周辺の物への損害といった重大な安全上のリスクが生じないよう適切に制御されているかを評価観点に加えました[参考資料23]。また、人と空間を共有して動くAIロボットのリスクを物理的・心理的・社会的に整理した「AIロボティクスに関するセーフティ評価観点ガイド」(2026年7月23日)を公開しています[参考資料26]。 AIの助言を使うこと(最終判断は人)と、AIに設備を動かさせることは、必要な検証の重さが大きく違います(本稿の解説)。後者では、AI以外の独立した安全機構(インターロック、非常停止)の確保が前提になります。
モデルの版、検索の設定、評価用のデータが変わると、評価の結果は変わります(本稿の解説)。材料の開発で、試験法や試験片を変えたら結果の比較ができなくなるのと同じです。評価セットの版を固定して記録すること、モデルを更新するたびに同じ評価を回すこと、評価に使った問題が学習に混入していないかを意識すること(NISTの評価が非公開のベンチマークを併用している理由の一つ[参考資料20])が実務の基本です。
10. 限界と、確認できなかったこと
(1) 評価結果の中身
英国 AISI や NIST の評価の個別の結果、各社のシステムカードの本文は、本稿では要約を超えて扱っていません。高リスクの評価の方法は、悪用を防ぐため公開されていない部分があります。
(2) 開発者の方針の網羅
開発者の方針は、確認できた三つの文書の構造にとどめ、他の開発者の文書(Meta、xAI、Microsoft、Amazon、中国の開発者などを含む)は扱っていません。方針の運用の実績(閾値に到達したか、対策が機能したか)は、独立に検証されたものを確認できませんでした。国際AI安全性報告書も、リスク管理の実践の現実の効果についての証拠は限られると述べています[参考資料14]。
(3) 規格の本文
ISO/IEC 23894・42001・42005・TR 5469 の本文は有料のため確認していません。要求事項の詳細は記載していません。
(4) 各国の機関の名称と役割の変化
英国、米国、日本の機関の名称・役割は変化しています(米国のCAISI→CAISSIの変更の発表文は確認できませんでした)。国際的な評価機関のネットワークの現在の名称と構成は、本稿では確認していません。
(5) 実運用の事故・インシデント
AIの事故・インシデントの個別の事例は、裁判や調査が係属中のものがあるため扱っていません。
- 評価は、能力の測定、閾値、緩和、報告、見直しの循環です。公式文書に共通する構造として整理しました(解説)
- 評価には限界があります。評価のギャップ、試験を認識するモデル、評価の不正(成功した解答のうち不正による分の下限は0.1〜4.8%)、能力の過小評価の可能性が、公式文書で指摘されています事実
- 開発者の安全方針は版を重ねて変化しています。確認日の版は、Anthropic 3.4(2026年7月8日有効)、OpenAI 更新版(2025年4月15日)、Google DeepMind 3.1(2026年4月17日)事実
- 失敗が0件でも、上限は試行回数で決まります。失敗率0.1%の上限を95%の確信で示すには、約3,000回の連続成功が要る(独立の仮定)本稿の計算
- 素材・化学・製造業では、AIの回答の確認、利用ルール、設備に動かさせる場合の独立した安全機構が要点です。既存のプラント保安のガイドラインと併用します(解説)
11. 評価・標準の読み方
AIの安全性は、能力と挙動の評価(ベンチマーク、専門家による評価、レッドチーミング)と、組織の管理(枠組み、標準、方針)の二つの面で扱われます。前者は「そのモデルが何をしうるか」、後者は「組織がそれにどう備えるか」を問います。次の表は、確認できた評価手法と標準・指針を並べたものです。
| 評価項目 | 代表的な評価手法・ベンチマーク(名称・出典) | 標準・指針(ISO/IEC・NIST・日本) | 読み方の注意 |
|---|---|---|---|
| リスクの特定・分類事実 | 確認できなかった(数値のベンチマークではなく、リスクの分類) | NIST AI 600-1(12のリスク、2024年7月)[参考資料2]。ISO/IEC 23894:2023[参考資料4]。AI事業者ガイドライン第1.2版 | 分類はリスク管理の入口。重なる項目がある。生成AI以外は対象外 |
| 危険な能力の評価事実 | 英国 AISI の評価(サイバー、化学・生物、自律性など。2023年11月以降)[参考資料15]。NISTのCAISSI(当時CAISI)の評価[参考資料20・21]。開発者の自己評価(システムカード)[参考資料10〜12]。評価ごとの課題は一部非公開 | 開発者の安全方針の閾値(Anthropic、OpenAI、Google DeepMind)。EU AI法第55条とGPAI行動規範[参考資料29・30] | 実施主体(開発元か第三者か)、設定(ツール、試行回数)、版を確認。評価は能力の下限を示すことが多い。個別のモデルの優劣を示さない |
| レッドチーミング事実 | NIST AI 600-1 のAIレッドチーミングの説明[参考資料2]。日本AISIのレッドチーミング手法ガイド 第1.10版[参考資料24]。CAISSIの大規模なレッドチーミング競技の知見(2026年3月23日のブログ)[参考資料18] | NIST AI 600-1 の推奨行動(MP-5.1-005 など) | 質はレッドチームの専門性と多様性に依存する。手法の詳細は一般には公開されない部分がある |
| 評価観点の網羅事実 | 日本AISI:評価観点ガイド 第1.20版(10+2観点)、評価ツール(OSS)[参考資料23・27] | AI事業者ガイドライン、NIST AI RMF・AI 600-1 を参照して作成されたと同ガイドに記載[参考資料23] | ガイドは網羅的でなく、改訂される。評価項目の例であり、合格基準ではない |
| 文書化事実 | モデルカード(Mitchellら、2019)、データシート(Gebruら、2021)[参考資料8・9]。各社のシステムカード | EU AI法の技術文書・学習内容の公開要約(GPAI)。ISO/IEC 42001 の文書化 | 共通の様式はない。評価の条件・不確かさ・伏せた部分の確認が要る |
| 組織の管理体制事実 | 確認できなかった(認証・監査による確認) | ISO/IEC 42001:2023[参考資料5]。ISO/IEC 42005:2025(影響評価)[参考資料6]。NIST AI RMF 1.0(改訂中)[参考資料1・3] | 認証や枠組みの採用は個々のAIの安全の保証ではない。NIST AI RMF の改訂は未確定(未確定/将来) |
| 機能安全・プラント事実 | 確認できなかった(用途ごとの検証による) | ISO/IEC TR 5469:2024(技術報告書)[参考資料7]。プラント保安分野AI信頼性評価ガイドライン 第2版[参考資料32] | TR は規格本体ではない。既存の安全評価(HAZOP、FMEA など)と併用する |
各団体の公式ページ・文書・論文で確認した事実(確認日 2026年10月15日)。この表の整理は本稿の計算(本記事による並べ替え)、「読み方の注意」の列は解説です。
読み方の注意
- 評価は能力の下限になりやすいです。評価者はファインチューニング用のAPIや大量の推論計算を使えないことが多く、実際の能力の上限を過小に見積もる可能性があります。
- 実施主体と設定で結果が変わります。開発元の自己評価、政府機関の評価、第三者の評価は、使うベンチマーク(公開か非公開か)、試行回数、安全装置の有無が違います。数字を並べて優劣をつけません。
- 枠組み・標準・方針は「推奨」か「要求」かを見ます。NIST AI RMF は任意、ISO/IEC 23894 は手引き、ISO/IEC 42001 は認証できる要求事項、開発者の安全方針は自主的な約束です。法令(EU AI法など)とは別の文書です。
12. 用語集
- レッドチーミング
- 管理された環境で、AIの有害な挙動や安全装置の強度を、攻撃者・利用者の視点で試す実践。
- システムカード/モデルカード
- モデルの用途、評価の条件と結果、安全対策、限界を記す文書。形式は開発者ごとに異なる。
- 重大能力レベル(CCL)
- Google DeepMind の枠組みで、重大な害につながりうる能力の水準。
- 追跡能力レベル(TCL)
- Google DeepMind の枠組み 3.1 で、より極端でないリスクを早期に把握するために加えられた水準。
- High/Critical
- OpenAI の枠組みの二つの能力水準。展開前、または開発中にも、十分な安全装置を要求する。
- Risk Report
- Anthropic の方針で、導入済みモデルのリスクと対策を記して公開する報告書。
- 評価のギャップ
- 公開前の試験の結果が、実運用の能力やリスクを必ずしも予測しない状態(国際AI安全性報告書)。
- sandbagging
- 評価で戦略的に低い成績をとること。
- 解答の汚染/採点者のごまかし
- 評価の課題で、解答を不適切に知ること/自動採点の抜け穴を突くこと(NIST CAISI)。
- 信頼区間
- 観測した値が、本来の値としてどの範囲にありうるかを示す区間。試行が少ないと広くなる。
- AISI
- AIの評価・安全性を担う政府機関。英国 AI Security Institute、日本 AI Safety Institute など。
- CAISI/CAISSI
- NISTのAI評価部署。改組後の名称がCAISI、確認日の現行ページではCAISSI。
- 機能安全
- 装置の安全関連機能が、故障や誤動作の場合でも安全を保つこと。ISO/IEC TR 5469 はAIとの関係を記す技術報告書。
- HAZOP/FMEA
- プラント・機器のリスク評価の手法(危険と運転性の検討/故障モード影響解析)。
13. 参考資料(一次情報)
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1(2023年1月), DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
- NIST "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1(2024年7月), DOI 10.6028/NIST.AI.600-1 — doi.org/10.6028/NIST.AI.600-1
- NIST "AI Risk Management Framework"(確認日 2026年10月15日。AI RMF 1.0 の改訂中の記載) — www.nist.gov/itl/ai-risk-management-framework
- ISO/IEC "ISO/IEC 23894:2023"(Information technology — Artificial intelligence — Guidance on risk management、第1版、2023年2月) — www.iso.org/standard/77304.html
- ISO/IEC "ISO/IEC 42001:2023"(Information technology — Artificial intelligence — Management system、第1版、2023年12月) — www.iso.org/standard/81230.html
- ISO/IEC "ISO/IEC 42005:2025"(AI system impact assessment、第1版) — www.iso.org/standard/42005
- ISO/IEC "ISO/IEC TR 5469:2024"(Artificial intelligence — Functional safety and AI systems、Technical Report、第1版、2024年1月) — www.iso.org/standard/81283.html
- Mitchell M. ほか "Model Cards for Model Reporting", Proc. FAT* '19, 220–229 (2019), DOI 10.1145/3287560.3287596(arXiv:1810.03993) — doi.org/10.1145/3287560.3287596
- Gebru T. ほか "Datasheets for datasets", Commun. ACM 64(12), 86–92 (2021), DOI 10.1145/3458723 — doi.org/10.1145/3458723
- Anthropic "Anthropic's Responsible Scaling Policy"(公式ページ。最終更新 2026年8月14日。第3.4版〔2026年7月8日有効〕までの版の一覧) — www.anthropic.com/responsible-scaling-policy
- OpenAI "Our updated Preparedness Framework"(2025年4月15日) — openai.com/index/updating-our-preparedness-framework/
- Google DeepMind "Strengthening our Frontier Safety Framework"(2025年9月22日、2026年4月17日更新〔3.1〕) — deepmind.google/discover/blog/strengthening-our-frontier-safety-framework/
- International AI Safety Report "International AI Safety Report 2026"(第2回、2026年2月3日。Bengio Y. ほか。arXiv:2602.21012) — internationalaisafetyreport.org/publication/international-ai-safety-report-2026
- International AI Safety Report "2026 Report: Extended Summary for Policymakers" — internationalaisafetyreport.org/publication/2026-report-extended-summary-policymakers
- UK AI Security Institute "Frontier AI Trends Report"(公表日は本稿では確認できなかった。2023年11月以降の評価の集計) — www.aisi.gov.uk/frontier-ai-trends-report
- 英国政府(DSIT) "Tackling AI security risks to unleash growth and deliver Plan for Change"(2025年2月14日。AI Safety Institute から AI Security Institute への改称) — www.gov.uk/government/news/tackling-ai-security-risks-to-unleash-growth-and-deliver-plan-for-change
- UK AI Security Institute "About"(組織・活動の説明ページ) — www.aisi.gov.uk/about
- NIST "Center for Advancing Innovation and Standards for Super Intelligence (CAISSI)"(確認日 2026年10月15日の現行ページ。役割の記載と、CAISIの名の研究ブログ・評価記事の一覧) — www.nist.gov/caissi
- NIST(CAISI研究ブログ) "Cheating On AI Agent Evaluations"(2025年12月2日) — www.nist.gov/blogs/caissi-research-blog/cheating-ai-agent-evaluations
- NIST(CAISI) "CAISI Evaluation of DeepSeek V4 Pro"(2026年5月1日) — www.nist.gov/news-events/news/2026/05/caisi-evaluation-deepseek-v4-pro
- NIST(CAISI) "CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities"(2026年9月17日) — www.nist.gov/news-events/news/2026/09/caisis-assessment-zais-glm-53-cyber-capabilities
- 日本AISI(IPA) Japan AISI トップページ(機能の説明) — aisi.go.jp/
- 日本AISI(IPA) 『AIセーフティに関する評価観点ガイド(第1.20版)概要』(令和8年7月7日) — aisi.go.jp/assets/pdf/ai_safety_eval_summary_v1.20_ja.pdf
- 日本AISI(IPA) 『AIセーフティに関するレッドチーミング手法ガイド』のページ(第1.10版〔2025年3月31日〕) — aisi.go.jp/output/output_framework/guide_to_red_teaming_methodology_on_ai_safety/
- 日本AISI(IPA) アウトプットの一覧(ヘルスケア領域のガイド〔2026年4月2日〕を含む) — aisi.go.jp/output/
- 日本AISI(IPA) 「AIロボティクスに関するセーフティ評価観点ガイドの公開」(2026年7月23日) — aisi.go.jp/output/output_information/260723/
- 日本AISI(IPA) 「AIセーフティ評価のための評価ツールをOSSとして公開」(2025年9月12日) — aisi.go.jp/output/output_information/250912/
- Mirza A. ほか "A framework for evaluating the chemical knowledge and reasoning abilities of large language models against the expertise of chemists", Nat. Chem. 17, 1027–1034 (2025), DOI 10.1038/s41557-025-01815-x — doi.org/10.1038/s41557-025-01815-x
- 欧州議会・理事会 Regulation (EU) 2024/1689(AI法)第55条ほか、EU官報 OJ L, 2024/1689, 12.7.2024 — eur-lex.europa.eu/eli/reg/2024/1689/oj
- 欧州委員会 "The General-Purpose AI Code of Practice"(2025年7月10日公表。透明性、著作権、安全とセキュリティの3章) — digital-strategy.ec.europa.eu/en/policies/contents-code-gpai
- カリフォルニア州議会 SB-53 "Artificial intelligence models: large developers"(条文。第22757.12条ほか) — leginfo.legislature.ca.gov/faces/billTextClient.xhtml?bill_id=202520260SB53
- 石油コンビナート等災害防止3省連絡会議(経済産業省、総務省消防庁、厚生労働省) 『プラント保安分野AI信頼性評価ガイドライン 第2版』(2021年3月。消防庁の通知 消防危第48号・消防特第64号、令和3年3月30日に添付) — www.fdma.go.jp/laws/tutatsu/items/210330_kiho_48-tokusai_64.pdf
- 内閣府 『人工知能基本計画 ~日本AX、より強く、より豊かに~』(令和8年7月14日閣議決定) — www8.cao.go.jp/cstp/ai/ai_plan/aiplan_20260714.pdf
- 日本AISI(IPA) 『AIセーフティに関する評価観点ガイド』のページ(第1.00版〔2024年9月18日〕〜第1.20版〔2026年7月7日〕) — aisi.go.jp/output/output_framework/guide_to_evaluation_perspective_on_ai_safety/
14. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| NIST AI 100-1(AI RMF 1.0、2023年1月):四つの機能、信頼できるAIの特性 | 出典1 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| NIST AI 600-1(2024年7月):12のリスクの整理、AIレッドチーミングの説明、推奨される行動(MP-5.1-005 など) | 出典2 https://doi.org/10.6028/NIST.AI.600-1 | 事実 |
| NISTのページ(確認日 2026年10月15日)が、AI RMF 1.0 の改訂中と記していること。改訂の内容と時期は不明 | 出典3 https://www.nist.gov/itl/ai-risk-management-framework | 未確定/将来 |
| ISO/IEC 23894:2023、42001:2023、42005:2025、TR 5469:2024 の番号・題名・版・発行年月・適用範囲の説明 | 出典4 https://www.iso.org/standard/77304.html 出典5 https://www.iso.org/standard/81230.html 出典6 https://www.iso.org/standard/42005 出典7 https://www.iso.org/standard/81283.html | 事実 |
| モデルカード(2019)、データシート(2021)の題名・掲載誌・年、モデルカードの趣旨 | 出典8 https://doi.org/10.1145/3287560.3287596 出典9 https://doi.org/10.1145/3458723 | 事実 |
| Anthropic Responsible Scaling Policy:版と有効日(1.0〜3.4)、第3.0版の構成、第3.1〜3.4版の変更、リスク報告書、System Card への言及 | 出典10 https://www.anthropic.com/responsible-scaling-policy | 事実 |
| OpenAI Preparedness Framework 更新版(2025年4月15日):基準、追跡カテゴリーと研究カテゴリー、High/Critical、SAG、要件の調整の条件 | 出典11 https://openai.com/index/updating-our-preparedness-framework/ | 事実 |
| Google DeepMind Frontier Safety Framework:第3版(2025年9月22日)と3.1(2026年4月17日)の変更点 | 出典12 https://deepmind.google/discover/blog/strengthening-our-frontier-safety-framework/ | 事実 |
| 国際AI安全性報告書2026(2026年2月3日):評価のギャップ、試験と実運用を区別するモデル、2025年に12社が枠組みを公表・更新、リスク管理の実践の効果の証拠が限られること | 出典13 https://internationalaisafetyreport.org/publication/international-ai-safety-report-2026 出典14 https://internationalaisafetyreport.org/publication/2026-report-extended-summary-policymakers | 事実 |
| 英国 AISI の Frontier AI Trends Report:評価の範囲、化学・生物の評価、全システムで脆弱性を見つけたこと、sandbagging の評価、限界(スナップショット、能力の上限の過小評価の可能性、方法の非公開) | 出典15 https://www.aisi.gov.uk/frontier-ai-trends-report | 事実 |
| 英国 AISI の改称(2025年2月14日)と焦点、組織の説明(DSIT内の研究組織、100人超の技術スタッフ、助成1,500万ポンド超) | 出典16 https://www.gov.uk/government/news/tackling-ai-security-risks-to-unleash-growth-and-deliver-plan-for-change 出典17 https://www.aisi.gov.uk/about | 事実 |
| NISTのCAISSIの現行ページ(役割、研究ブログ・評価記事の一覧、2026年3月のレッドチーミング競技のブログ) | 出典18 https://www.nist.gov/caissi | 事実 |
| CAISI研究ブログ「Cheating On AI Agent Evaluations」(2025年12月2日):解答の汚染と採点者のごまかし、不正による成功解答の下限(0.1〜4.8%) | 出典19 https://www.nist.gov/blogs/caissi-research-blog/cheating-ai-agent-evaluations | 事実 |
| CAISIの外国モデルの評価(2026年5月1日、同年9月17日):非公開ベンチマークの併用、項目反応理論に着想を得た推定、95%信頼区間、自己報告との差、Wilson信頼区間 | 出典20 https://www.nist.gov/news-events/news/2026/05/caisi-evaluation-deepseek-v4-pro 出典21 https://www.nist.gov/news-events/news/2026/09/caisis-assessment-zais-glm-53-cyber-capabilities | 事実 |
| 日本AISIの機能、評価観点ガイド 第1.20版(2026年7月7日)の観点と実施者・時期の考え方、レッドチーミング手法ガイド 第1.10版(2025年3月31日)、アウトプットの一覧、AIロボティクスのガイド(2026年7月23日)、評価ツールのOSS公開(2025年9月12日) | 出典22 https://aisi.go.jp/ 出典23 https://aisi.go.jp/assets/pdf/ai_safety_eval_summary_v1.20_ja.pdf 出典24 https://aisi.go.jp/output/output_framework/guide_to_red_teaming_methodology_on_ai_safety/ 出典25 https://aisi.go.jp/output/ 出典26 https://aisi.go.jp/output/output_information/260723/ 出典27 https://aisi.go.jp/output/output_information/250912/ 出典34 https://aisi.go.jp/output/output_framework/guide_to_evaluation_perspective_on_ai_safety/ | 事実 |
| ChemBench(Nature Chemistry 2025):2,700件超の質問、最良のモデルが平均して最良の化学者を上回る一方、基本的課題でつまずき過剰な自信を示す | 出典28 https://doi.org/10.1038/s41557-025-01815-x | 事実 |
| EU AI法第55条(体系的リスクのモデルの義務)、GPAI行動規範(2025年7月10日、安全とセキュリティの章) | 出典29 https://eur-lex.europa.eu/eli/reg/2024/1689/oj 出典30 https://digital-strategy.ec.europa.eu/en/policies/contents-code-gpai | 事実 |
| カリフォルニアSB 53 第22757.12条:フロンティアAIの枠組みに記述する事項(標準の取り込み、第三者の評価、サイバーセキュリティなど) | 出典31 https://leginfo.legislature.ca.gov/faces/billTextClient.xhtml?bill_id=202520260SB53 | 事実 |
| プラント保安分野AI信頼性評価ガイドライン第2版(2021年3月):3階層の品質、5つの用途、既存手法(HAZOP、FMEAなど)との関係 | 出典32 https://www.fdma.go.jp/laws/tutatsu/items/210330_kiho_48-tokusai_64.pdf | 事実 |
| 人工知能基本計画(第Ⅱ期、2026年7月14日)のAISIの強化、国際ネットワークの活用 | 出典33 https://www8.cao.go.jp/cstp/ai/ai_plan/aiplan_20260714.pdf | 未確定/将来 |
| 失敗が0件のときの試行回数 n=ln(0.05)/ln(1-p):p=10%で29回、1%で299回、0.1%で2,995回、0.01%で29,956回、n≒3/p | 本稿の計算。前提・限界は本文に明記 | 本稿の計算 |
| 評価の循環の整理(図2)、評価の限界の読み取り、文書を読むときの確認点、素材・化学・製造業での注意、評価・標準の対応表の整理 | 公表内容にもとづく本記事の整理・解説。各機関・企業が表明した見解ではない | 解説 |
| 個々のモデルの評価結果の優劣、開発者の方針の運用の実績、他の開発者の方針、国際的な評価機関のネットワークの現在の構成、英国 AISI の傾向報告書の公表日 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 図2〜4が説明のための作図であること。図1・5がAI生成イメージの枠であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(NIST・英国 AISI・日本 AISI・国際AI安全性報告書の公式ページ、開発者の公式な安全方針、ISO の規格ページ、査読論文、消防庁の通知)に限定しています。規格の本文は有料のため確認できていません。 評価の考え方の整理、素材・化学・製造業への読み取りは「解説」または「本稿の計算」として、出典付きの事実と区別しています。 個々のモデルの評価結果の優劣、開発者の方針の運用の実績、他の開発者の方針、国際的な評価機関のネットワークの現在の構成は、確認できなかったため記載していません。 攻撃や悪用の具体的な手順は記載していません。本記事は法的助言ではなく、特定の企業・個人を非難するものではありません。 図2〜4はベクター作図、図1・5はAI生成イメージ(未作成の枠)であり、いずれも実在の施設・機関・評価結果を示すものではありません。