TECHNOLOGY EXPLAINER
模倣学習と強化学習
― 人の動きをまねて学ぶ、試行錯誤で学ぶ、そしてシミュレーションから実機へ移す
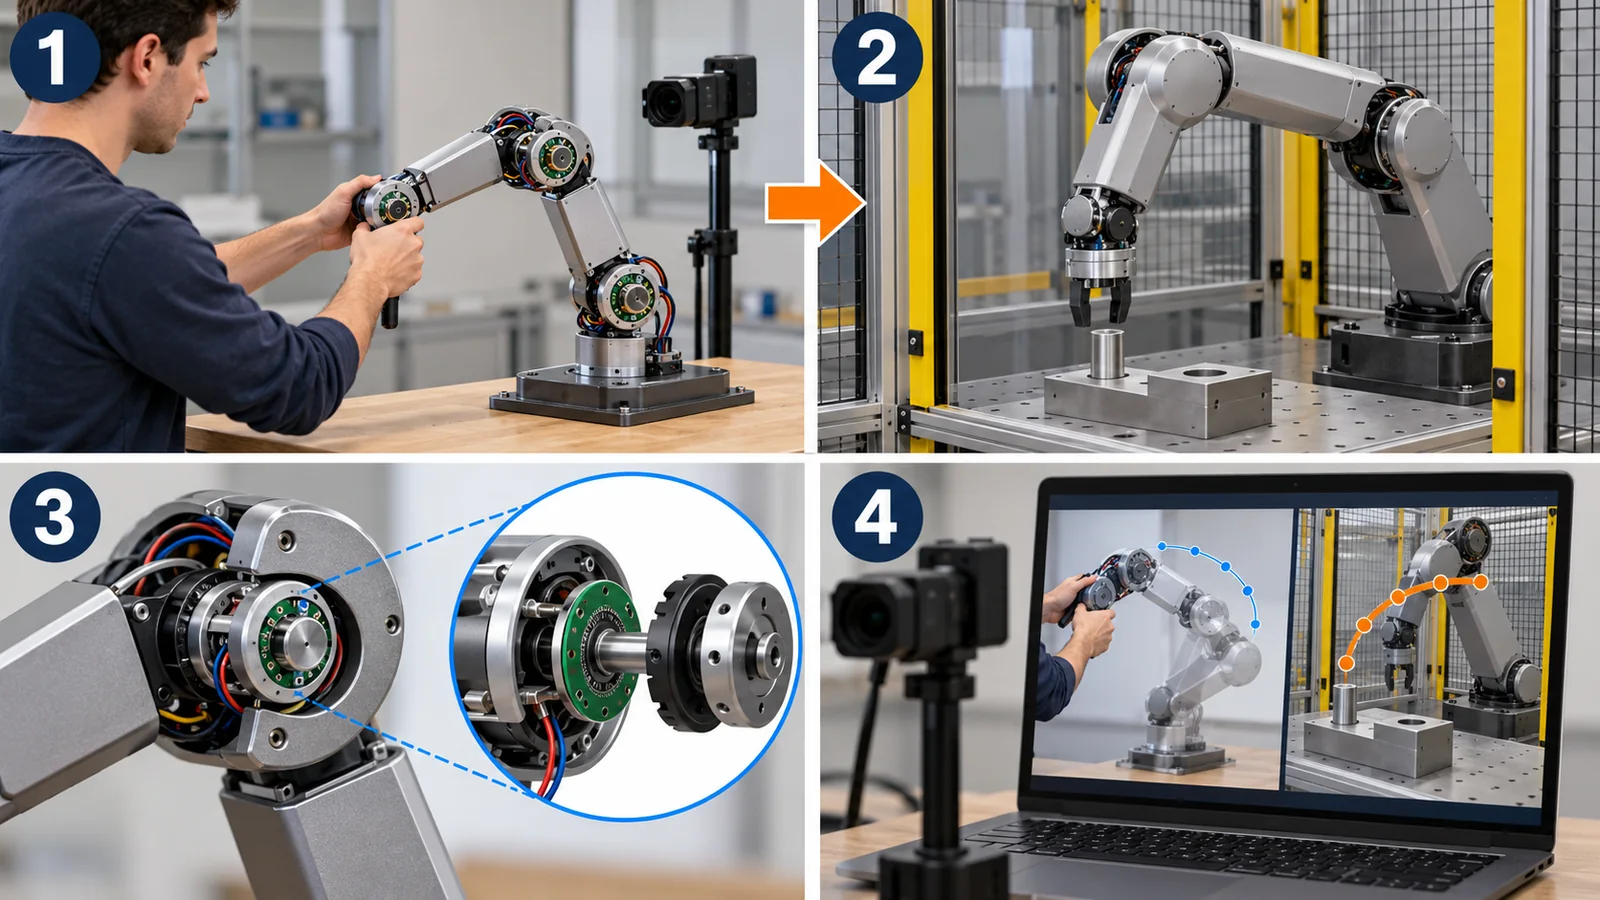
ロボットに新しい作業をさせるとき、人が動きを一つずつプログラムする代わりに、人の実演をまねさせる(模倣学習)方法と、やってみた結果の点数から自分で見つけさせる(強化学習)方法があります。どちらも「学習した方策(行動を決める関数)」を作りますが、得意な場面と落とし穴が違います。 この記事では、素材技術者にもなじみやすいたとえで両者のしくみを説明し、模倣学習で「小さなずれが広がる」理由、強化学習で実機の試行錯誤が重い理由、シミュレーションで学んで実機に移す(sim2real)ときの摩擦などの物性値の役割を、論文と本稿の小さな計算で確かめます。
- 模倣学習と強化学習とは何か(3行でつかむ)
- ロボットが「やり方」を身につける3つの道
- 模倣学習 ― 手本から「見えたもの → 行動」を学ぶ
- 模倣学習の落とし穴 ― 小さなずれが広がる
- 強化学習 ― 結果の点数だけで、やり方を見つける
- 実機で試行錯誤すると、どれくらいかかるか
- シミュレーションで学び、実機へ移す(sim2real)
- 素材技術者の視点:物性値の「幅」と、実機の「経年」
- 使い分けと組合せ ― どちらを選ぶか
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・草案・策定中などで、確定していない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
第4章の誤りの上限、第5章の収益、第6章の学習時間の想定は、本稿が置いた想定値による計算です。実在のロボットや方策の性能ではありません。論文の成功率・学習時間は、各論文が選んだロボット・課題・条件での報告値で、異なる論文の数字を並べて優劣はつけません。 規格(ISO)は番号・題名・段階の確認にとどめ、本文は確認していません。特定の製品・企業の優劣は論じません。
1. 模倣学習と強化学習とは何か(3行でつかむ)
- 模倣学習は「見取り稽古」:人の実演(見えたもの、とった行動)を正解として、方策を教師あり学習で作ります。正解があるので学習は速い反面、手本にない状況には弱くなります事実[参考資料1]
- 強化学習は「やってみて点数をもらう」:正解の行動は与えられず、結果の点数(報酬)が大きくなるように、方策を試行錯誤で改善します。人のまねを超えられる可能性がある反面、試行回数が膨大になりがちです事実[参考資料9・10]
- 実機で全部やるのは重い:そこで、シミュレーションで多数を並列に試し、実機に移す(sim2real)方法が使われます。1枚のGPUで四脚ロボットの歩行方策を約20分で学習した、という報告があります事実[参考資料13]。ただし、シミュレーションと実機のずれ(摩擦など)が次の壁になります
シリーズ共通のたとえでは、ロボットは「感じる(センサー)・考える(制御と知能)・動く(アクチュエータ)」の組合せです。この記事は、「考える」の部分、つまり見えたもの(観測)から次の行動を決める関数(方策)をどう作るかを扱います。 方策は、たとえば「カメラ画像と関節の角度を入れると、次の瞬間の関節の目標位置を返す」ニューラルネットワークです。「学習」とは、この関数の中の数値(パラメータ)を、データで調整することです。
本シリーズ「ロボット制御の基礎」編は、方策が出した目標を実際に動かす低い層を、「ロボットの視覚と認識」編は観測の作り方を、「ロボットシミュレーションとデジタルツイン」編はシミュレータそのものを、「遠隔操作とデータ収集」編は実演データの集め方を、「ロボット基盤モデルとVLA」編は大規模な事前学習と模倣・強化学習の関係を扱います。「世界モデルと身体性AI」編は、シミュレーションと実機のずれと、成功率の信頼区間の計算を詳しく扱っています。この記事は、学び方の二大系統とその落とし穴に絞ります。
模倣学習の弱点は「手本にない状況」、強化学習の弱点は「試行の数と報酬の設計」で、どちらも最後は「実機で、自分の条件で」確かめるしかありません。 シミュレーションは強力な練習場ですが、練習場の床の摩擦が本番と違えば、本番で転びます。
2. ロボットが「やり方」を身につける3つの道
ロボットに「箱から部品を取り出して穴にはめる」作業をさせたいとします。人が動きをプログラムする(座標を1つずつ教える)代わりに、学習で方策を作るには、大きく二通りの道があります。
| 項目 | 模倣学習 | 強化学習 |
|---|---|---|
| 与えるもの | 人の実演(観測と行動の組) | 報酬(結果の点数)と、試す場(実機またはシミュレータ) |
| たとえ(シリーズ共通のたとえの範囲で) | 先輩の手元を見て、まねる | やってみて、結果の点数から工夫を重ねる |
| 強み(解説) | 正解がある分、少ない回数で動き出せる。人の巧みさを写せる | 人が教えにくい動き(高速の歩行など)も見つけられる。結果を直接最適化できる |
| 弱み(解説) | 手本にない状況に弱い。手本の質と量に縛られる | 試行回数が多い。報酬の設計を誤ると、意図と違う動きを覚える |
| 実機での負担 | 実演を集める手間(人の時間) | 試行の数だけ、機体と時間を使う |
表の「強み・弱み」は本記事による整理(解説)です。どちらの手法がよいかは、課題・データ・計算資源で変わり、優劣は論じません。
3. 模倣学習 ― 手本から「見えたもの → 行動」を学ぶ
(1) いちばん単純な形:行動クローニング
実演のたびに、そのときロボットに見えていたもの(観測)と、人がとった行動を記録します。この(観測、行動)の組を大量に集め、「この観測のときはこの行動」という対応を、ニューラルネットワークで当てはめるのが行動クローニングです。普通の教師あり学習と同じ形なので、ここでの「正解」は人の行動です。
初期の代表例として、Bojarski らは、前方のカメラ画像の画素から操舵指令までを、人の運転データで学ぶ「端から端まで」の方式を報告しました[参考資料2]事実。
(2) 近年のロボット操作での例
- ACT(ALOHA):低コストな機器と遠隔操作の実演から、行動を数ステップ分まとめて生成する方式(行動チャンク)を提案しました。半透明の容器のふたを開ける、電池を差し込むなど6つの難しい課題で、80〜90%の成功率を、実演わずか10分で達成したと報告しています。論文は、誤りが時間とともに積み重なることと、人の実演が一定でない(非定常)ことを課題に挙げています[参考資料3]事実
- Diffusion Policy:方策を、ノイズから行動を取り出す拡散の過程として表します。4つの操作ベンチマークの12課題で、既存手法を平均46.9%上回ったと報告しています(論文の設定での比較)[参考資料4]事実
- robomimic:6つのオフライン学習手法を、5つのシミュレーション課題と3つの実機の多段階課題で比べ、実演の質への依存や、学習を止める時期による変動などを分析しました[参考資料5]事実
同じ場面でも、人は右から回り込むこともあれば左から回り込むこともあります。「平均」を取ると、どちらでもない真ん中を通ってしまうことがあります(本記事による解説)。Diffusion Policy が「複数の行動の候補を扱える」点を利点に挙げているのは、この問題に関係します[参考資料4]。実演データの質(誰が、どの条件で)の記録が大切になる理由でもあります。
4. 模倣学習の落とし穴 ― 小さなずれが広がる
行動クローニングは、教師あり学習と同じ形なのに、なぜ難しいのでしょうか。理由は、ロボットの行動が次に見るものを変えるからです。普通の画像分類では、1枚の判定の誤りが次の画像を変えることはありません。しかしロボットでは、判断を少し誤ると、位置が少しずれ、次に見る状況が手本と変わります。
Ross らは、これを独立同分布の仮定が成り立たない問題だと説明します。手本の状況での誤り率が ε の方策は、自分が作る状況では、T ステップの作業で最大 T²ε 回まちがう場合がある、という結果です。この上限は、最悪の場合に達する例も示されています[参考資料1]事実。
数字で確かめる
1ステップあたりの誤り率を ε=1% と想定します。作業の長さ(ステップ数)T を変えたときの、誤りの回数を計算します(本稿の計算)。
| 作業の長さ T | 線形に増える場合(T×ε) | 上限(T²×ε) | 起こりうる最大の回数 |
|---|---|---|---|
| 10 | 0.1回 | 1回 | 10回 |
| 50 | 0.5回 | 25回 | 50回 |
| 100 | 1回 | 100回 | 100回(上限が無意味に) |
| 200 | 2回 | 400回 | 200回(上限が無意味に) |
本稿の計算。ε=1%は想定値。T²ε は Ross らの上限[参考資料1]で、最悪の場合の値です(実際の方策の典型的な誤り回数ではありません)。T ステップで T 回を超えて誤ることはないので、T²ε が T を超える(ε>1/T)と、この上限は何も教えてくれなくなります。
正しくは:誤り率1%は、手本と同じ状況で測った値です。一度ずれて手本にない状況に入ると、そこでの誤り率は1%より大きくなりえます。Ross らの上限(T²ε)は最悪の場合の話で、典型的な値ではありませんが、作業が長くなるほど、手本の範囲外に出る機会が増えるという方向は変わりません。
対策の例
- DAgger:学習した方策を実際に動かし、方策自身が通った状況に専門家が正解の行動を付けて、データに加えて学び直します。これを繰り返し、方策が実際に入り込む状況を手本に含めます[参考資料1]事実
- 行動を数ステップまとめて出す(ACT):1ステップごとの判断の回数を減らし、誤りの積み重なりを抑える狙いです。ACT の論文は、誤りの積み重なりを課題として挙げ、行動列を生成するこの方式で対処しました[参考資料3]事実
- 人の修正を取り込む:方策の動きを人が途中で直し、その修正を学習に使う方法があり、HIL-SERL は実演と人の修正を強化学習と組み合わせています[参考資料11]事実
5. 強化学習 ― 結果の点数だけで、やり方を見つける
強化学習では、方策が行動し、環境(ロボット、物、物理法則)から観測と報酬を受け取る、という繰り返しで学びます。正解の行動は与えられず、「うまくいったら+1」のような点数だけが手がかりです。ゲームで、攻略法を教わらずに点数だけを見て何度も遊ぶのに似ています(たとえの限界:ゲームは失敗しても機体が壊れません)。
(1) 報酬と収益
1回ごとの点数が報酬で、それを先まで足し合わせたものが収益(リターン)です。先の報酬は割引率 γ(0〜1)で小さく数えます。たとえば、成功の報酬が4ステップ後にだけ付くとき、γ=0.9なら収益は0.9⁴=0.656、γ=0.5なら0.0625です本稿の計算。割引率が小さいと、先のことを軽く見るので、「長い手順の最後にだけ報酬がある」課題は学びにくくなります(本記事による解説)。
(2) 代表的な手法
- PPO:方策勾配法の一群で、環境との交わりでデータを集めて、「代理の目的関数」を複数エポックのミニバッチで更新します。実装が簡単で、サンプル効率とのバランスがよいと報告されています[参考資料6]事実
- SAC:データを再利用できるオフポリシーの手法で、サンプル数の多さと不安定さを課題としてきた従来法に対し、安定性を高めたと報告しています[参考資料7]事実
(3) 報酬の設計が、学ぶ内容を決める
報酬は、設計者が「何を良しとするか」を数にしたものです。報酬に抜け穴があると、方策は意図と違う方法で点数を稼ぐことがあります(報酬ハッキング)。Amodei らは、これを機械学習システムの事故の原因の一つとして挙げています[参考資料8]事実。たとえば、「部品を持ち上げた高さ」に報酬を付けると、部品をつかまずに投げ上げる方策が見つかるかもしれません(これは本記事による仮想例で、論文の結果ではありません)。
模倣学習では、各場面で「こう動くのが正解」と教わります。強化学習では、各場面の正解は教わらず、最後に点数だけが返ってきます。そのため、どの行動が点数に効いたのかを、自分で探す必要があります。これが、試行回数が多くなる主な理由です(本記事による解説)。
6. 実機で試行錯誤すると、どれくらいかかるか
強化学習が重いと言われる理由を、数字の桁で確かめます。まず、想定として、実機で100万ステップの試行が必要で、制御を毎秒10回行うとします。100万÷10=10万秒で、約27.8時間です。1,000万ステップで毎秒50回なら、20万秒、約55.6時間です本稿の計算。しかも、これはロボットが休まず動き続けた場合の時間で、物を元の位置に戻す、壊れた部品を直す、といった時間は入っていません(本記事による解説)。
実機の強化学習の報告もあります。
- Levine らは、カメラ画像だけで把持を学ぶために、80万回超の把持の試行を、2か月かけて6〜14台のロボットアームで集めたと報告しています[参考資料9]事実
- QT-Opt は、58万回超の実機の把持で学習し、未知の物体に対して96%の把持成功率に達したと報告しています[参考資料10]事実
- HIL-SERL は、人の実演と修正を組み込むことで、精密な組立などの課題を1〜2.5時間の学習で高い成功率に到達させたと報告し、模倣学習の基準手法より平均で成功率が2倍になったとしています[参考資料11]事実
3つの報告は、課題、ロボット、人の補助の有無、成功の定義が違うので、優劣や学習時間の比較はできません。「実機でも数時間で学べる場合がある」「ただし、人の手本や修正を使わない純粋な試行錯誤は、数十万回の規模になりうる」という、桁の感覚をつかむための並べ方です(本記事による解説)。
7. シミュレーションで学び、実機へ移す(sim2real)
実機の試行が重いなら、コンピュータの中で練習してから、実機に移すのが自然な考えです。GPUの上で、物理シミュレーションと方策の学習を一緒に動かすことで、従来のCPUのシミュレータに比べ、2〜3桁の高速化を得たと、Isaac Gym の論文は報告しています[参考資料12]事実。
(1) 歩行ロボットでの例
- Rudin らは、1枚のGPUでの大規模並列シミュレーションで、ANYmal が平坦な地形を歩く方策を4分未満、不整地を歩く方策を20分で学習し、実機に移して検証したと報告しています[参考資料13]事実
- Hwangbo らは、シミュレーションで訓練した方策を ANYmal に移し、速度指令への追従、より速い走行、複雑な姿勢からの転倒回復を実現したと報告しています[参考資料14]事実
- Lee らは、強化学習でシミュレーションの中だけで訓練した、体内の感覚(proprioception)だけを使う方策が、泥・雪・がれきなどの自然環境でも頑健に歩けたと報告しています[参考資料15]。Miki らは、地形の外界の知覚と体内の感覚を統合した方策を報告しています[参考資料16]事実
(2) ドローンでの例
Kaufmann らの Swift は、シミュレーションでの深層強化学習と、実世界で集めたデータを組み合わせた自律ドローンです。3人の人間の優勝者(うち2つの国際リーグの世界王者を含む)との1対1の実機のレースで、それぞれに複数のレースで勝ち、最速の記録を出したと報告されています[参考資料17]事実。これは、規定のコースでの競技の結果で、一般の飛行作業での性能を示すものではありません(本記事による解説)。
(3) ずれを減らす工夫:ドメインランダム化
シミュレーションと現実のずれ(リアリティギャップ)への代表的な対策が、ドメインランダム化です。シミュレータの見た目や物理量を毎回ばらつかせて学習し、「現実も、そのばらつきの1つに見える」ようにします。Tobin らは、非現実的なランダムな質感だけのシミュレータの画像で、実世界で1.5 cmの精度の物体検出器を学べたと報告しました[参考資料18]。OpenAI は、摩擦係数や物体の見た目などをランダム化したシミュレーションだけで、Shadow Dexterous Hand での物体の持ち替えを学び、人の実演なしで実機に移せたと報告しています[参考資料19]。続く研究は、自動ドメインランダム化(ADR)で、ロボットハンドによるルービックキューブの操作に取り組みました[参考資料20]事実。
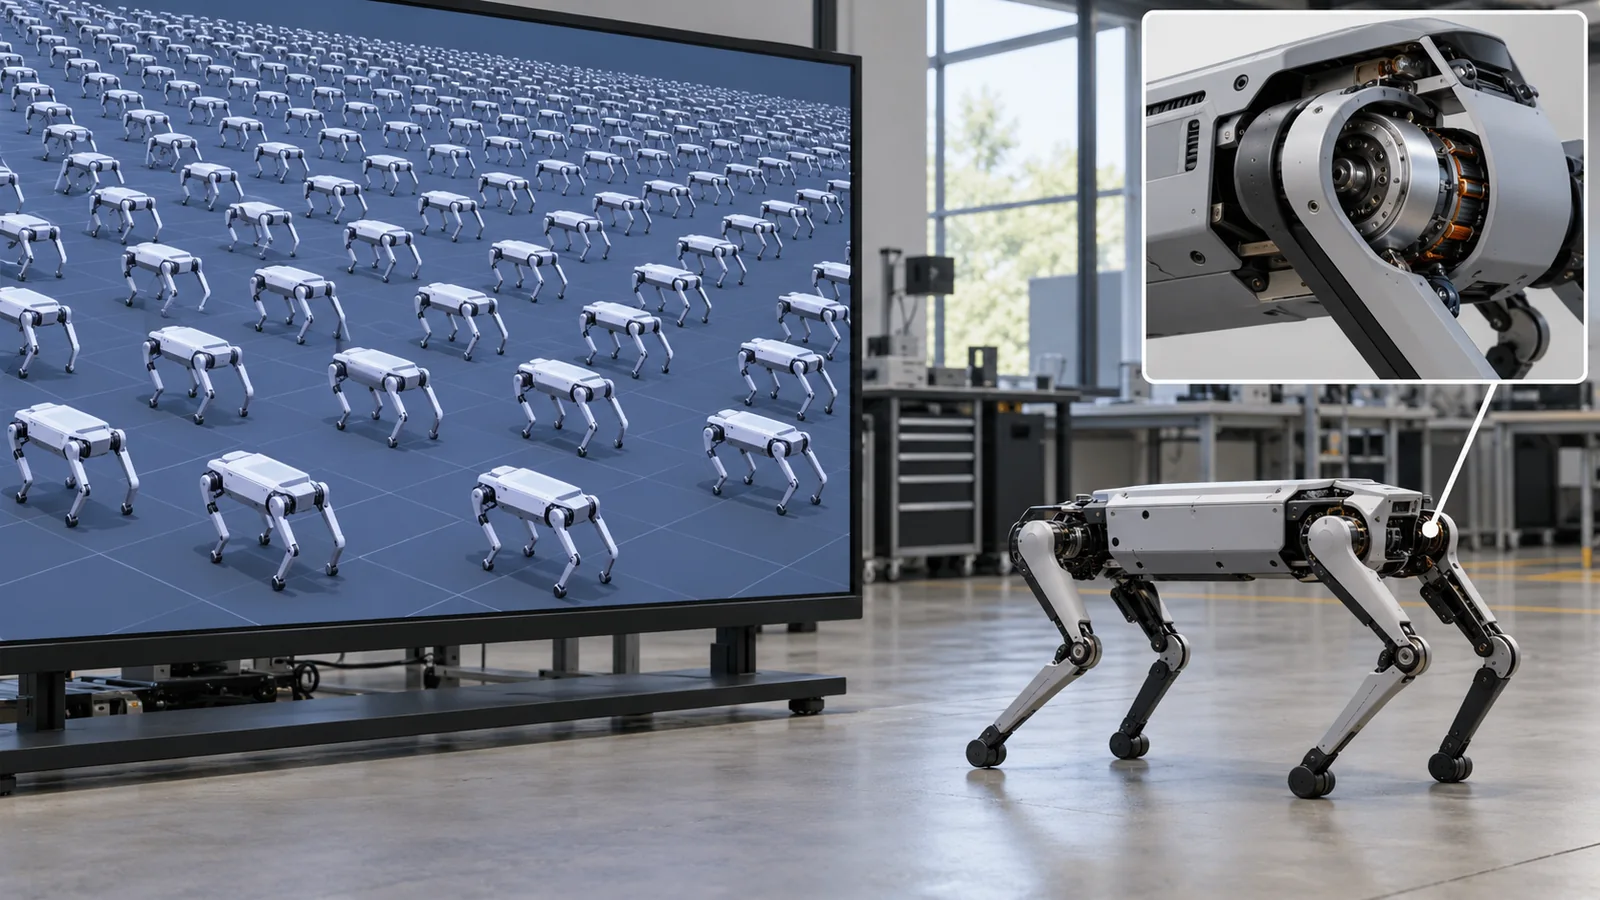
正しくは:シミュレーションで成功した方策が、実機で成功するかは別の問題です。摩擦、接触、遅れ、センサーのばらつきがずれる場合があるためです。ドメインランダム化や、実機の測定値で範囲を決める工夫は、ずれを減らす手段であって、成功の保証ではありません。ずれの要因の整理は、本シリーズ「世界モデルと身体性AI」編の第4章と、「ロボットシミュレーションとデジタルツイン」編で扱います。
8. 素材技術者の視点:物性値の「幅」と、実機の「経年」
ドメインランダム化の対象には、摩擦係数のような材料の物性値が含まれます[参考資料19]。ここで、材料の知識が活きます。つかむ物体の表面、床、治具、ハンドの指先のゴムなどについて、摩擦係数や弾性率を「一点」ではなく「測定した幅」で与えられるからです。幅を測らずに適当に広げると、方策が慎重になりすぎて作業が遅くなる、逆に狭すぎると実機で外れる、というトレードオフがありえます(図7。広すぎると慎重になる点は推測です)。
摩擦は、表面の粗さ、汚れ、湿度、温度、接触の力で変わります。したがって、「その摩擦係数が実機の条件で成り立つか」は、測定条件を揃えて確かめる価値があります。布、ケーブル、粉体、液体のように変形・流動する対象は、シミュレーションの再現がさらに難しい領域です(これは本記事による一般的な見立てで、本稿では一次情報を確認していません)。
ロボットのゴムの指先は摩耗し、歯車や関節にはガタが出て、配線の抵抗や潤滑も変わります。学習したときの機体と、1年後の機体は、同じではありません。方策を一度学習して終わりにせず、劣化に応じた再確認や再学習の手順が必要になりえます(本記事による一般的な見立てで、特定の機種の測定ではありません)。 また、強化学習の実機の試行錯誤は、機体に多くの負荷をかけるおそれがあります(推測)。実機の試行を減らす(シミュレーション、人の補助)工夫は、機体の寿命とコストの問題でもあります。
9. 使い分けと組合せ ― どちらを選ぶか
| 状況 | 向きやすい道(解説) | 理由 |
|---|---|---|
| 人が簡単に実演できる作業(組立、物の移動) | 模倣学習 | 実演が正解になり、少ない回数で動き出す。ACT は実演10分で6課題を学んだと報告[参考資料3] |
| 人が教えにくい動き(高速の歩行、飛行) | 強化学習+シミュレーション | 歩行は並列シミュレーションで短時間に学べる[参考資料13]。ドローンの競技の例もある[参考資料17] |
| 実機で精密さと速さを両立したい | 模倣+人の修正+強化学習 | HIL-SERL のように、実演と修正を足がかりにして、実機で磨く[参考資料11] |
| 対象の物性が大きくばらつく | ランダム化の範囲の測定+実機での確認 | どの道でも、物性の幅を測ることが土台になる(図7) |
表の「向きやすい道」は本記事による整理(解説)で、各論文が推奨したものではありません。実際の手法は複数の道を組み合わせています。
10. 限界と、確認できなかったこと/まとめ
(1) 論文の成績の比較
成功率・学習時間は、各論文が選んだロボット・課題・条件での報告値です。条件の異なる数字を並べて優劣を論じることはしていません。独立した第三者による再現は、本稿では確認していません。
(2) 想定値の計算
第4章・第6章の数字は、本稿が置いた想定(ε=1%、100万ステップなど)による算術で、実在の方策やロボットの性能ではありません。Ross らの上限は最悪の場合の値で、典型的な誤りの回数ではありません。
(3) 規格の本文
ISO の規格は、番号・題名・段階の確認にとどめ、本文は確認していません。学習した方策の安全性評価の方法を、直接定めた発行済みの規格は確認できませんでした。AIの機能安全を扱う ISO/IEC TS 22440 は、委員会原案の段階です。
(4) 取り上げなかった内容
大規模な事前学習済みモデルと模倣・強化学習の関係は「ロボット基盤モデルとVLA」編で、実演データの集め方は「遠隔操作とデータ収集」編で、シミュレータの詳細は「ロボットシミュレーションとデジタルツイン」編で扱います。人型ロボットの製品や、市場規模は扱いません。
- 模倣学習は人の実演を正解にして学ぶ方法で、手本にない状況で誤りが積み重なります(上限は T²ε。最悪の場合の値)。DAgger や行動チャンクなどの対策があります事実本稿の計算
- 強化学習は結果の点数だけで学ぶ方法で、試行回数と報酬の設計が壁です。実機では数十万回の試行を2か月かけて集めた例があり、シミュレーションを使うと20分で学べた例があります事実
- sim2real では、摩擦などの物性値の幅と、実機の経年が、成否を左右します。成功率は、実機で、自分の条件で確かめます(解説)
11. 評価・標準の読み方
学習した方策の性能は、課題の成功率で測るのが基本です。ただし、成功率は、試行回数・物の置き方・環境・評価する人で変わります。試行が少ないときの成功率の幅(信頼区間)の計算は、本シリーズ「世界モデルと身体性AI」編の第6章にあります。ここでは、模倣学習・強化学習の評価に使われるベンチマークと、安全に関する標準を整理します(確認日 2026年10月25日)。
| 評価項目 | 代表的な試験・ベンチマーク(名称・出典) | 標準・規則・指針(ISO など) | 読み方の注意 |
|---|---|---|---|
| 模倣学習の成功率 | robomimic(5つのシミュレーション課題+3つの実機課題、6つの学習手法)[参考資料5]。Diffusion Policy が用いた4つの操作ベンチマーク12課題[参考資料4]事実 | 確認できなかった | 実演の質、評価課題の選び方、学習を止める時期で成績が変わる。論文の設定での比較 |
| 強化学習の成功率・学習効率 | Meta-World(50の操作課題)[参考資料22]。D4RL(オフライン強化学習のデータセットと評価)[参考資料21]事実 | 確認できなかった | シミュレーション上の成績は実機の成績を保証しない。報酬の定義が違えば比べられない |
| 実機での成功率 | 論文ごとの実機試行(例:QT-Opt の未知物体の把持成功率96%[参考資料10]、ACT の80〜90%[参考資料3])事実 | 確認できなかった(学習した方策の汎化の評価を定めた標準は確認できなかった) | 試行回数・物の置き方・照明で幅が変わる。回数が少ない成功率は信頼区間で読む |
| 産業用ロボットの安全 | —(ベンチマークではなく規格) | ISO 10218-1:2025(ロボット本体の安全要求)、ISO 10218-2:2025(応用とロボットセル)[参考資料23・24]事実 | 学習した方策の評価方法を直接定めたものではない。本文は有料で、題名の確認にとどめる |
| AIを安全関連機能に使うとき | — | ISO/IEC TR 5469:2024(AIの機能安全。技術報告)[参考資料25]。ISO/IEC CD TS 22440-1(AIの機能安全:要求事項。委員会原案の段階)[参考資料26]事実未確定/将来 | 技術報告は要求事項ではなく情報。TS 22440 は策定中で、確定した内容ではない |
表の整理は本稿の計算(整理)。ISO の番号・題名・発行年月・段階は ISO の公式ページで確認(確認日 2026年10月25日)。規格本文は有料のため、題名・段階の記載にとどめています。
読み方の注意(素材技術者向け)
- デモ・ベンチマーク・現場は別物:論文の成功率は、選ばれた課題と整えた環境での値です。自社の部品・床・照明・摩耗した機体で、測り直してください
- 公称値と第三者の検証は別:学習時間や成功率の報告は、多くが開発した研究グループ自身の測定です。独立した再現かどうかを確認してください
- 標準は「要求」か「情報」か「策定中」か:ISO 10218 は安全要求、ISO/IEC TR 5469 は情報提供、ISO/IEC TS 22440 は策定中です。「規格に準拠」は、学習した方策が安全であることを意味しません
- 試行回数が少ない成功率は幅が広い:10回中9回の「90%」と、1,000回中900回の「90%」は別物です(「世界モデルと身体性AI」編の第6章)
12. 用語集
- 方策(ポリシー)
- 「いま見えているもの」から「次にとる行動」を返す関数。ここではニューラルネットワーク。
- 観測
- ロボットが得る情報(カメラ画像、関節の角度、力など)。
- 行動
- ロボットが出す指令(関節の目標位置、力、ハンドの開閉など)。
- 模倣学習
- 人の実演を「正解」にして、方策を学ぶ方法。
- 行動クローニング(BC)
- 模倣学習のいちばん単純な形。(観測、行動)の組を、教師あり学習で当てはめる。
- DAgger
- 学習した方策が通る状況でも、専門家に正解の行動を付けてもらい、データに加えて学び直す方法。
- 分布のずれ
- 学習したデータと、実際に使う場面の状況が違うこと。
- 行動チャンク
- 1ステップずつでなく、先の数ステップ分の行動をまとめて出すこと。
- 強化学習(RL)
- 行動の結果の点数(報酬)だけを手がかりに、報酬の合計が大きくなる方策を探す方法。
- 報酬
- 行動の結果を表す点数。設計者が決める。
- 収益(リターン)
- 報酬を先まで足し合わせた値。先の報酬は割引率で小さく数える。
- 割引率
- 先の報酬をどれだけ軽く数えるかを表す0〜1の数。
- 環境
- 方策が働きかける相手。ロボット、物、物理法則など。
- PPO
- 方策を少しずつ安全に更新する、広く使われる強化学習の手法。
- オフライン強化学習
- 新しく試さず、すでにあるデータだけで強化学習をすること。
- 報酬ハッキング
- 設計者の意図とは違う、報酬の抜け穴で点数を稼ぐ振る舞い。
- sim2real
- シミュレーションで学んだ方策を実機に移すこと。
- リアリティギャップ
- シミュレーションと現実のずれ。
- ドメインランダム化
- シミュレータの見た目や物理量をばらつかせて、ずれに強くする方法。
- 遠隔操作(テレオペ)
- 人がロボットを離れた場所から操作すること。実演データを集める手段にもなる。
- 成功率
- 試行のうち課題を達成した割合。試行回数と条件を伴って読む。
13. 参考資料(一次情報)
- Ross S., Gordon G. J., Bagnell J. A. “A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning” (DAgger), arXiv:1011.0686 (2010; AISTATS 2011) — arxiv.org/abs/1011.0686
- Bojarski M. ほか “End to End Learning for Self-Driving Cars”, arXiv:1604.07316 (2016) — arxiv.org/abs/1604.07316
- Zhao T. Z. ほか “Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware” (ALOHA, ACT), arXiv:2304.13705 (2023) — arxiv.org/abs/2304.13705
- Chi C. ほか “Diffusion Policy: Visuomotor Policy Learning via Action Diffusion”, arXiv:2303.04137 (2023) — arxiv.org/abs/2303.04137
- Mandlekar A. ほか “What Matters in Learning from Offline Human Demonstrations for Robot Manipulation”, arXiv:2108.03298 (2021) — arxiv.org/abs/2108.03298
- Schulman J. ほか “Proximal Policy Optimization Algorithms”, arXiv:1707.06347 (2017) — arxiv.org/abs/1707.06347
- Haarnoja T. ほか “Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor”, arXiv:1801.01290 (2018) — arxiv.org/abs/1801.01290
- Amodei D. ほか “Concrete Problems in AI Safety”, arXiv:1606.06565 (2016) — arxiv.org/abs/1606.06565
- Levine S. ほか “Learning Hand-Eye Coordination for Robotic Grasping with Deep Learning and Large-Scale Data Collection”, arXiv:1603.02199 (2016) — arxiv.org/abs/1603.02199
- Kalashnikov D. ほか “QT-Opt: Scalable Deep Reinforcement Learning for Vision-Based Robotic Manipulation”, arXiv:1806.10293 (2018) — arxiv.org/abs/1806.10293
- Luo J. ほか “Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning” (HIL-SERL), arXiv:2410.21845 (2024) — arxiv.org/abs/2410.21845
- Makoviychuk V. ほか “Isaac Gym: High Performance GPU-Based Physics Simulation For Robot Learning”, arXiv:2108.10470 (2021) — arxiv.org/abs/2108.10470
- Rudin N. ほか “Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning”, arXiv:2109.11978 (2021) — arxiv.org/abs/2109.11978
- Hwangbo J. ほか “Learning agile and dynamic motor skills for legged robots”, Science Robotics 4, eaau5872 (2019), DOI 10.1126/scirobotics.aau5872 — doi.org/10.1126/scirobotics.aau5872
- Lee J. ほか “Learning quadrupedal locomotion over challenging terrain”, Science Robotics 5, eabc5986 (2020), DOI 10.1126/scirobotics.abc5986 — doi.org/10.1126/scirobotics.abc5986
- Miki T. ほか “Learning robust perceptive locomotion for quadrupedal robots in the wild”, Science Robotics 7, eabk2822 (2022), DOI 10.1126/scirobotics.abk2822 — doi.org/10.1126/scirobotics.abk2822
- Kaufmann E. ほか “Champion-level drone racing using deep reinforcement learning”, Nature 620, 982–987 (2023), DOI 10.1038/s41586-023-06419-4 — doi.org/10.1038/s41586-023-06419-4
- Tobin J. ほか “Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World”, arXiv:1703.06907 (2017) — arxiv.org/abs/1703.06907
- OpenAI ほか “Learning Dexterous In-Hand Manipulation”, arXiv:1808.00177 (2018) — arxiv.org/abs/1808.00177
- OpenAI ほか “Solving Rubik’s Cube with a Robot Hand”, arXiv:1910.07113 (2019) — arxiv.org/abs/1910.07113
- Fu J. ほか “D4RL: Datasets for Deep Data-Driven Reinforcement Learning”, arXiv:2004.07219 (2020) — arxiv.org/abs/2004.07219
- Yu T. ほか “Meta-World: A Benchmark and Evaluation for Multi-Task and Meta Reinforcement Learning”, arXiv:1910.10897 (2019) — arxiv.org/abs/1910.10897
- ISO ISO 10218-1:2025 “Robotics — Safety requirements — Part 1: Industrial robots” (Edition 3, February 2025)。確認日 2026年10月25日 — iso.org/standard/73933.html
- ISO ISO 10218-2:2025 “Robotics — Safety requirements — Part 2: Industrial robot applications and robot cells” (Edition 2, February 2025)。確認日 2026年10月25日 — iso.org/standard/73934.html
- ISO/IEC ISO/IEC TR 5469:2024 “Artificial intelligence — Functional safety and AI systems” (Edition 1, January 2024)。確認日 2026年10月25日 — iso.org/standard/81283.html
- ISO/IEC ISO/IEC CD TS 22440-1 “Artificial intelligence — Functional safety and AI systems — Part 1: Requirements” (committee draft; stage 30.60, close of comment period)。確認日 2026年10月25日 — iso.org/standard/89535.html
14. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| ネットワークが画面の画素から操舵指令への写像を人の運転データで学ぶ「端から端まで」の方式(Bojarski ら) | Bojarski らの論文(要旨) 出典2 https://arxiv.org/abs/1604.07316 | 事実 |
| 模倣学習では方策の行動が次の観測に影響するため独立同分布の仮定が成り立たないこと、誤りがT²ε回まで増えうること(この上限が最悪の場合に達する例があること)、DAggerがその対策であること | Ross らの論文(序論、定理) 出典1 https://arxiv.org/abs/1011.0686 | 事実 |
| 誤りの上限の表・図(ε=1%、T=10〜200)、ε>1/T で上限が無意味になること | 本稿の計算(Ross らの上限 T²ε の算術。ε=1%は想定)。実在の方策の誤り回数ではない | 本稿の計算 |
| ACT/ALOHA:低コストの機器で実演からの模倣学習により、行動列の生成モデルで6つの難しい課題を80〜90%の成功率、実演10分で学んだこと。誤りの積み重ねと人の実演の非定常性が課題であること | Zhao らの論文(要旨) 出典3 https://arxiv.org/abs/2304.13705 | 事実 |
| Diffusion Policyが拡散過程として方策を表し、4つのベンチマークの12課題で既存手法を平均46.9%上回ると報告したこと | Chi らの論文(要旨) 出典4 https://arxiv.org/abs/2303.04137 | 事実 |
| robomimic:6つのオフライン学習手法を、5つのシミュレーションと3つの実機の多段階課題で比べ、実演の質への依存などを分析したこと | Mandlekar らの論文(要旨) 出典5 https://arxiv.org/abs/2108.03298 | 事実 |
| PPO(方策勾配法の一群。複数エポックのミニバッチ更新が可能)、SAC(オフポリシーのアクター・クリティック。高いサンプル数が課題とされてきたこと) | Schulman らの論文(要旨)、Haarnoja らの論文(要旨) 出典6 https://arxiv.org/abs/1707.06347 出典7 https://arxiv.org/abs/1801.01290 | 事実 |
| 報酬の誤った設計(報酬ハッキング)や分布のずれが、機械学習システムの事故の原因になりうること | Amodei らの論文(要旨) 出典8 https://arxiv.org/abs/1606.06565 | 事実 |
| 実機の試行錯誤:把持80万回超を2か月、6〜14台で収集(Levine ら)。58万回超の実機の把持で、未知物体への把持成功率96%(QT-Opt)。人の実演と修正を組み込んだRLが1〜2.5時間の学習で高い成功率に達したこと(HIL-SERL) | Levine ら、Kalashnikov ら、Luo らの論文(要旨) 出典9 https://arxiv.org/abs/1603.02199 出典10 https://arxiv.org/abs/1806.10293 出典11 https://arxiv.org/abs/2410.21845 | 事実 |
| 1枚のGPUでの大規模並列シミュレーション:平坦な地形で4分未満、不整地で20分でANYmalの歩行方策を学習し実機に移したこと(Rudin ら)。物理シミュレーションと方策学習をGPU上で行い2〜3桁高速化したこと(Isaac Gym) | Rudin らの論文(要旨)、Makoviychuk らの論文(要旨) 出典13 https://arxiv.org/abs/2109.11978 出典12 https://arxiv.org/abs/2108.10470 | 事実 |
| シミュレーションで訓練した方策をANYmalに移し、速度指令への追従、より速い走行、転倒からの復帰を実現したこと(Hwangbo ら)。proprioception(体内の感覚)だけの方策が泥・雪・がれきなどで頑健に歩くこと(Lee ら)。外界の知覚と体内の感覚を統合した方策(Miki ら) | Hwangbo ら、Lee ら、Miki らの論文(Science Robotics の要旨) 出典14 https://doi.org/10.1126/scirobotics.aau5872 出典15 https://doi.org/10.1126/scirobotics.abc5986 出典16 https://doi.org/10.1126/scirobotics.abk2822 | 事実 |
| Swift:シミュレーションでの深層強化学習と実世界のデータを組み合わせた自律ドローンが、3人の人間の優勝者との1対1のレースで、それぞれに複数のレースで勝ち、最速の記録を出したこと | Kaufmann らの論文(要旨) 出典17 https://doi.org/10.1038/s41586-023-06419-4 | 事実 |
| ドメインランダム化(描画の乱数化で実世界の物体検出を学習、1.5 cmの精度)と、摩擦係数などの物理量をランダム化して人の実演なしで実機に移したShadow Handの持ち替え、ルービックキューブ(ADR) | Tobin ら、OpenAI の論文(要旨) 出典18 https://arxiv.org/abs/1703.06907 出典19 https://arxiv.org/abs/1808.00177 出典20 https://arxiv.org/abs/1910.07113 | 事実 |
| D4RL(オフライン強化学習のデータセットと評価)、Meta-World(50の操作課題のベンチマーク) | Fu らの論文(要旨)、Yu らの論文(要旨) 出典21 https://arxiv.org/abs/2004.07219 出典22 https://arxiv.org/abs/1910.10897 | 事実 |
| ISO 10218-1:2025・ISO 10218-2:2025(産業用ロボットの安全要求、2025年2月)、ISO/IEC TR 5469:2024(AIの機能安全、技術報告)、ISO/IEC CD TS 22440-1(AIの機能安全、要求事項。委員会原案の段階)の番号・題名・段階 | ISOの公式ページ 出典23 https://www.iso.org/standard/73933.html 出典24 https://www.iso.org/standard/73934.html 出典25 https://www.iso.org/standard/81283.html 出典26 https://www.iso.org/standard/89535.html | 事実 |
| 実機の学習時間の想定(100万ステップ÷10 Hz=27.8時間、1,000万ステップ÷50 Hz=55.6時間)、収益の計算(0.9⁴=0.656)、図6の並べ方 | 本稿の計算(ステップ数÷制御周波数)。論文の報告値とは課題・条件が違い、優劣を示さない | 本稿の計算 |
| 「手本が足りない状況で崩れる」「摩擦などの物性値の幅を測ってランダム化の範囲を決める」「実機の摩耗や汚れで状況が変わる」「安全用途に学習した方策だけを使わない」という読み取り | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 学習した方策の安全性評価を直接定める規格、実機での強化学習の失敗・故障の統計、特定ロボットの学習時間の公称 | 本稿の調査範囲では一次情報で確認できなかったため記載していない(解説) | 解説 |
| 図1・図8がImageGen生成の概念画像であること、図2・図3・図7が説明のための概念図、図4・図5・図6が本稿の計算を含む作図であること | 本記事による注記 | 解説 |
最終更新:2026年10月25日/出典は一次情報(arXiv の論文、Science Robotics・Nature の論文、ISO の公式ページ)に限定しています。ISO の規格本文は有料のため確認できていません。 数値例は本稿が置いた想定値による計算で、実在のロボット・方策の性能ではありません。 学習した方策の安全性評価を直接定める規格、実機の強化学習の失敗・故障の統計、特定ロボットの学習時間の公称については、確認できなかったため記載していません。 図1と図8はImageGen生成の概念画像で、その他の図は説明用の概念図または本稿の計算を含む作図です。