TECHNOLOGY EXPLAINER
世界モデルと身体性AI
― 「次に何が起きるか」を予測し、体を動かすAIの仕組みと、その評価の読み方
ロボットのように体を持ち、現実の世界で動くAIを「身体性AI(embodied AI)」と呼びます。言語モデルと違い、間違いが物にぶつかる、壊す、人に当たる、という結果になるため、「どう作るか」と同じくらい「どう確かめるか」が重要です。 この記事では、「世界モデル」という言葉の3つの使われ方、ロボット基盤モデル(視覚・言語・行動をつなぐモデル)、シミュレーションと実機のギャップ、遠隔操作によるデータ収集、そして成功率や安全規格の読み方を、一次情報の範囲で整理します。ロボットの機構やドローンは、本シリーズの「ドローン・ロボティクス」編で扱うため、ここではAI側に絞ります。
- 身体性AIとは何か(3行でつかむ)
- 世界モデルとは何か ― 3つの使われ方
- ロボット基盤モデル ― 視覚・言語・行動をつなぐ
- シミュレーションと実機のギャップ
- データ収集 ― 遠隔操作とその周辺
- 成功率の読み方(本稿の計算つき)
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定・策定中であり、実績や確定が確認できていない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
この分野は変化が速く、モデルや規格の状況は数か月で変わります。本記事のモデル名・日付・規格の段階は2026年10月15日に公開資料で確認した範囲です。 ロボットの成功率は、特定のロボット・課題・環境・試行回数での、開発元や研究者の報告値です。異なる設定の数値を並べて、モデルの優劣は論じません。「世界初」「汎用」といった言葉は、開発元の主張として扱います。
1. 身体性AIとは何か(3行でつかむ)
- 「世界モデル」には3つの意味がある:(1)行動に応じて環境がどう変わるかを予測する、制御のための環境モデル、(2)映像を生成して世界を「シミュレート」するモデル、(3)映像の特徴を予測して表現を学ぶ JEPA 系のモデル、です。同じ言葉でも、予測するものと確かめ方が違います事実[参考資料1・7・6]
- ロボット基盤モデル(VLA)は、視覚言語モデルに「行動」を出力させて作る:画像と言語の指示を入力し、ロボットの行動を出力します。訓練データは、遠隔操作の記録、人の動画、シミュレーションなどを混ぜて作られます事実[参考資料12・15・16・18]
- 「シミュレーションで成功」は「実機で成功」ではない:摩擦などの物理量、接触、視覚、遅延がずれます。ロボットの成功率は、試行回数が少ないと幅が大きく、「90%」の意味は試行回数で変わります事実/本稿の計算
ロボットの成功率は、試行回数と条件を書かなければ、数字として比べられません。 同じ「90%」でも、10回中9回なら95%信頼区間はおよそ60〜98%、1,000回中900回ならおよそ88〜92%です本稿の計算(第6章)。
2. 世界モデルとは何か ― 3つの使われ方
「世界モデル」は、AIが「世界が(自分の行動によって)どう変わるか」を内部に持つ、という考えを指します。ただし、研究の文脈で3つの違う使われ方があります。以下では、論文・技術報告の記述にもとづいて整理します。
(1) 制御のための環境モデル:World Models から Dreamer へ
Ha と Schmidhuber の「World Models」(2018年)は、強化学習の環境の生成モデルを作り、空間と時間の圧縮した表現を教師なしで学ぶ、と説明しています。そこから取り出した特徴を、とても小さな方策の入力にして課題を解き、さらに、世界モデルが生成した「幻覚の夢」の中だけで方策を訓練して、実際の環境に転移させることもできた、と報告しています事実[参考資料1]。 Dreamer(Hafner ら)は、学習した世界モデルの潜在空間で「想像」した軌跡を使って行動を学び、20の視覚制御課題で、データ効率・計算時間・最終性能で既存手法を上回ったと報告しています[参考資料2]。 その後継の DreamerV3 は、単一の設定で150以上の多様な課題を扱い、人のデータやカリキュラムなしに、Minecraft でダイヤモンドを収集した最初のアルゴリズムだと報告しています(Nature 640、2025年)事実[参考資料3]。
(2) 映像生成による「世界のシミュレータ」
映像生成モデルを世界のシミュレータとみなす見方があります。OpenAI の Sora の技術報告(2024年2月15日)は、動画生成モデルのスケーリングが「物理世界の汎用シミュレータ」への有望な道だと示唆しつつ、同じ報告の中で、ガラスが割れるといった基本的な相互作用の物理を正確にはモデル化しない、食べ物を食べる場面で物体の状態変化が正しいとは限らない、といった限界を挙げています事実[参考資料10]。
Genie(Bruce ら、2024年)は、ラベルのないインターネット動画から教師なしで訓練された「生成的な対話環境」で、110億パラメータの基盤世界モデルと位置づけられ、時空間の映像トークナイザー、自己回帰の動力学モデル、潜在行動モデルから成ります。行動ラベルなしで訓練しながら、フレームごとに行動できる環境を生成できる、と述べています[参考資料7]。 Genie 3(Google DeepMind のブログ、2025年8月5日付)は、文章から、24フレーム/秒・720pでリアルタイムに操作できる世界を生成し、一貫性は数分間保てる、と記述しています。同じブログは、現在の限界として、エージェント自身が直接行える行動の範囲が限られること、複数のエージェントの相互作用の再現が研究課題であること、現実の場所を正確には再現できないこと、連続した対話は数分で数時間には及ばないことを挙げています事実[参考資料8]。
NVIDIA の Cosmos は、「物理AIはまずデジタルで訓練される必要がある」という考えのもと、動画の選別パイプライン、事前学習済みの世界基盤モデル、動画トークナイザーなどを含むプラットフォームで、モデルは寛容なライセンスのオープンウェイトとして公開された、と論文は述べています事実[参考資料9]。
(3) 表現を予測する:JEPA
JEPA(Joint-Embedding Predictive Architecture)は、画素そのものを再構成せず、表現(特徴)を予測する設計です。I-JEPA は、画像の一つのコンテキストブロックから、同じ画像の複数のターゲットブロックの表現を予測する、非生成の自己教師あり学習です[参考資料4]。V-JEPA は、動画の特徴予測だけで訓練し(200万本の動画)、凍結した骨格でも動き・外観の両方の課題で有効な表現を得た、と報告しています[参考資料5]。 V-JEPA 2 は、100万時間を超えるインターネット動画で行動なしに事前訓練し、さらに Droid データセットの62時間未満のラベルなしロボット動画で、行動で条件づけた潜在世界モデル(V-JEPA 2-AC)を追加訓練しました。論文は、これを2つの研究室の Franka アームに追加の訓練なしで適用し、画像のゴールを使った計画で物のつかみ・置きができた、と報告しています事実[参考資料6]。
Sora が「世界シミュレータ」と呼ばれても、同じ報告が物理の誤りを挙げています。Genie 3 の「一貫性が数分」という記述は、開発元の説明です。映像として自然であることと、行動に応じた正確な予測ができることは別の性質で、後者を測る共通の標準指標は、本稿が確認した範囲では見つかりませんでした(第8章)。 世界モデルを使うロボットの結果も、V-JEPA 2-AC のように「特定のロボット・特定の課題」での報告です。
3. ロボット基盤モデル ― 視覚・言語・行動をつなぐ
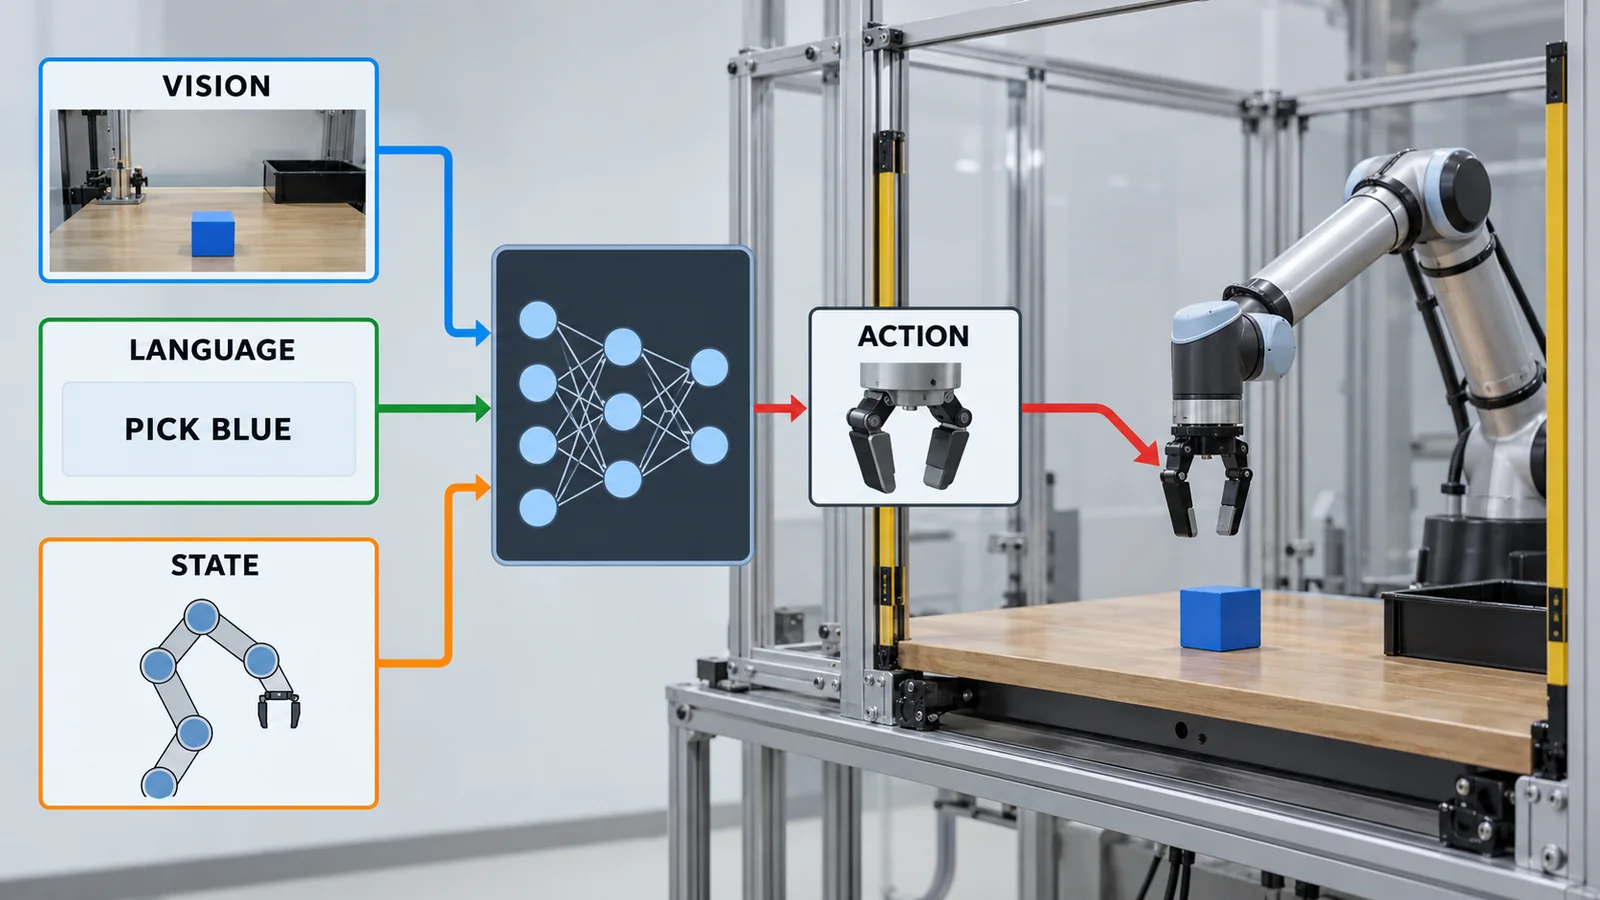
言語モデルの成功を受けて、「大規模で多様なデータで事前訓練した一つのモデルを、さまざまなロボットや課題に使う」考えが広がりました。ロボットの行動まで出力する視覚言語モデルはVLA(vision-language-action)モデルと呼ばれます。
元のSVG模式図・数値・出典注記を見る
(1) 流れの整理:RT-1、RT-2 から、汎用方策へ
RT-1(Brohan ら、2022年)は、実ロボットでの大規模データ収集を土台に、データ量・モデル規模・データの多様性の関数として汎化を調べ、高容量のモデルが多様なロボットデータを吸収できると論じました[参考資料11]。 RT-2 は、ウェブ規模の視覚言語モデルを、ロボットの軌跡データとウェブの視覚言語課題で一緒に微調整し、行動をテキストトークンとして言語と同じ形式で扱います。6,000回の評価試行で、新しい物体への汎化、訓練データにない指示の解釈などを報告しています事実[参考資料12]。
Open X-Embodiment は、21機関が22種類のロボットで集めた527のスキル(160,266のタスク)のデータを標準形式にまとめ、そこで訓練した RT-X が他のロボットの経験から「正の転移」を示したと報告しています[参考資料13]。Octo は、そのデータの80万軌跡で訓練したオープンな方策で、新しいセンサーや行動空間への微調整を、消費者向け GPU で数時間で行えると述べています[参考資料14]。OpenVLA は、97万の実ロボットのデモで訓練した70億パラメータのオープンな VLA で、29の課題で RT-2-X(550億)を絶対成功率で16.5%上回り、パラメータは7分の1と報告しています(論文の条件での値)事実[参考資料15]。
(2) 行動をどう生成するか:拡散・フロー・テキスト
行動の出し方は、大きく三つに分かれます(図3)。RT-2 のようにテキストトークンで出す方法、Diffusion Policy(Chi ら)のように拡散で行動を生成する方法、π0 のようにフローマッチングで生成する方法です。Diffusion Policy は、4つのロボット操作ベンチマークの12課題で、既存の最先端手法を平均46.9%上回ると報告しています[参考資料21]。π0(Physical Intelligence)は、事前学習済み VLM の上にフローマッチングの構造を載せ、単腕・双腕・移動マニピュレータなど複数の器用なロボットのデータで訓練し、洗濯物の折りたたみ、机の片付け、箱の組み立てを含む課題で評価しています事実[参考資料16]。
(3) 近年のモデル(開発元の技術報告)
| モデル(出典) | 構成の要点(技術報告の記述) | データ・報告された評価 | 読むときの注意 |
|---|---|---|---|
| π0.5(Physical Intelligence)[参考資料17] | π0 をもとに、多様な課題の共同訓練で広い汎化を狙う。複数のロボット、高レベルの意味予測、ウェブデータなどを使う | 初めて、学習ベースのエンドツーエンドのロボットシステムが、まったく新しい家で、台所や寝室の掃除のような長い、器用な作業をこなしたと報告 | 開発元の課題・ロボットでの報告。「新しい家」の数や成功率の条件は本文で確認が必要 |
| GR00T N1(NVIDIA)[参考資料18] | 人型ロボット向けのオープンな基盤モデル。視覚言語の部分(System 2)と、動作をリアルタイムに生成する拡散 Transformer(System 1)を一緒に訓練する | 実ロボットの軌跡、人の動画、合成データの混合で訓練。シミュレーションのベンチマークで模倣学習の基準を上回り、Fourier GR-1 で双腕作業を実演と報告 | 基準手法・ベンチマークは論文が選んだもの。他社モデルとの優劣ではない |
| Gemini Robotics(Google DeepMind)[参考資料19] | Gemini 2.0 を土台とする VLA と、空間・時間の理解を強めた Gemini Robotics-ER(物体検出、ポインティング、軌跡・把持の予測など)の2モデル | 追加の微調整で、短い課題を100回ほどのデモから学べると報告 | 報告は開発元の課題。再現は確認できなかった |
| Gemini Robotics 1.5[参考資料20] | 異なる機体のデータから学ぶ Motion Transfer、行動の前に自然言語で考える多段の推論、最先端を謳う ER 1.5 | 複数ステップの課題の分解・実行が向上したと記述 | 「最先端」は開発元の記述 |
すべて事実(各技術報告の記述)。「評価」の比較表ではありません。ロボット・課題・環境・試行回数が違うため、これらの結果を並べてモデルの優劣は言えません。
4. シミュレーションと実機のギャップ
ロボットの訓練を、すべて実機で行うのは時間も費用もかかります。そこで、シミュレーションで訓練して実機に移す(sim-to-real)方法が使われますが、シミュレーションと現実のずれ(リアリティギャップ)が障害になります。ずれの要因を、論文の記述をもとに整理します。
- 描画のランダム化(Tobin ら、2017年):シミュレータの描画をランダムに変えることで、「実世界が単なる別のばらつきに見える」ようにする方法です。非現実的なランダムな質感だけのシミュレータのデータで、実世界で1.5 cm の精度の物体検出器を学べ、これを使って散らかった環境での把持を行えた、と報告しています事実[参考資料22]
- 物理量のランダム化(OpenAI、2018年):Shadow Dexterous Hand での物体の持ち替えを、摩擦係数や物体の見た目など多くの物理的性質をランダム化したシミュレーションだけで訓練し、実機に移せた、人のデモなしで、と報告しています[参考資料23]。続く論文は、自動ドメインランダム化(ADR)で、人型のロボットハンドでルービックキューブを解いた、と述べています事実[参考資料24]
- 脚ロボット:Hwangbo らは、シミュレーションで訓練したニューラルネットの方策を ANYmal に移し、速度指令への追従、より速い走行、転倒からの復帰を実現したと報告しています[参考資料25]。続く Lee らは、学習ベースの歩行制御器で、ANYmal が自然の悪路を踏破できるようにしたと述べています[参考資料26]事実
- GPU 並列のシミュレーション基盤(Isaac Lab):高忠実度の GPU 並列物理、フォトリアルな描画、アクチュエータのモデル、センサーのシミュレーション、データ収集、ドメインランダム化のツールを一つにまとめた枠組みだと、論文は述べています事実[参考資料27]
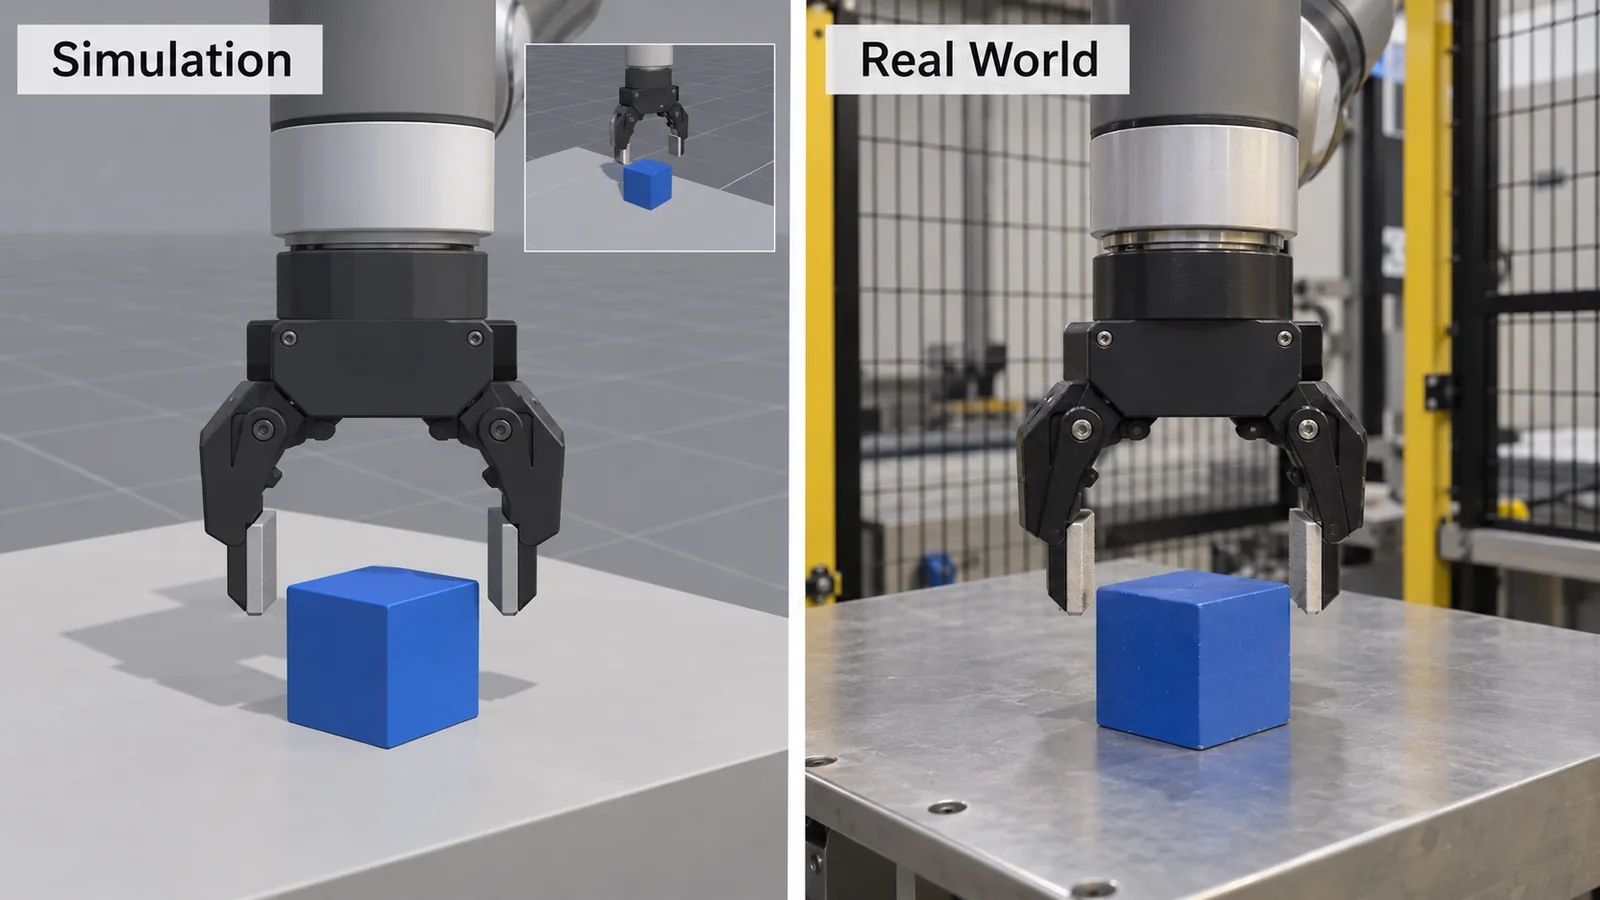
ランダム化の対象に、摩擦係数のような材料の物性値が挙がっていることに注目してください[参考資料23]。シミュレータは、接触を簡略なモデルで近似するため、摩擦、剛性、減衰、表面の粗さといった値が実物とずれると、方策は実機で期待通りに動きません。布、ケーブル、粉体、液体のような変形・流動する材料は、さらに再現が難しい領域です(これは本記事による解説で、変形材料の再現精度を測った一次資料は確認していません)。
材料の分野の知識が活きるのは、物性値を「一点」ではなく「測定した範囲」で与えることです。たとえば、把持する対象や床・治具の表面の摩擦係数、弾性率の測定値の幅を、ランダム化の範囲の根拠にします。ランダム化の範囲を広げすぎると方策が慎重になりすぎ、狭すぎると実機で破綻する、というトレードオフがあり得ます(推測です。一般論としての見立てで、論文で定量化された結果ではありません)。
評価でのギャップ:SIMPLER(Li ら)は、実世界での方策評価は大規模に行いにくく再現性にも課題があるとして、制御と視覚の違いを緩和した評価用のシミュレーション環境を作りました。対にした実機とシミュレーションの評価で、方策の成績の間に強い相関があり、分布のずれへの感度のような挙動の特徴も反映されたと報告しています。ただし、これは特定のロボット設定での結果で、すべてのロボット・課題で成り立つとは限りません事実[参考資料34]。
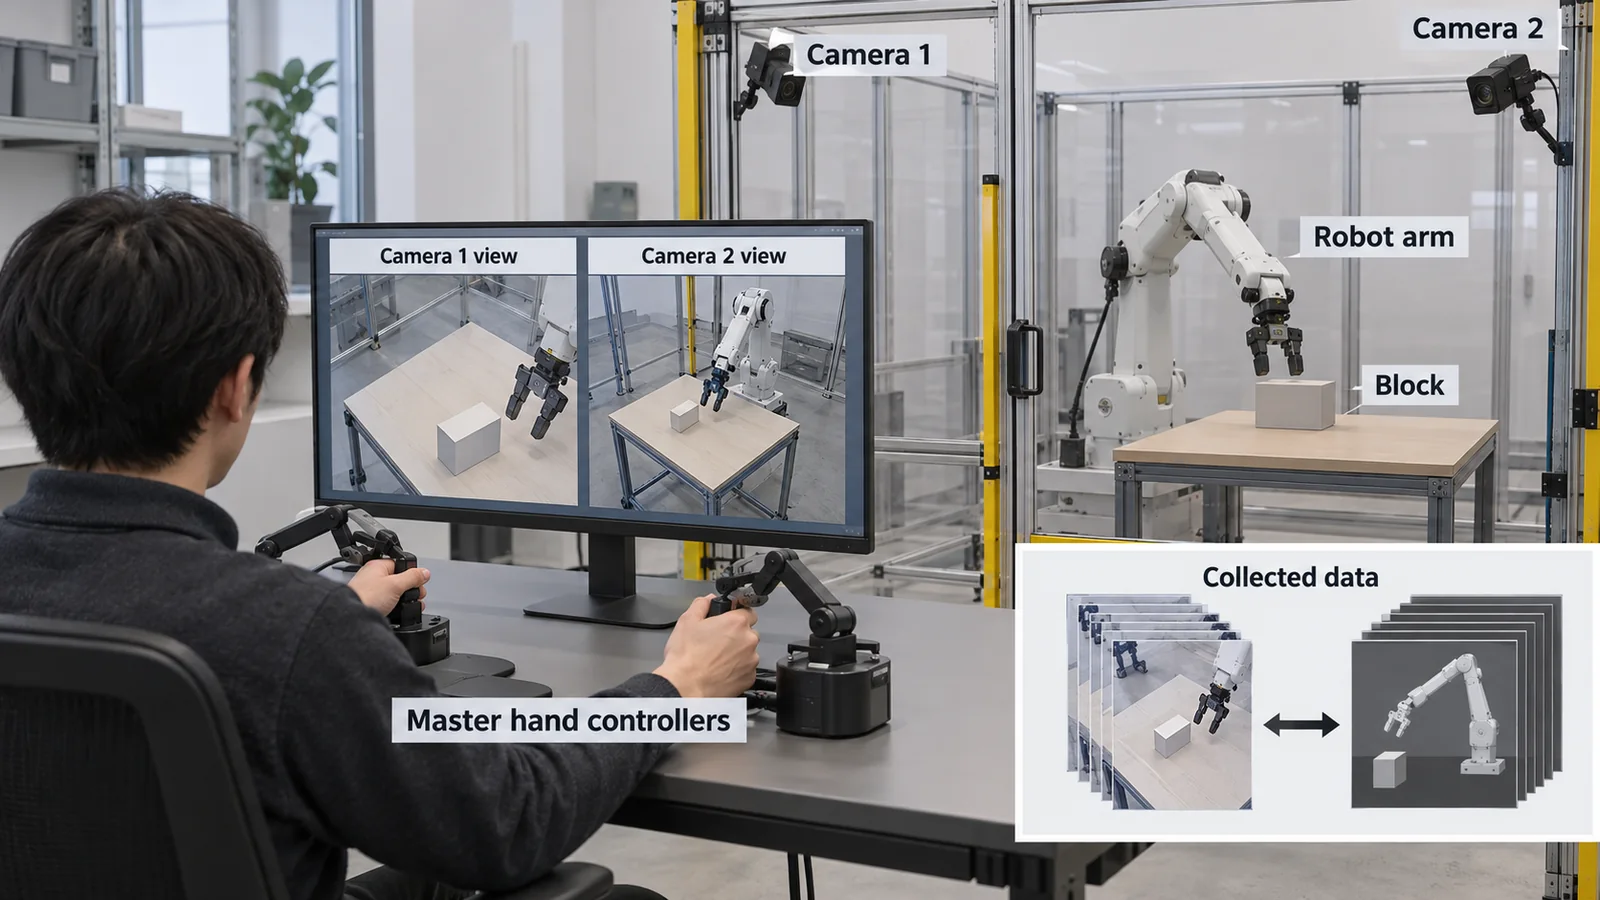
5. データ収集 ― 遠隔操作とその周辺
ロボット基盤モデルの「燃料」は、ロボットの行動の記録です。言語モデルのウェブ文書と違い、ロボットのデータは自然には貯まらず、人が操作して集める必要があります。主な方法を、論文の記述にもとづいて整理します。
| 方式 | 代表例(出典) | 要点(論文の記述) | 注意 |
|---|---|---|---|
| 低コストの遠隔操作 | ALOHA/ACT[参考資料28]、Mobile ALOHA[参考資料29] | ALOHA は、低コストで精度の低いハードでも、実演からの模倣学習で細かい作業ができるかを検証した。行動列の生成モデル ACT により、6つの難しい課題(半透明の容器のふたを開ける、電池を差し込むなど)を80〜90%の成功率で学べ、実演はわずか10分と報告。Mobile ALOHA は移動台車と全身の遠隔操作で、各課題50回の実演と既存データの共同訓練で成功率が最大90%上がったと報告 | 論文自身が、方策の誤りが時間とともに累積しうること、人のデモが一定でない(非定常)ことを課題に挙げる |
| 手持ちの道具で人が実演 | UMI[参考資料30] | 手持ちのグリッパーで、ロボットなしで現場の実演を集め、ロボットの方策に直接移す。推論時の遅延合わせと相対軌道の行動表現により、方策は機体に依存せず、複数のロボットで使えると述べる | 実演の質(人の腕前、条件)がそのまま方策に反映される(解説) |
| 分散して収集した大規模データ | DROID[参考資料31] | 76,000の実演軌跡(350時間)を、564の場面・84の課題で、北米・アジア・欧州の50人が12か月で収集。多様なデータで学ぶと性能・汎化が上がったと報告 | 論文は、多様な環境でのデータ収集には、物流・安全・ハードと人手の大きな投資が要ると述べる |
| 機関をまたぐ共同データ | Open X-Embodiment[参考資料13] | 21機関・22種類のロボット・527スキルを標準形式にまとめる | ロボットごとに行動空間が違う。Octo のように、新しい行動空間への微調整の仕組みが要る[参考資料14] |
| 人の動画・合成データの併用 | GR00T N1[参考資料18]、V-JEPA 2[参考資料6] | GR00T N1 は実ロボット、人の動画、合成データの混合で訓練。V-JEPA 2-AC は62時間未満のロボット動画で行動条件づけ | 動画に行動のラベルがない場合の扱いが設計の要点 |
すべて事実(各論文の記述)。方式の分け方は本記事の整理(解説)です。
本稿の計算 DROID は350時間・76,000軌跡。350時間=350×3,600=1,260,000秒なので、1軌跡の平均は 1,260,000÷76,000=約16.6秒。V-JEPA 2-AC が使った Droid のロボット動画は62時間未満(論文)で、350時間の 約18%以下(62÷350)。
前提と限界:数値は論文の記載値の単純な割り算です。62時間が DROID のどの部分かは、論文の記述以上には確認していません。軌跡の長さの分布や、操作の難しさは平均からは分かりません。
遠隔操作で集めたデータは、操作した人の腕前、癖、その日の条件のばらつきを含みます。ACT の論文が「人のデモは非定常になりうる」と述べているのは、この点です[参考資料28]。 工場のプロセスデータと同じく、データの質と条件の記録(誰が、いつ、どのロボットで、どの対象を、どんな環境で)が、あとで方策の失敗原因をたどる手がかりになります。ばらつきの管理や、失敗した実演を残すかどうかの判断は、データの設計の問題です(本記事による解説)。
また、人の技能を学習データにすることは、熟練者のノウハウの扱い(権利・労務・守秘)の問題も伴いますが、本記事は法的な助言を書きません。
6. 成功率の読み方(本稿の計算つき)
ロボットの論文は、課題の成功率で性能を示します。素材・プロセスの技術者になじみのある言葉でいえば、歩留まりです。歩留まりと同じく、成功率も何回試して、どんな条件かを見なければ解釈できません。
本稿の計算 試行が互いに独立で、条件が同じであると仮定して、Wilson の方法で95%信頼区間を計算します。
- 観測された成功率が90%のとき:10回中9回なら 約59.6〜98.2%、20回中18回なら 約69.9〜97.2%、50回中45回なら 約78.6〜95.7%、100回中90回なら 約82.6〜94.5%、1,000回中900回なら 約88.0〜91.7%
- すべて成功したとき:20回すべて成功でも、95%信頼区間の下限は 約83.9%、50回で約92.9%、100回で約96.3%、300回で約98.7%
- 「3の法則」:n回の試行で失敗が0回のとき、失敗率の95%上限はおよそ 3÷n。失敗率を1%以下と言うには、約300回の連続成功が必要(3÷299=約1.0%)
- 連続した工程:各ステップの成功率が90%で互いに独立なら、5ステップを続けて成功する確率は 0.9⁵=約59%
前提と限界:実機の試行は、物体の置き方、照明、摩耗などで条件が変わり、独立とは限りません。区間は標本の統計的な幅だけを表し、条件のかたよりによる誤差は含みません。実在のロボットの結果ではありません。
実際の論文の評価の規模は、さまざまです。RT-2 は6,000回の評価試行を報告し[参考資料12]、RoboArena は7つの方策を600回超の実機の対戦評価(二重盲検の対比較)で順位づけしています[参考資料35]。RoboArena は、固定した課題・環境・場所を標準化する従来の評価では、多様な課題と環境にわたる汎用方策の評価に拡張しにくいとして、評価者が自由に課題と環境を選び、二つの方策を二重盲検で比べる、クラウドソース型の方法を提案しました。DROID プラットフォームで7つの学術機関の評価者が参加し、従来の集中型の評価より正確に順位づけでき、拡張性・耐障害性・信頼性が高いと報告しています事実[参考資料35]。
シミュレーション上のベンチマークも使われます。LIBERO は、ロボット操作の生涯学習のベンチマークで、4つのタスクスイート(計130課題)と人の遠隔操作によるデモを提供します[参考資料32]。CALVIN は、言語で条件づけた長い手順のロボット操作の方策学習のベンチマークです[参考資料33]事実。ただし、シミュレーションの成績が実機の成績を保証するわけではありません(第4章)。
工程の歩留まりを20個の試作で評価して「90%」と言う人はいないはずです。ロボットも同じで、少数の試行での「90%」は、工程能力の主張としては弱いのです。導入を検討するときは、(1) 何回試したか、(2) 対象物・配置・照明をどの範囲で変えたか、(3) 失敗の中身(つかみ損ね、落下、衝突、停止)、(4) 人の介入の有無、を確認します(本記事による解説)。 また、「連続した工程の積」(0.9の5乗は約59%)は、長い作業ほど全体の成功率が急に下がることを示します。ステップごとの成功率だけでなく、作業全体の成功率を見る必要があります。
7. 限界と、確認できなかったこと
(1) 現在のモデルの性能
本記事の各モデル(π0、GR00T N1、Gemini Robotics など)と成功率は、各報告の時点・指定した設定の値です。2026年10月15日時点の最新モデルと、その後の評価を網羅していません。実機の結果は、独立した第三者による再現を確認していません。
(2) 世界モデルの検証
世界モデルの「物理的な正確さ」を測る共通の標準指標は、確認できませんでした。Genie 3 は開発元のブログで、限定公開の研究プレビューかどうかなど、提供状況の記載は確認していません。ヤン・ルカン氏の2022年の立場表明論文(OpenReview)は、自動取得が拒否されたため、本文を確認していません。JEPA の説明は I-JEPA・V-JEPA・V-JEPA 2 の論文の記述にとどめています。
(3) 規格
ISO の規格ページは自動取得が拒否されるため、番号・題名・版・発行時期・適用範囲は、検索結果に表示された公式ページの記載で確認しており、規格の本文は確認していません。学習で得た方策(ロボット基盤モデル)の安全性評価の方法を直接定めた規格は、確認できませんでした。
(4) 取り上げなかった内容
ロボットの機構・アクチュエータ・センサー、ドローンは「ドローン・ロボティクス」編で、材料探索や自律実験室は「マテリアルインフォマティクス」編で、自動運転は「自動運転とAI」編で扱います。人型ロボットの製品や事業計画、ロボットの価格、市場規模は扱いません。
- 「世界モデル」は3つの意味で使われます。制御用の環境モデル、映像生成のシミュレータ、表現を予測する JEPA。名前から、できることを断定しません事実
- ロボット基盤モデルは、視覚言語モデルに行動を出力させて作ります。行動は、テキスト・拡散・フローで生成され、データは遠隔操作・人の動画・合成を混ぜます事実
- シミュレーションと実機のギャップは、物性値・接触・視覚・遅延にあります。ランダム化や実機との対比評価で緩和します事実
- 成功率は、試行回数と条件で読みます。10回中9回の「90%」は約60〜98%、1,000回中900回は約88〜92%本稿の計算
- 安全は、産業用ロボットなどの既存の規格が中心で、学習で得た方策を直接扱う規格は確認できませんでした事実
8. 評価・標準の読み方
身体性AIの評価には、(1)課題の成功率(実機・シミュレーション)、(2)世界モデルの予測の質、(3)データの質と量、(4)安全性の4つの面があります。ベンチマークは研究ごとに課題・環境・ロボットが違い、安全は産業用ロボットなど既存の規格が土台になります。 学習で得た方策そのものを直接評価する国際規格は、本稿が確認した範囲では見つかりませんでした。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO・NIST など) | 読み方の注意 |
|---|---|---|---|
| シミュレーション上の方策評価 | LIBERO:4つのタスクスイート計130課題と遠隔操作のデモ(Liu ら)[参考資料32]。CALVIN:言語条件つきの長い手順の操作(Mees ら)[参考資料33]。SIMPLER:実機の方策評価を再現するシミュレーション環境(Li ら)[参考資料34] | 確認できなかった | SIMPLER は、特定のロボット設定で、実機の成績との強い相関を報告。他の設定への一般化は保証されない。シミュレーションの成績は実機の成績の代わりにならない 事実 |
| 実機での方策評価 | RT-2:6,000回の評価試行[参考資料12]。RoboArena:二重盲検の対比較で、評価者が課題と環境を自由に選ぶ分散型の評価(Atreya ら。7つの方策、600回超)[参考資料35] | ISO 18646-3:2021(サービスロボットの把持の大きさ・強さ・滑りへの耐性、扉の開閉の性能の試験方法。安全性の検証には使えない)[参考資料42]。ISO 18646-1:2016(車輪ロボットの移動)[参考資料40]、ISO 18646-2:2024(ナビゲーション)[参考資料41] | 成功率は試行回数と条件で幅が変わる(第6章)。ISO 18646 は屋内のサービスロボットの性能の試験方法で、学習方策の汎化の評価を定めるものではない(適用範囲の記載による)事実 |
| 脚ロボットの移動 | (ベンチマークではなく規格) | ISO/FDIS 18646-5(脚ロボットの移動の性能試験。最終国際規格案の段階)[参考資料43] | 策定中で、確定した内容ではない 未確定/将来 |
| 世界モデルの予測の質 | V-JEPA 2:動作理解(Something-Something v2 で top-1 77.3)、人の行動予測(Epic-Kitchens-100 で recall-at-5 39.7)、ロボットの計画(Franka アームでの把持・置き)の論文報告[参考資料6]。Genie 3・Sora:開発元の記述と実演[参考資料8・10] | 確認できなかった | 共通の標準指標は確認できなかった。映像としての自然さと、行動に応じた予測の正確さは別。開発元の実演は、選ばれた例である可能性がある(解説)事実 |
| 産業用ロボットの安全 | (ベンチマークではなく規格) | ISO 10218-1:2025(産業用ロボット本体の安全要求、第3版、2025年2月)[参考資料36]。ISO 10218-2:2025(産業用ロボットの応用とロボットセル)[参考資料37]。ISO/TS 15066:2016(協働ロボット。2022年に確認済み、改訂段階)[参考資料38] | ISO 10218-1:2025 の改訂点として、機能安全要求の明確化、サイバーセキュリティ、協働応用の安全要求(従来は ISO/TS 15066)が記されている(ISO ページの記載による)。学習で得た方策の評価方法を直接定めたものではない 事実 |
| 生活支援ロボットの安全 | (ベンチマークではなく規格) | ISO 13482:2014(生活支援ロボット:移動作業型、身体支援型、搭乗型。設計・保護方策・使用者向け情報を定め、危険の一覧を附属書に含む。第1版、2014年2月)[参考資料39] | 産業用の ISO 10218 を補う位置づけ。本文は有料のため、適用範囲の記載にとどめる 事実 |
| 動的に安定を保つ産業用移動ロボットの安全 | (ベンチマークではなく規格) | ISO/CD 25785-1(脚式・車輪式などで、能動的な制御で安定を保つ産業用移動ロボットの安全要求。委員会原案の段階)[参考資料44] | 策定中で、確定した内容ではない。脚ロボットの移動性能の規格 ISO 18646-5 を、安全要求の代わりに使ってはならない 未確定/将来 |
| AI を安全関連の機能に使うとき | (ベンチマークではなく技術報告) | ISO/IEC TR 5469:2024(AI の機能安全。AI を安全関連機能の内部で使う場合、非AIの安全機能でAI制御の機器を守る場合、AI で安全関連機能を設計する場合の性質・リスク要因・方法を記述。規範ではなく技術報告)[参考資料46]。ISO/IEC TS 22440 シリーズは策定中(委員会原案の段階) | 技術報告は要求事項ではなく、情報の提供。本文は有料のため、適用範囲の記載にとどめる 事実 |
| 用語・リスク管理の枠組み | (ベンチマークではなく枠組み) | ISO 8373:2021(ロボットの用語。改訂案 ISO/DIS 8373 あり)[参考資料45]。NIST AI RMF 1.0(NIST AI 100-1、2023年1月)[参考資料47] | NIST AI RMF は自主的な利用を意図した枠組み。ISO 8373 は用語の規格 事実 |
表の整理は本記事のもの(解説)です。ISO の本文は有料で確認していません。規格の段階は、検索結果に表示された ISO の公式ページの記載にもとづきます(確認日 2026年10月15日)。
読み方の注意(素材技術者向けに3点)
- 成功率は、設定と実施主体で変わります。ロボットの機種、課題、物の置き方、評価者が違えば、結果は変わります。開発元の報告は、独立した評価ではありません。シミュレーションの成績は、実機の成績の代わりにならず、実機の試行は回数で信頼区間を付けて読みます(第6章)
- ベンチマークの「飽和」と「汚染」:ロボットでは、訓練と評価に同じ課題・同じ環境を使うと、汎化ではなく慣れの測定になります(推測を含む一般論)。評価環境が訓練に含まれていないか、評価の対象物・場面が新しいかを確認します。ベンチマーク一般の飽和・汚染は、本シリーズ「ベンチマークと評価の読み方」編で扱います
- 規格は「要求」と「情報」と「策定中」を区別します。ISO 10218 は産業用ロボットの安全要求、ISO/IEC TR 5469 は情報を提供する技術報告、ISO 25785-1 や ISO/IEC TS 22440 は策定中です。「規格に適合している」ことは、学習で得た方策が安全であることを意味しません。法的な拘束力のある規制は、本シリーズ「EU AI法」編などで扱います
9. 用語集
- 身体性AI(embodied AI)
- ロボットなど体を持ち、現実の世界で知覚して行動するAI。
- 世界モデル
- 行動に応じて環境がどう変わるかを予測するモデル。使われ方が複数ある。
- VLA(vision-language-action)
- 画像と言語を入力し、ロボットの行動を出力するモデル。
- ロボット基盤モデル
- 多様なロボット・課題で事前訓練し、微調整して使う大規模なモデル。
- 模倣学習(行動クローニング)
- 人の実演を教師データにして、方策を学ぶ方法。
- 遠隔操作(テレオペレーション)
- 人がロボットを遠隔で操作し、その記録を学習データにする方法。
- 方策(ポリシー)
- 観測から行動を決める関数。ここではニューラルネットワーク。
- sim-to-real
- シミュレーションで訓練した方策を実機に移すこと。
- リアリティギャップ
- シミュレーションと現実のずれ。
- ドメインランダム化
- シミュレータの描画や物理量をランダムに変えて、ずれに強くする方法。
- JEPA
- 画素ではなく表現(特徴)を予測する、結合埋め込み予測アーキテクチャ。
- 潜在行動
- ラベルのない動画から学ぶ、行動に相当する内部の表現(Genie)。
- エンボディメント
- ロボットの機体(形、関節、センサー)の違い。
- 成功率
- 試行のうち課題を達成した割合。試行回数と条件を伴って読む。
- 信頼区間
- 標本から推定した値の統計的な幅。本稿は Wilson の方法の95%区間を使う。
10. 参考資料(一次情報)
- Ha D., Schmidhuber J. "World Models", arXiv:1803.10122 (2018) — arxiv.org/abs/1803.10122
- Hafner D. ほか "Dream to Control: Learning Behaviors by Latent Imagination", arXiv:1912.01603 (2019) — arxiv.org/abs/1912.01603
- Hafner D. ほか "Mastering diverse control tasks through world models", Nature 640, 647-653 (2025)。プレプリントは arXiv:2301.04104, DOI 10.1038/s41586-025-08744-2 — doi.org/10.1038/s41586-025-08744-2
- Assran M. ほか "Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture", arXiv:2301.08243 (2023) — arxiv.org/abs/2301.08243
- Bardes A. ほか "Revisiting Feature Prediction for Learning Visual Representations from Video", arXiv:2404.08471 (2024) — arxiv.org/abs/2404.08471
- Assran M. ほか "V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning", arXiv:2506.09985 (2025) — arxiv.org/abs/2506.09985
- Bruce J. ほか "Genie: Generative Interactive Environments", arXiv:2402.15391 (2024) — arxiv.org/abs/2402.15391
- Google DeepMind "Genie 3: A new frontier for world models"(2025年8月5日付のブログ)。確認日 2026年10月15日 — deepmind.google/discover/blog/genie-3-a-new-frontier-for-world-models
- NVIDIA ほか "Cosmos World Foundation Model Platform for Physical AI", arXiv:2501.03575 (2025) — arxiv.org/abs/2501.03575
- OpenAI "Video generation models as world simulators", 技術報告(2024年2月15日)。公式ページは自動取得が拒否されるため、インターネットアーカイブの保存版で全文を確認 — openai.com/index/video-generation-models-as-world-simulators
- Brohan A. ほか "RT-1: Robotics Transformer for Real-World Control at Scale", arXiv:2212.06817 (2022) — arxiv.org/abs/2212.06817
- Brohan A. ほか "RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control", arXiv:2307.15818 (2023) — arxiv.org/abs/2307.15818
- Open X-Embodiment Collaboration "Open X-Embodiment: Robotic Learning Datasets and RT-X Models", arXiv:2310.08864 (2023) — arxiv.org/abs/2310.08864
- Octo Model Team "Octo: An Open-Source Generalist Robot Policy", arXiv:2405.12213 (2024) — arxiv.org/abs/2405.12213
- Kim M. J. ほか "OpenVLA: An Open-Source Vision-Language-Action Model", arXiv:2406.09246 (2024) — arxiv.org/abs/2406.09246
- Black K. ほか(Physical Intelligence) "π0: A Vision-Language-Action Flow Model for General Robot Control", arXiv:2410.24164 (2024; v4 は 2026年1月) — arxiv.org/abs/2410.24164
- Physical Intelligence ほか "π0.5: a Vision-Language-Action Model with Open-World Generalization", arXiv:2504.16054 (2025) — arxiv.org/abs/2504.16054
- NVIDIA ほか "GR00T N1: An Open Foundation Model for Generalist Humanoid Robots", arXiv:2503.14734 (2025) — arxiv.org/abs/2503.14734
- Gemini Robotics Team "Gemini Robotics: Bringing AI into the Physical World", arXiv:2503.20020 (2025) — arxiv.org/abs/2503.20020
- Gemini Robotics Team "Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer", arXiv:2510.03342 (2025) — arxiv.org/abs/2510.03342
- Chi C. ほか "Diffusion Policy: Visuomotor Policy Learning via Action Diffusion", arXiv:2303.04137 (2023) — arxiv.org/abs/2303.04137
- Tobin J. ほか "Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World", arXiv:1703.06907 (2017) — arxiv.org/abs/1703.06907
- OpenAI ほか "Learning Dexterous In-Hand Manipulation", arXiv:1808.00177 (2018) — arxiv.org/abs/1808.00177
- OpenAI ほか "Solving Rubik's Cube with a Robot Hand", arXiv:1910.07113 (2019) — arxiv.org/abs/1910.07113
- Hwangbo J. ほか "Learning agile and dynamic motor skills for legged robots", Science Robotics 4, eaau5872 (2019), DOI 10.1126/scirobotics.aau5872 — doi.org/10.1126/scirobotics.aau5872
- Lee J. ほか "Learning quadrupedal locomotion over challenging terrain", Science Robotics 5, eabc5986 (2020), DOI 10.1126/scirobotics.abc5986 — doi.org/10.1126/scirobotics.abc5986
- NVIDIA ほか "Isaac Lab: A GPU-Accelerated Simulation Framework for Multi-Modal Robot Learning", arXiv:2511.04831 (2025) — arxiv.org/abs/2511.04831
- Zhao T. Z. ほか "Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware", arXiv:2304.13705 (2023) — arxiv.org/abs/2304.13705
- Fu Z. ほか "Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation", arXiv:2401.02117 (2024) — arxiv.org/abs/2401.02117
- Chi C. ほか "Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots", arXiv:2402.10329 (2024) — arxiv.org/abs/2402.10329
- Khazatsky A. ほか "DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset", arXiv:2403.12945 (2024) — arxiv.org/abs/2403.12945
- Liu B. ほか "LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning", arXiv:2306.03310 (2023) — arxiv.org/abs/2306.03310
- Mees O. ほか "CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks", arXiv:2112.03227 (2021) — arxiv.org/abs/2112.03227
- Li X. ほか "Evaluating Real-World Robot Manipulation Policies in Simulation", arXiv:2405.05941 (2024) — arxiv.org/abs/2405.05941
- Atreya P. ほか "RoboArena: Distributed Real-World Evaluation of Generalist Robot Policies", arXiv:2506.18123 (2025) — arxiv.org/abs/2506.18123
- ISO ISO 10218-1:2025 "Robotics — Safety requirements — Part 1: Industrial robots"(第3版、2025年2月) — iso.org/standard/73933.html
- ISO ISO 10218-2:2025 "Robotics — Safety requirements — Part 2: Industrial robot applications and robot cells" — iso.org/standard/73934.html
- ISO ISO/TS 15066:2016 "Robots and robotic devices — Collaborative robots"(2016年2月、2022年に確認済み、改訂段階) — iso.org/standard/62996.html
- ISO ISO 13482:2014 "Robots and robotic devices — Safety requirements for personal care robots"(第1版、2014年2月) — iso.org/standard/53820.html
- ISO ISO 18646-1:2016 "Robotics — Performance criteria and related test methods for service robots — Part 1: Locomotion for wheeled robots" — iso.org/standard/63127.html
- ISO ISO 18646-2:2024 "Robotics — Performance criteria and related test methods for service robots — Part 2: Navigation" — iso.org/standard/82643.html
- ISO ISO 18646-3:2021 "Robotics — Performance criteria and related test methods for service robots — Part 3: Manipulation" — iso.org/standard/73591.html
- ISO ISO/FDIS 18646-5 "Robotics — Performance criteria and related test methods for service robots — Part 5: Locomotion for legged robots"(最終国際規格案の段階。検索結果の記載で確認) — iso.org/standard/86850.html
- ISO ISO/CD 25785-1 "Robotics — Safety requirements for dynamically stable industrial mobile robots (legged, wheeled, or other forms of locomotion) — Part 1: Robots"(委員会原案の段階・策定中) — iso.org/standard/91469.html
- ISO ISO 8373:2021 "Robotics — Vocabulary"(第3版、2021年11月。改訂案 ISO/DIS 8373 あり) — iso.org/standard/75539.html
- ISO ISO/IEC TR 5469:2024 "Artificial intelligence — Functional safety and AI systems"(技術報告、第1版、2024年1月) — iso.org/standard/81283.html
- NIST NIST AI 100-1 "Artificial Intelligence Risk Management Framework (AI RMF 1.0)"(2023年1月) — doi.org/10.6028/NIST.AI.100-1
11. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| World Models(環境の生成モデル、夢の中で方策を訓練し実環境へ転移)、Dreamer(潜在空間の想像、20の視覚制御課題)、DreamerV3(150以上の課題、単一設定、Minecraft のダイヤモンド、Nature 640) | 出典1 https://arxiv.org/abs/1803.10122 出典2 https://arxiv.org/abs/1912.01603 出典3 https://doi.org/10.1038/s41586-025-08744-2 | 事実 |
| Sora 報告(2024年2月15日、「物理世界の汎用シミュレータ」は示唆、ガラスの破砕などの限界)、Genie(110億パラメータ、教師なし、潜在行動モデル)、Genie 3(2025年8月5日付、24フレーム/秒・720p、一貫性は数分、限界の記述)、Cosmos(世界基盤モデルのプラットフォーム、オープンウェイト) | 出典10 https://openai.com/index/video-generation-models-as-world-simulators/ 出典7 https://arxiv.org/abs/2402.15391 出典8 https://deepmind.google/discover/blog/genie-3-a-new-frontier-for-world-models/ 出典9 https://arxiv.org/abs/2501.03575 | 事実 |
| I-JEPA(ブロック間の表現予測)、V-JEPA(200万本の動画、特徴予測のみ)、V-JEPA 2(100万時間超の動画、62時間未満のロボット動画で V-JEPA 2-AC、Franka アームでのゼロショットの把持・置き、動作理解 77.3、行動予測 39.7) | 出典4 https://arxiv.org/abs/2301.08243 出典5 https://arxiv.org/abs/2404.08471 出典6 https://arxiv.org/abs/2506.09985 | 事実 |
| RT-1(データ量・モデル規模・多様性と汎化)、RT-2(行動をテキストトークンで表現、6,000回の評価試行)、Open X-Embodiment(21機関・22ロボット・527スキル・160,266タスク)、Octo(80万軌跡、消費者向け GPU で数時間の微調整)、OpenVLA(70億、97万デモ、29課題で RT-2-X に絶対成功率16.5%増、パラメータ7分の1)、Diffusion Policy(12課題で平均46.9%増)、π0(VLM の上のフローマッチング) | 出典11 https://arxiv.org/abs/2212.06817 出典12 https://arxiv.org/abs/2307.15818 出典13 https://arxiv.org/abs/2310.08864 出典14 https://arxiv.org/abs/2405.12213 出典15 https://arxiv.org/abs/2406.09246 出典21 https://arxiv.org/abs/2303.04137 出典16 https://arxiv.org/abs/2410.24164 | 事実 |
| π0.5(共同訓練、新しい家での長い器用な作業、「初めて」は開発元の記述)、GR00T N1(System 2 と System 1、実ロボット・人の動画・合成データ、Fourier GR-1)、Gemini Robotics(Gemini 2.0 土台、ER モデル、100回ほどのデモ)、Gemini Robotics 1.5(Motion Transfer、行動前の推論) | 出典17 https://arxiv.org/abs/2504.16054 出典18 https://arxiv.org/abs/2503.14734 出典19 https://arxiv.org/abs/2503.20020 出典20 https://arxiv.org/abs/2510.03342 | 事実 |
| 描画のランダム化(1.5 cm の物体検出)、物理量のランダム化(摩擦係数など、シミュレーションのみで訓練)、ADR とルービックキューブ、ANYmal の歩行と悪路踏破、Isaac Lab の構成、SIMPLER(実機との強い相関、特定のロボット設定) | 出典22 https://arxiv.org/abs/1703.06907 出典23 https://arxiv.org/abs/1808.00177 出典24 https://arxiv.org/abs/1910.07113 出典25 https://doi.org/10.1126/scirobotics.aau5872 出典26 https://doi.org/10.1126/scirobotics.abc5986 出典27 https://arxiv.org/abs/2511.04831 出典34 https://arxiv.org/abs/2405.05941 | 事実 |
| ALOHA/ACT(6課題で80〜90%、実演10分)、Mobile ALOHA(50回の実演、共同訓練で最大90%増)、UMI(手持ちグリッパー、機体非依存)、DROID(76,000軌跡・350時間・564場面・84課題・50人・12か月)、方策の誤りの累積と人のデモの非定常性 | 出典28 https://arxiv.org/abs/2304.13705 出典29 https://arxiv.org/abs/2401.02117 出典30 https://arxiv.org/abs/2402.10329 出典31 https://arxiv.org/abs/2403.12945 出典13 https://arxiv.org/abs/2310.08864 出典14 https://arxiv.org/abs/2405.12213 | 事実 |
| DROID の1軌跡の平均 約16.6秒(350時間÷76,000軌跡)、V-JEPA 2-AC が使った動画は350時間の約18%以下(62時間未満÷350時間) | 本稿の計算。論文の記載値(DROID:350時間・76,000軌跡、V-JEPA 2-AC:62時間未満)の単純な割り算。62時間が DROID のどの部分かは論文の記述以上には未確認 | 本稿の計算 |
| 成功率の95%信頼区間(Wilson の方法):10回中9回で約59.6〜98.2%、20回中18回で約69.9〜97.2%、50回中45回で約78.6〜95.7%、100回中90回で約82.6〜94.5%、1,000回中900回で約88.0〜91.7%。全成功時の下限(n=20で約83.9%、50で約92.9%、100で約96.3%、300で約98.7%)、3の法則、0.9の5乗=約59% | 本稿の計算。試行が独立で条件が同じという仮定。実機の試行では条件が変わり、独立とは限らない。実在のロボットの結果ではない | 本稿の計算 |
| LIBERO(4スイート計130課題、遠隔操作のデモ)、CALVIN(言語条件つきの長い手順の操作)、RoboArena(二重盲検の対比較、7つの方策、600回超、DROID プラットフォーム、7機関) | 出典32 https://arxiv.org/abs/2306.03310 出典33 https://arxiv.org/abs/2112.03227 出典35 https://arxiv.org/abs/2506.18123 出典12 https://arxiv.org/abs/2307.15818 | 事実 |
| ISO 10218-1:2025(第3版、2025年2月)と10218-2:2025、ISO/TS 15066:2016、ISO 13482:2014、ISO 18646-1:2016・-2:2024・-3:2021(-5 は最終国際規格案の段階)、ISO/CD 25785-1(策定中)、ISO/IEC TR 5469:2024(技術報告)、ISO 8373:2021、NIST AI 100-1(2023年1月)。番号・題名・版・段階は ISO 公式ページの記載(検索結果で確認)、本文は未確認 | 出典36 https://www.iso.org/standard/73933.html 出典37 https://www.iso.org/standard/73934.html 出典38 https://www.iso.org/standard/62996.html 出典39 https://www.iso.org/standard/53820.html 出典40 https://www.iso.org/standard/63127.html 出典41 https://www.iso.org/standard/82643.html 出典42 https://www.iso.org/standard/73591.html 出典43 https://www.iso.org/standard/86850.html 出典44 https://www.iso.org/standard/91469.html 出典46 https://www.iso.org/standard/81283.html 出典45 https://www.iso.org/standard/75539.html 出典47 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| 最新モデルの性能と独立した再現、世界モデルの物理的な正確さの標準指標、学習で得た方策の安全性を直接定めた規格、ISO 規格の本文、LeCun 氏の2022年の立場表明論文の本文、Genie 3 の提供状況、変形材料の再現精度を測った一次資料 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「世界モデルという名前からできることを断定しない」「ギャップの正体の多くは物性値と接触」「遠隔操作のデータは作業者の技能そのもの」「成功率は歩留まりと同じ統計で読む」「ランダム化の範囲は測定した範囲で与える(推測)」という読み取りと、表の整理(第2・3・5・8章) | 公表内容にもとづく本記事の整理・解説。各社・各機関が表明した見解ではない | 解説 |
| 図2〜図4・図6が説明のための作図(実測データではない)であること。図1と図5がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(arXiv の論文、Nature・Science Robotics の論文、開発元の技術報告とブログ、ISO の規格ページ、NIST の公式文書)に限定しています。ISO の規格本文は有料のため確認できていません。 読み取りや整理を含むため、それらは「解説」として出典付きの事実と区別しています。 最新モデルの性能、独立した再現、世界モデルの標準指標、学習で得た方策の安全性を直接定めた規格、規格の本文については、確認できなかったため記載していません。 成功率などの評価値は、各報告の設定のもので、モデルの優劣を示すものではありません。 図2〜図4・図6はベクター作図、図1と図5はImageGen生成の概念画像です(いずれも実際の測定結果やロボットの実物を示すものではありません)。