TECHNOLOGY EXPLAINER
ロボットの視覚と認識
― カメラと距離センサーで「何がどこにあるか」を知り、「つかめる」ところまで落とし込む仕組み
ロボットが物をつかむには、まず「目」で状況を知る必要があります。ところが、カメラの画像は色の数字の並びにすぎず、そこから何が・どこに・どの向きであるかを取り出し、さらにどうつかむかまで決めるには、いくつもの段階を重ねます。 この記事では、素材技術者にもなじみやすいたとえで、カメラと深度センサーのしくみ、点群、物体の検出とセグメンテーション、6D姿勢、把持(つかみ方)の認識を順に説明します。後半では、「検出できた」が「つかめた」ではない理由、透明・光沢・暗い表面が苦手な理由、評価指標(IoU、AP)と規格の読み方を、一次情報と本稿の小さな計算で確かめます。
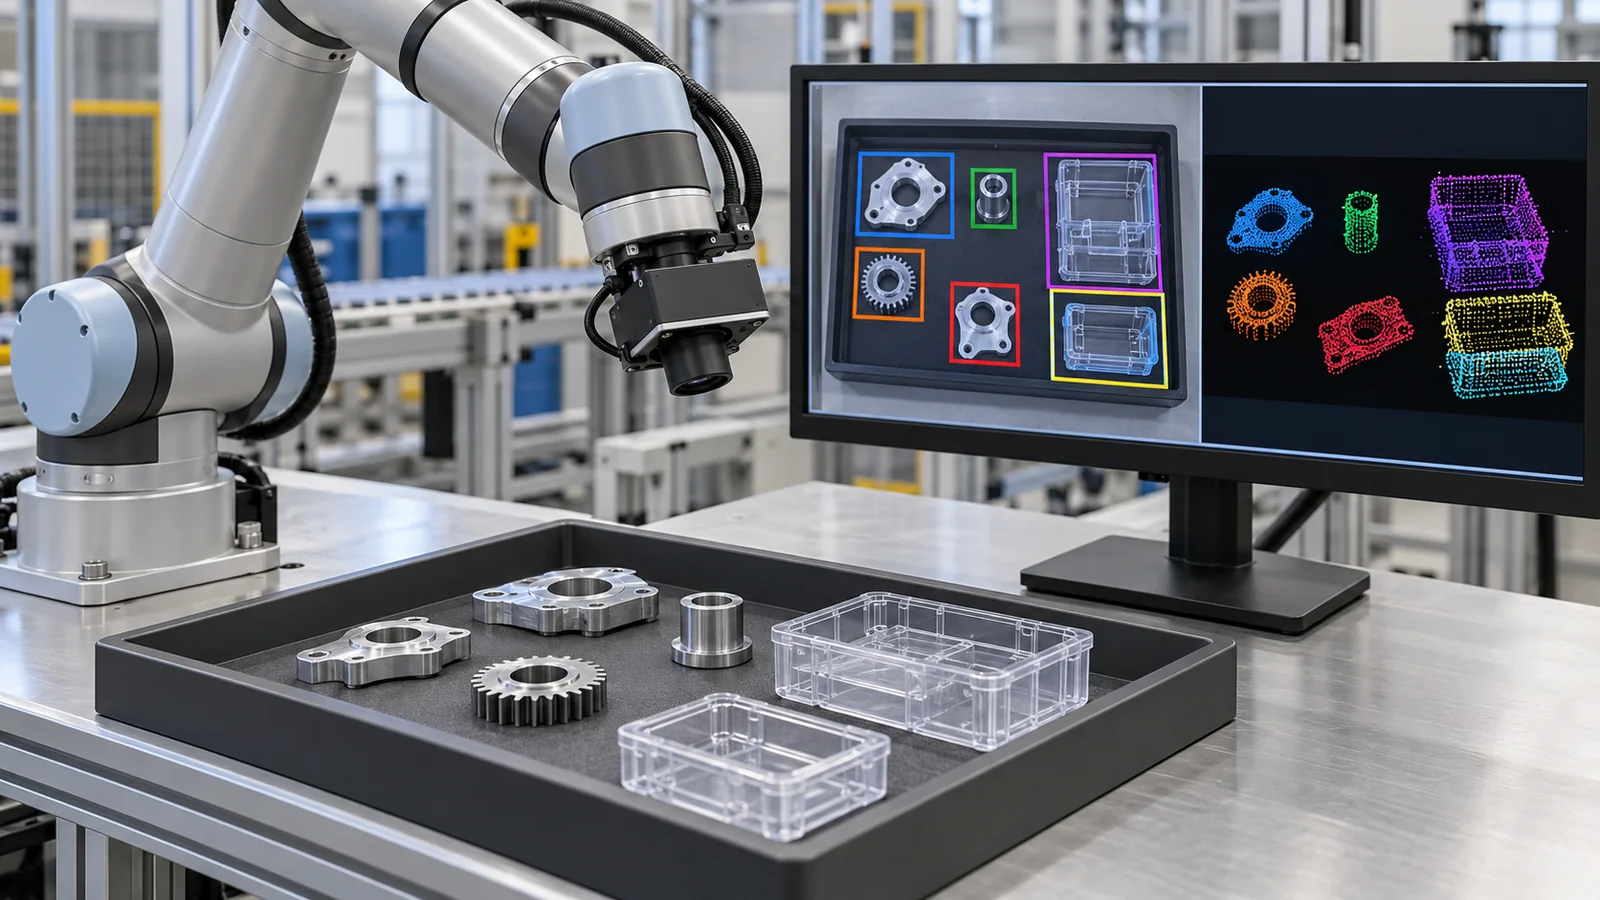
- ロボットの視覚とは何か(3行でつかむ)
- 「見る」から「つかむ」まで ― 全体の流れ
- 目の部品 ― カメラと深度センサー
- 距離の誤差は、距離の2乗で増える ― 本稿の計算
- 点群 ― 距離の画像を「空間の点」に変える
- 何が写っているか ― 物体検出とセグメンテーション
- どこに、どの向きか ― 6D姿勢
- どうつかむか ― 把持のための認識
- 素材技術者の視点②:表面・照明・汚れが、認識の成否を決める
- 認識の失敗の型と、確かめかた
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・草案・策定中などで、確定していない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
第4章・第5章・第6章・第8章の数値例は、本稿が置いた想定値(焦点距離、カメラの間隔、各段階の成功率など)による計算です。実在のカメラやロボットの性能を示すものではありません。論文の成績(成功率、処理速度など)は、各論文が選んだ物体・環境・ロボットでの報告値で、異なる論文の数字を並べて優劣はつけません。 規格(ISO、IEC)は題名・適用範囲の確認にとどめ、本文は確認していません。特定の製品・企業の優劣は論じません。
1. ロボットの視覚とは何か(3行でつかむ)
- 「見る」は、答えを順に出す段階の連なり:カメラと深度センサーで画像と距離を得る → 3次元の点の集まり(点群)にする → 物体を見つける → 位置と向きを決める → つかみ方を選ぶ、の順です。それぞれの段階が「何が写っている?」「どこに、どの向きで?」「どうつかむ?」という別の問いに答えます
- 距離センサーは万能ではない:2台のカメラで距離を測る方式(ステレオ)の誤差は、距離の2乗で増えます事実[参考資料1]。透明な物体は、標準的な3Dセンサーでは奥の面のような値になりやすいことが知られています事実[参考資料18]
- 「検出できた」は「つかめた」ではない:段階ごとの成功率は掛け算で全体に効きます(98%・95%・90%なら約84%)本稿の計算。評価は、枠の当たりを測る指標(IoU、AP)と、実機でのつかみの成功率を分けて読みます
シリーズ共通のたとえでは、ロボットは「感じる(センサー)・考える(制御と知能)・動く(アクチュエータ)」の3つの組合せです。この記事は、このうち「感じる」と、それを受けて「考える」の入口を扱います。 もう一つだけ前提があります。デジタル画像は画素(ピクセル)の格子で、普通のカラー画像では、各画素に赤・緑・青の明るさを表す3つの数字が入っています。人は画像を見て一瞬で「コップだ」と分かりますが、ロボットにとっては、まず数字の並びから出発します。
本シリーズ「LiDAR」編は光の往復時間による距離測定を、「自動運転とAI」編は走行中の認識を、「世界モデルと身体性AI」編は認識から行動までをつなぐAIを扱っています。この記事は、作業台の上で物をつかむ(マニピュレーション)ための認識に絞ります。つかむ手そのものは「ロボットハンドと把持」編、触って確かめる感覚は「触覚センサーと電子皮膚」編、自分の位置の推定は「SLAMと自己位置推定」編、認識結果を行動に直結させる学習は「模倣学習と強化学習」編と「ロボット基盤モデルとVLA」編で扱います。
認識は「1回の判定」ではなく「段階の連なり」で、小さな誤りは後ろの段階に持ち越されます。 だから、検出の成績だけを見て「つかめる」と考えず、段階ごとの成功率と、最後の「つかめた」までの成功率を、別々に確かめます。
2. 「見る」から「つかむ」まで ― 全体の流れ
机の上のコップをつかむ場面を考えます。人は、コップを見た瞬間に、「コップだ」「手の届くところにある」「取っ手がこちら向きだ」「ここを持てばよい」まで、無意識にやっています。ロボットでは、これを段階に分けて、1つずつ計算します。
| 段階 | 答える問い | 出力 | 代表的な手法の例 | 誤りが起きやすい点(解説) |
|---|---|---|---|---|
| ① センサー | 光をどう記録するか | 色の画像、距離の画像 | カメラ、ステレオ、投影方式、飛行時間方式 | 表面の性質、明るさ、距離で品質が変わる(第3・4・9章) |
| ② 点群 | 空間のどこに点があるか | 3次元の点の集まり | 距離の画像から計算(第5章) | 欠けた点、ばらつき、点の数が多く重い |
| ③ 検出・セグメンテーション | 何が写っているか | 枠またはマスクと名前 | YOLO、Mask R-CNN、DETR、SAM | 見たことのない物体、重なり、照明の違い(第6章) |
| ④ 6D姿勢 | どこに、どの向きか | 位置3つ+回転3つ | PoseCNN、FoundationPose など | 対称な物体、隠れ、反射(第7章) |
| ⑤ 把持の認識 | どう持てばよいか | 手の位置・向き・開き幅の候補 | Dex-Net、Contact-GraspNet など | 手の形や摩擦との相性、見えていない裏側(第8章) |
表の手法名は論文で確認できた代表例で、優劣や普及度を示すものではありません。「誤りが起きやすい点」は本記事による整理(解説)です。
段階を分ける利点は、どこが悪いのかを切り分けやすいことです。一方で、後ろの段階は前の段階の出力を信じて動くので、前の段階の誤りがそのまま引き継がれます。この記事の後半で、この「持ち越し」を数字で見ます。
3. 目の部品 ― カメラと深度センサー
(1) 普通のカメラは「色」は分かるが「距離」は直接分からない
普通のカラーカメラ(RGBカメラ)の画像は、色と模様の情報です。2つの物体が同じ大きさに見えても、小さくて近いのか、大きくて遠いのかは、画像1枚からは決まりません。そこで、ロボットでは、距離を測るセンサーを組み合わせます。色と距離を一緒に得るセンサーをRGB-Dセンサー(Dは深度=distance)と呼びます。
(2) 距離を知る4つの方法
代表的な方法を、しくみと得意・苦手で整理します。
| 方法 | しくみ(やさしく) | 得意 | 苦手(解説) |
|---|---|---|---|
| ステレオ視 | 2台のカメラの画像で、同じ点がどれだけずれて写るか(視差)を見て、三角形の関係から距離を求める[参考資料1]。人の両目と同じ考え方 | 屋外の明るい場所でも使える方式がある。色の画像と同じカメラで作れる | 模様の少ない面(白い壁など)では、2枚の画像の対応づけが難しい。遠くでは誤差が大きい(第4章) |
| 投影方式(模様を投げる) | 赤外線の模様を物体に投げ、その見え方のゆがみや、模様を手がかりにした対応づけで距離を求める。Keselman らが解説した RealSense R200 は、赤外の模様を投影してステレオの対応づけを助ける方式の一例[参考資料1] | 模様のない面でも距離が出やすい。暗い場所でも使える | 投影した模様の光は遠くで弱まるため、遠い距離では信号の強さが下がる(Keselman らの脚注[参考資料1])。表面の性質で模様の返りが変わる(第9章) |
| 飛行時間(ToF)・LiDAR | 光を出して、戻ってくるまでの時間から距離を求める。原理は本シリーズ「LiDAR」編で詳しく扱っている | 遠くまで測れる方式がある | 透明・鏡面・強い光沢の面で、戻る光が乱れる |
| 1枚の画像からAIで推定 | 学習済みのネットワークが、1枚のカラー画像から奥行きを推定する。Depth Anything V2 は、ラベル付きの実画像をすべて合成画像に置き換えて学習した単眼深度推定モデルと報告されている[参考資料19] | カメラ1台でよい | 得られるのは推定値で、センサーが測った値とは性質が違う。どの程度の精度でメートルの値になるかは、学習と設定による(本稿では確認していない) |
しくみの説明は本記事による一般的な整理(解説)。R200 の構成と Depth Anything V2 の学習方法は各論文の要旨にもとづきます。方式ごとの優劣は論じません。
(3) ステレオ視のしくみを、図で確かめる
自分の人差し指を目の前に立て、右目だけ・左目だけで交互に見ると、指が背景に対して左右にずれて見えます。指が近いほど、ずれは大きくなります。ステレオ視は、このずれを数えて距離にする方法です。
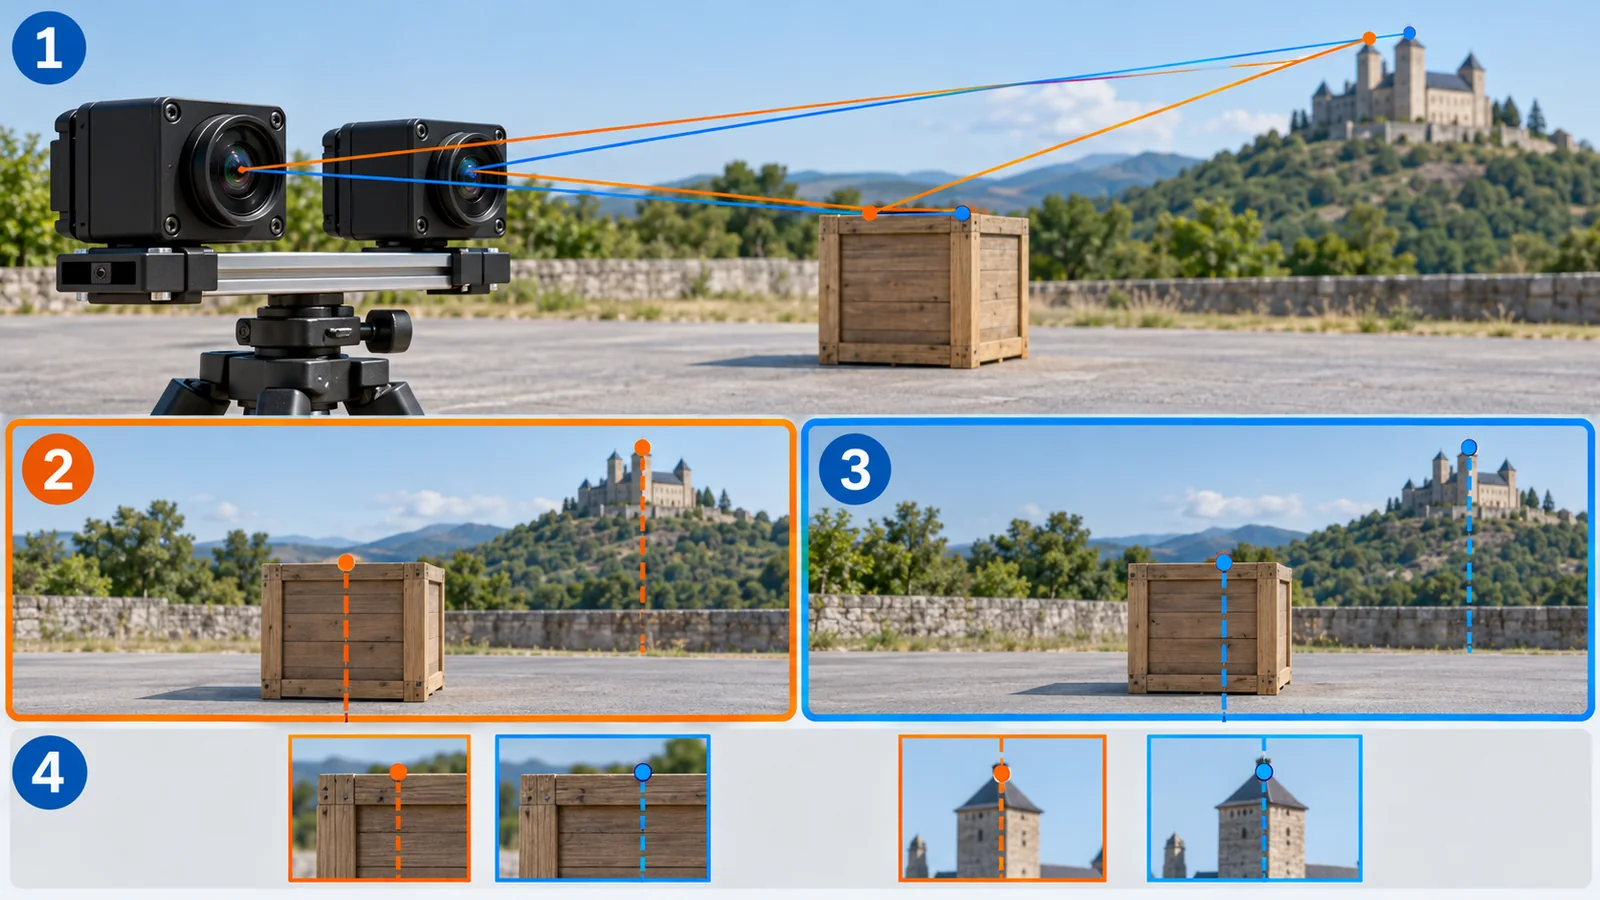
元のSVG・補足説明・出典を確認
元SVGの説明:概念図(ベクター作図)。2台のカメラで同じ点を見ると、近い点ほど左右の画像でのずれ(視差)が大きく、遠い点ほど小さくなります。式 Z=f×B÷d は Keselman らの解説と同じ形です[参考資料1]。図の長さは説明用で、実在のカメラの寸法ではありません。
式で書くと、距離 Z は「焦点距離 f × カメラの間隔 B ÷ 視差 d」です(Z=f×B÷d)。視差が大きい(ずれが大きい)ほど近い、という関係です[参考資料1]。ここで焦点距離 f と視差 d は画素の数で、間隔 B と距離 Z はメートルで表します。
ものさしで長さを測るのとは違い、ステレオ方式の距離は「左右の画像で同じ点を探し、ずれを数えて計算した」結果です。探す作業(対応づけ)がうまくいかない場所では、計算した距離も当てになりません。画像が欠けたり、まわりと違う値が出たりするのは、この「探す作業」の失敗が主な原因の一つです(本記事による解説)。
4. 距離の誤差は、距離の2乗で増える ― 本稿の計算
ステレオ方式で、距離の誤差がどう増えるかを数字で確かめます。まず感覚から。遠くの景色では、左右の目で見た「ずれ」はほとんどなくなります。ずれが小さいと、少しの読み違いが距離の大きな違いになります。
Keselman らは、距離 Z を視差 d から求める式を微分して、深度の誤差が Z² ÷ (f×B) × 視差の誤差で増えることを示しています[参考資料1]。視差の誤差は、カメラの画質と対応づけの方法で決まる値で、ほぼ一定とみなせる、と書かれています(同論文では測定から約0.1画素)。 つまり、距離が2倍になると誤差は4倍、カメラの間隔 B を2倍にすると誤差は半分です。
次の表は、焦点距離 f=600画素、視差の誤差=0.1画素と想定して計算したものです(本稿の計算)。
| 距離 Z | 誤差(間隔 B=70 mm) | 誤差(間隔 B=140 mm) | 1画素が覆う長さ(Z÷f) |
|---|---|---|---|
| 0.5 m | 約0.6 mm | 約0.3 mm | 約0.83 mm |
| 1 m | 約2.4 mm | 約1.2 mm | 約1.7 mm |
| 2 m | 約9.5 mm | 約4.8 mm | 約3.3 mm |
| 3 m | 約21 mm | 約11 mm | 約5.0 mm |
| 5 m | 約60 mm | 約30 mm | 約8.3 mm |
本稿の計算。想定値 f=600画素、視差の誤差=0.1画素、誤差=Z²÷(f×B)×0.1。実在のカメラの仕様ではありません。1画素が覆う長さは、距離を焦点距離で割った値(画素の幅が距離に比例して広がる)です。
同論文は、実機1台(R200、480×360画素、30 Hz)の測定値として、1 mで2.1 mm、2 mで8.0 mmを報告しています[参考資料1]。想定値の曲線(1 mで2.4 mm、2 mで9.5 mm)と同じ桁で、2 m の値が 1 m の約4倍になっている点も一致します。ただし、これは1台の例で、他の機器の値ではありません事実。
この計算から分かること
- 作業は近くで見るほど有利:手首にカメラを付けて、物に近づいて見る構成が多いのは、この誤差の増え方と整合します(本記事による解説)
- 小さなものは、遠くから見ると「1画素より小さい」:表のとおり、3 m先では1画素が約5 mmを覆うので、直径3 mmのねじは1画素に満たない大きさになります本稿の計算
- 間隔を広げれば誤差は減るが、トレードオフがある:カメラが大きくなり、近くのものが両方のカメラに入りにくくなります(本記事による解説)
Keselman らが解説した R200 は、左右のカメラの前に約840 nm 以下の光を遮るフィルターを付け、赤外の投影模様に感度を絞っています[参考資料1]。つまり、このカメラは、私たちの目に見える色ではなく、近赤外での物の見え方で距離を測っています。
ここに、材料の話が入ってきます。(1) 物体の表面が近赤外の光をどう返すか(散らす、鏡のように返す、通す、吸う)で、距離の取りやすさが変わります(第9章)。(2) カメラの窓やレンズ、フィルターの表面の汚れ・曇り・傷は、画像のコントラストや投影模様の見え方を変えうるので、工場や研究室では清掃や交換の手順が精度の一部になります(これは本記事による一般的な見立てで、特定の機器で測った値ではありません)。(3) フィルターをどんな膜やガラスで作るかは、本稿では一次情報を確認していません。
5. 点群 ― 距離の画像を「空間の点」に変える
深度画像は、各画素に「距離」が入った画像です。これを、ロボットが扱いやすい3次元の点の集まり(点群)にします。やり方は、カメラのレンズの性質(針穴カメラのモデル)を使った単純な計算です。
画素の位置 (u, v) と距離 Z が分かれば、カメラから見た3次元の位置 (X, Y, Z) は、X=(u−cx)×Z÷f、Y=(v−cy)×Z÷f で求まります。ここで (cx, cy) は画像の中心の画素、f は焦点距離(画素の単位)です。例として、f=600画素、中心 (320, 240) のカメラで、画素 (420, 300) の距離が 0.8 m のとき、X=(420−320)×0.8÷600=約0.133 m、Y=(300−240)×0.8÷600=0.08 m です本稿の計算。
点群は、(x, y, z) の3つの数字を並べた名簿のようなものです。点の並べ方に決まった順序はなく、名簿の順番を入れ替えても、表している形は同じです。画像のように「隣の画素」という決まった関係がないので、画像向けの手法をそのまま使えません。Qi らの PointNet は、この順序のない点の集まりを直接入力にするネットワークとして提案されました[参考資料2]事実。
データの重さ
640×480画素の深度画像から作る点群は 307,200 点です。各点を単精度の3つの数(4バイト×3)で持つと約3.7 MB、毎秒30枚なら約111 MB/秒になります本稿の計算。点群は便利ですが、そのまま処理すると重いので、点を間引く、物体の領域だけ切り出す、といった前処理が使われます(本記事による解説)。
点群を重ねる:ICP
物体の3次元モデル(CADなど)と、カメラで得た点群を重ねて、物体の位置と向きを決める古典的な方法が、ICP(反復最近接点)です。Besl と McKay が1992年に報告した、3次元形状の位置合わせの方法で、近い点どうしを対応づけながら少しずつ重ねる、という考え方です。論文で確認したのは題名と書誌で、仕組みの説明は本記事による一般的な解説です[参考資料3]事実。ただし、最初の位置が大きくずれていると、うまく重ならないことがあります(本記事による解説)。
6. 何が写っているか ― 物体検出とセグメンテーション
(1) 「枠」と「マスク」の違い
物体検出は、画像の中の物体を、四角い枠と名前で示します。セグメンテーションは、さらに細かく、各画素が「どの物体に属するか」を塗り分けます。同じ種類の物体を1個ずつ分けるものをインスタンス分割と呼びます。ロボットでつかむときは、枠よりマスクのほうが、物体の輪郭に合った点群を切り出せるので便利です(本記事による解説)。
(2) 代表的な手法(論文の記述)
- YOLO:検出を、1つのネットワークで「枠の位置と種類の確率」を一度に出す回帰の問題として扱い、基本モデルが毎秒45フレームで動くと報告しています[参考資料4]事実
- Mask R-CNN:枠を出す仕組みに、マスクを出す枝を追加した方式で、毎秒約5フレームで動くと報告しています[参考資料5]事実
- DETR:検出を「物体の集合を直接出す」問題として扱い、手作りの部品(重複を除く処理など)を省ける、と述べています[参考資料6]事実
- Segment Anything(SAM):点や枠などの指示(プロンプト)で領域を切り出すモデルで、11M(1,100万)枚の画像に10億個超のマスクを付けたデータセットで学習した、と報告しています[参考資料7]。SAM 2 は画像と動画の両方を対象にしています[参考資料8]事実
- Grounding DINO:言葉で指定した物体(カテゴリ名や、説明の文)を探す「開語彙」の検出器です[参考資料9]事実
各論文の処理速度は、論文が使った計算機と画像の大きさでの値で、同じ条件の比較ではありません。ここから「どれが速い」「どれが優れている」とは言えません(本記事による解説)。
Grounding DINO や SAM のような大きな学習済みモデルは、学習時に決めた種類の外の物体も扱えるように作られています。しかし、作業現場の特殊な部品(光沢のある金属片、半透明の樹脂部品など)で十分に当たるかは別問題です。自分の部品の画像で試し、当たらない条件を確かめるのが安全です(本記事による解説)。論文の成績は、論文が選んだデータでの値です。
(3) 「当たった」の基準:IoU と AP
検出が正しいかどうかは、予測した枠と正解の枠の重なり具合で判定します。この重なり具合が IoU(重なった面積÷合わせた面積)です。次の図は、小さく枠がずれた例で、IoU が 0.59 になる計算を示します。
COCO の評価ページによると、主な指標 AP は、IoU の基準を 0.50 から 0.95 まで 0.05 刻みの10段階にして平均し、さらに80カテゴリで平均した値です。IoU=0.50 だけで測る AP(PASCAL VOC の指標)や、0.75 で測る厳しい AP も別に出します。物体の大きさを小(面積 32²画素未満)・中・大(96²画素超)に分けた AP もあり、1枚の画像につき最大100件の検出で計算します[参考資料11]事実。COCO データセットは、約32.8万枚の画像に250万件のラベル付き対象を含みます[参考資料10]事実。
AP は「枠がどれだけ重なったか」の平均です。つかむには、数ミリ〜数センチの位置の正確さと向きが必要で、枠の重なりではそこまで分かりません。次の第7章・第8章は、この「その先」を扱います(本記事による解説)。
7. どこに、どの向きか ― 6D姿勢
物体の位置は3つの数字(x, y, z)、向きは3つの回転(前後に傾ける、左右に傾ける、軸のまわりに回す)で表せます。合わせて6つの自由度なので「6D姿勢」と呼びます。自由度(DOF)は、シリーズ共通のとおり「動かせる方向の数」ですが、ここでは「物体が取りうる位置と向きの数」の意味で使っています。
- PoseCNN:物体の中心を画像で探し、カメラからの距離を予測して3次元の位置を出し、回転は四元数で回帰する方式です。対称な物体を扱う損失も導入し、YCB-Video データセット(21物体、92本の動画、133,827フレーム)を公開しました[参考資料12]事実
- BOP:1枚のRGB-D画像から、剛体の6D姿勢を推定する手法を比べるためのベンチマークです。8つのデータセットと共通の評価方法を用意し、論文の時点で15手法を評価しています[参考資料14]事実
- FoundationPose:CADモデル、または少数の参照画像があれば、微調整なしで新しい物体の6D姿勢の推定と追跡に使える、と報告された基盤モデルです[参考資料15]事実
丸い棒や円盤は、軸のまわりに回しても見た目が変わりません。この場合、「向きが何度か」は見た目からは決まらず、正解が複数あることになります。PoseCNN が対称な物体を扱う損失を導入したのは、このためです[参考資料12]。ロボットでつかむ場面では、対称な部品をどの向きで置くかが問題になることがあります(本記事による解説)。
8. どうつかむか ― 把持のための認識
物の位置と向きが分かっても、どこをどう挟めばよいかは別の問題です。ハンドの形(2本指か、吸着か)、物の重さ、表面の滑りやすさに依存します。このため、「つかみ方」を直接予測する研究が進みました。
- Dex-Net 2.0:3Dモデルから作った670万の合成の点群とつかみ方で、つかみの成功確率を予測するネットワークを学習しました。実機(ABB YuMi)で1,000回超の試行を行い、形の難しい既知の8物体で成功率93%、つかみの計画に0.8秒だった、と報告しています[参考資料16]事実
- Contact-GraspNet:深度の記録から、平行ジョー(2枚の板で挟む)ハンドのつかみ方を直接出す方式です。1,700万の模擬のつかみで学習し、整理された山積みの未知の物体で成功率90%超、従来の最新手法に比べて失敗率を半分にした、と報告しています[参考資料17]事実
- ClearGrasp:透明な物体の3次元形状を、1枚のRGB-D画像から推定する手法です。透明物体は標準的な3Dセンサーでは、奥の面のような雑音混じりの値になるため、法線やマスクなどを推定して深度を補正します。5万枚超の合成画像と、実画像286枚のテストを用意しました[参考資料18]事実
上の成功率は、いずれも論文が選んだ物体・置き方・ハンド・試行回数での値です。Dex-Net の「既知の8物体」と Contact-GraspNet の「未知の物体の整理された山積み」は条件が違うため、数字を並べて優劣を言うことはできません(本記事による解説)。試行回数が少ない成功率の読み方は、本シリーズ「世界モデルと身体性AI」編の第6章に、信頼区間の計算があります。
段階ごとの成功率は、掛け算で効く
「検出98%、姿勢95%、把持90%」という、説明用の想定を置きます。各段階が独立なら、全体の成功率は 0.98×0.95×0.90=約84%です。どの段階を改善すると、全体が一番上がるでしょうか。
- 検出を 98% から 99.5% に上げると、全体は約85.1%(+1.3ポイント)です
- 把持を 90% から 95% に上げると、全体は約88.4%(+4.6ポイント)です
本稿の計算。各段階の成功率は説明用の想定で、各段階が独立という仮定を置いています。実在のシステムの成績ではありません。
結論は単純です。いちばん弱い段階を改善するのが効くこと、そして検出の指標(AP)だけを追っても、最後の成功率は分からないことです。実際には、前の段階の誤りが次の段階の失敗率を変えるので、独立という仮定は理想化です(本記事による解説)。
正しくは:画像認識の成績(AP など)は、枠やマスクがどれだけ重なったかの指標で、つかむための数ミリの位置や向き、ハンドとの相性までは保証しません。透明・光沢・暗い表面では、距離そのものが取れないことがあります(第9章)。つかむロボットの成績は、実機で、自分の物体と置き方で確かめます。
9. 素材技術者の視点②:表面・照明・汚れが、認識の成否を決める
ここまでの手法は、いずれも「光が物体に当たって戻ってくる」ことを前提にしています。したがって、物体の表面の性質と照明が、認識の成否を大きく左右します。材料の知識がもっとも役に立つ章です。
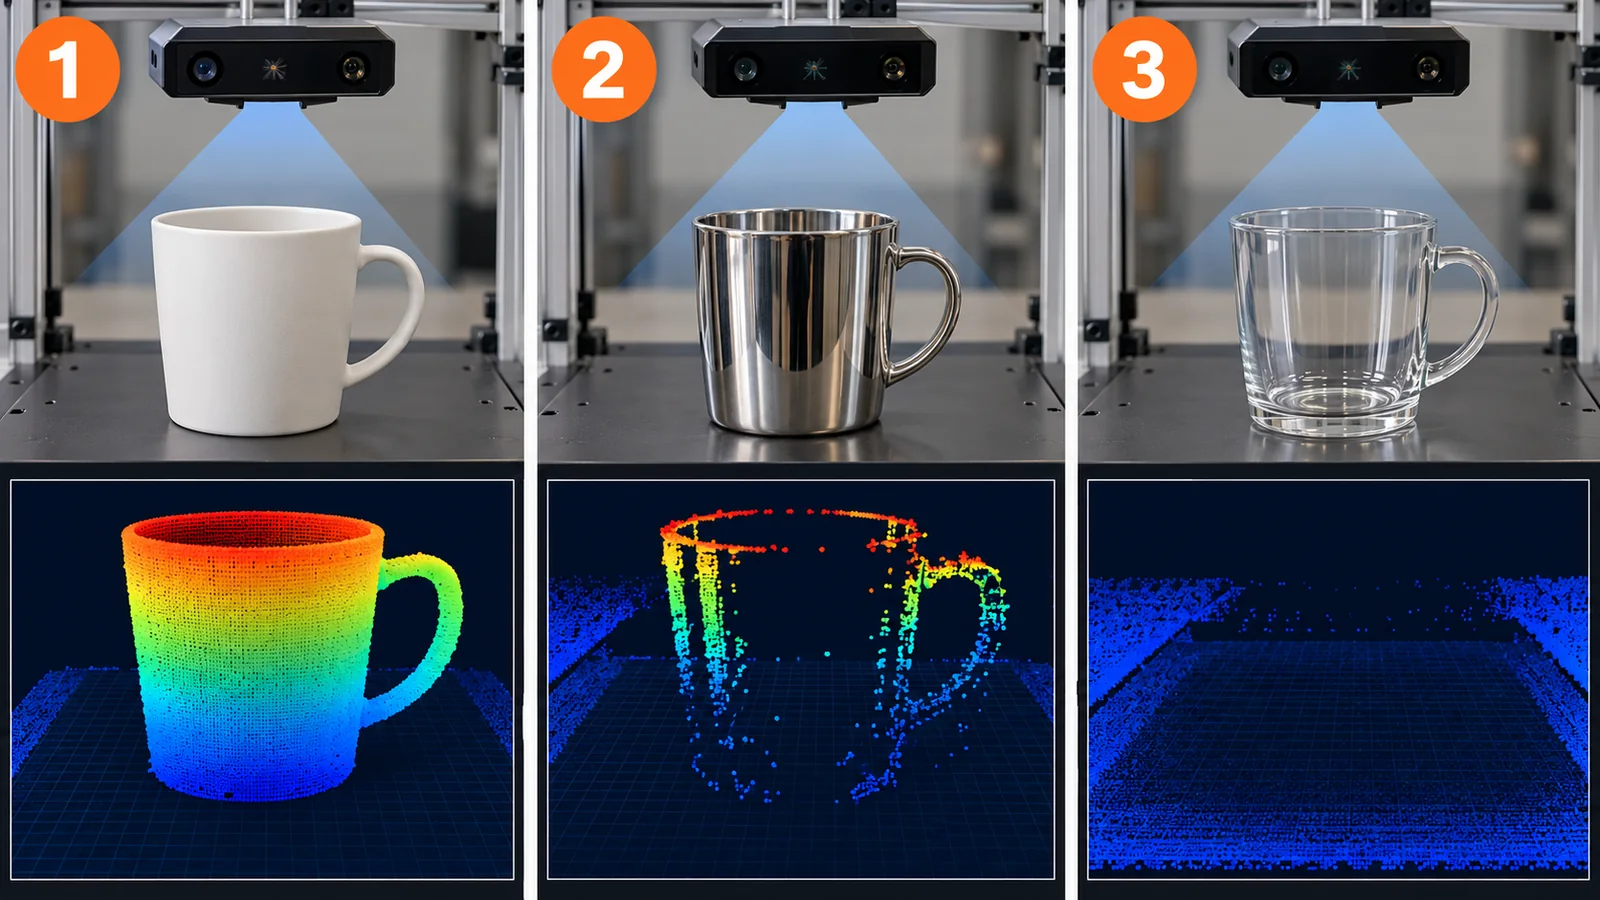
元のSVG・補足説明・出典を確認
元SVGの説明:概念図(ベクター作図)。同じ形でも、表面の光の返し方で深度の取れやすさが変わります。透明物体の深度が「奥の面のような、ゆがんだ値」になることは ClearGrasp の論文[参考資料18]に、赤外の投影光を使う方式の例は Keselman らの解説[参考資料1]にあります。
表面ごとの見えかた
- つや消しの面:光があちこちに散るので、どの角度から見ても似た明るさで、距離が安定しやすい傾向があります(本記事による解説)
- 光沢のある面(研磨した金属、ガラスのような表面):光が一方向に強く返るため、ある角度でまぶしく光り、別の角度では暗くなります。距離の画像に穴や飛びが出る場合があります(本記事による解説)
- 透明な面(ガラス、透明樹脂):光が通り抜けるため、標準的な3Dセンサーでは、奥の面に近い雑音混じりの値になります[参考資料18]事実
- 真っ黒に近い面(黒いゴム、炭素を含む材料など):光を吸収して戻りが弱くなり、距離が取りにくくなる場合があります(本記事による一般的な見立てで、本稿では一次情報を確認していません)
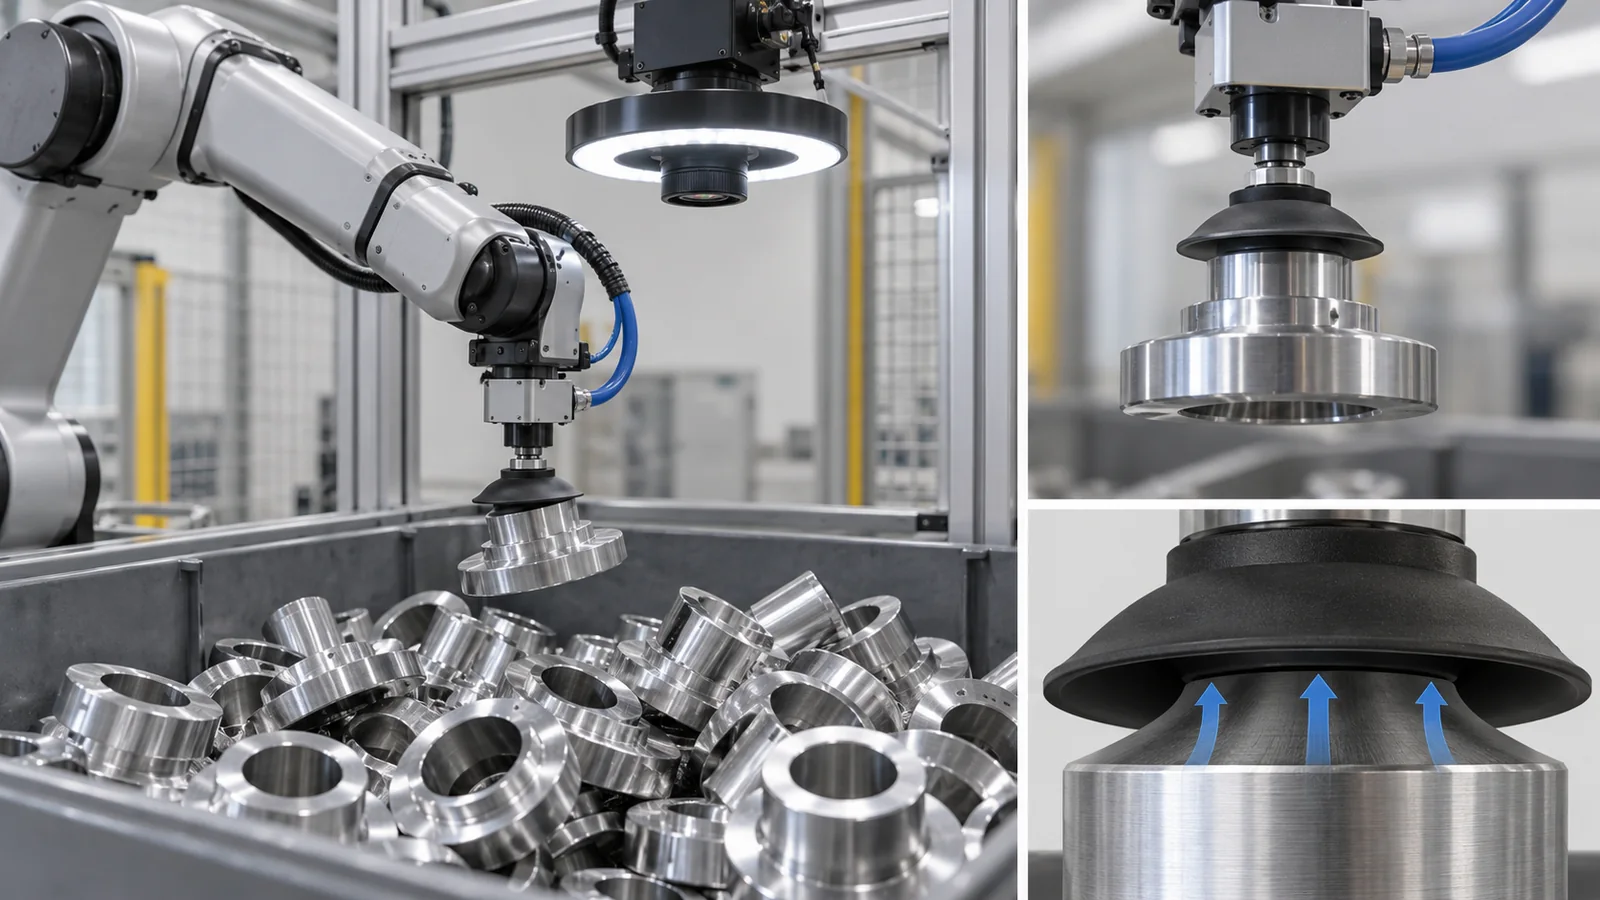
同じ形の部品でも、(1) 切削したままの金属、(2) めっきや研磨で光沢を出したもの、(3) 黒色の塗装や陽極酸化をしたもの、では、カメラと深度センサーへの「見えかた」が変わります。認識が難しい部品は、表面処理や色の選び方を変えるだけで、認識が容易になる可能性があります。逆に、見た目や機能のために選んだ表面が、認識を難しくしていることもあります(これは本記事の一般的な見立てで、特定の部品での測定ではありません)。
照明も材料の問題です。偏光フィルターで光沢の反射を弱める、拡散照明で影やまぶしさを減らす、といった工夫は、表面の光の返し方を前提に選びます。カメラや照明の取り付け位置、窓の汚れ、粉じん・油の付着といった現場の条件は、導入前の試験で確かめる項目です(解説)。
カメラと深度センサーの誤りは、数ミリ〜数センチになりえます。ロボットハンドが、つかんだ瞬間の触覚や力で位置を直せれば、視覚の誤りを後から補えます。視覚と触覚の役割分担は、本シリーズ「ロボットハンドと把持」編と「触覚センサーと電子皮膚」編で扱います(本記事による解説)。
10. 認識の失敗の型と、確かめかた
現場で起きやすい失敗を、原因別に整理します。自分の工程で試すときのチェックリストとして使えます(本記事による整理で、統計ではありません)。
| 失敗の型 | どう見えるか | 原因の例 | 確かめかた |
|---|---|---|---|
| 距離が取れない | 点群に穴がある、距離の画像が黒く抜ける | 透明・光沢・暗い表面、模様のない面 | 実際の部品で距離画像を見る。表面処理・照明を変える |
| 距離がずれる | 物体が浮いて見える、傾いて見える | 遠すぎ、校正のずれ | 近づけて測る。既知の寸法の治具で測り直す |
| 検出できない・誤検出 | 枠が付かない、背景を物体と判定 | 見たことのない見た目、照明の違い、重なり | 照明・背景・向きを変えた画像でテストする |
| 位置と向きが違う | 枠は合っているが、つかみが外れる | 対称な物体、隠れ、点群のノイズ | 枠の指標ではなく、姿勢の誤差と最終のつかみ成功率を測る |
| つかみに失敗 | つかむ前後で滑る、落とす | 摩擦、ハンドの形との相性、見えていない裏側 | 実機で、物体と置き方を変えて何十回も試す |
表は本記事による整理(解説)です。実際の失敗率は、物体・環境・機器で大きく異なります。
11. 限界と、確認できなかったこと/まとめ
(1) 製品・機器の精度
特定のカメラ、深度センサー、ロボットの製品としての精度・処理速度は、扱っていません。距離の誤差の表は、Keselman らの式[参考資料1]に、本稿が置いた想定値を入れた計算で、実在の機器の仕様ではありません。
(2) 論文の成績の比較
YOLO の毎秒45フレームや、Dex-Net の成功率93%、Contact-GraspNet の成功率90%超は、各論文が選んだ条件での報告値です。条件の異なる数字を並べて、手法の優劣を論じることはしていません。独立した第三者による再現は、本稿では確認していません。
(3) 規格の本文
ISO・IEC の規格は、番号・題名・発行時期・適用範囲の記載にとどめ、本文は確認していません。深度センサーの精度を定める国際規格や、画像認識の学習モデルの評価方法を、ロボットの把持に向けて直接定めた規格は、確認できませんでした。
(4) 取り上げなかった内容
触覚による認識、距離センサーの詳しい原理(LiDAR)、自己位置の推定(SLAM)、自動運転の認識は、それぞれ本シリーズの別の編で扱います。視覚と言語を組み合わせて行動まで出すモデルは「ロボット基盤モデルとVLA」編で扱います。
- 認識は、センサー → 点群 → 検出・分割 → 6D姿勢 → つかみ方、の段階の連なりで、小さな誤りは後ろの段階に持ち越されます
- ステレオの距離誤差は Z²÷(f×B) で増え、距離が2倍なら誤差は4倍です。透明・光沢・暗い表面は、距離が取りにくい代表例です事実本稿の計算
- 検出の指標(IoU、AP)は枠の重なりの指標で、つかめるかどうかは別に実機で測ります。段階ごとの成功率は掛け算で効きます本稿の計算
- 素材技術者は、表面処理・色・照明・汚れという材料側の条件で、認識の難しさを大きく変えられる可能性があります(解説)
12. 評価・標準の読み方
ロボットの視覚の「ものさし」は、段階ごとに違います。距離センサーは誤差(平面への当てはめのばらつきなど)で、検出は IoU と APで、姿勢は位置と向きの誤差で、つかみは実機での成功率で測ります。それぞれのものさしは、別の段階の成績を保証しません。 安全にかかわる「人を検知する」機能には、AIの認識とは別の、安全規格の枠組みがあります。確認できた範囲を表にします(確認日 2026年10月25日)。
| 評価項目 | 代表的な試験・ベンチマーク(名称・出典) | 標準・規則・指針 | 読み方の注意 |
|---|---|---|---|
| 深度センサーの精度 | 平面に当てはめたときのばらつき(RMS)を距離ごとに測る方法の一例(Keselman ら)[参考資料1]事実 | 確認できなかった(深度カメラの精度を定める国際規格は確認できなかった) | 距離・解像度・フレームレート・対象の質感で値が変わる。メーカー公称は条件を確認する |
| 物体検出・セグメンテーション | COCO の AP(IoU 0.50〜0.95 の平均)、AP50、AP75、面積別[参考資料11]。データセット[参考資料10]事実 | ISO/IEC TS 4213:2022「機械学習による分類の性能の評価」(2022年10月発行。ISOのページに改訂版の草案が記載)[参考資料26]。検出・分割をこの規格が扱うかは、本文を未確認事実未確定/将来 | データセットの作られ方・使われ方に条件づけられる。枠の重なりで、つかめるかは分からない |
| 6D姿勢 | BOP(8データセット、共通の評価方法)[参考資料14]、YCB-Video[参考資料12]事実 | 確認できなかった | 対称な物体や隠れの扱いが評価に影響する。実環境の照明・反射は、データセットより厳しいことがある(解説) |
| つかみの成功 | YCB 物体・モデルセットとその評価の手順(Calli ら)[参考資料13]、NIST SP 1227(ロボットハンドの性能指標と試験方法の草案、2018年)[参考資料20]、Dex-Net・Contact-GraspNet の実機試行[参考資料16・17]事実 | ISO 18646-3:2021「サービスロボットの性能基準と試験方法 第3部:マニピュレーション」(把持の大きさ・強さ・滑りへの耐性、扉の開閉。屋内が対象。安全要求の検証には使えない)[参考資料21]事実 | 物体の集合・置き方・ハンド・試行回数が違えば成功率は比べられない。草案は確定した要求ではない |
| 人の検知(安全) | —(AIの認識の評価ではなく、安全装置の枠組み) | IEC 61496-3:2025(近赤外の拡散反射で人などを検知する非接触の保護装置。複雑な分類は扱わず、屋外用途の要求・試験も扱わない)[参考資料22]。ISO 10218-1:2025・ISO 10218-2:2025(産業用ロボットの安全要求)[参考資料23・24]事実 | 人の検知を、学習した画像認識だけに任せない。学習した認識の安全性評価の方法を直接定めた規格は、確認できなかった |
| AIを安全機能に使うとき | — | ISO/IEC TR 5469:2024「人工知能 ― 機能安全とAIシステム」(技術報告。AIを安全関連機能の中で使う場合などの性質・リスク要因・方法を記述)[参考資料25]事実 | 技術報告は要求事項ではなく情報の提供。本文は有料で、適用範囲の記載にとどめる |
| 用語 | — | ISO 8373:2021「ロボット ― 用語」(第3版、2021年11月。改訂案 ISO/DIS 8373 が掲載)[参考資料27]事実 | 用語の定義は版で変わりうる |
表の整理は本稿の計算(整理)。ISO・IEC の番号・題名・発行年月・段階は公式ページの記載で確認(IEC 61496-3 は販売元 AFNOR のページに載る IEC の適用範囲文)。規格本文は有料のため、適用範囲の記載にとどめています。
読み方の注意(素材技術者向け)
- 実演・ベンチマーク・現場は別物:論文のデモや公開データでの成績は、整った照明と選ばれた物体での値です。自分の部品・自分の照明・自分の汚れで測り直してください
- 公称値と実測値は別:カメラの距離精度や処理速度は、メーカーの公称か、論文での測定かを区別し、距離・解像度・対象の質感の条件を確認してください
- 標準は「要求」か「情報」か「草案」か:ISO 10218 は産業用ロボットの安全要求、ISO/IEC TR 5469 は情報を提供する技術報告、NIST SP 1227 は草案です。「規格に沿っている」ことは、学習した認識が安全であることを意味しません
- 認証・承認の範囲:人を検知する保護装置は、規格が定める範囲(機器の種類、屋内か屋外か、検知の対象)で評価されます。その外の使い方には、そのまま当てはまりません
13. 用語集
- RGB画像
- 赤・緑・青の3色で記録した普通のカラー画像。色や模様は分かるが、距離は直接は分からない。
- 深度画像
- 各画素に「カメラからの距離」を入れた画像。
- RGB-D
- カラー画像(RGB)と深度画像(D)をそろえて得るセンサーまたはデータ。
- ステレオ視
- 2台のカメラの画像のずれ(視差)から距離を求める方法。
- 視差
- 同じ点が、左右の画像で何画素ずれて写るか。近いほど大きい。
- ベースライン
- ステレオカメラの2台の間隔。
- 焦点距離
- レンズの性質を表す長さ。ここでは画素の単位で表す。
- 点群
- 3次元の点(x, y, z)の集まり。深度画像から作る。
- 物体検出
- 画像の中の物体を、枠と名前で示すこと。
- セグメンテーション
- 画像の各画素が、どの物体(または背景)に属するかを示すこと。
- インスタンス分割
- 同じ種類の物体も、1個ずつ別々の領域に分けるセグメンテーション。
- IoU
- 予測と正解の領域の重なり具合(重なった面積÷合わせた面積)。0〜1。
- AP/mAP
- 検出の成績を、順位づけと重なりの基準をふまえて1つの数にしたもの。COCOでは種類とIoU基準で平均する。
- 6D姿勢
- 物体の位置(3つの値)と向き(3つの回転)をあわせた6つの値。
- 把持(はじ)
- 物をつかんで持つこと。
- 把持の候補
- ハンドをどの位置・向き・開き幅で閉じるか、の案。
- 開語彙(オープンボキャブラリ)検出
- 学習時に決めた種類だけでなく、言葉で指定した物体も探す検出。
- 合成データ
- コンピュータで作った学習用の画像やデータ。
- 分布のずれ
- 実際に使う場面が、学習したデータと違う性質を持つこと。
- ICP
- 2つの点群の位置を、近い点どうしを合わせながら少しずつ重ねる方法(反復最近接点)。
- AOPDDR
- 近赤外の光の拡散反射で人などの侵入を検知する保護装置。安全用のレーザースキャナなどが相当する。
14. 参考資料(一次情報)
- Keselman L. ほか “Intel RealSense Stereoscopic Depth Cameras”, arXiv:1705.05548 (2017) — arxiv.org/abs/1705.05548
- Qi C. R. ほか “PointNet: Deep Learning on Point Sets for 3D Classification and Segmentation”, arXiv:1612.00593 (2016; CVPR 2017) — arxiv.org/abs/1612.00593
- Besl P. J., McKay N. D. “A method for registration of 3-D shapes”, IEEE Trans. Pattern Anal. Mach. Intell. 14, 239–256 (1992), DOI 10.1109/34.121791 — doi.org/10.1109/34.121791
- Redmon J. ほか “You Only Look Once: Unified, Real-Time Object Detection”, arXiv:1506.02640 (2015) — arxiv.org/abs/1506.02640
- He K. ほか “Mask R-CNN”, arXiv:1703.06870 (2017) — arxiv.org/abs/1703.06870
- Carion N. ほか “End-to-End Object Detection with Transformers”, arXiv:2005.12872 (2020) — arxiv.org/abs/2005.12872
- Kirillov A. ほか “Segment Anything”, arXiv:2304.02643 (2023) — arxiv.org/abs/2304.02643
- Ravi N. ほか “SAM 2: Segment Anything in Images and Videos”, arXiv:2408.00714 (2024) — arxiv.org/abs/2408.00714
- Liu S. ほか “Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection”, arXiv:2303.05499 (2023) — arxiv.org/abs/2303.05499
- Lin T.-Y. ほか “Microsoft COCO: Common Objects in Context”, arXiv:1405.0312 (2014; ECCV 2014) — arxiv.org/abs/1405.0312
- COCO Consortium “Detection Evaluation” (the metrics used by COCO)。確認日 2026年10月25日 — cocodataset.org/#detection-eval
- Xiang Y. ほか “PoseCNN: A Convolutional Neural Network for 6D Object Pose Estimation in Cluttered Scenes”, arXiv:1711.00199 (2017) — arxiv.org/abs/1711.00199
- Calli B. ほか “Benchmarking in Manipulation Research: The YCB Object and Model Set and Benchmarking Protocols”, arXiv:1502.03143 (2015) — arxiv.org/abs/1502.03143
- Hodan T. ほか “BOP: Benchmark for 6D Object Pose Estimation”, arXiv:1808.08319 (2018; ECCV 2018) — arxiv.org/abs/1808.08319
- Wen B. ほか “FoundationPose: Unified 6D Pose Estimation and Tracking of Novel Objects”, arXiv:2312.08344 (2023) — arxiv.org/abs/2312.08344
- Mahler J. ほか “Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp Metrics”, arXiv:1703.09312 (2017; RSS 2017) — arxiv.org/abs/1703.09312
- Sundermeyer M. ほか “Contact-GraspNet: Efficient 6-DoF Grasp Generation in Cluttered Scenes”, arXiv:2103.14127 (2021) — arxiv.org/abs/2103.14127
- Sajjan S. ほか “ClearGrasp: 3D Shape Estimation of Transparent Objects for Manipulation”, arXiv:1910.02550 (2019) — arxiv.org/abs/1910.02550
- Yang L. ほか “Depth Anything V2”, arXiv:2406.09414 (2024) — arxiv.org/abs/2406.09414
- Falco J., Van Wyk K., Messina E. “Performance Metrics and Test Methods for Robotic Hands (Draft)”, NIST Special Publication 1227 (draft), 2018 — doi.org/10.6028/NIST.SP.1227-draft
- ISO ISO 18646-3:2021 “Robotics — Performance criteria and related test methods for service robots — Part 3: Manipulation” (Edition 1, June 2021)。確認日 2026年10月25日 — iso.org/standard/73591.html
- IEC IEC 61496-3:2025 “Safety of machinery — Electro-sensitive protective equipment — Part 3: Particular requirements for active opto-electronic protective devices responsive to diffuse reflection (AOPDDR)” (August 2025; scope text as shown by the distributor AFNOR)。確認日 2026年10月25日 — boutique.afnor.org (IEC 61496-3:2025)
- ISO ISO 10218-1:2025 “Robotics — Safety requirements — Part 1: Industrial robots” (Edition 3, February 2025)。確認日 2026年10月25日 — iso.org/standard/73933.html
- ISO ISO 10218-2:2025 “Robotics — Safety requirements — Part 2: Industrial robot applications and robot cells” (Edition 2, February 2025)。確認日 2026年10月25日 — iso.org/standard/73934.html
- ISO/IEC ISO/IEC TR 5469:2024 “Artificial intelligence — Functional safety and AI systems” (Edition 1, January 2024)。確認日 2026年10月25日 — iso.org/standard/81283.html
- ISO/IEC ISO/IEC TS 4213:2022 “Information technology — Artificial intelligence — Assessment of machine learning classification performance” (October 2022)。確認日 2026年10月25日 — iso.org/standard/79799.html
- ISO ISO 8373:2021 “Robotics — Vocabulary” (Edition 3, November 2021)。確認日 2026年10月25日 — iso.org/standard/75539.html
15. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| ステレオの距離の式 Z=f×B÷d、深度誤差が Z²÷(f×B)×(視差の誤差)で増えること、視差の誤差を約0.1画素として扱う記述 | Keselman らの解説(式1〜3) 出典1 https://arxiv.org/abs/1705.05548 | 事実 |
| R200の1台の実測例:1 mで2.1 mm、2 mで8.0 mm(480×360、30 Hz)。ベースラインが約70 mm、左右カメラに約840 nm以下の可視光を遮るフィルターが付いていること | Keselman らの解説(表5、第2章) 出典1 https://arxiv.org/abs/1705.05548 | 事実 |
| 深度誤差の表(0.5〜5 m)、点群のデータ量、1画素が覆う長さ、IoU 0.59、段階ごとの成功率の積(83.8%など) | 本稿の計算(Python。想定値 f=600画素、B=70 mm、視差の誤差=0.1画素。段階の成功率は説明用の想定)。実在の機器・システムの成績ではない | 本稿の計算 |
| 1枚の画像から深度を推定する単眼深度推定モデル(Depth Anything V2)。ラベル付きの実画像をすべて合成画像に置き換えて学習したこと | Yang らの論文(要旨) 出典19 https://arxiv.org/abs/2406.09414 | 事実 |
| 点群が順序のない点の集合であり、それを直接入力とするネットワーク(PointNet)が提案されたこと。2つの点群を重ねる古典的な方法(ICP) | Qi らの論文(要旨)、Besl と McKay の論文(題名・書誌) 出典2 https://arxiv.org/abs/1612.00593 出典3 https://doi.org/10.1109/34.121791 | 事実 |
| YOLOが物体検出を1つのネットワークでの回帰として扱い、基本モデルで毎秒45フレームで処理すること。Mask R-CNNが枠の予測に加えてマスクを予測し、約5 fpsで動くこと。DETRが検出を集合予測として扱うこと | Redmon ら、He ら、Carion らの論文(要旨) 出典4 https://arxiv.org/abs/1506.02640 出典5 https://arxiv.org/abs/1703.06870 出典6 https://arxiv.org/abs/2005.12872 | 事実 |
| Segment Anythingが10億個超のマスクと1,100万枚の画像のデータセットで学習した「プロンプトで指定できる」セグメンテーションであること。SAM 2が画像・動画に対応すること。Grounding DINOが言葉で指定した物体を検出する開語彙の検出器であること | Kirillov ら、Ravi ら、Liu らの論文(要旨) 出典7 https://arxiv.org/abs/2304.02643 出典8 https://arxiv.org/abs/2408.00714 出典9 https://arxiv.org/abs/2303.05499 | 事実 |
| COCOの評価指標:APをIoU 0.50〜0.95の10段階(0.05刻み)と80カテゴリで平均すること、AP(IoU=.50)とAP(IoU=.75)、小・中・大の面積区分(32²・96²画素)、1画像あたり最大100件の検出。COCOデータセットが328,000枚・250万件のラベル付き対象を持つこと | COCOの評価ページ、Lin らの論文(要旨) 出典11 https://cocodataset.org/#detection-eval 出典10 https://arxiv.org/abs/1405.0312 | 事実 |
| PoseCNNと、YCB-Videoデータセット(21物体、92本の動画、133,827フレーム)。YCB物体・モデルセットがマニピュレーション研究の比較用に作られたこと。BOPが8つのデータセットと15手法を評価したこと。FoundationPoseがCADモデルまたは少数の参照画像で新しい物体に使えること | Xiang ら、Calli ら、Hodan ら、Wen らの論文(要旨) 出典12 https://arxiv.org/abs/1711.00199 出典13 https://arxiv.org/abs/1502.03143 出典14 https://arxiv.org/abs/1808.08319 出典15 https://arxiv.org/abs/2312.08344 | 事実 |
| Dex-Net 2.0:670万の合成点群で学習、1,000回超の実機試行、既知の8物体で成功率93%、把持の計画に0.8秒 | Mahler らの論文(要旨) 出典16 https://arxiv.org/abs/1703.09312 | 事実 |
| Contact-GraspNet:1,700万の模擬把持で学習、未知の物体の整理された山積みで成功率90%超、失敗率を従来比で半減 | Sundermeyer らの論文(要旨) 出典17 https://arxiv.org/abs/2103.14127 | 事実 |
| 透明物体は標準的な3Dセンサーでは深度が取りにくく、奥の面に近い雑音混じりの値になること。ClearGraspの合成データ(5万枚超)と実画像のテスト286枚 | Sajjan らの論文(要旨) 出典18 https://arxiv.org/abs/1910.02550 | 事実 |
| ISO 18646-3:2021の題名・発行(2021年6月、第1版)・適用範囲(把持の大きさ・強さ・滑りへの耐性、扉の開閉)。屋内が対象で、安全要求の検証・妥当性確認には使えないこと | ISOの公式ページ 出典21 https://www.iso.org/standard/73591.html | 事実 |
| NIST SP 1227(草案)の題名と発行年(2018年) | NISTの出版物ページ 出典20 https://doi.org/10.6028/NIST.SP.1227-draft | 事実 |
| IEC 61496-3:2025の題名・発行(2025年8月)・適用範囲(近赤外の拡散反射で人などを検知する非接触の保護装置。複雑な分類は扱わず、屋外用途の要求・試験も扱わない) | AFNOR(IEC規格の販売元)のページに載るIECの適用範囲文 出典22 https://www.boutique.afnor.org/en-gb/standard/iec-6149632025/safety-of-machinery-electrosensitive-protective-equipment-part-3-particular/xs305084/449130 | 事実 |
| ISO 10218-1:2025・ISO 10218-2:2025(産業用ロボットの安全要求、2025年2月)、ISO/IEC TR 5469:2024(AIの機能安全。技術報告)、ISO/IEC TS 4213:2022(分類性能の評価。改訂版の草案あり)、ISO 8373:2021(ロボットの用語。改訂案あり)の番号・題名・段階 | ISOの公式ページ 出典23 https://www.iso.org/standard/73933.html 出典24 https://www.iso.org/standard/73934.html 出典25 https://www.iso.org/standard/81283.html 出典26 https://www.iso.org/standard/79799.html 出典27 https://www.iso.org/standard/75539.html | 事実 |
| 「認識の誤りは後ろの段階に持ち越される」「表面で見えかたが変わる(つや消し・光沢・真っ黒)」「カメラや照明の配置で成否が変わる」「安全機能にAIの認識をそのまま使わない」という読み取り | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 規格の本文、実機での画像認識の失敗率の統計、個別製品の認識性能の比較、市場規模 | 本稿の調査範囲では一次情報で確認できなかったため記載していない(解説) | 解説 |
| 図1・図8がImageGen生成の概念画像であること、図2・図3・図7が説明のための概念図、図4・図5・図6が本稿の計算を含む作図であること | 本記事による注記 | 解説 |
最終更新:2026年10月25日/出典は一次情報(arXiv の論文、COCO の評価ページ、NIST・ISO・IEC の公式ページ)に限定しています。ISO・IEC の規格本文は有料のため確認できていません。 数値例は本稿が置いた想定値による計算で、実在のカメラ・ロボットの性能ではありません。 製品としての深度センサーの精度、実機での認識の失敗率の統計、学習した認識の安全性評価を直接定める規格については、確認できなかったため記載していません。 図1と図8はImageGen生成の概念画像で、その他の図は説明用の概念図または本稿の計算を含む作図です。