TECHNOLOGY EXPLAINER
材料データと記述子
― 材料を「数字の名刺」にして、データの質・欠損・偏りに向き合う
機械学習が読めるのは、数字だけです。だから、材料の組成・構造・つくり方を、まず数字に直す必要があります。この数字の列が記述子、本シリーズの言い方では材料の「名刺」です。 どんな名刺をつくるか、そして集めたデータの質(ばらつき、欠損、偏り、失敗データの有無)が、予測が当たるかどうかを大きく左右します。この記事は、素材技術者が自社の実験データをMIに使える形に整えるために、記述子のつくり方と、データの質の落とし穴を、小さな計算を交えて説明します。
- 3行でわかる/読む前に/シリーズの中での位置
- 記述子とは何か ― 材料を数字の「名刺」にする
- 組成から名刺をつくる ― 手計算で確かめる
- 実験ノートを表にする ― 「1行1試料」と、データの質
- 数字の桁をそろえる ― 尺度の問題
- 欠損と「測れなかった値」
- データの偏りと、外挿の危険
- 失敗データの価値
- 記述子を選ぶ・減らす考え方
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・改訂中など、まだ確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。
第5〜7章の数値は、本稿が作った合成データ(乱数の種を固定)の計算です。実在の材料データや製品の性能を示すものではなく、仕組みと落とし穴を数値で見せるための例です。第3章の元素の値は PubChem の周期表のデータで、計算は本稿です。ISO/IEC・ISO の規格は、番号・題名・発行年月の確認にとどめ、本文は確認していません。
1. 3行でわかる/読む前に/シリーズの中での位置
- 記述子は、材料を数字で表した「名刺」:組成、構造、つくり方(プロセス)を、機械が読める数値の列にしたものです。名刺に書く項目の選び方で、予測の当たり方が変わります
- データの質が、予測の質を決める:測定のばらつき、桁の違い、欠損、データの偏り、失敗の記録の有無が、どれも結果をゆがめます。モデルの工夫より先に、データを整える価値があります
- いちばん大事な1点:「測れなかった」「うまくいかなかった」という情報も、データです。空欄にせず、理由と一緒に残すと、MIが使える材料の「境界」が見えます
本シリーズ「マテリアルインフォマティクス概論」編を読んでいなくても読めるように、必要な前提は短く説明します。要点は次のとおりです。機械学習は「過去のデータから傾向を学ぶ近似器」で、データの範囲の外(外挿)は苦手です。記述子は、材料を数字で表した「名刺」です。化学・材料の基本的な知識があれば十分で、プログラミングの知識は要りません。
これは、本シリーズ「マテリアルインフォマティクス」の2番目の記事で、「概論」編の次にあたります。ここで作る「名刺」と「データの質」の考え方は、次の編「材料データベースとFAIR原則」(データの集め方と共有の仕方)、「小データ機械学習」(少ないデータで学ぶ工夫)、「不確かさと適用範囲」(予測の信頼度)の土台になります。
2. 記述子とは何か ― 材料を数字の「名刺」にする
(1) たとえ:初対面の人を、名刺で比べる
初対面の人を比べるとき、名刺があれば便利です。会社、役職、所在地のように、決まった項目が並んでいるからです。材料も同じです。決まった項目を、数字で並べた名刺があれば、機械は、2つの材料がどれくらい似ているかを計算できます。この名刺が記述子(フィンガープリントとも呼ばれます)です。Ramprasad らの総説は、予測が、「まず材料を数値で表し、その表現と目的の特性を、学習した対応づけで結ぶ」形で行われること、この数値の表現が、適用の場面に応じて、さまざまな種類と規模をとりうることを述べています事実[参考資料1]。
元のSVG・数値・出典を確認する
元SVGの説明:本稿の計算を含む作図(ベクター作図)。材料を、組成・構造・つくり方から数字に直した「名刺」のイメージ。組成の欄だけが実際の計算で、他の欄は項目の例です。
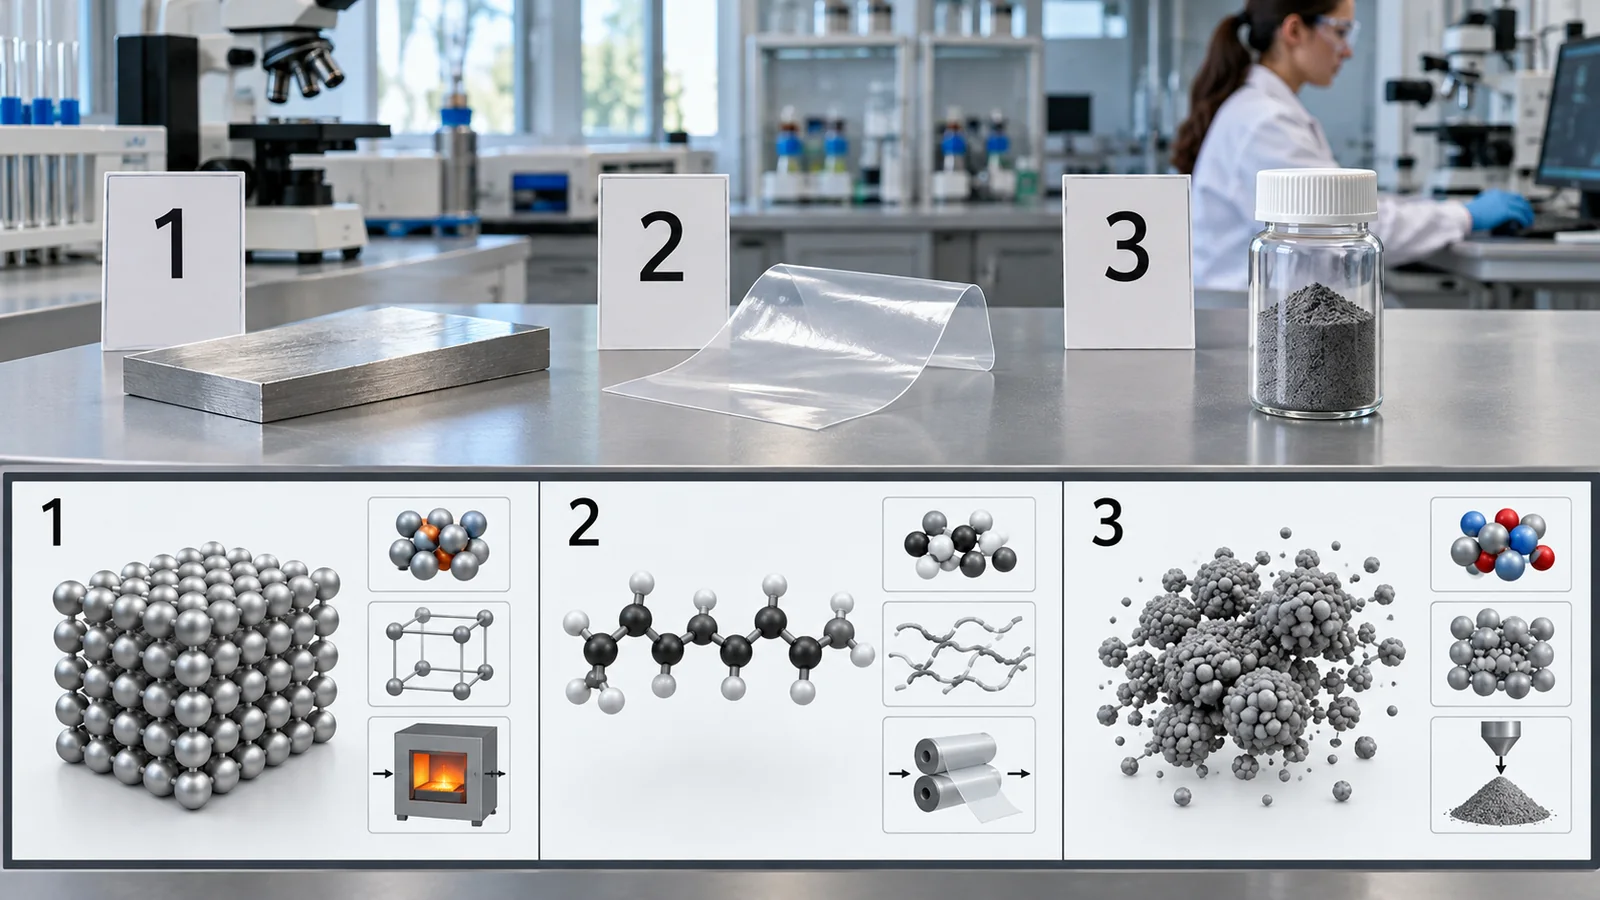
名刺の項目は、材料の組成(何が、どんな割合で入っているか)、構造(原子がどう並んでいるか)、つくり方(温度・時間・雰囲気などのプロセス)のどこから取るか、で大きく3つに分けられます。図2のように、組成の項目は化学式だけから計算できます。構造とつくり方の項目は、別の情報が必要です。
| 名刺の種類 | 何から作るか/代表例(出典) | 長所 | 注意 |
|---|---|---|---|
| 組成の記述子 | 化学式(元素と割合)から、元素の性質の統計量をつくる。Ward らの汎用の枠組みは、145個の属性を使い、うち元素の性質の統計量は、22種の元素の性質の平均、平均絶対偏差、範囲、最小、最大、最頻値[参考資料3]事実。matminer は、特徴量の抽出ルーチン47クラスを集め、数千の記述子を生成できるソフトウェア[参考資料4]事実 | 結晶構造が不要。化学式だけで作れるので、未知の組成でもすぐ計算できる | 同じ組成でも、結晶構造が違えば性質が違う。その区別はできない(本記事による解説) |
| 構造の記述子 | 原子の位置から作る。Rupp らは、核の電荷と原子の位置だけを入力にして、有機分子の原子化エネルギーを予測する機械学習の模型を提案[参考資料5]事実。Bartók らは、原子の周りの環境を表す記述子(SOAP など)が、回転・反転・平行移動・同種原子の入れ替えで値が変わらない必要がある、と整理[参考資料6]事実 | 原子の並びの違いを反映できる | 構造が必要。未知の材料では、構造そのものを予測か計算で得ることになり、その誤差が混ざる(本記事による解説) |
| 分子の指紋 | 分子の部分構造の有無を並べる。ECFP(拡張連結性指紋)は、構造と活性の関係のモデリング用に開発された、円形の指紋[参考資料8]事実 | 計算が速く、部分構造として解釈しやすい | 三次元の形や、材料としての集合状態(結晶、高分子鎖の絡み合い)は直接は表さない(本記事による解説) |
| プロセスの記述子 | 焼成温度、時間、雰囲気、原料ロットなど、つくり方を数字・カテゴリにする。Ling らは、組成とプロセスの両方の最適化を扱う、実験の設計の枠組みを報告[参考資料27]事実 | 実際の性能を左右する要因を、モデルに入れられる | 記録の仕方で質が決まる。測っていない条件(湿度、乾燥履歴など)は、名刺に書けない(本記事による解説) |
表の整理は本記事による解説です。他の表現(スペクトル、画像、文章)や、構造を表す手法の詳しい比較は、Musil らの総説[参考資料9]と、Damewood らの総説[参考資料10]を参照してください。
本によって、「記述子」「特徴量(feature)」「説明変数」「属性(attribute)」と呼び方が違いますが、ここでは同じものを指します(本記事による解説)。Ghiringhelli らは、記述子の選択を、統計的学習の中の「ほとんど黙って、問い直されない段階」と呼び、記述子と、特性を決める仕組みの間の科学的なつながりが不明だと、学習した関係の因果が不確かになる、と論じています事実[参考資料2]。名刺の項目は、「なんとなく」ではなく、何を知りたいかに合わせて、意味のあるものを選ぶのが大切です。
3. 組成から名刺をつくる ― 手計算で確かめる
いちばん簡単な名刺を、実際に手計算でつくってみます。材料の例は LiFePO₄(リン酸鉄リチウム)です。リチウム(Li)、鉄(Fe)、リン(P)、酸素(O)が、1:1:1:4 の割合で入っています。原子の合計は7個です。
- 割合を出す:Li、Fe、P は、それぞれ 1/7、O は 4/7 です
- 元素の性質を調べる:ここでは電気陰性度(原子が電子を引きつける強さの目安)を使います。PubChem の周期表の値は、Li 0.98、Fe 1.83、P 2.19、O 3.44 です[参考資料19]
- 割合で重みづけした平均をとる:(0.98 + 1.83 + 2.19) ÷ 7 + 4 × 3.44 ÷ 7 = 0.714 + 1.966 = 2.68
- 範囲をとる:最大 − 最小 = 3.44 − 0.98 = 2.46
同じ手順で、4つの化合物の「名刺」をつくった結果が、図3の下の表です(本稿の計算)。平均の電気陰性度は、LiFePO₄ が 2.68、BaTiO₃ が 2.55、NaCl が 2.05、MgO が 2.38 です。範囲(最大と最小の差)は、イオン結合性の強い化合物ほど大きい、という見方もできます(本記事による解説)。Ward らの汎用の枠組みの「元素の性質の統計量」は、この考え方(平均、範囲など)を、22種の元素の性質に広げたものです[参考資料3]。
本稿の計算。元素の値は PubChem の周期表のデータ[参考資料19]。平均は原子の個数の割合で重みづけ。これは入門用の2項目の例で、実際の組成記述子は数十〜数百項目です[参考資料3]。
平均だけだと、NaCl(Na 0.93 と Cl 3.16)と、電気陰性度が中間の元素2つの化合物が、同じ平均になりうるからです。範囲は、元素どうしの「性質の差」を表します。1つの数字では見えないことを、別の数字で補う、と考えてください。たとえの限界:この名刺は、化学式から作ったもので、「どう並んでいるか」は何も書いていません。組成が同じで構造が違う材料は、同じ名刺になります。
4. 実験ノートを表にする ― 「1行1試料」と、データの質
自社の実験データを使うとき、最初の仕事は、実験ノートを表にすることです。機械が読めるのは表です。文章や写真だけでは、数字にできません。図4は、メモ書きを、1行に1つの試料が入る表に直す例です。
元のSVG・数値・出典を確認する
元SVGの説明:概念図(ベクター作図)。メモ書きを、機械が読める表に直す例。条件と結果を別の列に置き、単位・ロット・失敗の記録を残します。値は説明用です。
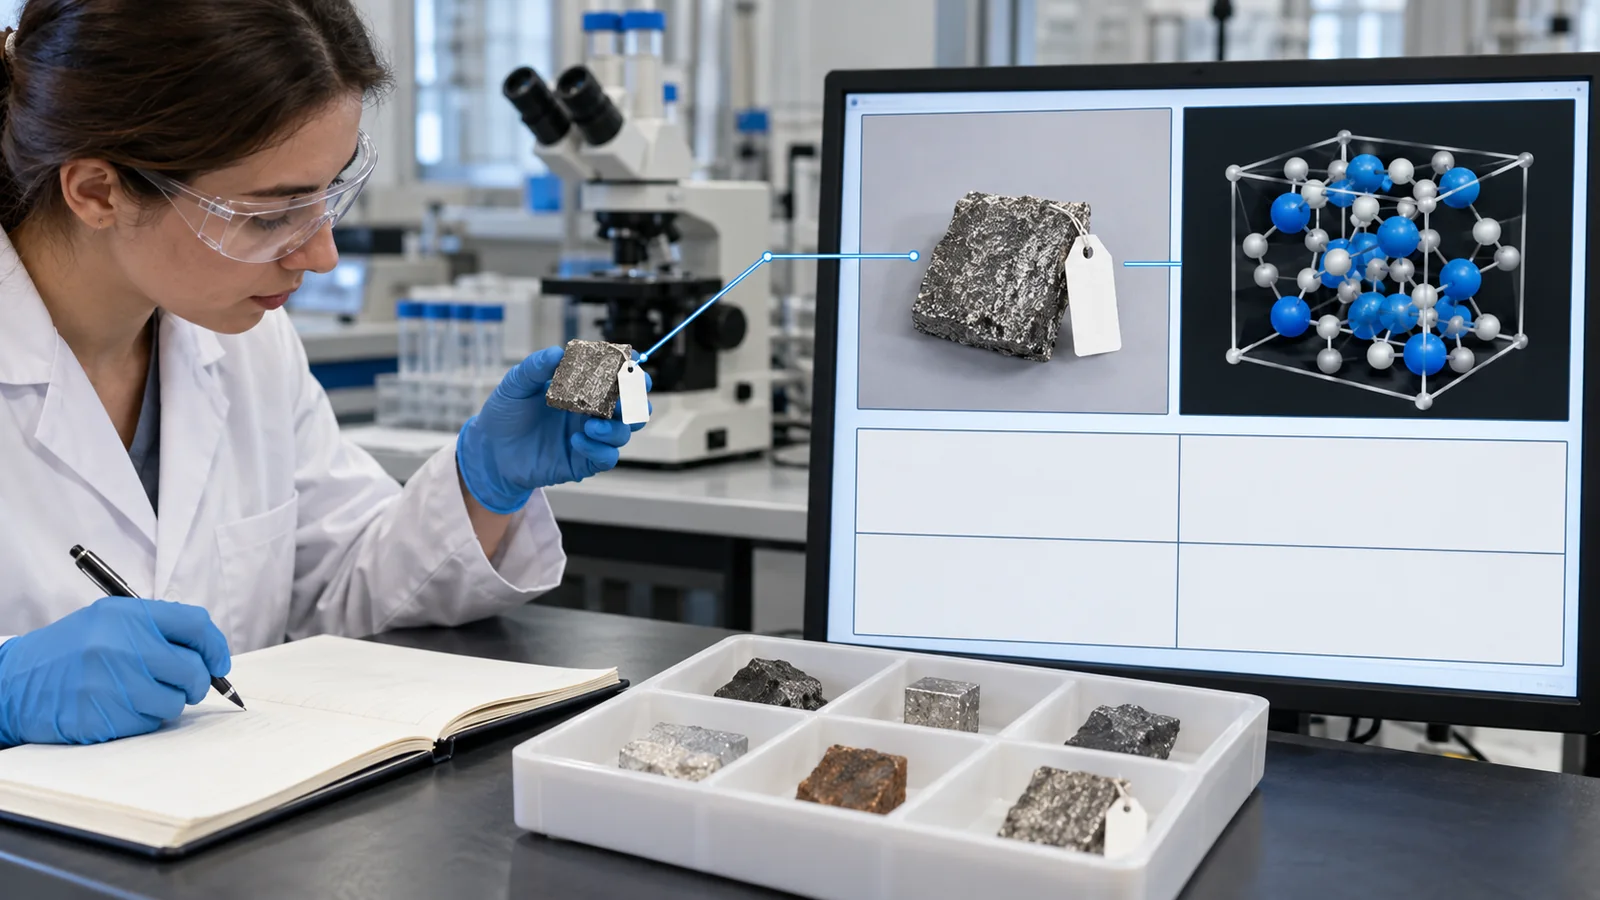
表にするときの決まりは、3つだけです。①1行に1つの試料(同じ試料を何回か測ったら、その回数だけ行を足す)。②1列に1つの項目(単位は列の名前に入れる)。③空欄にしない(測れなかった、失敗した、は理由を書く)。これだけで、後の作業が楽になります。
| データの質のチェック項目 | 起きること | 点検のしかた(解説) |
|---|---|---|
| 単位の混在 | ℃と K、MPa と GPa が同じ列に混ざり、桁が合わない | 列ごとに単位を固定し、列名に書く。取り込み時に範囲を確認する |
| 表記ゆれ | 「LiFePO4」「LFP」「リン酸鉄リチウム」が別のものとして扱われる | 材料名や略称は、決まった表記に統一する。化学式の列を別に持つ |
| 日付・ロット・装置 | どの原料、どの装置、どの日のものかが分からず、ばらつきの原因を追えない | 日付、原料ロット、装置、担当者の列を必ず入れる |
| 検出下限・測定範囲 | 「測定下限未満」が、空欄や0として記録される | 下限値と、下限未満であることを別の列で記録する(第6章) |
| 重複 | 同じ試料が2回入り、評価が甘くなる(データ漏れの一種) | 試料のIDで重複を探す。同じ試料の繰り返しは、同じ「グループ」として扱う |
| 外れ値 | 入力ミスか、本当にある現象か、見分けがつかない | 元の記録に戻って確認する。理由が分からないまま、消さない |
| 測定のばらつき | モデルの誤差が、測定のばらつき以下にはならない | 同じ試料を繰り返し測り、ロット間・装置間の差も見る(下記) |
表は本記事による解説です。データ品質の国際規格(ISO/IEC 5259 シリーズ)は、第11章で題名と範囲を紹介します。
測定のばらつきについて、数字で一例を見ます。OQMD の論文は、同じ化合物の生成エネルギーを測った実験どうしの平均絶対誤差が0.082 eV/原子と、「驚くほど大きい」ことを報告しています(DFT の計算と実測の差は 0.096 eV/原子)事実[参考資料16]。測定のばらつきの扱い方は、計測の分野で整理されています。たとえば、JCGM 100:2008(GUM)は、測定の不確かさを、「測定結果に結びつく、測定量に合理的に帰せられる値の散らばりを特徴づけるパラメータ」と定義しています事実[参考資料26]。
同じ試料を3回、できれば別のロットで作り直して測ってみてください。そのばらつき(標準偏差など)が、モデルがめざせる誤差の目安の下限です。ばらつきが10%なら、誤差5%のモデルは、測定の誤差より小さい誤差を主張していることになり、ノイズまで覚えている(過学習)可能性が高くなります(本記事による解説)。
また、ロット(原料の製造単位)や装置の違いは、「材料の差」ではなく「条件の差」として表に残してください。後で、「どのロットで外れたか」を調べられます。
5. 数字の桁をそろえる ― 尺度の問題
名刺の項目は、桁が違うことがよくあります。たとえば、温度は 300〜1,300 K(幅は約1,000)、組成の割合は 0〜1(幅は1)です。多くの機械学習の手法は、この桁の違いに影響されます。scikit-learn のユーザーガイドは、多くの推定器が、個々の特徴量が、平均0、分散1の標準正規分布のデータに、多かれ少なかれ似ていないと、うまく動かないことがある、と説明しています事実[参考資料17]。
その影響を、小さな実験で確かめます(本稿の計算)。「最も近い3つの過去の試料の値の平均を返す」近傍法を、温度と割合の2つの記述子で使います。真の特性は、割合に強く(周期的に)、温度にはゆるやかに依存します。60点で学習し、新しい500点で誤差を測ります(30回の平均)。
結果は、図6のとおりです。桁をそろえずに使うと、距離をほぼ温度の差だけが決めてしまい、割合の効果が見えません。誤差(RMSE)は0.83で、「平均を返すだけ」の何もしない予測(0.73)より悪くなりました。標準化(各項目から平均を引き、ばらつきの大きさで割る)をすると、誤差は0.24に下がりました。
本稿の計算。合成データ(真の特性 = sin(2π × 割合) + 0.3 × (温度 − 800)/500 + 雑音0.05)。実在の材料の結果ではありません。標準化は訓練データだけで平均とばらつきを求め、評価データにはその値を適用しました(データ漏れを避けるため)。
標準化に使う平均とばらつきを、評価に使うデータまで含めて計算すると、評価の情報が学習に漏れます。標準化も、訓練データだけで学び、評価データには、その値を当てはめるだけにします(Kapoor と Narayanan が整理した「前処理での漏れ」の一つです事実[参考資料22]。詳しくは、本シリーズ「機械学習とニューラルネットワークの基礎」編)。なお、決定木に基づく手法のように、桁の違いに強い手法もありますが、本稿では一次情報を確認していません。
6. 欠損と「測れなかった値」
材料の表には、空欄(欠損)がつきものです。測っていない項目、測れなかった試料、装置の測定範囲の外の値、などです。scikit-learn のユーザーガイドは、不完全なデータを使う基本の方法は、欠損のある行や列を捨てることだが、役に立つかもしれないデータを失う代わりになる、より良い方法は、既知の部分から欠損を推定する「補完(imputation)」だ、と説明しています[参考資料18]。
ただし、なぜ欠損したのかが重要です。もし欠損が偶然でなく、たとえば「低い値ほど検出下限を下回って測れない」ようなときは、測れた点だけを集めると、偏りが生まれます。小さな実験で確かめます(本稿の計算)。
- 設定:記述子 x(例:添加量)と特性 y の間に、y = x + 雑音(標準偏差0.5)という関係がある。y が −0.5より低い値は、検出下限を下回って記録されない(欠損が全体の約33%)
- 真の平均は 0.00。ところが、測れた点だけの平均は 0.60 に上がる
- 傾きは、全部の点なら 1.00、測れた点だけだと 0.82 にゆるやかになる
- 欠損を検出下限の値(−0.5)で埋めると、平均は 0.24 で、真の値 0.00 とはまだ差がある
本稿の計算。合成データ(200,000点で平均と傾きを計算。図の点は200点)。実在の材料の結果ではありません。
欠損の理由によっては、解決しません。平均で埋める方法は、欠損が偶然のときには、よく使われる手軽な方法ですが、「低い値ほど欠ける」ような場合には、測れた点だけの偏った平均で埋めることになり、偏りが残ります。上の例では、測れた点だけの平均 0.60 で埋めても、真の平均 0.00 には近づきません。対策は、①欠損の理由(検出下限、失敗、未測定)を別の列で記録する、②検出下限未満は「下限未満である」という情報として扱う、③欠損の理由に詳しい人(測定者)に確認する、です(本記事による解説)。
7. データの偏りと、外挿の危険
集めたデータが、条件の一部の範囲に偏っていると、その範囲の外では、予測が当たりません。小さな実験で確かめます(本稿の計算)。真の関係を y = sin(3x) + 0.5x とし、x = 0〜1 の範囲だけで30点(雑音0.05)を測って学習します。評価は、同じ範囲(内)と、x = 1〜3(外)で行います。
結果は、図8のとおりです。範囲の内側では、3次の多項式の誤差は0.03、3近傍法は0.08と、どちらも当たります。ところが、外側(x = 1〜3)では、多項式の誤差は12.6(中央値)まで跳ね上がりました。3近傍法は、端の値のまま一定になり、誤差は0.98です。この外側での真の値のばらつき(標準偏差0.97)と同じ程度で、「平均を返す」予測と変わりません。
本稿の計算。合成データ。50回の平均(多項式は中央値)。範囲の外では、モデルの種類によって、外れ方が違います(暴走する、一定になる)が、どちらも当たりません。
これは、人為的な極端な例です。しかし、実際の材料データでも、似た偏りが報告されています。Jia らは、アミンを鋳型にした金属酸化物の水熱合成の報告で、アミンの選択が、べき乗則の分布に従い、全アミンの17%が、報告された化合物の79%に使われていることを見つけました。人が実験を選ぶときの流行や認知の偏りが、データに表れるのです。さらに、548件の無作為に作った実験で、反応物の人気や反応条件の選び方は、反応の成否とは相関がないことを示し、小さな無作為の反応データで学習したモデルが、人が選んだより大きなデータで学習したモデルを上回った、と報告しています事実[参考資料13]。
また、Li らは、複数の大きな材料データセットで、データの最大95%を学習から除いても、分布内の予測性能はほとんど変わらないこと、除けたデータは、数が多すぎる材料タイプに関連していること、分布外での悪化は防げないことを示しています事実[参考資料15]。データの量より、どんな範囲を、どれくらい偏りなく含むかが大切だ、ということです。
自社の実験データは、「うまくいきそうな条件」に集中していることが多いはずです。いつもの原料、いつもの温度、いつもの組成の近くです。それは、日々の仕事としては正しい判断です。ただし、MIでそのデータを使うと、「いつもの条件の外」では当たらないモデルができます(本記事による解説)。名刺の項目ごとに、データがどの範囲を覆っているか(最小・最大・件数)を、先に表にしてみてください。未知の領域を探すときは、モデルが当たる範囲(適用範囲)を確認する必要があります。本シリーズ「不確かさと適用範囲」編で扱います。
8. 失敗データの価値
論文や報告に載るデータは、成功した結果が中心です。失敗した条件は、書かれないことが多くあります。しかし、失敗の記録は、成功する条件の「境界」を教えます。図9の左は、成功だけを記録した場合で、成功した点はよく試される条件の周りに集まり、どこまで条件を広げてよいかが分かりません。右は、失敗も記録した場合で、成功と失敗の境目が見えます。
Raccuglia らは、実験ノートに残っていた「失敗した反応」(論文にはならなかったもの)のデータを集め、バナジウムのセレン酸塩(テンプレート剤を含む)の反応の成否を機械学習に学ばせました。このモデルは、人の直感より高い精度で反応の成功と失敗を予測できました、と報告されています事実[参考資料12]。論文の説明は、失敗した反応は、反応が成立する条件の限界についての貴重な情報を持つのに、ほとんど報告されない、という点も指摘しています[参考資料12]。
また、Kononova らは、論文から、固相合成の「レシピ」(目的の材料、原料、操作とその条件、反応式)を、文章処理の技術で自動的に取り出し、19,488件の合成の記録(53,538の合成の段落から)を、公開のデータセットにまとめました事実[参考資料14]。文章を表の形に直す取り組みの一例です。ただし、元の論文の偏り(第7章)は、そのまま引き継がれます(本記事による解説)。
自社の実験ノートには、論文にならなかった失敗が、たくさん眠っています。それらは、「どの条件でどう失敗したか」という、境界の情報です。第4章の表で、失敗を「失敗」「相が不純」「膜が割れた」のように分類して記録しておけば、後で使えます。ただし、「失敗」の定義(何をもって失敗と呼ぶか)を、関係者でそろえておくことが大切です。定義が人によって違うと、データがばらつきます(本記事による解説)。知的財産や機密に関わる実験データを外部に出すかどうかは、社内の規則に従ってください。
9. 記述子を選ぶ・減らす考え方
名刺の項目は、多ければ良いわけではありません。次の4つの点を確認します(本記事による解説)。
- 予測するときに、手に入る情報だけを使う:結果が分かってからでないと知り得ない情報(たとえば、測定後に決まる別の特性)を、名刺に入れてはいけません。評価の数字は良くなりますが、使い物になりません(データ漏れの一種)
- 物理・化学の意味があるか:意味のある項目は、データが少なくても働きやすく、結果の解釈もできます。Ghiringhelli らは、適切な記述子の要件を論じ、古典的な例(閃亜鉛鉱型またはウルツ鉱型と、岩塩型の半導体のエネルギー差)で、意味のある記述子を体系的に見つける方法を示しました[参考資料2]
- 項目の数は、データの数に見合うか:項目が試料数に近づくと、過学習が起きやすくなります(本シリーズ「小データ機械学習」編)。Ouyang らの SISSO は、膨大な候補から、少数の最良の記述子を選ぶ圧縮センシングの方法で、小さな学習データでも安定した結果が得られる、と報告しています事実[参考資料11]
- 測れる、または計算できるか:名刺の項目が、実際の現場で、安く確実に得られなければ、使えません
データが少ないときは、逆効果になりえます。項目が増えるほど、偶然の揺らぎに合う項目が混ざり、訓練データには当てはまるのに、新しい試料では外れる(過学習)ことが起きます。名刺を厚くする前に、データの質、偏り、ばらつきを点検してください。また、項目を訓練データだけを見て選んでください(評価データを見てから選ぶと、評価が甘くなります)。詳しくは、「小データ機械学習」編で扱います。
10. 限界と、確認できなかったこと/まとめ
(1) 確認できなかったこと
- PubChem の電気陰性度の尺度:PubChem の周期表のページで、どの尺度(Pauling など)の値かは確認できませんでした。そのため、本稿は「PubChem の値」と書き、尺度名は書いていません
- 記述子の性能の優劣:どの記述子が、どの材料・特性で最も良いかは、本稿では扱いません。比較は、データセットと分割で変わります(Musil らの総説[参考資料9]、Damewood らの総説[参考資料10]を参照)
- 数値実験:第5〜7章の計算は合成データです。実在の材料での偏りや欠損の影響の大きさは、示していません
- 決定木に基づく手法と桁の違い:桁の違いに強い手法があることは、本稿では一次情報を確認していません
- 規格の本文:ISO/IEC 5259、ISO 5725-1、JCGM 100 の本文の要求事項は、本稿では確認していません(題名・発行年月・定義の引用にとどめています)
- MIに特化したデータ品質の標準:確認できませんでした(第11章)
- 記述子は、材料を数字で表した「名刺」です。組成、構造、つくり方のどこから作るかで種類が分かれます。組成の名刺は、化学式だけから作れます(例:LiFePO₄ の平均の電気陰性度 2.68、範囲 2.46)本稿の計算
- まず、実験ノートを「1行1試料」の表にします。単位、日付、ロット、失敗の理由を残します
- 桁をそろえる(標準化):合成データで、そろえないと誤差が0.83、そろえると0.24でした本稿の計算
- 欠損の理由を残す:検出下限未満が欠けると、測れた点だけの平均は0.60(真の値0.00)に偏り、傾きは1.00から0.82にゆるむ例でした本稿の計算
- データの偏りは、外で当たらないモデルを作ります:人の選択の偏り(アミンの17%が化合物の79%)も報告されています事実
- 失敗データは、成功の境界を教えます:失敗した反応の記録を学習に使うと、人の直感より高い精度で予測できた例があります事実
11. 評価・標準の読み方
記述子とデータの良し悪しは、直接は測れません。多くの場合、その名刺とデータで学習したモデルの性能(誤差、データの分け方)を通して、間接的に測ります。ものさしの読み方は、次のとおりです。①誤差(MAE、RMSE)は、測定のばらつき(再現性)と比べる。②分割の仕方(ランダムか、組成やロットで分けたか)で、数字が変わる。③ベンチマークは、共通のデータで手法を比べる。④データの質は、データの品質に関する国際規格や、測定の不確かさの標準で、考え方が整理されている。ここでは、確認できた範囲を表にします(確認日 2026年10月22日)。MIに特化した記述子・データ品質の標準は、確認できませんでした。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST・国際的な原則など) | 読み方の注意 |
|---|---|---|---|
| 記述子を含む予測の精度 | Matbench:13課題(312〜13.2万件、10のDFT・実験データ源)。組成と結晶構造などから特性を予測する課題。Dunn ら(2020)[参考資料21]事実 | 確認できなかった(MIに特化した記述子の標準は確認できず) | 課題ごとに入力(組成のみ/構造あり)と分割が違う。ランダム分割は新しい材料への当たりを過大に見せることがある |
| データの共有と再利用 | —(評価ではなく原則) | FAIR原則(Wilkinson ら、2016):データを、見つけやすく、アクセスでき、相互運用でき、再利用できるようにする15の原則[参考資料20]事実 | 原則であって、標準規格ではない。「豊かなメタデータ(条件・単位・ロット)を付ける」考え方は、第4章の表と共通する(本記事による解説) |
| 学習データの品質 | 確認できなかった(材料データの品質を測る共通ベンチマークは確認していない) | ISO/IEC 5259-1:2024(データ品質の概要・用語・例)[参考資料23]、ISO/IEC 5259-3:2024(データ品質マネジメントの要求事項と指針)[参考資料24](いずれも2024年7月)事実 | 分析・機械学習一般のデータ品質の規格。材料分野の具体的な基準は定めていない。本文は未確認 |
| 測定の正確さ(真度と精度) | OQMD の例:実験どうしの平均絶対誤差 0.082 eV/原子(Kirklin ら、2015)[参考資料16]事実 | ISO 5725-1:2023(測定方法と結果の正確さ〔真度と精度〕― 第1部:一般原則と定義、2023年7月)[参考資料25]事実 | 規格は、試験方法を比べる枠組みの用語と原則。本文は未確認。ばらつきの具体的な値は、自社の測定で求める |
| 測定の不確かさの表し方 | — | JCGM 100:2008(GUM:測定の不確かさの表現の指針、2008年9月)[参考資料26]事実 | 「不確かさ」の国際的な定義と評価の考え方。予測モデルの不確かさ(第5編)とは別の概念である点に注意 |
| データ漏れ・前処理の落とし穴 | Kapoor と Narayanan(2023):漏れの型の整理と、17分野・少なくとも294本の論文への影響の報告[参考資料22]事実 | 確認できなかった | 標準化や補完も、訓練データだけで学ぶ。分割の単位(試料・ロット)を決めてから前処理する |
表の整理は本稿の計算(整理)。ISO/IEC・ISO の番号・題名・発行年月は ISO の公式ページで確認(確認日 2026年10月22日)。規格本文は有料のため、題名と発行年月の確認にとどめ、要求事項は書いていません。
読み方の注意(素材技術者向け)
- モデルの数字は、データの質を超えません:測定のばらつき、欠損、偏りが大きいデータでは、どんなモデルでも限界があります。誤差は、測定のばらつきと比べて読んでください
- ベンチマークの順位と、自社の材料での実力は別です:Matbench のような公開のデータの結果は、自社の名刺・自社のデータとは条件が違います
- 分割の落とし穴:同じ試料・同じロットの繰り返しが、訓練と評価にまたがると、数字が過大になります。前処理(標準化、補完、項目の選択)も、訓練データだけで行ってください
- 原則・規格は、多くが推奨です:FAIR原則は、法的な拘束力のない指針です。ISO/IEC の規格は、法令や契約で引用されて初めて拘束力を持つのが一般的です(本記事による解説)。「準拠」と書かれていたら、どの文書のどの要求事項かを確認してください
12. 用語集
- 記述子(フィンガープリント)
- 材料を数字で表した「名刺」。組成・構造・つくり方を数値の列にしたもの。
- 特徴量/説明変数/属性
- 記述子と同じ意味で使われる呼び方。
- 機械学習
- 過去のデータから傾向を学ぶ近似器。データの外(外挿)は苦手。
- 組成の記述子
- 化学式(元素と割合)から作る記述子。例:電気陰性度の平均と範囲。
- 構造の記述子
- 原子の位置や周りの環境から作る記述子。回転などで値が変わらない必要がある。
- プロセスの記述子
- 温度・時間・雰囲気・ロットなど、つくり方を数値やカテゴリにしたもの。
- 電気陰性度
- 原子が電子を引きつける強さの目安。元素ごとの値がある。
- 1行1試料の表
- 1行に1つの試料、1列に1つの項目を入れた表。機械が読める形。
- ロット
- 同じ条件・同じ時期に作られた原料や試料のまとまり。ばらつきの要因になる。
- 標準化
- 各項目から平均を引き、ばらつきの大きさで割って、桁をそろえる処理。
- 欠損
- 表の空欄。測っていない、測れなかった、失敗した、などの理由がある。
- 検出下限
- 装置が確実に測れる最も小さい値。これ未満は「測れない」。
- 補完(imputation)
- 欠損を、既知の部分から推定して埋めること。
- 外れ値
- 他と大きく離れた値。入力ミスか本当の現象かを確認する。
- 近傍法
- 最も近い過去の試料の値から予測する単純な方法。
- 外挿
- 学習データの範囲の外での予測。当たりにくい。
- 過学習
- 偶然の揺らぎまで覚え、新しいデータで外れる状態。
- データ漏れ(リーケージ)
- 評価に使うべき情報が学習に入り込み、評価が過大になること。
- 測定の不確かさ
- 測定結果に合理的に帰せられる値の散らばりを表す量(GUMの定義)。
- FAIR原則
- データを、見つけやすく、アクセスでき、相互運用でき、再利用できるようにする15の原則。
- ベンチマーク
- 手法を比べるための共通の課題とデータ、指標。
13. 参考資料(一次情報)
- Ramprasad R. ほか "Machine learning in materials informatics: recent applications and prospects", npj Comput. Mater. 3, 54 (2017), DOI 10.1038/s41524-017-0056-5 — doi.org/10.1038/s41524-017-0056-5
- Ghiringhelli L. M. ほか "Big Data of Materials Science: Critical Role of the Descriptor", Phys. Rev. Lett. 114, 105503 (2015), DOI 10.1103/PhysRevLett.114.105503 — doi.org/10.1103/PhysRevLett.114.105503
- Ward L. ほか "A general-purpose machine learning framework for predicting properties of inorganic materials", npj Comput. Mater. 2, 16028 (2016), DOI 10.1038/npjcompumats.2016.28(オープンアクセス) — doi.org/10.1038/npjcompumats.2016.28
- Ward L. ほか "Matminer: An open source toolkit for materials data mining", Comput. Mater. Sci. 152, 60–69 (2018), DOI 10.1016/j.commatsci.2018.05.018 — doi.org/10.1016/j.commatsci.2018.05.018
- Rupp M. ほか "Fast and Accurate Modeling of Molecular Atomization Energies with Machine Learning", Phys. Rev. Lett. 108, 058301 (2012), DOI 10.1103/PhysRevLett.108.058301 — doi.org/10.1103/PhysRevLett.108.058301
- Bartók A. P., Kondor R., Csányi G. "On representing chemical environments", Phys. Rev. B 87, 184115 (2013), DOI 10.1103/PhysRevB.87.184115 — doi.org/10.1103/PhysRevB.87.184115
- Behler J., Parrinello M. "Generalized Neural-Network Representation of High-Dimensional Potential-Energy Surfaces", Phys. Rev. Lett. 98, 146401 (2007), DOI 10.1103/PhysRevLett.98.146401 — doi.org/10.1103/PhysRevLett.98.146401
- Rogers D., Hahn M. "Extended-Connectivity Fingerprints", J. Chem. Inf. Model. 50, 742–754 (2010), DOI 10.1021/ci100050t — doi.org/10.1021/ci100050t
- Musil F. ほか "Physics-Inspired Structural Representations for Molecules and Materials", Chem. Rev. 121, 9759–9815 (2021), DOI 10.1021/acs.chemrev.1c00021 — doi.org/10.1021/acs.chemrev.1c00021
- Damewood J. ほか "Representations of Materials for Machine Learning", Annu. Rev. Mater. Res. 53, 399–426 (2023), DOI 10.1146/annurev-matsci-080921-085947 — doi.org/10.1146/annurev-matsci-080921-085947
- Ouyang R. ほか "SISSO: A compressed-sensing method for identifying the best low-dimensional descriptor in an immensity of offered candidates", Phys. Rev. Mater. 2, 083802 (2018), DOI 10.1103/PhysRevMaterials.2.083802 — doi.org/10.1103/PhysRevMaterials.2.083802
- Raccuglia P. ほか "Machine-learning-assisted materials discovery using failed experiments", Nature 533, 73–76 (2016), DOI 10.1038/nature17439 — doi.org/10.1038/nature17439
- Jia X. ほか "Anthropogenic biases in chemical reaction data hinder exploratory inorganic synthesis", Nature 573, 251–255 (2019), DOI 10.1038/s41586-019-1540-5 — doi.org/10.1038/s41586-019-1540-5
- Kononova O. ほか "Text-mined dataset of inorganic materials synthesis recipes", Sci. Data 6, 203 (2019), DOI 10.1038/s41597-019-0224-1(オープンアクセス) — doi.org/10.1038/s41597-019-0224-1
- Li K. ほか "Exploiting redundancy in large materials datasets for efficient machine learning with less data", Nat. Commun. 14, 7283 (2023), DOI 10.1038/s41467-023-42992-y(オープンアクセス) — doi.org/10.1038/s41467-023-42992-y
- Kirklin S. ほか "The Open Quantum Materials Database (OQMD): assessing the accuracy of DFT formation energies", npj Comput. Mater. 1, 15010 (2015), DOI 10.1038/npjcompumats.2015.10(オープンアクセス) — doi.org/10.1038/npjcompumats.2015.10
- scikit-learn User Guide "Preprocessing data" — scikit-learn.org/stable/modules/preprocessing.html
- scikit-learn User Guide "Imputation of missing values" — scikit-learn.org/stable/modules/impute.html
- PubChem(NIH 国立医学図書館) "Periodic Table of Elements"(元素の性質の表。本稿は REST API の元素データを使用) — pubchem.ncbi.nlm.nih.gov/periodic-table/
- Wilkinson M. D. ほか "The FAIR Guiding Principles for scientific data management and stewardship", Sci. Data 3, 160018 (2016), DOI 10.1038/sdata.2016.18(オープンアクセス) — doi.org/10.1038/sdata.2016.18
- Dunn A. ほか "Benchmarking materials property prediction methods: the Matbench test set and Automatminer reference algorithm", npj Comput. Mater. 6, 138 (2020), DOI 10.1038/s41524-020-00406-3(オープンアクセス) — doi.org/10.1038/s41524-020-00406-3
- Kapoor S., Narayanan A. "Leakage and the reproducibility crisis in machine-learning-based science", Patterns 4, 100804 (2023), DOI 10.1016/j.patter.2023.100804(オープンアクセス) — doi.org/10.1016/j.patter.2023.100804
- ISO/IEC "ISO/IEC 5259-1:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 1: Overview, terminology, and examples"(ISO のページ) — iso.org/standard/81088.html
- ISO/IEC "ISO/IEC 5259-3:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 3: Data quality management requirements and guidelines"(ISO のページ) — iso.org/standard/81092.html
- ISO "ISO 5725-1:2023 Accuracy (trueness and precision) of measurement methods and results — Part 1: General principles and definitions"(ISO のページ) — iso.org/standard/69418.html
- JCGM "JCGM 100:2008 Evaluation of measurement data — Guide to the expression of uncertainty in measurement (GUM)"(BIPM 公開の PDF) — bipm.org/documents/…/JCGM_100_2008_E.pdf
- Ling J. ほか "High-Dimensional Materials and Process Optimization Using Data-Driven Experimental Design with Well-Calibrated Uncertainty Estimates", Integr. Mater. Manuf. Innov. 6, 207–217 (2017), DOI 10.1007/s40192-017-0098-z — doi.org/10.1007/s40192-017-0098-z
14. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 予測が、材料を数値の組(フィンガープリント/記述子)で表し、学習した対応づけで特性に結ぶ形で行われること。記述子が応用に応じて種類と規模をとること | Ramprasad ら(2017)の要旨 出典1 https://doi.org/10.1038/s41524-017-0056-5 | 事実 |
| 記述子の選択が「ほとんど黙って、問い直されない段階」であること。記述子と特性の仕組みの間のつながりが不明だと、学習した関係の因果が不確かになること。適切な記述子の要件を論じ、古典的な例(閃亜鉛鉱型またはウルツ鉱型と、岩塩型の半導体のエネルギー差)で意味のある記述子を見つける方法を示したこと | Ghiringhelli ら(2015)の要旨 出典2 https://doi.org/10.1103/PhysRevLett.114.105503 | 事実 |
| Ward らの枠組みが145個の属性を使うこと。元素の性質の統計量が、22種の元素の性質の平均、平均絶対偏差、範囲、最小、最大、最頻値であること | Ward ら(2016)の本文 出典3 https://doi.org/10.1038/npjcompumats.2016.28 | 事実 |
| matminer が47の特徴量抽出クラスをもち、数千の記述子を生成できるソフトウェアであること | Ward ら(2018)の要旨 出典4 https://doi.org/10.1016/j.commatsci.2018.05.018 | 事実 |
| 核の電荷と原子の位置だけを入力に、有機分子の原子化エネルギーを予測する機械学習の模型を提案したこと | Rupp ら(2012)の要旨 出典5 https://doi.org/10.1103/PhysRevLett.108.058301 | 事実 |
| 原子の周りの環境の記述子が、微分可能で、回転・反転・平行移動・同種原子の入れ替えに対して不変である必要があること。SOAP を提案したこと | Bartók ら(2013)の要旨 出典6 https://doi.org/10.1103/PhysRevB.87.184115 | 事実 |
| ECFP が、構造と活性の関係のモデリング用に開発された円形の指紋であること。計算が速いこと、部分構造の有無を表し解釈しやすいこと | Rogers と Hahn(2010)の要旨 出典8 https://doi.org/10.1021/ci100050t | 事実 |
| 構造の表現と、材料の表現(画像・スペクトルなど)を扱う総説であること | Musil ら(2021)、Damewood ら(2023)の要旨 出典9 https://doi.org/10.1021/acs.chemrev.1c00021 出典10 https://doi.org/10.1146/annurev-matsci-080921-085947 | 事実 |
| SISSO が膨大な候補から少数の最良の記述子を選ぶ圧縮センシングの方法で、小さな学習データでも安定した結果が得られること | Ouyang ら(2018)の要旨 出典11 https://doi.org/10.1103/PhysRevMaterials.2.083802 | 事実 |
| 失敗した反応の記録を学習に使った機械学習が、人の直感より高い精度で成否を予測したこと。失敗した反応は反応条件の限界についての貴重な情報をもつが、ほとんど報告されないこと | Raccuglia ら(2016)のページの説明 出典12 https://doi.org/10.1038/nature17439 | 事実 |
| アミンの選択がべき乗則の分布に従い、17%のアミンが報告された化合物の79%に使われること。548件の無作為の実験で、反応物の人気や条件の選び方が成否と相関しないこと。小さな無作為データで学習したモデルが大きな人が選んだデータのモデルを上回ったこと | Jia ら(2019)の要旨 出典13 https://doi.org/10.1038/s41586-019-1540-5 | 事実 |
| 固相合成の19,488件のレシピを、53,538の段落から文章処理で取り出して公開データセットにしたこと | Kononova ら(2019)の要旨 出典14 https://doi.org/10.1038/s41597-019-0224-1 | 事実 |
| データの最大95%を除いても分布内の予測性能がほとんど変わらないこと。除けたデータは過剰に多い材料タイプに関連し、分布外の悪化は防げないこと | Li ら(2023)の要旨 出典15 https://doi.org/10.1038/s41467-023-42992-y | 事実 |
| 実験どうしの生成エネルギーの平均絶対誤差 0.082 eV/原子。DFT と実測の差 0.096 eV/原子 | Kirklin ら(2015)の要旨 出典16 https://doi.org/10.1038/npjcompumats.2015.10 | 事実 |
| 多くの推定器が、特徴量が標準正規分布のデータに似ていないとうまく動かないことがあること。欠損のある行や列を捨てる基本の方法と、補完の方法の説明 | scikit-learn のユーザーガイド 出典17 https://scikit-learn.org/stable/modules/preprocessing.html 出典18 https://scikit-learn.org/stable/modules/impute.html | 事実 |
| LiFePO₄ の元素の電気陰性度(Li 0.98、Fe 1.83、P 2.19、O 3.44)ほか、BaTiO₃・NaCl・MgO の元素の値と原子量 | PubChem の周期表のデータ(REST API、確認日 2026年10月22日)。尺度名は確認できなかった 出典19 https://pubchem.ncbi.nlm.nih.gov/periodic-table/ | 事実 |
| FAIR原則が15の原則で、見つけやすさ・アクセス・相互運用・再利用を扱うこと | Wilkinson ら(2016) 出典20 https://doi.org/10.1038/sdata.2016.18 | 事実 |
| Matbench が13課題(312〜13.2万件、10のDFT・実験データ源)で、組成や結晶構造から特性を予測する課題を含むこと | Dunn ら(2020)の要旨 出典21 https://doi.org/10.1038/s41524-020-00406-3 | 事実 |
| データ漏れが17分野・少なくとも294本の論文に影響したこと、漏れの型(前処理を訓練とテストにまたがって行う、など) | Kapoor と Narayanan(2023) 出典22 https://doi.org/10.1016/j.patter.2023.100804 | 事実 |
| ISO/IEC 5259-1:2024、5259-3:2024(いずれも2024年7月)、ISO 5725-1:2023(2023年7月)の番号・題名・発行年月 | ISO のページ(確認日 2026年10月22日) 出典23 https://www.iso.org/standard/81088.html 出典24 https://www.iso.org/standard/81092.html 出典25 https://www.iso.org/standard/69418.html | 事実 |
| JCGM 100:2008(GUM、2008年9月)の題名と、測定の不確かさの定義 | BIPM 公開の PDF(確認日 2026年10月22日) 出典26 https://www.bipm.org/documents/20126/2071204/JCGM_100_2008_E.pdf/cb0ef43f-baa5-11cf-3f85-4dcd86f77bd6?version=1.24&t=1775224054694&download=true | 事実 |
| 組成とプロセスの両方を扱う最適化のため、実験を設計する枠組みを報告したこと | Ling ら(2017)の要旨 出典27 https://doi.org/10.1007/s40192-017-0098-z | 事実 |
| LiFePO₄ ほか4化合物の名刺の値(平均・範囲)、標準化前後の誤差(0.83、0.24)、欠損の例(平均 0.60、傾き 0.82)、範囲の外での誤差(12.6、0.98) | 本稿の計算(Python・NumPy。元素の値は PubChem、数値実験は合成データで乱数の種を固定)。実在の材料のデータの結果ではない | 本稿の計算 |
| PubChem の電気陰性度の尺度名、記述子の優劣の比較、決定木系の手法と桁の違い、MIに特化したデータ品質の標準、ISO 規格の本文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「名刺」のたとえ、データの質のチェック項目、各「素材技術者の視点」、記述子を選ぶ4つの点、プロセス記述子の例 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図が実データの観察ではなく、説明のための作図であること。ヒーロー画像と図5がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月22日/出典は一次情報(査読論文、scikit-learn・PubChem・ISO・BIPM の公式ページ)に限定しています。ISO の規格の本文は有料のため確認できていません。 第5〜7章の数値実験は本稿が作った合成データの計算で、実在の材料の結果ではありません。 PubChem の電気陰性度の尺度名、記述子の優劣、決定木系の手法と桁の違い、MIに特化したデータ品質の標準については、確認できなかったため記載していません。 図はすべて説明用の概念図または本稿の計算を含む作図で、ヒーロー画像と図5はImageGen生成の概念画像です。