TECHNOLOGY EXPLAINER
マテリアルインフォマティクス概論
― 「広大な地図から宝のありかを探す」ために、データと計算と実験をつなぐ
マテリアルインフォマティクス(MI)は、材料のデータと機械学習を使って、次に試す材料を絞るための考え方と道具です。ただし、AIが材料を発明してくれるわけではありません。AIや計算が出すのは「候補」で、本当にその性質があるかは、合成して測って初めて分かります。 この記事は、MIを初めて学ぶ素材技術者のために、MIとは何か、順問題と逆問題、歴史、計算・実験・AIの分担、そして今日からできることを、図と小さな計算で順に説明します。シリーズ全体で使う「たとえ」と「言葉」の土台も、ここで作ります。
- 3行でわかる/読む前に/シリーズの中での位置
- 材料探索は「広大な地図」の宝探し
- マテリアルインフォマティクス(MI)とは何か
- 順問題と逆問題
- 計算・実験・AIの役割分担
- MIの基本の流れ
- どれくらい効くのか ― 絞り込みの効果
- 歴史と、「AIが新材料を発見」の読み方
- 素材技術者が今日からできること
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・目標など、まだ確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。
図に出てくる「絞り込みの効果」(第7章)は、本稿が作った合成データの計算です。実在の材料や製品の性能を示すものではありません。また、この記事は市場規模の推計を使いません。「AIが新材料を発見した」という主張は、誰が、何を基準に言っているのかを分けて読みます(第8章)。ISO/IEC の規格は、番号・題名・発行年月の確認にとどめ、本文は確認していません。
1. 3行でわかる/読む前に/シリーズの中での位置
- MIは「次に試す材料を絞る道具」:材料の組成・構造・つくり方を数字に直し(記述子)、過去のデータから機械学習で傾向を学び、探す場所を絞ります。材料から特性を予測する「順問題」と、望む特性から材料を探す「逆問題」の両方を扱います
- 計算・実験・AIの分担:計算(DFTなど)は「安く速く候補を出し」、実験は「本当にそうか確かめ」、AIは「探す場所を絞る」。3者はデータでつながる循環です
- いちばん大事な1点:予測や計算上の安定性は、「候補」であって「発見」ではありません。合成して、測って、再現できて、初めて材料の性質として扱えます
化学・材料・プロセスの基本的な知識があれば十分です。機械学習やプログラミングの知識は要りません。新しい言葉は、出てきたところで短く説明します。数式はほとんど使わず、使うときは文章で意味を説明し、数値の例で確かめます。分からなくなったら、第12章の用語集に戻ってください。
これは、本シリーズ「マテリアルインフォマティクス」の入口の記事です。ここで、シリーズ共通の言葉とたとえを作ります。次の編で、「材料データと記述子」「材料データベースとFAIR原則」「小データ機械学習」「不確かさと適用範囲」を順に扱います。その先の、グラフニューラルネットワーク、ベイズ最適化、機械学習原子間ポテンシャル、自律実験室などは、それぞれの編で詳しく扱います。各編は、単独でも読めるように書いています。
2. 材料探索は「広大な地図」の宝探し
(1) たとえ:宝のありかを探す
新しい材料を探す仕事を、広大な地図の中から宝のありかを探すことにたとえます。地図は、材料の候補の全体です。宝は、ほしい性質をもつ材料です。1か所を掘ること(1回の合成と測定)には、時間も費用もかかります。地図が広すぎて、全部は掘れません。
では、地図はどれくらい広いのでしょうか。Davies らは、周期表の最初の103元素から4成分の化合物をつくる組合せは、元素の割合まで数えると1兆(1012)通りを超えると見積もりました。そこから、価数と電気陰性度(原子が電子を引きつける強さの目安)で、化学的にありえない組成を除くと、約100億(1010)通りになる、としています事実[参考資料4]。
100億通りがどれくらいかを、感覚でつかむために、1日1件のペースで全部を試したとして、単純に割り算をします。1010 ÷ 365.25 ≒ 2,700万年です(本稿の計算)。1時間に1件を休みなく試しても約110万年、1日に1,000件を試せる高スループット実験(多数の試料を並行して作り、測る方法)でも、約2.7万年かかります。図2の右側のとおりです。
本稿の計算。1010 通りという数字は Davies らの見積り[参考資料4]で、割り算は本稿です。合成や測定の成功率、人手、装置の台数は考えていない、桁をつかむための計算です。
100億という数は、「元素の組合せと割合」を数えた見積りで、実在する材料の数ではありません。また、実際の材料では、どの組成かだけでなく、どうつくるか(温度、時間、雰囲気、原料の純度)でも性質が変わります。つまり、地図には「場所」のほかに「掘り方」という次元もあります。このシリーズで「探す場所」と書くときは、組成・構造・つくり方を合わせた条件の空間を指します(本記事による解説)。
(2) 時間:新しい材料が使われるまで10〜20年
もう一つの壁は、時間です。米国の国家科学技術会議が2011年6月に出した「Materials Genome Initiative(MGI)」の白書は、新しい種類の材料が初めて使われるまでに、典型的におよそ10〜20年かかると述べています。例として、リチウムイオン電池が、研究室の概念として提案された1970年代半ばから、広く使われた1990年代後半まで、20年かかったことを挙げています事実[参考資料1]。現在の MGI のサイトは、「発見から市場まで、20年以上かかりうる」と説明しています事実[参考資料3]。
白書は、遅い理由の一つに、材料の研究開発が、経験的な勘と試行錯誤の実験に頼り続けていることを挙げています。また、材料が市場に出るまでの7つの段階を、別々のチームが別々の組織で担い、段階の間でフィードバックが少ないことも挙げています[参考資料1]。そのうえで、MGI は「先進材料を、現在より少なくとも2倍の速さで、費用はごく一部で、発見・開発・製造・展開する」ことをめざす、としています事実[参考資料1]。これは目標であり、達成されたかどうかは別の話です(第10章)。
3. マテリアルインフォマティクス(MI)とは何か
マテリアルインフォマティクス(MI:materials informatics)は、材料科学の知識と、データを扱う情報科学を組み合わせて、材料の研究開発を速くする考え方です。Ramprasad らの総説は、MI の中心にある手法を、次のように説明しています。過去のデータだけから素早く予測する「代理の模型(サロゲートモデル)」を、機械学習でつくる。多くの場合、材料をまず数値の組(フィンガープリント、本シリーズでは記述子)で表し、それと目的の特性を、学習した対応づけで結びつける事実[参考資料5]。
ここで出てきた3つの言葉を、シリーズ共通の言い方で整理します。
- 機械学習=過去のデータから傾向を学ぶ近似器。入力と出力の関係を、データに合わせて数式の形で当てはめます。たとえの限界:データの範囲の外(外挿)は苦手で、物理法則を理解しているわけではありません
- 記述子=材料を数字で表した「名刺」。組成、構造、つくり方を、機械が読める数値に直したものです(次の編「材料データと記述子」で詳しく扱います)
- DFT(密度汎関数理論)=電子の振る舞いから材料の性質を計算する物理シミュレーション。近似を含み、実測と一致するとは限りません(本シリーズ「量子化学・材料シミュレーション」編と「密度汎関数理論の基礎」編で扱います)
Agrawal と Choudhary は、大量のデータから材料を探す動きを、実験・理論・計算に続く「第四のパラダイム」(データ駆動の発見)の一部として論じ、MI の例を、特性を予測する「順モデル」と、材料の候補を見つける「逆モデル」に分けて紹介しています事実[参考資料6]。MI は、この考え方を材料に当てはめた分野だ、といえます(本記事による解説)。
不正確です。機械学習が行うのは、既存のデータから傾向を学び、どの候補が有望そうかを絞ることです。その候補が本当に合成でき、狙いの性質を示すかは、人と実験が確かめます。Ramprasad らも、予測は「通常は内挿的」で、新しい材料の領域へ外挿するには「予測の不確かさを適切に考慮する必要がある」と述べています[参考資料5]。「AIが○○万種の新材料を発見した」という言い方は、計算上の予測を指していることが多く、実験での確認とは別です(第8章)。
4. 順問題と逆問題
MI の問いは、向きで2つに分けられます。順問題は、「この材料(組成・構造・つくり方)なら、どんな特性になるか」を予測する問いです。逆問題は、「この特性がほしい。どんな材料にすればよいか」を提案する問いです。
元のSVG・数値・出典を確認する
元SVGの説明:概念図(ベクター作図)。左は順問題と逆問題の向き。右は、特性が山形に変わる仮の例で、目標の特性(点線)に当てはまる条件が2つあります。実際の材料では、組成・構造・つくり方の組合せで、答えがもっと多くなります。
逆問題のほうが難しいのは、答えが1つに決まらないからです。右の図のように、特性が山形に変わる材料の条件では、同じ目標の特性に2つの条件が当てはまります。実際の材料では、組成・構造・つくり方の組合せで、答えがもっと多くなることもあれば、1つもないこともあります(本記事による解説)。
Zunger は、逆設計(inverse design)を、先に望む機能を宣言し、理論計算で、その機能を示す安定で合成できる化合物を予測し、「予測→合成→評価」の循環で予測を改善していく、新しい理論と実験の協力の形として論じています事実[参考資料7]。Sanchez-Lengeling と Aspuru-Guzik は、機械学習の生成モデルで、望む性質をもつ分子を提案する「逆設計」を整理しています[参考資料8](生成モデルは、本シリーズ「生成AIによる材料設計」編で扱います)。
実務では、逆問題を、順問題の予測器で候補をたくさん評価して、目標に近いものを残すという形で使うことが多くあります(本記事による解説)。図の左下の3段階のとおりです。つまり、「望みの特性から材料が直接出てくる」わけではなく、「たくさんの候補を安く評価して、絞る」のです。絞った後に、合成して測ることは省けません。
5. 計算・実験・AIの役割分担
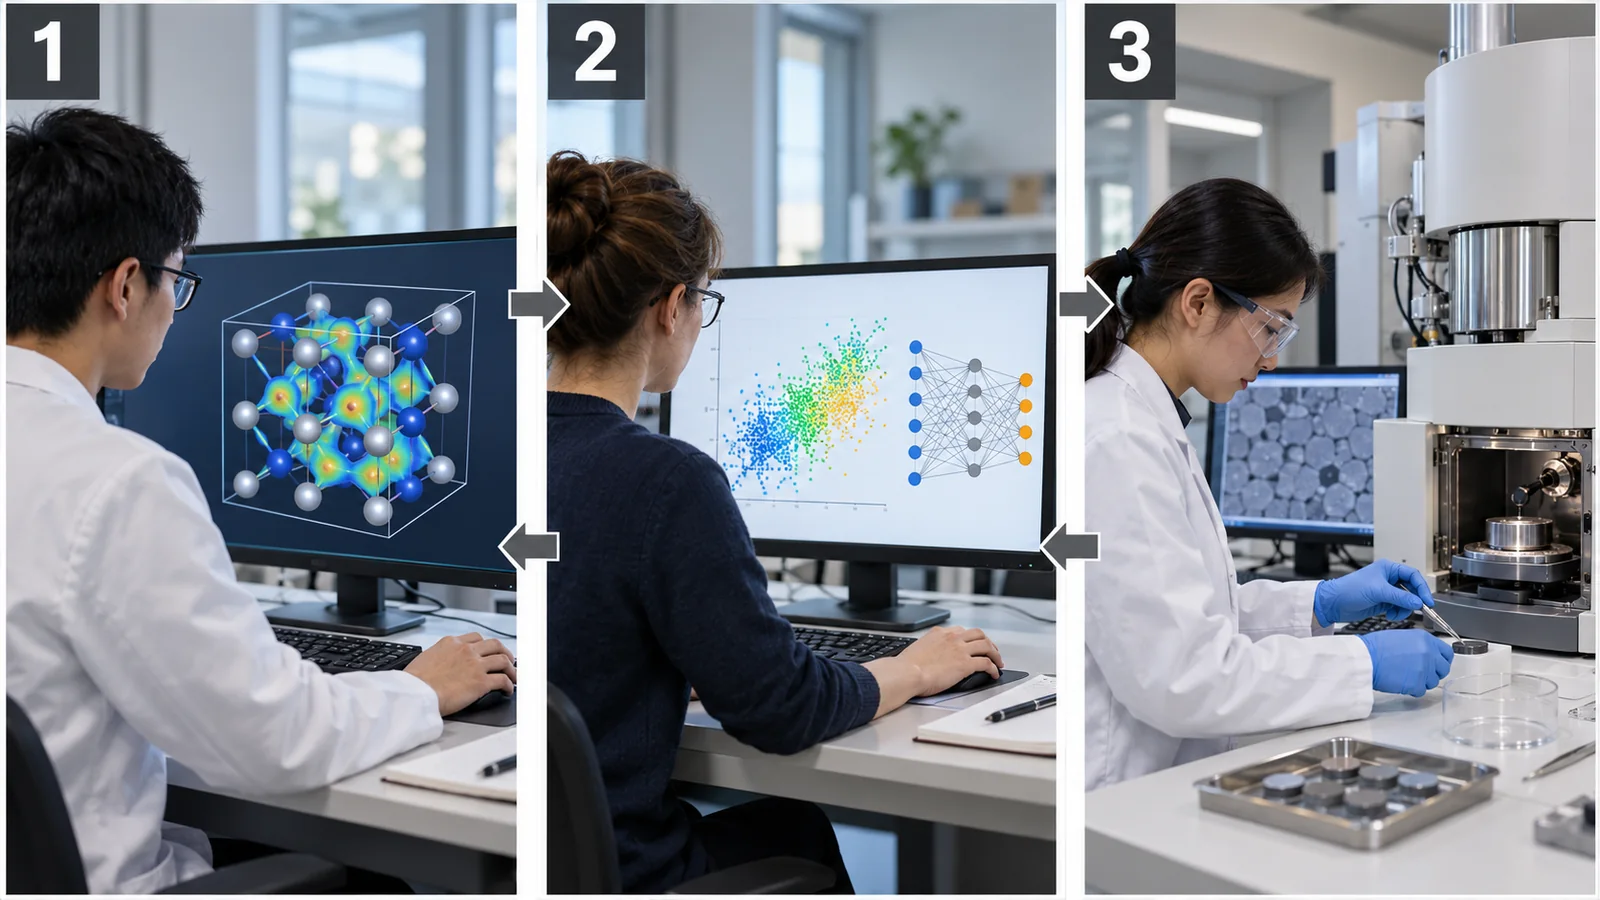
MIは、AIだけで成り立つものではありません。計算、実験、AIの3つが、それぞれの得意なところを受け持ちます。
元のSVG・数値・出典を確認する
元SVGの説明:概念図(ベクター作図)。計算・実験・AI の役割分担。矢印は、候補とデータが行き来する向きを示す本稿の整理で、特定の研究室の構成ではありません。
| 役割 | 得意なこと | 弱いところ | 素材分野での例(解説) |
|---|---|---|---|
| 計算(DFTなど) | 実験より安く速く、多数の候補の性質を見積もる | 近似を含む。実測と一致するとは限らない | 結晶の安定性、電子の状態、エネルギーの計算 |
| 実験(合成・測定) | 本当にそうなるかを、現実の試料で確かめる | 時間と費用がかかり、件数が限られる。ばらつきもある | 合成、成形、測定、耐久試験 |
| AI(機械学習) | 過去のデータから傾向を学び、探す場所を絞る | データの範囲の外は苦手。理由の説明が難しいことがある | 次に試す候補の順位づけ、計算の代わりの高速な予測 |
表の整理は本記事による解説です。各行は一般的な傾向で、すべての手法に当てはまるとは限りません。
「計算は実測と一致するとは限らない」を、数字で見てみます。OQMD(Open Quantum Materials Database)の論文は、DFT で計算した化合物の生成エネルギー(化合物が単体から生じるときのエネルギーの変化)と、実測の値を、1,670個の化合物で比べています。その平均絶対誤差は0.096 eV/原子でした。そして、実験どうし(同じ化合物を測った別の報告)の間の平均絶対誤差も0.082 eV/原子と、「驚くほど大きい」ことが分かり、計算と実測の差の相当な部分は、実験側の不確かさに由来するかもしれない、と論じています事実[参考資料9]。
MI で、素材技術者がいちばん価値を出せるのは、実験の質です。AIも計算も、学習や検証に使う「正しいデータ」は、結局、実験から来ます。上の OQMD の例が示すように、実験どうしでも、0.08 eV/原子ほどの違いが出ることがあります(化合物の生成エネルギーの場合)。同じ試料を繰り返し測ったときのばらつき、ロットの違い、装置や測定者の違いを把握していないと、モデルが当たったのか外れたのかも、判断できません(本記事による解説)。
「計算はAIに任せ、実験は人が計画する」のではなく、何を計算に、何をAIに、何を実験に任せるかを、材料と目的ごとに決めるのが、これからの素材技術者の仕事になります。
6. MIの基本の流れ
MIの仕事は、おおよそ6つの段階に分けられます。順番に、何をするかを短く説明します。図6は、各段階を、本シリーズのどの編で詳しく扱うかも示しています。
- 目的を決める:どの特性を、どの範囲で、どれくらいの精度で、いつまでに知りたいのかを、1行で書きます。目的があいまいだと、あとの段階が決まりません
- データを集める:自社の実験ノートや測定データ、公開されているデータベース(本シリーズ「材料データベースとFAIR原則」編)から集めます
- 数字にする:材料を記述子(名刺)に直します。表に1行ずつ並べます(「材料データと記述子」編)
- モデルを作る:データから傾向を学ぶ予測器をつくります。材料のデータは少ないことが多く、過学習(偶然の揺らぎまで覚えてしまうこと)に注意が要ります(「小データ機械学習」編)
- 予測と不確かさ:予測値だけでなく、「その予測がどれくらい信用できるか」を一緒に見ます(「不確かさと適用範囲」編)
- 実験で確かめる:予測で絞った候補を合成・測定します。結果は新しいデータとして②に戻ります(「ベイズ最適化と能動学習」編、「自律実験室」編)
7. どれくらい効くのか ― 絞り込みの効果
「探す場所を絞る」と、どれくらい得をするのでしょうか。小さな数値実験で確かめます(本稿の計算)。
- 設定:候補が10,000件あり、その中の本当に良いもの(真の特性が上位1%、つまり100件)を「当たり」とします。実験できるのは100件だけです
- 無作為に100件選ぶと:当たりの期待値は、100 × 1% = 1件です
- 予測で絞ると:予測器が、各候補に点数をつけます。この点数と真の値の相関を ρ(ロー)とします。ρ は、0〜1の数で、1に近いほど、点数の並び方が真の値の並び方に近いことを表します。点数の上位100件を選び、当たりがいくつ入るかを数えます(500回の平均)
結果は、図7のとおりです。予測が全く役に立たない ρ = 0 では、当たりは約1.1件で、無作為と同じです。ρ = 0.5 では約12.9件、ρ = 0.9 では約54.2件に増えます。実験できる件数を20件に絞ると、無作為の期待値は0.2件で、ρ = 0.5 なら約3.9件、ρ = 0.9 なら約17.1件になります。
本稿の計算。合成データ(真の特性は正規分布、予測の点数は真の値と相関ρをもつ乱数)。実在の材料のデータではありません。「予測の質が新しい候補でも同じ ρ で保たれる」という仮定の上の計算です。
ほしいのは、上位にいるものを見つけることで、全部の値を正確に当てることではありません。順位が大まかに合っていれば、上位に当たりが集まります。実際の研究でも、同じ傾向が報告されています。Ling らは、組成・プロセス条件の最適化で、機械学習のモデルが提案する実験を使うと、無作為に選ぶ場合の平均3分の1の測定回数で最適な候補が見つかった、と報告しています(4つの材料科学の試験事例での結果)事実[参考資料10]。
ただし、この数値実験は、予測の質が新しい候補でも保たれると仮定しています。これは、データの範囲の外では成り立たないことがあります。第5編「不確かさと適用範囲」で扱います。
誤りです。Li らは、複数の大きな材料データセットで、データの最大95%を学習から除いても、学習したデータと同じ範囲の材料(分布内)の予測性能はほとんど変わらないことを示しました。除けたデータは、数が多すぎる材料タイプに偏っていて、学習の範囲の外(分布外)の予測の悪化は防げませんでした事実[参考資料11]。大事なのは、データの量だけでなく、質、偏り、分け方、情報の豊かさです。本シリーズ「材料データと記述子」編と「小データ機械学習」編で扱います。
8. 歴史と、「AIが新材料を発見」の読み方
MIの歴史を、本稿が論文や公式文書で確認できた範囲で、年表にします(図8)。
年表から、3つの流れが読み取れます(本記事による解説)。① 政策:2011年の MGI が、データ共有と計算を材料開発の柱に据えました。2021年の戦略計画は、「Materials Innovation Infrastructure の統一」「材料データの活用」「人材の育成」の3つを今後5年の目標にしています[参考資料2]。② データ基盤:2012〜13年に、AFLOW[参考資料16]、Materials Project[参考資料17]、OQMD[参考資料18]が公開され、DFT で計算した材料データが使えるようになりました(本シリーズ「材料データベースとFAIR原則」編)。③ 評価:2020年以降、Matbench[参考資料22]や Matbench Discovery[参考資料23]のように、手法を共通の条件で比べる枠組みが整いつつあります(第11章)。
(1) 事例:「220万構造」をどう読むか
「AIが新材料を発見した」と報じられる研究の例として、Merchant らの GNoME(Graph Networks for Materials Exploration)があります。論文の要旨は、大規模に学習したグラフニューラルネットワーク(原子のつながりを入力にするAI)が、既知の安定な結晶に対する凸包(エネルギー的な安定性の境界)より下に位置する220万構造の発見を可能にした、と述べています。同じ要旨は、そのうち736件はすでに独立に実験で実現されているとも書いています事実[参考資料12]。
一方、Cheetham と Seshadri は、この論文の主張を検討し、「新規性、信頼性、有用性の3つを満たす化合物の証拠が乏しい」と指摘する論考を、Chemistry of Materials に発表しています。同時に、方法自体には期待が持てるとし、材料合成と結晶学の専門知識を取り込む必要がある、とも述べています事実[参考資料13]。
両方の文献が示しているのは、「予測された」「合成された」「有用と確かめられた」は、別の段階だということです。「AIが220万種の新材料を発見」は、論文の中の計算上の予測の件数です。「新材料が220万種できた」という意味ではありません。素材技術者が読むときは、次の3つを分けて確認してください(本記事による解説)。
- 予測の段階:誰が、何を基準に(どの計算で、どの安定性の定義で)「発見」と呼んでいるか
- 合成・確認の段階:実際に合成された件数、構造を確かめた方法、独立した検証があるか
- 有用性の段階:その材料が、ほしい性質を、実際の使用条件で示すか
9. 素材技術者が今日からできること
MIは、大がかりなシステムを入れなくても、自社のデータの整え方から始められます。次の6つは、素材技術者が、今日からできることです(本記事による解説)。
| やること | なぜ大事か | まず、どうするか |
|---|---|---|
| ① 目的を1行で書く | 目的があいまいだと、集めるデータも、評価の仕方も決まらない | 「どの特性を、どの範囲で、いくつ、どの精度で」を書く |
| ② 実験ノートを「1行1試料」の表にする | 機械が読めるのは表。文章や写真だけでは、数字にできない | 列に、組成、つくり方の条件、測定値、単位、日付、ロット、装置、担当を入れる |
| ③ 失敗・未達のデータも残す | 「うまくいかなかった条件」は、境界を教える貴重な情報。Raccuglia らは、失敗した反応の記録を学習に使うと、人の直感より高い精度で反応の成否を予測できたと報告している[参考資料20]事実 | 空欄にせず、「失敗」「測定下限未満」などの理由を書く |
| ④ 測定のばらつきを先に知る | モデルの誤差が、測定のばらつきより小さくなることはない。OQMD の例では、実験どうしでも0.082 eV/原子のずれがあった[参考資料9] | 同じ試料を繰り返し測り、ロット間・装置間の差も見る |
| ⑤ 単純な基準と比べる | 複雑なモデルの数字だけでは、良いかどうか分からない | 「全データの平均」「最も近い過去の試料の値」と比べる(本シリーズ「機械学習とニューラルネットワークの基礎」編) |
| ⑥ 小さく始めて、実験で確かめる | 予測は候補であって、発見ではない | 予測で絞った少数の候補を、対照(比べる基準の試料)と再現を入れて合成・測定する |
表は本記事による解説です。③のRaccuglia らの研究の対象は、バナジウムセレン酸塩の水熱合成(実験ノートの記録)で、他の材料にそのまま当てはまるとは限りません。
AIに任せやすいのは、大量の候補の「順位づけ」、測定データからの傾向の抽出、繰り返しの多い解析です。専門家の判断が要るのは、「その候補は化学的に妥当か」「合成できそうか(原料、雰囲気、温度)」「不純物や粒界、表面の影響は無視してよいか」「その特性が製品の要求に効くか」です。これらは、データにはまだ書かれていないことが多く、材料の知識が必要です。Cheetham と Seshadri も、材料合成と結晶学の専門知識を取り込む必要性を指摘しています[参考資料13]。
予測を確かめる実験は、確かめる設計にします。具体的には、①対照:既知の基準の試料を同じ条件で測る。②再現:同じ条件を複数回、別のロットでつくる。③盲検に近い形:予測を知らない人が測る(できれば)。④失敗も記録:予測が外れた条件こそ、次の学習に役立つ。予測が当たっても、1回の成功は、再現された事実ではありません。第11章の「実験での確認の読み方」も参照してください(本記事による解説)。
10. 限界と、確認できなかったこと/まとめ
(1) 確認できなかったこと
- 用語の起源:Rajan の論文『Materials informatics』(Materials Today、2005年)は書誌の確認にとどめ、本文は確認していません。この論文が用語の最初かどうかも、確認していません
- MGI の達成度:2021年の戦略計画は、MGI の方法が、「一部の用途で」先進材料の導入を加速した、と記しています[参考資料2]。2倍の速さ・費用のごく一部、という目標の全体が達成されたかは、本稿では確認していません。MGI 以外の各国の戦略は、本シリーズ「各国のMI戦略とデータ基盤」編で扱います
- 期間の数字:「10〜20年」「20年以上」は、MGI の文書の記述です[参考資料1・3]。材料や用途で大きく異なり、本稿は独自に確かめていません
- GNoME:予測された構造の新規性・有用性は、本稿では評価しません。論文[参考資料12]と論考[参考資料13]の主張を、並べて示しました
- 日本の取り組み:NIMS などの国内の動きは、本稿の確認範囲に含めていません(他編で扱います)
- 規格の本文:ISO/IEC の規格は、番号・題名・発行年月の確認にとどめ、本文は確認していません
- MIに特化した国際標準:確認できませんでした(第11章)
- 数値実験:第2・7章の計算は、単純な割り算と合成データです。実在の材料の予測の実力を示すものではありません
- MIは、材料の候補が多すぎるという壁に、「探す場所を絞る」ことで挑む考え方です。103元素の4成分の組合せは1兆通りを超え、化学的な条件で絞っても約100億通りです事実。1日1件では約2,700万年かかります本稿の計算
- 順問題は「材料→特性」、逆問題は「特性→材料」です。実務では、順問題の予測器で多数の候補を評価し、絞って実験します
- 計算は安く速く候補を出し、実験は確かめ、AIは絞ります。どれも万能ではなく、DFTと実測の差は0.096 eV/原子、実験どうしの差も0.082 eV/原子の例があります事実
- 予測は「候補」です。「予測された」「合成された」「有用と確かめられた」は別の段階で、GNoMEの例では、主張と検討の両方が公表されています事実
- 今日からできること:目的を書く、1行1試料の表にする、失敗も残す、ばらつきを知る、単純な基準と比べる、確かめる設計で実験する
11. 評価・標準の読み方
MIの良し悪しは、どんな「ものさし」で測るかで決まります。代表的なものさしは、予測の誤差(MAE:平均絶対誤差、RMSE、R²)、データの分け方(ランダムに分けたか、組成・時間で分けたか)、ベンチマーク(共通の課題での順位)、計算と実測の差、実験での確認の成功率と再現性です。 どれも、何を測っていて、何を測っていないかに注意が要ります。たとえば、予測誤差が小さくても、学習データの範囲の外で当たるとは限りません。ここでは、MIに関わるベンチマークと標準・原則を、確認できた範囲で表にします(確認日 2026年10月22日)。MIに特化した国際標準は、確認できませんでした。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST・国際的な原則など) | 読み方の注意 |
|---|---|---|---|
| 材料特性の予測精度 | Matbench:13課題。Dunn ら(2020)[参考資料22]事実 | 確認できなかった(MIに特化した国際標準は確認できず) | ランダム分割の数字は、新しい材料への当たりを過大に見せることがある(本シリーズ「機械学習とニューラルネットワークの基礎」編) |
| 安定な結晶を見つける力 | Matbench Discovery:機械学習のエネルギーモデルを、安定な結晶探索の前段の絞り込みとして評価する枠組み。回帰の指標と、探索課題に合う分類の指標のずれを指摘(Riebesell ら、2025)[参考資料23]事実 | 確認できなかった | 精度の高い回帰でも、安定性の境界(0 eV/原子)の近くでは偽陽性が増えうる |
| 手法の横断比較と再現性 | JARVIS-Leaderboard:AI、電子状態計算、力場、量子計算、実験を含む。論文時点で274のベンチマーク、1,281件の投稿(Choudhary ら、2024)[参考資料24]事実 | 確認できなかった | ベンチマークの順位と、自社の材料での実力は別。条件(データ、分割、指標)の違いを確認する |
| 計算と実測の差 | OQMD:1,670化合物の生成エネルギーで、DFT−実測の平均絶対誤差 0.096 eV/原子、実験どうし 0.082 eV/原子(Kirklin ら、2015)[参考資料9]事実 | 確認できなかった | 計算値を実測値のように扱わない。実験側のばらつきも差の原因になる |
| データの共有・再利用 | —(評価ではなく原則) | FAIR原則(Wilkinson ら、2016):見つけやすく、アクセスでき、相互運用でき、再利用できる、という15の原則[参考資料19]事実 | FAIRは原則で、標準規格ではない。データを公開(オープン)にすることとも同じではない |
| 測定の国際的な整合 | — | VAMAS(Versailles Project on Advanced Materials and Standards):整合した測定・試験・仕様・標準の技術的基盤をつくる国際共同プロジェクトを進める枠組み[参考資料25]事実 | MIに特化した標準ではない。個別の試験法の標準は、材料ごとに別に確認する |
| AIの概念と枠組み | — | ISO/IEC 22989:2022(AIの概念と用語、2022年7月)[参考資料26]、ISO/IEC 23053:2022(機械学習を使うAIシステムの枠組み、2022年6月)[参考資料27]事実 | 用語と枠組みの規格。材料の予測が「当たる」ことを保証するものではない。本文は未確認 |
| 学習データの品質 | 確認できなかった(材料データの品質を測る共通ベンチマークは確認していない) | ISO/IEC 5259-1:2024(データ品質の概要・用語・例)[参考資料28]、ISO/IEC 5259-3:2024(データ品質マネジメントの要求事項と指針)[参考資料29](いずれも2024年7月)事実 | 分析・機械学習一般のデータ品質。材料分野の具体的な品質基準は定めていない。本文は未確認 |
| リスク管理・運用 | — | ISO/IEC 42001:2023(AIのマネジメントシステム、2023年12月)[参考資料30]、NIST AI RMF 1.0(NIST AI 100-1)[参考資料31]事実 | NIST AI RMF は自主的な利用が前提。ISO/IEC 規格は、法令や契約で引用されて初めて拘束力を持つのが一般的(本記事による解説) |
| 政策の進み具合 | — | MGI 戦略計画(2021年版):3つの目標を今後5年の計画として掲げる[参考資料2]事実未確定/将来 | 計画と達成は別。達成状況は本稿では確認していない |
表の整理は本稿の計算(整理)。ISO/IEC の番号・題名・発行年月は ISO の公式ページで確認(確認日 2026年10月22日)。規格本文は有料のため、題名・発行年月の確認にとどめ、要求事項は書いていません。
読み方の注意(素材技術者向け)
- ベンチマークの順位と、自社の材料での実力は別です:ベンチマークは、特定のデータ・分割・指標での順位です。自社の材料で使うときは、自社のデータで、自社の目的に合う分け方で測り直してください
- 「予測」と「実験での確認」を区別してください:予測の誤差が小さいことと、合成して性質が確かめられたことは別です。実験での確認は、件数、成功の定義、再現、独立した検証の有無を見ます
- データ漏れと分割の落とし穴:同じ系統の試料が訓練と評価にまたがると、数字は過大になります(本シリーズ「機械学習とニューラルネットワークの基礎」編)
- 原則・標準は、多くが推奨です:FAIR原則や NIST AI RMF は、法的な拘束力のない指針です。「準拠」と書かれていたら、どの文書のどの要求事項かを確認してください
- 計画と達成は別です:MGI の目標(2倍の速さ)は、目標です。達成の証拠は、別に確認が必要です
12. 用語集
- マテリアルインフォマティクス(MI)
- 材料科学とデータ科学を組み合わせ、材料の探索・開発を速くする考え方。
- 順問題
- 材料(組成・構造・つくり方)から、特性を予測する問い。
- 逆問題(逆設計)
- 望む特性から、材料を提案する問い。答えは複数あるか、ないことがある。
- 機械学習
- 過去のデータから傾向を学ぶ近似器。データの外(外挿)は苦手。
- 記述子(フィンガープリント)
- 材料を数字で表した「名刺」。組成・構造・つくり方を数値にしたもの。
- 代理モデル(サロゲート)
- 高価な計算や実験の代わりに、過去のデータから素早く予測する模型。
- DFT(密度汎関数理論)
- 電子の振る舞いから材料の性質を計算する物理シミュレーション。近似を含む。
- 生成エネルギー
- 化合物が単体から生じるときのエネルギーの変化。安定性の目安になる。
- 凸包(コンベックスハル)
- エネルギー的に安定な組合せの境界。これより上のものは、より安定な組合せに分解しうる。
- 内挿/外挿
- 学習データの範囲の内側/外側での予測。外挿は当たりにくい。
- 過学習
- 偶然の揺らぎまで覚えてしまい、新しいデータで外れる状態。
- 相関ρ
- 2つの値の並び方の近さを表す0〜1(または−1〜1)の数。1に近いほど近い。
- 平均絶対誤差(MAE)
- 予測と正解の差の絶対値の平均。単位は元の量と同じ。
- 高スループット
- 多数の計算や実験を、並行して自動的に行う方式。
- ベンチマーク
- 手法を比べるための共通の課題とデータ、指標。
- ベースライン
- 比較の基準にする単純な方法(平均を返す、最近傍の値を返すなど)。
- FAIR原則
- データを、見つけやすく、アクセスでき、相互運用でき、再利用できるようにする15の原則。
- MGI
- Materials Genome Initiative。米国の、材料の発見・開発・展開を加速する政府の取り組み(2011年開始)。
- MII
- Materials Innovation Infrastructure。MGI が掲げる、計算・実験・データをつなぐ基盤。
- GNN(グラフニューラルネットワーク)
- 原子のつながりを入力にするAI。別編で扱う。
- 能動学習
- 次に測る試料を、モデルが選びながら学ぶ方法。別編で扱う。
- 自律実験室
- AIとロボットが、実験の計画と実施を繰り返す実験室。別編で扱う。
- 再現性
- 同じ条件でやり直して、同じ結果が得られること。
13. 参考資料(一次情報)
- National Science and Technology Council "Materials Genome Initiative for Global Competitiveness", 2011年6月 — mgi.gov/sites/mgi/files/materials_genome_initiative-final.pdf
- NSTC Subcommittee on the Materials Genome Initiative "Materials Genome Initiative Strategic Plan", 2021年11月 — mgi.gov/sites/mgi/files/MGI-2021-Strategic-Plan.pdf
- Materials Genome Initiative "About the Materials Genome Initiative"(公式サイト) — mgi.gov/about-materials-genome-initiative
- Davies D. W. ほか "Computational Screening of All Stoichiometric Inorganic Materials", Chem 1, 617–627 (2016), DOI 10.1016/j.chempr.2016.09.010 — doi.org/10.1016/j.chempr.2016.09.010
- Ramprasad R. ほか "Machine learning in materials informatics: recent applications and prospects", npj Comput. Mater. 3, 54 (2017), DOI 10.1038/s41524-017-0056-5 — doi.org/10.1038/s41524-017-0056-5
- Agrawal A., Choudhary A. "Perspective: Materials informatics and big data: Realization of the 'fourth paradigm' of science in materials science", APL Mater. 4, 053208 (2016), DOI 10.1063/1.4946894 — doi.org/10.1063/1.4946894
- Zunger A. "Inverse design in search of materials with target functionalities", Nat. Rev. Chem. 2, 0121 (2018), DOI 10.1038/s41570-018-0121 — doi.org/10.1038/s41570-018-0121
- Sanchez-Lengeling B., Aspuru-Guzik A. "Inverse molecular design using machine learning: Generative models for matter engineering", Science 361, 360–365 (2018), DOI 10.1126/science.aat2663 — doi.org/10.1126/science.aat2663
- Kirklin S. ほか "The Open Quantum Materials Database (OQMD): assessing the accuracy of DFT formation energies", npj Comput. Mater. 1, 15010 (2015), DOI 10.1038/npjcompumats.2015.10(オープンアクセス) — doi.org/10.1038/npjcompumats.2015.10
- Ling J. ほか "High-Dimensional Materials and Process Optimization Using Data-Driven Experimental Design with Well-Calibrated Uncertainty Estimates", Integr. Mater. Manuf. Innov. 6, 207–217 (2017), DOI 10.1007/s40192-017-0098-z — doi.org/10.1007/s40192-017-0098-z
- Li K. ほか "Exploiting redundancy in large materials datasets for efficient machine learning with less data", Nat. Commun. 14, 7283 (2023), DOI 10.1038/s41467-023-42992-y(オープンアクセス) — doi.org/10.1038/s41467-023-42992-y
- Merchant A. ほか "Scaling deep learning for materials discovery", Nature 624, 80–85 (2023), DOI 10.1038/s41586-023-06735-9 — doi.org/10.1038/s41586-023-06735-9
- Cheetham A. K., Seshadri R. "Artificial Intelligence Driving Materials Discovery? Perspective on the Article: Scaling Deep Learning for Materials Discovery", Chem. Mater. 36, 3490–3495 (2024), DOI 10.1021/acs.chemmater.4c00643 — doi.org/10.1021/acs.chemmater.4c00643
- Rajan K. "Materials informatics", Materials Today 8(10), 38–45 (2005), DOI 10.1016/S1369-7021(05)71123-8 — doi.org/10.1016/S1369-7021(05)71123-8
- Fischer C. C. ほか "Predicting crystal structure by merging data mining with quantum mechanics", Nature Materials 5, 641–646 (2006), DOI 10.1038/nmat1691 — doi.org/10.1038/nmat1691
- Curtarolo S. ほか "AFLOW: An automatic framework for high-throughput materials discovery", Comput. Mater. Sci. 58, 218–226 (2012), DOI 10.1016/j.commatsci.2012.02.005 — doi.org/10.1016/j.commatsci.2012.02.005
- Jain A. ほか "Commentary: The Materials Project: A materials genome approach to accelerating materials innovation", APL Mater. 1, 011002 (2013), DOI 10.1063/1.4812323 — doi.org/10.1063/1.4812323
- Saal J. E. ほか "Materials Design and Discovery with High-Throughput Density Functional Theory: The Open Quantum Materials Database (OQMD)", JOM 65, 1501–1509 (2013), DOI 10.1007/s11837-013-0755-4 — doi.org/10.1007/s11837-013-0755-4
- Wilkinson M. D. ほか "The FAIR Guiding Principles for scientific data management and stewardship", Sci. Data 3, 160018 (2016), DOI 10.1038/sdata.2016.18(オープンアクセス) — doi.org/10.1038/sdata.2016.18
- Raccuglia P. ほか "Machine-learning-assisted materials discovery using failed experiments", Nature 533, 73–76 (2016), DOI 10.1038/nature17439 — doi.org/10.1038/nature17439
- Butler K. T. ほか "Machine learning for molecular and materials science", Nature 559, 547–555 (2018), DOI 10.1038/s41586-018-0337-2 — doi.org/10.1038/s41586-018-0337-2
- Dunn A. ほか "Benchmarking materials property prediction methods: the Matbench test set and Automatminer reference algorithm", npj Comput. Mater. 6, 138 (2020), DOI 10.1038/s41524-020-00406-3(オープンアクセス) — doi.org/10.1038/s41524-020-00406-3
- Riebesell J. ほか "A framework to evaluate machine learning crystal stability predictions", Nat. Mach. Intell. 7, 836–847 (2025), DOI 10.1038/s42256-025-01055-1 — doi.org/10.1038/s42256-025-01055-1
- Choudhary K. ほか "JARVIS-Leaderboard: a large scale benchmark of materials design methods", npj Comput. Mater. 10, 93 (2024), DOI 10.1038/s41524-024-01259-w — doi.org/10.1038/s41524-024-01259-w
- VAMAS "Versailles Project on Advanced Materials and Standards"(公式サイト) — vamas.org
- ISO/IEC "ISO/IEC 22989:2022 Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(ISO のページ) — iso.org/standard/74296.html
- ISO/IEC "ISO/IEC 23053:2022 Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML)"(ISO のページ) — iso.org/standard/74438.html
- ISO/IEC "ISO/IEC 5259-1:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 1: Overview, terminology, and examples"(ISO のページ) — iso.org/standard/81088.html
- ISO/IEC "ISO/IEC 5259-3:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 3: Data quality management requirements and guidelines"(ISO のページ) — iso.org/standard/81092.html
- ISO/IEC "ISO/IEC 42001:2023 AI management systems"(ISO のページ) — iso.org/standard/81230.html
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1, 2023年1月, DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
14. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 103元素から4成分の化合物をつくる組合せは、元素の割合まで数えると1兆(10¹²)通りを超え、価数と電気陰性度で化学的にありえない組成を除くと約100億(10¹⁰)通りになるという見積り | Davies ら(2016)の要旨 出典4 https://doi.org/10.1016/j.chempr.2016.09.010 | 事実 |
| 新しい種類の材料が初めて使われるまで、典型的におよそ10〜20年。リチウムイオン電池は、1970年代半ばの提案から1990年代後半の普及まで20年。少なくとも2倍の速さで、費用はごく一部で、という MGI の目標。7つの段階。段階間のフィードバックが少ないこと | MGI 白書(2011年6月) 出典1 https://www.mgi.gov/sites/mgi/files/materials_genome_initiative-final.pdf | 事実 |
| 現在の MGI のサイトが、発見から市場まで20年以上かかりうると説明し、「従来の方法の2倍の速さで、費用はごく一部で」を目標としていること | MGI の公式サイト 出典3 https://www.mgi.gov/about-materials-genome-initiative | 事実 |
| MGI 戦略計画(2021年11月)の3つの目標(MII の統一、材料データの活用、人材の育成)。MGI の方法が、一部の用途で先進材料の導入を加速したという記述 | MGI 2021 Strategic Plan 出典2 https://www.mgi.gov/sites/mgi/files/MGI-2021-Strategic-Plan.pdf | 事実 |
| MI の中心手法が、過去のデータだけから素早く予測する代理モデルを機械学習でつくり、材料を数値の組(フィンガープリント/記述子)で表すこと。予測は通常内挿的で、外挿には不確かさの考慮が必要なこと | Ramprasad ら(2017)の要旨 出典5 https://doi.org/10.1038/s41524-017-0056-5 | 事実 |
| データ駆動の発見を「第四のパラダイム」として論じ、順モデル(特性予測)と逆モデル(材料の発見)の例を挙げていること | Agrawal と Choudhary(2016)の要旨 出典6 https://doi.org/10.1063/1.4946894 | 事実 |
| 逆設計の考え方(望む機能を先に宣言し、理論計算で安定で合成できる化合物を予測し、予測・合成・評価の循環で改善) | Zunger(2018)の要旨 出典7 https://doi.org/10.1038/s41570-018-0121 | 事実 |
| 機械学習の生成モデルによる分子の逆設計を整理した論文であること(題名) | Sanchez-Lengeling と Aspuru-Guzik(2018)の題名・書誌 出典8 https://doi.org/10.1126/science.aat2663 | 事実 |
| DFT−実測の生成エネルギーの平均絶対誤差 0.096 eV/原子(1,670化合物)。実験どうしの平均絶対誤差 0.082 eV/原子。誤差の相当部分が実験の不確かさに由来しうるという見解 | Kirklin ら(2015)の要旨 出典9 https://doi.org/10.1038/npjcompumats.2015.10 | 事実 |
| 機械学習の提案する実験を使うと、4つの材料科学の試験事例で、無作為に比べて平均3分の1の測定回数で最適な候補が見つかったこと | Ling ら(2017)の要旨 出典10 https://doi.org/10.1007/s40192-017-0098-z | 事実 |
| データの最大95%を除いても分布内の予測性能がほとんど変わらないこと。除けたデータは過剰に多い材料タイプに関連し、分布外の悪化は防げないこと | Li ら(2023)の要旨 出典11 https://doi.org/10.1038/s41467-023-42992-y | 事実 |
| GNoME が、既知の安定結晶に対する凸包より下の220万構造の発見を可能にしたという論文の記述。736件がすでに独立に実験で実現されているという記述 | Merchant ら(2023)の要旨 出典12 https://doi.org/10.1038/s41586-023-06735-9 | 事実 |
| GNoME の主張を検討し、新規性・信頼性・有用性を満たす化合物の証拠が乏しいとしたこと。方法には期待が持てるが、材料合成と結晶学の専門知識の取り込みが必要とされたこと | Cheetham と Seshadri(2024)の要旨 出典13 https://doi.org/10.1021/acs.chemmater.4c00643 | 事実 |
| 年表の出来事(Rajan 2005、Fischer 2006、AFLOW・Materials Project・OQMD 2012〜13、FAIR原則と Raccuglia 2016、Butler 2018、Matbench 2020)の書誌。Rajan の論文の本文は未確認 | 各論文の書誌(Crossref で確認) 出典14 https://doi.org/10.1016/S1369-7021(05)71123-8 出典15 https://doi.org/10.1038/nmat1691 出典16 https://doi.org/10.1016/j.commatsci.2012.02.005 出典17 https://doi.org/10.1063/1.4812323 出典18 https://doi.org/10.1007/s11837-013-0755-4 出典21 https://doi.org/10.1038/s41586-018-0337-2 | 事実 |
| FAIR原則が15の原則で、見つけやすさ・アクセス・相互運用・再利用を扱うこと。2016年に Scientific Data で公表されたこと | Wilkinson ら(2016) 出典19 https://doi.org/10.1038/sdata.2016.18 | 事実 |
| 失敗した反応の記録を学習に使った機械学習が、人の直感より高い精度で反応の成否を予測したこと(バナジウムセレン酸塩の水熱合成) | Raccuglia ら(2016) 出典20 https://doi.org/10.1038/nature17439 | 事実 |
| Matbench(13課題)、Matbench Discovery(回帰指標と分類指標のずれ、偽陽性)、JARVIS-Leaderboard(274のベンチマーク、1,281件の投稿)の内容 | 各論文の要旨 出典22 https://doi.org/10.1038/s41524-020-00406-3 出典23 https://doi.org/10.1038/s42256-025-01055-1 出典24 https://doi.org/10.1038/s41524-024-01259-w | 事実 |
| VAMAS が整合した測定・試験・仕様・標準の技術的基盤をつくる国際共同プロジェクトを進める枠組みであること | VAMAS の公式サイト 出典25 https://www.vamas.org | 事実 |
| ISO/IEC 22989:2022(2022年7月)、23053:2022(2022年6月)、5259-1:2024、5259-3:2024(いずれも2024年7月)、42001:2023(2023年12月)の番号・題名・発行年月 | ISO のページ(確認日 2026年10月22日) 出典26 https://www.iso.org/standard/74296.html 出典27 https://www.iso.org/standard/74438.html 出典28 https://www.iso.org/standard/81088.html 出典29 https://www.iso.org/standard/81092.html 出典30 https://www.iso.org/standard/81230.html | 事実 |
| NIST AI RMF 1.0(NIST AI 100-1、2023年1月)の番号・題名 | NIST の文書(DOI) 出典31 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| 10¹⁰ 通りを1日1件・1時間1件・1日1,000件で試す年数(約2,700万年、約110万年、約2.7万年)、絞り込みの効果の表(ρ ごとの当たり件数) | 本稿の計算(単純な割り算、およびPythonによる合成データの数値実験。乱数の種2026、500回の平均)。実在の材料のデータの結果ではない | 本稿の計算 |
| MGI の2倍の速さ・費用のごく一部という目標の達成状況、Rajan 論文の本文、GNoME の新規性・有用性の判定、MIに特化した国際標準、ISO/IEC 規格の本文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「計算は安く速く、実験は確かめる、AIは絞る」という役割分担、「探す場所」の考え方、「素材技術者の視点」の各記述、今日からできることの6項目 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図が実データの観察ではなく、説明のための作図であること。ヒーロー画像と図9がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月22日/出典は一次情報(米国 MGI の公式文書、査読論文、ISO・NIST・VAMAS の公式ページ)に限定し、調査会社の市場推計は使っていません。ISO/IEC 規格の本文は有料のため確認できていません。 絞り込みの数値実験は本稿が作った合成データの計算で、実在の材料の結果ではありません。 MGI の目標の達成状況、Rajan 論文の本文、GNoME の新規性・有用性の判定、MIに特化した国際標準については、確認できなかったため記載していません。 図はすべて説明用の概念図または本稿の計算を含む作図で、ヒーロー画像と図9はImageGen生成の概念画像です。