TECHNOLOGY EXPLAINER
ベンチマークと評価の読み方
― 「点数」の背後にある、版・設定・採点・誤差・実施主体
生成AIの性能は、MMLU・GPQA・SWE-bench などの「点数」で語られます。しかし点数は、問題集の版、プロンプトの書式、サンプル数、思考の強さ、ツールの有無、採点の方法、問題数による誤差、そして誰が測ったかで変わります。さらに、広く使われたベンチマークは、汚染(学習データへの混入)・誤り・飽和によって、数年で役目を終えることがあります。 この記事は、代表的なベンチマークの原論文と設定、設定による点数の動き、誤差の見積り(本稿の計算)、汚染と飽和の実例、評価の実施主体の違い、LLM-as-judge・人手評価・順位表(LMArena など)の方法と限界、そして NIST・ISO/IEC・HELM・MLCommons の指針を、一次情報の範囲で整理します。素材技術者が「点数」を読み、自社の課題で評価するときの手順にまとめます。
- 「点数」は何でできているか(3行でつかむ)
- 評価の型と流れ ― ずれが入り込む場所
- 代表的なベンチマークの原論文と設定
- 設定で点数が動く ― 書式、pass@k、思考の強さ、配信
- 誤差を見積もる ― 問題数と信頼区間(本稿の計算)
- 汚染・誤り・飽和 ― ベンチマークの「寿命」
- 誰が測ったか ― 評価の実施主体
- LLM-as-judge、人手評価、順位表(LMArena など)の方法と限界
- 素材技術者の視点 ― 自社の課題で評価する
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=草案・改訂中・査読前などで、確定していない事項
このほか、仕組みや使い方の読み取りは「解説」として区別しています。推測は太字で示します。
ここに出てくるベンチマークの数値・順位表の記述は、特定の版・設定・実施主体・時点のものです。異なる設定の数値を並べて、モデルの優劣をつけることはしません。第三者の順位表(Arena、HELM など)は、方法と日付を示したうえで参考値として扱い、順位を事実として断定しません。 モデル名・ベンチマークの運用状況・ポリシーは変化が速いため日付を書いています。確認日(2026年10月15日)より後の状態は、公式ページで確かめてください。
1. 「点数」は何でできているか(3行でつかむ)
- 点数は、問題集・実行設定・採点・集計・報告主体の合成:NIST の AI 800-2 初期公開草案(2026年1月)は、自動ベンチマーク評価を「評価の目的を定めベンチマークを選ぶ」「評価を実装して実行する」「結果を分析して報告する」の3段階・9つの実践に整理しています。比較が目的なら、モデル間で評価の設定をそろえるほど、結果は比較しやすくなる、とも書いています事実[参考資料33]。ただしこれは自主的な指針の草案です。
- ベンチマークには寿命がある:MMLU は最新の LLM が90%超を出すようになり、難しい問題集 HLE が作られました[参考資料15]。MMLU には誤りを含む問題が推定6.49% あると報告され[参考資料3]、SWE-bench Verified は OpenAI が2026年2月に、汚染などを理由にスコアの報告を停止しました[参考資料10]事実。
- 誤差が書かれていない点数は、読み方が決まらない:仮に30問の問題集で正答率80% なら、問題の抽出だけで95%区間は約±14ポイントです本稿の計算(第5章)。Arena のような人手投票の順位表も、方法と区間を見て読みます(第8章)。
ベンチマークの点数は、「版・設定・採点・問題数(誤差)・実施主体」の5点セットで読みます。どれかが書かれていなければ、その点数は、他の数字と並べて優劣をつける根拠にはなりません。 そして、点数が高いことは、自分の課題で使えることを意味しません(第9章)。
2. 評価の型と流れ ― ずれが入り込む場所
(1) 評価の四つの型
言語モデルの評価は、採点の仕方で大きく四つの型に分けて整理できます(本記事による分類)。
- 正解との照合:MMLU(選択式)、GPQA(選択式)、GSM8K・MATH・AIME(最終答えの一致)など[参考資料1・4・6・7]。
- 実行して採点:HumanEval のように、生成コードを単体テストで実行して合否を判定する型。SWE-bench は、実在のリポジトリの課題に対する修正が、テストに合格するかで判定します[参考資料5・8]。
- 人または LLM による判定:MT-Bench、Chatbot Arena(人手の選好投票)、HELM Capabilities の一部(LLM 判定)など[参考資料23・24・29]。
- 更新型:新しい問題を継続的に追加して汚染を避けようとする LiveCodeBench、LiveBench など[参考資料13・14]。
これとは別に、安全性(有害な出力の抑止)を測る型があり、MLCommons の AILuminate は12の危険の区分でシステムの耐性を評価します[参考資料30]。本稿は能力評価の読み方を中心に扱い、エージェントと安全の評価は本シリーズ『エージェントの評価と安全』『AIの安全性評価とリスク管理』編で扱います。
(2) 評価の流れと、ずれが入る場所
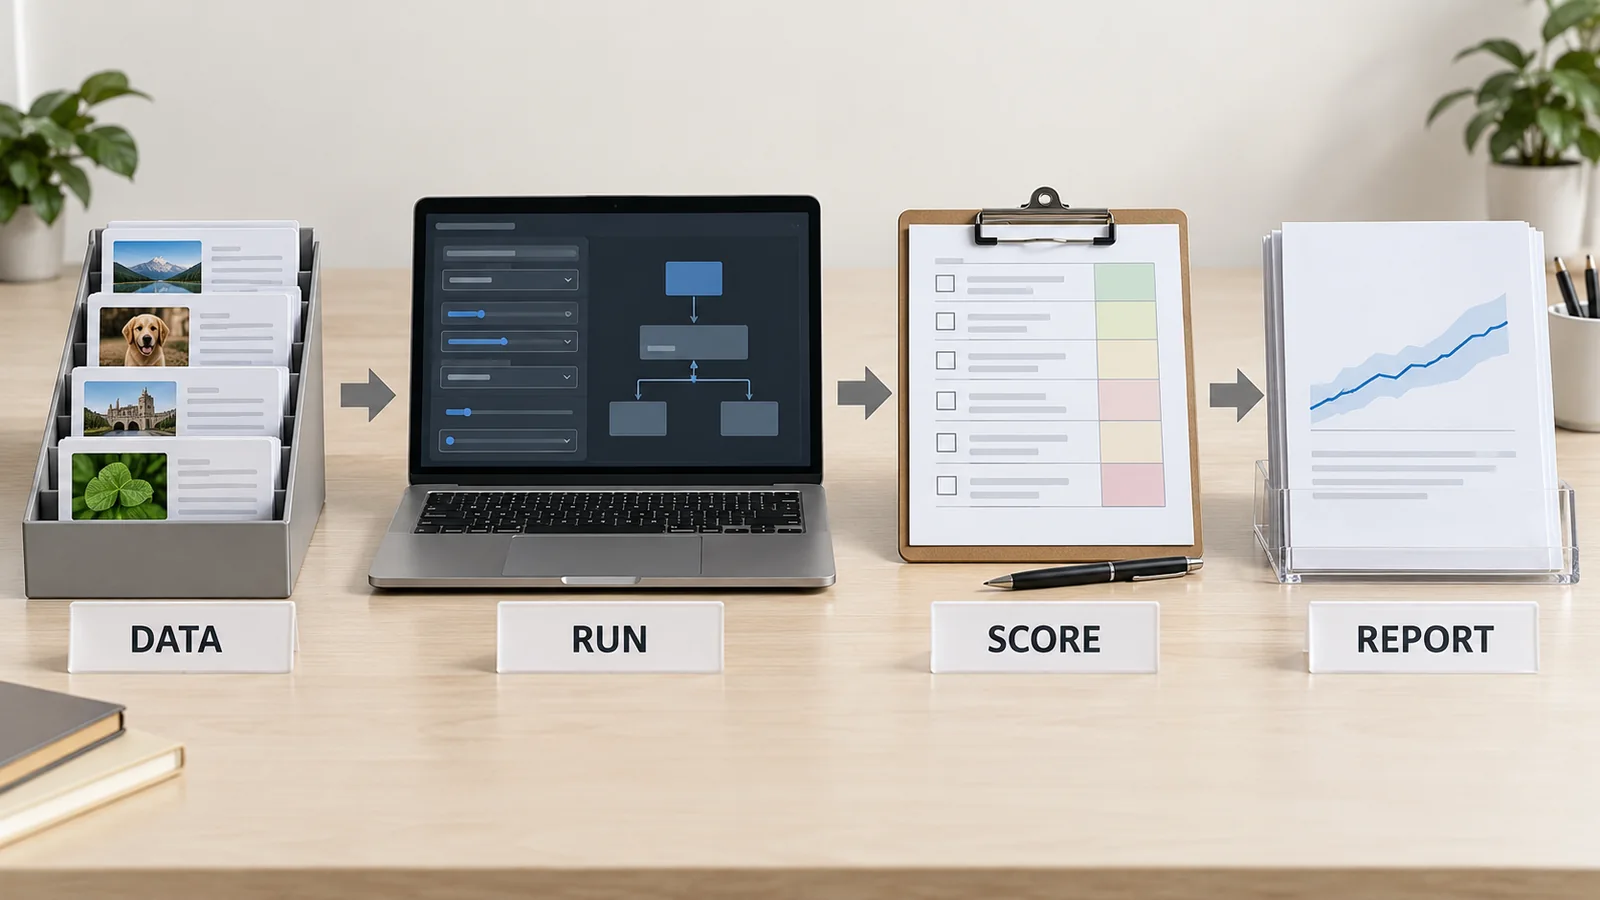
NIST AI 800-2 初期公開草案は、評価の設定を四つ(推論の設定:温度や思考の強さなど、足場の設定:ツールや best-of-N など、課題の設定、採点の設定)に分けています[参考資料33]。この分類を借りて、評価の流れを一枚にまとめたのが図2です。
元のSVG模式図・数値・出典注記を見る
3. 代表的なベンチマークの原論文と設定
次の表は、本稿で名前の出てくる主なベンチマークの原論文・公式ページで確認できた規模と方式です。点数の大小は載せていません。同じ名前でも版や部分集合が違うことがあるため、「どの版か」を必ず確認します。
| 名称(原典) | 測るもの・規模 | 採点 | 読むときの注意 |
|---|---|---|---|
| MMLU(Hendrycks ら 2020、arXiv 2009.03300)[1] | 57科目(初等数学、米国史、コンピュータ科学、法律など)の選択式。15,908問を分割し、テスト14,079問、各科目のテストは最低100問 | 選択式の正答率 | 公開当時は最大の GPT-3 でも、ランダムを平均約20ポイント上回る程度だった。いまは90%超が出るため差がつきにくい[15]。誤りを含む問題が推定6.49%[3] |
| MMLU-Pro(Wang ら 2024、arXiv 2406.01574)[2] | 選択肢を4から10に増やし、推論を要する問題を足し、易しい・ノイズの多い問題を除いた MMLU の拡張 | 選択式の正答率 | 著者らによれば、MMLU より精度が16〜33ポイント下がり、プロンプト24種類での点数の変動は MMLU の4〜5%から2% に減った。CoT で改善する点が MMLU と違う |
| MMLU-Redux(Gema ら 2024、arXiv 2406.04127)[3] | MMLU の5,700問を人手で再注釈した部分集合(57科目すべて) | 誤りの有無の注釈 | MMLU 全体で誤りを含む問題が推定6.49%。Virology の分析した問題では57% に誤り。再注釈で、元の報告との差が出た |
| GPQA(Rein ら 2023、arXiv 2311.12022)[4] | 生物・物理・化学の専門家が作った選択式。Extended 546問、GPQA 本体(main)448問、Diamond 198問 | 選択式の正答率 | Extended での正答率は専門家64.8%、非専門家34.1%。main と Diamond は検証者の回答で絞った集合で、論文は正答率に選択効果があると注記 |
| GSM8K(Cobbe ら 2021、arXiv 2110.14168)[6]、MATH(Hendrycks ら 2021、arXiv 2103.03874)[7] | GSM8K は小学校レベルの算数文章題8.5K問、MATH は競技数学12,500問 | 最終答えの一致 | GSM1k による汚染の検証がある[16](第6章)。OpenAI は、MATH と GSM8K ではもはやモデルを有効に差別化できないと述べた[44] |
| AIME(MAA)[43] | 米国数学協会の招待競技。15問の試験で、答えは0〜999の整数。AI の評価には、年ごとの問題(AIME 2024、2025 など)が使われる | 最終答えの一致 | 問題数が少ない(仮に I・II 回の計30問なら、第5章のとおり誤差が大きい)。年・サンプル数・思考の強さの記載が必要 |
| HumanEval(Chen ら 2021、arXiv 2107.03374)[5] | 手書きの164問のプログラミング課題(docstring から関数を作る) | 単体テストの実行。pass@k(論文は n=200、k≤100) | 古い問題集で、公開から時間が経つ。学習データとの重複が指摘されている[17]。pass@k の k を確認(第4章) |
| SWE-bench(Jimenez ら 2023、arXiv 2310.06770)[8]/SWE-bench Verified(OpenAI 2024年8月13日)[9] | 12の Python リポジトリの実際の GitHub の課題2,294問。Verified は、専門家の確認を経た500問の部分集合 | 修正後に、課題に対応するテストと既存の回帰テストの両方に合格すること | 公開時の最高は Claude 2 の1.96%[8]。Verified の経緯と、その後の報告停止は第6章 |
| LiveCodeBench(Jain ら 2024、arXiv 2403.07974)[13]/LiveBench(White ら 2024、arXiv 2406.19314)[14] | LiveCodeBench は、LeetCode・AtCoder・CodeForces から継続的に問題を集め、論文時点で2023年5月〜2024年5月の400問。LiveBench は最近の情報源から月次で問題を更新し、客観的な正解で自動採点 | テスト実行/客観的な正解との照合 | 問題の公開時期で区切ることで、モデルの学習データの期限との重なりを避ける設計。ただし、問題の期間と評価対象のモデルの学習期限の関係を確認する必要がある |
| HLE(Phan ら、Nature 649, 1139–1146, 2026年1月28日掲載)[15] | 約1,000人の専門家が作った2,500問。数学・人文・自然科学など。選択式と短答式 | 正解の照合。論文は判定に LLM(o3-mini)を使い、等価な表記を考慮する | 問題は投稿前に複数の最先端モデルで解かせ、解けなかったものだけを専門家の審査に回す(70,000回超の試行のうち、モデルが解けず審査に回ったのは約13,000問)。論文自身が、低い精度は部分的に設計によるものだと述べる。公開問題とは別に非公開の保持セットを持ち、過学習や不正利用の確認に使う |
| ChemBench(Mirza ら 2024、arXiv 2404.01475)[42] | 化学の知識・推論を評価する2,700問超。化学者との比較つき | 自動評価 | 著者らは、最良のモデルが研究内の最良の化学者を平均で上回ったが、基本的な課題でつまずき、過信した予測をすると報告。査読誌版の有無は本稿では確認していない |
すべて事実(各原論文・公式ページ・掲載誌、確認日 2026年10月15日)。「読むときの注意」の一部は本記事の解説です。
4. 設定で点数が動く ― 書式、pass@k、思考の強さ、配信
同じモデルでも、評価の設定を変えると点数は動きます。一次情報で確認できた主な要因を、次の表に整理しました。
| 設定 | 一次情報で確認できたこと | 記録しておくこと(解説) |
|---|---|---|
| プロンプトの書式 | Sclar らは、意味を変えない書式の違い(区切りや体裁など)だけで、few-shot 設定の複数のオープンモデルが非常に敏感に反応し、LLaMA-2-13B では最大76ポイントの差が出ると報告した。モデルを大きくしても、例の数を増やしても、指示微調整をしても感度は残り、書式ごとの性能はモデル間で弱くしか相関しない。著者らは、1つの書式の値ではなく、もっともらしい書式の範囲での性能を報告するよう勧める[19] | プロンプト全文、区切り文字、選択肢の表記、回答の取り出し方。可能なら複数の書式での範囲 |
| ショット数・CoT の有無 | MMLU-Pro では、CoT を使うと直接回答より性能が上がるが、元の MMLU ではそうでなかった[2]。HELM Capabilities は、選択式の2課題を zero-shot の CoT で評価している[29] | shot 数、CoT の指示、公式のプロンプトテンプレートを使ったか |
| pass@k の k とサンプル数 | HumanEval の pass@k は、n(≥k)個のサンプルを生成し、そのうち c 個が合格したとして、不偏推定量で計算する(論文は n=200、k≤100)[5] | k、n、温度。図3のとおり、k が違えば同じモデルでも別の数字になる |
| 思考の強さ・サンプル数(推論モデル) | NIST AI 800-2 初期公開草案は、思考の強さ(reasoning effort)のような費用と性能のトレードオフの設定を、実際の利用を反映して選ぶよう例示している[33]。具体例は本シリーズ『推論モデル』編 | effort・thinking level・予算、pass@1 か cons@k か、使用トークン数 |
| ツール・足場(スキャフォールド) | 同草案は、足場の設定(ツールの有無、best-of-N のような集約)を、推論や課題、採点の設定と並ぶ独立の設定として扱う[33] | 使えるツールと版、エージェントの構成、再試行の回数 |
| 配信の状態 | 同草案は、推論エンジン・量子化・チャットテンプレートの設定ミスやバグで、モデルが劣化した状態で配信されうること、商用の提供者でも、同じモデルをどの文脈長で配信するかが異なりうることを、評価の落とし穴に挙げている[33] | どの API・どの量子化で動かしたか、文脈長、取得日 |
| 評価コードと回答の取り出し | lm-evaluation-harness の開発者らは、3年の経験から、評価設定への感度、方法の比較の難しさ、再現性と透明性の欠如を課題として挙げ、推奨を示している[20]。同草案は、回答の取り出し(パース)や、ベンチマークの版管理も実践に含める[33] | 評価フレームワークの名前と版、ベンチマークの版、ログ |
すべて事実(各原論文・NIST の草案)。右列は本記事の解説です。NIST AI 800-2 は初期公開草案(2026年1月)で、確定版ではありません。
pass@k を例に:同じモデルが「1%」にも「75%」にもなる
1サンプルあたりの成功率がおよそ1%のモデル(n=200サンプル中 c=2個が合格)を、HumanEval の不偏推定量で計算すると、pass@1 は1.0%、pass@10 は9.8%、pass@100 は75.1% になります。成功率が5%(c=10)なら、pass@1 は5.0%、pass@10 は40.9%、pass@100 は99.9% です本稿の計算。どれも同じモデルの同じ結果から計算した数字で、k が違うだけです。
5. 誤差を見積もる ― 問題数と信頼区間(本稿の計算)
Miller は、評価は実験であり、評価の問題は未知の母集団から抽出されたものと見なせる、という考え方で、評価データの分析、2つのモデルの差の測定、評価実験の計画のための式を示しています[参考資料21]。NIST の草案も、可能な限り不確かさを添えて統計量を報告すること、ばらつきの要因として、「問題ごとに生成されるサンプルの非決定性」と「問題集に問題が抽出されること」の二つを例に挙げています[参考資料33]。また BetterBench は、評価した24のベンチマークのほとんどが、結果の統計的有意性を報告せず、結果を容易に再現できるようにもなっていない、と報告しています[参考資料22]事実。
ここでは最も簡単な場合(各問題が正解か不正解かの二値、問題が独立に抽出されたという近似)で、問題集の規模ごとに、正答率の95%区間を計算しました。正答率は仮定で、実際のモデルの値ではありません。
| 問題数(規模の例) | 仮定した正答率 | 標準誤差(ポイント) | 95%区間(標準誤差×1.96) |
|---|---|---|---|
| 30問(AIME の I・II 回を合わせた規模と仮定) | 80% | 7.3 | ±14.3(65.7〜94.3) |
| 164問(HumanEval) | 90% | 2.3 | ±4.6(85.4〜94.6) |
| 198問(GPQA Diamond) | 70% | 3.3 | ±6.4(63.6〜76.4) |
| 500問(SWE-bench Verified) | 70% | 2.0 | ±4.0(66.0〜74.0) |
| 14,079問(MMLU のテスト) | 85% | 0.30 | ±0.6(84.4〜85.6) |
本稿の計算(標準誤差=√(p(1−p)/n))。問題数は原論文・公式ページ[参考資料4・5・8・9・1]による事実。正答率は仮定。30問は、AIME が年2回の試験(MAA のページに I・II の記載)で各15問であることからの仮定で、評価に使われた問題数は評価ごとに確認が必要です。
2つのモデルを同じ問題集で比べる場合、問題ごとの正誤の差を使う対応のある分析が有効で、NIST の草案も、2モデルの平均点の比較には対応のある差に対する統計的検定を例に挙げています[参考資料33]。単純に独立とみなすと、500問・正答率70%のとき、2モデルの差の標準誤差は約2.9ポイントで、95%区間は約±5.7ポイントです本稿の計算。198問なら約±9.0ポイントです。つまり、数ポイントの差は、問題集の規模によっては誤差の範囲に入ります。
正答率70% 前後で、独立な2群の差を「観測された差で95%区間がゼロを含まない」ように検出するのに必要な問題数の目安は、差10ポイントで約160問、5ポイントで約650問、2ポイントで約4,000問です本稿の計算(正規近似、(1.96/差)²×2p(1−p))。これは、第9章で自社の評価を設計するときの目安になります。
MMLU のテストは14,079問と多く、統計的な誤差は小さくなります(上の表の±0.6ポイント)。しかし、問題の約6.49% に誤りがあるという推定[参考資料3]のように、問題や正解の質から来るずれは、問題数を増やしても消えません。統計的な区間は、「この問題集の上でのばらつき」を示すだけで、「この問題集が測りたいものを測れているか」は別に確かめる必要があります。NIST の草案も、ベンチマークが測りたい構成概念と関連するか、品質が十分か(多様性、問題数、汚染)を、選定の実践の中で問うています[参考資料33]。
6. 汚染・誤り・飽和 ― ベンチマークの「寿命」
(1) 三つの問題
汚染は、評価用の問題や解答が学習データに混ざることです。サーベイ論文は、これを Benchmark Data Contamination と呼び、モデルが評価ベンチマークの情報を学習データから取り込んでしまい、評価の段階で不正確・不確かな性能が出ることと説明しています[参考資料18]。誤りは、問題や正解そのものの間違い、飽和は、上位のモデルが高得点に達して差がつかなくなることです(本記事による整理)。
(2) 汚染の証拠
- GSM1k:Zhang らは、GSM8K と同じ様式・難しさで、新しく作った算数問題 GSM1k を用意し、主要なオープン・クローズドモデルを評価しました。精度は最大8% 下がり、いくつかのモデルのファミリーに、ほぼすべてのサイズで系統的な過学習の証拠が見られました。一方で、最前線のモデルの多くは過学習の兆候が小さく、すべてのモデルが新しい問題にもおおむね汎化した、とも報告しています事実[参考資料16]。
- 言い換え:Yang らは、n-gram の重なりによる除去では不十分で、言い換えや翻訳といった簡単な変形で除去を回避できること、そのような変形が除去されないと、13B のモデルでも過学習して GPT-4 並みの高得点が出うることを示しました。また、RedPajama-Data-1T や StarCoder-Data の事前学習データで、HumanEval の8〜18% が重複していると報告しています事実[参考資料17]。
(3) 誤りと飽和の証拠
- 誤り:Gema らは、MMLU の5,700問を人手で再注釈し、MMLU 全体で誤りを含む問題が推定6.49%、Virology の分析した問題では57% に誤りがあるとして、元の報告との差を示しました[参考資料3]。
- 飽和:HLE の論文は、最新の LLM が MMLU などの人気ベンチマークで90%超を出し、最先端の測定が難しくなったことが HLE を作った動機だと述べます[参考資料15]。OpenAI も、最近のフロンティアモデルは MATH と GSM8K で非常に高い成績を収め、これらのベンチマークではモデルを有効に差別化できなくなったと書いています[参考資料44]。
(4) 事例:SWE-bench とその後継
ベンチマークの「寿命」を一つの系譜で追える例が SWE-bench です。
- 2023年10月:SWE-bench は、12の Python リポジトリの実際の GitHub の課題2,294問で構成され、公開時の最高モデル(Claude 2)が1.96% の課題を解いた、と報告されました[参考資料8]。
- 2024年8月13日:OpenAI は、SWE-bench に解くのが難しい、または不可能な課題があり、モデルの能力を系統的に過小評価していると考え、専門家の確認を経た500問の部分集合 SWE-bench Verified を公開しました。注釈では、38.3% の課題で問題文が仕様不足、61.1% で妥当な解を不正解にしうる単体テストとフラグが立ち、全体として68.3% が除外されました。OpenAI は、このフィルタリングは行きすぎている可能性が高いとも述べています[参考資料9]。
- 2025年9月:SWE-Bench Pro が、41のリポジトリの1,865問で、公開・保持・商用の3つの集合に分けて公開されました(arXiv 2509.16941)[参考資料11]。
- 2026年2月23日:OpenAI は、SWE-bench Verified のスコアの報告を停止し、他のモデル開発者にも同様の措置を勧め、SWE-bench Pro の結果を報告するよう推奨すると発表しました。理由は、過去6か月の最先端の進歩が74.9% から80.9% に鈍化したこと、モデルが解けなかった問題の27.6%(138問)を監査したところ59.4% に、正しい提出を拒否する欠陥のあるテストなどの重大な問題があったこと、そしてテストしたすべての最前線モデルが、元の修正(ゴールドパッチ)や問題文の具体的な内容を再現できたことです。同社は、Verified の改善は、実際のソフトウェア開発能力の向上より、学習中にどれだけ触れたかをますます反映する、と書いています事実[参考資料10]。
- 2026年9月8日:別の著者らが、SWE-Bench Pro にも、ゴールドの解答や隠した評価情報の漏洩による報酬の不正利用と、誤解を招く問題文や不適切な範囲のテストといった問題の質の課題があると主張し、検証版 SWE-Bench Pro Verified を提案する論文を公開しました未確定/将来[参考資料12](査読前の preprint で、本稿は内容を検証していません)。
(5) 対策と、その限界
- 更新型:LiveCodeBench は問題の公開時期で区切り、LiveBench は月次で問題を更新し、客観的な正解で自動採点します[参考資料13・14]。ただし、評価するモデルの学習データの期限と問題の期間を突き合わせる必要があります(解説)。
- 保持セット:HLE は、公開問題とは別に非公開の保持セットを持ち、公開ベンチマークへの過学習や不正利用の確認に使うと述べます[参考資料15]。
- canary string:NIST の草案は、ベンチマークのデータに固有の文字列を混ぜ、あからさまなテストセット学習を確認する方法を、新しい(emerging)実践として挙げています。また、汚染のリスクを下げる方法として、学習中にベンチマークのデータを隠す、システムの作成後に作ったデータを使う、を挙げています[参考資料33]。
- 選定基準:HELM Capabilities は、シナリオの選定で、最先端モデルの性能から見て飽和していないか、公開時期が新しいか、品質(明瞭さ・普及・再現性)を考慮したと述べます[参考資料29]。
ベンチマークは、材料の標準試験片や基準試料に似た役割です。ただし、AI の問題集は、使い回すほど「学習に混ざる」「誤りが見つかる」「全員が満点に近づく」といった理由で、測る力を失います。素材の標準試料は消耗しても組成を再現できますが、ベンチマークは一度公開されると、同じ条件の再現が難しい点が違います(本記事による解説)。 だから、公開ベンチマークの点数は、最新の版か、更新されているか、汚染の対策があるかを添えて読み、自分の仕事では、公開していない自社の評価セットを持つ必要があります(第9章)。
7. 誰が測ったか ― 評価の実施主体
同じベンチマークでも、測った主体によって、設定の自由度・利害・検証可能性が違います。一次情報で確認できた主体を、次の表に整理しました。どれが「正しい」かではなく、何を確認すればよいかを示すものです。
| 実施主体 | 例(一次情報で確認できたこと) | 読むときの注意(解説) |
|---|---|---|
| 開発元(自己報告) | OpenAI の o1 の付録 A、gpt-oss のモデルカードは、開発元が自社モデルを評価した表を載せている[44、本シリーズ『推論モデル』編]。SWE-bench Verified の監査も OpenAI 自身の分析[10] | 設定(思考の強さ、サンプル数、ツール)の選択を開発元が行う。他社の値と同じ条件とは限らない。独立の再現が確認できないことが多い |
| 独立の研究機関・大学 | HELM(Stanford CRFM)は「基盤モデルを評価する、再現可能で透明な枠組み」と自称し[45]、論文では、7つの指標(精度、較正、頑健性、公平性、バイアス、毒性、効率)を16の中核シナリオで測り、30のモデルを42のシナリオで評価した[28]。HELM Capabilities は5つの課題(MMLU-Pro、GPQA、IFEval、WildBench、Omni-MATH)を各1,000問に絞り、選択式は zero-shot の CoT、一部は複数の LLM 判定者の平均で採点する。すべてのプロンプトを公開する[29] | プロンプト単位で検証できる点が強み。一方、評価対象のモデルの更新に追随する負担があり、順位表の鮮度は確認が必要(2026年10月15日にページで確認した HELM Capabilities の最新リリースは v1.15.0、2025年11月24日付) |
| 業界団体 | MLCommons の AILuminate v1.0 は、12の危険の区分(暴力犯罪、プライバシー、名誉毀損、専門的助言など)で、AI システムが危険な出力を誘発するプロンプトに耐えるかを評価する。5段階(Poor から Excellent)の評価尺度と、エントロピーに基づく応答評価を持つ。著者らは、評価者の不確かさや単一ターンの限界を明記している[30・31] | 安全性の評価で、能力ベンチマークとは目的が違う。評価の対象は「プロンプトに対するシステムの応答」で、現実の被害の頻度を直接測るものではない |
| 公的機関 | NIST の CAISI は、自動ベンチマーク評価の実務を示す指針の初期公開草案 NIST AI 800-2(2026年1月)を公表した[33・35]。英国 AI Security Institute は、評価のための OSS フレームワーク Inspect を、Meridian Labs とともに開発している[32] | これらは指針・ツールで、モデルの順位表ではない。草案は確定版ではない(第11章) |
| コミュニティ投票・プラットフォーム | Chatbot Arena(現 Arena)は、利用者のペア比較による人手の選好を集め、Bradley–Terry モデルでスコアを推定する[24]。評価と順位付けのコードは Arena-Rank として公開されている[26] | 人の好みを反映する一方、質問の分布、回答の長さや書式の好み、テスト前の提供の扱いなどに左右される(第8章) |
すべて事実(各論文・公式ページ、確認日 2026年10月15日)。右列は本記事の解説です。HELM Capabilities の最新リリースは、ページに表示されていた版と日付です。
- 誰が測ったか(開発元か、独立か、投票か)
- いつ測ったか(モデルの版・取得日、ベンチマークの版)
- どの設定か(プロンプト、shot、思考の強さ、ツール、pass@k の k)
- 何問で、誤差はどれくらいか(第5章)
- どう採点したか(正解照合、テスト実行、LLM 判定、人手)
- その問題集は汚染・誤り・飽和の影響を受けていないか(第6章)
8. LLM-as-judge、人手評価、順位表(LMArena など)の方法と限界
(1) LLM-as-judge(LLM による採点)
Zheng らは、強い LLM を判定者にして、自由記述の応答を評価する方法を検討しました。判定者には、位置(先に出た答えを好む)、冗長さ、自己強化(自分の出力を好む)の偏りと、推論力の限界があることを示し、緩和策を提案しています。そのうえで、GPT-4 のような強い判定者は、統制された人手評価・クラウドソースの人手評価と80%超の一致を示し、これは人間どうしの一致と同程度だと報告しました事実[参考資料23]。
HELM Capabilities は、この方式を実際に使っている例です。WildBench の採点は、複数の LLM(GPT-4o、Llama 3.1 405B Instruct Turbo、Claude 3.5 Sonnet)に、チェックリストに対して応答を採点させ、平均を取ります。Omni-MATH の判定では、元の論文の判定用プロンプトを使わず、HELM Safety の LLM 判定用プロンプトに変えました。理由は、人手による検証(canary の結果)で、元のプロンプトが判定者の幻覚を誘発することが分かったからです事実[参考資料29]。判定者の選び方とプロンプトで点数が変わりうることを示す一次情報です(解説)。
(2) 人手評価と順位表:Arena の場合
Chatbot Arena は、利用者が2つのモデルの匿名の応答を比べて投票する仕組みです。論文は、ペア比較とクラウドソースの投票を用い、Bradley–Terry モデルで順位付けすること、論文の時点で24万票超が集まったこと、投票が専門家の評価者と良く一致することを述べています[参考資料24]。Bradley–Terry モデルでは、モデル m が m′ に勝つ確率は 1/(1+eξm′−ξm) で、ξ は各モデルの係数です[参考資料24]。この式から、係数の差と勝率の関係を計算しました。
| 係数の差 Δξ | 0.05 | 0.1 | 0.2 | 0.3 | 0.5 |
|---|---|---|---|---|---|
| 上位側が1回の比較で勝つ確率 | 51.2% | 52.5% | 55.0% | 57.4% | 62.2% |
本稿の計算(式は Chatbot Arena 論文[参考資料24]の Bradley–Terry モデル)。サイトに表示されるスコアの尺度(係数そのものか、換算した値か)は本稿では確認できていないため、表示スコアの差と勝率の対応は、公式の説明で確認してください。
つまり、係数の差が小さい順位は、1回ごとの比較ではほぼ五分五分です。Arena の公式ポリシー(2026年9月1日更新)は、評価と順位付けのパイプラインを Arena-Rank として公開し、公開データを使って誰でも検証できると述べています。一般に公開されたモデル(オープンウェイト、公開 API、公開サービス)だけを掲載し、評価が安定するまでに少なくとも1,000票を集めること、公開前に評価したモデルの点数は、公開後に十分な新しい票が集まるまで暫定とすること、提供者は公開前に複数の変種を試せること、サンプリングの確率が偏っても、回帰に再重み付けを使ってスコアが偏らないようにしていることを記しています事実[参考資料26]。
(3) 順位表の公平性をめぐる論争:双方の主張
Singh らの「The Leaderboard Illusion」は、非公開のテストの慣行が、公開前に複数の変種を試して、望めば点数を取り下げられる一部の提供者に有利に働き、最良の点数を選べることから、Arena のスコアが選択的な開示で偏る、と主張しました。また、クローズドなモデルがオープンウェイトのモデルより高い割合でサンプリングされ、Arena のデータへのアクセスに非対称があると推定し、Arena のデータが得られると Arena の分布で大きな性能向上が得られる、とも述べています[参考資料25]。 これに対し Arena は2025年5月9日(2025年6月13日更新)の声明で、この論文に建設的な指摘があるとしつつ、事実と異なる主張があると反論しました。たとえば、公開前のテストで100点超の上昇が得られるという主張の図は、Arena の方針や実際の性能と無関係なガウス分布の仮想実験で、実際の効果は小さく(約50回のテスト・3,000票で約+11 Elo)、新しいデータの蓄積で消える、また、オープンモデルの割合は公式統計で40.9% だ、と述べています[参考資料27]。 本稿は、どちらが正しいかを判断しません。確かなのは、順位表の運用(誰がどのモデルをいつ・何回試せるか)が、点数の意味に影響しうるとして、双方が公開の場で議論していること、そして Arena が公開前のモデルの点数を暫定として扱う方針を明文化していることです(解説)。
順位表(Arena、HELM など)は、方法・日付・版・信頼区間を確認したうえで、候補を絞る材料として使い、順位を事実として断定しません。人の好みの順位は、自分の業務の正しさ(例:材料物性の正確さ)と一致するとは限りません。HELM のように、プロンプトと応答が公開され再現できる評価は、自分の設定と突き合わせやすい利点があります[参考資料28・29]。
9. 素材技術者の視点 ― 自社の課題で評価する
ChemBench は、2,700問超の問題で化学の知識と推論を評価する枠組みで、著者らは、最良のモデルが研究内の最良の化学者を平均で上回った一方、基本的な課題でつまずき、過信した予測をすると報告しています[参考資料42]。化学一般の知識を測る問題集と、自社の配合・工程・設備の条件のもとでの判断は別です。推測として、一般のベンチマークが高くても、自社の用語、自社の測定条件、自社の規格の使い方で間違えることは起こりえます。 ですから、自社の代表的な質問(例:自社の試験規格の読み替え、工程条件の単位換算、不具合の原因の候補出し)で小さな評価セットを作り、正解を担当者が確定して、モデルの出力を採点します。
正答率70% 前後で、2つの設定の差を検出するのに必要な問題数の目安は、第5章のとおり、差10ポイントで約160問、5ポイントで約650問、2ポイントで約4,000問です本稿の計算。社内で用意できる問題が50問なら、見える差は10ポイントよりはるかに大きい場合に限られます。 小さな評価セットでは「このモデルが優れる」とは言えず、「明らかに使えない」を除く用途に向く、と整理できます(解説)。同じ問題で2つの設定を比べる場合は、対応のある分析のほうが少ない問題数で差を検出できます[参考資料33]。
公開ベンチマークが汚染と飽和で劣化する(第6章)のに対し、社内の評価セットは、学習に使われない形で守られている限り、汚染されにくいという利点があります。評価セットを外部のサービスに入力する場合、その扱い(保存や学習利用の有無)は契約と設定によるため、利用前に必ず確認し、確認できない場合は自社内で動かせるモデルやツールで評価します(本記事による助言ではなく、一般的な注意)。NIST の草案が例示する canary string(評価データに固有の文字列を入れる)も、社内の評価セットに応用できます[参考資料33]。 あわせて、NIST の草案が勧めるように、評価ログ(完全な出力)、モデルとシステムの正確な版、コードの版を保存し、可能なら費用も性能と並べて報告します[参考資料33]。
自社評価の手順(解説)
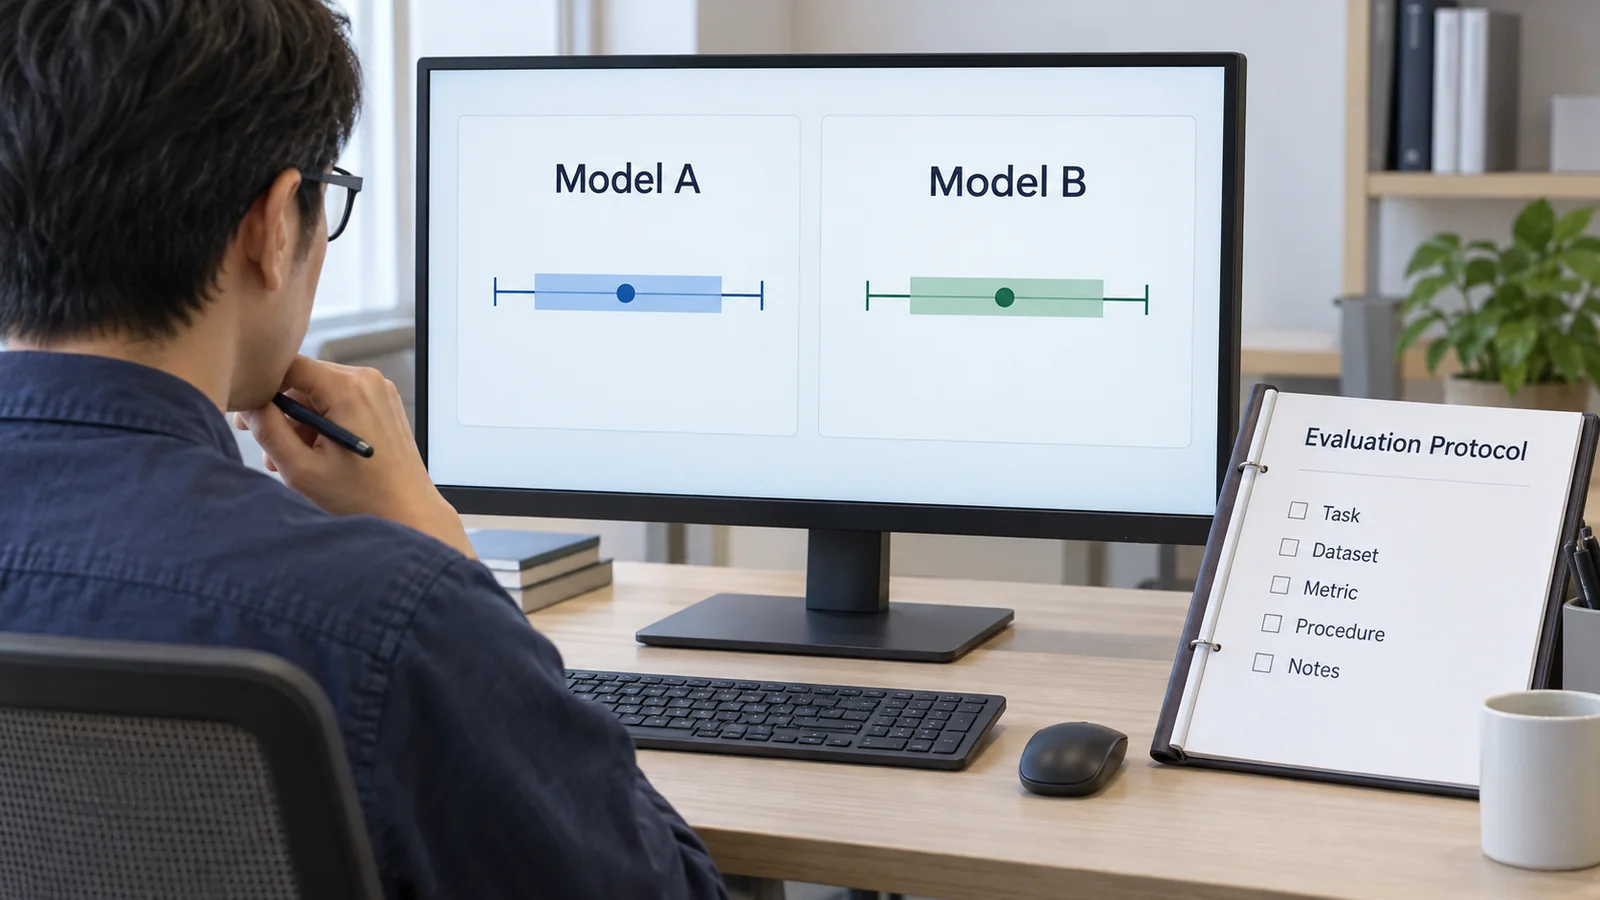
- 目的を決める:評価結果を何に使うか(候補の絞り込み、採用判断、運用中の監視)と、測りたい能力を書く。
- 評価セットを作る:代表的な質問と正解を、担当者が確定する。難易度の分布を持たせ、誤りの再点検をする。
- 設定を固定する:プロンプト、shot、温度、思考の強さ、ツール、採点方法を決めて記録する。
- 複数回実行して誤差を出す:同じ設定で複数回実行し、問題数に応じた区間を添える。
- 結果と使用資源を保存する:出力、使用トークン、費用、モデルの版と日付を残す。
- 定期的に再評価する:モデルの更新・退役に備え、同じ設定で再実行できるようにする。
10. 限界と、確認できなかったこと
(1) 点数の現在値
本稿は、特定のモデルの点数や順位を載せていません。HELM、Arena などの最新の順位は、確認日以降に変わります。HELM Capabilities のページで確認した最新リリースは v1.15.0(2025年11月24日)で、2026年10月15日時点で、それより新しい版が出ていないか、本稿では確認していません。
(2) 各社・各機関の主張の検証
OpenAI による SWE-bench Verified の分析(監査、汚染の証拠)、Arena と「The Leaderboard Illusion」の双方の主張、SWE-Bench Pro Verified の論文の主張は、いずれも公表された文書の記述で、本稿は独立に再現していません。SWE-Bench Pro Verified は査読前の preprint です。
(3) 規格・草案の本文
ISO/IEC の規格は、公式ページの題名・発行年月・適用範囲(要旨)のみを確認し、本文は未確認です。NIST AI 800-2 は初期公開草案の PDF を取得して、構成と主要な実践を確認しましたが、最終版は2026年10月15日時点で確認できませんでした。NIST AI 100-1 は PDF で確認しました。
(4) Arena のスコアの尺度
Arena のサイトに表示されるスコアが、Bradley–Terry の係数そのものか、換算した値かは、本稿では確認できませんでした。第8章の勝率の表は、係数の差に対するものです。
(5) 素材・化学分野の評価
素材・プロセス分野に特化した、広く合意された評価基準や、本稿が提案する自社評価の手順が有効であることを確認した一次情報は、確認できませんでした。第9章は、本記事の解説です。
- 点数は、版・設定・採点・問題数・実施主体の合成です。設定を変えるだけで、書式の違いなどで最大76ポイントの差が出る例があります事実
- pass@k は k で別の数字になります。1%の成功率のモデルでも、pass@100 は75%になりえます本稿の計算
- 問題数が少ないと、誤差が大きくなります。30問で正答率80%と仮定すると、95%区間は±14ポイントです本稿の計算
- ベンチマークには寿命があります。MMLU の誤り、GSM1k の過学習の証拠、SWE-bench Verified の報告停止などが、一次情報で確認できます事実
- 順位表は参考値です。Arena の運用方針と、その公平性をめぐる双方の主張を確認したうえで使います事実
- 自社の課題で、公開しない評価セットを持ちます。検出したい差が小さいほど、必要な問題数は増えます本稿の計算
11. 評価・標準の読み方
この記事は評価の読み方そのものを扱うため、この章では、ベンチマークの設計・実施・報告に関わる規格・指針・枠組みを中心に、確認できたものを並べます。AI の評価を直接定める国際規格は少なく、国際規格の多くは技術報告書(TR)や技術仕様書(TS)の形で、評価の考え方や用語を整理しています。ベンチマーク個々の原論文は第3章に示しました。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| ベンチマーク評価の設計・実施・報告の実務 | HELM(Stanford CRFM)の枠組み[28・45]、lm-evaluation-harness の経験の整理[20]、UK AI Security Institute の Inspect[32]、BetterBench(46の実践で24のベンチマークを評価)[22]事実 | NIST AI 800-2「Practices for Automated Benchmark Evaluations of Language Models」初期公開草案(CAISI、2026年1月、DOI 10.6028/NIST.AI.800-2.ipd)。評価の目的とベンチマークの選定、評価の実装と実行、結果の分析と報告の3段階・9つの実践を示す自主的な指針で、意見募集は2026年3月31日まで。NIST のページ(2026年9月30日更新)は2026年10月15日時点でも初期公開草案として掲載しており、最終版は確認できなかった[33・35]未確定/将来 | 草案は推奨される実務で、要求ではなく、法的拘束力もない。「emerging practice」の印の実践は、まだ確立途上 |
| 多指標の網羅的評価 | HELM:7指標(精度・較正・頑健性・公平性・バイアス・毒性・効率)を中核シナリオで測る[28]。HELM Capabilities は5課題を各1,000問に絞る[29]事実 | ISO/IEC TR 42106:2026(AI システムの品質特性の差異化ベンチマークの概念的な枠組みの概観。2026年7月発行、TR=技術報告書)[36]事実 | HELM は学術の枠組みで、ISO/IEC の規格ではない。TR は要求事項ではなく、概観 |
| 分類・回帰などの性能の測定法 | 確認できなかった(生成モデルの能力ベンチマークを対象にした共通手法) | ISO/IEC TS 4213:2022(機械学習の分類性能の評価方法、2022年10月、TS=技術仕様書)[37]。次の版 ISO/IEC DIS 4213「Performance measurement for AI classification, regression, clustering and recommendation tasks」が作成中未確定/将来(ISO のページで確認) | 題名と適用範囲から、分類などの予測モデルの性能測定が対象で、生成 AI の自由記述の評価を直接扱うものとは確認できなかった |
| 品質モデルと評価の指針 | 確認できなかった | ISO/IEC 25059:2023(SQuaRE の AI システム向け品質モデル、2023年6月)[40]。ISO/IEC TS 25058:2024(AI システムの品質評価のガイダンス、2024年1月、見直し段階で、AWI 25058 に置き換え予定)[39]。ISO/IEC TS 42119-2:2025(AI システムの試験の概観、ISO/IEC/IEEE 29119 の適用、2025年11月)[38]事実 | 品質特性の語彙と枠組みで、「どのベンチマークで測るか」「合格点」は定めない。本文は有料で未確認 |
| データの品質(評価データを含む) | 確認できなかった | ISO/IEC 5259-2:2024(分析と機械学習のためのデータ品質、第2部:データ品質の測定、2024年11月)[41]。題名・発行年月のみ確認事実 | ベンチマークの問題集への適用範囲は、要旨を確認できなかったため記載しない |
| 安全性・信頼性のベンチマーク | MLCommons AILuminate v1.0(12の危険の区分、5段階の評価、arXiv 2503.05731)[30・31]。HELM の Safety と AIR-Bench のリーダーボード[45]事実 | NIST AI 100-1(AI RMF 1.0、2023年1月)の MEASURE 機能は、定量・定性・混合の手法で AI のリスクを分析・評価・ベンチマーク・監視する、と説明する[34]事実(自主的な枠組み) | AILuminate は業界団体のベンチマークで、規格ではない。プロンプトへの応答の評価で、現実の被害の頻度ではない |
| 順位表の運用 | Arena の評価・順位付けのパイプラインを Arena-Rank として公開[26]。Chatbot Arena の方法[24]事実 | 確認できなかった(順位表の運用を定めた ISO/IEC・NIST の規格は確認できなかった。Arena の公式ポリシー[26]は同社の運用方針) | 運用方針は変更されうる(ポリシーは2026年9月1日更新)。公開前のテストと暫定スコアの扱いを確認 |
規格の番号・題名・発行年月・段階は ISO・NIST の公式ページで確認した事実(確認日 2026年10月15日)。ベンチマーク・枠組みの要点は各原論文・公式ページによる。表の並べ方と「読み方の注意」は本稿の計算(本記事による整理)です。
読み方の注意
- ベンチマークの値は、設定と実施主体で変わります。書式の違いだけで最大76ポイント、k の違いで同じモデルが1%にも75%にもなります(第4章)。点数は、版・設定・採点・問題数・実施主体の5点セットで読みます。
- 飽和と汚染に注意します。MMLU、GSM8K、SWE-bench Verified の例のように、広く使われた問題集は、誤りや汚染、飽和で差を測る力を失います(第6章)。最新・更新型・保持セットなどの対策を添えた点数を優先します。
- 標準・指針は、推奨か要求か、法的拘束力があるかで読み分けます。NIST AI 800-2 は自主的な指針の草案、AI 100-1 は自主的な枠組み、ISO/IEC の TR・TS は報告書・仕様書です。HELM・MLCommons・Arena は規格ではありません。いずれも「どのモデルが優れるか」を決めるものではありません。
- 宣言値と実測値を区別します。開発元が発表した点数は宣言値、自社の設定で測った点数が実測値です(第9章)。
12. 用語集
- ベンチマーク
- 固定の問題集と採点方法で、モデルの能力を数値にする仕組み。
- pass@k
- 1問に k 回まで挑戦して、一度でも合格する確率。n 個のサンプルと合格数 c から不偏推定量で計算する。
- cons@k(多数決)
- k 個のサンプルのうち最も多い答えを採用した場合の正答率。
- 汚染(contamination)
- 評価用の問題や解答が学習データに混ざること。
- 飽和(saturation)
- 上位のモデルが高得点に達して、差がつかなくなること。
- LLM-as-judge
- LLM に応答を採点・比較させる評価方法。位置・冗長さ・自己強化の偏りが知られる。
- Bradley–Terry モデル
- ペア比較の勝敗から、各モデルの強さの係数を推定する統計モデル。Arena が使う。
- 標準誤差・95%区間
- 問題の抽出による不確かさの目安。二値の正答率では √(p(1−p)/n)、区間はその1.96倍。
- 保持セット(held-out)
- 非公開にしておき、過学習や不正利用の確認に使う評価用の問題。
- canary string
- 評価データに入れる固有の文字列。学習に使われたかを確認する目印。
- スキャフォールド(足場)
- モデルの外側の仕組み(ツール、再試行、集約など)。エージェント評価の結果を左右する。
- TR/TS
- ISO/IEC の技術報告書(Technical Report)/技術仕様書(Technical Specification)。要求事項を持つ国際規格(IS)とは別。
- 初期公開草案(IPD)
- NIST が意見募集のために出す、確定前の文書。
13. 参考資料(一次情報)
- Hendrycks D. ほか "Measuring Massive Multitask Language Understanding", arXiv:2009.03300 (2020; v3 2021年1月) — arxiv.org/abs/2009.03300
- Wang Y. ほか "MMLU-Pro: A More Robust and Challenging Multi-Task Language Understanding Benchmark", arXiv:2406.01574 (2024; v6 2024年11月) — arxiv.org/abs/2406.01574
- Gema A. P. ほか "Are We Done with MMLU?", arXiv:2406.04127 (2024; v3 2025年1月、MMLU-Redux) — arxiv.org/abs/2406.04127
- Rein D. ほか "GPQA: A Graduate-Level Google-Proof Q&A Benchmark", arXiv:2311.12022 (2023年11月) — arxiv.org/abs/2311.12022
- Chen M. ほか "Evaluating Large Language Models Trained on Code", arXiv:2107.03374 (2021年7月、HumanEval と pass@k) — arxiv.org/abs/2107.03374
- Cobbe K. ほか "Training Verifiers to Solve Math Word Problems", arXiv:2110.14168 (2021年10月、GSM8K) — arxiv.org/abs/2110.14168
- Hendrycks D. ほか "Measuring Mathematical Problem Solving With the MATH Dataset", arXiv:2103.03874 (2021年3月) — arxiv.org/abs/2103.03874
- Jimenez C. E. ほか "SWE-bench: Can Language Models Resolve Real-World GitHub Issues?", arXiv:2310.06770 (2023年10月; v3 2024年11月) — arxiv.org/abs/2310.06770
- OpenAI "Introducing SWE-bench Verified"(2024年8月13日、2025年2月24日更新) — openai.com/index/introducing-swe-bench-verified/
- OpenAI "Why we no longer evaluate SWE-bench Verified"(2026年2月23日) — openai.com/index/why-we-no-longer-evaluate-swe-bench-verified/
- Deng X. ほか "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", arXiv:2509.16941 (2025年9月; v2 2025年11月) — arxiv.org/abs/2509.16941
- Zheng P. ほか "SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents", arXiv:2609.08149 (2026年9月8日、v3 2026年10月9日、査読前の preprint) — arxiv.org/abs/2609.08149
- Jain N. ほか "LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code", arXiv:2403.07974 (2024年3月; v2 2024年6月) — arxiv.org/abs/2403.07974
- White C. ほか "LiveBench: A Challenging, Contamination-Limited LLM Benchmark", arXiv:2406.19314 (2024年6月; v2 2025年4月) — arxiv.org/abs/2406.19314
- Phan L. ほか "A benchmark of expert-level academic questions to assess AI capabilities (Humanity's Last Exam)", Nature 649, 1139–1146 (2026年1月28日掲載), DOI 10.1038/s41586-025-09962-4。プレプリントは arXiv:2501.14249 — doi.org/10.1038/s41586-025-09962-4
- Zhang H. ほか "A Careful Examination of Large Language Model Performance on Grade School Arithmetic", arXiv:2405.00332 (2024年5月; v4 2024年11月、GSM1k) — arxiv.org/abs/2405.00332
- Yang S. ほか "Rethinking Benchmark and Contamination for Language Models with Rephrased Samples", arXiv:2311.04850 (2023年11月) — arxiv.org/abs/2311.04850
- Xu C. ほか "Benchmark Data Contamination of Large Language Models: A Survey", arXiv:2406.04244 (2024年6月) — arxiv.org/abs/2406.04244
- Sclar M. ほか "Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design or: How I learned to start worrying about prompt formatting", arXiv:2310.11324 (2023年10月; v2 2024年7月) — arxiv.org/abs/2310.11324
- Biderman S. ほか "Lessons from the Trenches on Reproducible Evaluation of Language Models", arXiv:2405.14782 (2024年5月; v3 2026年5月) — arxiv.org/abs/2405.14782
- Miller E. "Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations", arXiv:2411.00640 (2024年11月) — arxiv.org/abs/2411.00640
- Reuel A. ほか "BetterBench: Assessing AI Benchmarks, Uncovering Issues, and Establishing Best Practices", arXiv:2411.12990 (2024年11月) — arxiv.org/abs/2411.12990
- Zheng L. ほか "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena", arXiv:2306.05685 (2023年6月; v4 2023年12月) — arxiv.org/abs/2306.05685
- Chiang W.-L. ほか "Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference", arXiv:2403.04132 (2024年3月) — arxiv.org/abs/2403.04132
- Singh S. ほか "The Leaderboard Illusion", arXiv:2504.20879 (2025年4月; v2 2025年5月) — arxiv.org/abs/2504.20879
- Arena "Arena Leaderboard Policy"(公式ポリシー。2024年3月2日公開、2026年9月1日更新、確認日 2026年10月15日) — arena.ai/blog/policy/
- Arena "Our Response to 'The Leaderboard Illusion' Writeup"(2025年5月9日、2025年6月13日更新、確認日 2026年10月15日) — arena.ai/blog/our-response
- Liang P. ほか "Holistic Evaluation of Language Models", arXiv:2211.09110 (2022年11月; v2 2023年10月、TMLR 2023) — arxiv.org/abs/2211.09110
- Stanford CRFM "HELM Capabilities: Evaluating LMs Capability by Capability"(ブログ、2025年3月20日) — crfm.stanford.edu/2025/03/20/helm-capabilities.html
- Ghosh S. ほか(MLCommons) "AILuminate: Introducing v1.0 of the AI Risk and Reliability Benchmark from MLCommons", arXiv:2503.05731 (2025年2月; v2 2025年4月) — arxiv.org/abs/2503.05731
- MLCommons "AILuminate"(公式ページ、確認日 2026年10月15日) — mlcommons.org/ailuminate/
- UK AI Security Institute/Meridian Labs "Inspect: An open-source framework for large language model evaluations"(公式ドキュメント、確認日 2026年10月15日) — inspect.aisi.org.uk/
- NIST(CAISI) "Practices for Automated Benchmark Evaluations of Language Models", NIST AI 800-2 Initial Public Draft(2026年1月), DOI 10.6028/NIST.AI.800-2.ipd — nvlpubs.nist.gov/nistpubs/ai/NIST.AI.800-2.ipd.pdf
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1(2023年1月), DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
- NIST "Towards Best Practices for Automated Benchmark Evaluations"(2026年1月30日公表、意見募集は2026年3月31日まで)。NIST の Guidelines ページ(2026年9月30日更新)も確認 — www.nist.gov/news-events/news/2026/01/towards-best-practices-automated-benchmark-evaluations
- ISO/IEC "ISO/IEC TR 42106:2026 Differentiated benchmarking of AI system quality characteristics"(2026年7月、技術報告書) — www.iso.org/standard/42106
- ISO/IEC "ISO/IEC TS 4213:2022 Information technology — Artificial intelligence — Assessment of machine learning classification performance"(2022年10月) — www.iso.org/standard/79799.html
- ISO/IEC "ISO/IEC TS 42119-2:2025 Artificial intelligence — Testing of AI — Part 2: Overview of testing AI systems"(2025年11月) — www.iso.org/standard/84127.html
- ISO/IEC "ISO/IEC TS 25058:2024 … SQuaRE — Guidance for quality evaluation of artificial intelligence (AI) systems"(2024年1月) — www.iso.org/standard/82570.html
- ISO/IEC "ISO/IEC 25059:2023 … SQuaRE — Quality model for AI systems"(2023年6月) — www.iso.org/standard/80655.html
- ISO/IEC "ISO/IEC 5259-2:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 2: Data quality measures"(2024年11月) — www.iso.org/standard/81860.html
- Mirza A. ほか "Are large language models superhuman chemists?", arXiv:2404.01475 (2024年4月; v2 2024年11月、ChemBench) — arxiv.org/abs/2404.01475
- Mathematical Association of America (MAA) "MAA Invitational Competitions"(AIME の説明、確認日 2026年10月15日) — maa.org/maa-invitational-competitions/
- OpenAI "Learning to reason with LLMs"(2024年9月12日。MATH・GSM8K で差別化できないとの記述) — openai.com/index/learning-to-reason-with-llms/
- Stanford CRFM "Holistic Evaluation of Language Models (HELM)"(公式サイトとリーダーボード一覧、Capabilities の最新リリース v1.15.0・2025年11月24日、確認日 2026年10月15日) — crfm.stanford.edu/helm/
14. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| NIST AI 800-2 初期公開草案:3段階・9実践、評価設定の4分類、比較可能性、費用と性能の併記、劣化した配信、評価の不正(grader gaming など)、canary string、汚染の低減策、統計・不確かさの実践、2026年1月・DOI、意見募集 | NIST の草案 PDF とニュースページ 出典33 https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.800-2.ipd.pdf 出典35 https://www.nist.gov/news-events/news/2026/01/towards-best-practices-automated-benchmark-evaluations | 事実 |
| 草案が2026年10月15日時点でも初期公開草案として掲載されていること、意見募集が2026年3月31日まで | NIST の Guidelines ページ(2026年9月30日更新) 出典35 https://www.nist.gov/news-events/news/2026/01/towards-best-practices-automated-benchmark-evaluations | 事実 |
| NIST AI 100-1(2023年1月)と MEASURE 機能の説明、自主的な枠組みであること | NIST AI RMF 1.0 出典34 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| MMLU:57科目、15,908問、テスト14,079問、各科目テスト最低100問、公開当時の結果 | Hendrycks ら 出典1 https://arxiv.org/abs/2009.03300 | 事実 |
| MMLU-Pro(10択、16〜33ポイント低下、プロンプト感度4〜5%→2%、CoT で改善)。MMLU-Redux(5,700問、誤り推定6.49%、Virology 57%) | Wang ら、Gema ら 出典2 https://arxiv.org/abs/2406.01574 出典3 https://arxiv.org/abs/2406.04127 | 事実 |
| GPQA の集合(Extended 546、main 448、Diamond 198)と正答率(専門家64.8%、非専門家34.1%) | Rein ら 出典4 https://arxiv.org/abs/2311.12022 | 事実 |
| HumanEval 164問、pass@k の不偏推定量(n=200、k≤100)。GSM8K 8.5K問、MATH 12,500問 | Chen ら、Cobbe ら、Hendrycks ら 出典5 https://arxiv.org/abs/2107.03374 出典6 https://arxiv.org/abs/2110.14168 出典7 https://arxiv.org/abs/2103.03874 | 事実 |
| AIME は15問、答えは0〜999の整数、I・II の2回の試験 | MAA のページ 出典43 https://maa.org/maa-invitational-competitions/ | 事実 |
| SWE-bench:2,294問・12リポジトリ・公開時の最高1.96%。Verified:500問、38.3%・61.1%・68.3% の注釈結果 | Jimenez ら、OpenAI の発表(2024年) 出典8 https://arxiv.org/abs/2310.06770 出典9 https://openai.com/index/introducing-swe-bench-verified/ | 事実 |
| OpenAI による Verified の報告停止(2026年2月23日):74.9%→80.9%、138問の監査、59.4%・35.5%・18.8%、ゴールドパッチの再現、SWE-bench Pro の推奨 | OpenAI の発表(2026年) 出典10 https://openai.com/index/why-we-no-longer-evaluate-swe-bench-verified/ | 事実 |
| SWE-Bench Pro(1,865問・41リポジトリ・3集合)。SWE-Bench Pro Verified の主張(査読前) | Deng ら、Zheng ら 出典11 https://arxiv.org/abs/2509.16941 出典12 https://arxiv.org/abs/2609.08149 | 事実 |
| LiveCodeBench(400問、2023年5月〜2024年5月)、LiveBench(月次更新、上位でも70%未満) | 各論文 出典13 https://arxiv.org/abs/2403.07974 出典14 https://arxiv.org/abs/2406.19314 | 事実 |
| HLE(2,500問、約1,000人の専門家、投稿前のモデル検証、約13,000問の審査、保持セット、o3-mini による判定、MMLU で90%超)、Nature 掲載日・巻号 | HLE の Nature 論文 出典15 https://doi.org/10.1038/s41586-025-09962-4 | 事実 |
| GSM1k(精度が最大8%低下、系統的な過学習の証拠、最前線は兆候が小さい) | Zhang ら 出典16 https://arxiv.org/abs/2405.00332 | 事実 |
| 言い換えによる汚染除去の回避、13B モデルの過学習、HumanEval の8〜18%の重複 | Yang ら 出典17 https://arxiv.org/abs/2311.04850 | 事実 |
| 汚染(Benchmark Data Contamination)の定義と整理 | Xu ら 出典18 https://arxiv.org/abs/2406.04244 | 事実 |
| 書式による最大76ポイントの差、モデル間での弱い相関、範囲で報告する提案 | Sclar ら 出典19 https://arxiv.org/abs/2310.11324 | 事実 |
| 評価ハーネスの経験と再現性の課題 | Biderman ら 出典20 https://arxiv.org/abs/2405.14782 | 事実 |
| 評価の統計(母集団からの抽出、2モデルの差、計画)、24ベンチマークの多くが統計的有意性を報告しないこと | Miller、BetterBench 出典21 https://arxiv.org/abs/2411.00640 出典22 https://arxiv.org/abs/2411.12990 | 事実 |
| LLM-as-judge の偏り(位置・冗長さ・自己強化)と80%超の一致 | Zheng ら(MT-Bench) 出典23 https://arxiv.org/abs/2306.05685 | 事実 |
| Chatbot Arena の方法(ペア比較、Bradley–Terry、24万票超、専門家との一致)、勝つ確率の式 | Chiang ら 出典24 https://arxiv.org/abs/2403.04132 | 事実 |
| Arena の運用方針:Arena-Rank、公開モデルのみ掲載、1,000票、暫定スコア、複数変種の試験、再重み付け | Arena の公式ポリシー(2026年9月1日更新) 出典26 https://arena.ai/blog/policy/ | 事実 |
| 「Leaderboard Illusion」の主張と、Arena の反論(約+11 Elo、オープンモデル40.9% など) | Singh ら、Arena の声明 出典25 https://arxiv.org/abs/2504.20879 出典27 https://arena.ai/blog/our-response | 事実 |
| HELM(7指標・16中核シナリオ・30モデル・42シナリオ)、HELM Capabilities(5課題・各1,000問・LLM 判定者の平均・Omni-MATH のプロンプト変更・選定基準)、リーダーボード一覧と最新リリース | HELM の論文・ブログ・公式サイト 出典28 https://arxiv.org/abs/2211.09110 出典29 https://crfm.stanford.edu/2025/03/20/helm-capabilities.html 出典45 https://crfm.stanford.edu/helm/ | 事実 |
| AILuminate v1.0(12の危険の区分、5段階、エントロピーに基づく評価、限界) | MLCommons の論文・ページ 出典30 https://arxiv.org/abs/2503.05731 出典31 https://mlcommons.org/ailuminate/ | 事実 |
| Inspect が UK AI Security Institute と Meridian Labs による OSS の評価フレームワークであること | Inspect のドキュメント 出典32 https://inspect.aisi.org.uk/ | 事実 |
| ISO/IEC TR 42106:2026、TS 4213:2022(DIS 4213 作成中)、TS 42119-2:2025、TS 25058:2024(AWI 25058 予定)、25059:2023、5259-2:2024 の番号・題名・発行年月・段階 | ISO の標準ページ 出典36 https://www.iso.org/standard/42106 出典37 https://www.iso.org/standard/79799.html 出典38 https://www.iso.org/standard/84127.html 出典39 https://www.iso.org/standard/82570.html 出典40 https://www.iso.org/standard/80655.html 出典41 https://www.iso.org/standard/81860.html | 事実 |
| ChemBench(2,700問超、最良モデルが最良の化学者を平均で上回った等の著者の報告) | Mirza ら 出典42 https://arxiv.org/abs/2404.01475 | 事実 |
| MATH・GSM8K でモデルを有効に差別化できないという OpenAI の記述 | OpenAI の発表(2024年) 出典44 https://openai.com/index/learning-to-reason-with-llms/ | 事実 |
| 正答率の標準誤差と95%区間(30/164/198/500/14,079問)、2モデルの差の区間、必要問題数(約160/650/4,000問)、pass@k の値(c=2:1.0/9.8/75.1%、c=10:5.0/40.9/99.9%)、Bradley–Terry の勝率(51.2/52.5/55.0/57.4/62.2%) | 本稿の計算。正答率・n・c は説明用の仮定で、特定のモデルの値ではない(正規近似・独立近似) | 本稿の計算 |
| 「ベンチマークは使い回すと劣化する」「点数を見たら確認する六つのこと」「自社評価の手順」「素材技術者の視点①〜④」、評価の四つの型の分類 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2・図3・図4・図5が説明用の作図であること、図1・図6がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
| Arena のスコア表示の尺度、HELM Capabilities のより新しい版、NIST AI 800-2 の最終版、素材分野の合意された評価基準、自社評価手順の有効性、SWE-Bench Pro Verified の内容の検証、規格の本文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない(本稿) | 解説 |
最終更新:2026年10月15日(確認日)/出典は一次情報(原論文、Nature 掲載論文、開発元・運営者の公式ページ、NIST・ISO の公式ページ)に限定しています。規格の本文は有料のため確認できていません。順位表やベンチマークの運用状況は変化が速く、確認日より後の状態は保証しません。 Arena のスコア表示の尺度、HELM Capabilities のより新しい版、NIST AI 800-2 の最終版、素材分野の合意された評価基準、自社評価手順の有効性、SWE-Bench Pro Verified の内容の検証、規格の本文は、確認できなかったため記載していません。 本文中の数値は、特定の版・設定・実施主体のものであり、モデルの優劣を示すものではありません。誤差の計算は説明用の仮定にもとづきます。 図2〜図5はベクター作図、図1と図6はImageGen生成の概念画像であり、いずれも実際の測定画面や製品を示すものではありません。