TECHNOLOGY EXPLAINER
スペクトル・画像データのAI解析
― 測ったデータを「読む」作業を、AIにどこまで任せられるか
X線回折(XRD)の波形、ラマンなどの分光スペクトル、電子顕微鏡の画像。材料の研究室では、毎日のように「測ったデータを読む」作業が発生します。この作業を、データから傾向を学んだAIに手伝わせる研究が増えています。 ところが、「正解率94%」のような数字は、何のデータで、どう分けて、何を正解としたかによって、意味がまったく変わります。この記事では、相の同定、組織の分類、ノイズ除去の3つの仕事を、図と小さな計算例でやさしく解説し、精度の主張を条件つきで読むコツまで整理します。
- 3行でわかる/読む前に/シリーズの中での位置
- 「測ったデータを読む」とは ― 波形と画像、AIの3つの仕事
- XRDの相同定 ― 従来の照合と、AI(CNN)の違い
- AIの学習データをどう用意するか ― 計算パターンと実測のずれ
- 精度の数字を、条件つきで読む
- 事例:自律実験室のXRD解析をめぐる議論
- 分光スペクトル(ラマン・X線吸収)への応用
- 顕微鏡像への応用 ― 組織の分類と塗り分け
- ノイズ除去 ― 消してはいけないものを消さない
- データの分け方と漏れ ― 本稿の計算
- 素材技術者の視点 ― 自社データをどう整え、どこで人が判断するか
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=改訂中・制定途中・提案段階などで、確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。
第3〜4章と第9〜10章の計算例は、本稿が作った合成データ(乱数の種を固定)です。実在の試料・装置の結果ではありません。論文の精度の数字は、各論文の報告値を条件とともに紹介するもので、手法や研究グループの優劣を決めるものではありません(条件が違うため比べられません)。 確認日は 2026年10月22日です。この分野は変化が速いため、モデルや規格の状態は確認日時点のものです。規格(ISO)は題名・適用範囲の確認にとどめ、本文は確認していません。
1. 3行でわかる/読む前に/シリーズの中での位置
- AIは「測ったデータを読む」作業の下書きをする:XRDの波形から「どの結晶が入っているか」を絞る(相の同定)、顕微鏡像を「どの組織か」で塗り分ける(分類)、ノイズを減らす、といった仕事に使われています事実[参考資料1・2・11]
- 精度の数字は条件つきでしか読めない:同じ「約9割」でも、計算で作ったデータか実測か、候補の数はいくつか、試料ごと分けたかで意味が変わります。自律実験室の解析をめぐっては、後から手作業で再解析され、数が訂正された例もあります事実[参考資料5]
- 最後に確かめるのは人と実験:AIは候補を絞り、確からしさ(確率)を出す道具です。「確率が低い」「候補にない相かもしれない」ときに、人が見て追加の測定をする運用が前提です
必要なのは、XRDや顕微鏡で測定した経験(あるいは結果を見た経験)だけです。機械学習の知識は要りません。次の3点だけ、先に頭に置いてください。
- 機械学習=「過去のデータから傾向を学ぶ近似器」:学習したデータの範囲の外(外挿)は苦手で、物理法則を理解しているわけではありません(詳しくは本シリーズ「機械学習とニューラルネットワークの基礎」編)
- 材料探索=「広大な地図の中から、宝のありかを探す」:AIは探す場所を絞る道具で、宝(本当に新しい材料)があるかを確かめるのは、合成と測定(実験)です
- 計算・実験・AIの分担:計算は「安く速く候補(や比較用のデータ)を出す」、実験は「本当にそうか確かめる」、AIは「探す場所を絞る・読む手間を減らす」。この記事では、この3者が測定データの解析でどう噛み合うかを見ます
本シリーズ「マテリアルインフォマティクス(MI)」の中で、この記事は「測定した後のデータ」をAIで読むことを扱います。測定を自動で回す話は「自律実験室」編と「高スループット実験とロボット合成」編、AIの結果の信頼性は「不確かさと適用範囲」編、結果の再現性は「MIの結果の評価と再現性の読み方」編で扱います。この記事は単独でも読めるよう、必要な前提を本文で説明します。
2. 「測ったデータを読む」とは ― 波形と画像、AIの3つの仕事
まず、身近な場面から考えます。XRDで粉末試料を測ると、角度と強さを並べた波形が出ます。この波形を見て、あなたは何をしていますか。おそらく、「このピークの位置は、あの相のものだ」「この小さな山は不純物かもしれない」と、頭の中の参照データと照らしています。顕微鏡像でも、「この白い針状の部分はセメンタイトだろう」と、経験に照らして区別しているはずです。
この「照らして区別する」作業が、AIにとっての仕事になります。データの種類は大きく2つ、波形(1次元)と画像(2次元)です。
| データ | 代表的な測定 | 知りたいこと | AIの仕事の名前 |
|---|---|---|---|
| 波形(1次元) | XRD、ラマン、赤外、X線吸収(XAS) | どんな相・化合物・局所構造が入っているか | 同定(何が入っているか当てる)、分類 |
| 画像(2次元) | 光学顕微鏡、SEM、TEM | どんな組織か、どこに欠陥・粒界があるか | 分類、分割(塗り分け)、検出 |
| どちらも | — | ノイズや背景を減らして、見たいものを見やすくしたい | ノイズ除去、補正 |
表の整理は本稿による導入のための分類です。
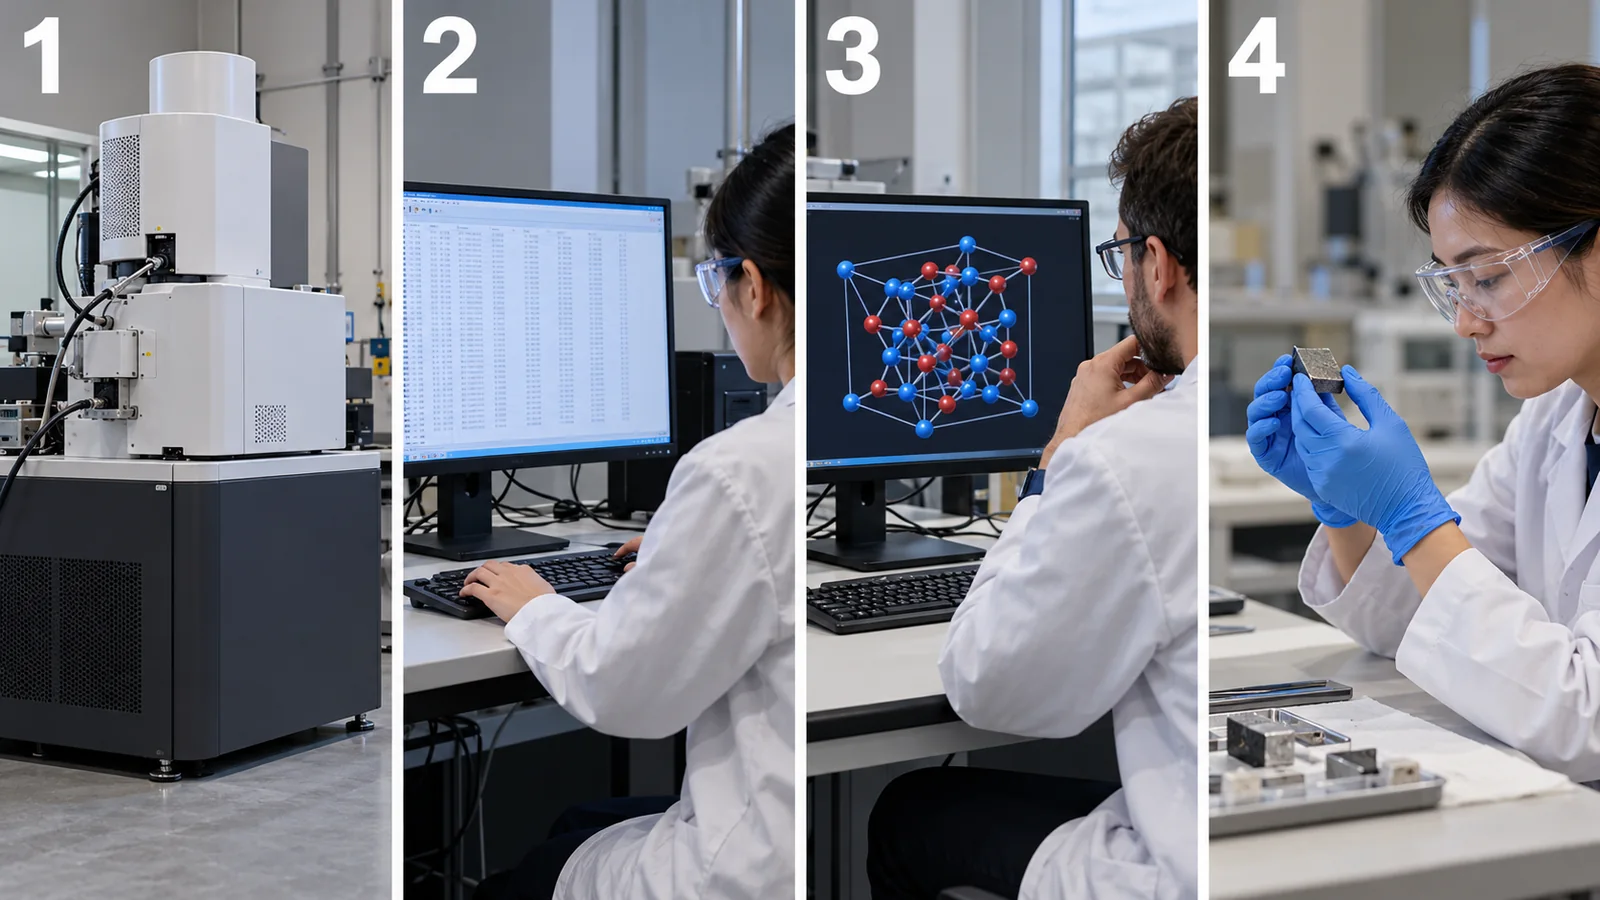
元のSVG・数値・出典を確認する
元SVGの説明:概念図(ベクター作図)。測定データをAIで読む流れ。AIが担当するのは③で、測定(①)と最後の判断(④)は人と実験の仕事のままです。分類は本記事による整理です。
分類は「この試料(画像全体)はどのタイプか」を1つ答えること、同定は「何が入っているか」を答えること(混合物なら複数)、分割は「画像のどの部分がどのタイプか」を画素ごとに塗り分けることです。たとえば、鋼の組織を「この画像はマルテンサイトが多い」と1つに決めるのは分類、「この領域がマルテンサイト、この領域がフェライト」と塗り分けるのは分割です。
3. XRDの相同定 ― 従来の照合と、AI(CNN)の違い
(1) まず、XRDの波形が「指紋」になる理由
結晶にX線を当てると、原子が規則正しく並んでいるため、特定の角度でだけ強い反射が起こります。反射が起こる角度は、結晶の中の面の間隔 d と、X線の波長 λ で決まります(ブラッグの式 nλ = 2d sinθ)。面の間隔は物質ごとに違うので、角度と強さを並べた波形(回折パターン)は、その結晶の「指紋」になります(本記事による解説)。
数字で確かめます(本稿の計算)。シリコンの格子定数は約5.431 Å(NISTの標準物質で証明された値は 0.5431109 nm[参考資料21])。(111)面の間隔は 5.431/√3 ≒ 3.136 Å です。Cu Kα線(波長1.5406 Å)なら、sinθ = 1.5406/(2×3.136) より θ ≒ 14.22°、つまり測定の角度(2θ)は 28.44° になります。
たとえとして「指紋照合」を使うと分かりやすくなります。指紋は人を特定する手がかりになります。ただし、たとえには限界があります。回折パターンは混合物では複数の指紋が重なってしまい、ピークが重なる場合には、どちらの相のピークか分からなくなることがあります。
(2) 従来のやり方:ピークを取り出して照合する
従来の「相同定」は、測ったパターンから、ピークの位置と強さを取り出し、標準のデータベース(たとえば、無料で公開されている Crystallography Open Database[参考資料25]や、有償のデータベース)の参照パターンと見比べる方法が基本です。専門のソフトウェアが似ている順に候補を並べ、最後は人が選びます。この方法は、Szymanski らの論文でも、プロファイル照合(profile matching)の代表として比較に使われています[参考資料2]。
(3) AI(CNN)のやり方:波形全体を入力して、確率を出す
AIの方法では、波形全体(たとえば、2θ が10°から80°までの4,501個の強さの数値[参考資料2])を入力し、「候補の相ごとの確からしさ」を出力します。ここで使われるのが畳み込みニューラルネットワーク(CNN)です。
CNNは、「小さな窓を波形に沿ってずらしながら、ピークらしい形を探す」装置だと考えてください。1段目では「尖っている」「裾が広い」といった小さな形を拾い、段を重ねるごとに「3本のピークが特定の間隔で並ぶ」のようなより大きな特徴を拾います。どの特徴を拾うかを、人が決めるのではなく、正解付きの大量のパターンから学習して決めるのが従来法との違いです。 たとえの限界:CNNが拾う「特徴」は、人が理解できる物理量(面間隔など)とは限りません。結果が合っていても、なぜ合っているのかを説明しにくい場合があります。
Szymanski らの方法では、同じ入力に対して、予測を1,000回繰り返して(ネットワークの一部の結合をランダムに外しながら)、各相が選ばれた割合を「確率」とみなしています[参考資料2]。この確率は、「どの結果を人が見直すべきか」を決める手がかりとして使えます。同論文では、計算で作った単相のテストで、確率が70%を超えた予測(テスト全体の84%)に絞ると、正解率が92%から96%に上がったと報告されています事実[参考資料2]。なお、この確率が実際の正解の頻度とぴったり合っているか(較正されているか)は、本稿では論文から確認できませんでした。
もっと詳しく:なぜ「候補の相をあらかじめ決める」必要があるのか
これらの方法は、答えの候補(参照相)があらかじめ決まっていることを前提にします。Szymanski らの評価では、Li–Mn–Ti–O–F系の255個の参照相(実験で報告された安定相140個+仮想的な固溶体115個)の中から答えを選ぶ設定でした事実[参考資料2]。候補にない相が試料に入っていたとき、AIは「候補の中でいちばん近いもの」を答えてしまいます。これは外挿が苦手という機械学習の一般的な性質の、XRDでの現れです(本記事による解説)。
4. AIの学習データをどう用意するか ― 計算パターンと実測のずれ
AIに学習させるには、「波形と、その正解(どの相か)」の組が大量に要ります。ところが、新しい材料や薄膜では、正解付きの実測データはほとんどありません。そこで多くの研究は、既知の結晶構造から計算で作った回折パターンを訓練データに使います。Oviedo らは結晶構造データベース(ICSD)から作った計算パターンを使い[参考資料1]、Szymanski らも同様です[参考資料2]。
ここに落とし穴があります。計算パターンは「理想の結晶」のもので、実測には3種類のずれが出ます。
- 位置のずれ:薄膜のひずみ、固溶(組成のずれ)、試料の高さのずれで、ピークの角度が動く
- 幅の違い:結晶の粒(結晶子)が小さいほどピークが広がる
- 強さの違い:結晶が特定の向きに並ぶ(配向)と、ピークの高さの比が変わる。薄膜では特に起きやすい[参考資料1]
Szymanski らは、こうしたずれをあらかじめ計算パターンに加えて学習データを増やしました(データ拡張)。具体的には、格子定数に最大±4%のひずみ、結晶子サイズ1〜100 nm に対応するピーク幅(Scherrerの式)、ピーク強度の最大±50%の変化です。1つの参照相あたり150本、255相で計38,250本の計算スペクトルを作っています事実[参考資料2]。Oviedo らも、薄膜に特有の配向や格子ひずみを考慮した「物理に基づくデータ拡張」を提案しています事実[参考資料1]。
図4の下の数字(本稿の計算)は、ずれの大きさの感覚をつかむためのものです。格子定数が1%変わるだけで、28°付近のピークが約0.3°動きます。±4%の拡張は、おおよそ±1.1°の動きに相当します。一方、Szymanski らは、拡張の範囲を超える大きな変化(大きな組成のずれなど)には対応できないと報告しています。実際、仮想的な固溶体を学習に加える前の評価では、計算パターン20本のうち正しく構造を当てたのは11本でした(加えた後は95%)事実[参考資料2]。
データ拡張の範囲(ひずみ±4%、結晶子1〜100 nm など)は、論文が想定した試料の範囲です。薄膜、粉末、焼結体、電極シートでは、ずれの出方が違います。たとえば電極シートは、集電体の金属のピークと、プラスチックや樹脂の広い背景が重なります(本記事による解説)。 自社の試料に使うなら、自社の典型的なずれ(試料ホルダー、配向、背景)を再現した学習データで検証し直すのが基本です。そのとき最も価値があるのは、手元の標準試料(既知の相)を、同じ装置・同じ条件で測ったデータです。装置の定規としては、NISTが証明した標準物質(シリコン粉末 SRM 640g など)があります[参考資料21]。
5. 精度の数字を、条件つきで読む
「正解率90%」は、一見分かりやすい数字です。ところが、何を正解とし、何を相手に、どのデータで測ったかを知らないと、意味が決まりません。ここでは、実際の論文の数字を、条件とともに読んでみます。
図5の数字を、1つずつ読み解きます。
| 報告 | データ(訓練/評価) | 報告された数字 | 読むときの注意 |
|---|---|---|---|
| Oviedo ら(2019)[1] | ICSDから作った計算パターン+実測の薄膜115試料(ハロゲン化金属、3種類の次元、7種類の空間群) | 交差検証で、次元93%、空間群89%。データ拡張により小さなデータで学習。XRDの取得間隔は0.16°(2θ)まで粗くしても精度が保たれ、5.5分以内に測定・分類できると報告事実 | 評価対象は、薄膜のハロゲン化金属という限られた系。試料115は少ない。交差検証の分け方の詳細は本稿では論文本文から確認できなかった |
| Szymanski ら(2021)[2](計算スペクトル) | Li–Mn–Ti–O–F系の140相。計算パターンにずれを混ぜ、学習80%・テスト20%(4,200本) | CNNは94%、市販のプロファイル照合ソフトJADEは78%(個別のずれを混ぜたテスト)。ずれを全部混ぜると、CNN 92%、JADE 68%事実 | 評価データも、学習データと同じ「計算で作ったもの」。実測での性能は次の行を参照 |
| 同(実測スペクトル)[2] | 同じ系の10材料を実測。単相(きれいな試料、背景・ノイズ・ピークのずれ・幅・強度の変化を意図的に加えた試料)と、2相・3相の混合 | きれいな試料は10相すべて正解。背景のある20本で1つ誤り(アナターゼ TiO₂)。ピークのずれは5/6。2相は10/10、3相は13/15(JADEは7/10、9/15)事実 | 測定数が10〜20本と少なく、1つの誤りが数字に大きく効く。1つの研究室・1つの装置・1つの化学系の結果 |
| 同(混合の計算スペクトル)[2] | 1,000本ずつの計算スペクトル。2相、3相(等量)、少量相(10〜30%) | 2相87%、3相78%。少量相に限ると64%、多量相は92%事実 | 少量の不純物相を見つけることが難しい。少量相の検出(相の数の判定)は93%と報告されるが、同定の正解率とは別の指標 |
| 先行研究(Szymanskiらの論文での紹介)[2] | Vecseiらが、計算パターンだけで学習したネットワークを、RRUFFの実測鉱物スペクトルに適用 | 正解率54%(Szymanskiらによる紹介)事実 | 私たちは原論文の本文を確認していない。「計算データだけで学習すると、実測では大きく落ちうる」ことを示す例として読む |
数字はすべて各論文の報告値。分類の比較は、条件が違う数字を並べたものであり、手法の優劣を決めるものではありません。
誤解:「CNNが94%、従来法(JADE)が78%だから、AIの方が優れている」
正しくは:この比較は、論文の著者が設計した条件(その化学系、その計算データ、その設定のJADE)での結果です。JADEの設定や参照データベースの選び方で結果は変わりえます。著者らは、AIが苦手な場面も報告しています。たとえば、単斜晶系や三斜晶系の低対称な相では、ピークが多く、広がると重なりやすいため誤りが多い(ピーク幅の影響による誤分類113本のうち82本)事実[参考資料2]。
使うときの結論:数字は「その条件で、その手法が動くことの確認」と読み、自社の試料で測り直すのが近道です。
追加の測定を「AIに決めさせる」試み
Szymanski らは別の論文で、測定装置とAIをつなぎ、測定の途中で結果を解析して、次にどの角度を丁寧に測るかを決める「適応的XRD」を報告しています。少量の物質を、短い測定時間で検出できたこと、固相反応の途中で一時的に現れる中間相を、一般的な実験室のXRD装置で追跡できたことが示されました事実[参考資料3]。測定とAIを組み合わせる方向は、本シリーズ「クローズドループ最適化」編・「自律実験室」編で扱います。
6. 事例:自律実験室のXRD解析をめぐる議論
精度の主張が、後から見直されることもあります。ここでは、中立に、公表された範囲だけを並べます。個人や研究グループを評価するものではありません。
| 時期 | 出来事 | 区分 |
|---|---|---|
| 2023年11月 | Szymanski らが、自律実験室「A-Lab」の報告を Nature に発表。粉末試料のXRDは、Materials Project(計算構造)やICSDの構造から学習した機械学習モデルで解析し、その結果を自動のリートベルト解析で確認したと記載。現在のオンライン版の要旨(後述の訂正を反映)は「57の標的から36の化合物を17日間で合成」[4] | 事実 |
| 2024年 | Leeman ら(PRX Energy)が、A-Labの合成生成物を検討し、解析上の問題点を指摘。「自動リートベルト解析はまだ信頼できない」「予測された化合物の3分の2は、既知の、元素が同じ位置を共有する無秩序な固溶体の可能性が高い」と主張[6] | 事実(批判側の主張) |
| 2026年1月19日 | 著者による訂正(Nature 650, E1)が公表。「新規性」の主張は、「予測プラットフォームにとって新しい」という意図が誤解されうるとして文章を修正。回折パターンを手作業で再解析し、報告された成功40件のうち36件を確認、4件はXRDだけでは決着しない(inconclusive)とした。この再解析は公表後に査読を受けた。訓練データに誤って含まれていた化合物1つを議論から削除[5] | 事実(著者の訂正) |
この表は公開された文書だけにもとづく整理です。批判と訂正の内容の当否は、本稿では判定しません。
この事例が教えるのは、AIの解析結果を「新しい相ができた」という結論に使うときの、確認の重さです。
- XRDだけでは決まらないことがある:元素が同じ位置を共有する無秩序な構造は、秩序構造と回折パターンが似ることがあります。別の測定(組成分析、電子顕微鏡、他の分光)での裏づけを取る設計にします
- 候補(参照)に何を入れたかが結果を決める:計算で予測した構造を参照に入れると、予測と似た相が答えになりやすい(本記事による解説)。無秩序な固溶体も候補に入れておく発想が必要です
- 学習データに評価対象が混ざらないように:訂正の中で、訓練データに誤って含まれていた化合物が削除されています。これは次の第10章のデータ漏れ(リーク)の実例の一つです
7. 分光スペクトル(ラマン・X線吸収)への応用
波形のAI解析は、XRDだけではありません。ここでは2つの例を、条件とともに挙げます。
- ラマン分光(物質の分子振動を見る分光):Liu らは、前処理(ベースラインの補正など)を行わなくても、CNNに生のラマンスペクトルから物質を識別させる方法を、RRUFF(鉱物の公開データベース[参考資料9])で評価しました。サポートベクターマシンなど他の機械学習より良い分類性能を報告しています事実[参考資料8]。ただし、評価は鉱物のデータベースでの結果で、分類性能の具体的な数字や、鉱物以外の材料での性能は、本稿では論文要旨の範囲を超えて確認していません。
- X線吸収分光(XAS。原子の周りの局所構造を見る):Torrisi らは、遷移金属酸化物の数千のスペクトルで、ランダムフォレスト(決定木を多数組み合わせた手法)が、原子の周りの配位数(4・5・6配位)や最近接距離、バーダー電荷(Bader電荷。原子に割り当てた電子の量)を予測できることを示し、スペクトルのどの領域が効いているかを調べました事実[参考資料7]。ここで使われたスペクトルは、実測ではなくFEFFという計算で作った理論スペクトルです(Materials ProjectやOQMDの計算構造に対して)[参考資料7]。実測のXASにそのまま適用できるかは、この研究の範囲では確かめられていません。
学習に使うデータが計算でできていると、大量に、正解(局所構造)つきで作れる利点があります。反面、計算が実測と違う部分(装置の分解能、試料のムラ、計算の近似)は、そのままAIに引き継がれません。実測への橋渡しがどれだけできているかは、手法ごとに確かめる必要があります。
8. 顕微鏡像への応用 ― 組織の分類と塗り分け
(1) 組織の分類:Azimi らの鋼の例
鋼の組織の判定は、熟練者が顕微鏡像を見て、マルテンサイトやベイナイトなどを区別する作業です。熟練者による判定には、主観や観察者の違いが入りえます。Azimi らは、低炭素鋼のSEM像から、画素ごとに種類を判定し、物体ごとに多数決で名前を決める方法を提案しました(図6)。4つの組織成分の分類で、正解率93.94%を報告し、同じデータでの先行の手法(48.89%)を上回ったとしています事実[参考資料11]。
この数字を読むときに押さえたいのは、画像の分け方です。論文では、学習が11枚、テストが10枚の画像で、物体の数としては学習2,831個とテスト2,262個でした。画像単位で分けており(同じ画像の物体が学習とテストにまたがらない)、これは第10章で見る漏れを防ぐ分け方です。一方で、著者自身が「概念実証」としており、ベイナイトの細かな分類(上部・下部など)は次の段階としています事実[参考資料11]。
(2) 組織の画像を「多様体」で整理する:DeCost らの超高炭素鋼
DeCost らは、超高炭素鋼を様々な熱処理で作った組織のSEM像のデータセットを公開し、画像の特徴量(SIFTという手法による特徴と、CNNによる特徴)を比べて、主要な組織成分と、焼なまし条件の分類を試みました。t-SNE という次元削減の手法で、組織と加工条件の関係を可視化できることも示しています事実[参考資料12]。同じ研究グループの関連論文[参考資料27]は、様々な熱処理で作った超高炭素鋼の顕微鏡像を、加工条件の情報とソースコードと一緒に公開し、画像から似た組織を探す検索や、組織と加工条件の地図を描く道具を示しています事実。材料の組織画像を、条件つきで共有する取り組みの例です。
(3) 原子分解能の像:欠陥を数える、動きを追う
Ziatdinov らは、原子が見える走査透過電子顕微鏡(STEM)像から、深層学習で原子の位置と種類、欠陥の種類を読み取りました。学習データにない欠陥も、原子の座標の情報から見つける「弱い教師あり」の方法で、グラフェン中のシリコン添加原子の配位の切り替えを追跡しています事実[参考資料10]。
(4) 塗り分け(分割)のためのモデルと、事前学習
画像を画素ごとに塗り分けるモデルの代表がU-Netです。少ない注釈付き画像でも学習できるよう、データ拡張を強く使う設計で、電子顕微鏡像の神経構造の分割コンテスト(ISBI)で、当時の最良の方法を上回ったと報告されました事実[参考資料14]。材料の顕微鏡像では、さらに、10万枚を超える注釈付き顕微鏡像(54種類の材料)で事前学習した「MicroNet」が報告されています。ImageNetで事前学習したモデルに比べ、撮影条件が違う画像への汎化が良く、少ない学習データでも精度が高く、ニッケル超合金の画像1枚だけで学習した場合に、IoU誤差が相対で72.2%減ったとされています事実[参考資料13]。
IoU(Intersection over Union)は、AIが塗り分けた領域と、人が塗った正解の領域が、どれだけ重なっているかを示す指標です。「重なった面積」を「両方を合わせた面積」で割ります。たとえば、正解の領域が100画素、AIの領域が80画素で、重なりが60画素なら、IoU = 60/(100+80−60) = 0.5 です(本稿の計算)。ここで、人が塗った「正解」も、塗る人によってぶれます。IoUが高いかどうかは、正解のぶれとの比較で読む必要があります(本記事による解説)。
9. ノイズ除去 ― 消してはいけないものを消さない
測定データにはノイズが乗ります。ノイズを減らせば、小さなピークが見つけやすくなり、AIへの入力もきれいになります。ところが、「ノイズ」と「信号」を区別するのは、簡単ではありません。ここでは、いちばん単純な方法(移動平均)で、何が起きるかを小さな計算で確かめます。
(1) 本稿の計算:平滑化を強くすると、ピークが潰れる
合成した波形(高さ100と80の近接した2本のピークと、高さ4の小さなピーク)にノイズを乗せ、窓の大きさを変えて移動平均をかけます。図8に結果を示します。
窓を小さく(5点)すると、ノイズは半分程度(1.51→0.72)になり、ピークの形はほぼ保たれます。窓がピーク幅(0.30°)と同じ大きさ(15点)になると、すでに高い方のピークの高さは約2割下がります(100→82)。窓を41点(0.82°)にすると、近接した2本のピークはほぼ1つの山になり、谷が埋まり、小ピークも埋もれます。 本稿の計算
同じ窓の大きさでも、方法によって違います。Savitzky と Golay が提案した方法(窓の中を多項式で当てはめて平滑化[参考資料18])では、本稿の計算で、窓15点・3次の場合、2本のピークは99と80、谷は10.8、小ピークは4.1と、形がよく保たれました本稿の計算。つまり、「ピークの形を保ちたいなら、単純な平均より、形を保つ性質のある方法を選ぶ」という設計判断が必要になります(本記事による解説)。
(2) AIによるノイズ除去:何を学んでいるのか
深層学習によるノイズ除去も、「何が信号か」を学習データから決める点では同じです。きれいな正解がなくても、ノイズの乗った2つの観測だけで学習する方法(Noise2Noise)が報告されています事実[参考資料16]。 一方で、顕微鏡像の再構成に関するレビューは、深層学習の課題として、訓練データの作り方、未知の構造を発見できるか、そして実在しない細部を「推測してしまう」危険を挙げています事実[参考資料17]。このレビューの対象は蛍光顕微鏡ですが、考え方は電子顕微鏡像やスペクトルにも当てはまります(本記事による解説)。電子顕微鏡へのディープラーニング応用の全体像は、レビュー[参考資料15]が整理しています。
誤解:見た目がきれいになった波形や画像は、元より正確な測定結果である。
正しくは:ノイズ除去は、情報を足すのではなく、「たぶんノイズだろう」と判断した成分を引く処理です。引きすぎれば信号が失われ(図8)、AIが学習した「もっともらしい形」で埋めれば、実在しない細部が現れる危険があります。
確かめ方:生データとノイズ除去後の波形・画像を必ず並べて保存し、定量に使うのは生データまたはその処理の影響を評価した値にします。
10. データの分け方と漏れ ― 本稿の計算
第5章の数字を読むときの最大のポイントは、評価に使うデータが、学習に使ったデータと「本当に別物」かです。ここで次の場面を考えます。同じ試料を6回測定したとします。この6本はよく似ています。もし、そのうち5本を学習に、1本を評価に使うと、AIは「見たことのある試料」を当てるだけでよく、実力以上の点数になります。これがデータ漏れ(リーク)です。一般的な研究でも、17の分野で、合わせて294本の論文に影響したと報告されています事実[参考資料19]。
本稿の計算で確かめます。似た3つの結晶型を想定し、各型について10の試料を作ります。試料ごとにピーク位置が±0.7°(標準偏差)ずれ、1試料を6回測定します(計180本)。分類は、いちばん近い学習データの型を答える単純な方法(最近傍法)です。2通りの分け方を比べます(図9)。
- A:測定1本ずつランダムに分ける(同じ試料の測定が学習と評価の両方に入りうる)
- B:試料ごと分ける(同じ試料の測定は、学習か評価のどちらかだけ)
結果は、Aでは30回すべて正解率1.00、Bでは平均0.75(0.48〜1.00)でした。あて推量は0.33です。本稿の計算。Aの数字は、「その試料を学習時に見ているから当たる」だけで、新しい試料での実力を表しません。Bのように「新しい試料」を評価するのが、実際の使い方(未知の試料を測る)に近い分け方です。
同じ試料の測定は、試料ごとの癖(ピークのずれ、結晶子サイズ、配向)を共有しています。この癖は、結晶の型とは無関係です。ところが、学習と評価の両方に同じ試料が入ると、AIは型ではなく「癖」で当てられます。実運用では毎回、新しい試料が来ます。したがって、評価も「新しい試料」で行う必要があります。同様に、同じバッチ・同じ日・同じ装置の測定も、癖を共有するので、まとめて分けるのが安全です(本記事による解説)。
11. 素材技術者の視点 ― 自社データをどう整え、どこで人が判断するか
- 測定条件を一緒に保存する:装置、X線源、スリット、ステップ幅、走査速度、試料ホルダー、試料の調製(粉砕・成形・薄膜)、日付、測定者。波形だけでは、ずれの原因が分かりません
- ラベル(正解)の根拠を残す:「この試料は相Aと判定した」の判定を、誰が・何で(リートベルト解析、別の分析)行ったかを記録します。ラベルが人の判断のぶれを含むなら、そのぶれがAIの精度の上限になります
- 失敗した測定、ずれの大きい測定も残す:AIは、きれいなデータだけで学習すると、現場のずれに弱くなります(第4章)。現場の「ずれ」の見本は貴重なデータです
- ロット・日付ごとに分けて評価する:第10章のとおり、分け方で精度が変わります。「来月のロット」を評価に取っておく設計が、最も実運用に近い確認になります
- 装置の定規を確かめる:標準物質で、ピーク位置と幅が装置として合っているかを定期的に確認します(例:NISTのシリコン粉末SRM 640g[参考資料21])。装置がずれていれば、AIの結果もずれます
AIに任せられる部分と、専門家の判断が要る部分
| 場面 | AIに任せやすい | 専門家の判断が要る |
|---|---|---|
| ルーチンの相確認 | 既知の相の組合せで、確率が高い場合の一次判定 | 確率が低い、候補にない相の疑い、新規の相の主張 |
| 少量相の検出 | 「第2の相がありそうか」の警告 | 少量相の同定(正解率が下がる[参考資料2])、含有量の定量 |
| 組織画像 | 大量の画像の前選別、領域の目安の塗り分け | 規格に基づく粒度や組織の最終判定(例:ISO 643[参考資料23]の方法での測定) |
| ノイズ除去・補正 | 可視化のための表示 | 定量に使うか、どこまで処理してよいかの判断 |
表は本稿による整理(解説)です。
12. 限界と、確認できなかったこと/まとめ
(1) 原著の本文を確認できなかった数字
Vecsei らの54%は、Szymanski らの論文での紹介にもとづきます。原論文の本文は確認していません。Raman(Liu ら)の具体的な正解率も、論文要旨の範囲を超えて確認していません。Ziatdinov ら、Torrisi ら、DeCost らは、題名と要旨の範囲で引用しました。
(2) 規格の本文
ISO 16700、ISO 643、ISO/IEC TS 4213 は、ISO のページで番号・題名・状態・適用範囲を確認しました。規格の本文(試験条件、手順、合否基準)は有料で、確認していません。X線回折分析の日本産業規格(JIS K 0131 など)は、確認日に番号・題名・現行版を公式の資料で確認できなかったため、記載していません。
(3) 扱っていないデータと手法
中性子回折、全散乱(PDF解析)、電子線回折、EBSD(電子後方散乱回折)、深層学習以外のスペクトル解析(主成分分析、非負値行列因子分解など)、基盤モデル(大規模モデル)によるスペクトル・画像解析は扱っていません。
(4) 企業の製品・ソフトウェア
測定装置メーカーや解析ソフトウェア企業の製品、およびその精度の主張は扱っていません(一次情報として確認していないため)。
(5) 日本国内の動向
国内の研究機関のデータ基盤やスペクトルデータベースは、この記事では調べていません。
- AIは、測定データの「読み」の下書きをします。XRDの相同定、ラマンやXASのスペクトル、顕微鏡像の分類と塗り分け、ノイズ除去が代表です事実
- 学習データは計算で作ることが多く、実測とのずれを加えて学習します。薄膜では配向、ひずみなどが効きます。1%の格子定数の違いで、28°付近のピークは約0.3°動きます事実/本稿の計算
- 精度の数字は条件つきで読みます。報告値は、計算データか実測か、候補の範囲、分け方、測定数で意味が変わります。少量相や低対称の相は難しい事実
- 解析結果を「新しい」という結論に使うときは、確認を重くします。自律実験室の例では、手作業の再解析で数が訂正されました事実
- 分け方で数字が変わります。合成データの例では、ランダム分割で1.00、試料ごとの分割で0.75でした本稿の計算
- ノイズ除去は情報を引く処理です。強すぎる平滑化は、近接したピークを潰します本稿の計算
13. 評価・標準の読み方
スペクトルや画像のAI解析の「良し悪し」は、まず正解の根拠(誰が、何で決めたか)、評価データの分け方(試料ごと・ロットごとか)、指標(正解率、少量相の見落とし、IoUなど)、比べる相手(ベースライン)の4つで決まります。数字は、これらを揃えて初めて比べられます。AI全般に通用する国際標準はありますが、「XRDの相同定にAIを使ってよい条件」を定めた標準は、確認できませんでした。ここでは、確認できた範囲を表にします(確認日 2026年10月22日)。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 分類の正解率 | 各論文が自前の評価データで報告(例:Oviedo らの交差検証[1]、Szymanski らの計算・実測スペクトル[2]、Azimi らの画像単位の分割[11])事実 | ISO/IEC TS 4213:2022 "Information technology — Artificial intelligence — Assessment of machine learning classification performance"(2022年10月発行。ISO のページで「改訂される予定」の段階。ISO/IEC DIS 4213 が次版として掲載)[24]事実未確定/将来 | 共通のベンチマークは確認できなかった。条件の違う数字の比較は不可 |
| 実測データでの汎化 | 公開された鉱物のラマン・XRD等のデータベース RRUFF(実測)[9]。計算データだけで学習し実測で評価した例(54%)[2]事実 | 確認できなかった | 計算データだけで学習すると、実測で落ちる可能性がある(第4・5章) |
| 参照データベース | Crystallography Open Database(COD。論文は Nucleic Acids Research 2012)[25]。有償のデータベースの中身は引用しない | 確認できなかった | 参照に何を入れたかで答えが変わる(第6章) |
| 顕微鏡像の分割・分類 | IoUなど。MicroNet の評価[13]、Warwick electron microscopy datasets(電子顕微鏡のデータセット)[26]、UHCSDB(超高炭素鋼の顕微鏡像)[27]事実 | 確認できなかった(AIの精度評価に特化した標準は確認できなかった) | 「正解」の塗り分けは人によってぶれる。画像単位・試料単位で分ける |
| XRD装置の確かさ | — | NIST SRM 640g(シリコン粉末。格子定数 a = 0.5431109 nm、拡張不確かさ ±0.000008 nm(k=2)、22.5 ℃)。NIST SP 260-245(2024年2月)[21]事実 | 装置の位置・幅の校正の物差し。AIの精度の標準ではない |
| SEM画像の倍率校正 | — | ISO 16700:2016 "Microbeam analysis — Scanning electron microscopy — Guidelines for calibrating image magnification"(第2版、2016年8月発行。2023年に見直し・確認)[22]事実 | 画像から長さ・粒径をAIで測るときの前提(倍率が正しいこと) |
| 鋼の粒度の測定 | — | ISO 643:2024 "Steels — Micrographic determination of the apparent grain size"(第5版、2024年8月発行)[23]事実 | AIで粒径を測る場合の比較対象になりうる従来法(本稿の解説)。AI手法を認める規格かは確認できなかった |
| データの再利用性 | FAIR原則(Wilkinson ら、2016)[20]事実 | (FAIRは原則であり、ISOなどの規格ではない) | 原則は推奨で、要求ではない。測定条件を含めて保存する根拠になる |
| データ漏れの点検 | Kapoor と Narayanan(2023)の漏れの整理と点検票[19]事実 | 確認できなかった | 分割の単位と前処理の手順を報告に書く |
表の整理は本稿の計算(整理)。ISO・NIST の番号・題名・版・状態は各公式ページで確認(確認日 2026年10月22日)。規格本文は有料のため、適用範囲の記載にとどめています。
読み方の注意(素材技術者向け)
- 論文の順位と、自社の試料での実力は別です:論文は著者が選んだ化学系・装置・条件の結果です。自社の標準試料と実際の試料で、試料ごと・ロットごとに分けて測り直してください
- 予測(AIの読み)と、実験での確認は別です:AIの出力は「候補と確からしさ」であり、新しい相の存在の証明ではありません。別の測定での裏づけを取る設計にします(第6章)
- 計算データで学習したAIは、評価も実測で:計算データで評価した数字は、計算データの作り方に依存します。実測の評価がない数字は、その分だけ割り引いて読みます
- 原則・規格の強さ:FAIR原則は推奨、ISO/IEC の規格は多くが任意の採用で、法令や契約で引用されて初めて拘束力を持ちます(後者は本記事による解説)。計画や改訂中の規格は未確定/将来として扱います
14. 用語集
- XRD(X線回折)
- X線を結晶に当て、反射の角度と強さから結晶の並びを調べる測定。
- 回折パターン
- XRDで得られる、角度(2θ)と強さの波形。結晶の「指紋」にたとえられる。
- ブラッグの式
- 反射が起こる条件 nλ = 2d sinθ。面間隔 d と波長 λ で角度が決まる。
- 相(phase)/相同定
- 試料中の結晶の種類/何が入っているかを特定すること。
- プロファイル照合
- 測ったパターンを参照パターンと重ねて比べる従来の方法。
- リートベルト解析
- 結晶構造のモデルから計算したパターンを、測定に合うように当てはめる解析。
- CNN(畳み込みニューラルネットワーク)
- 小さな窓をずらしながら局所的な形を拾う、波形や画像向けのAI。
- データ拡張
- 元のデータに変形やずれを加えて、学習データを増やす工夫。
- 配向(テクスチャ)
- 結晶が特定の向きに並ぶこと。ピークの高さの比が変わる。
- 結晶子/Scherrerの式
- X線に対して一体として振る舞う結晶の粒/ピークの広がりから結晶子の大きさを見積もる式。
- ラマン分光
- 光を当て、散乱光の波長のずれから分子の振動を見る測定。
- XAS/XANES
- X線吸収分光/そのうち吸収端付近を見て、原子の周りの局所構造や電子状態を調べる。
- ランダムフォレスト
- 多数の決定木を組み合わせて予測する機械学習の手法。
- 分類・分割(セグメンテーション)
- 画像全体を1つに分ける/画素ごとに種類を塗り分ける。
- IoU
- AIの領域と正解の領域の重なり具合(共通部分÷合併部分)。
- 事前学習/転移学習
- 別の大量データで先に学習し、手元の少ないデータに合わせて調整する方法。
- データ漏れ(リーク)
- 評価に使うべき情報が学習に入り込み、評価が過大になること。
- 交差検証
- データを何通りかに分けて、学習と評価を繰り返し平均する方法。
- Savitzky–Golay法
- 窓の中を多項式で当てはめて波形を平滑化する方法。
- 標準物質(SRM)
- 値が証明された、装置の校正用の物質。NISTのシリコン粉末など。
- FAIR原則
- データを見つけやすく、アクセスしやすく、組み合わせやすく、再利用しやすくする原則。
- MI(マテリアルインフォマティクス)
- データと計算、機械学習を使って材料の研究を効率化する方法。
15. 参考資料(一次情報)
- Oviedo F. ほか "Fast and interpretable classification of small X-ray diffraction datasets using data augmentation and deep neural networks", npj Comput. Mater. 5, 60 (2019), DOI 10.1038/s41524-019-0196-x(オープンアクセス) — nature.com/articles/s41524-019-0196-x
- Szymanski N. J., Bartel C. J., Zeng Y., Tu Q., Ceder G. "Probabilistic Deep Learning Approach to Automate the Interpretation of Multi-phase Diffraction Spectra", Chem. Mater. 33, 4204–4215 (2021), DOI 10.1021/acs.chemmater.1c01071(プレプリント arXiv:2103.16664 を本文の確認に使用) — arxiv.org/abs/2103.16664
- Szymanski N. J. ほか "Adaptively driven X-ray diffraction guided by machine learning for autonomous phase identification", npj Comput. Mater. 9, 31 (2023), DOI 10.1038/s41524-023-00984-y — nature.com/articles/s41524-023-00984-y
- Szymanski N. J. ほか "An autonomous laboratory for the accelerated synthesis of inorganic materials", Nature 624, 86–91 (2023), DOI 10.1038/s41586-023-06734-w — nature.com/articles/s41586-023-06734-w
- Szymanski N. J. ほか "Author Correction: An autonomous laboratory for the accelerated synthesis of inorganic materials", Nature 650, E1 (2026年1月19日), DOI 10.1038/s41586-025-09992-y — nature.com/articles/s41586-025-09992-y
- Leeman J. ほか "Challenges in High-Throughput Inorganic Materials Prediction and Autonomous Synthesis", PRX Energy 3, 011002 (2024), DOI 10.1103/PRXEnergy.3.011002 — doi.org/10.1103/PRXEnergy.3.011002
- Torrisi S. B. ほか "Random forest machine learning models for interpretable X-ray absorption near-edge structure spectrum-property relationships", npj Comput. Mater. 6, 109 (2020), DOI 10.1038/s41524-020-00376-6(オープンアクセス) — nature.com/articles/s41524-020-00376-6
- Liu J. ほか "Deep convolutional neural networks for Raman spectrum recognition: a unified solution", Analyst 142, 4067–4074 (2017), DOI 10.1039/c7an01371j — doi.org/10.1039/c7an01371j
- RRUFF project "RRUFF Database of Mineral Data"(公式サイト) — rruff.info
- Ziatdinov M. ほか "Deep Learning of Atomically Resolved Scanning Transmission Electron Microscopy Images: Chemical Identification and Tracking Local Transformations", ACS Nano 11, 12742–12752 (2017), DOI 10.1021/acsnano.7b07504 — doi.org/10.1021/acsnano.7b07504
- Azimi S. M. ほか "Advanced Steel Microstructural Classification by Deep Learning Methods", Sci. Rep. 8, 2128 (2018), DOI 10.1038/s41598-018-20037-5(オープンアクセス) — nature.com/articles/s41598-018-20037-5
- DeCost B. L., Francis T., Holm E. A. "Exploring the microstructure manifold: Image texture representations applied to ultrahigh carbon steel microstructures", Acta Mater. 133, 30–40 (2017), DOI 10.1016/j.actamat.2017.05.014(arXiv:1702.01117 を要旨の確認に使用) — arxiv.org/abs/1702.01117
- Stuckner J. ほか "Microstructure segmentation with deep learning encoders pre-trained on a large microscopy dataset", npj Comput. Mater. 8, 200 (2022), DOI 10.1038/s41524-022-00878-5(オープンアクセス) — doi.org/10.1038/s41524-022-00878-5
- Ronneberger O., Fischer P., Brox T. "U-Net: Convolutional Networks for Biomedical Image Segmentation", arXiv:1505.04597(MICCAI 2015) — arxiv.org/abs/1505.04597
- Ede J. M. "Deep learning in electron microscopy", Mach. Learn.: Sci. Technol. 2, 011004 (2021), DOI 10.1088/2632-2153/abd614 — doi.org/10.1088/2632-2153/abd614
- Lehtinen J. ほか "Noise2Noise: Learning Image Restoration without Clean Data", arXiv:1803.04189(ICML 2018) — arxiv.org/abs/1803.04189
- Belthangady C., Royer L. A. "Applications, promises, and pitfalls of deep learning for fluorescence image reconstruction", Nat. Methods 16, 1215–1225 (2019), DOI 10.1038/s41592-019-0458-z — doi.org/10.1038/s41592-019-0458-z
- Savitzky A., Golay M. J. E. "Smoothing and Differentiation of Data by Simplified Least Squares Procedures", Anal. Chem. 36, 1627–1639 (1964), DOI 10.1021/ac60214a047 — doi.org/10.1021/ac60214a047
- Kapoor S., Narayanan A. "Leakage and the reproducibility crisis in machine-learning-based science", Patterns 4, 100804 (2023), DOI 10.1016/j.patter.2023.100804(オープンアクセス) — doi.org/10.1016/j.patter.2023.100804
- Wilkinson M. D. ほか "The FAIR Guiding Principles for scientific data management and stewardship", Sci. Data 3, 160018 (2016), DOI 10.1038/sdata.2016.18 — doi.org/10.1038/sdata.2016.18
- Cline J. P. ほか "Certification of Standard Reference Material 640g: Line Position and Line Shape Standard for Powder Diffraction (Silicon Powder)", NIST Special Publication 260-245 (2024年2月), DOI 10.6028/NIST.SP.260-245 — doi.org/10.6028/NIST.SP.260-245
- ISO "ISO 16700:2016 Microbeam analysis — Scanning electron microscopy — Guidelines for calibrating image magnification"(ISO のページ) — iso.org/standard/65375.html
- ISO "ISO 643:2024 Steels — Micrographic determination of the apparent grain size"(ISO のページ) — iso.org/standard/82221.html
- ISO/IEC "ISO/IEC TS 4213:2022 Information technology — Artificial intelligence — Assessment of machine learning classification performance"(ISO のページ) — iso.org/standard/79799.html
- Gražulis S. ほか "Crystallography Open Database (COD): an open-access collection of crystal structures and platform for world-wide collaboration", Nucleic Acids Res. 40, D420–D427 (2012), DOI 10.1093/nar/gkr900 — doi.org/10.1093/nar/gkr900
- Ede J. M. "Warwick electron microscopy datasets", Mach. Learn.: Sci. Technol. 1, 045003 (2020), DOI 10.1088/2632-2153/ab9c3c — doi.org/10.1088/2632-2153/ab9c3c
- DeCost B. L. ほか "UHCSDB: UltraHigh Carbon Steel Micrograph DataBase", Integr. Mater. Manuf. Innov. 6, 197–205 (2017), DOI 10.1007/s40192-017-0097-0 — link.springer.com/article/10.1007/s40192-017-0097-0
16. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 薄膜XRDから次元と空間群を分類するCNN。計算パターンと実測115試料、物理に基づくデータ拡張、交差検証で次元93%、空間群89%、取得間隔0.16°(5.5分以内) | Oviedo ら(2019)の要旨・本文 出典1 https://www.nature.com/articles/s41524-019-0196-x | 事実 |
| Szymanski らの方法:計算パターンに物理に基づく拡張(ひずみ±4%、結晶子1〜100 nm、強度±50%)、255参照相(140+115)、38,250本、4,501点の入力、1,000回の予測で確率 | Szymanski ら(arXiv版の方法) 出典2 https://arxiv.org/abs/2103.16664 | 事実 |
| 計算スペクトルでCNN 94%・JADE 78%(ずれ混合で92%・68%)、確率70%超で92%→96%、上位3候補に99%、2相87%・3相78%、少量相64%・多量相92%、固溶体の追加で11/20→95% | Szymanski ら(結果の章) 出典2 https://arxiv.org/abs/2103.16664 | 事実 |
| 実測スペクトル:きれいな10相はすべて正解、背景20本で1誤り、ピークのずれ5/6、2相10/10・3相13/15(JADE 7/10・9/15)、ピーク幅による誤り113本のうち82本が単斜・三斜 | Szymanski ら(実測と結果の章) 出典2 https://arxiv.org/abs/2103.16664 | 事実 |
| Vecseiらが計算パターンで学習した網で、RRUFFの実測に54%(Szymanskiらによる紹介) | Szymanski ら(序論の記述)。原論文は未確認 出典2 https://arxiv.org/abs/2103.16664 | 事実 |
| 測定とAIを結んだ適応的XRD。微量相の検出と、固相反応の中間相の追跡 | Szymanski ら(2023)の要旨 出典3 https://www.nature.com/articles/s41524-023-00984-y | 事実 |
| A-Lab:XRDはMaterials Project・ICSDの構造で学習したMLで解析し、自動リートベルトで確認。現在の要旨は57標的から36化合物、17日間 | Szymanski ら(2023)の要旨・本文 出典4 https://www.nature.com/articles/s41586-023-06734-w | 事実 |
| 著者訂正(2026年1月19日):新規性の表現の修正、手作業の再解析で成功40件中36件を確認・4件は決着せず、再解析は公表後に査読、訓練データに誤って含まれた化合物1つを削除 | Nature 650, E1(Author Correction) 出典5 https://www.nature.com/articles/s41586-025-09992-y | 事実 |
| Leeman らの批判:自動リートベルト解析は信頼できない、予測化合物の3分の2は既知の無秩序な固溶体の可能性が高い(批判側の主張) | Leeman ら(PRX Energy)の要旨 出典6 https://doi.org/10.1103/PRXEnergy.3.011002 | 事実 |
| XANESスペクトルは、FEFFによる計算で作られ、ランダムフォレストが配位数・最近接距離・バーダー電荷を予測 | Torrisi ら(2020)の要旨・方法 出典7 https://www.nature.com/articles/s41524-020-00376-6 | 事実 |
| 前処理なしのラマンスペクトルをCNNで識別、RRUFFで評価、SVMなどより良い性能(要旨の範囲) | Liu ら(2017)の要旨 出典8 https://doi.org/10.1039/c7an01371j 出典9 https://rruff.info/ | 事実 |
| STEM像から原子の位置・種類・欠陥を深層学習で読み取り、学習データにない欠陥も弱い教師ありで検出 | Ziatdinov ら(2017)の要旨 出典10 https://doi.org/10.1021/acsnano.7b07504 | 事実 |
| 低炭素鋼の組織4分類、画素ごとの分類と多数決で93.94%(先行48.89%)、画像単位の分割(学習11枚・テスト10枚、物体2,831個と2,262個)、概念実証 | Azimi ら(2018)の要旨・本文 出典11 https://www.nature.com/articles/s41598-018-20037-5 | 事実 |
| 超高炭素鋼のSEM像データセット、SIFTとCNNの特徴の比較、t-SNEによる可視化 | DeCost ら(2017)の要旨 出典12 https://arxiv.org/abs/1702.01117 出典27 https://link.springer.com/article/10.1007/s40192-017-0097-0 | 事実 |
| MicroNet:10万枚超の注釈付き顕微鏡像(54種類)で事前学習、撮影条件の違う画像への汎化、IoU誤差72.2%減(ニッケル超合金1枚で学習) | Stuckner ら(2022)の要旨 出典13 https://doi.org/10.1038/s41524-022-00878-5 | 事実 |
| U-Netは少ない注釈付き画像で学習でき、ISBIの電子顕微鏡像の分割で先行の最良法を上回ったと報告 | Ronneberger ら(要旨) 出典14 https://arxiv.org/abs/1505.04597 | 事実 |
| 電子顕微鏡への深層学習のレビュー | Ede(2021)の要旨 出典15 https://doi.org/10.1088/2632-2153/abd614 | 事実 |
| Noise2Noise:ノイズの乗った例だけでの学習。深層学習の画像再構成の課題(訓練データ、未知構造の発見、実在しない細部の推測) | Lehtinen ら(要旨)、Belthangady と Royer(要旨) 出典16 https://arxiv.org/abs/1803.04189 出典17 https://doi.org/10.1038/s41592-019-0458-z | 事実 |
| 多項式の当てはめによる平滑化(Savitzky–Golay法)が提案されたこと(題名・書誌) | Savitzky と Golay(1964)の書誌 出典18 https://doi.org/10.1021/ac60214a047 | 事実 |
| データ漏れが17分野・合わせて294本の論文に影響したこと | Kapoor と Narayanan(2023) 出典19 https://doi.org/10.1016/j.patter.2023.100804 | 事実 |
| FAIR原則(Wilkinson ら、2016)の題名・書誌 | 論文の書誌 出典20 https://doi.org/10.1038/sdata.2016.18 | 事実 |
| SRM 640g:格子定数 a = 0.5431109 nm(22.5 ℃)、拡張不確かさ ±0.000008 nm(k=2)、約7.5 gのシリコン粉末、2024年2月 | NIST SP 260-245 の要旨 出典21 https://doi.org/10.6028/NIST.SP.260-245 | 事実 |
| ISO 16700:2016(2016年8月、2023年に見直し・確認)、ISO 643:2024(2024年8月)の番号・題名・状態 | ISO のページ 出典22 https://www.iso.org/standard/65375.html 出典23 https://www.iso.org/standard/82221.html | 事実 |
| ISO/IEC TS 4213:2022(2022年10月、改訂される予定の段階)と、次版 ISO/IEC DIS 4213 が掲載されていること | ISO のページ 出典24 https://www.iso.org/standard/79799.html | 事実未確定/将来 |
| COD の論文、Warwick electron microscopy datasets の論文の書誌 | 論文の書誌 出典25 https://doi.org/10.1093/nar/gkr900 出典26 https://doi.org/10.1088/2632-2153/ab9c3c | 事実 |
| シリコン(111)の2θ=28.44°、格子定数1%・4%の変化で−0.29°・−1.12°、結晶子100・10・1 nmで幅0.08°・0.82°・8.2°(Scherrer式、形状因子0.9)、IoU 0.5 の例 | 本稿の計算(ブラッグの式、Scherrerの式。格子定数5.431 Å、波長1.5406 Å)。実在の測定結果ではない | 本稿の計算 |
| 図8の平滑化の数字(窓5点・15点・41点、Savitzky–Golay窓15点・3次)、図9の最近傍法の正解率(1.00と平均0.75、0.48〜1.00) | 本稿の計算(Python・NumPy。合成データ、乱数の種を固定)。実在の測定結果ではない | 本稿の計算 |
| JIS K 0131 など日本産業規格の現行版、Vecsei らの原論文の本文、ラマンの具体的な正解率、確率の較正 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「外挿が苦手」「ずれの出方は試料ごとに違う」「別の測定での裏づけが要る」「単純な平均より形を保つ方法を選ぶ」「ISO/IEC規格の多くは任意の採用」という読み取りと、AIに任せやすい/専門家が判断する場面の整理 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2〜図6・図8・図9が実データの観察ではなく説明のための作図であること。図1と図7がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月22日/出典は一次情報(査読論文、arXiv の論文、NIST・ISO の公式ページ)に限定しています。ISO の規格本文は有料のため確認できていません。 計算例は本稿が作った合成データの計算で、実在の試料の結果ではありません。 JIS K 0131 など日本産業規格の現行版、Vecsei らの原論文の本文、ラマンの具体的な正解率、確率の較正については、確認できなかったため記載していません。 図はすべて説明用の概念図または本稿の計算を含む作図で、図1と図7はImageGen生成の概念画像です。