TECHNOLOGY EXPLAINER
Transformerと大規模言語モデル
― 「次のトークンを当てる」仕組みと、規模を読むときの注意
大規模言語モデル(LLM)は、それまでのトークンから次のトークンの確率を出すモデルを、大量のテキストで学習し、1トークンずつ生成するものです。中核の Transformer は、注意機構、前向き層(FFN)、残差接続と正規化を、層として重ねた構造です。 この記事では、トークン化、注意機構の計算(小さな数値例つき)、ブロックの構成と最近の変種、事前学習、自己回帰生成と KV キャッシュ、そして「モデルの大きさ」の読み方(総パラメータ数と有効パラメータ数、文脈長の宣言値)を、公式の論文・技術報告の範囲で整理します。主要モデルの系譜も扱いますが、モデル間の優劣は論じません。
- 大規模言語モデルとは何か(3行でつかむ)
- 言語モデルの基本 ― 次のトークンの確率と自己回帰
- トークン化 ― モデルが読むのは「文字」ではない
- 注意機構 ― 小さな数値例で追う
- Transformer のブロックと最近の変種、パラメータ数の検算
- 事前学習 ― 次のトークンを当てる学習
- 自己回帰生成、サンプリング、KV キャッシュ
- 規模の読み方 ― 密なモデル、混合専門家、非公表
- 主要モデルの系譜(公式資料の範囲)
- 限界と、確認できなかったこと/まとめ
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・改訂中などで、確定していない事項
このほか、材料研究への読み取りは「解説」として区別しています。推測は太字で示します。モデル名・サイズ・日付は確認日 2026年10月15日時点の公式資料の記載で、この分野は変化が速く、古い情報を「現在」とは読まないでください。
モデルのサイズ・文脈長・学習量は、各開発元が論文・技術報告で公表した値です。「公称」であり、実際の性能や実用の効率を示すものではありません。公表されていない値は「非公表」と書き、推計していません。 ベンチマークの数値は、名称・出典・設定を添えて示しますが、設定や実施主体が異なる数値を並べて優劣をつけることはしません。第3章・第4章・第5章・第7章の数値例は、本稿が計算したものです。
1. 大規模言語モデルとは何か(3行でつかむ)
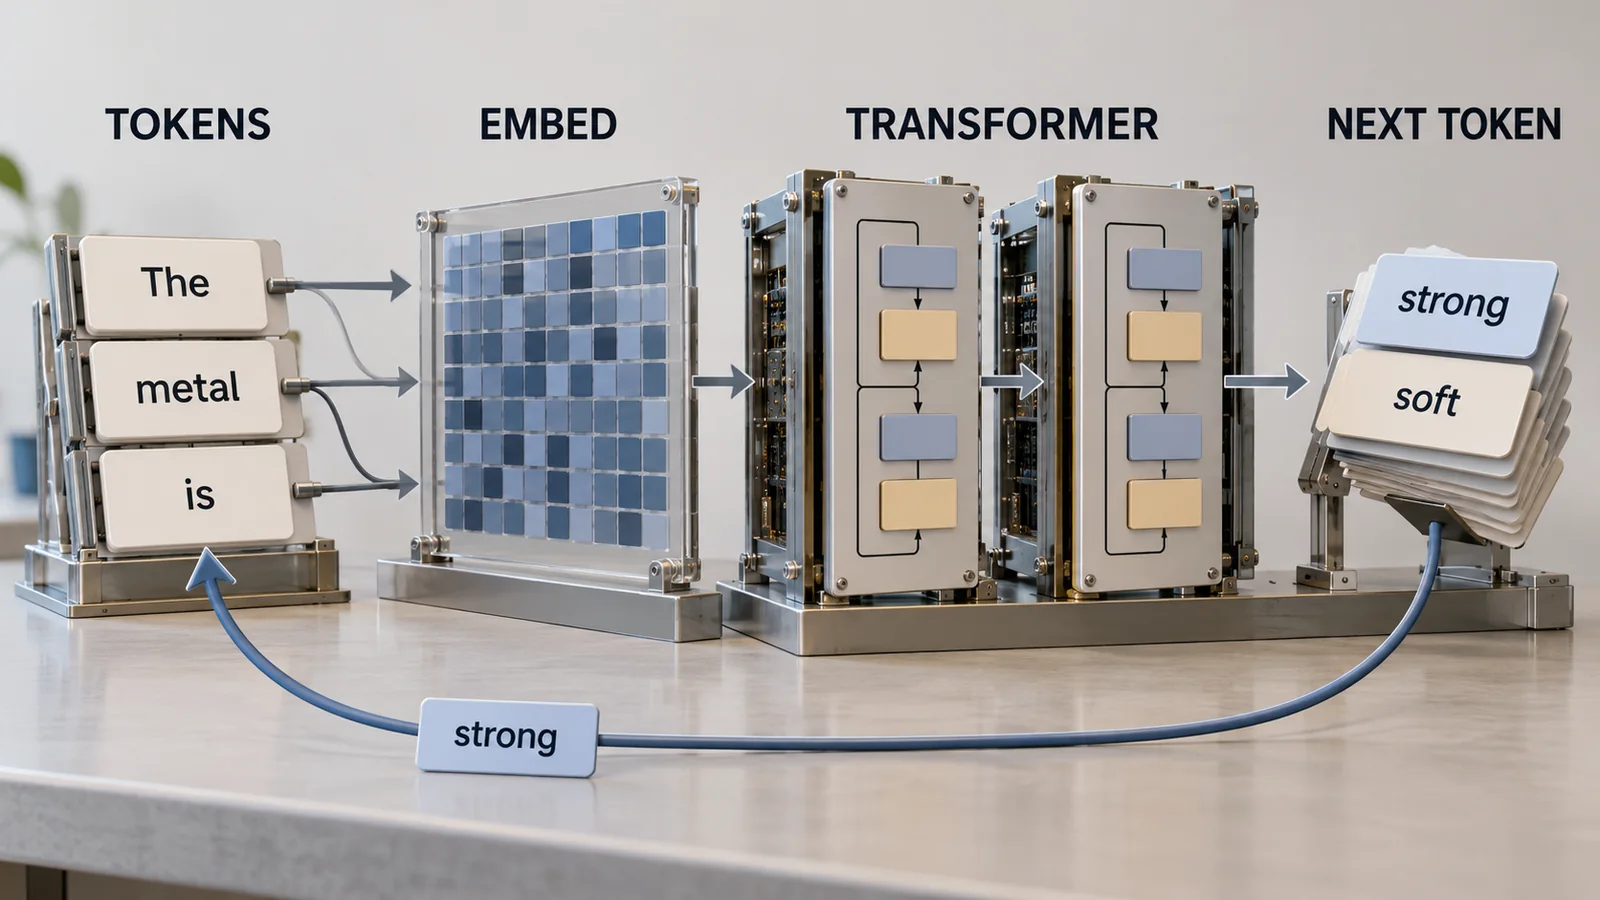
- 次のトークンを当てる:LLM は、それまでのトークン列から次のトークンの確率を出し、そこから1つ選んで末尾に足す、という操作を繰り返してテキストを作ります(自己回帰)。学習では、大量のテキストの「次のトークン」を当てるよう、パラメータを調整します
- 中核は Transformer:注意機構(どのトークンを参照するか)と前向き層(FFN)を、残差接続と正規化で包んで L 層重ねた構造です。パラメータ数は、層数と幅(次元)の2乗でおおむね決まります事実[参考資料1・11]
- 「大きさ」は1つの数字ではない:総パラメータ数、1トークンあたりに使う有効(活性)パラメータ数、文脈長(宣言値)、KV キャッシュの大きさは別の量です。モデルによっては、規模が公表されていません事実[参考資料17・18・21]
「何Bのモデル」という数字だけでは、計算量もメモリも決まりません。 混合専門家(MoE)の Mixtral 8x7B は、各トークンが47Bのパラメータにアクセスできるのに、実際に使う(活性な)パラメータは13Bです事実[参考資料17]。DeepSeek-V3 は総計671B、トークンごとの活性は37Bです事実[参考資料18]。 総数は「メモリに置く量」、活性数は「1トークンあたりの計算量」の目安になります(本記事による解説)。
2. 言語モデルの基本 ― 次のトークンの確率と自己回帰
テキストを、トークンの列 x₁, x₂, …, xT とみなすと、言語モデルは、その確率を「それまでのトークンから次のトークンの確率」の積に分けます。p(x₁…xT) = ∏ p(xt | x1…xt−1)。これが自己回帰です(本記事による解説)。 Vaswani らの Transformer は、デコーダで、後ろのトークンを参照できないよう注意にマスクをかけ、出力を1つずらすことで、位置 i の予測が、i より前の既知のトークンだけに依存するようにしています事実[参考資料1]。
元のSVG模式図・数値・出典注記を見る
Transformer には、原論文の encoder-decoder 型(翻訳向け)のほか、encoder だけを使う型(BERT など)と、decoder だけを使う型(GPT 系列など)があります。BERT は、双方向の Transformer を事前学習する構成として報告され事実[参考資料8]、GPT(2018年)は、12層の decoder-only の Transformer でした(768次元、12ヘッド、FFN は3072次元)事実[参考資料6]。T5 は、すべての課題を「テキストからテキスト」の形にそろえた encoder-decoder 型で、最大110億パラメータまで試されました事実[参考資料9]。現在の対話型 LLM の多くは decoder-only 型です(本記事による整理。個々のモデルの構造は各報告で確認してください)。
3. トークン化 ― モデルが読むのは「文字」ではない
モデルが処理するのは、文字や単語そのものではなく、トークン(語彙の中の1項目)の番号です。Sennrich らは、稀な語や未知の語をサブワードの列として符号化すれば、語彙を固定したまま、あらゆる語を扱える(open-vocabulary)と提案し、バイト対符号化(BPE)をこの目的に適用しました事実[参考資料3]。SentencePiece は、生のテキストから直接、サブワードの語彙を学習して符号化と復号を行う、言語に依存しないトークナイザです事実[参考資料4]。
語彙の大きさは設計の選択です。Llama 3 は、tiktoken の100Kトークンに、英語以外の言語を支えるための28Kトークンを加えた128Kの語彙を使い、Llama 2 のトークナイザに比べて、英語のサンプルの圧縮率が1トークンあたり3.17文字から3.94文字に上がった、と報告しています事実[参考資料14]。 一方、Petrov らは、同じ内容を訳した文章でも、言語によってトークン数が大きく違い、最大で15倍になる場合があり、多言語を意図して作ったトークナイザでもこの差が残る、と報告しています事実[参考資料5]。
文脈の長さ(入力として扱える量)や処理の量は、文字数ではなくトークン数で数えられます。同じ長さの文書でも、言語(日本語か英語か)や、トークナイザの作りによって、トークン数が変わります[参考資料5・14]。日本語の論文や特許を扱うときに、同じ内容の英語に比べてどれだけ多くのトークンを使うかは、使うトークナイザで実測して確認する必要があります(本記事による解説。具体的な倍率は、本稿では一次情報を確認していません)。
化学式、材料名、数値の並びがどう分割されるかも、トークナイザしだいです。細かく分割される場合があると推測しますが、本稿では確認していません。数値や単位を含む文章をモデルに読ませる前に、実際の分割を確かめるのが安全です。
4. 注意機構 ― 小さな数値例で追う
注意機構(attention)は、各トークンが、他のトークンのどれを、どれだけ参考にするかを決めて、その情報を混ぜる仕組みです。原論文は、Attention(Q, K, V) = softmax(QKᵀ / √dk) V を示しています。クエリ Q とキー K の内積を、√dk で割ってから softmax で重みにして、値 V を加重平均します事実[参考資料1]。√dk で割るのは、次元が大きいと内積が大きくなり、softmax が飽和した領域に入ってしまうのを避けるためと説明されています[参考資料1]。 原論文の基本モデルでは、モデルの次元は512、ヘッドは8つで、各ヘッドが別の射影で注意を計算し、結果をつなげます[参考資料1]。
- 3つのトークンで、Q = K とした最小の例です。スコア QKᵀ/√2 に因果マスクをかけて softmax すると、上の図の重みになります
- 1番目は自分しか見えないので重み1.00、3番目は自分に0.50、1番目と2番目に0.25ずつ重みを置きます。出力は、見える範囲の V の加重平均です(例:3番目は (0.99, 2.51))
- 表示の重みは小数第2位に丸めた値です。出力は丸める前の値から計算しています
本稿の計算。Python(NumPy)で、倍精度で計算。ベクトルは説明用の最小例で、実在のモデルの値ではありません。
(1) 位置の情報
注意機構そのものは、トークンの順序を区別しません。そのため、位置の情報を足す必要があります。原論文は、正弦波による位置符号化を使い、学習する位置埋め込みでもほぼ同じ結果だったと述べています事実[参考資料1]。その後、Su らの RoPE(回転位置埋め込み)が提案されました。絶対位置を回転行列で符号化しつつ、自己注意の式に、相対位置への依存を取り込む方法です事実[参考資料27]。Llama 3 は RoPE(θ = 500,000)を使っています[参考資料14]。
(2) 計算量とメモリ:文脈長の2乗
注意の計算は、文脈の中の全トークン対のスコア(n × n)を扱うので、文脈長 n に対して2乗で増えます。Kaplan らは、順伝播1回の計算量を Cforward ≈ 2N + 2·nlayer·nctx·dattn と見積もり(N は非埋め込みパラメータ数)、dmodel が nctx/12 より十分大きい場合には、文脈に依存する項は小さい、としています事実[参考資料11]。 この式に、Llama 3 405B の値(126層、d = 16,384、N ≒ 4.05×10¹¹)を入れると、文脈に依存する項が 2N に占める割合は、n = 8,192 で約4%、n = 131,072 で約67%です(本稿の計算。Kaplan の式を、nctx 全長で使った概算で、GQA・マスクによる削減や実装は考慮していません)。長い文脈では、注意の計算が無視できなくなります。
さらに、n × n のスコア行列を素朴にメモリに書き出すと、n = 131,072 では 1.7×10¹⁰ 要素、半精度(2バイト)で約34 GB(1ヘッド・1層あたり)になります(本稿の計算)。Dao らの FlashAttention は、この行列を丸ごと書き出さず、タイル(小さな塊)に分けて計算し、GPU の高帯域メモリ(HBM)とオンチップの SRAM の間の読み書きを減らす、厳密な注意の計算法です事実[参考資料30]。注意の計算は、演算量だけでなく、メモリ間のデータ移動で決まる、ということです。
5. Transformer のブロックと最近の変種、パラメータ数の検算
decoder-only の Transformer の1ブロックは、「正規化 → 注意 → 残差の加算」と「正規化 → FFN → 残差の加算」からなります。これを L 層重ね、最後に語彙全体へのスコアを出します。
原論文以降、構成部品のいくつかが置き換えられてきました。次の表は、LLaMA の報告が、先行モデルから取り入れた改良として挙げている部品を含め、原論文との違いを整理したものです事実[参考資料12]。
| 部品 | 原論文(2017) | その後よく使われる変種 | 報告されている狙い |
|---|---|---|---|
| 正規化の位置 | 各サブ層の出力の後(Post-LN)[1] | 各サブ層の入力の前(Pre-LN)。GPT-2・GPT-3・LLaMA・gpt-oss が採用[12・20] | 学習の安定化。Xiong らは、元の Post-LN では学習率のウォームアップが重要で、正規化の位置が効くと分析[24] |
| 正規化の関数 | LayerNorm[1] | RMSNorm(二乗平均平方根だけで正規化)[25]。LLaMA が採用[12] | 再中心化は不要と仮定し、計算を軽くする[25] |
| FFN の活性化 | ReLU[1] | SwiGLU(ゲート付き線形ユニット)[26]。LLaMA・Llama 3 が採用[12・14] | 性能の改善[12] |
| 位置の情報 | 正弦波の位置符号化[1] | RoPE[27]。LLaMA・Llama 3・gpt-oss が採用[12・14・20] | 相対位置への依存を取り込み、系列長に柔軟[27] |
| 注意のヘッド | マルチヘッド(MHA)[1] | マルチクエリ(MQA)[28]、グループ化クエリ(GQA)[29]。Llama 3 は KV ヘッド8つの GQA[14] | KV キャッシュを小さくし、推論時のメモリ帯域の負担を減らす[14・28]。GQA は MHA に近い品質で MQA に近い速度とされる[29] |
| FFN の疎化 | 密(全パラメータを使う) | 混合専門家(MoE):複数の FFN(専門家)から、トークンごとに数個を選ぶ[15・17] | 総パラメータ数を増やしつつ、1トークンあたりの計算を抑える[17] |
すべて事実(各原論文・技術報告)。どの部品の組み合わせが最良かは、本稿では判断していません。
パラメータ数の検算
Kaplan らは、標準の設定(dattn = dff/4 = dmodel)での非埋め込みパラメータ数を、N ≈ 12·nlayer·dmodel² と見積もっています事実[参考資料11]。公表された構成値で、この式と、部品ごとに数えた値を検算しました。
| モデル | 層数 L | 次元 d | 12·L·d² | 部品ごとに数えた値(本体) | 公称 |
|---|---|---|---|---|---|
| GPT-3 175B | 96 | 12,288 | 173.9 B | —(標準構成のため12Ld²で見積) | 175.0 B |
| Llama 3 8B | 32 | 4,096 | 6.44 B | 6.98 B(+埋め込み 0.52 B × 2 = 8.03 B) | 8 B |
| Llama 3 70B | 80 | 8,192 | 64.4 B | 68.45 B(+ 1.05 B × 2 = 70.55 B) | 70 B |
| Llama 3 405B | 126 | 16,384 | 405.9 B | 401.65 B(+ 2.10 B × 2 = 405.84 B) | 405 B |
本稿の計算。「部品ごとに数えた値」は、Llama 3 の公表値(層数、次元、FFN の次元 14,336/28,672/53,248、注意ヘッド 32/64/128、KV ヘッド 8、語彙128,000、SwiGLU)[参考資料14]から、注意(Q・K・V・出力の射影)と FFN(3つの行列)を数えたもので、入力と出力の埋め込みを別々に持つと仮定して語彙×次元を2回足しました。層正規化などの小さな項は除きます。公称の 8B/70B/405B は丸めた呼称です。GPT-3 は公表値(96層、d = 12,288)[参考資料10]。
検算から、次のことがわかります。標準構成の GPT-3 では、Kaplan の簡便式がほぼ当たります(173.9 B と公称175.0 B)。SwiGLU や GQA を使う Llama 3 では、簡便式は数%ずれ、部品ごとに数えた値のほうが公称に近くなります(本記事による解説)。パラメータの大半は、注意の射影行列と FFN の重み行列で、どちらも「次元の2乗」に比例する大きな行列です。層を深く、幅を広げるほど、重みの量は急に増えます。
6. 事前学習 ― 次のトークンを当てる学習
事前学習では、大量のテキストの各位置で「次のトークン」を当てるよう、クロスエントロピー損失(予測した確率の対数に基づく損失)を最小にする方向にパラメータを更新します(本記事による解説。Kaplan らも、言語モデルの性能をクロスエントロピー損失で測っています[参考資料11])。因果マスクにより、1本の文章の全位置の予測を並列に計算できます(第2章)。 学習の規模は、公表されているものでは、次のとおりです。
- GPT-3(175B):すべてのモデルを合計3,000億トークンで学習し、175Bモデルのバッチは320万トークン、文脈長は2,048でした事実[参考資料10]
- Llama 3:約15T(旗艦モデルは15.6T)の多言語トークンで事前学習。Llama 2 は1.8Tトークンでした。旗艦モデルの事前学習の計算量は 3.8×10²⁵ FLOP で、Llama 2 の最大版の約50倍。まず8Kトークンの文脈で学習し、続けて文脈を128Kトークンに拡張しています事実[参考資料14]
- DeepSeek-V3:全体の学習に H800 GPU を278.8万 GPU 時間使ったと、開発元が報告しています事実(開発元の公表値)[参考資料18]
学習の計算量は、おおよそ「6 × パラメータ数 × 学習トークン数」で見積もれます。Kaplan らは、順伝播が1トークンあたり約2N、逆伝播がその約2倍なので、学習は1トークンあたり約6N FLOP とし、総計算量を C ≈ 6N·B·S(B はバッチ、S は更新回数)と置いています事実[参考資料11]。この式を、公表値で検算します。
| モデル | パラメータ数 N | 学習トークン数 D | 6·N·D | 報告書の値 |
|---|---|---|---|---|
| GPT-3 175B | 1.75×10¹¹ | 3.0×10¹¹ | 3.15×10²³ FLOP | 3.14×10²³ FLOP(3,640 PF-day)[10] |
| Llama 3 405B | 4.05×10¹¹ | 1.56×10¹³ | 3.79×10²⁵ FLOP | 3.8×10²⁵ FLOP[14] |
本稿の計算。6ND は概算で、注意の文脈長依存の項や、実装による追加の計算は含みません。報告書の値はそれぞれの論文の記載です。学習データと計算量の関係は、本シリーズ「学習データとスケーリング則」編で詳しく扱います。
事前学習を終えたモデルは、文章の続きを書きますが、指示に従う、安全に振る舞う、といった調整はまだ十分ではありません。その調整(事後学習)は、本シリーズ「事後学習とファインチューニング」編で扱います。Llama 3 の報告も、事前学習の後に、人のフィードバックによる調整を何度か繰り返すと説明しています[参考資料14]。
7. 自己回帰生成、サンプリング、KV キャッシュ
(1) 確率から1つ選ぶ:サンプリング
生成では、モデルが出した語彙全体の確率から、次のトークンを1つ選びます。最も確率の高いものを選ぶ(貪欲法)、複数の候補を並べて探す(ビーム探索)などの、確率を最大化する復号法は、退屈で一貫性がなかったり、同じ文を繰り返したりする「退化」を起こすことがあります。Holtzman らは、確率の低い裾を切り落とし、確率の大部分を含むトークンの集まり(核)から選ぶ核サンプリング(top-p)を提案しました事実[参考資料32]。温度(確率分布の尖り具合を調整する値)や top-p などの設定で、同じ入力でも出力は変わります(本記事による解説)。
(2) KV キャッシュ:過去の K と V を覚えておく
1トークンずつ生成するとき、過去のトークンの K と V は変わらないので、毎回計算し直さず、保存して再利用します。これが KV キャッシュです。Pope らは、各層の注意のキーと値のテンソルを KV キャッシュと呼び、デコードの間はメモリに保持する必要がある、と説明しています事実[参考資料31]。Shazeer は、1トークンずつ進める推論は、大きなキーと値のテンソルを繰り返し読み込むメモリ帯域のコストで遅くなる、として、キーと値をヘッド間で共有するマルチクエリ注意を提案しました事実[参考資料28]。
KV キャッシュの大きさは、2(K と V)× 層数 × KV ヘッド数 × ヘッド次元 × 1要素のバイト数 × トークン数(1系列あたり)です。Llama 3 405B(126層、KVヘッド8、ヘッド次元 16,384/128 = 128)を bf16(2バイト)で動かすと、1トークンあたり 516,096 バイト(約0.52 MB)、128Kトークン(131,072)の1系列で約67.6 GB(63 GiB)です。仮に、KV ヘッド数が注意ヘッド数と同じ128(マルチヘッド注意)なら、同じ長さで約1.08 TBになります(本稿の計算)。
重み自体も大きく、405B を bf16 で持つと約810 GB、70B で約140 GB、8B で約16 GB です(本稿の計算。パラメータ数×2バイト。量子化や圧縮は考慮していません)。Pope らは、モデルのパラメータが1枚のアクセラレータのメモリに収まらないのが一般的であることを、推論の難しさの一因として挙げています[参考資料31]。
1トークンを生成するたびに、モデルは過去の K・V(KV キャッシュ)を読みます[参考資料28]。重みの読み出しも、バッチが小さいときは律速になりやすいと考えられます(本記事による解説)。そのため、推論の速さは、演算器の数よりメモリの帯域と容量で決まる場面が多くなります。
GQA のように KV キャッシュを小さくする設計(上の試算では、128Kトークンで1.08 TB が67.6 GB に、約16分の1)や、FlashAttention のようにメモリ間のデータ移動を減らす計算法[参考資料30]は、同じ問題をソフトウェア側から解く工夫です。ハードウェア側の解が、HBM の積層、2.5D パッケージ、熱を逃がす界面材料です。本シリーズ「HBM」編、「CoWoS」編、「熱界面材料TIM」編、「AIアクセラレータ」編で扱っています(本記事による解説)。
生成は確率的で、もっともらしいが誤った内容が出ることがあります。NIST の生成AIプロファイルは、この「confabulation(作話)」を、自信をもって述べられた、しかし誤った、あるいは偽の内容(俗に「幻覚」)と定義し、生成AI特有のリスクの一つに挙げています事実[参考資料49]。自然言語生成の「幻覚」の調査も、評価指標と対策、課題を整理しています[参考資料34]。 材料の物性値、論文の引用、規格の番号、特許の番号は、必ず元の文献で確認してください(本記事による解説)。
また、長い文脈を扱うモデルでも、必要な情報が入力の真ん中にあるときに、性能が大きく下がることが報告されています。関連情報が先頭か末尾にあるときに最も高く、真ん中に置くと著しく下がる、U字の傾向です事実[参考資料33]。宣言された文脈長(例:128K)と、その長さで情報をどれだけ使えるかは別です(本記事による解説)。長い資料を読ませるときは、重要な条件を冒頭か末尾に置く、要点を分けて質問する、といった工夫が有効かもしれませんが、効果は自分のタスクで確かめる必要があります。
8. 規模の読み方 ― 密なモデル、混合専門家、非公表
次の表は、公式の論文・技術報告が記載している規模を、そのまま整理したものです。異なるモデルの優劣は、この表からは読み取れません(学習データ、学習量、事後学習、評価の設定が違うため)。
| モデル | 公表年 | 構造 | 総パラメータ数 | 1トークンあたりの有効(活性)パラメータ数 | 文脈長(宣言値) | 出典 |
|---|---|---|---|---|---|---|
| GPT-3 | 2020 | 密(decoder-only) | 175 B | 全部(密) | 2,048 | [10] |
| PaLM | 2022 | 密(densely activated) | 540 B | 全部(密) | 本稿では確認せず | [23] |
| Llama 3 405B | 2024 | 密 | 405 B | 全部(密) | 128K(8Kで事前学習後、継続事前学習で拡張) | [14] |
| Mixtral 8x7B | 2024 | MoE(各層8専門家から2つ) | 47 B | 13 B | 学習時 32k | [17] |
| DeepSeek-V3 | 2024 | MoE | 671 B | 37 B | 128K(32K、128K と2段階で拡張) | [18] |
| Qwen3-235B-A22B | 2025 | MoE(128専門家から8つが活性) | 235 B | 22 B | 128K | [19] |
| gpt-oss-120b | 2025 | MoE(128専門家から上位4つ) | 116.8 B | 5.1 B | 131,072(密な層を YaRN で拡張) | [20] |
| GPT-4 | 2023 | 技術報告書は、構造(モデルサイズを含む)、ハードウェア、学習計算量、データセットの構築などの詳細を含まない、と明記 | [21] | |||
| Gemini 1.0(Ultra・Pro) | 2023 | Transformer デコーダを基盤 | 報告書の表に記載なし(Nano は1.8B・3.25B) | 32k(学習で対応) | [22] | |
すべて事実(開発元の公表値)。B=十億。文脈長は各資料の表記のまま。確認日 2026年10月15日。2025年以降に出た他のモデルや、2026年の新しい世代は網羅していません。
読み方の注意
- 総数と活性数:MoE は、総パラメータ数のぶんだけ重みを置く必要がある(メモリ)一方、1トークンの計算は活性パラメータ数に比例します(計算量)。どちらか一方だけで規模を語らないでください(本記事による解説)
- 文脈長は宣言値:表の文脈長は、設計・学習で対応した長さの宣言です。長い文脈で情報を使える度合いは別に評価が必要で、真ん中の情報で性能が下がる報告があります[参考資料33]
- 非公表は非公表として扱う:GPT-4 の技術報告書は規模を明記しません[参考資料21]。規模の推計は、本稿では書きません
9. 主要モデルの系譜(公式資料の範囲)
Transformer まわりの流れを、大きな系列に分けて並べると、次の図のようになります。年は、論文・技術報告の公表年です。系列の中の矢印は、時間の順序を示すもので、一方が他方を改良した、あるいは優れていることを意味しません。
- 注意機構の導入(2014年):Bahdanau らは、機械翻訳で、デコードの各ステップで入力の関連する部分を(ソフトに)探す仕組みを提案しました事実[参考資料2]。2017年に Transformer が、再帰や畳み込みを使わず、注意だけに基づく構造を示しました[参考資料1]
- 事前学習モデルの大型化(2018〜2020年):GPT(2018年)[6]、BERT(2018年)[8]、GPT-2(2019年、最大1.5B)[7]、T5(2019年)[9]、GPT-3(2020年、175B)[10]と、規模と用途の幅が広がりました。GPT-3 の報告は、課題ごとの微調整なしの少数ショット設定で性能を調べました[10]
- 公開された重みの系列(2023年〜):LLaMA は7B〜65B、Llama 2 は7B〜70B、Llama 3 は8B〜405B と報告されています[12・13・14]。LLaMA の報告は、公開されているデータだけで学習したモデルを示した点を強調しています[12]
- 混合専門家(MoE)の流れ:疎に活性化する MoE 層(2017年、最大1,370億パラメータ)[15]、Switch Transformer(最大1兆パラメータ)[16]、Mixtral[17]、DeepSeek-V3[18]、Qwen3[19]、gpt-oss[20]と続きます
- 規模が非公表のモデル:GPT-4(2023年)と Gemini 1.0(2023年)の報告は、モデルの構造や規模の詳細を、少なくとも一部は記載していません[21・22]
この分野は世代交代が速く、確認日 2026年10月15日時点で、本稿は2025年までの主要な公式資料の範囲を扱っています。2026年に公開されたモデルは網羅しておらず、確認できていません。
10. 限界と、確認できなかったこと/まとめ
(1) 新しいモデル
本稿が表にしたのは、2025年までの主要な公式資料です。2026年に公開されたモデルや、各社の最新の世代は確認していません。モデル名・サイズ・文脈長は、確認日(2026年10月15日)より後に変わりえます。
(2) 規模が非公表のモデル
GPT-4 や Gemini 1.0 の Ultra・Pro などは、規模が公式資料に書かれていません。報道や推計の値は使っていません。
(3) ベンチマークの数値
本稿はベンチマークの設計と読み方を整理し、モデルごとの得点は載せていません。設定や実施主体が異なる数値を並べて優劣をつけないためです。
(4) 扱っていない内容
最適化の細部、初期化、量子化・蒸留などの効率化(本シリーズ「モデルの効率化」編)、推論の最適化とサービング(同「推論の最適化とサービング」編)、状態空間モデルなど Transformer 以外の系列は扱っていません。
(5) トークナイザの実測
日本語の文書が英語の文書に比べて何倍のトークン数になるか、化学式や数値がどう分割されるかは、一次情報を確認していません。
(6) 規格の本文
ISO/IEC 22989、23053、42001、23894 の本文は有料のため確認していません。題名・番号・発行年月の確認にとどめています。
- LLM は、次のトークンの確率を出して1つ選ぶ操作を繰り返します。中核は、注意機構と FFN を残差・正規化で包んだ Transformer です事実
- 注意は、Q と K の内積から重みを作り、V を加重平均します。計算は文脈長の2乗で増え、長い文脈では無視できなくなります(405B で文脈項が 2N の約4%から約67%へ)事実/本稿の計算
- パラメータの大半は、次元の2乗に比例する大きな行列です。簡便式 12Ld² は標準構成でほぼ当たり、SwiGLU・GQA の構成では数%ずれます本稿の計算
- 生成はメモリの読み出しの仕事です。Llama 3 405B の KV キャッシュは、128Kトークン・1系列で約67.6 GB(KV ヘッド8の GQA)。重みは bf16 で約810 GB本稿の計算
- 「大きさ」は総数・活性数・文脈長(宣言値)で読みます。非公表の規模は推計しません。確認日を添え、異なるモデルの優劣は論じません事実
11. 評価・標準の読み方
言語モデルの評価は、事前学習の損失(パープレキシティ)、課題別のベンチマーク(知識、コード、数学、長文脈など)、人の選好による比較、そして学習・推論の速度の測定に分かれます。どれも、設定(ショット数、プロンプト、ツールの有無、サンプリング、実施主体)で数字が変わるため、名称・版・設定を添えて読みます。第三者の順位表は、方法と日付を確認したうえで参考値として扱います。 安全性とリスクは、数字だけで決まらず、標準・指針(ISO/IEC、NIST)が組織の運用や評価の枠組みを示します。確認できた範囲を表にします(確認日 2026年10月15日)。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典・設定) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 事前学習の損失 | クロスエントロピー損失(パープレキシティ)。Kaplan らは損失をパラメータ数・データ量・計算量で整理[11]。MLPerf Training の LLM 課題は、C4 データで「log perplexity の目標値」に達するまでの時間を測る(参照モデルの例:Llama 3.1 405B で目標 5.6。ページ記載の最新版 v6.0)[43]事実 | 確認できなかった | 損失はトークナイザごとに単位が違うため、異なるトークナイザのモデルの損失を直接比べない(本記事による解説) |
| 知識・推論の総合評価 | MMLU(57課題)[35]。BIG-bench(204課題、450人の著者、132機関)[36]。HELM(16の中核シナリオを7つの指標で測り、評価条件をそろえる)[37]。MMLU-Pro(選択肢を4から10に増やし、推論重視の問題を加えた拡張。著者は MMLU 比で精度が16〜33%下がると報告)[50]事実 | 確認できなかった | ショット数・プロンプト・実施者で値が変わる。MMLU 系の飽和(上位の差が見分けにくい)が拡張版の動機[50] |
| コード生成 | HumanEval(164問の手書き問題、単体テストで関数の正しさを判定。pass@k)[38]事実 | 確認できなかった | pass@k は、1問あたりに生成する試行数に依存する |
| 数学の文章題 | GSM8K(約8,500問)[39]。GSM1k(1,205問を新規に作成し、GSM8K との差で記憶・過学習を調べる。一部のモデルで精度が最大8%下がったと報告)[40]事実 | 確認できなかった | 公開ベンチマークは学習データに混入しうる(汚染)[40・42] |
| 人の選好 | Chatbot Arena(匿名のペア比較に利用者が投票。論文時点で24万票超)[41]。第三者の順位表は参考値。順位を事実として断定しない事実 | 確認できなかった | 投票者と質問の集団に依存する。順位は日付と方法を確認して読む |
| 長い文脈の使い方 | 関連情報の位置を変えて性能を測る分析(Liu ら)。先頭・末尾で高く、真ん中で下がる U 字[33]事実 | 確認できなかった | 宣言された文脈長は、実効の性能とは別 |
| ベンチマーク汚染 | テストデータの暗号化・学習からの除外要求などの対策の提案(Jacovi ら)[42]。新規の問題で測り直す方法(GSM1k)[40]事実 | 確認できなかった | 汚染の有無は、外からは確認しにくい |
| 学習の速度 | MLPerf Training:品質目標に達するまでの学習時間。結果にはおおよそ±5%(画像系は±2.5%)のばらつきがあると、ページに記載。Closed 区分(同じモデルで比較)と Open 区分、提出区分(Available/Preview/RDI)がある[43]事実 | 確認できなかった | システム構成・ソフトウェア・版を確認する。区分の違う結果を並べない |
| 推論の性能 | MLPerf Inference: Datacenter(ページ表示は v6.1)。シナリオ別の遅延制約・スループット指標と品質目標を定める。電力は、システム全体の壁での AC 電力[44]事実 | 確認できなかった | TDP や電源の定格など、MLCommons が測定・検証しない値は含まれない(ページの記載) |
| 概念・用語/リスク管理・運用 | — | ISO/IEC 22989:2022(AI の概念と用語)[45]、ISO/IEC 23053:2022(機械学習を使う AI システムの枠組み)[46]、ISO/IEC 42001:2023(AI のマネジメントシステム)[47]、ISO/IEC 23894:2023(AI のリスク管理の指針)[48]。NIST AI 600-1(生成AIプロファイル、2024年7月。12のリスクを定義し、confabulation を含む)[49]事実 | 多くは任意の採用。本文は未確認で、要求事項は書いていない |
表の整理は本稿の計算(整理)。ISO/IEC の番号・題名は ISO の公式ページで、NIST AI 600-1 は NIST の文書で確認(確認日 2026年10月15日)。規格の本文は有料のため、題名・適用範囲の記載にとどめています。MLPerf のページの版は、確認日時点の表示です。
読み方の注意(素材技術者向け)
- ベンチマーク値は、設定と実施主体で変わります:ショット数、プロンプト、ツールの使用、サンプリング、思考の長さ、評価の実施者(開発元か第三者か)が違う数字を並べて、優劣をつけないでください。開発元の技術報告の数字は、その開発元が選んだ設定の結果です
- 飽和と汚染に注意:公開ベンチマークは、上位の差が見分けにくくなり(飽和)、学習データに混入する(汚染)ことがあります[参考資料40・42・50]。新しい問題で測り直す、自分のタスクで測る、が基本です
- 標準・指針は、多くが任意です:ISO/IEC の規格や NIST の指針は、法令や契約で引用されて初めて拘束力を持つのが一般的で、NIST の生成AIプロファイルは自主的な利用を前提にしています[参考資料49](ISO/IEC の位置づけは本記事による解説)
- 宣言値と実効値は別です:文脈長、パラメータ数、速度の数字は、開発元の公称、または特定の構成での測定です。自分のデータ・ハードウェアで確かめる価値があります
12. 用語集
- トークン
- モデルが処理する語彙の1項目(サブワード)。文脈長や処理量の数え方の単位。
- 自己回帰
- それまでのトークンから次のトークンの確率を出し、1つ選んで足す操作の繰り返し。
- 注意機構(attention)
- 各トークンが他のトークンの情報をどれだけ参照するかを、重みで決めて混ぜる仕組み。
- Q・K・V
- クエリ・キー・値。QとKの内積で重みを作り、Vを加重平均する。
- 因果マスク
- 後ろのトークンを参照させないための遮蔽。
- FFN
- 前向き層。各トークンを独立に変換する2〜3つの行列の組。
- 残差接続/正規化
- 入力を出力に足す接続と、値の大きさをそろえる処理。学習を安定させる。
- RoPE
- 回転位置埋め込み。位置を回転で符号化し、相対位置への依存を取り込む。
- MHA/MQA/GQA
- 注意のヘッドの共有の仕方。MQA・GQAはKVを共有してKVキャッシュを小さくする。
- KVキャッシュ
- 生成中に、過去トークンのKとVを保存して再利用するメモリ。
- 混合専門家(MoE)
- 複数のFFN(専門家)から、トークンごとに数個を選んで使う構造。
- 総パラメータ数/活性パラメータ数
- モデルが持つ全パラメータ数/1トークンの計算で実際に使うパラメータ数。
- decoder-only
- デコーダ部分だけを使う構成。GPT系列、Llama系列など。
- サンプリング(温度・top-p)
- 確率から次のトークンを選ぶ方法と、その調整値。
- パープレキシティ
- 言語モデルの予測の不確かさを表す指標。クロスエントロピーの指数。
- confabulation(作話)
- 自信をもって述べられた、誤った内容。俗に「幻覚」。
- ベンチマーク汚染
- 評価用の問題が学習データに混入し、得点が過大になること。
13. 参考資料(一次情報)
- Vaswani A. ほか "Attention Is All You Need", arXiv:1706.03762(NeurIPS 2017) — arxiv.org/abs/1706.03762
- Bahdanau D., Cho K., Bengio Y. "Neural Machine Translation by Jointly Learning to Align and Translate", arXiv:1409.0473 — arxiv.org/abs/1409.0473
- Sennrich R., Haddow B., Birch A. "Neural Machine Translation of Rare Words with Subword Units", arXiv:1508.07909 — arxiv.org/abs/1508.07909
- Kudo T., Richardson J. "SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing", arXiv:1808.06226 — arxiv.org/abs/1808.06226
- Petrov A. ほか "Language Model Tokenizers Introduce Unfairness Between Languages", arXiv:2305.15425 — arxiv.org/abs/2305.15425
- Radford A. ほか(OpenAI) "Improving Language Understanding by Generative Pre-Training"(2018) — cdn.openai.com/…/language_understanding_paper.pdf
- Radford A. ほか(OpenAI) "Language Models are Unsupervised Multitask Learners"(2019) — cdn.openai.com/…/language_models_are_unsupervised_multitask_learners.pdf
- Devlin J. ほか "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding", arXiv:1810.04805 — arxiv.org/abs/1810.04805
- Raffel C. ほか "Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer", arXiv:1910.10683 — arxiv.org/abs/1910.10683
- Brown T. B. ほか "Language Models are Few-Shot Learners", arXiv:2005.14165 — arxiv.org/abs/2005.14165
- Kaplan J. ほか "Scaling Laws for Neural Language Models", arXiv:2001.08361 — arxiv.org/abs/2001.08361
- Touvron H. ほか "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971 — arxiv.org/abs/2302.13971
- Touvron H. ほか "Llama 2: Open Foundation and Fine-Tuned Chat Models", arXiv:2307.09288 — arxiv.org/abs/2307.09288
- Grattafiori A. ほか(Llama Team, Meta) "The Llama 3 Herd of Models", arXiv:2407.21783 — arxiv.org/abs/2407.21783
- Shazeer N. ほか "Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer", arXiv:1701.06538 — arxiv.org/abs/1701.06538
- Fedus W., Zoph B., Shazeer N. "Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity", arXiv:2101.03961 — arxiv.org/abs/2101.03961
- Jiang A. Q. ほか "Mixtral of Experts", arXiv:2401.04088 — arxiv.org/abs/2401.04088
- DeepSeek-AI "DeepSeek-V3 Technical Report", arXiv:2412.19437 — arxiv.org/abs/2412.19437
- Yang A. ほか(Qwen Team) "Qwen3 Technical Report", arXiv:2505.09388 — arxiv.org/abs/2505.09388
- OpenAI "gpt-oss-120b & gpt-oss-20b Model Card", arXiv:2508.10925 — arxiv.org/abs/2508.10925
- OpenAI "GPT-4 Technical Report", arXiv:2303.08774 — arxiv.org/abs/2303.08774
- Gemini Team(Google) "Gemini: A Family of Highly Capable Multimodal Models", arXiv:2312.11805 — arxiv.org/abs/2312.11805
- Chowdhery A. ほか "PaLM: Scaling Language Modeling with Pathways", arXiv:2204.02311 — arxiv.org/abs/2204.02311
- Xiong R. ほか "On Layer Normalization in the Transformer Architecture", arXiv:2002.04745(ICML 2020) — arxiv.org/abs/2002.04745
- Zhang B., Sennrich R. "Root Mean Square Layer Normalization", arXiv:1910.07467 — arxiv.org/abs/1910.07467
- Shazeer N. "GLU Variants Improve Transformer", arXiv:2002.05202 — arxiv.org/abs/2002.05202
- Su J. ほか "RoFormer: Enhanced Transformer with Rotary Position Embedding", arXiv:2104.09864 — arxiv.org/abs/2104.09864
- Shazeer N. "Fast Transformer Decoding: One Write-Head is All You Need", arXiv:1911.02150 — arxiv.org/abs/1911.02150
- Ainslie J. ほか "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints", arXiv:2305.13245 — arxiv.org/abs/2305.13245
- Dao T. ほか "FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness", arXiv:2205.14135 — arxiv.org/abs/2205.14135
- Pope R. ほか "Efficiently Scaling Transformer Inference", arXiv:2211.05102 — arxiv.org/abs/2211.05102
- Holtzman A. ほか "The Curious Case of Neural Text Degeneration", arXiv:1904.09751 — arxiv.org/abs/1904.09751
- Liu N. F. ほか "Lost in the Middle: How Language Models Use Long Contexts", arXiv:2307.03172 — arxiv.org/abs/2307.03172
- Ji Z. ほか "Survey of Hallucination in Natural Language Generation", ACM Comput. Surv. 55 (2023), DOI 10.1145/3571730 — arxiv.org/abs/2202.03629
- Hendrycks D. ほか "Measuring Massive Multitask Language Understanding", arXiv:2009.03300 — arxiv.org/abs/2009.03300
- Srivastava A. ほか "Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models", arXiv:2206.04615(TMLR) — arxiv.org/abs/2206.04615
- Liang P. ほか "Holistic Evaluation of Language Models", arXiv:2211.09110(TMLR 2023) — arxiv.org/abs/2211.09110
- Chen M. ほか "Evaluating Large Language Models Trained on Code", arXiv:2107.03374 — arxiv.org/abs/2107.03374
- Cobbe K. ほか "Training Verifiers to Solve Math Word Problems", arXiv:2110.14168 — arxiv.org/abs/2110.14168
- Zhang H. ほか "A Careful Examination of Large Language Model Performance on Grade School Arithmetic", arXiv:2405.00332 — arxiv.org/abs/2405.00332
- Chiang W.-L. ほか "Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference", arXiv:2403.04132 — arxiv.org/abs/2403.04132
- Jacovi A. ほか "Stop Uploading Test Data in Plain Text: Practical Strategies for Mitigating Data Contamination by Evaluation Benchmarks", arXiv:2305.10160 — arxiv.org/abs/2305.10160
- MLCommons "MLPerf Training"(ベンチマーク一覧・規則の概要。確認日に表示の最新版 v6.0) — mlcommons.org/benchmarks/training/
- MLCommons "MLPerf Inference: Datacenter"(確認日のページ表示 v6.1) — mlcommons.org/benchmarks/inference-datacenter/
- ISO/IEC "ISO/IEC 22989:2022 Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(ISO のページ) — iso.org/standard/74296.html
- ISO/IEC "ISO/IEC 23053:2022 Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML)"(ISO のページ) — iso.org/standard/74438.html
- ISO/IEC "ISO/IEC 42001:2023 AI management systems"(ISO のページ) — iso.org/standard/81230.html
- ISO/IEC "ISO/IEC 23894:2023 AI — Guidance on risk management"(ISO のページ) — iso.org/standard/77304.html
- NIST "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1, 2024年7月, DOI 10.6028/NIST.AI.600-1 — doi.org/10.6028/NIST.AI.600-1
- Wang Y. ほか "MMLU-Pro: A More Robust and Challenging Multi-Task Language Understanding Benchmark", arXiv:2406.01574 — arxiv.org/abs/2406.01574
14. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| Attention(Q,K,V) = softmax(QKᵀ/√d_k)V、√d_k で割る理由、原論文の基本モデル(d_model=512、8ヘッド)、デコーダのマスクで位置 i の予測が前の位置だけに依存すること、正弦波の位置符号化(学習する位置埋め込みでもほぼ同じ結果)、原論文の Post-LN と LayerNorm・ReLU | Vaswani ら(2017) 出典1 https://arxiv.org/abs/1706.03762 | 事実 |
| 注意機構の導入(デコードの各ステップで入力の関連部分を探す) | Bahdanau ら 出典2 https://arxiv.org/abs/1409.0473 | 事実 |
| BPE のサブワードによる open-vocabulary の提案、SentencePiece の性格 | Sennrich ら、Kudo と Richardson 出典3 https://arxiv.org/abs/1508.07909 出典4 https://arxiv.org/abs/1808.06226 | 事実 |
| 同じ内容でも言語によりトークン数が最大15倍違うこと、多言語トークナイザでも差が残ること | Petrov ら 出典5 https://arxiv.org/abs/2305.15425 | 事実 |
| GPT(2018):12層 decoder-only、768次元、12ヘッド、FFN 3072。GPT-2(2019):最大1.5B | OpenAI の論文 出典6 https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf 出典7 https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf | 事実 |
| BERT(双方向、110M/340M)、T5(text-to-text、最大11B) | Devlin ら、Raffel ら 出典8 https://arxiv.org/abs/1810.04805 出典9 https://arxiv.org/abs/1910.10683 | 事実 |
| GPT-3:175B、96層、d=12,288、2,048文脈、バッチ320万トークン、3,000億トークン、3.14×10²³ FLOP(3,640 PF-day)、少数ショット | Brown ら(Table 2.1、Table D.1) 出典10 https://arxiv.org/abs/2005.14165 | 事実 |
| 非埋め込みパラメータ N ≈ 12·L·d²、順伝播 C_forward ≈ 2N + 2·L·n_ctx·d_attn、学習 C ≈ 6N/トークン、d_model > n_ctx/12 のとき文脈項が小さいこと、損失をクロスエントロピーで測ること | Kaplan ら(2020) 出典11 https://arxiv.org/abs/2001.08361 | 事実 |
| LLaMA:7B〜65B、公開データのみで学習、Pre-norm・RMSNorm・SwiGLU・RoPE の採用。Llama 2:7B〜70B | Touvron ら 出典12 https://arxiv.org/abs/2302.13971 出典13 https://arxiv.org/abs/2307.09288 | 事実 |
| Llama 3:構成値(8B/70B/405B の層数・次元・FFN・ヘッド・KVヘッド8・語彙128,000・SwiGLU・RoPE θ=500,000)、語彙128K、圧縮率3.17→3.94文字/トークン、約15T(旗艦15.6T)トークン、Llama 2 は1.8T、3.8×10²⁵ FLOP、8K で事前学習後128Kに拡張、GQA の目的 | Llama Team(2024) 出典14 https://arxiv.org/abs/2407.21783 | 事実 |
| MoE 層(最大137B)、Switch Transformer(最大1兆) | Shazeer ら、Fedus ら 出典15 https://arxiv.org/abs/1701.06538 出典16 https://arxiv.org/abs/2101.03961 | 事実 |
| Mixtral 8x7B:各層8専門家から2つ、47B/活性13B、学習時文脈32k | Jiang ら 出典17 https://arxiv.org/abs/2401.04088 | 事実 |
| DeepSeek-V3:671B/活性37B、278.8万 H800 GPU 時間、文脈を32K、128Kと2段階で拡張 | DeepSeek-AI(開発元の公表値) 出典18 https://arxiv.org/abs/2412.19437 | 事実 |
| Qwen3-235B-A22B:235B/活性22B、94層、128専門家から8つ、文脈128K | Qwen Team 出典19 https://arxiv.org/abs/2505.09388 | 事実 |
| gpt-oss-120b:116.8B/活性5.1B、128専門家から上位4つ、GQA(KVヘッド8)、Pre-LN、RoPE、密な層を131,072に拡張 | OpenAI のモデルカード 出典20 https://arxiv.org/abs/2508.10925 | 事実 |
| GPT-4 の報告書が構造・モデルサイズ・ハードウェア・学習計算量などの詳細を含まないこと | OpenAI(2023) 出典21 https://arxiv.org/abs/2303.08774 | 事実 |
| Gemini 1.0:3つのサイズ、Nano は1.8B・3.25B、Ultra・Pro のサイズは表に記載なし、32k の文脈に対応、decoder 基盤 | Gemini Team 出典22 https://arxiv.org/abs/2312.11805 | 事実 |
| PaLM:540B、densely activated | Chowdhery ら 出典23 https://arxiv.org/abs/2204.02311 | 事実 |
| Post-LN の学習ではウォームアップが重要で正規化の位置が効くこと | Xiong ら 出典24 https://arxiv.org/abs/2002.04745 | 事実 |
| RMSNorm(再中心化は不要と仮定して二乗平均平方根で正規化)、SwiGLU(GLU の変種)、RoPE(回転で絶対位置を符号化し相対位置依存を取り込む) | Zhang と Sennrich、Shazeer、Su ら 出典25 https://arxiv.org/abs/1910.07467 出典26 https://arxiv.org/abs/2002.05202 出典27 https://arxiv.org/abs/2104.09864 | 事実 |
| MQA(キー・値を共有、推論のメモリ帯域の負担を軽減)、GQA(中間の数のKVヘッド、MHAに近い品質でMQAに近い速度) | Shazeer、Ainslie ら 出典28 https://arxiv.org/abs/1911.02150 出典29 https://arxiv.org/abs/2305.13245 | 事実 |
| FlashAttention:IO を意識した厳密な注意、タイルで HBM と SRAM の読み書きを減らす | Dao ら 出典30 https://arxiv.org/abs/2205.14135 | 事実 |
| KV キャッシュの定義、パラメータが1枚のアクセラレータのメモリに収まらないのが一般的であること | Pope ら 出典31 https://arxiv.org/abs/2211.05102 | 事実 |
| 確率最大化の復号法が退化を起こすこと、核サンプリングの提案 | Holtzman ら 出典32 https://arxiv.org/abs/1904.09751 | 事実 |
| 長い文脈の真ん中の情報で性能が下がる U 字の傾向 | Liu ら 出典33 https://arxiv.org/abs/2307.03172 | 事実 |
| 自然言語生成の「幻覚」が、無意味または入力に忠実でない出力を指すこと、調査が指標・対策・課題を整理していること | Ji ら 出典34 https://arxiv.org/abs/2202.03629 | 事実 |
| MMLU(57課題)、BIG-bench(204課題・450人・132機関)、HELM(16の中核シナリオ×7指標)、MMLU-Pro(選択肢4→10、精度が16〜33%低下) | 各原論文 出典35 https://arxiv.org/abs/2009.03300 出典36 https://arxiv.org/abs/2206.04615 出典37 https://arxiv.org/abs/2211.09110 出典50 https://arxiv.org/abs/2406.01574 | 事実 |
| HumanEval(164問、単体テスト、pass@k)、GSM8K(約8,500問)、GSM1k(1,205問、精度低下は最大8%) | Chen ら、Cobbe ら、Zhang ら 出典38 https://arxiv.org/abs/2107.03374 出典39 https://arxiv.org/abs/2110.14168 出典40 https://arxiv.org/abs/2405.00332 | 事実 |
| Chatbot Arena(匿名ペア比較、論文時点で24万票超)、ベンチマーク汚染への3つの対策の提案 | Chiang ら、Jacovi ら 出典41 https://arxiv.org/abs/2403.04132 出典42 https://arxiv.org/abs/2305.10160 | 事実 |
| MLPerf Training の LLM 課題(C4、log perplexity の目標、参照モデルと目標値、v6.0)、結果のばらつき(±5%、画像系±2.5%)、Closed/Open と提出区分。MLPerf Inference: Datacenter(ページ表示 v6.1、電力は壁での全システムAC電力、TDP等は検証対象外) | MLCommons の公式ページ(確認日 2026年10月15日) 出典43 https://mlcommons.org/benchmarks/training/ 出典44 https://mlcommons.org/benchmarks/inference-datacenter/ | 事実 |
| ISO/IEC 22989:2022、23053:2022、42001:2023、23894:2023 の番号・題名 | ISO のページ 出典45 https://www.iso.org/standard/74296.html 出典46 https://www.iso.org/standard/74438.html 出典47 https://www.iso.org/standard/81230.html 出典48 https://www.iso.org/standard/77304.html | 事実 |
| NIST AI 600-1(2024年7月):12のリスクを定義し、confabulation を「自信をもって述べられた誤り・偽の内容」と定義、自主的利用 | NIST AI 600-1 の本文 出典49 https://doi.org/10.6028/NIST.AI.600-1 | 事実 |
| 注意の数値例(重み、出力)、文脈項が 2N に占める割合(約4%、約67%)、n×n スコア行列(約34 GB)、パラメータ数の検算表、6ND の検算(3.15×10²³、3.79×10²⁵)、KV キャッシュ(516,096 B/トークン、約67.6 GB、約1.08 TB)、重みのメモリ(810 GB、140 GB、16 GB) | 本稿の計算(Python・NumPy。公表された構成値と Kaplan の式に基づく概算。入出力の埋め込みを別々に持つと仮定。bf16=2バイト)。実在のモデルの実測ではない | 本稿の計算 |
| 2026年の新しいモデル、非公表モデルの規模、ベンチマークのモデル別得点、日本語・化学式のトークン数の実測、ISO/IEC 規格の本文 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「トークン数が文脈・費用・処理時間の単位になる」「生成はメモリの読み出しの仕事になる」「LLM を文献調査に使うときの確認の注意」「MoE は総数と活性数の両方で読む」という読み取りと、素材・研究への含意 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2〜図5・図7が実在のモデルの内部の出力ではなく説明のための作図であること。図1と図6がImageGen生成の概念画像であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(arXiv の原論文、各開発元の技術報告・モデルカード、MLCommons・ISO・NIST の公式ページ)に限定しています。ISO/IEC 規格の本文は有料のため確認できていません。 モデル名・サイズ・文脈長は確認日時点の公式資料の記載で、この分野は変化が速いため、古い情報を「現在」とは読まないでください。 2026年の新しいモデル、規模が非公表のモデルの規模、ベンチマークのモデル別得点、日本語や化学式のトークン数の実測、ISO/IEC 規格の本文については、確認できなかったため記載していません。 図は説明用の概念図または本稿の計算を含む作図で、図1と図6はImageGen生成の概念画像です。いずれも実在のモデルの内部の実測や製品の実物を示すものではありません。