TECHNOLOGY EXPLAINER
検索拡張生成とコンテキストウィンドウ
― 「何を見つけて渡すか」と、「長く入れた分だけ使えるのか」
検索拡張生成(RAG)は、質問に関係する文書の断片を外部から検索し、質問と一緒に大規模言語モデル(LLM)へ渡す方式です。一方、コンテキストウィンドウ(文脈窓)が数十万から100万トークンに広がり、「文書をまるごと入れる」選択肢も現実になりました。ただし、入る量(宣言値)と、使える量(実効性能)は別で、長い文脈ほどメモリ(KV キャッシュ)と計算も増えます。 この記事は、RAG の構成、埋め込みとベクトル検索、チャンク分割、長い文脈の宣言値と実効性能、KV キャッシュのメモリ量と計算(本稿の計算)、RAG と長文脈の使い分け、社内文書・研究データで使うときの注意を、原論文と公式資料の範囲で整理します。
- RAG とコンテキストウィンドウ(3行でつかむ)
- RAG の構成 ― 原論文と全体像
- 埋め込みとベクトル検索
- チャンク分割 ― 表・条件・単位が切れる問題
- 長いコンテキスト ― 宣言値と実効性能
- KV キャッシュのメモリと計算(本稿の計算)
- RAG か、長いコンテキストか
- 社内文書・研究データでの使い方と注意
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=改訂中・提案段階・計画であり、確定していない事項
このほか、仕組みや使い方の読み取りは「解説」として区別しています。推測は太字で示します。
コンテキスト長・モデルの構成・検索や長文脈の評価結果は、特定のモデル・版・設定・評価条件での値です。長文脈の評価論文の多くは、古いモデルを対象にしており、現行のモデルでは結果が違う可能性があります。 モデル名・コンテキスト長の仕様は変化が速いため、公式ドキュメントの内容に確認日を付けています。確認日(2026年10月15日)より後の状態は、必ず公式ページで確かめてください。KV キャッシュなどの計算は、モデルの公開された構成値から導いた概算で、実際の実装(量子化、ページング、並列化)で変わります。
1. RAG とコンテキストウィンドウ(3行でつかむ)
- RAG は「検索して、断片を渡す」:Lewis らの原論文は、事前学習済みの生成モデル(パラメトリックな記憶)と、Wikipedia のベクトル索引(非パラメトリックな記憶)を組み合わせた方式を示しました事実[参考資料1]。モデルの外に知識を置くことで、出典を示しやすく、知識を入れ替えやすくなります(解説)。
- 文脈窓の宣言値は大きいが、実効性能は別:Anthropic の公式ドキュメントは、複数のモデルが1Mトークンの文脈窓を持つと書く一方、トークンが増えると精度と再現率が下がる「context rot」が起きる、と明記しています事実[参考資料23]。RULER の論文は、32K以上を謳う17モデルのうち、32K で満足できる性能を保てたのは半数にとどまると報告しています[参考資料15]。
- 長い文脈はメモリを食う:公開された構成値から計算すると、Llama 3.1 8B の KV キャッシュは128Kトークンで16 GiB、70B で40 GiB です本稿の計算(第6章)。
RAG の品質は「何を見つけて、何を渡すか」で決まり、長い文脈は「入る量」であって「使える量」ではありません。 文書をまるごと入れても、必要な情報が文脈の中ほどにあると見落とされたり(Lost in the Middle)、検索で上位に出ても断片から条件が欠けたりします。どちらの方式でも、自分の文書と質問で測る必要があります(第8章)。
2. RAG の構成 ― 原論文と全体像
(1) 原論文が示した構成
Lewis らは、パラメトリックな記憶として事前学習済みの seq2seq モデルを、非パラメトリックな記憶として Wikipedia の密ベクトル索引を使う RAG モデルを示しました。Wikipedia の記事を100語ずつの互いに重ならない断片に分け、約2,100万件の文書として、各文書の埋め込みを計算し、Faiss で近似検索の索引(HNSW)を作っています事実[参考資料1]。同じ時期の Karpukhin らの DPR も、Wikipedia を100語の「パッセージ」に分けた21,015,324件を検索単位とし、BERT(base)で768次元のベクトルを作り、Faiss で索引化しています[参考資料2]。 RAG が、外部知識で出典を示しやすくし、知識を更新しやすくする、という動機は原論文の冒頭に書かれています[参考資料1]。REALM は、事前学習の段階から、Wikipedia のような大規模コーパスの文書を検索して参照する潜在的な検索器を組み込み、知識をパラメータに暗黙に持つ代わりに、より部品化され解釈しやすい形で持つことを目指しました[参考資料3]。
(2) 全体像:事前処理と質問時
RAG は、文書を検索できる形にする事前処理と、質問のたびに検索して文脈を作る質問時の二段に分けて整理できます。Anthropic の解説は、知識ベースを数百トークン以下の断片に分け、埋め込みモデルでベクトルにし、実行時に質問に近い断片をベクトルデータベースから取り出して、プロンプトに加える、という標準的な流れを説明しています[参考資料25]。
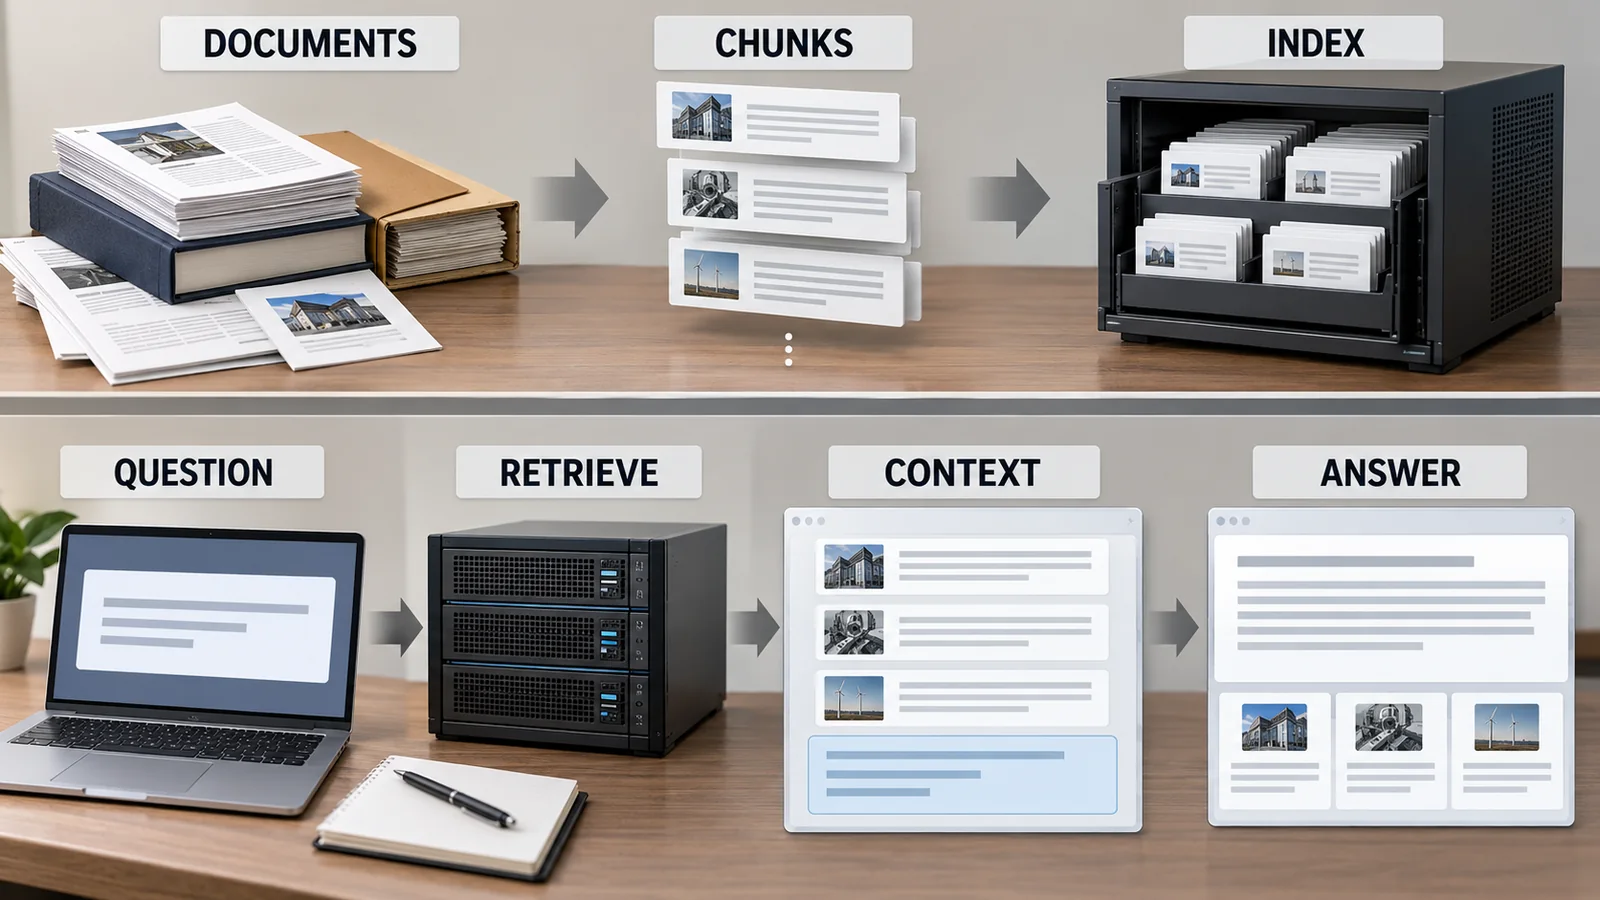
元のSVG模式図・数値・出典注記を見る
Barnett らの経験報告は、研究・教育・生物医学の3つの事例から、RAG の設計で考慮すべき7つの失敗点を示し、主な結論として、RAG の検証は運用中にしか実現できないこと、頑健性は最初から設計されるのではなく進化することを挙げています事実[参考資料14]。つまり、導入時に一度評価して終わりではなく、運用しながら測り続ける前提で作るのが現実的です(解説)。
3. 埋め込みとベクトル検索
(1) 埋め込み:テキストを「近さ」で比べられる数字にする
Sentence-BERT は、BERT のペア入力の計算量が大きすぎる問題(1万文の中で最も似たペアを探すのに約5,000万回の推論、約65時間)を、文ごとに埋め込みを作ってコサイン類似度で比べる方式に変え、約5秒に縮めた、と報告しています事実[参考資料6]。この「あらかじめ文書を埋め込んでおき、質問時には質問だけを埋め込んで近いものを探す」という考え方が、RAG の検索の基本です(解説)。
(2) 近似最近傍探索:全件を比べずに近いものを探す
文書数が数百万・数千万になると、質問と全件の類似度を計算するのは重くなります。HNSW(階層的な小世界グラフ)は、多層のグラフで探索を行い、対数的な計算量の増え方を実現する近似最近傍探索の方法として提案されました[参考資料7]。Faiss は、ベクトルの類似度検索(索引化、検索、クラスタリング、圧縮)のためのライブラリで、論文は検索の精度・速度・メモリのトレードオフの空間と設計原則を説明しています[参考資料8]。ScaNN の異方性ベクトル量子化も、大規模検索の高速化の方法です[参考資料9]事実。近似なので、本当に最も近いものを取りこぼす場合があり、精度と速度は設定で変わります(解説)。
(3) 語彙検索(BM25)との組み合わせ
埋め込みは意味の近さを捉えますが、正確な語句の一致を逃すことがあります。Anthropic の解説は、BM25 は語彙の一致に基づく順位付けで、固有の識別子や専門用語を含む質問に特に有効で、たとえばエラーコード「TS-999」のような完全一致は、埋め込みでは見つけにくいことがある、と述べています[参考資料25]。BEIR は、18の公開データセットで10種類の検索方式を評価し、BM25 が頑健な基準になること、再ランクと後期相互作用(late interaction)の方式が平均的にゼロショットで最良だが計算コストが高いこと、密・疎の検索は計算効率が良いが他に劣ることが多いことを報告しました事実[参考資料10]。MTEB は、8つのタスク・58データセット・112言語で33モデルを評価し、すべてのタスクで優れる単一の埋め込み方式はない、と報告しています[参考資料11]。
素材の文書には、グレード名、品番、規格番号(JIS や ISO の番号)、化学式、試験法の記号のように、一字違えば別のものという語が多く現れます。意味の近さで探す埋め込みだけでは、似た品番を取り違えることが起こりえます(本記事による解説)。Anthropic の解説が示すとおり、語彙検索(BM25)と埋め込みを併用するハイブリッド検索は、識別子の完全一致と意味の近さを両方拾う方法です[参考資料25]。 自社の文書で使うときは、実際の品番や規格番号で検索して、正しい文書が上位に出るかを、導入前に確かめてください。
(4) ベクトルの記憶量:本稿の計算
ベクトル索引の大きさは、おおまかに「断片の数 × 次元数 × 1要素のバイト数」です。DPR の規模(21,015,324件、768次元)と、100万件の断片で次元が違う場合を計算しました。
| 断片の数 | 次元数 | 1要素 | ベクトルだけの大きさ |
|---|---|---|---|
| 21,015,324(DPR の Wikipedia) | 768 | float32(4バイト) | 約64.6 GB |
| 21,015,324 | 768 | float16(2バイト) | 約32.3 GB |
| 21,015,324 | 768 | int8(1バイト) | 約16.1 GB |
| 1,000,000(社内文書の仮定) | 1,024 | float32 | 約4.1 GB |
| 1,000,000(同上) | 3,072 | float32 | 約12.3 GB |
本稿の計算(GB=109バイト)。断片数・次元数は説明用の仮定(DPR の件数と768次元は論文[参考資料2]の値)。HNSW などの索引の追加メモリ、メタデータ、本文の保存は含みません。
つまり、社内文書の規模なら、ベクトルそのものは1台のサーバーの主記憶に収まる大きさになりえます。一方、検索の精度や速度は、記憶量ではなく、埋め込みの質、索引の設定、チャンク分割で決まります(解説)。また、埋め込みは匿名化ではありません。Morris らは、埋め込みから元のテキストを復元する手法で、32トークンの入力の92% を正確に復元でき、臨床ノートのデータセットから氏名などの個人情報も復元できたと報告しています事実[参考資料16]。機密文書の埋め込みも、機密情報として扱う必要があります(解説)。
4. チャンク分割 ― 表・条件・単位が切れる問題
(1) 粒度の選び方で、検索の精度が変わる
Chen らの Dense X Retrieval は、検索の単位(文書、パッセージ、文)の選び方が、検索と下流タスクの性能に大きく影響することを示しました。「命題(proposition)」という、1つの事実を自己完結した形で表す細かい単位で索引化すると、パッセージ単位より検索で優れ、同じ計算予算での下流の質問応答も改善した、と報告しています事実[参考資料13]。Günther らの late chunking は、長い文脈を扱える埋め込みモデルで文書の全トークンをまず埋め込み、プーリングの直前で断片に分けることで、周囲の文脈を含んだ断片の埋め込みを得る方法です[参考資料12]。
(2) 断片にコンテキストを足す:Contextual Retrieval
断片が単独だと、何についての記述か分からなくなる問題があります。Anthropic は2024年9月19日の解説で、各断片の前に、文書全体から作った断片固有の説明を付けてから埋め込み・BM25 索引を作る「Contextual Retrieval」を示し、検索の失敗を49%、再ランクとの併用で67% 減らせたと述べています事実[参考資料25]。これは開発元自身の実験で、独立の再現は確認していません。同じ解説は、知識ベースが約20万トークン(約500ページ)より小さければ、RAG を使わず、プロンプトに全部入れる選択肢がある、とも書いています(2024年時点の記述)[参考資料25]。
(3) チャンクの大きさと数:本稿の計算
文書の長さ T トークン、断片の大きさ s、重なり o とすると、断片の数は、おおむね ⌈(T−o)/(s−o)⌉ です。10万トークン(A4で約200ページ相当の仮定)の資料を、重なりを断片の10% として分けた場合と、上位5件を文脈に入れた場合のトークン数を計算しました。
| 断片の大きさ s | 重なり o | 10万トークンの資料の断片数 | 上位5件を入れたときの文脈 | 上位20件を入れたとき |
|---|---|---|---|---|
| 200トークン | 20 | 556 | 1,000トークン | 4,000トークン |
| 500トークン | 50 | 223 | 2,500トークン | 10,000トークン |
| 1,000トークン | 100 | 111 | 5,000トークン | 20,000トークン |
本稿の計算(断片数=⌈(T−o)/(s−o)⌉、T=100,000の仮定)。「文脈」は断片そのもののトークン数だけで、質問・指示・回答の分は含みません。
断片を小さくすると、1つの断片が話題に絞られて検索に当たりやすい反面、文脈が切れ、断片の数も増えます。大きくすると文脈は残りますが、検索の精度が落ち、LLM に渡すトークンが増えます(解説)。最適な大きさは文書の種類(報告書、規格、表の多い成績書)で違い、一般解はありません。
試験成績書やデータシートでは、数値の意味は、表の見出し、単位、試験温度・湿度、試験法、試料の状態によって決まります。機械的に一定の長さで切ると、数値の行と見出し・条件が別の断片に分かれ、検索で見つかっても、条件の取り違えが起きます(図3、本記事による解説)。PDF の表や図は、文字として取り出す段階(解析)でも崩れやすい点に注意が必要です。 対策は、表を1つの塊として保持する、各断片に文書名・節・試験条件を付ける、小さい断片で検索して親の節を渡す、のように、文書の構造を壊さない分割です。推測として、数値の根拠を扱う業務では、回答に必ず出典のページと条件を併記させる運用が効果的ですが、その効果を測った一次情報は本稿にありません。
5. 長いコンテキスト ― 宣言値と実効性能
(1) 宣言値:どれくらい「入る」と書かれているか
Anthropic の公式ドキュメント(確認日 2026年10月15日)は、Claude Opus 5.5、Sonnet 5.5、Haiku 5.5 など複数のモデルが1Mトークンの文脈窓を持ち、1回の要求で最大128kの出力トークンを生成できると記しています。それ以外のモデルは200kトークンです[参考資料23]。Google の Gemini API のドキュメントは、Gemini 4 のモデルで、入力・思考・出力のトークンが1つの文脈窓(1,048,576トークン)を共有すると書いています[参考資料24]。Llama 3 の論文は、最大モデルの文脈窓を最大128Kトークン[参考資料26]、gpt-oss のモデルカードは、全層密結合の層を YaRN で131,072トークンに拡張したと説明しています[参考資料30]事実。これらは「入力できる上限」の宣言値で、その長さで正確に使えることの保証ではありません。
(2) 実効性能:長くなると何が起きるか
| 評価(出典) | 一次情報で確認できたこと | 読むときの注意 |
|---|---|---|
| Lost in the Middle(Liu ら 2023)[17] | 複数文書の質問応答と、キーと値の検索で、関連情報の位置を変えると性能が大きく変わる。関連情報が文脈の先頭か末尾にあるときに最も高く、中ほどにあると大きく下がる。長い文脈を想定したモデルでも同様 | 2023年の論文の時点のモデルでの結果。現行のモデルでは異なる可能性があるため、自社の設定で位置を変えて試す |
| RULER(Hsieh ら 2024)[15] | needle-in-a-haystack(針探し)を拡張し、複数の針、多段の追跡、集約などを加えた合成ベンチマーク。17モデルを13タスクで評価し、単純な針探しではほぼ満点でも、ほぼすべてのモデルで文脈が長くなるほど大きく低下した。32K以上を謳いながら、32Kで満足できる性能を保てたのは半数 | 「満足できる性能」の基準は論文の設定。合成タスクで、実際の文書の質問とは異なる |
| NoLiMa(Modarressi ら 2025)[18] | 針と質問の語句の重なりを最小にした針探し。128K以上を謳う13モデルのうち、32K で11モデルが、短い文脈での強い基準値の50%を下回った。GPT-4o は基準99.3%から69.7%へ低下。推論や CoT を使うモデルでも長い文脈で低下した | 語句の一致に頼れない場合の評価。質問と文書の言い回しが違う実務に近い一方、合成の針探しである点は同じ |
| LongBench(Bai ら 2023)[19]、HELM Long Context[20] | LongBench は英語・中国語の21データセット・6種のタスクで長文理解を評価する。HELM Long Context は、RULER の2課題、∞Bench の2課題、OpenAI MRCR の5課題で、「長い入力に対応していることは、強い長文脈能力を意味しない」としてリーダーボードを提供する(ページで確認した版は v1.0.0、2025年9月29日付) | 順位表は日付と版を確認し、参考値として使う。タスクは要約・質問応答・多段推論などで難しさが違う |
| Anthropic の公式の説明[23] | 文脈窓は「作業記憶」で、大きいほど長いプロンプトを扱えるが、多ければよいとは限らない。トークンが増えるほど精度と再現率が下がる context rot が起きる、と記載 | 開発元自身の説明。程度はモデルとタスクで異なり、数値は示されていない |
すべて事実(各論文・公式ページ、確認日 2026年10月15日)。右列は本記事の解説です。
資料や仕様に「1Mトークン」とあれば、それは宣言値です。実効は、タスク(検索、集約、推論)・文脈の位置・質問と文書の言い回しの近さ・モデルの版で変わります。長文脈の評価論文は、いずれも古いモデルを対象にしているため、数字をそのまま現行モデルに当てはめないことが大切です。導入するときは、自社の文書と質問で、文脈の長さと必要情報の位置を変えて測るのが確実です(第8章)。
6. KV キャッシュのメモリと計算(本稿の計算)
(1) KV キャッシュとは何か、どう計算するか
LLM が1トークンずつ文章を生成するとき、過去のすべてのトークンの注意の計算に使う「キー(K)」と「値(V)」を毎回計算し直さず、メモリに保存して再利用します。これが KV キャッシュで、KV cache は大きなバッチと長い文脈で、メモリ使用量と速度の新しいボトルネックになる、と KIVI の論文は説明しています[参考資料34]。1トークンあたりの KV キャッシュの大きさは、次の式で見積もれます(本記事による式)。
KV キャッシュ(バイト)= 2(K と V)× 層数 × KV ヘッド数 × ヘッド次元 × 1要素のバイト数 × トークン数
複数のクエリが1組の KV を共有する MQA(Shazeer)[参考資料32]や GQA(Ainslie ら)[参考資料31]は、KV ヘッド数を減らして、この式の「KV ヘッド数」を小さくする方法です。Llama 3 は8個の KV ヘッドの GQA を使い、推論の高速化と KV キャッシュの縮小を目的にしたと説明しています[参考資料26]。DeepSeek-V2 の MLA(多頭潜在注意)は、1トークンあたり (dc+dRh)×層数 個の要素だけを保存する方式で、DeepSeek 67B と比べて KV キャッシュを93.3% 減らしたと報告されています事実[参考資料29]。
(2) モデルごとの計算
公開されている構成値から、bf16(1要素2バイト)、バッチ1、1本の系列の KV キャッシュを計算しました。構成値は、Llama 3.1 が論文の表[参考資料26]、DeepSeek-V3 と gpt-oss-120b が公式の config.json[参考資料27・28]です。
| モデル | 構成(層数/KV ヘッド数/ヘッド次元) | 1トークンあたり | 8Kトークン | 32Kトークン | 128Kトークン | 1Mトークン(外挿) |
|---|---|---|---|---|---|---|
| Llama 3.1 8B | 32/8/128 | 128 KiB | 1.0 GiB | 4.0 GiB | 16.0 GiB | 128 GiB |
| Llama 3.1 70B | 80/8/128 | 320 KiB | 2.5 GiB | 10.0 GiB | 40.0 GiB | 320 GiB |
| Llama 3.1 405B | 126/8/128 | 504 KiB | 3.9 GiB | 15.8 GiB | 63.0 GiB | 504 GiB |
| DeepSeek-V3(MLA) | 61層、保存は (512+64) 要素/層 | 68.6 KiB | 0.54 GiB | 2.1 GiB | 8.6 GiB | 68.6 GiB |
| gpt-oss-120b | 36層(全体注意18層+窓128の層18層)/8/64 | 全体注意の層のみ 36 KiB | 0.29 GiB | 1.1 GiB | 4.5 GiB | 36.0 GiB |
本稿の計算(KiB=1,024バイト、GiB=1,0243バイト)。構成値は事実(Llama 3 の論文の表、DeepSeek-V3・gpt-oss の公式 config.json、gpt-oss モデルカードの注意パターンの記述)。1Mトークンの列は計算上の外挿で、各モデルの宣言値は128K前後(Llama 3.1:128K、DeepSeek-V3 の config:163,840、gpt-oss:131,072)です。gpt-oss は窓128の層の分(約4.5 MiB)を足しています。重み・アクティベーション・実装の余裕は含みません。
同じ128Kトークンでも、Llama 3.1 8B が16 GiB、70B が40 GiB、gpt-oss-120b(窓付きの層が半分)が4.5 GiB、DeepSeek-V3(MLA)が8.6 GiB と、モデルの設計で数倍違います。さらに、KV キャッシュは同時に処理する系列の数(バッチ)に比例して増えるので、128Kの系列を同時に8本処理する Llama 3.1 8B なら、KV だけで128 GiB です(本稿の計算)。
この問題への対策も一次情報で確認できます。PagedAttention(vLLM)は、KV キャッシュのメモリが断片化と重複で無駄になることを、OS の仮想メモリのようなページングで防ぎ、ほぼ無駄のない管理を実現して、同程度の遅延でスループットを2〜4倍にしたと報告しています[参考資料33]。KIVI は KV キャッシュを2ビットに量子化し、Llama・Falcon・Mistral でほぼ同じ品質を保ったまま、重みを含むピークメモリを2.6倍減らし、バッチを最大4倍にできたと報告しています[参考資料34]事実。これらは著者らの実験で、精度への影響は条件つきです。
(3) 計算の中身とデコード速度:本稿の計算
文脈が長くなると、メモリだけでなく、計算の中身も変わります。入力を一括処理するプレフィルでは、注意の計算量が文脈長 L の2乗に比例して増える一方、線形層(重み行列の積)の計算量は L に比例します。Llama 3.1 8B(パラメータ約80億、層数32、注意の次元4,096)で、因果マスクを考慮して概算すると、注意の計算量が線形層を超えるのは約6.1万トークンです。128Kトークンでは、注意の計算量は線形層の約2.1倍になります本稿の計算。
出力を1トークンずつ作るデコードでは、1トークンごとに重みとそれまでの KV キャッシュをメモリから読み出します。メモリ帯域を3 TB/s と仮定すると、重みだけ(80億×2バイト)を読む下限の速度は約188トークン/秒、8Kの文脈では約176、128Kの文脈(KV 16 GiB を追加で読む)では約90トークン/秒です本稿の計算(1本の系列の上限で、実際は並列化・量子化・キャッシュ構成で変わります)。
KV キャッシュは、GPU に接続された高帯域メモリ(HBM など)に置かれるのが普通で、その容量と帯域が、同時に扱える文脈の長さと利用者数を決めます(本記事による解説)。128Kトークンの1系列で16 GiB という数字は、同時利用者が増えるほど積み上がります。つまり、文書を丸ごと入れる運用は、使うたびに HBM の容量・帯域と電力を消費する方式で、RAG で必要な断片だけに絞ることは、精度だけでなく物理資源の節約にもなりえます。 HBM とパッケージ、データセンターの電力・冷却は本シリーズの『HBM』『推論の最適化とサービング』『AIデータセンターの電力と冷却』編で扱います。
7. RAG か、長いコンテキストか
Li らは、RAG と長文脈(LC)の LLM を、3つの最新モデルと複数の公開データセットで比べました。結果は、資源が十分にあれば LC が平均的な性能で RAG を一貫して上回る一方、RAG は費用が大幅に低いという利点が残る、というものです。著者らは、モデルの自己反省で質問を RAG か LC に振り分ける Self-Route を提案し、LC に近い性能を保ちつつ計算費用を大きく下げられるとしています事実[参考資料21]。Self-RAG は、必要なときだけ検索し、検索した断片と自分の生成を反省トークンで点検する方式です[参考資料4]。
| 観点 | RAG(検索して渡す) | 長いコンテキスト(まるごと入れる) |
|---|---|---|
| 扱える量 | 索引化できる限り(数百万件の断片でも) | 文脈窓に収まる量(数十万〜100万トークン) |
| 更新 | 索引の更新で反映 | 質問のたびに入力するため、常に最新を渡せる |
| 費用・遅延 | 質問あたりのトークンが少ない | 質問あたりのトークンが多く、KV キャッシュも大きい(第6章) |
| 出典の示しやすさ | 断片に文書名・ページなどのメタデータを付けやすい | 文書内の位置を回答に求める必要がある |
| アクセス権 | 検索時に、利用者の権限で断片を絞れる(第8章) | 文脈に入れた文書は、その応答の中で全部見える |
| 典型的な失敗 | 検索漏れ、関係の薄い断片、条件の欠落(第4章) | 文脈の中ほどの見落とし、長くなるほどの精度低下(第5章) |
この表は本記事の解説です。性能と費用の関係の一次情報は Li らの論文[参考資料21]、知識ベースが小さい場合の選択肢は Anthropic の解説[参考資料25]によります。
どちらが優れるかは、資料の量・更新頻度・出典の要否・権限の管理・予算で決まり、一般解はありません。小さな知識ベース(Anthropic の解説は約20万トークン未満を例示)なら、まるごと入れる方式が簡単で、大きな知識ベースや権限管理が必要な場合は RAG が現実的です(解説)。
8. 社内文書・研究データでの使い方と注意
RAG を社内の報告書、試験成績書、規格、研究データに使うときは、精度だけでなく、権限・安全・出典・更新・再現性を設計に入れる必要があります。一次情報で確認できた論点を整理します。
(1) アクセス権と機密
OWASP の「LLM アプリケーション Top 10(2025年版)」は、LLM08「ベクトルと埋め込みの弱点」で、RAG のベクトル・埋め込みの生成・保存・検索の弱点が、悪意のある入力の混入、出力の操作、機微情報へのアクセスに悪用されうるとし、アクセス制御の不備による機微情報の漏えい、複数の利用者・組織が同じベクトルデータベースを共有する環境での文脈間の漏えいを例に挙げています。対策としては、きめ細かなアクセス制御と、権限を考慮したベクトル・埋め込みの保管、データセットの論理的・アクセス上の分離、検索のログの保管を挙げています事実[参考資料35]。 第3章のとおり、埋め込みから元の文章を復元できる研究もあります[参考資料16]。権限は、検索の段階で利用者ごとに適用し、埋め込みや索引も機密文書と同じ扱いにするのが基本です(解説)。
(2) 文書に仕込まれた指示と、毒入りの文書
OWASP の LLM01「プロンプトインジェクション」は、LLM がウェブサイトやファイルのような外部の入力を取り込むとき、その内容の中の指示によってモデルの挙動が意図せず変わる間接的なプロンプトインジェクションを挙げ、外部コンテンツを分離して識別することなどを対策に含めています[参考資料36]。Zou らの PoisonedRAG は、知識データベースへの悪意あるテキストの注入が新しい攻撃面になると示し、数百万件のテキストを含むデータベースに、標的の質問ごとに5件の悪意あるテキストを入れると、約90%の攻撃成功率になり、評価した防御は不十分だった、と報告しています[参考資料22]事実。 取り込む文書の出所を管理し、外部から来た文書や、不特定の人が書き込める文書を、社内の信頼できる文書と同列に索引に入れないことが対策の第一歩です(解説)。具体的な攻撃手順は本稿では扱いません。
(3) 出典、根拠、ハルシネーション
NIST AI 600-1(生成AIプロファイル、2024年7月)は、生成AIに特有のリスクの一つに、確信をもって述べられた誤りまたは虚偽の内容を作ること(confabulation、いわゆるハルシネーション)を挙げています[参考資料37]。RAG の動機には、出典を示せることがありますが[参考資料1]、検索した断片を渡しても、モデルが断片を無視したり、取り違えたりすることはあります。OWASP は、応答の評価に、文脈の関連性、根拠への忠実さ(groundedness)、質問と回答の関連性の三つ(RAG Triad)を挙げています[参考資料36]。Ragas は、検索が関連する焦点の合った断片を見つける能力、LLM が断片を忠実に使う能力、生成の質を、人手の正解なしで評価する指標群を提案しています[参考資料5]。
(4) 更新、版、再現性
Barnett らは、RAG の頑健性は設計時に作り込むものではなく、運用の中で進化すると述べています[参考資料14]。規格や社内標準は改訂されるため、古い版の断片が検索に混ざらないよう、文書の版・有効期間を索引のメタデータに持たせ、更新時に旧版を除く運用が必要です(解説)。また、同じ質問でも、索引の内容、検索の設定、モデルの版で回答が変わるため、重要な判断に使った回答には、取得日・索引の版・モデルの版・参照した断片を記録します。
測定データ(試験片ごとの強度、組成、条件)は、文章というより表や構造化データで、条件ごとに数値が決まります。文章の断片として索引に入れると、第4章のとおり、条件と数値が切り離されます。測定データは、まずデータベースや表計算の形で保持し、LLM には、その検索や集計をさせるか、検索結果の表を条件ごと渡すほうが、取り違えを避けやすい場合があります(本記事による解説)。 推測として、報告書の文章には RAG、数値の台帳には構造化データ、と使い分けるのが現実的ですが、この使い分けの効果を測った一次情報は、本稿の調査範囲にはありません。
導入前のチェックリスト(解説)
- 対象文書:どの文書を、誰に、何の判断のために使うか。外部由来の文書が混ざらないか。
- 権限:検索の段階で利用者の権限を適用できるか。複数の部署・取引先で索引を共有しないか。
- 分割と解析:表・図・数式・化学式・単位が壊れていないか。代表的な文書で、実際に断片を目で確認したか。
- 検索:品番・規格番号で正しい文書が上位に出るか(語彙検索とのハイブリッド)。上位 k に正解の断片が入る割合(recall@k)を測ったか。
- 生成:回答に出典・ページ・条件が付くか。断片にない内容を答えていないか(根拠への忠実さ)。
- 評価:自社の質問と正解のセットで、検索と生成を分けて測ったか。文脈の長さと必要情報の位置を変えて試したか。
- 運用:文書の更新・旧版の除外、ログ(質問・検索結果・回答)、記録(取得日・版)の方法があるか。
9. 限界と、確認できなかったこと
(1) 長文脈の評価の鮮度
第5章の長文脈の評価(Lost in the Middle、RULER、NoLiMa)は、論文の時点のモデルの結果で、2026年10月15日時点の各社の最新モデルの実効性能は、本稿では確認していません。HELM Long Context のページで確認した版(v1.0.0、2025年9月29日)より新しい版が出ていないかも、確認していません。
(2) KV キャッシュなどの計算
第6章の計算は、公開された構成値から導いた概算です。実際の実装は、KV キャッシュの量子化、ページング、プレフィックスの共有、テンソル並列などで変わります。メモリ帯域3 TB/s と1本の系列のデコードは説明用の仮定で、特定の製品の実測ではありません。Llama 3.1 の構成値は論文の表によるもので、公式の config.json は確認していません(ゲート付きのため)。
(3) 開発元自身の実験
Contextual Retrieval の改善(失敗を49%・67%減らした)は Anthropic 自身の実験です。独立の再現は確認できませんでした。PagedAttention・KIVI・DeepSeek-V2 の数値も、各論文の著者らの報告です。
(4) 規格の本文と、RAG に特化した規格
ISO/IEC の規格は題名・発行年月・適用範囲の要旨のみを確認し、本文は未確認です。RAG やベクトル検索の性能を直接定める国際規格は確認できませんでした。OWASP の文書は、コミュニティの指針で、規格ではありません。
(5) 素材・研究データでの効果
素材技術の文書(試験成績書、規格、データシート)に RAG や長文脈を適用したときの精度や、本稿の「チェックリスト」「表の扱い」の有効性を測った一次情報は、確認できませんでした。第4章・第8章の素材分野の記述は、本記事の解説と推測です。
- RAG は、検索した断片を質問と一緒に LLM に渡す方式です。品質は、解析・分割・埋め込み・検索・再ランク・出典の全体で決まります事実
- 文書を切る単位と、条件の保持が重要です。表の数値が見出しや試験条件と切り離される問題は、素材の文書で特に起きやすい点です(解説)
- 文脈窓の宣言値は実効性能ではありません。RULER では32K以上を謳うモデルの半数が32Kで満足な性能を保てませんでした事実
- 長い文脈はメモリを食います。Llama 3.1 8B の KV キャッシュは128Kトークンで16 GiB、70B で40 GiB です本稿の計算
- RAG と長文脈は使い分けます。資源が十分なら長文脈が平均で上回るが、RAG は費用が低い、という報告があります事実
- 社内文書では、権限・安全・出典・更新を設計します。埋め込みも機密として扱い、取り込む文書の出所を管理します事実
10. 評価・標準の読み方
RAG と長い文脈の評価は、検索の品質(正しい断片が上位に出るか)、生成の品質(断片に忠実に答えるか)、長文脈の実効性能(長さと位置による低下)、資源(メモリ・遅延・費用)の4つに分けて考えます。一方、これらを直接定める国際規格は確認できず、規格・指針は主にリスク管理・データ品質・試験の枠組みとして存在します。次の表は、確認できたものを区分つきで並べたものです。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 検索の品質 | BEIR(18データセット、10方式を評価。BM25 が頑健な基準)[10]。MTEB(8タスク・58データセット・112言語・33モデル。すべてのタスクで優れる単一の埋め込み方式はない)[11]事実 | 確認できなかった(検索品質を定めた ISO/IEC・NIST の規格は確認できなかった) | 公開の検索ベンチマークの順位は、自社の文書・言語・専門用語と異なる。自社の質問で recall@k などを測る |
| RAG 全体の品質(忠実さ・関連性) | Ragas(人手の正解なしで、検索の関連性、断片への忠実さ、生成の質を評価する指標群)[5]。OWASP が挙げる RAG Triad(文脈の関連性、根拠への忠実さ、質問と回答の関連性)[36]。Barnett ら:検証は運用中にしか実現できない[14]事実 | NIST AI 600-1(生成AIプロファイル、2024年7月。confabulation などのリスクを整理)[37]。ISO/IEC TS 42119-2:2025(AI システムの試験の概観)[39]事実 | LLM を判定者にする指標は、判定者の偏りの影響を受ける(本シリーズ『ベンチマークと評価の読み方』編)。NIST AI 600-1 は任意の枠組み |
| 長文脈の実効性能 | Lost in the Middle[17]、RULER[15]、NoLiMa[18]、LongBench[19]、HELM Long Context(5課題、v1.0.0、2025年9月29日)[20]事実 | 確認できなかった | 宣言値(1Mトークンなど)と実効は別。評価論文は古いモデルが対象で、現行モデルでは異なりうる。針探しは易しい指標で、多段・集約で低下しやすい |
| メモリ・計算・環境負荷 | 各モデルの公開構成値からの KV キャッシュの計算(第6章)。PagedAttention[33]、KIVI[34]の報告事実 | ISO/IEC TR 17903:2024(機械学習の計算デバイスの概観、2024年5月、TR)[43]。ISO/IEC TR 20226:2025(AI システムの環境面の側面と関連しうる指標の概観、2025年7月、TR)[44]事実 | TR は技術報告書で、要求事項ではない。推論時のメモリ量の測定法を定めた規格は確認できなかった |
| データ品質・データの管理 | 確認できなかった | ISO/IEC 5259-2:2024(分析と機械学習のためのデータ品質、第2部:データ品質の測定、2024年11月)[40]。題名・発行年月のみ確認事実 | RAG の索引に入れる文書の品質・版・鮮度への適用範囲は、要旨を確認できなかったため記載しない |
| セキュリティ(権限・間接注入・毒入り文書) | PoisonedRAG[22]、埋め込みの復元[16]の研究事実 | OWASP LLM01 プロンプトインジェクション[36]、LLM08 ベクトルと埋め込みの弱点[35](OWASP 2025年版、コミュニティの指針で規格ではない)。NIST AI 100-1(AI RMF 1.0、2023年1月、自主的な枠組み)[38]。ISO/IEC 23894:2023(AI のリスク管理の指針)[42]。ISO/IEC 42001:2023(AI マネジメントシステムの要求事項)[41]事実 | OWASP は推奨の一覧で、法的拘束力はない。ISO/IEC 42001 は要求事項を持ち認証の対象になりうるが、RAG 固有の要求は確認できなかった |
規格の番号・題名・発行年月は ISO・NIST・OWASP の公式ページで確認した事実(確認日 2026年10月15日)。ベンチマークの要点は各原論文による。表の並べ方と「読み方の注意」は本稿の計算(本記事による整理)です。
読み方の注意
- ベンチマークの値は、設定と実施主体で変わります。検索のベンチマークは言語・分野・文書の長さで、長文脈のベンチマークはタスクと文脈の位置で結果が変わります。開発元自身の実験(Contextual Retrieval など)は独立の評価ではありません。
- 飽和と汚染に注意します。針探し(NIAH)はほぼ満点でも、RULER や NoLiMa で低下するように、易しい指標で飽和した評価は、実務の難しさを反映しません。
- 標準・指針は、推奨か要求か、法的拘束力があるかで読み分けます。NIST AI 600-1・AI 100-1 は自主的な枠組み、OWASP はコミュニティの指針、ISO/IEC の TR は報告書、42001 は要求事項を持つ規格です。いずれも RAG の「検索精度」や「文脈長の実効性能」の合否を定めてはいません。
- 宣言値と実測値を区別します。文脈窓の宣言値(1Mトークンなど)は実効ではなく、KV キャッシュの計算値は実測のメモリ使用量ではありません。自社の環境で測ります。
11. 用語集
- RAG(検索拡張生成)
- 質問に関係する文書の断片を外部から検索し、質問と一緒にモデルへ渡す方式。
- 埋め込み(embedding)
- テキストを、意味の近さを距離で比べられるベクトルに変換したもの。
- ベクトル検索
- 質問の埋め込みに近い断片を、埋め込みの類似度で探す検索。
- 近似最近傍探索
- 全件を比べず、HNSW などの索引で近いものを高速に探す方法。取りこぼしがありうる。
- BM25
- 語彙の一致にもとづく順位付けの関数。識別子や専門用語の完全一致に強い。
- ハイブリッド検索
- 語彙検索(BM25)と埋め込み検索を併用する検索。
- チャンク
- 文書を検索用に分けた断片。大きさと重なりを設定する。
- 再ランク
- 検索で得た候補を、より精密な方法で並べ替える段階。
- コンテキストウィンドウ(文脈窓)
- モデルが1回の処理で参照できるトークンの上限。入力・出力・思考が共有することがある。
- KV キャッシュ
- 過去のトークンのキーと値を保存して再利用するメモリ。文脈長とバッチに比例して増える。
- GQA/MQA/MLA
- KV の量を減らす注意の方式。KV ヘッド数を減らす(GQA・MQA)、潜在ベクトルに圧縮する(MLA)。
- context rot
- 文脈が長くなるほど、精度と再現率が下がる現象(Anthropic の用語)。
- 間接プロンプトインジェクション
- 取り込んだ文書やウェブページ内の指示によって、モデルの挙動が意図せず変わること。
- recall@k
- 上位 k 件に、正解の断片が含まれる割合。
12. 参考資料(一次情報)
- Lewis P. ほか "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", arXiv:2005.11401 (2020; v4 2021年4月) — arxiv.org/abs/2005.11401
- Karpukhin V. ほか "Dense Passage Retrieval for Open-Domain Question Answering", arXiv:2004.04906 (2020; v3 2020年9月) — arxiv.org/abs/2004.04906
- Guu K. ほか "REALM: Retrieval-Augmented Language Model Pre-Training", arXiv:2002.08909 (2020年2月) — arxiv.org/abs/2002.08909
- Asai A. ほか "Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection", arXiv:2310.11511 (2023年10月) — arxiv.org/abs/2310.11511
- Es S. ほか "Ragas: Automated Evaluation of Retrieval Augmented Generation", arXiv:2309.15217 (2023; v2 2025年4月) — arxiv.org/abs/2309.15217
- Reimers N., Gurevych I. "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks", arXiv:1908.10084 (2019年8月) — arxiv.org/abs/1908.10084
- Malkov Yu. A., Yashunin D. A. "Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs", arXiv:1603.09320 (2016; v4 2018年8月) — arxiv.org/abs/1603.09320
- Douze M. ほか "The Faiss library", arXiv:2401.08281 (2024; v4 2025年10月) — arxiv.org/abs/2401.08281
- Guo R. ほか "Accelerating Large-Scale Inference with Anisotropic Vector Quantization", arXiv:1908.10396 (2019; v5 2020年12月、ScaNN) — arxiv.org/abs/1908.10396
- Thakur N. ほか "BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models", arXiv:2104.08663 (2021; v4 2021年10月) — arxiv.org/abs/2104.08663
- Muennighoff N. ほか "MTEB: Massive Text Embedding Benchmark", arXiv:2210.07316 (2022; v3 2023年3月) — arxiv.org/abs/2210.07316
- Günther M. ほか "Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models", arXiv:2409.04701 (2024; v3 2025年7月) — arxiv.org/abs/2409.04701
- Chen T. ほか "Dense X Retrieval: What Retrieval Granularity Should We Use?", arXiv:2312.06648 (2023; v3 2024年10月) — arxiv.org/abs/2312.06648
- Barnett S. ほか "Seven Failure Points When Engineering a Retrieval Augmented Generation System", arXiv:2401.05856 (2024年1月) — arxiv.org/abs/2401.05856
- Hsieh C.-P. ほか "RULER: What's the Real Context Size of Your Long-Context Language Models?", arXiv:2404.06654 (2024; v3 2024年8月) — arxiv.org/abs/2404.06654
- Morris J. X. ほか "Text Embeddings Reveal (Almost) As Much As Text", arXiv:2310.06816 (2023年10月) — arxiv.org/abs/2310.06816
- Liu N. F. ほか "Lost in the Middle: How Language Models Use Long Contexts", arXiv:2307.03172 (2023; v3 2023年11月) — arxiv.org/abs/2307.03172
- Modarressi A. ほか "NoLiMa: Long-Context Evaluation Beyond Literal Matching", arXiv:2502.05167 (2025; v3 2025年7月) — arxiv.org/abs/2502.05167
- Bai Y. ほか "LongBench: A Bilingual, Multitask Benchmark for Long Context Understanding", arXiv:2308.14508 (2023; v2 2024年6月) — arxiv.org/abs/2308.14508
- Stanford CRFM "HELM Long Context"(リーダーボード。ページで確認した版は v1.0.0、2025年9月29日、確認日 2026年10月15日) — crfm.stanford.edu/helm/long-context/latest/
- Li Z. ほか "Retrieval Augmented Generation or Long-Context LLMs? A Comprehensive Study and Hybrid Approach", arXiv:2407.16833 (2024; v2 2024年10月) — arxiv.org/abs/2407.16833
- Zou W. ほか "PoisonedRAG: Knowledge Corruption Attacks to Retrieval-Augmented Generation of Large Language Models", arXiv:2402.07867 (2024; v3 2024年8月) — arxiv.org/abs/2402.07867
- Anthropic "Context windows"(Claude API ドキュメント、確認日 2026年10月15日) — platform.claude.com/docs/en/build-with-claude/context-windows
- Google "Gemini thinking"(Gemini API ドキュメント。Gemini 4 の文脈窓と出力上限の記載、確認日 2026年10月15日) — ai.google.dev/gemini-api/docs/thinking
- Anthropic "Introducing Contextual Retrieval"(2024年9月19日) — www.anthropic.com/news/contextual-retrieval
- Llama Team(Grattafiori A. ほか) "The Llama 3 Herd of Models", arXiv:2407.21783 (2024年7月; v3 2024年11月) — arxiv.org/abs/2407.21783
- DeepSeek-AI "deepseek-ai/DeepSeek-V3"(Hugging Face の公式モデルページの config.json、確認日 2026年10月15日) — huggingface.co/deepseek-ai/DeepSeek-V3/blob/main/config.json
- OpenAI "openai/gpt-oss-120b"(Hugging Face の公式モデルページの config.json、確認日 2026年10月15日) — huggingface.co/openai/gpt-oss-120b/blob/main/config.json
- DeepSeek-AI "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model", arXiv:2405.04434 (2024; v5 2024年6月、MLA) — arxiv.org/abs/2405.04434
- OpenAI "gpt-oss-120b & gpt-oss-20b Model Card", arXiv:2508.10925 (2025年8月8日) — arxiv.org/abs/2508.10925
- Ainslie J. ほか "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints", arXiv:2305.13245 (2023; v3 2023年12月) — arxiv.org/abs/2305.13245
- Shazeer N. "Fast Transformer Decoding: One Write-Head is All You Need", arXiv:1911.02150 (2019年11月、MQA) — arxiv.org/abs/1911.02150
- Kwon W. ほか "Efficient Memory Management for Large Language Model Serving with PagedAttention", arXiv:2309.06180 (2023年9月、vLLM) — arxiv.org/abs/2309.06180
- Liu Z. ほか "KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache", arXiv:2402.02750 (2024; v2 2024年7月) — arxiv.org/abs/2402.02750
- OWASP "LLM08:2025 Vector and Embedding Weaknesses"(OWASP Top 10 for LLM Applications 2025、確認日 2026年10月15日) — genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/
- OWASP "LLM01:2025 Prompt Injection"(OWASP Top 10 for LLM Applications 2025、確認日 2026年10月15日) — genai.owasp.org/llmrisk/llm01-prompt-injection/
- NIST "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1(2024年7月), DOI 10.6028/NIST.AI.600-1 — doi.org/10.6028/NIST.AI.600-1
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1(2023年1月), DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
- ISO/IEC "ISO/IEC TS 42119-2:2025 Artificial intelligence — Testing of AI — Part 2: Overview of testing AI systems"(2025年11月) — www.iso.org/standard/84127.html
- ISO/IEC "ISO/IEC 5259-2:2024 Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 2: Data quality measures"(2024年11月) — www.iso.org/standard/81860.html
- ISO/IEC "ISO/IEC 42001:2023 Information technology — Artificial intelligence — Management system"(2023年12月) — www.iso.org/standard/81230.html
- ISO/IEC "ISO/IEC 23894:2023 Information technology — Artificial intelligence — Guidance on risk management"(2023年2月) — www.iso.org/standard/77304.html
- ISO/IEC "ISO/IEC TR 17903:2024 Information technology — Artificial intelligence — Overview of machine learning computing devices"(2024年5月、技術報告書) — www.iso.org/standard/85078.html
- ISO/IEC "ISO/IEC TR 20226:2025 Information technology — Artificial intelligence — Environmental sustainability aspects of AI systems"(2025年7月、技術報告書) — www.iso.org/standard/86177.html
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| RAG の原論文:パラメトリックな記憶と Wikipedia のベクトル索引、100語の断片、約2,100万件、Faiss の HNSW。動機(出典の提示と知識の更新) | Lewis ら 出典1 https://arxiv.org/abs/2005.11401 | 事実 |
| DPR:100語のパッセージ21,015,324件、BERT(base)で768次元、Faiss で索引化。REALM:事前学習への検索器の組み込み | Karpukhin ら、Guu ら 出典2 https://arxiv.org/abs/2004.04906 出典3 https://arxiv.org/abs/2002.08909 | 事実 |
| Self-RAG:必要なときだけ検索し、反省トークンで点検する方式 | Asai ら 出典4 https://arxiv.org/abs/2310.11511 | 事実 |
| Ragas:人手の正解なしでの RAG の評価指標群 | Es ら 出典5 https://arxiv.org/abs/2309.15217 | 事実 |
| Sentence-BERT:約5,000万回の推論・約65時間から約5秒へ、コサイン類似度。HNSW、Faiss、ScaNN の位置づけ | 各論文 出典6 https://arxiv.org/abs/1908.10084 出典7 https://arxiv.org/abs/1603.09320 出典8 https://arxiv.org/abs/2401.08281 出典9 https://arxiv.org/abs/1908.10396 | 事実 |
| BEIR(18データセット、10方式、BM25 が頑健)。MTEB(8タスク、58データセット、112言語、33モデル、単一の方式は支配しない) | Thakur ら、Muennighoff ら 出典10 https://arxiv.org/abs/2104.08663 出典11 https://arxiv.org/abs/2210.07316 | 事実 |
| Dense X(検索単位の選択と命題)。late chunking。Contextual Retrieval(失敗を49%・67%減、約20万トークン未満ならまるごと入れる選択肢、BM25 とエラーコードの例) | 各論文、Anthropic の解説 出典13 https://arxiv.org/abs/2312.06648 出典12 https://arxiv.org/abs/2409.04701 出典25 https://www.anthropic.com/news/contextual-retrieval | 事実 |
| RAG の7つの失敗点、検証は運用中にしか実現できないこと | Barnett ら 出典14 https://arxiv.org/abs/2401.05856 | 事実 |
| 埋め込みの復元(32トークンの92%、氏名の復元) | Morris ら 出典16 https://arxiv.org/abs/2310.06816 | 事実 |
| Lost in the Middle、RULER(17モデル、32K以上を謳う半数が32Kで満足な性能)、NoLiMa(13モデル、32Kで11モデルが50%未満、GPT-4o 99.3%→69.7%)、LongBench(21データセット)、HELM Long Context(5課題、v1.0.0) | 各論文、HELM のページ 出典17 https://arxiv.org/abs/2307.03172 出典15 https://arxiv.org/abs/2404.06654 出典18 https://arxiv.org/abs/2502.05167 出典19 https://arxiv.org/abs/2308.14508 出典20 https://crfm.stanford.edu/helm/long-context/latest/ | 事実 |
| 文脈窓の宣言値(Claude の1M・200k・出力128k、context rot の記載。Gemini 4 の1,048,576の共有。Llama 3 の128K。gpt-oss の131,072) | 各社の公式ドキュメント・論文・モデルカード 出典23 https://platform.claude.com/docs/en/build-with-claude/context-windows 出典24 https://ai.google.dev/gemini-api/docs/thinking 出典26 https://arxiv.org/abs/2407.21783 出典30 https://arxiv.org/abs/2508.10925 | 事実 |
| RAG と長文脈の比較(LC が平均で上回る、RAG は費用が低い、Self-Route) | Li ら 出典21 https://arxiv.org/abs/2407.16833 | 事実 |
| KV キャッシュと GQA・MQA・MLA の説明、MLA の保存要素数、KV キャッシュ93.3%減。PagedAttention(2〜4倍)、KIVI(2.6倍、バッチ最大4倍) | 各論文 出典34 https://arxiv.org/abs/2402.02750 出典31 https://arxiv.org/abs/2305.13245 出典32 https://arxiv.org/abs/1911.02150 出典29 https://arxiv.org/abs/2405.04434 出典33 https://arxiv.org/abs/2309.06180 | 事実 |
| モデルの構成値(Llama 3 の層数・KV ヘッド数、DeepSeek-V3 の config、gpt-oss の config と窓128・GQA・YaRN) | Llama 3 の論文、公式 config.json、gpt-oss モデルカード 出典26 https://arxiv.org/abs/2407.21783 出典27 https://huggingface.co/deepseek-ai/DeepSeek-V3/blob/main/config.json 出典28 https://huggingface.co/openai/gpt-oss-120b/blob/main/config.json 出典30 https://arxiv.org/abs/2508.10925 | 事実 |
| OWASP LLM08(権限を考慮したベクトル保管、分離、ログ)、LLM01(間接プロンプトインジェクション、外部コンテンツの分離、RAG Triad) | OWASP の公式ページ 出典35 https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/ 出典36 https://genai.owasp.org/llmrisk/llm01-prompt-injection/ | 事実 |
| PoisonedRAG(数百万件に5件の悪意あるテキストで約90%、防御は不十分) | Zou ら 出典22 https://arxiv.org/abs/2402.07867 | 事実 |
| NIST AI 600-1(confabulation)、AI 100-1(自主的な枠組み) | NIST の文書 出典37 https://doi.org/10.6028/NIST.AI.600-1 出典38 https://doi.org/10.6028/NIST.AI.100-1 | 事実 |
| ISO/IEC TS 42119-2:2025、5259-2:2024、42001:2023、23894:2023、TR 17903:2024、TR 20226:2025 の番号・題名・発行年月 | ISO の標準ページ 出典39 https://www.iso.org/standard/84127.html 出典40 https://www.iso.org/standard/81860.html 出典41 https://www.iso.org/standard/81230.html 出典42 https://www.iso.org/standard/77304.html 出典43 https://www.iso.org/standard/85078.html 出典44 https://www.iso.org/standard/86177.html | 事実 |
| ベクトルの記憶量(64.6/32.3/16.1 GB、4.1/12.3 GB)、チャンクの数とトークン数(556/223/111、1,000〜20,000)、KV キャッシュの計算(式、各モデルの値)、プレフィルの計算量の比(約6.1万トークンで交差、128Kで約2.1倍)、デコード速度の上限(約188/176/90 トークン/秒) | 本稿の計算。断片数・次元数・メモリ帯域3 TB/s・T=10万トークンなどは説明用の仮定で、特定の製品・文書の値ではない | 本稿の計算 |
| 「検索と生成を分けて測る」「ハイブリッド検索を試す」「表は条件ごと保持する」「数値は構造化データで扱う」「導入前のチェックリスト」、素材技術者の視点①〜④、RAG と長文脈の比較表 | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
| 図2・図3・図4・図5が説明用の作図であること(図3の数値・表は架空の例)、図1・図6がAI生成イメージ(画像未設置の枠)であること | 本記事による注記 | 解説 |
| 現行の各社最新モデルの長文脈の実効性能、RAG・ベクトル検索の性能を定める国際規格、素材文書での RAG の精度、チェックリストの有効性、Llama 3.1 の公式 config.json、HELM Long Context のより新しい版 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない(本稿) | 解説 |
最終更新:2026年10月15日(確認日)/出典は一次情報(原論文、開発元の公式ドキュメント・config.json・モデルカード、OWASP・NIST・ISO の公式ページ)に限定しています。規格の本文は有料のため確認できていません。コンテキスト長などの仕様は変化が速く、確認日より後の状態は保証しません。 現行の各社最新モデルの長文脈の実効性能、RAG・ベクトル検索の性能を定める国際規格、素材文書での RAG の精度、チェックリストの有効性、Llama 3.1 の公式 config.json、HELM Long Context のより新しい版は、確認できなかったため記載していません。 KV キャッシュ・ベクトル・チャンクの計算は、公開された構成値と説明用の仮定にもとづく概算で、実際の実装と異なります。 図2〜図5はベクター作図、図1と図6はAI生成イメージ(画像未設置の枠)であり、いずれも実際の製品内部や実在の材料データを示すものではありません。