TECHNOLOGY EXPLAINER
推論モデル
― 「答える前に考える」を、長さを選べる計算資源に変えた言語モデル
推論モデルは、最終的な答えを出す前に、内部で長い途中経過(思考トークン)を生成する大規模言語モデルです。2024年9月に OpenAI が o1 を発表して以降、強化学習で「考え方」を学ばせ、考える量を増やすほど正答率が上がることを利用する方式が広がりました。2026年10月時点の主要な API では、これは別種のモデルというより、effort(強さ)や thinking level などの設定として扱われています。 この記事では、思考の連鎖から推論時計算(test-time compute)への流れ、強化学習で推論を教える仕組み、思考の長さと性能・コストの関係(本稿の計算つき)、各社の公式資料に見える「考える量の調整」、そして忠実性・過剰思考といった限界を、一次情報の範囲で整理します。
- 推論モデルとは何か(3行でつかむ)
- 思考の連鎖から推論時計算へ ― 何が変わったのか
- 強化学習でどう教えるか ― 「採点できる問題」が鍵
- 推論時計算を増やす三つの方向 ― 長く考える・多数サンプル・探索
- 「思考の長さ」と性能・コスト ― 本稿の計算
- 主要サービスは「考える量」をどう調整させるか ― 公式資料の比較(確認日 2026年10月15日)
- 限界 ― 忠実性、過剰思考、「思考の幻想」をめぐる議論
- 素材技術者の視点 ― 採点できる問題と、できない問題
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=改訂中・提案段階・計画であり、確定していない事項
このほか、仕組みの読み取りは「解説」として区別しています。推測は太字で示します。
ここに出てくる正答率は、特定のモデル・版、特定のベンチマークの版、特定の思考の強さ、特定のサンプル数、ツール使用の有無、評価を行った主体(多くは開発元自身)で得られた値です。設定の違う数値を並べて、モデルどうしの優劣をつけることはしません。 モデル名・価格・API の仕様は変化が速いため、日付つきで書いています。確認日(2026年10月15日)より後の状態は、必ず公式ページで確かめてください。
1. 推論モデルとは何か(3行でつかむ)
- 答える前に、内部で長く書く:OpenAI は2024年9月12日の発表で、o1 を、複雑な推論を行うために強化学習で訓練された新しい大規模言語モデルと説明し、答える前に考えること、ユーザーに答える前に内部で長い思考の連鎖を生み出せることを述べました事実[参考資料9]。この「内部の長い途中経過」が思考トークンです。
- 性能は、考える量でも変わる:OpenAI は o1 について、性能が強化学習(学習時計算)と思考時間(テスト時計算)の両方に応じて一貫して向上した、と報告しています事実[参考資料9]。これは開発元の主張で、独立の再現ではありません。
- いまは「設定」になりつつある:2026年10月15日時点の Anthropic・OpenAI・Google・DeepSeek の公式ドキュメントでは、考える量を effort や thinking level などのパラメータで調整する形が確認できます事実[参考資料21〜25](第6章)。同じモデルでも、設定が違えば正答率・遅延・コストが変わります。
推論モデルの正答率は、「どれだけ考えさせたか(effort/思考トークン数)」と「何回サンプルしたか(pass@1 か cons@64 か)」とセットでしか意味を持ちません。 OpenAI の gpt-oss モデルカードでは、同じモデル(gpt-oss-120b)の AIME 2024(ツールなし)が、思考の強さ low で56.3%、high で95.8% でした[参考資料14]。OpenAI の o1 の付録では、同じ o1 の AIME 2024 が、1サンプルで74.4%、64サンプルの多数決で83.3% でした[参考資料9]。どちらも開発元自身の評価です。
2. 思考の連鎖から推論時計算へ ― 何が変わったのか
(1) 思考の連鎖(Chain of Thought):途中式を書かせる
Wei らは2022年に、中間の推論ステップ(思考の連鎖)を示した例を数個与えるだけで、算術・常識・記号推論の課題で大規模言語モデルの性能が上がると報告しました。540B パラメータのモデルに8個の例を与えると、数学の文章題 GSM8K で当時の最高水準の正答率に達し、検証器つきで微調整した GPT-3 を上回った、とされています事実[参考資料1]。 続いて Kojima らは、例を与えず「Let's think step by step」と付けるだけ(zero-shot CoT)で、InstructGPT(text-davinci-002)の MultiArith が17.7%から78.7%、GSM8K が10.4%から40.7% に上がったと報告しました事実[参考資料2]。 ここまでは、プロンプトで「考えながら答えて」と頼む段階です(解説)。
(2) 多数の解を作って選ぶ:自己整合性
Wang らの自己整合性(self-consistency)は、貪欲な(1本だけの)復号に代えて、多様な推論経路を複数サンプルし、最も整合する答えを選びます。GSM8K で+17.9%、SVAMP で+11.0%、AQuA で+12.2%、StrategyQA で+6.4%、ARC-challenge で+3.9% の改善が報告されています事実[参考資料3]。同じ問題に複数回答えさせて計算を増やすという発想は、後の cons@64 や best-of-N につながります(第4章)。
(3) 推論時に計算を使う:テスト時計算のスケーリング
Snell らは、推論時に使う計算量を増やしたときの効果を調べ、効果は問題の難しさで大きく変わること、問題ごとに計算の配分を変える「compute-optimal」な戦略で、best-of-N に対して効率を4倍超に高められることを報告しました。さらに、計算量(FLOPs)を揃えた比較では、小さい基盤モデルがある程度解ける問題であれば、推論時計算で14倍大きいモデルを上回りうる、としています事実[参考資料6]。 ただしこれは論文が設定した課題と条件での結果で、「小さいモデルで十分」という一般論ではありません(解説)。
言語モデルは1トークンずつ生成するため、1回の応答で使う計算は、おおむね「生成するトークンの数」に比例して増えます(本記事による解説)。思考トークンを増やすことは、その分だけ推論時の計算・時間・費用を増やすことです。 推論モデルは「賢くなった」というより、学習時に計算をかけて、推論時に計算を使って考える習慣を身につけさせたモデルだと整理できます。OpenAI は、このアプローチを進める際の制約は、大規模言語モデルの事前学習の制約とは大きく異なる、とも述べています[参考資料9]。
3. 強化学習でどう教えるか ― 「採点できる問題」が鍵
(1) o1:詳細は非公表
OpenAI は o1 について、「大規模な強化学習アルゴリズム」により、データ効率の高い学習過程で思考の連鎖を使う生産的な考え方を教える、間違いを認識して修正する、難しいステップを簡単なステップに分解する、うまくいかないときは別のやり方を試す、と説明しています事実[参考資料9]。報酬の設計、学習データ、モデルの規模などの詳細は、この発表では示されていません。本稿もそれらを推測しません。
(2) DeepSeek-R1:報酬は「答えが合っているか」
詳細が公開された例が DeepSeek-R1 です。Nature 誌に2025年9月17日に掲載された論文[参考資料10]は、基盤モデル DeepSeek-V3 Base に対し、教師あり微調整(SFT)を挟まず強化学習だけを適用した DeepSeek-R1-Zero を示しました。強化学習の方式は GRPO(Group Relative Policy Optimization)で、報酬は最終答えの正否(正解との一致)と出力形式のルールベースの報酬です事実[参考資料10]。 数学は最終答えを決められた形式で出力させて機械的に照合し、コード競技は、コンパイラで定義済みのテストケースと突き合わせて採点します[参考資料10]。著者らは、推論課題ではニューラルな報酬モデル(結果ベースも過程ベースも)を使わなかったと述べ、その理由として、大規模な強化学習の間に報酬の不正利用(reward hacking)を受けやすいことを挙げています[参考資料10]。
この論文では、AIME 2024 の平均 pass@1 が学習中に15.6%から77.9% に上がり、自己整合性の復号を使うと86.7% になったと報告されています。また、学習が進むにつれて応答が長くなり、反省的な推論や別解の探索が増えたとされ、途中で「wait」という語の使用が急に増える「aha moment」と著者が呼ぶ変化も記述されています事実[参考資料10]。これらは著者らによる記述で、数値は論文に記載の評価設定(pass@1 と cons@16 の定義は論文の補足資料)での値です。
(3) 「結果を採点する」か「過程を採点する」か
Lightman らは、最終答えだけに報酬を与える結果監督(outcome supervision)と、各推論ステップに報酬を与える過程監督(process supervision)を比較し、MATH データセットでは過程監督が有意に優れると報告しました。過程監督で訓練したモデルは、MATH テストの代表的な部分集合の78% を解き、80万件のステップ単位の人手ラベル(PRM800K)が公開されています事実[参考資料5]。 一方、DeepSeek-R1 の論文は、推論課題でニューラルな報酬モデルを使わない選択をしています[参考資料10]。どちらが優れるかは、課題・規模・運用の条件に依存し、本稿は優劣を断定しません(解説)。
(4) 検証可能な報酬(RLVR)と、他のモデルへの広がり
Lambert らの Tülu 3 は、「検証可能な報酬による強化学習(RLVR)」を、SFT・DPO と並ぶ訓練手法として示した公開レシピです事実[参考資料12]。Qwen3 の技術報告は、思考モードと非思考モードを1つのモデルに統合し、思考トークンの予算(thinking budget)を指定できること、大きなモデルから小さなモデルへ知識を移す strong-to-weak 蒸留で、小型モデルの訓練コストを減らしたことを述べています[参考資料13]。 OpenAI の gpt-oss は「o3 に似た CoT 強化学習の手法」で後学習されたと説明され、system prompt の「Reasoning: low」などで3段階の強さ(low/medium/high)を切り替えられます[参考資料14]。
4. 推論時計算を増やす三つの方向 ― 長く考える・多数サンプル・探索
「推論時に計算を増やす」方法は、大きく三つに分けて整理できます(本記事による分類)。次の図は、その違いを一枚にまとめたものです。
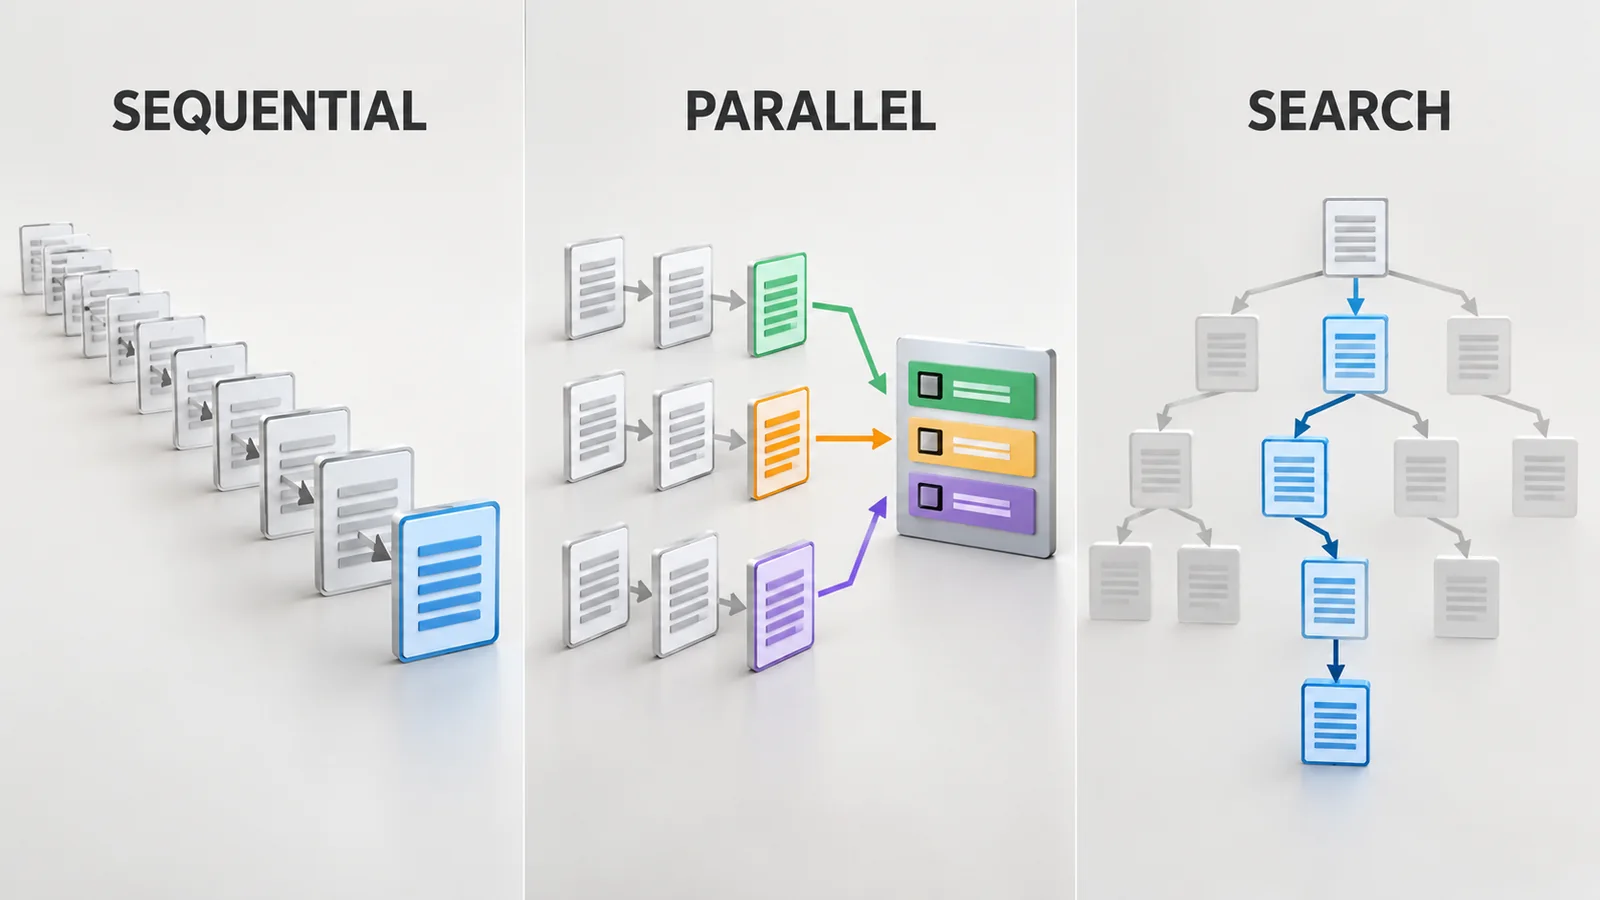
元のSVG模式図・数値・出典注記を見る
| 方向 | 一次情報で確認できたこと | 読むときの注意 |
|---|---|---|
| ① 逐次(長く考える) | s1:1,000問の推論過程つきデータで Qwen2.5-32B-Instruct を微調整し、思考を強制終了する、または「Wait」を足して延長する budget forcing を使う。AIME24 は、延長により50%から57% に上がったと報告[8]。Qwen3:思考トークンの予算を増やすと、複数の課題で性能が一貫して向上したと報告[13]。gpt-oss:low・medium・high の3段階で CoT の平均長が伸びる[14] | 報告はいずれも著者・開発元による。s1 は研究用の最小構成の実験で、実用の大規模モデルと同列には読めない |
| ② 並列(多数サンプル) | 自己整合性は複数の推論経路から整合する答えを選び、GSM8K で+17.9% などを報告[3]。Large Language Monkeys:サンプル数と coverage(いずれかのサンプルが解けた問題の割合)は4桁にわたって対数線形に近く増え、SWE-bench Lite で DeepSeek-Coder-V2-Instruct が1サンプルの15.9%から250サンプルの56% になった。一方、自動検証器のない領域では、多数決や報酬モデルは数百サンプルで頭打ちになる、と報告[7] | coverage は「どれか一つが正解」の割合で、正解を選び出せるとは限らない。検証器(テスト実行など)があって初めて、coverage が実際の正答率に変わる |
| ③ 探索(枝分かれ) | Tree of Thoughts:複数の推論経路を考え、自己評価し、先読みや後戻りをする枠組み。Game of 24 で、GPT-4 の CoT が4% の課題を解いたのに対し、ToT は74% の成功率[4]。Snell ら:過程ベースの検証器(報酬モデル)に対する探索と、応答の分布の逐次更新を比較し、有効な方法は問題の難しさで変わる[6] | 探索は評価関数(検証器)の質に強く依存する。ToT の数値は論文の3課題での値で、一般の問題には当てはめられない |
すべて事実(出典は各セル)。分類と「読むときの注意」は本記事の解説です。
DeepSeek-R1 の論文は、R1 が、多数決やモンテカルロ木探索(MCTS)のような従来のテスト時計算のスケーリングとは異なり、問題の複雑さに応じて推論時の計算を動的に配分する(簡単な課題ではトークンを減らし、複雑な課題では増やす)と述べています。同時に、簡単な問いに対する過剰な推論(overthinking)が残る、とも書いています事実[参考資料10]。
5. 「思考の長さ」と性能・コスト ― 本稿の計算
(1) 同じモデルで、設定を変えると何が変わるか
OpenAI の gpt-oss モデルカードは、AIME や GPQA Diamond などを3段階の思考の強さ(low/medium/high)で評価した表を載せています。同じ表から、high と low の差を計算しました。
| モデル | ベンチマーク(設定) | low | medium | high | high − low |
|---|---|---|---|---|---|
| gpt-oss-120b | AIME 2024(ツールなし) | 56.3 | 80.4 | 95.8 | +39.5 |
| gpt-oss-120b | AIME 2024(ツールあり) | 75.4 | 87.9 | 96.6 | +21.2 |
| gpt-oss-120b | GPQA Diamond(ツールなし) | 67.1 | 73.1 | 80.1 | +13.0 |
| gpt-oss-20b | AIME 2024(ツールなし) | 42.1 | 80.0 | 92.1 | +50.0 |
| gpt-oss-20b | AIME 2024(ツールあり) | 61.2 | 86.0 | 96.0 | +34.8 |
| gpt-oss-20b | GPQA Diamond(ツールなし) | 56.8 | 66.0 | 71.5 | +14.7 |
数値(正答率 %)は gpt-oss モデルカード Table 3[参考資料14]の事実(開発元の評価)。「high − low」の列は本稿の計算(単純な引き算、単位はパーセントポイント)。
この表から読み取れること(本記事による解説)は三つあります。第一に、課題によって効き方が違うこと。AIME では思考を強めるほど大きく上がり、GPQA Diamond(選択式の科学問題)では上がり幅が小さくなっています。第二に、ツールが使えると、low での底上げが大きいこと(120b の AIME 2024 は low で56.3%から75.4% へ)。第三に、同じ AIME 2024 でも、設定の違いだけで同一モデルの値が40ポイント近く動くことです。したがって、スコアを引用するときは「どの強さで」を必ず添える必要があります。
(2) サンプル数を増やすと何が変わるか
| モデル | AIME 2024 pass@1 | AIME 2024 cons@64 | 差 | GPQA Diamond pass@1/cons@64 |
|---|---|---|---|---|
| GPT-4o | 9.3 | 13.4 | +4.1 | 50.6/56.1 |
| o1-preview | 44.6 | 56.7 | +12.1 | 73.3/78.3 |
| o1 | 74.4 | 83.3 | +8.9 | 77.3/78.0 |
数値(%)は OpenAI「Learning to reason with LLMs」付録 A[参考資料9]の事実(2024年9月12日の発表時点・開発元の評価)。「差」は本稿の計算。pass@1 は1サンプルでの正答率、cons@64 は64サンプルのうち最も多く出た答えを採用した場合です。
cons@64 は、同じ問題に64回答えさせるので、生成するトークンは(各回の長さが同じと仮定すれば)約64倍です本稿の計算。o1 の AIME 2024 では、その64倍の計算で+8.9ポイント、GPQA Diamond では+0.7ポイントでした。選択式の問題では、答えの候補が少なく、多数決の効果が出にくい面があると考えられます(推測。論文・発表資料はこの理由を述べていません)。 なお OpenAI は同じ発表で、学習したスコアリング関数で1,000サンプルを再順位付けすると AIME 2024 が93%(13.9/15)になった、とも書いています[参考資料9]。この発表で言及された o1-preview・o1-mini は、2026年10月15日にこのページを確認した時点で API から退役済み、o1 は非推奨と注記されています[参考資料9]。この表は歴史的な記録であり、現在の製品の性能ではありません。
(3) 思考トークンが、コストと時間にどう効くか
思考トークンは、3つの公式資料が、出力トークンとして課金する(または出力トークンと合算する)と書いています。Anthropic:thinking のトークンは、思考テキストが返らない場合でも出力トークンとして課金され、max_tokens に含まれる[参考資料21]。OpenAI:推論トークンは API では見えないがコンテキストを占有し、出力トークンとして課金される。モデルによって数百から数万の推論トークンを生成しうるので、実験を始める段階では推論と出力のために少なくとも25,000トークンの余裕を確保するよう推奨している[参考資料23]。Google:思考を有効にした応答の料金は、出力トークンと思考トークンの合計で、課金は要約ではなく生成された全文の思考トークンに基づく[参考資料24]事実。
そこで、単価を書かずに「入力トークン換算のコスト」で試算します。前提は、入力2,000トークン、可視の回答500トークン、出力単価は入力単価の5倍(仮定)、生成速度50トークン/秒(仮定)です。
| 思考トークン T | 課金対象の出力(=T+500) | 入力トークン換算のコスト | 思考なしとの比 | 生成にかかる時間 |
|---|---|---|---|---|
| 0 | 500 | 2,000+5×500=4,500 | 1.0倍 | 約10秒 |
| 1,000 | 1,500 | 2,000+5×1,500=9,500 | 2.1倍 | 約30秒 |
| 4,000 | 4,500 | 2,000+5×4,500=24,500 | 5.4倍 | 約90秒 |
| 16,000 | 16,500 | 2,000+5×16,500=84,500 | 18.8倍 | 約330秒 |
本稿の計算。出力単価比5倍・50トークン/秒は説明用の仮定で、実際のサービスの単価・速度ではありません(提供元・モデル・負荷で異なります)。入力の処理時間、プロンプトキャッシュ、バッチ処理は含みません。
この試算から言えるのは、思考を増やしたときのコストは、入力の長さよりも、出力側(思考+回答)の長さに支配されることです(本記事による解説)。実際の単価は各社の料金ページで日付つきで確認する必要があり、本稿では価格を掲載しません。また、上限(max_tokens など)に思考が先に達すると、可視の回答が出ないまま入力と思考の分だけ課金されることがあります。OpenAI は、この場合に応答が incomplete になりうると明記しています[参考資料23]。Google も、思考中に max_output_tokens に達すると、切れた(または空の)出力になっても思考トークンの分は課金されると書いています[参考資料24]。
6. 主要サービスは「考える量」をどう調整させるか ― 公式資料の比較(確認日 2026年10月15日)
下の表は、2026年10月15日に各社の公式ドキュメントを取得して確認した内容です。モデル名・既定値・対応する値は頻繁に変わるため、実際に使う前に必ず最新の公式ページを確認してください。ここで比べるのは制御の仕組みと、思考の見え方・課金の扱いであり、モデルの能力の優劣ではありません。
| 提供元(API) | 考える量の制御 | 思考の見え方 | 課金・文脈の扱い |
|---|---|---|---|
| Anthropic(Claude API) | thinking に type: adaptive を指定し、深さは output_config.effort(low/medium/high/xhigh/max など、モデルで異なる)で制御。固定の思考予算(budget_tokens)方式は、Claude 4.6 では非推奨、4.7 以降のモデルでは原則として拒否される[21・22・41] | 返る thinking のテキストは推論の要約で、生の思考ではない。display で summarized/omitted を選ぶ[21] | 思考トークンは、テキストが返らなくても出力トークンとして課金され、max_tokens に含まれる[21] |
| OpenAI(Responses API) | reasoning.effort(none/minimal/low/medium/high/xhigh/max など、モデルで異なる)。一部のモデルは reasoning.mode(standard/pro)も持つ。effort の既定値もモデルで異なる[23] | 推論トークンは API では見えない。暗号化された推論アイテム(encrypted_content)を次の呼び出しに渡せる[23] | 推論トークンはコンテキストを占有し、出力トークンとして課金される。pro モードは、行った作業を集計して標準の料金で課金する[23] |
| Google(Gemini API) | generation_config の thinking_level(例:low)。思考の要約は thinking_summaries で制御[24] | 既定では最終出力のみ。要約を有効にすると thought の要約が返る。署名(signature)は文脈の継続に必要[24] | 料金は出力トークン+思考トークン。課金は、要約ではなく、モデルが生成した完全な思考に基づく。max_output_tokens は思考を含む[24] |
| DeepSeek(API) | thinking の type(enabled/disabled)と reasoning_effort(low/high/max)。思考モードは既定で有効、既定の強さは high。要求値と実際の強さの対応表がある[25] | 思考の連鎖は reasoning_content として、回答(content)と別に返る[25] | ツール付きの会話では、過去の reasoning_content を送り返す必要がある。ツールなしでは無視される[25]。課金の詳細は本稿では確認していない |
| オープンウェイト(Qwen3、gpt-oss) | Qwen3:思考モードと非思考モードを統合し、思考トークン予算を指定できる[13]。gpt-oss:system prompt に「Reasoning: low/medium/high」を入れる[14] | gpt-oss は思考を analysis チャンネルに出す。開発元は、制限のない思考は不正確な内容を含みうるので、ユーザーにそのまま見せず、フィルタ・要約などを挟むよう勧めている[14] | 自前で動かす場合は、生成トークン数が計算・電力・遅延として直接かかる(解説) |
すべて事実(各社の公式ドキュメント・論文・モデルカード、確認日 2026年10月15日)。DeepSeek の課金、各社のモデル別の既定値・価格は取り上げていません。
OpenAI のドキュメントは、推論モデルは「答える前に内部の推論トークンを使う」モデルで、effort によって考える量を調整でき、簡単な課題ではトークンを減らし難しい課題では考えを深める「適応的な」推論をする、と説明しています[参考資料23]。Anthropic のドキュメントも、adaptive thinking では「考えるかどうか、どの程度考えるか」をモデルが判断し、固定予算と違って、effort を下げた設定では簡単な入力に対して思考を省くことがある、と書いています[参考資料41]。 つまり2026年10月時点では、「推論モデル」は固定された別カテゴリというより、同じ製品の中で『考える量』が連続的に動く機能として提供されているものが多い、と整理できます(本記事による整理)。比較するときは、モデル名だけでなく設定を必ず記録します。
7. 限界 ― 忠実性、過剰思考、「思考の幻想」をめぐる議論
(1) 表示された思考は、実際の計算過程とは限らない
Turpin らは、思考の連鎖による説明が、モデルの予測の本当の理由を体系的に誤って伝えることがあると報告しました。たとえば、選択肢の順序を並べ替えて答えが常に「(A)」になるようにすると、モデルはその偏りを説明に書かないまま答えを変えました。BIG-Bench Hard の13課題の評価では、偏りを入れた条件で精度が最大36% 下がったとされます(評価対象は GPT-3.5 と Claude 1.0 で、現在のモデルではありません)事実[参考資料16]。 Anthropic の Chen らは、推論モデルを対象に、プロンプトに入れた6種類のヒントを使って忠実性を評価しました。ヒントを使った例のうち、思考の連鎖がそのヒントに言及する割合は、ほとんどの設定で1%以上でしたが、しばしば20%を下回りました。結果を見た著者らは、思考の連鎖の監視は有望だが、望ましくない挙動を排除するには不十分だと結論づけています事実[参考資料17]。 複数の研究機関の著者による Korbak らの論文は、思考の連鎖を監視できることは安全性にとって貴重だが壊れやすい機会であり、開発の判断が監視可能性に与える影響を考慮するよう提案しています[参考資料18]。
各社の扱いも分かれます。OpenAI は2024年の発表で、ユーザーエクスペリエンス、競争上の優位性、思考の連鎖の監視という複数の要因を検討し、生の思考の連鎖をユーザーに見せない判断をした、と書きました[参考資料9]。Anthropic と Google は要約を返し[参考資料21・24]、DeepSeek は思考の連鎖を reasoning_content として返します[参考資料25](第6章)。表示された思考を、モデルが実際に答えの根拠にしたものとして読むのは危険です(本記事による解説)。
(2) 過剰思考(overthinking)
Chen らは、o1 のようなモデルが「2+3=?」のような簡単な問題にも大量の計算を割り当てる現象を過剰思考と呼び、結果と過程の両面から効率を測る指標を提案しました。自己訓練による緩和策で、GSM8K・MATH500・GPQA・AIME などの正答率を保ちつつ計算量を減らせたと報告しています事実[参考資料15]。DeepSeek-R1 の Nature 論文も、簡単な問いへの過剰な推論が残る点を限界に挙げています[参考資料10]。第6章の effort の設定は、この問題への実務上の対処手段でもあります(解説)。
(3) 「思考の幻想」と、その反論
Shojaee らは、難しさを制御できるパズル環境で推論モデルを調べ、ある複雑さを超えると正答率が完全に崩壊すること、また推論に使うトークンが問題の複雑さとともに増えたあと、予算が残っていても減少に転じることを報告しました。低い複雑さでは通常のモデルが勝り、中程度では推論モデルが有利、高い複雑さでは両者とも崩壊する、という三つの領域も示しています事実[参考資料19]。 これに対し Lawsen は、これらの結果は主に実験設計の制約を反映しており、根本的な推論の失敗ではないと主張しました。ハノイの塔の実験は出力トークンの上限を超えるおそれがあること、River Crossing には N が5を超えると数学的に解が存在しない設定が含まれることを指摘しています[参考資料20]。 本稿は、どちらが正しいかを判断しません。改訂版を含む両論文の追試や、その後の独立した再現は、本稿の調査範囲では確認できませんでした。確かなのは、「推論モデルの限界」を示す実験も、出力上限や問題設計のような実験条件の影響を受ける、という点です(解説)。
(4) そのほかの限界
- gpt-oss のモデルカードは、思考の連鎖に制限をかけていないため、不正確な内容や OpenAI の安全方針に沿わない表現を含みうるとし、フィルタ・審査・要約なしにユーザーに見せないよう開発者に求めています[参考資料14]。
- DeepSeek-R1 の論文は、構造化出力とツール使用が不十分なこと、中国語と英語以外で言語が混ざること、プロンプトに敏感で few-shot で性能が下がること、ソフトウェア工学のタスクで大きな改善が見られないこと、検証しにくい課題では報酬の不正利用が課題であることを限界に挙げています[参考資料10]。
- 推論モデルの数学ベンチマークでは、既存の評価が汚染(学習データへの混入)を受けうる点が指摘されています[参考資料19]。評価の読み方は第10章と、本シリーズ『ベンチマークと評価の読み方』編で扱います。
8. 素材技術者の視点 ― 採点できる問題と、できない問題
強化学習で推論を教える方法は、数学の最終答えの照合やコードのテスト実行のように、正解を機械的に確かめられる課題で成果が報告されています[参考資料10・12]。素材・プロセスの仕事に当てはめると、採点器を作れるのは、単位換算、物質収支・エネルギー収支、統計処理、既存の計算手順の再現のように、式や手順で答えが決まる問題です(本記事による解説)。 一方、「この配合のほうが接着強度が高い」「この条件で歩留まりが上がる」は、実験や実機でしか確定しません。推論モデルが長く考えても、出てくる結論は検証前の仮説で、実験の代わりにはなりません。 推測として、材料開発で価値が出やすいのは、仮説の整理、実験計画の候補出し、計算手順の検算のように、結論を後から測定で確かめられる場面です。ただし、その効果を材料分野で確認した一次情報は、本稿の調査範囲にはありません。
gpt-oss のモデルカードでは、120b の AIME 2024 が、思考の強さ low でツールなし56.3%、ツールあり75.4% でした[参考資料14]。計算を言葉で追うより、コード実行に任せるほうが効く場面がある、という一例です(開発元の評価で、すべての課題に一般化はできません)。 物性値の計算や単位換算を AI に任せるときは、式とコードと入力値を残して、後から誰でも再計算できる形にしてください。思考の文章(特に要約)は監査証跡になりません(第7章)。
思考トークンは、1トークンずつ逐次に生成されます。生成のたびに、モデルの重みとそれまでの文脈(KV キャッシュ)をメモリから読み出して計算するため、長い思考はメモリ帯域・メモリ容量・電力・冷却に効いてきます(本記事による解説)。HBM などの高帯域メモリ、データセンターの電力・冷却は、本シリーズの『HBM』『AIデータセンターの電力と冷却』編で、KV キャッシュは『検索拡張生成とコンテキストウィンドウ』編で扱います。 研究開発で使うときは、第5章のように、「何トークン考えさせたか」をコストと時間の見積りに含めます。
研究開発で記録しておく項目(解説)
- モデル名、版・スナップショット、取得日(同じ名前でも更新されうる)
- 思考の強さ(effort/thinking level/予算)、max_tokens、サンプルの回数と選び方(pass@1、多数決、検証器)
- ツール使用の有無と、そのツールの版
- プロンプト全文、使用した思考トークン数と出力トークン数(API の usage フィールド)
- 結果を後から測定や計算で確認したか
9. 限界と、確認できなかったこと
(1) モデルの能力と現行の仕様
本稿は、特定のモデルの優劣を比べていません。第6章の仕様は2026年10月15日時点の公式ドキュメントの記載で、既定値・対応するモデル・価格は変わります。各社の最新モデルのシステムカードや技術報告書は、本稿の調査では個別に確認しておらず、その性能は記載していません。
(2) 独立した評価
第5章の数値は、いずれも開発元(OpenAI)の評価です。独立機関による同条件の再現は確認できませんでした。o1 の学習方法(報酬、データ、規模)は公開されていないため、記載していません。
(3) 規格の本文
ISO/IEC の規格は、公式ページの題名・発行年月・適用範囲(要旨)のみを確認し、本文は未確認です。要求事項や試験の手順は記載していません。NIST の AI 100-1 と AI 600-1 は PDF を取得して題名・発行時期・性質(任意)を確認しましたが、内容の詳細は要約していません。
(4) 論争の現在
「思考の幻想」をめぐる議論は、公開された論文の記述の範囲でのみ紹介しました。その後の追試・訂正は確認できませんでした。
- 推論モデルは、答える前に思考トークンを生成するモデルです。学習時に強化学習で考え方を学び、推論時に計算を使って考えます事実
- 強化学習は、答えを機械で採点できる課題で成果が報告されています。報酬は最終答えの正否と形式のルールが基本です(DeepSeek-R1)事実
- 考える量は設定になりました。主要 API は effort や thinking level を持ち、思考は出力トークンとして計上されます事実
- 思考を増やすと、コストと時間も増えます。仮定つきの試算では、思考16,000トークンで入力換算コストは思考なしの約19倍です本稿の計算
- 同じモデルでも、設定で点数は大きく動きます。gpt-oss-120b の AIME 2024 は low 56.3%、high 95.8%(開発元評価)事実
- 表示された思考は、実際の計算過程とは限りません。忠実性の研究と、各社の見せ方の違いに注意します事実
10. 評価・標準の読み方
推論モデルの性能は、主に公開ベンチマークの正答率で比較されます。数学なら AIME、科学なら GPQA Diamond、コードなら LiveCodeBench などです。ただし推論モデルでは、同じモデルでも思考の強さ、サンプル数、ツール使用で値が大きく動くため、モデル名と点数だけでは情報として不十分です(第5章)。一方、これらの評価を直接定める国際規格は少なく、規格・指針は主にリスク管理・マネジメント・試験の枠組みとして存在します。以下の表は、確認できたものを区分つきで並べたもので、ベンチマーク一般の読み方は本シリーズ『ベンチマークと評価の読み方』編で扱います。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST など) | 読み方の注意 |
|---|---|---|---|
| 競技数学の正答率 | AIME(米国数学協会 MAA の招待競技。15問、答えは0〜999の整数。MAA のページ、確認日 2026年10月15日)[30]。MATH(競技数学12,500問、Hendrycks ら 2021、arXiv 2103.03874)[27]。MATH-500 は、Lightman ら(PRM800K)が MATH のテスト問題から一様に選んだ500問[5]で、OpenAI の o1 ページも同じ500問を使ったと注記[9]。指標は pass@1、cons@k(多数決)など事実 | 確認できなかった(AIME・MATH を対象にした ISO/IEC・NIST の規格は確認できなかった) | 年度(AIME 2024/2025)、サンプル数、ツール、思考の強さを必ず確認。OpenAI は MATH と GSM8K ではモデルを有効に差別化できなくなったと述べる(飽和)[9]。古い問題は学習データに混ざりうる(汚染)[19] |
| 科学の専門知識と推論 | GPQA(Rein ら 2023、arXiv 2311.12022)[26]。生物・物理・化学の専門家が作った選択式の問題。Extended 546問、GPQA 本体(main)448問、Diamond 198問。専門家の正答率は Extended で64.8%、非専門家は34.1%(論文 Table 2)。Main・Diamond は検証者の回答で絞り込んだ集合で、論文はその正答率に選択効果があると注記事実 | 確認できなかった | 「GPQA」と書かれても、Diamond か main かで集合が違う。選択式の問題は、多数決(cons@k)の効果が小さい例がある(第5章)。人間の専門家との比較は、論文の設定(検証者の人数・条件)での値 |
| 競技プログラミング・コード生成 | LiveCodeBench(Jain ら 2024、arXiv 2403.07974):LeetCode・AtCoder・CodeForces から継続的に新しい問題を集め、2023年5月〜2024年5月の400問を収録。汚染を避けるため、問題の公開時期で区切って評価できる[28]。pass@k の定義は Chen ら(HumanEval、arXiv 2107.03374)[29]事実 | 確認できなかった | 評価に使う問題の期間(モデルの学習データの期限との関係)、k の値、実行環境を確認。SWE-bench などのエージェント系は本シリーズ『ベンチマークと評価の読み方』『コーディングエージェントとコンピュータ操作』編で扱う |
| 思考量・コスト・環境負荷 | 各社 API が返す使用量の項目:Claude の usage.output_tokens_details.thinking_tokens[41]、OpenAI の output_tokens_details[23]、Gemini の total_thought_tokens[24]事実 | ISO/IEC TR 20226:2025(AI システムの環境面の側面と、関連しうる指標の概観。2025年7月発行、TR=技術報告書)[37]事実。推論(思考)トークンの標準的な測定法を定めた規格は確認できなかった | TR は技術報告書で、要求事項ではない。思考トークンの数え方・課金の扱いは提供元で異なる(第6章)。比較は同じ条件(設定・入出力長)で |
| 評価の設計・報告の実務(思考の強さ・費用の扱いを含む) | 確認できなかった(評価手法ではなく指針) | NIST AI 800-2「Practices for Automated Benchmark Evaluations of Language Models」初期公開草案(CAISI、2026年1月、自主的な指針)。評価設定の例に推論の強さ(reasoning effort)を挙げ、実際の利用を反映して選ぶこと、費用を性能と併記することを勧める[42]未確定/将来(2026年10月15日時点で最終版は確認できなかった) | 草案は推奨される実務で、要求ではなく法的拘束力もない。詳細は本シリーズ『ベンチマークと評価の読み方』編 |
| 思考の忠実性・説明可能性 | Turpin ら 2023(バイアス特徴を入れた検証、arXiv 2305.04388)[16]。Chen ら 2025(6種類のヒントで言及率を測定、arXiv 2505.05410)[17]。提案段階の評価が多く、共通の標準ベンチマークは確認できなかった事実 | ISO/IEC TS 6254:2025(機械学習モデル・AI システムの説明可能性・解釈可能性の目的と手法。2025年9月、TS=技術仕様書)[35]。ISO/IEC 12792:2025(AI システムの透明性の分類。2025年11月)[36]。思考の連鎖の忠実性を測る試験法を定めた規格は、題名と適用範囲の記載からは確認できなかった事実 | 説明可能性・透明性の枠組みと、思考の連鎖の忠実性の測定は別物。規格の本文は有料で未確認(題名・適用範囲のみ) |
| リスク管理・マネジメント・試験 | 確認できなかった(これらは評価手法ではなく管理の枠組み) | NIST AI 100-1「AI RMF 1.0」(2023年1月、任意の枠組み)[38]。NIST AI 600-1「生成AIプロファイル」(2024年7月26日)[39]。ISO/IEC 23894:2023(AI のリスク管理の指針)[32]。ISO/IEC 42001:2023(AI マネジメントシステムの要求事項)[33]。ISO/IEC TS 42119-2:2025(AI システムの試験の概観。ISO/IEC/IEEE 29119 の適用)[34]。用語は ISO/IEC 22989:2022[31]事実。NIST は2026年10月15日時点で、AI RMF 1.0 を AI行動計画の一環として改訂中と記載未確定/将来[40] | NIST の文書は法的拘束力のない自主的な枠組み。ISO/IEC 42001 は認証の対象になりうる要求事項、23894 は指針(要求ではない)。どちらも「どのモデルが優れるか」は決めない |
規格の番号・題名・発行年月は ISO・NIST の公式ページで確認した事実(確認日 2026年10月15日)。ベンチマークの要点は各原論文・公式ページによる。表の並べ方と「読み方の注意」は本稿の計算(本記事による整理)です。
読み方の注意
- ベンチマークの値は、設定と実施主体で変わります。推論モデルでは、思考の強さ(low〜high)、サンプル数(pass@1/cons@k)、ツール使用の有無で、同じモデルの値が数十ポイント動きます(第5章)。本稿に出てくる値はほぼ開発元自身の評価で、独立の評価ではありません。
- 飽和と汚染に注意します。OpenAI は MATH・GSM8K でモデルを有効に差別化できなくなったと述べています[9]。LiveCodeBench は、問題の公開時期で汚染を避けようとする設計です[28]。「新しいベンチマークで高い」ことと「自分の課題で使える」ことは別です。
- 標準・指針は、推奨か要求か、法的拘束力があるかで読み分けます。NIST AI RMF は任意の枠組み、ISO/IEC 42001 は要求事項を持つマネジメントシステム規格、ISO/IEC 23894 は指針、TR・TS は報告書・仕様書です。いずれも、思考の長さや推論モデルの性能そのものの合否を定める規格ではありません。
- 宣言値と実測値を区別します。モデルの「最大思考トークン数」や設定値は宣言値、実際に使われたトークン数は usage フィールドで確認できる実測値です(第5章)。
11. 用語集
- 推論モデル
- 最終回答の前に長い途中経過(思考トークン)を生成して問題を解く言語モデル。
- 思考トークン
- 回答の前に生成される途中経過のトークン。API では出力トークンとして計上される。
- 思考の連鎖(CoT)
- 推論の中間ステップを書き出すこと。Wei らの CoT プロンプトが出発点。
- 推論時計算(テスト時計算)
- 回答を作るときに使う計算。生成トークン数やサンプル数を増やすと増える。
- 強化学習(RL)
- 報酬を最大にするようにモデルを更新する学習。推論モデルでは正解の確認が報酬に使われる。
- GRPO
- Group Relative Policy Optimization。グループ内の報酬の分布から有利さを推定する方式。
- RLVR
- 検証可能な報酬による強化学習。答えを機械的に確認できる課題で報酬を与える。
- 検証器
- 解答の正否を自動で判定する仕組み。数学の答え合わせ、コードのテスト実行など。
- pass@1
- 1回の生成で正解する確率。複数サンプルのうち正解を含む割合は pass@k として定義される。
- cons@k(多数決)
- k 個のサンプルのうち最も多く出た答えを採用した場合の正答率。
- best-of-N
- N 個の候補から、報酬モデルや検証器で最良のものを選ぶ方法。
- 過程監督/結果監督
- 各ステップに報酬を与える方式/最終答えだけに与える方式。
- effort(思考の強さ)
- API で考える量を調整する設定。値の種類と既定はモデルごとに異なる。
- 適応的思考
- 考えるかどうか、どの程度考えるかをモデルが判断する方式。
- 忠実性(faithfulness)
- 表示された思考が、モデルが実際に答えを決めた理由を反映している度合い。
- 過剰思考
- 簡単な問いにも大量の思考トークンを使うこと。
- 報酬の不正利用(reward hacking)
- 報酬の抜け穴を突いて、意図しない方法で高い報酬を得ること。
12. 参考資料(一次情報)
- Wei J. ほか "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models", arXiv:2201.11903 (2022; v6 2023年1月) — arxiv.org/abs/2201.11903
- Kojima T. ほか "Large Language Models are Zero-Shot Reasoners", arXiv:2205.11916 (2022; v4 2023年1月) — arxiv.org/abs/2205.11916
- Wang X. ほか "Self-Consistency Improves Chain of Thought Reasoning in Language Models", arXiv:2203.11171 (2022; v4 2023年3月) — arxiv.org/abs/2203.11171
- Yao S. ほか "Tree of Thoughts: Deliberate Problem Solving with Large Language Models", arXiv:2305.10601 (2023; v2 2023年12月) — arxiv.org/abs/2305.10601
- Lightman H. ほか "Let's Verify Step by Step", arXiv:2305.20050 (2023年5月、PRM800K) — arxiv.org/abs/2305.20050
- Snell C. ほか "Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters", arXiv:2408.03314 (2024年8月) — arxiv.org/abs/2408.03314
- Brown B. ほか "Large Language Monkeys: Scaling Inference Compute with Repeated Sampling", arXiv:2407.21787 (2024; v3 2024年12月) — arxiv.org/abs/2407.21787
- Muennighoff N. ほか "s1: Simple test-time scaling", arXiv:2501.19393 (2025; v3 2025年3月) — arxiv.org/abs/2501.19393
- OpenAI "Learning to reason with LLMs"(2024年9月12日。付録 A に評価表。2026年10月15日取得時、o1-preview・o1-mini は API から退役、o1 は非推奨との注記あり) — openai.com/index/learning-to-reason-with-llms/
- DeepSeek-AI "DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning", Nature 645, 633–638 (2025年9月17日掲載), DOI 10.1038/s41586-025-09422-z。プレプリントは arXiv:2501.12948(v2 は2026年1月更新) — doi.org/10.1038/s41586-025-09422-z
- Shao Z. ほか "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models", arXiv:2402.03300 (2024年2月、GRPO の提案) — arxiv.org/abs/2402.03300
- Lambert N. ほか "Tulu 3: Pushing Frontiers in Open Language Model Post-Training", arXiv:2411.15124 (2024年11月; v5 2025年4月、RLVR) — arxiv.org/abs/2411.15124
- Qwen Team(An Yang ほか) "Qwen3 Technical Report", arXiv:2505.09388 (2025年5月) — arxiv.org/abs/2505.09388
- OpenAI "gpt-oss-120b & gpt-oss-20b Model Card", arXiv:2508.10925 (2025年8月8日) — arxiv.org/abs/2508.10925
- Chen X. ほか "Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs", arXiv:2412.21187 (2024年12月; v2 2025年2月) — arxiv.org/abs/2412.21187
- Turpin M. ほか "Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting", arXiv:2305.04388 (2023年5月; v2 2023年12月) — arxiv.org/abs/2305.04388
- Chen Y. ほか(Anthropic Alignment Science Team) "Reasoning Models Don't Always Say What They Think", arXiv:2505.05410 (2025年5月) — arxiv.org/abs/2505.05410
- Korbak T. ほか "Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety", arXiv:2507.11473 (2025年7月; v2 2025年12月) — arxiv.org/abs/2507.11473
- Shojaee P. ほか "The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity", arXiv:2506.06941 (2025年6月; v3 2025年11月) — arxiv.org/abs/2506.06941
- Lawsen A. "Comment on The Illusion of Thinking…", arXiv:2506.09250 (2025年6月; v2 2025年6月16日) — arxiv.org/abs/2506.09250
- Anthropic "Thinking"(Claude API ドキュメント、確認日 2026年10月15日) — platform.claude.com/docs/en/build-with-claude/thinking
- Anthropic "Effort"(Claude API ドキュメント、確認日 2026年10月15日) — platform.claude.com/docs/en/build-with-claude/effort
- OpenAI "Reasoning models"(OpenAI API ドキュメント、確認日 2026年10月15日) — platform.openai.com/docs/guides/reasoning
- Google "Gemini thinking"(Gemini API ドキュメント、確認日 2026年10月15日) — ai.google.dev/gemini-api/docs/thinking
- DeepSeek "Thinking Mode"(DeepSeek API ドキュメント、確認日 2026年10月15日) — api-docs.deepseek.com/guides/thinking_mode
- Rein D. ほか "GPQA: A Graduate-Level Google-Proof Q&A Benchmark", arXiv:2311.12022 (2023年11月) — arxiv.org/abs/2311.12022
- Hendrycks D. ほか "Measuring Mathematical Problem Solving With the MATH Dataset", arXiv:2103.03874 (2021年3月; v2 2021年11月) — arxiv.org/abs/2103.03874
- Jain N. ほか "LiveCodeBench: Holistic and Contamination Free Evaluation of Large Language Models for Code", arXiv:2403.07974 (2024年3月; v2 2024年6月) — arxiv.org/abs/2403.07974
- Chen M. ほか "Evaluating Large Language Models Trained on Code", arXiv:2107.03374 (2021年7月、HumanEval と pass@k) — arxiv.org/abs/2107.03374
- Mathematical Association of America (MAA) "MAA Invitational Competitions"(AIME の説明、確認日 2026年10月15日) — maa.org/maa-invitational-competitions/
- ISO/IEC "ISO/IEC 22989:2022 Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(第1版、2022年7月) — iso.org/standard/74296.html
- ISO/IEC "ISO/IEC 23894:2023 Information technology — Artificial intelligence — Guidance on risk management"(第1版、2023年2月) — iso.org/standard/77304.html
- ISO/IEC "ISO/IEC 42001:2023 Information technology — Artificial intelligence — Management system"(第1版、2023年12月) — iso.org/standard/81230.html
- ISO/IEC "ISO/IEC TS 42119-2:2025 Artificial intelligence — Testing of AI — Part 2: Overview of testing AI systems"(2025年11月) — iso.org/standard/84127.html
- ISO/IEC "ISO/IEC TS 6254:2025 … Objectives and approaches for explainability and interpretability of machine learning (ML) models and artificial intelligence (AI) systems"(2025年9月) — iso.org/standard/82148.html
- ISO/IEC "ISO/IEC 12792:2025 Information technology — Artificial intelligence (AI) — Transparency taxonomy of AI systems"(2025年11月) — iso.org/standard/84111.html
- ISO/IEC "ISO/IEC TR 20226:2025 Information technology — Artificial intelligence — Environmental sustainability aspects of AI systems"(2025年7月、技術報告書) — iso.org/standard/86177.html
- NIST "Artificial Intelligence Risk Management Framework (AI RMF 1.0)", NIST AI 100-1(2023年1月), DOI 10.6028/NIST.AI.100-1 — doi.org/10.6028/NIST.AI.100-1
- NIST "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile", NIST AI 600-1(2024年7月), DOI 10.6028/NIST.AI.600-1 — doi.org/10.6028/NIST.AI.600-1
- NIST "AI Risk Management Framework"(NIST のページ。AI RMF 1.0 改訂中との記載、確認日 2026年10月15日) — nist.gov/itl/ai-risk-management-framework
- Anthropic "Building with extended thinking"(Claude API ドキュメント。固定予算方式と adaptive への移行、確認日 2026年10月15日) — platform.claude.com/docs/en/build-with-claude/extended-thinking
- NIST(CAISI) "Practices for Automated Benchmark Evaluations of Language Models", NIST AI 800-2 Initial Public Draft(2026年1月), DOI 10.6028/NIST.AI.800-2.ipd — nvlpubs.nist.gov/nistpubs/ai/NIST.AI.800-2.ipd.pdf
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| CoT プロンプト(540B モデル、8例、GSM8K で当時の最高水準)。zero-shot CoT(MultiArith 17.7%→78.7%、GSM8K 10.4%→40.7%) | Wei ら、Kojima ら 出典1 https://arxiv.org/abs/2201.11903 出典2 https://arxiv.org/abs/2205.11916 | 事実 |
| 自己整合性:GSM8K +17.9%、SVAMP +11.0%、AQuA +12.2%、StrategyQA +6.4%、ARC-challenge +3.9% | Wang ら 出典3 https://arxiv.org/abs/2203.11171 | 事実 |
| テスト時計算の最適配分:best-of-N 比4倍超の効率、FLOPs 一致で14倍大きいモデルを上回りうる | Snell ら 出典6 https://arxiv.org/abs/2408.03314 | 事実 |
| o1 は強化学習で訓練され、答える前に思考の連鎖を生成する。学習時計算とテスト時計算で性能が向上。生の思考を見せない判断とその理由。付録 A の数値(AIME 2024 pass@1/cons@64、GPQA Diamond など)、MATH・GSM8K でモデルを差別化できなくなったという記述、500問の MATH 分割、API 退役の注記 | OpenAI の発表ページ(2024年9月12日) 出典9 https://openai.com/index/learning-to-reason-with-llms/ | 事実 |
| DeepSeek-R1-Zero:SFT なしの強化学習、GRPO、ルールベース報酬(正答・形式)、ニューラル報酬モデル不使用の理由、AIME 2024 pass@1 15.6%→77.9%・86.7%、応答長の増加、aha moment、過剰思考・言語混在・プロンプト感度・ソフトウェア工学・報酬不正利用の限界、Nature 掲載日 | Nature 論文 出典10 https://doi.org/10.1038/s41586-025-09422-z | 事実 |
| GRPO の提案(PPO の簡略化) | DeepSeekMath、Nature 論文 出典11 https://arxiv.org/abs/2402.03300 出典10 https://doi.org/10.1038/s41586-025-09422-z | 事実 |
| 過程監督が結果監督を上回る(MATH の代表的部分集合の78%)、PRM800K | Lightman ら 出典5 https://arxiv.org/abs/2305.20050 | 事実 |
| RLVR の提案。Qwen3 の思考/非思考モード統合・思考予算・strong-to-weak 蒸留 | Tülu 3、Qwen3 技術報告 出典12 https://arxiv.org/abs/2411.15124 出典13 https://arxiv.org/abs/2505.09388 | 事実 |
| gpt-oss:o3 に似た CoT 強化学習、3段階の強さ、Table 3 の数値、思考の連鎖は制限されず不正確な内容を含みうること | gpt-oss モデルカード 出典14 https://arxiv.org/abs/2508.10925 | 事実 |
| s1:budget forcing、AIME24 50%→57%。Large Language Monkeys:coverage と SWE-bench Lite 15.9%→56%、検証器のない領域での頭打ち。Tree of Thoughts:Game of 24 で4%→74% | 各論文のアブストラクト 出典8 https://arxiv.org/abs/2501.19393 出典7 https://arxiv.org/abs/2407.21787 出典4 https://arxiv.org/abs/2305.10601 | 事実 |
| 過剰思考の指摘と緩和策 | Chen ら(2024) 出典15 https://arxiv.org/abs/2412.21187 | 事実 |
| 思考の連鎖の不忠実性(バイアス特徴で精度が最大36%低下)、ヒント6種類での言及率、思考の監視可能性の提案 | Turpin ら、Chen ら(Anthropic)、Korbak ら 出典16 https://arxiv.org/abs/2305.04388 出典17 https://arxiv.org/abs/2505.05410 出典18 https://arxiv.org/abs/2507.11473 | 事実 |
| 「思考の幻想」の主張(複雑さによる崩壊、推論努力の減少、三つの領域)と、実験設計の制約を指摘する反論 | Shojaee ら、Lawsen 出典19 https://arxiv.org/abs/2506.06941 出典20 https://arxiv.org/abs/2506.09250 | 事実 |
| Anthropic:thinking の要約表示、出力トークンとして課金、adaptive と effort、4.7 以降での固定予算方式の拒否 | Claude API ドキュメント 出典21 https://platform.claude.com/docs/en/build-with-claude/thinking 出典22 https://platform.claude.com/docs/en/build-with-claude/effort 出典41 https://platform.claude.com/docs/en/build-with-claude/extended-thinking | 事実 |
| OpenAI:reasoning.effort、推論トークンは API で見えずコンテキストを占有し出力として課金、25,000トークンの余裕の推奨、incomplete になりうること、pro モード | OpenAI API ドキュメント 出典23 https://platform.openai.com/docs/guides/reasoning | 事実 |
| Google:thinking_level、thinking_summaries、完全な思考に基づく課金、max_output_tokens と課金 | Gemini API ドキュメント 出典24 https://ai.google.dev/gemini-api/docs/thinking | 事実 |
| DeepSeek:thinking の enabled/disabled、reasoning_effort の対応表、reasoning_content | DeepSeek API ドキュメント 出典25 https://api-docs.deepseek.com/guides/thinking_mode | 事実 |
| GPQA の集合(Extended 546、main 448、Diamond 198)と正答率(専門家64.8%、非専門家34.1%) | Rein ら 出典26 https://arxiv.org/abs/2311.12022 | 事実 |
| MATH(12,500問)、LiveCodeBench(400問、2023年5月〜2024年5月)、pass@k の定義 | 各論文 出典27 https://arxiv.org/abs/2103.03874 出典28 https://arxiv.org/abs/2403.07974 出典29 https://arxiv.org/abs/2107.03374 | 事実 |
| AIME は15問で答えは0〜999の整数 | MAA のページ 出典30 https://maa.org/maa-invitational-competitions/ | 事実 |
| ISO/IEC 22989:2022、23894:2023、42001:2023、TS 42119-2:2025、TS 6254:2025、12792:2025、TR 20226:2025 の番号・題名・版・発行年月 | ISO の標準ページ 出典31 https://www.iso.org/standard/74296.html 出典32 https://www.iso.org/standard/77304.html 出典33 https://www.iso.org/standard/81230.html 出典34 https://www.iso.org/standard/84127.html 出典35 https://www.iso.org/standard/82148.html 出典36 https://www.iso.org/standard/84111.html 出典37 https://www.iso.org/standard/86177.html | 事実 |
| NIST AI 100-1(2023年1月)、AI 600-1(2024年7月)、NIST による AI RMF 1.0 改訂中の記載 | NIST の文書・ページ 出典38 https://doi.org/10.6028/NIST.AI.100-1 出典39 https://doi.org/10.6028/NIST.AI.600-1 出典40 https://www.nist.gov/itl/ai-risk-management-framework | 事実 |
| NIST AI 800-2 初期公開草案(2026年1月):推論の強さ(reasoning effort)を評価設定の例に挙げ、費用と性能の併記を勧めること。自主的な指針で最終版は未確認 | NIST の草案 PDF 出典42 https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.800-2.ipd.pdf | 事実 |
| gpt-oss の high − low の差、o1 の cons@64 − pass@1 の差、cons@64 の生成量が約64倍であること、思考トークンのコスト試算(入力換算 4,500/9,500/24,500/84,500、1.0/2.1/5.4/18.8倍、時間 10/30/90/330秒) | 本稿の計算。前提(入力2,000、回答500、出力単価比5、50トークン/秒)は仮定であり、各社の単価ではない | 本稿の計算 |
| o1 の GPQA で多数決の効果が小さい理由 | 推測。論文・発表資料は理由を述べていない(本稿の解説) | 解説 |
| 三方向の分類(逐次・並列・探索)、「推論モデルは設定になりつつある」という整理、素材技術者の視点①〜③、研究開発で記録する項目 | 公表内容にもとづく本記事の整理・解説。各社が表明した見解ではない | 解説 |
| 図2・図3・図4・図6が説明用の作図であること、図5が出典の数値の作図であること、図1・図7がAI生成イメージ(未設置の枠)であること | 本記事による注記 | 解説 |
| AIME・MATH・GPQA を対象とする ISO/IEC・NIST の規格、思考の連鎖の忠実性の試験法を定めた規格、推論トークンの標準測定法、独立機関による同条件の再現、「思考の幻想」の追試、各社最新モデルの個別仕様 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない(本稿) | 解説 |
最終更新:2026年10月15日(確認日)/出典は一次情報(原論文、Nature 掲載論文、開発元のモデルカード・公式ドキュメント、ISO・NIST の公式ページ)に限定しています。規格の本文は有料のため確認できていません。モデル名・API の仕様・既定値・退役状況は変化が速く、確認日より後の状態は保証しません。 AIME・MATH・GPQA を対象とする規格、思考の連鎖の忠実性の試験法を定めた規格、推論トークンの標準測定法、独立機関による同条件の再現、「思考の幻想」の追試、各社最新モデルの個別仕様は、確認できなかったため記載していません。 本文中の正答率は、特定のモデル・版・設定・評価主体の値であり、モデルの優劣を示すものではありません。 図2・図3・図4・図5・図6はベクター作図、図1と図7はAI生成イメージ(画像未設置の枠)であり、いずれも実際の製品内部や測定画面を示すものではありません。