TECHNOLOGY EXPLAINER
推論の最適化とサービング
― 「速い」「安い」「待たせない」を同時に満たせない理由と、その折り合いのつけ方
学習済みのモデルを実際のサービスとして動かすとき、計算の時間とコストの大半は「1トークンずつ文章を作る」段階に使われます。この段階は計算力よりメモリの読み出し速度と容量で決まるため、バッチ処理、KVキャッシュの管理、投機的デコーディング、プリフィルとデコードの分離といった工夫が生まれました。この記事では、各技術の仕組みと、遅延・スループット・コストの関係を、論文と公式の評価規則の範囲で整理し、本稿の計算で数字の感覚をつかみます。
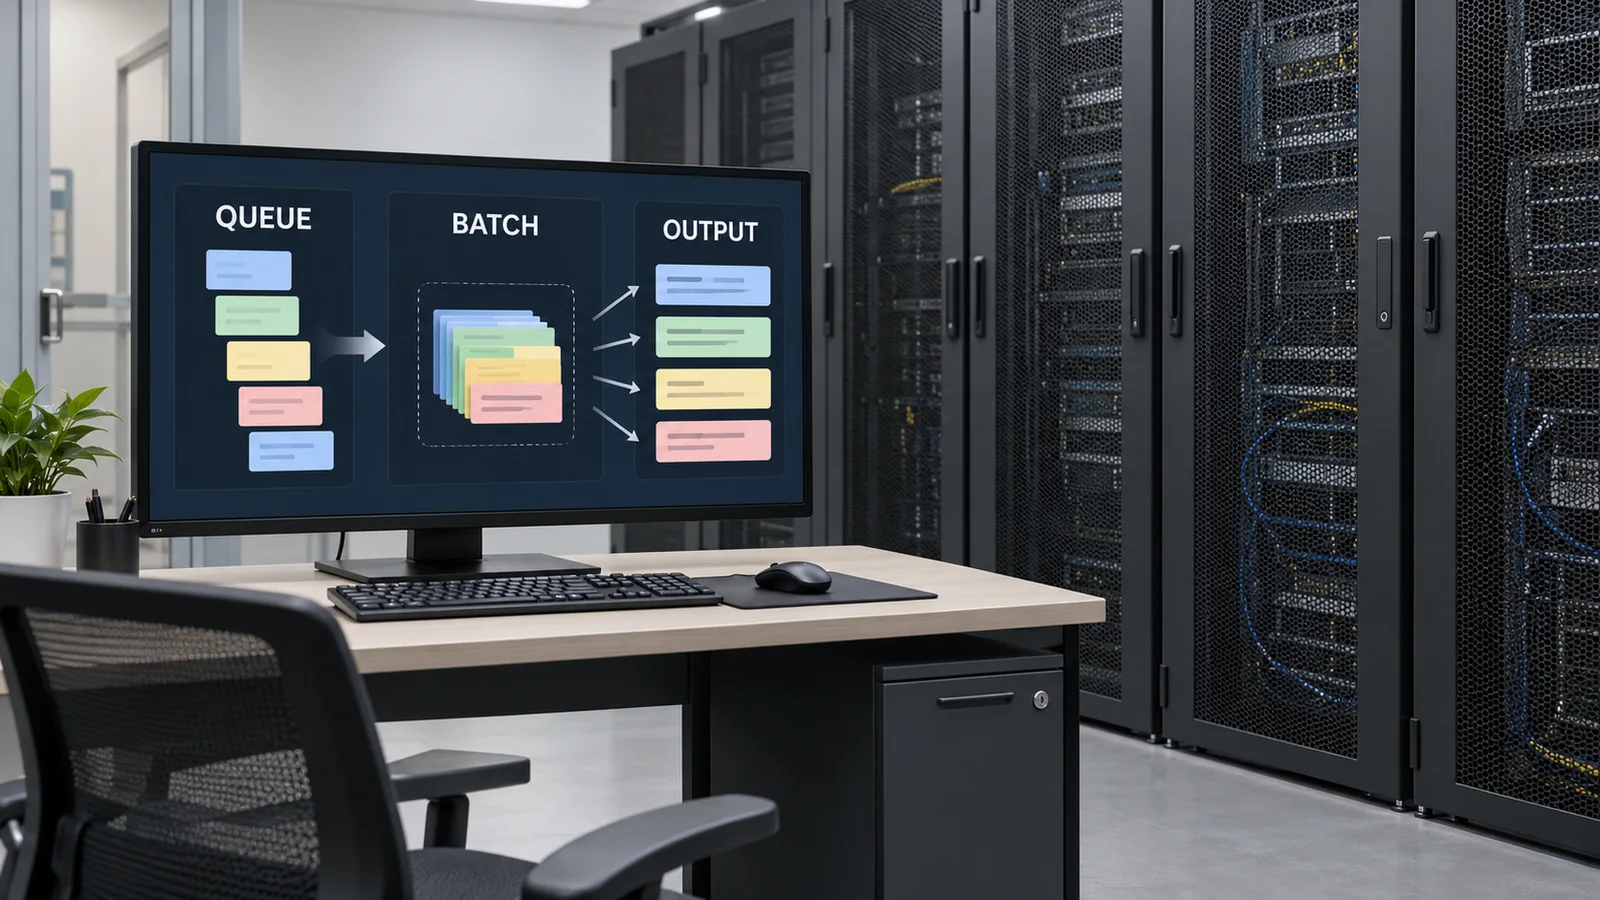
- 推論の最適化とは(3行でつかむ)
- 推論の2つの段階 ― プリフィルとデコード
- KVキャッシュ ― 会話の途中状態がメモリを占める
- バッチ処理とスループット ― 同時に処理するほど安くなるが、待たされる
- メモリの使い方 ― PagedAttention、プレフィックスの再利用、FlashAttention
- 投機的デコーディング ― 小さなモデルに下書きさせ、大きなモデルがまとめて検算する
- プリフィルとデコードの分離、チャンク化 ― 干渉をどう避けるか
- 遅延・スループット・コストの読み方 ― 数字に添えるべき条件
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定・提案であり、実績や確定が確認できていない事項
このほか、読み取りや整理は「解説」として区別しています。推測は太字で示します。
ここに出てくる速度・倍率は、各論文の著者が、特定のモデル・ハードウェア・負荷で測った報告値と、本稿が単純なモデルで試算した値です。異なる論文の倍率を並べて優劣をつけることはしません。製品名・企業の優劣は論じません。本稿の計算は理想化した上限の見積もりで、実機の性能の予測ではありません。
1. 推論の最適化とは(3行でつかむ)
- 推論は2つの段階に分かれます:入力文を一度に読み込む「プリフィル」(演算が詰まる)と、答えを1トークンずつ作る「デコード」(メモリの読み出しが詰まる)です。性能と費用の議論のほとんどは、この違いから始まります事実[参考資料1・13]
- 速さ・安さ・待ち時間は同時には最適化できません:同時に処理する人数(バッチ)を増やすとGPU1枚あたりの処理量とコストは改善しますが、1人あたりの応答の間隔は延びます(第4章で本稿が試算)本稿の計算
- メモリが同時処理数を決めます:会話の途中状態(KVキャッシュ)は1トークンごとに増え、GPUのメモリを占めます。その持ち方(PagedAttention など)と、2段階を別の機械に分ける設計が、実際のサービスの工夫の中心です事実[参考資料1・9]
「毎秒○トークン」「○倍速い」は、モデル、精度、ハードウェア、バッチ、入出力の長さ、ソフトウェア、遅延の条件を書いて初めて比べられます。MLCommons の評価規則は、LLMの遅延を「最初のトークンまでの時間(TTFT)」と「トークン間隔(TPOT)」の二つで制約し、その範囲で出せる最大の処理量を競う作りです事実[参考資料14]。
2. 推論の2つの段階 ― プリフィルとデコード
言語モデルは、入力のあとに続く文字(トークン)を1つずつ予測して並べます。1つ作るたびにモデル全体を1回通す必要があり、Leviathan らは「K個のトークンを作るにはモデルをK回、順番に動かす」と書いています事実[参考資料3]。ただし最初に入力文全体を読む部分は別で、全トークンを並列に処理できます。Sarathi-Serve の論文はこれを、プリフィルは「遅延は大きいがGPUの演算を使い切る」、デコードは「遅延は小さいが、1回に1トークンしか処理しないため演算の使用率が低い」と整理しています事実[参考資料10]。
Splitwise の論文は同じ違いを、プロンプト処理は「演算が重い」、トークン生成は「メモリが重い」段階で、遅延・スループット・メモリ・消費電力の性質がそれぞれ異なる、と述べています事実[参考資料8]。LLM の遅延として、MLPerf Inference の規則はTTFT(最初のトークンの遅延)とTPOT(生成されるトークン間の平均間隔)の2つを集計すると定義しています事実[参考資料14]。「待たされる」感覚は TTFT、「文字が流れる速さ」は TPOT にほぼ対応します(この対応づけは本稿の解説です)。
3. KVキャッシュ ― 会話の途中状態がメモリを占める
Transformer は、新しいトークンを作るたびに、過去のすべてのトークンとの関係(注意:attention)を計算します。過去のトークンの Key と Value を毎回計算し直すと無駄が大きいため、保存して使い回します。これが KV キャッシュです。1トークンあたりの大きさは、2(KeyとValue)×層数×KVヘッドの数×ヘッドの次元×1要素のバイト数、で決まります(本稿の整理)。
vLLM の論文は、OPT-13B(FP16)では1トークンのKVキャッシュが800 KB(2 × 5,120 × 40層 × 2バイト)で、2,048トークンなら1リクエストで最大1.6 GBになる、と示しています事実[参考資料1]。また、13Bモデルを NVIDIA A100(40 GB)で動かす例で、メモリの約65%が重み、約30%がリクエストごとの動的な状態(主にKVキャッシュ)だったと報告しています事実[参考資料1]。KVキャッシュが大きいほど同時に抱えられる人数が減り、スループットが下がります。
そのため、近年のモデルは KV を減らす設計を取り入れています。Ainslie らの GQA(grouped-query attention)は、Key/Value のヘッドを、Query のヘッドより少なくする方式で、多頭注意に近い品質で多対一注意(MQA)に近い速度を目指します事実[参考資料6]。Llama 3 の論文は、8つの Key/Value ヘッドの GQA を使い、「推論速度を上げ、デコード中のKVキャッシュを小さくする」と述べています事実[参考資料7]。
本稿の計算 Llama 3 8B の論文の表にある構成(32層、モデル次元4,096、アテンションヘッド32、Key/Valueヘッド8、ヘッドの次元は 4,096÷32=128)事実[参考資料7]を使います。BF16(1要素2バイト)とします。
1トークン:2 × 32 × 8 × 128 × 2 = 131,072バイト(約0.13 MB)。同じ次元でKVヘッドが32(GQAなしの多頭注意)だったと仮定すると 524,288バイト(約0.52 MB)で、4倍です。
2,048トークンの1人分:131,072 × 2,048 = 約0.27 GB(GQAなしの仮定なら約1.07 GB)。
80 GBのGPUに載せたとき:重みはBF16で 80億 × 2 = 約16 GB。計算・通信用の領域を 8 GB 確保すると仮定(例示の値)すると、KVキャッシュに回せるのは 80 − 16 − 8 = 56 GB。2,048トークンの利用者は 56 ÷ 0.27 = 約208人(GQAなしの仮定では約52人)。
前提と限界:パラメータ数は公称の「80億」で、予約領域の8 GBは仮の値です。ブロック管理の無駄、量子化(KVを8ビットにするなど)、複数GPUへの分割は考えていません。実際の同時処理数ではなく、メモリの大きさの感覚をつかむための試算です。
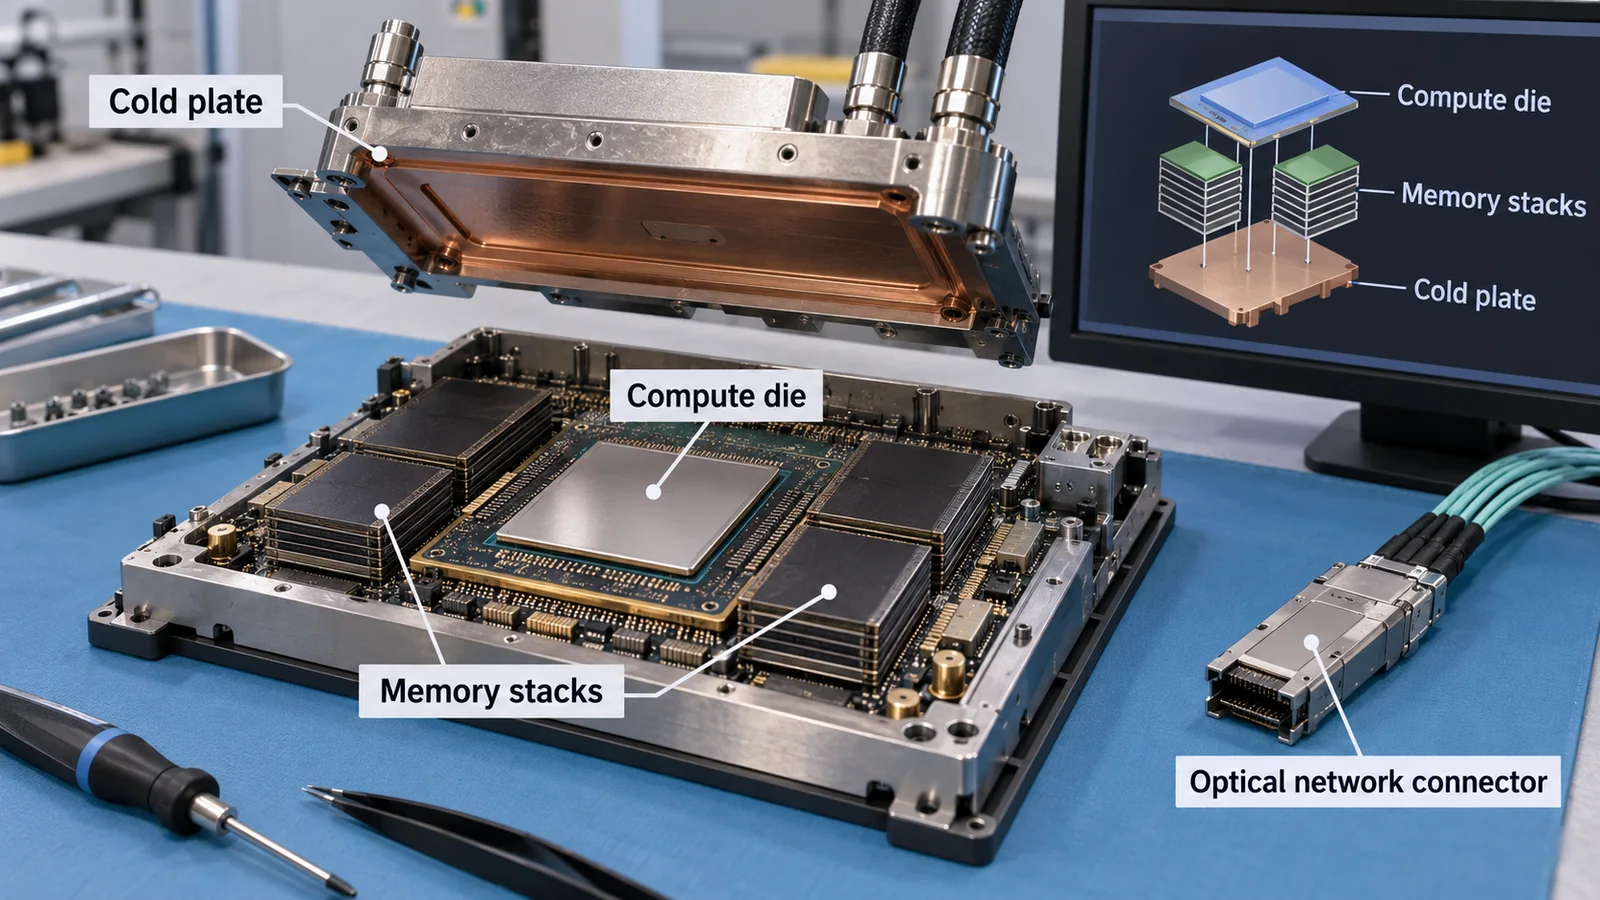
デコードの速さは、1トークンごとに重みとKVキャッシュをメモリから読み出す速さで決まり、同時に抱えられる人数はメモリの容量で決まります(第3・4章)。GPUのメモリは多くの場合HBM(広帯域メモリ)で、これは積層したDRAMチップをTSVとマイクロバンプでつなぎ、GPUの隣に載せた部品です。つまり推論の性能の天井は、HBMの積層数、帯域、容量、そしてそれを冷やして信頼性を保つ材料(封止、熱界面材料)に直結します。
積層・接合・熱の話は本シリーズの「HBM」「CoWoS」「熱界面材料TIM」編に詳しく書いています。本稿の位置づけは、ソフトウェアの工夫(バッチ、ページ管理、分離)は、メモリ容量と帯域という物理量を「どう使い切るか」の工夫だということです(本記事による解説)。
4. バッチ処理とスループット ― 同時に処理するほど安くなるが、待たされる
デコードでは、1トークンのたびにモデルの重みを全部メモリから読みます。1人分だけ処理しても、10人分まとめて処理しても、重みの読み出しは1回です。そのため、まとめて処理する人数(バッチ)を増やすほど、GPU1枚あたりの1秒のトークン数が増えます。vLLM の論文も、高いスループットには「十分な数のリクエストを同時にバッチ処理する必要がある」と書いています事実[参考資料1]。
従来の「静的バッチ」では、バッチ内の最も長い応答が終わるまで全員が待たされます。Orca(OSDI 2022)は、1回のモデル実行(1イテレーション)ごとにスケジュールし直す「イテレーションレベルのスケジューリング」を提案しました。先に終わった要求はすぐ返せて、新しい要求は次のイテレーションから加われます事実[参考資料2]。今日の多くのサービング基盤が使う「連続バッチ処理(continuous batching)」の考え方で、この対応づけは本稿の解説です。
| 同時処理数 B | 1ステップの時間(メモリ律速) | 演算だけの時間 | 全体のトークン/秒 | 1人あたりのトークン/秒 | 100万トークンあたり(US$) |
|---|---|---|---|---|---|
| 1 | 4.9 ms | 0.0 ms | 206 | 206 | 4.05 |
| 8 | 5.4 ms | 0.1 ms | 1,477 | 185 | 0.56 |
| 32 | 7.3 ms | 0.5 ms | 4,360 | 136 | 0.19 |
| 64 | 9.9 ms | 1.0 ms | 6,462 | 101 | 0.13 |
| 128 | 15.0 ms | 2.1 ms | 8,515 | 67 | 0.10 |
| 208 | 21.4 ms | 3.4 ms | 9,700 | 47 | 0.09 |
すべて本稿の計算。Llama 3 8B(BF16)、H100 SXM(帯域3.35 TB/s、密な演算は疎性ありの値の半分と仮定)、全員が2,048トークンの時点、1 GPU、1 GPU時間を3 US$とした例示値。実測ではありません。
モデル:1ステップの時間 =(重み16 GB + B × 0.27 GB)÷ 3.35 TB/s。H100 SXM のメモリ帯域は NVIDIA の公称値 3.35 TB/s、メモリ 80 GB事実[参考資料13]。1ステップで全員が1トークン進むとします。
結果:B=1 では 1ステップ約4.9 ms(1人あたり約206トークン/秒、全体も同じ)。B=208 では 1ステップ約21.4 ms で、1人あたりは約47トークン/秒に下がる一方、全体は約9,700トークン/秒(B=1の約47倍)になります。コストの換算(例示の価格)では、100万トークンあたり約4.05 US$ から約0.09 US$ になります。
演算は余っています:この範囲では演算だけの時間(表の「演算だけの時間」)はメモリの時間よりずっと短く、デコードが演算ではなくメモリで決まる、という第2章の整理と合います。密な演算性能は NVIDIA のデータシートの「疎性あり」の値の半分(約990 TFLOPS)と仮定しました事実[参考資料13]。
前提と限界:実機にはカーネル起動やスケジューリングの時間、通信、メモリの利用効率の損失があり、実際の値はこれより遅くなります。複数GPU、量子化、MoE、プリフィルの時間は含みません。GPUの価格は仮の値で、実勢価格ではありません。「バッチを増やすほど1人あたりの速度が下がり、全体は上がる」という方向を示すための試算です。
5. メモリの使い方 ― PagedAttention、プレフィックスの再利用、FlashAttention
従来のシステムは、各リクエストのKVキャッシュを、最大長に合わせて連続した領域に確保していました。実際の応答は最大長よりずっと短いことが多く、使われない予約領域(内部断片化)や領域の隙間(外部断片化)が生じます。vLLM の論文の測定では、既存システムでKVキャッシュのうち実際のトークン状態に使われていたのは20.4〜38.2%でした事実[参考資料1]。
PagedAttention は、OSの仮想メモリとページングにならい、KVキャッシュを固定サイズのブロックに分けて、連続していない場所に置き、ブロック表で論理的な順序とつなぎます。これで無駄はほぼ最後のブロック内に限られ、リクエスト内・リクエスト間でブロックを共有することもできます。vLLM の著者らは、同程度の遅延で、既存の最先端システム(FasterTransformer、Orca)に比べスループットが2〜4倍になったと報告しています(著者の測定条件の値)事実[参考資料1]。
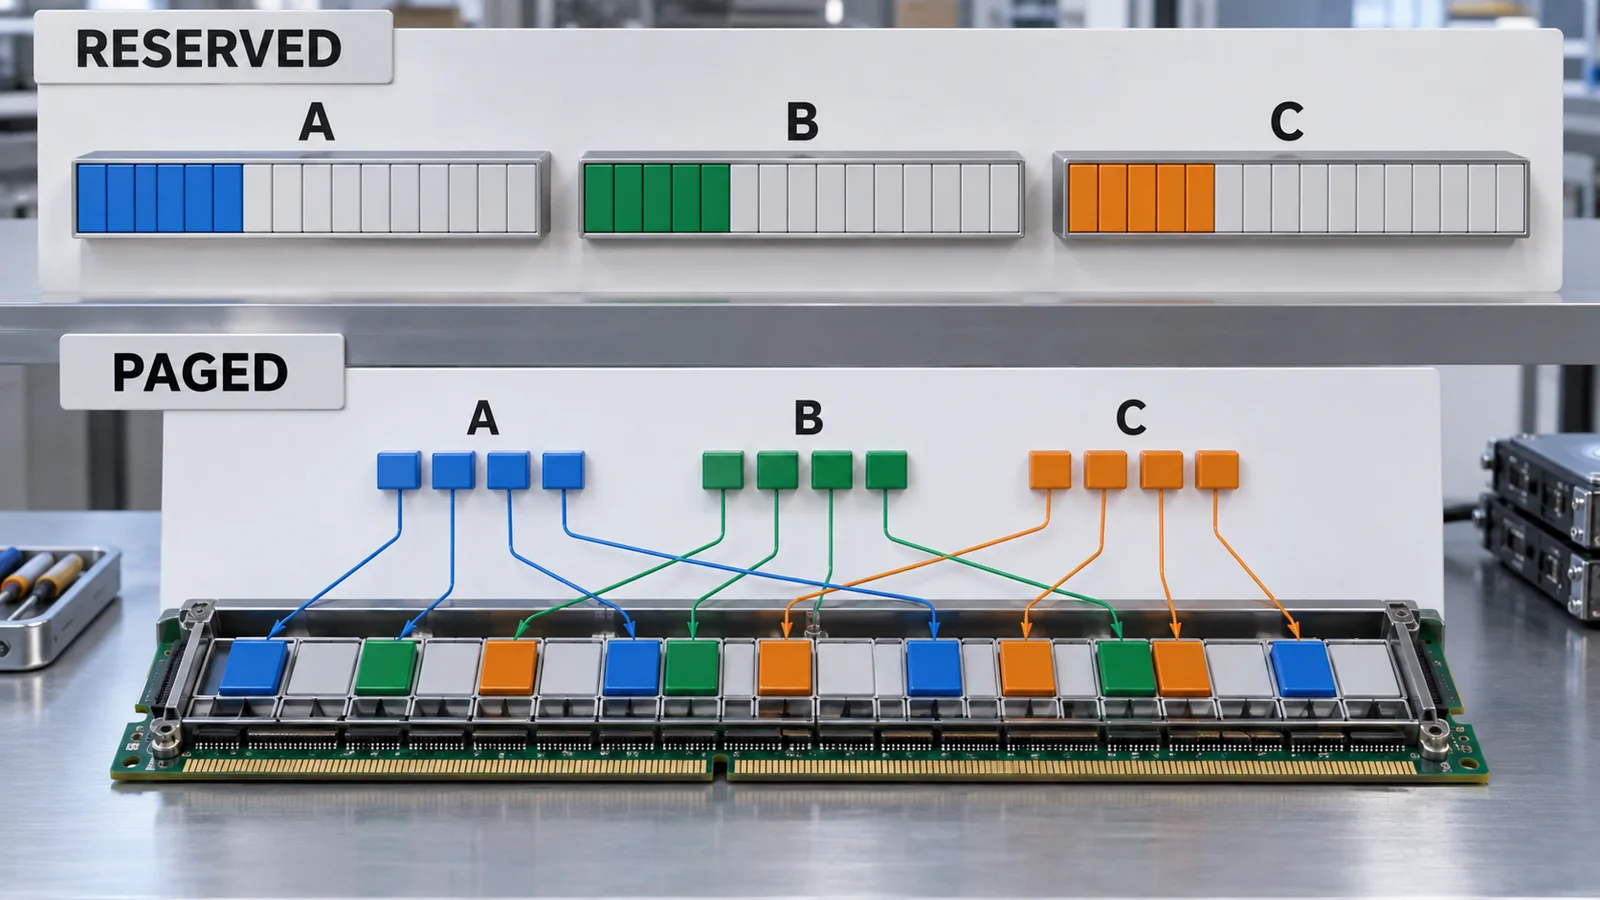
元のSVG模式図・数値・出典注記を見る
同じ文章の先頭(システムプロンプトや共通の文書)を多数のリクエストが共有する場合は、その部分のKVキャッシュを再計算せず再利用できます。SGLang の論文は、そのための仕組みRadixAttentionを提案し、多段の対話やRAGなどで最大6.4倍のスループットを報告しています(著者の条件の値)事実[参考資料12]。再利用が効くかどうかは、共通部分の割合と、キャッシュをどれだけ保持できるか(メモリ)で決まります(本稿の解説)。
アテンション計算そのものも、メモリの読み書きがボトルネックです。FlashAttention は、GPUの大容量メモリ(HBM)と小さな高速メモリ(SRAM)の間の読み書きの回数を、タイル分割で減らす「IOを意識した」厳密な(近似でない)アテンションのアルゴリズムです事実[参考資料5]。結果を変えずにメモリ移動を減らす点で、投機的デコーディング(次章)のような「出力を変えない高速化」の仲間です(この分類は本稿の整理)。
6. 投機的デコーディング ― 小さなモデルに下書きさせ、大きなモデルがまとめて検算する
デコードは重みの読み出しで時間がかかる一方、演算には余裕があります(第4章)。そこで、安い小さなモデル(ドラフト)で数トークン先まで下書きを作り、大きなモデルがそれらを並列に検算して、合っていれば一度に複数トークン進める方法が考えられました。Leviathan らは、受理・棄却の仕組みを工夫して、出力の分布を変えずにT5-XXL で2〜3倍の速度向上を報告し事実[参考資料3]、Chen らは700億パラメータの Chinchilla で、分散環境で2〜2.5倍を報告しています事実[参考資料4](いずれも著者の条件)。
Leviathan らは、ドラフトの下書きが大モデルに受け入れられる確率の平均を受理率 α、ドラフト1回のコストが大モデル1回の何倍かをc、1回に下書きするトークン数をγとして、1回の検算で進むトークン数の期待値を (1 − α^(γ+1)) ÷ (1 − α)、実時間の改善率の期待値を (1 − α^(γ+1)) ÷ ((1 − α)(γc + 1)) と導いています(トークンごとの受理が独立で同じ確率という単純化つき)事実[参考資料3]。
| 受理率 α | γ=2 | γ=4 | γ=8 |
|---|---|---|---|
| 0.4 | 1.42 倍 | 1.37 倍 | 1.19 倍 |
| 0.6 | 1.78 倍 | 1.92 倍 | 1.77 倍 |
| 0.8 | 2.22 倍 | 2.80 倍 | 3.09 倍 |
| 0.9 | 2.46 倍 | 3.41 倍 | 4.38 倍 |
すべて本稿の計算(Leviathan らの式[参考資料3]に c=0.05 を代入)。ドラフトのコスト比 c=0.05 は例示の値です(論文は、約2桁小さいドラフトで c が0.05未満だったと報告)。
注意点が3つあります。第一に、検算のために余分な演算をするので、演算の総量は増えます。Leviathan らも、この方法は演算を増やして遅延を減らす、と整理しています事実[参考資料3]。デコードが演算でなくメモリで詰まっているときに効き、バッチが大きく演算にも余裕がなくなると、効果は小さくなりえます(これは演算量が増えるという論文の記述からの本稿の解説で、実測値ではありません)。第二に、ドラフトは別の小さなモデルのほか、大きなモデルの内部の特徴から次を予測する方式(EAGLE など)がある、という実装の違いがあります事実[参考資料19]。第三に、評価の場では、MLPerf Inference の規則は投機的デコーディングを特定のワークロードに限り、規則が定めた参照用の予測ヘッドと設定のもとでだけ認めています事実[参考資料14]。
7. プリフィルとデコードの分離、チャンク化 ― 干渉をどう避けるか
プリフィルとデコードを同じGPUで混ぜると、長いプリフィルがデコード中の他の利用者の応答を止めてしまいます。DistServe の論文は、既存のシステムが両者を同じGPUでまとめてバッチ処理するため「強い干渉」が起き、資源の配分や並列化の方針も両者で縛られる、と指摘しています事実[参考資料9]。対策は大きく2つあります。
- チャンク化(chunked prefill):Sarathi-Serve は、プリフィルをほぼ等しい大きさの断片に分け、進行中のデコードを止めずに新しい要求を加える「停止しないスケジュール」を提案しました。Mistral-7B(A100 1枚)で vLLM の2.6倍の「サービング容量」(遅延の上限を守って処理できる量)を報告しています(著者の条件)事実[参考資料10]
- 分離(disaggregation):プリフィル専用とデコード専用のGPU群に分け、KVキャッシュを間の通信で渡します。Splitwise は、同程度のコストで 1.4倍のスループットを2割低い費用で、または同じ費用・電力で 2.35倍のスループットを報告し事実[参考資料8]、DistServe は、遅延の条件を満たしたまま最大 7.4倍の要求、または 12.6倍厳しい遅延条件を報告しています事実[参考資料9](いずれも著者の条件)
Mooncake は、Moonshot AI のサービス(Kimi)の基盤として、プリフィルとデコードを分け、GPUクラスターの余っているCPU・DRAM・SSDをKVキャッシュの置き場として使う設計を公開しました。著者らは、実際の負荷でKimiが75%多くの要求を処理できたと述べています(同社の報告)事実[参考資料11]。
| 手法 | 何を変えるか | 著者の報告(条件つき) | 主な代償・条件 |
|---|---|---|---|
| 連続バッチ(Orca) | 1イテレーションごとにスケジュール | GPT-3 175B で FasterTransformer に対し、同程度の遅延で36.9倍のスループット[2] | スケジューラーが複雑になる |
| PagedAttention(vLLM) | KVの置き方(ページ化) | 同程度の遅延でスループット2〜4倍[1] | ブロックの間接参照のオーバーヘッド |
| 投機的デコーディング | 1回の検算で複数トークン | T5-XXL で2〜3倍[3]、Chinchilla 70B で2〜2.5倍[4] | 演算量が増える。受理率に依存 |
| チャンク化(Sarathi-Serve) | プリフィルを断片化して混在 | Mistral-7B・A100 1枚で vLLM の2.6倍の容量[10] | 断片化のオーバーヘッド |
| 分離(Splitwise・DistServe) | プリフィルとデコードを別GPU群に | 1.4倍のスループットを2割低い費用で[8]、最大7.4倍の要求[9] | KVの転送。構成・ネットワークへの依存 |
すべて事実(各論文の著者の報告)。ベースライン、モデル、ハード、負荷が論文ごとに異なるため、表の倍率どうしを比べて優劣をつけることはできません。
Splitwise の論文は、トークン生成の段階は最新GPUの演算能力を必要とせず、より低い電力とコストで動かせる、という観察から分離を設計しています事実[参考資料8]。同じ作業を、少ない機械・少ない電力で処理できれば、ラックの発熱と受電が減ります。つまり推論ソフトウェアの改善は、データセンターの電力と冷却の問題(本シリーズ「AIデータセンターの電力と冷却」編)にもつながります。
逆に、ソフトウェアで速くしても、1トークンあたりの電力(J/トークン)が下がるとは限りません(バッチを大きくしてGPUを使い切る、投機的デコーディングで演算量が増える、など)。電力は MLPerf Power のような規則で測るのが筋で(第10章)、速度の倍率だけでエネルギーを語らないことが大切です(本記事による解説)。
8. 遅延・スループット・コストの読み方 ― 数字に添えるべき条件
第4〜7章で見たとおり、同じシステムでも条件で数字は何倍も変わります。速度やコストの主張を見るときに、確認すべき項目を表にまとめます(本稿の整理)。
| 確認する項目 | なぜ必要か |
|---|---|
| モデルと規模(総・活性パラメータ) | 混合専門家(MoE)では、総数と1トークンで使う数が違う。非公表なら推計しない |
| 精度(BF16、FP8、4ビットなど) | 重みとKVのバイト数が変わり、速度と同時処理数に直結。品質が保たれているかも要確認 |
| ハードウェアと台数、接続 | メモリ帯域・容量と、GPU間の通信が律速になる |
| バッチ・同時接続数 | 全体のトークン/秒と1人あたりの速さがトレードオフ(第4章) |
| 入力と出力の長さ | プリフィルとKVの大きさが変わる。長文では条件が大きく変わる |
| 遅延の条件(TTFT・TPOT、何パーセンタイルか) | 遅延の上限を守った上での最大処理量か、制約なしの最大値か |
| ソフトウェアと版 | サービング基盤・カーネルの版で性能が大きく動く |
| 出力の品質 | 高速化が出力を変えていないか(精度目標、分布が不変か) |
| 電力・価格・日付 | 価格は通貨・単位・入出力の別・日付・プランを添える。消費電力は測定の範囲を添える |
第4〜7章をもとにした本稿の整理です。価格は日々変わるため、本稿は特定の事業者の料金を掲載しません。
社内の文書検索や実験記録の要約など、結果を急がない処理は、まとめて流す(オフライン、バッチを大きく)ほうがコストあたりの処理量が多くなります。一方、現場の人と対話する用途では、TTFTとTPOTが使い心地を決めるため、バッチを小さくして遅延を守る設計になります。両者を同じ設備で混ぜると互いに影響しあうため、用途ごとに遅延の目標(SLO)を決めて設計するのが筋です(本記事による解説)。
機密のデータを社外に出せない場合は、自前のGPUで動かすことになり、第3章のとおりGPUのメモリ容量が同時に使える人数を決めます。必要なGPUの台数は、モデルの大きさ、精度、文脈の長さ、同時利用者数の組合せで決まるため、カタログの「トークン/秒」だけでは決められません(本記事による解説)。
9. 限界と、確認できなかったこと
- 実機の測定値は載せていません:本稿の計算は、メモリ律速を仮定した理想化の見積もりです。MLPerf の個別の提出結果の数字や、各社のハードウェアの比較は、設定が揃わないため載せていません
- 扱っていない技術:量子化の詳細、MoE の専門家並列、テンソル並列・パイプライン並列の通信コスト、KVキャッシュの量子化・圧縮、スライディングウィンドウ注意などは、本稿では詳しく扱っていません(モデルの効率化は本シリーズ「モデルの効率化」編を参照)
- サービング基盤ごとの機能差:vLLM(Apache-2.0 のオープンソース、2026年10月14日にもリポジトリが更新されていることを確認)事実[参考資料20]、SGLang、その他の基盤の個別の機能や版ごとの違いは、検証していません
- 価格:各事業者のAPI料金は変動が速く、公式の価格表の確認と日付の記載が必要なため、本稿には載せていません。コストの例は、GPU時間を3 US$とした例示の値です
- 標準:LLM推論の遅延・スループットを定める国際規格は確認できませんでした。ISO/IEC 22989 は用語の規格です
- プリフィルは演算、デコードはメモリが律速になりやすい。この違いが、多くの工夫の出発点です事実
- バッチを増やすと全体は増え、1人あたりは減ります。本稿の単純な試算では、B=1 から B=208 で全体が約47倍、1人あたりが約23%になりました本稿の計算
- メモリ管理が同時処理数を決めます。PagedAttention は既存システムで20.4〜38.2%だったKVメモリの実使用率を引き上げる設計です事実
- 出力を変えずに速くする工夫(投機的デコーディングなど)と、構成を変える工夫(分離)があり、倍率は論文ごとの条件つきの報告です事実
- 評価は MLPerf Inference の規則が基準ですが、標準規格は用語が中心で、性能の合否を決める国際規格は確認できませんでした
10. 評価・標準の読み方
推論の性能は、(1) 遅延(TTFT・TPOT)、(2) 遅延の上限を守って出せる処理量、(3) 出力の品質が保たれているか、(4) 消費電力、の4つの組合せで評価します。業界で最もよく使われる公開の枠組みが MLCommons の MLPerf Inference で、利用者の到着を模したサーバーシナリオとオフラインシナリオを定め、LLM のベンチマークごとに TTFT・TPOT の上限と精度目標を決めています事実[参考資料14]。確認日 2026年10月15日時点で、MLCommons のベンチマークのページは MLPerf Inference v6.1 を示しており事実[参考資料15]、2026年9月16日の発表では、30団体が提出し、RAG のエンドツーエンドのテストなどが加わったと伝えています事実[参考資料15]。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針 | 読み方の注意 |
|---|---|---|---|
| 遅延(TTFT・TPOT) | MLPerf Inference の規則(ルール文書、2026年10月15日確認)。例:DeepSeek-R1 の Server シナリオは TTFT/TPOT 2,000 ms/80 ms、Interactive は 1,500 ms/15 ms、Llama 2 70B の Conversational は 2,000 ms/200 ms、Interactive は 450 ms/40 ms[14]事実 | LLMの応答遅延を定める ISO/IEC 等の規格は確認できなかった。用語は ISO/IEC 22989:2022(AIの概念と用語)[18]事実 | 上限値はベンチマークとシナリオごとに異なり、版で改定される。数値は版を確認して使う |
| 遅延を守った処理量 | MLPerf の Server シナリオ(ポアソン到着、遅延条件を満たす最大のポアソン到着率を指標とする)と Offline シナリオ(全サンプルを最初に投入)[14]事実。研究では DistServe の goodput(TTFT・TPOT の両方の条件を満たした要求の処理率)[9] | 確認できなかった | Offline は遅延制約がなく、Server とは別の数字。比べるときは同じシナリオどうしで |
| 出力の品質 | MLPerf は精度目標を定める(例:Llama 3.1 8B 要約は FP32 参照の99%または99.9%、DeepSeek-R1 は FP16 参照の99%)[14]事実。投機的デコーディングは分布を変えない方式として論文で証明[3] | 確認できなかった | 「参照の99%」は、そのタスクの指標での話。他のタスクの品質を保証しない |
| 消費電力・エネルギー | MLPerf Power(Tschand ら、arXiv 2410.12032)が、MLPerf のシステム電力測定を整理している[17]事実 | 確認できなかった | 電力を測った提出は一部で、測定範囲(システム全体か)が条件。速度の倍率とは別に見る |
| この枠組み自体の経緯 | MLPerf Inference の設計:Reddi ら(ISCA 2020)[16]事実 | 将来の変更:MLCommons は、API中心のハーネスを基盤とする「MLPerf Endpoints」が、データセンター向けの Inference に置き換わると述べている[15]未確定/将来 | ベンチマークの構成は毎回変わる。年をまたいだ数字の比較は避ける |
区分タグは各セルに付けています。MLPerf の遅延上限の数値は、GitHub の規則文書(2026年10月15日時点の master)から転記しており、版が変わると改定されます。表の整理は本稿によるものです。
読み方の注意は3つです。
- 設定と実施主体で数字が変わる:MLPerf は提出者が自社の最適化で測る方式で、規則がハーネス、精度目標、投機的デコーディングの可否まで定めています。規則の外で測った「○倍」とは別物です
- ベンチマークは入れ替わる:MLPerf Inference は版ごとにモデルとシナリオが変わります(例:v6.1 で RAG のエンドツーエンドとエッジのエージェント処理が追加)。古い版の数字を「現在」として扱わない
- 標準は「用語」が中心:LLM 推論の速度や遅延を要求事項として定める国際規格は、本稿の調査範囲では確認できませんでした。ISO/IEC 22989 は概念と用語の規格で、性能の合否を決めるものではありません。性能の主張は、公開ベンチマークの規則と条件に依存します
11. 用語集
- TTFT
- Time to first token。最初のトークンが出るまでの時間。
- TPOT
- Time per output token。出力されるトークンどうしの平均間隔。
- プリフィル/デコード
- 入力を一度に処理する段階/1トークンずつ生成する段階。
- KVキャッシュ
- 過去のトークンのKeyとValueを保存したもの。
- バッチ
- 同時にまとめて処理する要求の集まり。
- 連続バッチ処理
- 1イテレーションごとに要求の出入りを許す方式(Orca が提案)。
- PagedAttention
- KVキャッシュを固定サイズのブロックに分けて管理する方式(vLLM)。
- GQA
- Grouped-query attention。Key/Valueのヘッド数をQueryより少なくする方式。
- 投機的デコーディング
- 下書きモデルの出力を大モデルが並列に検算して進める方式。
- 受理率 α
- 下書きが検算で受け入れられる確率の平均。
- goodput
- 遅延の条件を満たした要求だけを数えた処理率。
- SLO
- Service level objective。遅延などのサービスの目標値。
- メモリ律速
- 演算よりメモリの読み書きが性能を決める状態。
- HBM
- High bandwidth memory。積層DRAMをGPUの隣に載せた広帯域メモリ。
12. 参考資料(一次情報)
- Kwon W. ほか "Efficient Memory Management for Large Language Model Serving with PagedAttention", SOSP '23 (2023), DOI 10.1145/3600006.3613165, arXiv 2309.06180 — arxiv.org/abs/2309.06180
- Yu G.-I. ほか "Orca: A Distributed Serving System for Transformer-Based Generative Models", OSDI '22 (2022) — usenix.org/conference/osdi22/presentation/yu
- Leviathan Y. ほか "Fast Inference from Transformers via Speculative Decoding", ICML 2023, PMLR 202 (2023), arXiv 2211.17192 — proceedings.mlr.press/v202/leviathan23a.html
- Chen C. ほか "Accelerating Large Language Model Decoding with Speculative Sampling", arXiv 2302.01318 (2023) — arxiv.org/abs/2302.01318
- Dao T. ほか "FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness", NeurIPS 2022, arXiv 2205.14135 — arxiv.org/abs/2205.14135
- Ainslie J. ほか "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints", EMNLP 2023, DOI 10.18653/v1/2023.emnlp-main.298, arXiv 2305.13245 — arxiv.org/abs/2305.13245
- Grattafiori A. ほか(Meta) "The Llama 3 Herd of Models", arXiv 2407.21783 (2024)(表3:8B は32層、モデル次元4,096、ヘッド32、Key/Value ヘッド8) — arxiv.org/abs/2407.21783
- Patel P. ほか "Splitwise: Efficient Generative LLM Inference Using Phase Splitting", ISCA 2024, DOI 10.1109/ISCA59077.2024.00019, arXiv 2311.18677 — arxiv.org/abs/2311.18677
- Zhong Y. ほか "DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving", OSDI '24 (2024), arXiv 2401.09670 — usenix.org/conference/osdi24/presentation/zhong-yinmin
- Agrawal A. ほか "Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve", OSDI '24 (2024), arXiv 2403.02310 — usenix.org/conference/osdi24/presentation/agrawal
- Qin R. ほか(Moonshot AI ほか) "Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving", arXiv 2407.00079 (2024)(FAST '25 版の題名は "Mooncake: Trading More Storage for Less Computation — A KVCache-centric Architecture for Serving LLM Chatbot") — arxiv.org/abs/2407.00079
- Zheng L. ほか "SGLang: Efficient Execution of Structured Language Model Programs", arXiv 2312.07104 (2023) — arxiv.org/abs/2312.07104
- NVIDIA "NVIDIA H100 Tensor Core GPU"(H100 SXM:GPU メモリ 80 GB、メモリ帯域 3.35 TB/s、Tensor Core の値は「疎性あり」、最大TDP 700 W まで/確認日 2026年10月15日) — nvidia.com/en-us/data-center/h100/
- MLCommons "MLPerf Inference Rules"(inference_policies リポジトリの inference_rules.adoc。確認日 2026年10月15日の master。TTFT/TPOT の定義、シナリオ、LLM ベンチマークの精度目標・遅延上限、投機的デコーディングの付録) — github.com/mlcommons/inference_policies/blob/master/infer...
- MLCommons "MLCommons Sets Participation Record with New MLPerf Inference v6.1 Benchmark Results"(2026年9月16日の発表。GlobeNewswire 配信の転載ページ)、およびベンチマークのページ https://mlcommons.org/benchmarks/inference-datacenter/(v6.1 の表示を確認/2026年10月15日) — financialcontent.com/article/gnwcq-2026-9-16-mlcommons-se...
- Reddi V. J. ほか "MLPerf Inference Benchmark", ISCA 2020, DOI 10.1109/ISCA45697.2020.00045, arXiv 1911.02549 — arxiv.org/abs/1911.02549
- Tschand A. ほか "MLPerf Power: Benchmarking the Energy Efficiency of Machine Learning Systems from Microwatts to Megawatts for Sustainable AI", arXiv 2410.12032 (2024) — arxiv.org/abs/2410.12032
- ISO/IEC "ISO/IEC 22989:2022 Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(第1版、2022年7月。JTC 1/SC 42) — iso.org/standard/74296.html
- Li Y. ほか "EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty", ICML 2024, arXiv 2401.15077 — arxiv.org/abs/2401.15077
- vLLM project GitHub リポジトリ vllm-project/vllm(ライセンス Apache-2.0、2026年10月14日に更新を確認) — github.com/vllm-project/vllm
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| OPT-13B の1トークンのKVキャッシュ800 KB(2×5,120×40層×2バイト)、2,048トークンで最大1.6 GB。A100 40 GB で重み約65%・動的状態約30%。既存システムのKV実使用率20.4〜38.2%。PagedAttention の設計。スループット2〜4倍(FasterTransformer・Orca 比、同程度の遅延) | 出典1 https://arxiv.org/abs/2309.06180 | 事実 |
| イテレーションレベルのスケジューリングと選択的バッチ処理(Orca)。静的バッチでは先に終わった要求を返せず、新しい要求は現在のバッチの終了を待つ。GPT-3 175B で FasterTransformer に対し同程度の遅延で36.9倍のスループット | 出典2 https://www.usenix.org/conference/osdi22/presentation/yu | 事実 |
| 投機的デコーディングの定義、出力の分布が変わらないこと、T5-XXL で2〜3倍、受理率 α・コスト比 c・γ の式(期待トークン数と実時間の改善率)、c は0.05未満、演算量が増えること | 出典3 https://proceedings.mlr.press/v202/leviathan23a.html | 事実 |
| 投機的サンプリングで Chinchilla 70B が分散環境で2〜2.5倍 | 出典4 https://arxiv.org/abs/2302.01318 | 事実 |
| FlashAttention がIOを意識した厳密なアテンションで、HBMとSRAM間の読み書きをタイル分割で減らすこと | 出典5 https://arxiv.org/abs/2205.14135 | 事実 |
| GQA が Key/Value ヘッドを減らす方式で、MQA並みの速度と多頭注意に近い品質を目指すこと | 出典6 https://arxiv.org/abs/2305.13245 | 事実 |
| Llama 3 8B の構成(32層、モデル次元4,096、ヘッド32、Key/Value ヘッド8)と、GQA を推論速度とKVキャッシュ削減のために使うという記述 | 出典7 https://arxiv.org/abs/2407.21783 | 事実 |
| Splitwise:プロンプト計算(演算が重い)とトークン生成(メモリが重い)の2段階、分離の設計、1.4倍のスループットを2割低い費用で、または同じ費用・電力で2.35倍 | 出典8 https://arxiv.org/abs/2311.18677 | 事実 |
| DistServe:同じGPUでの混在による干渉、TTFT・TPOT の要件、最大7.4倍の要求または12.6倍厳しい遅延条件(>90%の要求が条件内) | 出典9 https://www.usenix.org/conference/osdi24/presentation/zhong-yinmin | 事実 |
| Sarathi-Serve:プリフィルとデコードの性質、チャンク化と停止しないスケジュール、Mistral-7B(A100 1枚)で vLLM の2.6倍の容量 | 出典10 https://www.usenix.org/conference/osdi24/presentation/agrawal | 事実 |
| Mooncake:Kimi の基盤、プリフィルとデコードの分離、CPU・DRAM・SSD をKVキャッシュに使う設計、実負荷で75%多くの要求(同社の報告) | 出典11 https://arxiv.org/abs/2407.00079 | 事実 |
| SGLang の RadixAttention とスループット最大6.4倍(著者の条件) | 出典12 https://arxiv.org/abs/2312.07104 | 事実 |
| H100 SXM のメモリ80 GB、帯域3.35 TB/s、Tensor Core の値が「疎性あり」であること、最大TDP 700 W まで | 出典13 https://www.nvidia.com/en-us/data-center/h100/ | 事実 |
| MLPerf Inference の規則:TTFT・TPOT の定義、Server/Offline のシナリオ、LLM の遅延上限と精度目標の例、投機的デコーディングは特定のワークロードのみ・参照の予測ヘッドと設定で許可 | 出典14 https://github.com/mlcommons/inference_policies/blob/master/inference_rules.adoc | 事実 |
| MLPerf Inference v6.1 が2026年9月16日に発表され、30団体の提出、RAG のエンドツーエンドとエッジのエージェント処理のテストが追加、MLPerf Endpoints がデータセンター向けの Inference を置き換えると述べていること | 出典15 https://www.financialcontent.com/article/gnwcq-2026-9-16-mlcommons-sets-participation-record-with-new-mlperf-inference-v61-benchmark-results | 未確定/将来 |
| MLPerf Inference の設計と目的(ISCA 2020) | 出典16 https://arxiv.org/abs/1911.02549 | 事実 |
| MLPerf Power がシステム電力の測定を整理していること | 出典17 https://arxiv.org/abs/2410.12032 | 事実 |
| ISO/IEC 22989:2022 が AI の用語と概念を定める規格であること(第1版、2022年7月) | 出典18 https://www.iso.org/standard/74296.html | 事実 |
| EAGLE が特徴量の水準で次を予測する投機的サンプリングの枠組みであること | 出典19 https://arxiv.org/abs/2401.15077 | 事実 |
| vLLM が Apache-2.0 のオープンソースで、2026年10月14日にリポジトリが更新されていること | 出典20 https://github.com/vllm-project/vllm | 事実 |
| Llama 3 8B のKVキャッシュ(131,072バイト/トークン)、80 GB GPU での同時処理数、バッチと速度の表(4.9 ms〜、約9,700トークン/秒 など)、投機的デコーディングの改善率の表、コストの例(1 GPU時間3 US$) | 本稿の計算。メモリ律速を仮定した理想化の見積もりで、予約領域8 GB・価格3 US$/GPU時間・c=0.05 は仮定の値。実機の予測ではない | 本稿の計算 |
| 実機の測定値、各社の価格、LLM推論の遅延を定める国際規格、MLPerf の個別の提出結果の比較 | 本稿の調査範囲では確認できなかった(または設定が揃わないため)載せていない。解説 | 解説 |
| 「KVキャッシュはHBMの容量と帯域の言い換え」「1トークンあたりの電力が冷却・電源を決める」「工場でのバッチの考え方」という読み取り。連続バッチ処理とOrcaの対応づけ。TTFT・TPOT と体感の対応づけ | 公表内容にもとづく本記事の整理・解説。各機関が表明した見解ではない | 解説 |
最終更新:2026年10月15日/出典は一次情報(査読論文・学会論文、MLCommons の規則文書と発表、NVIDIA のデータシート、ISO のページ)に限定しています。実機の測定値、各社の価格、LLM推論の遅延を定める国際規格については、確認できなかったため記載していません。倍率は各論文の著者の条件つきの報告で、本稿の計算は理想化した試算です。図2・5・7はベクター作図、図3・4・6は本稿の計算を含む作図、図1と図8はAI生成イメージ(枠のみ)です。