TECHNOLOGY EXPLAINER
マルチモーダルAIと生成モデル
― 画像・動画・音声を「トークン」に直し、読み、そして作る仕組み
画像を見て質問に答えるAI、文章から画像や動画や音声を作るAI、声でリアルタイムに会話するAI。どれも、画像・音声・動画を、モデルが扱える数の並び(トークンや潜在表現)に直す「前処理」が土台にあります。 この記事では、視覚言語モデルの構成、トークン化、拡散モデルとフローマッチング、リアルタイム音声、そして評価指標(FID・CLIPScore・人手評価)の読み方を、一次情報の範囲で整理します。ディープフェイクは、本シリーズの別編で扱います。
- マルチモーダルAIとは何か(3行でつかむ)
- 全体像 ― 理解の系統と生成の系統
- 視覚言語モデル ― 画像を「読む」仕組みと、その苦手
- トークン化 ― 画像・音声・動画を「並び」にする
- 拡散モデルとフローマッチング ― ノイズからデータを作る
- 動画・音声の生成と、リアルタイム音声
- ディープフェイクは別編で ― この記事の範囲
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定であり、実績が確認できていない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
この分野は変化が速く、モデルの世代や提供状況は数か月で入れ替わります。本記事のモデル名・日付は2026年10月15日に公開資料で確認した範囲で、「現在の最新」を示すものではありません。 評価の数値は、論文や開発元が公表した特定の設定・実施主体での値です。設定や実施主体の違う数値を並べて、モデルの優劣は論じません。第三者の順位表は参考値としてのみ扱い、順位は事実として断定しません。
1. マルチモーダルAIとは何か(3行でつかむ)
- 「読む」と「作る」は、別の仕組みで発展してきた:画像を読んで文章で答える視覚言語モデルは、視覚エンコーダと言語モデルをつないだ構成が基本です。画像・動画・音声を作る生成モデルは、拡散モデルやフローマッチングが主流です。近年は、一つのモデルで両方を扱う試みも出ています事実[参考資料1・3・9・15・20]
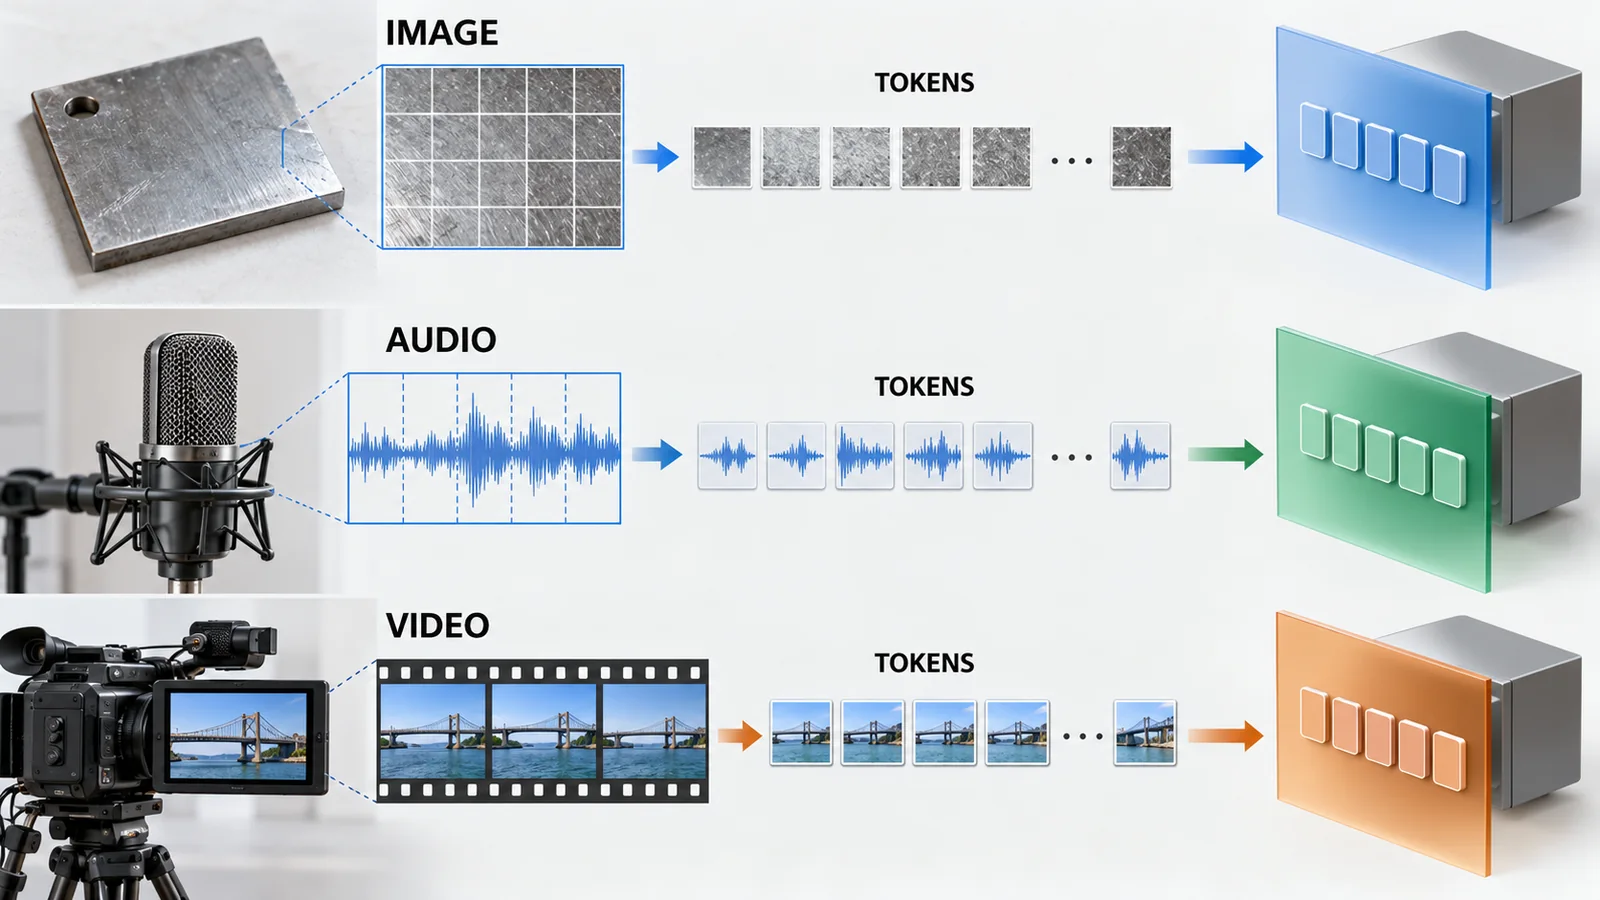
- 共通の鍵は「トークン化」:画像はパッチや潜在表現に、音声は音声コーデックの符号に、動画は時空間のパッチに直され、Transformer が扱える「並び」になります。解像度や長さが増えると、並びが長くなり、計算とメモリの負担が大きく増えます事実/本稿の計算
- 評価は一つの数字では決まらない:FID は「生成画像全体の分布が、本物の画像に近いか」、CLIPScore は「画像と文章が合っているか」、人手評価は「人がどちらを好むか」を測ります。どれも設定と実施主体で値が変わり、互いに食い違うことがあります事実[参考資料28・31・30]
「FID が低い」ことは、「人が良いと感じる」ことを保証しません。 Jayasumana らは、FID が人間の評価者と食い違う例、標本数を変えると結果が変わる例を示し、最近の文章から画像を作るモデルの評価で FID だけを主要な指標にすることの見直しを求めています事実[参考資料30]。
2. 全体像 ― 理解の系統と生成の系統
マルチモーダルAIは、入力と出力の組み合わせで整理すると見通しがよくなります。 画像・音声・動画を入力してテキストで答えるのが「理解」、テキストや画像を入力して画像・動画・音声を作るのが「生成」です。前者は視覚エンコーダと言語モデルをつなぐ設計、後者は拡散モデルやフローマッチングが中心でした(次章以降)。
近年は、この境界をまたぐモデルが増えています。たとえば GPT-4o のシステムカードは、GPT-4o を「テキスト・音声・画像・動画の任意の組み合わせを入力とし、テキスト・音声・画像の任意の組み合わせを出力する自己回帰のオムニモデル」で、「テキスト・視覚・音声をまたいで端から端まで(end-to-end)訓練され、すべての入出力が同じニューラルネットワークで処理される」と記述しています(2024年8月8日付)事実[参考資料24]。 研究面では、Chameleon が画像とテキストを任意の順序で理解・生成する「早期融合のトークン型」モデルを示し[参考資料19]、Transfusion は次トークン予測と拡散を一つの Transformer で訓練する方法を示しました[参考資料20]事実。
ただし、「オムニ」「ネイティブマルチモーダル」という呼び方は開発元の記述で、何がどこまで一つのモデルで処理されているかは、各社の技術文書で確認する必要があります。本記事は、特定モデルの内部構造を断定しません。
3. 視覚言語モデル ― 画像を「読む」仕組みと、その苦手
(1) 画像を「単語」のように並べる:ViT と CLIP
Vision Transformer(ViT)は、画像を P×P のパッチに切り分け、並べた系列を Transformer に入力します。論文は、画像の解像度を H×W とするとパッチ数が N=HW/P² になり、これが Transformer の入力系列の長さになる、と説明しています(論文の題名にある「16×16の単語」は、16×16画素のパッチのことです)事実[参考資料1]。
CLIP は、インターネットから集めた4億組の(画像、文章)で「どの文章がどの画像に付いているか」を当てる事前学習を行い、画像と文章を同じ空間に写します。これにより、あらかじめ決めたカテゴリー以外でも、自然言語で指定した概念で画像を分類する「ゼロショット」転移ができます。論文は、ImageNet で、元の ResNet-50 と同じ精度を、ImageNet の訓練画像128万枚を使わずに達成したと報告しています事実[参考資料2]。
(2) 視覚エンコーダと言語モデルをつなぐ
画像を読んで文章で答えるモデルの多くは、事前学習済みの視覚エンコーダと事前学習済みの言語モデルを、小さな接続部品で結んで作られます。代表的な構成を、論文の記述にもとづいて整理します事実。
| 方式 | 代表例(論文) | 構成の要点(論文の記述) | 読むときの注意 |
|---|---|---|---|
| 対照学習の二塔 | CLIP[参考資料2] | 画像と文章を別々のエンコーダで同じ空間に写す。4億組の画像・文章対で事前学習 | 文章を「生成」するモデルではない。ほかのモデルの視覚エンコーダとして使われる |
| 凍結モデルの橋渡し | Flamingo[参考資料4]、BLIP-2[参考資料5] | Flamingo は、事前学習済みの視覚のみ・言語のみのモデルを橋渡しし、画像とテキストが交互に並ぶ入力を扱う。BLIP-2 は、凍結した画像エンコーダと凍結した言語モデルを、軽量な Querying Transformer でつなぐ | BLIP-2 は、ゼロショットの VQAv2 で Flamingo80B を8.7%上回り、学習するパラメータが54分の1と報告している(論文の条件・時点の値) |
| 射影+指示の微調整 | LLaVA[参考資料3] | CLIP の視覚エンコーダと言語モデル(Vicuna)をつなぎ、言語のみの GPT-4 で生成した画像・言語の指示データで端から端まで微調整する | 指示データを別のAIで生成している。評価の一部も GPT-4 を基準にした相対値で、人の評価とは別物 |
| 早期融合・トークン統一 | Chameleon[参考資料19] | 画像もテキストも離散トークンにし、混ぜた並びを一つのモデルで理解・生成する | 画像の離散化で失われる情報がある(第4章) |
すべて事実(各論文の要旨・本文の記述)。方式の分け方は本記事の整理(解説)です。
(3) 苦手:細部の幾何と、ないものを「見る」こと
視覚言語モデルは多くのベンチマークで高い点を取りますが、単純な視覚課題で意外な失敗をします。 Rahmanzadehgervi らは、2つの円が重なっているか、2本の線が何回交わるか、単語のどの文字が丸で囲まれているか、五輪のようなロゴの円はいくつか、といった7つの単純な課題(BlindTest)で、論文公開時点の最先端の視覚言語モデル4つの正答率が平均58.07%だったと報告しています。最良のモデルでも77.84%で、人の期待正答率は100%でした。図形の間隔を広げるとほぼ100%になること、視覚エンコーダには課題を解く情報が含まれているのに言語モデルがそれを正しい答えに変換できないこと(線形プローブの実験)も示しています事実[参考資料38]。 これは論文の公開時点(2024年7月、最終版は2025年3月)のモデルの結果で、現在のモデルの性能ではありません。
また、Li らは、視覚言語モデルが画像にない物体を述べてしまう「物体ハルシネーション」を体系的に調べ、訓練用の指示データに頻出する物体や、画像中の物体と同時に現れやすい物体が、特に作り出されやすいと報告しました。評価の方法自体も、入力の指示や出力の書き方に左右されるため、「はい/いいえ」で繰り返し尋ねる方法(POPE)を提案しています事実[参考資料37]。
走査電子顕微鏡(SEM)や光学顕微鏡の像、スペクトルのグラフ、装置の画面を視覚言語モデルに読ませたくなる場面は多くあります。 BlindTest の結果は、粒子の重なりの判定、交点の数、近接した図形の識別といった、材料の画像解析でよく必要になる作業が、視覚言語モデルの苦手な領域に近いことを示唆します(論文は人工的な図形を使った試験で、顕微鏡像での性能を直接示すものではありません。これは本記事による解説です)。
実務の組み立てとしては、「何が写っているか」の下書き・分類の補助には視覚言語モデルを使い、粒子数、粒径、膜厚、欠陥の数と位置といった数値は、閾値処理やセグメンテーションなど従来の画像処理と、人の目視で確認する、と分けるのが安全です。 また、画像がモデルに渡る前に縮小・タイル化されれば微細な構造は失われうるため、入力解像度とスケールバー(縮尺)の扱いも条件として記録します(解説)。 なお、MMMU(大学レベルの多分野の問題集)は、化学構造を含む30種類の画像を使っており、専門的な図を読む力を測る試みの一つですが、現場の自分の画像での性能は、自分のデータで確かめるしかありません[参考資料36]。
4. トークン化 ― 画像・音声・動画を「並び」にする
言語モデルは、文章を「トークン」という整数の並びに直して処理します。画像・音声・動画を同じように扱うには、まず連続した信号を、有限の長さの並びに直す必要があります。この変換(トークン化・潜在表現への圧縮)の設計が、品質・計算量・遅延を大きく左右します。
元のSVG模式図・数値・出典注記を見る
| 対象 | 主な方法(出典) | 要点 |
|---|---|---|
| 画像:パッチ | ViT[参考資料1] | 画像を P×P のパッチに切り、そのまま並べる。パッチを小さくするほど並びが長くなる |
| 画像:離散トークン | VQ-VAE[参考資料6]、VQGAN[参考資料7] | エンコーダの出力を、符号表(コードブック)の番号に直す。VQGAN は、畳み込みで「画像の部品の語彙」を学び、Transformer でその組み合わせをモデル化する |
| 画像:潜在空間 | 潜在拡散モデル[参考資料8] | 事前学習済みのオートエンコーダの潜在空間で拡散を行う。画素空間の拡散モデルは、論文によれば訓練に数百 GPU 日を要することがあり、潜在空間で計算量を下げる。文章などの条件は、クロスアテンションで与える |
| 音声:ニューラル音声コーデック | SoundStream[参考資料27]、EnCodec[参考資料26]、Mimi(Moshi)[参考資料25] | 畳み込みのエンコーダ・デコーダと、残差ベクトル量子化(RVQ)で、音声を複数の符号表の番号の並びに直す。SoundStream は3〜18 kbps で動作し、EnCodec は24 kHz で1.5〜24 kbps に対応し、符号表は1つあたり1024エントリ(10ビット) |
| 動画:時空間パッチ | Sora の技術報告[参考資料21] | 動画を、時間・空間の両方で圧縮した潜在表現に直し、時空間パッチに分割して Transformer のトークンとする。報告は、モデルと実装の詳細を含まないと明記している |
すべて事実(各論文・技術報告の記述)。
本稿の計算:解像度とトークン数、音声のビットレート
各論文の式と数値から、「並びの長さ」がどう増えるかを計算します本稿の計算。
- ViT:N=HW/P²(論文)。224×224、P=16 なら N=(224×224)/(16×16)=196。448×448 なら 784(4倍)。自己注意が扱うトークンの組の数 N² は、196²=38,416 から 784²=614,656 へ、16倍
- DiT:256×256 の画像は潜在 32×32×4 になり、パッチの大きさ p=2 で T=(I/p)²=(32/2)²=256 トークン。512×512 の画像は潜在 64×64×4 で、p=2 なら 1,024 トークン(論文が示す値)。DiT の論文も、p を半分にすると T は4倍になり、計算量(Gflops)は少なくとも4倍になる、と述べている
- 音声(Mimi):12.5 Hz で、符号表8個、各2048エントリ(11ビット)。1秒あたり 12.5×8=100トークン、ビットレートは 12.5×8×11=1,100 bit/s = 1.1 kbps(論文の記載値と一致)。1分で6,000トークン
- 圧縮率の目安:24 kHz・16ビット・モノラルの無圧縮音声は 24,000×16=384 kbps(この仮定は本稿)。1.1 kbps との比は 384÷1.1=約349倍
前提と限界:N² は「注意が見る組の数」の目安で、実際の計算量は、注意以外の層(全結合など)やアルゴリズムの工夫で変わり、一律に16倍にはなりません。DiT の計算量(Gflops)は、論文では「少なくとも4倍」と書かれている点だけを根拠にしています。 動画は、フレーム数が加わるため並びはさらに長くなりますが、Sora の圧縮率や並びの長さは報告に書かれていないため、本稿は計算しません。
解像度を上げる、動画の秒数を延ばす、といった要求は、トークン数の増加として計算機に跳ね返ります。並びが長くなれば、注意の計算が増え、途中の結果を置くメモリの容量と帯域が足りなくなります。これは、本シリーズ「HBM」編や「CoWoS」編で扱う、AIアクセラレータのメモリ帯域・パッケージの制約と直接つながる話です(本記事による解説。生成モデルごとの必要メモリは、公開資料からは確認できなかったため示しません)。
言い換えれば、生成AIの「高画質」「長尺」は、計算量とメモリ、ひいては電力と冷却で支えられているということです。NIST の生成AIプロファイルが、環境への影響(訓練と運用での大きな計算資源の使用)を、生成AIに特有または増幅されるリスクの一つに挙げているのも、この事情と整合します[参考資料46]。電力と冷却は、本シリーズ「AIデータセンターの電力と冷却」編で扱います。
5. 拡散モデルとフローマッチング ― ノイズからデータを作る
(1) 拡散モデル:ノイズを足す過程の「逆」を学ぶ
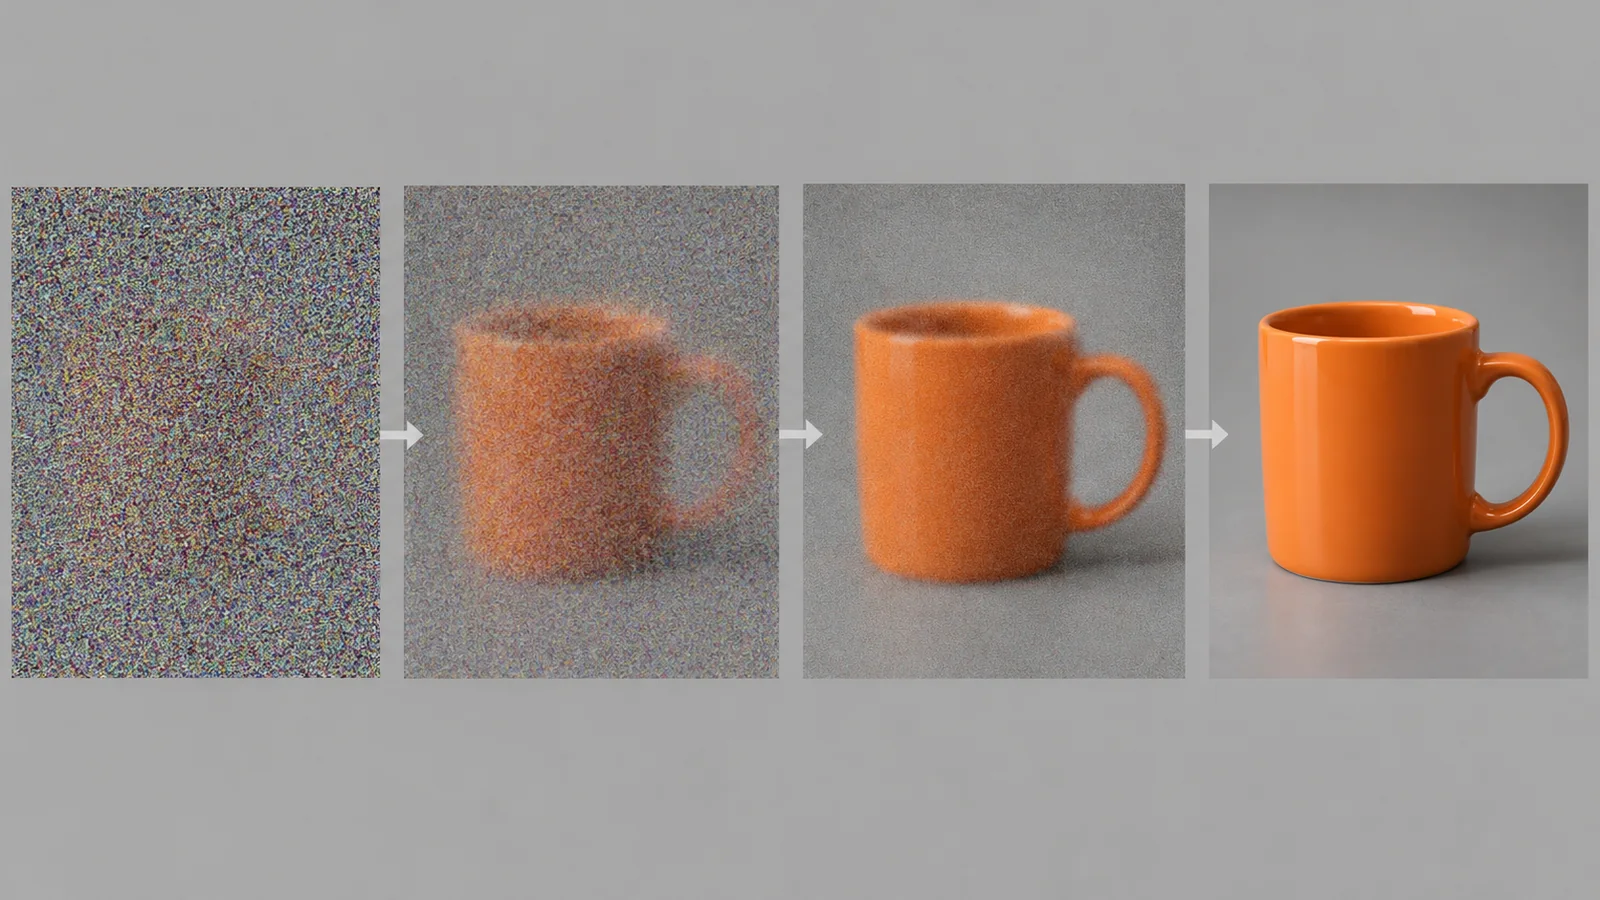
拡散モデルは、データに少しずつノイズを加えて最終的にノイズに変える過程を決め、その逆(ノイズから元のデータへ戻る過程)をニューラルネットワークで学ぶ生成モデルです。Ho らの DDPM は、この枠組みで高品質な画像生成を示しました(CIFAR-10 の無条件生成で FID 3.17、Inception score 9.46 と報告)事実[参考資料9]。 Song らは、拡散を確率微分方程式(SDE)として定式化し、従来のスコアベース生成と拡散確率モデルを同じ枠組みで説明しました。逆向きの過程はスコア(データ分布の勾配場)だけに依存し、同じ分布からサンプルする常微分方程式(ODE)も導けます事実[参考資料10]。
素朴な拡散モデルは多数のステップの反復が必要で、生成が遅くなります。これを緩和する方法として、DDIM(同じ訓練手順のまま、生成を実時間で10〜50倍速くできると報告)[参考資料12]や、一度の評価でノイズからデータへ直接写す一貫性モデル(1ステップ生成を設計上サポートし、複数ステップで品質と計算量を調整できる)[参考資料13]が提案されています事実。
文章などの条件を効かせる方法として、分類器なしガイダンス(classifier-free guidance)が広く使われます。条件つきと条件なしのスコア推定を一緒に訓練し、その二つを組み合わせて、サンプルの品質と多様性のトレードオフを調整します事実[参考資料11]。
(2) 潜在拡散と Transformer(DiT)
潜在拡散モデルは、前章のとおり、オートエンコーダの潜在空間で拡散を行うことで計算量を下げ、クロスアテンションで文章などの条件を与えます[参考資料8]。 Peebles と Xie の DiT は、拡散モデルの骨格を U-Net から、潜在のパッチを扱う Transformer に置き換え、計算量(Gflops)が大きいほど FID が下がる傾向を示しました。最大の DiT-XL/2 は、クラス条件つき ImageNet 256×256 で FID 2.27 を報告しています(条件・論文時点の値)事実[参考資料14]。
(3) フローマッチングと整流フロー:直線に近い経路
Lipman らのフローマッチングは、連続正規化フロー(CNF)を、固定した確率経路のベクトル場を回帰して学ぶ「シミュレーション不要」の方法です。拡散の経路を特殊例として含み、最適輸送に基づく別の経路も使えます。論文は、ImageNet で拡散ベースの方法より、尤度とサンプル品質の両方で一貫して良い結果が得られたと報告しています事実[参考資料15]。 Liu らの整流フロー(rectified flow)は、二つの分布の点をできるだけ直線で結ぶ常微分方程式を学ぶもので、ほぼ直線の経路は、1回の Euler 離散化でも高品質な結果を与えうると報告されています事実[参考資料16]。
元のSVG模式図・数値・出典注記を見る
Stable Diffusion 3 の論文(Esser ら)は、整流フローを、知覚的に重要なスケールにノイズの標本化を偏らせて訓練することで、高解像度の文章→画像生成で確立された拡散の定式化より良い結果を得たと報告し、画像とテキストに別々の重みを持たせ、両者の情報が双方向に流れる Transformer 構造(MMDiT)を提案しています。モデルの規模と検証損失の関係が予測可能に変化する、とも述べています事実[参考資料17]。 Black Forest Labs の FLUX.1 [dev] のモデルカードは、このモデルを「120億パラメータの整流フロー Transformer」と記述しています(確認日 2026年10月15日)事実[参考資料18]。
フローマッチングも整流フローも、条件を明示した論文の実験で良い結果を示したもので、拡散モデルと数学的に近縁です(フローマッチングは拡散の経路を特殊例に含む)。 また、論文のモデルは規模・データ・評価指標が異なります。本記事は、どちらの系統が一般に優れるかを断定しません。新しい画像・動画モデルが実際にどちらの定式化を使っているかは、開発元の技術文書で確認する必要があります(公開されていない場合もあります)。
(4) 理解と生成を一つのモデルで
Transfusion は、言語モデルの次トークン予測と拡散を、一つの Transformer で混合モダリティの系列に対して訓練します。最大70億パラメータ、2兆の混合トークンで、同規模の拡散モデルと言語モデルに匹敵する画像・テキスト生成ができると報告し、画像を離散トークンに量子化して言語モデルで訓練する方法より大幅によくスケールするとしています事実[参考資料20]。 これは、第4章の「離散化で失われる情報」の問題に対する、一つの答えです(論文の主張で、条件を限った比較です)。
6. 動画・音声の生成と、リアルタイム音声
(1) 動画生成
OpenAI の Sora の技術報告(2024年2月15日)は、可変の長さ・解像度・縦横比の動画と画像で、文章条件つきの拡散モデルを訓練し、動画と画像の潜在コードの時空間パッチを扱う Transformer を使うと述べ、最大のモデルは1分間の高精細な動画を生成できるとしています。動画生成のスケーリングが「物理世界の汎用シミュレータ」への有望な道だという示唆も述べていますが、同じ報告が、ガラスが割れるといった基本的な相互作用の物理を正確にはモデル化しないなど、シミュレータとしての多くの限界を挙げています事実[参考資料21]。 報告は、モデルと実装の詳細を含まないと明記しています。「世界シミュレータ」は開発元の見立てであり、実証された事実ではありません(世界モデルは本シリーズ「世界モデルと身体性AI」編で扱います)。
Google DeepMind の Veo 3 のモデルカード(2025年5月23日公開、2026年1月13日更新と記載)は、Veo 3 を、文章や画像から音声つきの高解像度の動画を作る生成システムと位置づけ、潜在拡散を用い、音声の時間的な潜在表現と動画の時空間の潜在表現に拡散を適用すると記述しています。訓練には Google の TPU と JAX を使ったとあります事実[参考資料22]。 同じカードは、既知の限界として「複雑なシーンや複雑な動きで、全体の一貫性を保つことは難しい課題として残る」と述べています。評価については、Meta が公開した MovieGenBench(動画用1,003プロンプト、動画+音声用527プロンプト)などを使い、他社モデルの出力との人手の比較で、Veo 3 が総合的な好みとプロンプトへの追従で最良だったと開発元が記述しています。確認した範囲では、評価者の人数や選び方などの詳細はカードに記載されていません事実[参考資料22]。
Google の Gemini API のドキュメント(ページの最終更新2026年6月30日と記載、確認日 2026年10月15日)は、動画生成のモデルとして Gemini Omni Flash と Veo 3.1 を挙げ、前者を既定として勧めています事実[参考資料23]。 2025年5月のVeo 3から1年余りで、提供される動画生成モデルの名前と推奨が入れ替わっていることは、この分野の変化の速さを示す一例です(本記事による解説)。
(2) リアルタイム音声:遅延は何で決まるか
従来の音声対話は、音声区間検出、音声認識、テキストでの対話、音声合成を順に動かすパイプライン型でした。Moshi の論文は、この構成では段ごとの遅延が積み重なり、対話の応答に数秒の遅延が生じること、テキストを介するため感情や非言語音などの情報が失われること、話者の交代を区切って扱うため、重なりや割り込みを扱えないことを問題として挙げています事実[参考資料25]。
これに対し、音声から音声へ直接生成する一体型が提案されています。Moshi は、テキストの言語モデルを土台に、ニューラル音声コーデックの符号を生成し、自分の音声とユーザーの音声を並行する2本のストリームでモデル化します。論文は、これを実時間・全二重の音声言語モデルとして、理論上の遅延160 ms、実際には200 msと述べています。Mimi コーデックのフレームは80 msで、論文は音響トークンの遅延を1フレームにした設定で理論遅延160 msを与えています事実[参考資料25]。 GPT-4o のシステムカードは、音声入力への応答が最短232 ms、平均320 msだと記述しています事実[参考資料24]。どちらの論文・カードも、人の会話の応答間隔の研究(Stivers ら、2009年)を引いて、人間の会話の応答時間と比べています。
「160 ms」と「232 ms」を比べても、どちらが優れるかは言えません。Moshi の160 msはモデルの構成から決まる理論値(実測は200 ms)で、GPT-4o の232 ms・320 msは開発元が示した応答時間で、測定の起点・終点、通信の遅延、ハードウェア、測った回数などの条件は、確認した範囲では同じ定義で比較できる形になっていません。 実際の体感遅延は、通信経路、サーバーの負荷、端末の処理でも変わります(本記事による解説)。
生成モデルは「データ分布に似たもの」を作るのであって、物理法則や材料の構造を満たす保証はありません。Sora の報告は物理の誤りを自ら挙げ、Veo 3 のカードも複雑な動きの一貫性の難しさを認めています[参考資料21・22]。 材料の分野で、生成モデルで作った「それらしい顕微鏡像」「それらしい断面図」を、実験データや論文の図として扱うことは、データの捏造になります。学習データを増やす目的で合成画像を使う場合も、本物と区別できるよう記録し、評価は本物のデータで行う必要があります(本記事による解説)。
また、前述のとおり FID は自然画像で学習された Inception の特徴を使うため、推測ですが、材料の顕微鏡像のような専門画像の「忠実さ」を測る指標として、そのまま信頼できるとは限りません。論文は、Inception の表現が最近の文章→画像モデルの生成内容を十分に表せないと指摘しています[参考資料30]。
7. ディープフェイクは別編で ― この記事の範囲
画像・動画・音声の生成は、本物と見分けのつかない偽の素材を作る悪用にもつながります。本記事は悪用の手順や具体的な方法を扱いません。詳しい説明は、本シリーズ「著作権・来歴・ディープフェイク」編で扱います。ここでは、一次資料で確認できた枠組みだけを示します。
- リスクの分類:NIST AI 600-1(2024年7月)は、生成AIに特有または増幅されるリスクを12項目に整理しています(CBRN情報、虚偽の生成〔confabulation〕、危険・暴力・憎悪を含むコンテンツ、データプライバシー、環境への影響、有害なバイアスと均質化、人とAIの関係、情報の完全性、情報セキュリティ、知的財産、わいせつ・卑劣・虐待的コンテンツ、バリューチェーンと部品の統合)。情報の完全性は、事実と意見・虚構を区別しない内容の生成が容易になり、大規模な偽情報・誤情報の流布に使われうることを指します事実[参考資料46]
- 開発元の対策の記述:Veo 3 のカードは、ディープフェイクを作れることを認めたうえで、専用のディープフェイクツールより品質が低いこと、SynthID の透かしで一部を緩和できることを記述しています事実[参考資料22]。この評価は開発元の自己評価で、独立した検証の結果ではありません
- この記事では書かないこと:特定の人物や作品を模倣する方法、検出をすり抜ける方法、各社の安全対策を回避する方法。対策の考え方(来歴情報、透かし、検出の限界)は別編で整理します
8. 限界と、確認できなかったこと
(1) 現在のモデルの性能
本記事が扱うモデル(GPT-4o、Veo 3、Moshi、FLUX.1 [dev] など)と、各論文の評価値は、公表時点・指定した設定のものです。2026年10月15日時点の各社の最新モデルや、新しい評価結果は網羅していません。BlindTest や MMMU のように、論文公開後にモデルが更新されて結果が変わりうる評価は、数値を載せていません。
(2) 開発元の評価
Veo 3 の人手比較、GPT-4o の応答時間など、開発元が自ら公表した評価は、独立した第三者の再現を確認していません。評価者の人数、選び方、プロンプトの選び方など、詳細が記載されていない項目は、確認できなかったと書いています。
(3) 公式ページの取得
OpenAI の Sora の技術報告のページは、自動取得が拒否されるため、インターネットアーカイブに保存された同じページで全文を確認しました。ISO の各規格ページは、同様の理由で自動取得できないため、題名・版・発行時期・適用範囲は検索結果に表示された公式ページの記載で確認しており、規格の本文は確認していません。
(4) 内部構造・規模
多くの商用モデルは、パラメータ数、訓練データ、必要な計算量を公表していません。本記事はこれらを推計していません(「非公表」「確認できなかった」と扱います)。FLUX.1 [dev] の120億パラメータは、開発元のモデルカードの記述です。
(5) 取り上げなかった内容
画像編集・画像から3Dへの生成、音楽生成、音声の個人性(声の複製)、著作権と学習データ、ディープフェイクの検出技術は、本記事では扱いません(一部は本シリーズの別編で扱います)。顕微鏡像・材料データ向けの専門の生成モデルも扱っていません。
- 画像・音声・動画は、トークン(並び)に直されて初めてモデルに入ります。解像度や長さが増えると、並びが長くなり、計算量とメモリの負担が増えます事実/本稿の計算
- 「読む」モデルは、視覚エンコーダと言語モデルの接続が基本で、細部の幾何やないものの「ハルシネーション」が苦手です。顕微鏡像の数値は従来の画像処理と目視で確かめます事実
- 「作る」モデルは、拡散とフローマッチング(整流フロー)が主流です。両者は近縁で、どちらが優れると断定できません事実
- リアルタイム音声は、パイプライン型から音声直接生成へ。遅延の数字は定義が違い、並べて優劣をつけません事実
- 評価は、指標ごとに測るものが違います。FID だけで画質を語らず、設定と実施主体を確認します事実
9. 評価・標準の読み方
マルチモーダルAIの評価には、(1)生成物の統計的な近さ(FID など)、(2)入力との整合(CLIPScore、物体の数・位置など)、(3)人手の好み(対戦型の比較、評価者による採点)、(4)理解の正確さ(質問応答、ハルシネーション)、(5)速さ(遅延)の5つの面があります。 それぞれ別の道具で測り、結果は設定・版・実施主体で変わります。標準・指針は、モデルの性能そのものではなく、AIの管理・リスク・用語・品質モデルの枠組みを与えるものが中心です。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(ISO/IEC・NIST・ITU など) | 読み方の注意 |
|---|---|---|---|
| 生成画像の品質・分布の近さ | FID:Inception-v3 の特徴で、生成画像と本物の画像の分布の距離を測る(Heusel ら、2017)[参考資料28]。Inception Score:分類器の出力から品質と多様性を測る(Salimans ら、2016)[参考資料29]。CMMD:CLIP の特徴と最大平均差を使う提案(Jayasumana ら)[参考資料30] | 生成画像の品質指標を定める ISO/IEC・NIST の規格は確認できなかった。ISO/IEC TS 4213:2022 は、機械学習の分類性能の評価が対象[参考資料44] | FID は人の評価と食い違う例・標本数で結果が変わる例がある(Jayasumana ら)。Inception Score は50,000標本程度で評価することが推奨されている(Salimans ら)。専門画像(顕微鏡像など)への適用は推測になるため慎重に 事実 |
| 文章と画像の整合 | CLIPScore:CLIP で画像と文の適合度を参照文なしで測る(Hessel ら、EMNLP 2021)[参考資料31]。GenEval:物体の共起・位置・数・色を、物体検出器などで検証する(Ghosh ら)[参考資料32] | 確認できなかった | CLIPScore は、ニュースの説明文のように文脈の知識が要る場合には、参照文を使う指標より弱いと論文が指摘。GenEval の論文は、公開時点のモデルが空間関係と属性の結びつけでなお弱いと報告 事実 |
| 多面的な評価 | HEIM:文章→画像モデルを12の観点(整合、品質、美しさ、独創性、推論、知識、バイアス、有害性、公平性、頑健性、多言語、効率)、62の場面、26モデルで評価(Lee ら)[参考資料33] | NIST AI RMF 1.0(NIST AI 100-1、2023年1月)と生成AIプロファイル NIST AI 600-1(2024年7月)。いずれも自主的に使う枠組み[参考資料47・46] | HEIM は「単独で全観点に優れるモデルはない」と報告。観点ごとに強みが異なる 事実 |
| 動画の品質 | FVD:動画版の分布距離(Unterthiner ら、2018)[参考資料34]。VBench:動画の品質を16の次元に分け、人の好みの注釈で検証(Huang ら)[参考資料35]。開発元の人手比較:Veo 3 のカードは MovieGenBench を使用[参考資料22] | 確認できなかった | FVD は大規模な人手調査で人の判断とよく相関すると論文が報告。開発元の人手比較は、評価者の詳細がカードにない(確認した範囲)。比較相手と版・時点で結果が変わる 事実 |
| 視覚言語モデルの理解 | MMMU:大学レベル11,500問、6分野・30科目・183の下位分野、30種類の画像(Yue ら)[参考資料36]。POPE:物体ハルシネーションの繰り返し質問による評価(Li ら)[参考資料37]。BlindTest:7つの単純な視覚課題(Rahmanzadehgervi ら)[参考資料38] | 確認できなかった。ISO/IEC TS 4213:2022 は分類性能の評価が対象で、自由な文章生成を直接扱うものではない[参考資料44] | MMMU は学術的な問題の正答率で、現場の画像の読み取りの正確さとは別物。BlindTest は人工図形。結果は公開時点のモデルのもので、版が上がると変わる 事実 |
| 人手の好み(対戦型) | Chatbot Arena:二つの出力を比較する人の投票を統計的に順位づけする方法(Chiang ら、LLM向けの論文)[参考資料39]。画像・動画向けの同様の順位表は本稿では個別に確認していない | 確認できなかった | 第三者の順位表は、方法・更新日・投票した人の層を確認し、参考値として使う。順位を事実として断定しない 事実 |
| 音声の品質・遅延 | MUSHRA(EnCodec の論文が音声品質の主観評価に使用)[参考資料26]。遅延:GPT-4o 232 ms(最短)・320 ms(平均)[参考資料24]、Moshi 理論160 ms・実測200 ms[参考資料25] | ITU-R BS.1534-3(2015年10月):中程度の品質の音声システムの主観評価法(MUSHRA)。隠した基準音とアンカーを含み、0〜100の連続尺度で採点する[参考資料40] | 遅延は共通の測定規格を確認できなかった。各社の定義が違い、並べて優劣をつけない。MUSHRA は聴取条件・評価者・アンカーの設定で結果が変わる 事実 |
| AIの管理・リスク・用語・品質モデル | (ベンチマークではなく枠組み) | ISO/IEC 42001:2023(AIマネジメントシステム、2023年12月)[参考資料41]。ISO/IEC 23894:2023(AIのリスク管理の手引き、2023年2月)[参考資料42]。ISO/IEC 22989:2022(AIの概念と用語、2022年7月)[参考資料43]。ISO/IEC 25059:2023(AIシステムの品質モデル、2023年6月)[参考資料45]。NIST AI 600-1(12のリスク)[参考資料46] | 42001 は組織の管理体制の要求事項で、モデルの出力品質を保証するものではない。23894・22989 は手引き・用語。25059 は品質の観点の整理。本文は有料のため、題名・適用範囲の記載にとどめる 事実 |
表の整理は本稿の計算ではなく本記事の整理(解説)です。ISO/IEC の本文は有料のため確認していません。確認日 2026年10月15日。
読み方の注意(素材技術者向けに3点)
- ベンチマークの値は、設定と実施主体で変わります。同じモデルでも、プロンプトの選び方、比較相手、評価者、版が違えば結果は変わります。Veo 3 のように開発元が人手比較を行った結果は、独立した評価ではありません。第三者の順位表は、方法と日付を確認したうえで参考値にとどめます
- 指標は「何を測るか」が一つです。FID は分布、CLIPScore は文との一致、GenEval は物体の数・位置・色、遅延は時間です。画質の良さ・正確さ・速さは、別々に確認します。公開ベンチマークの問題や画像が学習データに混入していないかを、利用者が確かめることは難しく(本記事の解説)、飽和と汚染は本シリーズ「ベンチマークと評価の読み方」編で扱います
- 標準・指針には、拘束力のあるものとないものがあります。NIST AI RMF 1.0 と AI 600-1 は、自主的に使う枠組みです(AI 600-1 は AI RMF が自主的な利用を意図していると記す)。ISO/IEC 42001 は組織の管理体制を定める規格で、規格を満たすことは個々のモデルの出力が正確であることを意味しません。法的な拘束力のある規制(EU AI法など)は、本シリーズ「EU AI法」編で扱います
10. 用語集
- マルチモーダル
- テキスト、画像、音声、動画など複数の種類のデータを扱うこと。
- 視覚言語モデル(VLM)
- 画像(や動画)とテキストを入力し、テキストで答えるモデル。
- トークン
- モデルが処理する離散的な単位。画像・音声では、パッチや符号表の番号を指す。
- パッチ
- 画像を小さな正方形に切った断片。Transformer の入力の単位。
- 潜在表現(潜在空間)
- オートエンコーダなどで圧縮した、元の画像より小さな表現。
- VQ(ベクトル量子化)
- 連続値を、符号表の最も近い項目の番号に置き換える処理。
- RVQ(残差ベクトル量子化)
- 量子化の残りの誤差を、次の符号表でさらに量子化する方式。音声コーデックで使う。
- 拡散モデル
- ノイズを加える過程の逆を学び、ノイズからデータを作る生成モデル。
- フローマッチング/整流フロー
- ノイズとデータを結ぶ経路(整流フローは直線に近い経路)を学ぶ生成の方法。
- 分類器なしガイダンス
- 条件つき・条件なしの推定を組み合わせ、条件への従い方を調整する方法。
- DiT/MMDiT
- 拡散の骨格に使う Transformer。MMDiT は画像とテキストに別の重みを持つ。
- FID
- Fréchet Inception Distance。生成画像と本物の画像の特徴の分布の距離。
- CLIPScore
- CLIP を使い、画像と文の適合度を測る指標。
- MUSHRA
- 隠した基準音とアンカーを含む、音声品質の主観評価法(ITU-R BS.1534)。
- ハルシネーション
- 入力にないものを、もっともらしく述べること。NIST AI 600-1 は confabulation と呼ぶ。
- 全二重(フルデュプレックス)
- 聞くことと話すことを同時に行い、重なりや割り込みも扱えること。
11. 参考資料(一次情報)
- Dosovitskiy A. ほか "An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale", arXiv:2010.11929 (2020) — arxiv.org/abs/2010.11929
- Radford A. ほか "Learning Transferable Visual Models From Natural Language Supervision", arXiv:2103.00020 (2021) — arxiv.org/abs/2103.00020
- Liu H. ほか "Visual Instruction Tuning", NeurIPS 2023, arXiv:2304.08485 — arxiv.org/abs/2304.08485
- Alayrac J.-B. ほか "Flamingo: a Visual Language Model for Few-Shot Learning", arXiv:2204.14198 (2022) — arxiv.org/abs/2204.14198
- Li J. ほか "BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models", arXiv:2301.12597 (2023) — arxiv.org/abs/2301.12597
- van den Oord A. ほか "Neural Discrete Representation Learning", arXiv:1711.00937 (2017) — arxiv.org/abs/1711.00937
- Esser P. ほか "Taming Transformers for High-Resolution Image Synthesis", arXiv:2012.09841 (2020) — arxiv.org/abs/2012.09841
- Rombach R. ほか "High-Resolution Image Synthesis with Latent Diffusion Models", arXiv:2112.10752 (2021) — arxiv.org/abs/2112.10752
- Ho J. ほか "Denoising Diffusion Probabilistic Models", arXiv:2006.11239 (2020) — arxiv.org/abs/2006.11239
- Song Y. ほか "Score-Based Generative Modeling through Stochastic Differential Equations", arXiv:2011.13456 (2020) — arxiv.org/abs/2011.13456
- Ho J., Salimans T. "Classifier-Free Diffusion Guidance", arXiv:2207.12598 (2022) — arxiv.org/abs/2207.12598
- Song J. ほか "Denoising Diffusion Implicit Models", arXiv:2010.02502 (2020) — arxiv.org/abs/2010.02502
- Song Y. ほか "Consistency Models", arXiv:2303.01469 (2023) — arxiv.org/abs/2303.01469
- Peebles W., Xie S. "Scalable Diffusion Models with Transformers", arXiv:2212.09748 (2022) — arxiv.org/abs/2212.09748
- Lipman Y. ほか "Flow Matching for Generative Modeling", arXiv:2210.02747 (2022) — arxiv.org/abs/2210.02747
- Liu X. ほか "Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow", arXiv:2209.03003 (2022) — arxiv.org/abs/2209.03003
- Esser P. ほか "Scaling Rectified Flow Transformers for High-Resolution Image Synthesis", arXiv:2403.03206 (2024) — arxiv.org/abs/2403.03206
- Black Forest Labs FLUX.1 [dev] モデルカード(Hugging Face)。確認日 2026年10月15日 — huggingface.co/black-forest-labs/FLUX.1-dev
- Chameleon Team "Chameleon: Mixed-Modal Early-Fusion Foundation Models", arXiv:2405.09818 (2024) — arxiv.org/abs/2405.09818
- Zhou C. ほか "Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model", arXiv:2408.11039 (2024) — arxiv.org/abs/2408.11039
- OpenAI "Video generation models as world simulators", 技術報告(2024年2月15日)。公式ページは自動取得が拒否されるため、インターネットアーカイブの保存版で全文を確認 — openai.com/index/video-generation-models-as-world-simulators
- Google DeepMind "Veo 3 Model Card"(公開 2025年5月23日、更新 2026年1月13日と記載)。確認日 2026年10月15日 — storage.googleapis.com/deepmind-media/Model-Cards/Veo-3-Model-Card.pdf
- Google "Video generation in the Gemini API"(ページの最終更新 2026年6月30日と記載)。確認日 2026年10月15日 — ai.google.dev/gemini-api/docs/video
- OpenAI "GPT-4o System Card", arXiv:2410.21276。システムカード本体は 2024年8月8日付(cdn.openai.com/gpt-4o-system-card.pdf) — arxiv.org/abs/2410.21276
- Défossez A. ほか(Kyutai) "Moshi: a speech-text foundation model for real-time dialogue", arXiv:2410.00037 (2024) — arxiv.org/abs/2410.00037
- Défossez A. ほか "High Fidelity Neural Audio Compression", arXiv:2210.13438 (2022) — arxiv.org/abs/2210.13438
- Zeghidour N. ほか "SoundStream: An End-to-End Neural Audio Codec", arXiv:2107.03312 (2021) — arxiv.org/abs/2107.03312
- Heusel M. ほか "GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium", NeurIPS 2017, arXiv:1706.08500(FID を導入した論文) — arxiv.org/abs/1706.08500
- Salimans T. ほか "Improved Techniques for Training GANs", arXiv:1606.03498 (2016) — arxiv.org/abs/1606.03498
- Jayasumana S. ほか "Rethinking FID: Towards a Better Evaluation Metric for Image Generation", arXiv:2401.09603 (2023) — arxiv.org/abs/2401.09603
- Hessel J. ほか "CLIPScore: A Reference-free Evaluation Metric for Image Captioning", EMNLP 2021, arXiv:2104.08718 — arxiv.org/abs/2104.08718
- Ghosh D. ほか "GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment", arXiv:2310.11513 (2023) — arxiv.org/abs/2310.11513
- Lee T. ほか "Holistic Evaluation of Text-To-Image Models", arXiv:2311.04287 (2023) — arxiv.org/abs/2311.04287
- Unterthiner T. ほか "Towards Accurate Generative Models of Video: A New Metric & Challenges", arXiv:1812.01717 (2018) — arxiv.org/abs/1812.01717
- Huang Z. ほか "VBench: Comprehensive Benchmark Suite for Video Generative Models", arXiv:2311.17982 (2023) — arxiv.org/abs/2311.17982
- Yue X. ほか "MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI", arXiv:2311.16502 (2023) — arxiv.org/abs/2311.16502
- Li Y. ほか "Evaluating Object Hallucination in Large Vision-Language Models", arXiv:2305.10355 (2023) — arxiv.org/abs/2305.10355
- Rahmanzadehgervi P. ほか "Vision language models are blind: Failing to translate detailed visual features into words", arXiv:2407.06581 (2024, v6 は 2025年3月) — arxiv.org/abs/2407.06581
- Chiang W.-L. ほか "Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference", arXiv:2403.04132 (2024) — arxiv.org/abs/2403.04132
- ITU-R Recommendation ITU-R BS.1534-3 (10/2015) "Method for the subjective assessment of intermediate quality level of audio systems"(MUSHRA) — itu.int (R-REC-BS.1534-3-201510)
- ISO/IEC ISO/IEC 42001:2023 "Information technology — Artificial intelligence — Management system"(第1版、2023年12月) — iso.org/standard/81230.html
- ISO/IEC ISO/IEC 23894:2023 "Information technology — Artificial intelligence — Guidance on risk management"(第1版、2023年2月) — iso.org/standard/77304.html
- ISO/IEC ISO/IEC 22989:2022 "Information technology — Artificial intelligence — Artificial intelligence concepts and terminology"(第1版、2022年7月) — iso.org/standard/74296.html
- ISO/IEC ISO/IEC TS 4213:2022 "Information technology — Artificial intelligence — Assessment of machine learning classification performance" — iso.org/standard/79799.html
- ISO/IEC ISO/IEC 25059:2023 "Software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Quality model for AI systems"(第1版、2023年6月) — iso.org/standard/80655.html
- NIST NIST AI 600-1 "Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile"(2024年7月) — doi.org/10.6028/NIST.AI.600-1
- NIST NIST AI 100-1 "Artificial Intelligence Risk Management Framework (AI RMF 1.0)"(2023年1月) — doi.org/10.6028/NIST.AI.100-1
12. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| 画像を P×P のパッチに分け N=HW/P² が系列長になること[参考資料1]。CLIP が4億組の画像・文章対で事前学習し、ImageNet で ResNet-50 と同じ精度を訓練画像なしで達成したこと[参考資料2] | 出典1 https://arxiv.org/abs/2010.11929 出典2 https://arxiv.org/abs/2103.00020 | 事実 |
| 視覚言語モデルの構成(LLaVA:CLIP+Vicuna と GPT-4 生成の指示データ、Flamingo、BLIP-2:Querying Transformer と 8.7%・54分の1 の報告、Chameleon:早期融合のトークン型) | 出典3 https://arxiv.org/abs/2304.08485 出典4 https://arxiv.org/abs/2204.14198 出典5 https://arxiv.org/abs/2301.12597 出典19 https://arxiv.org/abs/2405.09818 | 事実 |
| BlindTest(7課題、4モデル平均58.07%、最良77.84%、人の期待正答率100%、余白を広げるとほぼ100%、線形プローブ)、POPE と物体ハルシネーション、MMMU(11,500問、6分野・30科目・183下位分野・30種類の画像) | 出典38 https://arxiv.org/abs/2407.06581 出典37 https://arxiv.org/abs/2305.10355 出典36 https://arxiv.org/abs/2311.16502 | 事実 |
| VQ-VAE の離散符号、VQGAN の「画像の部品の語彙」、潜在拡散(数百 GPU 日、潜在空間、クロスアテンション)、SoundStream(3〜18 kbps、RVQ)、EnCodec(24 kHz で1.5〜24 kbps、符号表1024エントリ)、Mimi(12.5 Hz、8符号表、各2048、1.1 kbps、フレーム80 ms)、Sora 報告(潜在への圧縮と時空間パッチ、詳細は非公開) | 出典6 https://arxiv.org/abs/1711.00937 出典7 https://arxiv.org/abs/2012.09841 出典8 https://arxiv.org/abs/2112.10752 出典27 https://arxiv.org/abs/2107.03312 出典26 https://arxiv.org/abs/2210.13438 出典25 https://arxiv.org/abs/2410.00037 出典21 https://openai.com/index/video-generation-models-as-world-simulators/ | 事実 |
| ViT の 224→448 px で196→784 トークン(N² は38,416→614,656、16倍)、DiT の 256→512 px で256→1,024 トークン、Mimi の 100 トークン/秒・1.1 kbps と、24 kHz・16ビット・モノラル(384 kbps)に対する約349倍 | 本稿の計算。論文の式と数値(ViT:N=HW/P²、DiT:T=(I/p)² と 256・1,024 トークン、Mimi:12.5 Hz・8符号表・2048エントリ)を使用。無圧縮音声の基準(24 kHz・16ビット・モノラル)は本稿の仮定。注意の計算量が一律に16倍になるわけではない | 本稿の計算 |
| DDPM(CIFAR-10 で FID 3.17、Inception score 9.46)、SDE による定式化、DDIM(実時間で10〜50倍)、一貫性モデル(1ステップ生成)、分類器なしガイダンス、DiT(FID 2.27、Gflops と FID の関係) | 出典9 https://arxiv.org/abs/2006.11239 出典10 https://arxiv.org/abs/2011.13456 出典12 https://arxiv.org/abs/2010.02502 出典13 https://arxiv.org/abs/2303.01469 出典11 https://arxiv.org/abs/2207.12598 出典14 https://arxiv.org/abs/2212.09748 | 事実 |
| フローマッチング(拡散の経路を特殊例に含む)、整流フロー(ほぼ直線の経路、1ステップでも高品質)、Stable Diffusion 3(整流フロー+MMDiT)、FLUX.1 [dev](120億パラメータの整流フロー Transformer、確認日 2026年10月15日) | 出典15 https://arxiv.org/abs/2210.02747 出典16 https://arxiv.org/abs/2209.03003 出典17 https://arxiv.org/abs/2403.03206 出典18 https://huggingface.co/black-forest-labs/FLUX.1-dev | 事実 |
| GPT-4o のシステムカード(2024年8月8日付、オムニモデル、端から端まで訓練)、Transfusion(次トークン予測+拡散、70億パラメータ・2兆トークン) | 出典24 https://arxiv.org/abs/2410.21276 出典20 https://arxiv.org/abs/2408.11039 | 事実 |
| Sora の技術報告(2024年2月15日、時空間パッチ、1分の動画、物理の限界、「世界シミュレータ」は示唆)、Veo 3 のモデルカード(潜在拡散、TPU・JAX、MovieGenBench の人手比較は開発元の記述、複雑な動きの一貫性の限界、ディープフェイクと SynthID)、Gemini API の動画生成ページ(Gemini Omni Flash と Veo 3.1、最終更新 2026年6月30日) | 出典21 https://openai.com/index/video-generation-models-as-world-simulators/ 出典22 https://storage.googleapis.com/deepmind-media/Model-Cards/Veo-3-Model-Card.pdf 出典23 https://ai.google.dev/gemini-api/docs/video | 事実 |
| パイプライン型の遅延・情報損失・話者交代の問題、Moshi(全二重、理論遅延160 ms・実測200 ms、2本のストリーム)、GPT-4o の音声応答時間(最短232 ms・平均320 ms) | 出典25 https://arxiv.org/abs/2410.00037 出典24 https://arxiv.org/abs/2410.21276 | 事実 |
| FID(Inception-v3 特徴の分布の距離)、Inception Score(50,000標本程度を推奨)、CMMD と FID の問題点、CLIPScore(参照文なし、文脈知識が要る場合に弱い)、GenEval、HEIM(12観点・62場面・26モデル)、FVD、VBench(16次元)、Chatbot Arena(二つの出力の比較投票) | 出典28 https://arxiv.org/abs/1706.08500 出典29 https://arxiv.org/abs/1606.03498 出典30 https://arxiv.org/abs/2401.09603 出典31 https://arxiv.org/abs/2104.08718 出典32 https://arxiv.org/abs/2310.11513 出典33 https://arxiv.org/abs/2311.04287 出典34 https://arxiv.org/abs/1812.01717 出典35 https://arxiv.org/abs/2311.17982 出典39 https://arxiv.org/abs/2403.04132 | 事実 |
| ITU-R BS.1534-3(2015年10月、MUSHRA)、ISO/IEC 42001:2023、23894:2023、22989:2022、TS 4213:2022(分類性能の評価)、25059:2023、NIST AI 100-1(2023年1月)、NIST AI 600-1(2024年7月、12のリスク、自主的な枠組み)。ISO の番号・題名・版・発行時期は公式ページの記載、本文は未確認 | 出典40 https://www.itu.int/dms_pubrec/itu-r/rec/bs/R-REC-BS.1534-3-201510-I!!PDF-E.pdf 出典41 https://www.iso.org/standard/81230.html 出典42 https://www.iso.org/standard/77304.html 出典43 https://www.iso.org/standard/74296.html 出典44 https://www.iso.org/standard/79799.html 出典45 https://www.iso.org/standard/80655.html 出典47 https://doi.org/10.6028/NIST.AI.100-1 出典46 https://doi.org/10.6028/NIST.AI.600-1 | 事実 |
| NIST AI 600-1 の12のリスク分類と「情報の完全性」の定義、環境への影響の項目、Veo 3 のカードのディープフェイクと SynthID に関する記述(開発元の自己評価) | 出典46 https://doi.org/10.6028/NIST.AI.600-1 出典22 https://storage.googleapis.com/deepmind-media/Model-Cards/Veo-3-Model-Card.pdf | 事実 |
| 各社の最新モデルと最新の評価値、独立した第三者による再現、ISO/IEC の規格本文、動画生成モデルの内部規模・必要メモリ、画像・動画向けの対戦型順位表の個別内容、顕微鏡像での視覚言語モデルの性能 | 本稿の調査範囲でアクセスできた一次情報では確認できなかったため記載していない | 解説 |
| 「顕微鏡像は『数える・測る』と『分類の下書き』を分ける」「生成AIの高画質・長尺は計算量とメモリで支えられる」「それらしい画像は物理的に正しい画像ではない」「FID は専門画像に適用できるとは限らない(推測)」「遅延の数字を並べて優劣をつけない」という読み取りと、表の整理(第3章・第9章) | 公表内容にもとづく本記事の整理・解説。各社・各機関が表明した見解ではない | 解説 |
| 図2〜図6が説明のための作図(実測データではない)であること。図1と図7がAI生成イメージの枠であること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(arXiv の論文、開発元のモデルカード・システムカード・技術報告、NIST・ISO・ITU の公式ページ)に限定しています。ISO/IEC の規格本文は有料のため確認できていません。 読み取りや整理を含むため、それらは「解説」として出典付きの事実と区別しています。 各社の最新モデルと最新の評価値、独立した第三者による再現、規格の本文、動画モデルの内部規模については、確認できなかったため記載していません。 評価値は公表時点・指定の設定のもので、モデルの優劣を示すものではありません。 図2〜図6はベクター作図で、図1と図7はAI生成イメージの枠です(いずれも実際の測定結果や製品の実物を示すものではありません)。