TECHNOLOGY EXPLAINER
AIアクセラレータ
― GPU・TPU・NPUの設計の違いと、「ピーク性能」と「実効性能」の読み方
AIの計算の大半は、巨大な行列の掛け算です。それを速く、少ない電力で行うために作られたのがAIアクセラレータです。ただし、カタログの「○○ PFLOPS」は、どの精度で、疎性(スパース)を使った値か、ピーク値かによって意味がまったく変わります。さらに、現在の大規模言語モデルの推論では、演算器の速さよりメモリ帯域が速度を決めることが多くあります。 この記事では、GPU・TPU・NPU・カスタムチップ・ウェハスケールの設計の違い、演算精度(FP16・FP8・FP4)、メモリ階層とHBM、メモリ帯域が律速になる理由(ルーフライン)、ピーク性能と実効性能の違い、そして素材技術者から見たパッケージ・熱・冷却との接点を、公式資料で確認できた範囲で整理します。
- AIアクセラレータとは何か(3行でつかむ)
- 設計の違い ― GPU・TPU・NPU・カスタムチップ・ウェハスケール
- 演算精度 ― FP32からFP16・FP8・FP4へ
- メモリ階層とHBM
- メモリ帯域がボトルネックになる理由 ― ルーフライン
- ピーク性能と実効性能 ― 仕様表とMLPerfの読み方
- 素材技術者の視点:パッケージ・熱・冷却
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公式の資料・論文・規格ページに記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予告・策定中で、実績や確定した仕様が確認できていない事項
このほか、読み取りは「解説」として区別しています。推測は太字で示します。
チップの仕様はメーカー公称の値で、精度・疎性の有無・ピーク値か実効値か・出荷の状況が、値ごとに異なります。本記事は、条件を添えて載せ、異なる条件の数値を並べて優劣をつけません。「出荷中」か「予告・プレビュー」かは、公式資料と MLCommons の区分で確認できた範囲で書きます。HBM、CoWoS、チップレットなどの個別の技術は、本シリーズの別編で詳しく扱います。
1. AIアクセラレータとは何か(3行でつかむ)
- 行列演算を大量に行う専用の演算器と、それにデータを届けるメモリの組:AIアクセラレータは、行列の掛け算(Tensor Core のような専用ユニット)を並べ、近くに高速なメモリ(HBM など)を置いたチップです。NVIDIA は Rubin GPU について、224個のストリーミングマルチプロセッサ、896個の Tensor Core、288 GBのHBM4を持つと説明します事実[参考資料1]
- 設計の系統は複数ある:GPU、TPU、端末向けの NPU、クラウド事業者のカスタムチップ、ウェハ全体を1つのチップにするもの、など。何を中心に作るかが違います(第2章)
- 「ピーク」と「実効」は別:仕様表のピーク性能は、演算器が全部動いた場合の上限です。実際の速さは、メモリ帯域、通信、ソフトウェアで決まります(第5・6章)
仕様表の数字は、「精度」「疎性」「ピークか実効か」の3つの条件を読んで初めて意味を持ちます。同じチップでも、どの値を選ぶかで「演算の速さ」が数倍に見え、メモリ帯域が足りなければ、その速さは出ません。
2. 設計の違い ― GPU・TPU・NPU・カスタムチップ・ウェハスケール
| 系統 | 設計の中心(公式資料の記述) | 読むときの注意 |
|---|---|---|
| GPU | NVIDIA は Rubin GPU を、演算ダイ2個(レチクル限界の大きさ)を高速のダイ間リンクで1つのパッケージにまとめたものと説明します。224個の SM、896個の Tensor Core、大きな中央の L2 キャッシュ、HBM4 を備える[参考資料1] | 汎用の並列計算に由来し、ソフトウェアの蓄積が厚い。AI専用の機能(Tensor Core、精度の切り替え)が年々増える |
| TPU | Google の初代 TPU の論文は、65,536個の8ビット積和器を持つ行列演算ユニット(ピーク92 TOPS)と28 MiB のソフトウェア管理のオンチップメモリを持つ ASIC で、決定的な実行モデルが応答時間の要件に合う、と述べます[参考資料3]。TPU7x(Ironwood)は1チップに2つの TensorCore と4つの SparseCore を持つ[参考資料2]。TPU v4 の論文は、SparseCore が埋め込みを使うモデルを5〜7倍速くしながら、ダイ面積と電力の5%しか使わないと述べる[参考資料21] | 行列演算に特化し、オンチップメモリの管理をソフトウェアに任せる設計。クラウドで使う前提で、フレームワークは JAX と PyTorch(TensorFlow は非対応)と同社の資料に記載[参考資料2] |
| NPU | 端末の SoC に載る、AI処理用のチップ。Microsoft は Copilot+ PC を、毎秒40兆回(TOPS)を超える演算ができる NPU を備える Windows 11 機の新しい区分と説明します[参考資料4] | 電力の小さい端末が前提で、データセンター用とは桁も用途も違う。端末AIは本シリーズ『エッジAIとオンデバイスAI』編で扱う |
| カスタムチップ | AWS の Trainium3 は、4つの専用エンジン(Tensor、Vector、Scalar、GPSIMD)を持つ大きなコア8つと、HBM3e 144 GB、チップごとの帯域4.9 TB/s、HBM と演算器の間の2段のオンチップ SRAM、演算から物理的に分けた通信専用コアを持つ、と説明されます[参考資料5] | クラウド事業者が自社の負荷に合わせて設計する。仕様は事業者が自社サービスで公開する範囲に限られる |
| ウェハスケール | Cerebras は WSE-3 Turbo を、46,225 mm²、4兆トランジスタ、900,000コア、250 PFLOPS のAI演算を持つチップと説明します。WSE-3 は44 GBのオンチップ SRAM と43.2 PB/s の帯域を持つとされます[参考資料6] | 欠陥を避けるのでなく、欠陥に耐える設計(冗長なコアと配線、不良を迂回する構造)で歩留まりに対応する、と同社は説明します |
すべて事実(メーカー・事業者の公称値と論文)。右の列のうち公式資料が述べていない部分は本記事の解説です。Cerebras の「19倍のトランジスタ、56倍の演算(NVIDIA B300 比)」という同社の比較は、比較の条件(精度・疎性)がページに書かれていないため、本記事では使いません。
GPU の Rubin は2個、TPU7x は2個のチップレット(それぞれ独立のメモリ空間を持つ)、AMD の MI455X は3次元の積層結合の演算ダイを使う、というように、1つのチップを大きく作る代わりに、複数のダイをパッケージの中で結ぶ方向が、複数の系統で共通して見られます[参考資料1・2・12]。詳しくは本シリーズ『チップレット』編『CoWoS』編『異種統合』編で扱います。
3. 演算精度 ― FP32からFP16・FP8・FP4へ
AIの計算は、数値の桁(ビット数)を減らしても、結果の質が大きく落ちない部分が多くあります。ビット数を減らすと、メモリから読むデータ量が減り、同じ面積に置ける演算器が増え、電力あたりの演算量が増えます。そのため、精度は世代ごとに下がってきました。
| 形式 | ビット構成(符号・指数・仮数) | 確認できたこと |
|---|---|---|
| FP32・FP16 | 1・8・23/1・5・10 | IEEE 754 の浮動小数点形式。FP16 は指数が5ビットで範囲が狭く、学習では、FP32 の重みの写しを持つことと損失のスケーリングという2つの工夫を Micikevicius らは提案した(メモリ消費をほぼ半分にできると報告)[参考資料8・20・24] |
| BF16(bfloat16) | 1・8・7 | 指数の範囲が FP32 と同じで、FP32 との変換が簡単。ハイパーパラメータの調整なしに収束させやすいと Kalamkar らは報告する。最大値 3.38e38[参考資料8] |
| FP8(E4M3、E5M2) | 1・4・3/1・5・2 | Micikevicius らの提案。E4M3 は重みと活性化、E5M2 は勾配に使うことを勧める。最大値は 448 と 57,344。最大175Bパラメータの言語モデルの学習で、16ビットと同等の結果品質を示したと報告[参考資料9] |
| FP4(E2M1)と微小スケーリング | 1・2・1。32要素(MX)または16要素(NVFP4)ごとに倍率を持つ | OCP の MX 仕様 v1.0 は MXFP8・MXFP6・MXFP4・MXINT8 を定める。MXFP4 は32要素ごとに8ビットの倍率(E8M0)で、1要素あたり4.25ビット(本稿の計算)[参考資料10・25]。NVFP4 は16要素ごとに E4M3 の倍率と、テンソル全体の FP32 の倍率を使う。NVIDIA は、120億パラメータのモデルを10兆トークンで学習した例を報告する[参考資料11] |
すべて事実(各論文と OCP の発表)。「微小スケーリング」の4.25ビットは本稿の計算です。
「精度」の次に読む:疎性(スパース)とピーク値
- 疎性(structured sparsity):行列のゼロを前提に、計算を減らす機能。NVIDIA の HGX の仕様表は、一部の値を「疎性の仕様」で示し、「密(dense)の値は、示した疎性の値の半分」と脚注に書きます[参考資料7]。AMD の MI355X のページは、密と、構造的疎性ありの値を別の行に分けて書きます(例:BF16 は 2.5 PFLOPS と 5 PFLOPS)[参考資料13]
- 同じ資料の中でも条件が混ざる:NVIDIA の Rubin の仕様では、NVFP4「推論」の50 PFLOPS は疎性の値、NVFP4「学習」の35 PFLOPS、FP8/FP6 の17.5 PFLOPS、FP16/BF16 の4 PFLOPS は密の値と脚注で区別されています[参考資料7]。見出しの数字だけを拾うと、疎性と密を取り違えます
- ピーク値:Google Cloud の TPU7x の表は「チップあたりのピーク演算」として BF16 2,307、FP8 4,614 TFLOPs を示しますが、疎性の条件は同じ表に書かれていません[参考資料2]。書かれていない条件は、確認できなかったと扱います
- 規格の動き:IEEE Std 754(浮動小数点演算の規格)は2019年版があり[参考資料24]、機械学習向けの狭いビット幅の形式を定める IEEE P3109 は、IEEE SA のページで「Active PAR(承認日 2023年2月15日)」と表示される策定中のプロジェクトです未確定/将来[参考資料26]
低い精度は、どのモデル・どの層でも安全とは限りません。FP4 の論文は、学習の安定・収束・実装に課題があるとし、無作為な回転、2次元の量子化、確率的な丸め、一部の層を高い精度に残す、といった工夫を組み合わせています[参考資料11]。精度を下げた結果の品質は、モデルとタスクごとに確かめる必要があります(本記事では特定モデルの品質を評価していません)。
4. メモリ階層とHBM
チップの中のデータは、近いほど速く、小さく、遠いほど遅く大きく置かれます。階層の例として、TPU7x の資料は、HBM(192 GB、約7.37 TB/s)、HBM より桁違いに帯域の高いオンチップ SRAM(VMEM、ソフトウェアで使う一時置き場)、ホスト側のメモリと PCIe、を挙げ、データをこの層の間で動かす管理が性能の鍵だと述べます事実[参考資料2]。
- HBM は「容量と帯域を同時に稼ぐ」層:Rubin は288 GBのHBM4で最大22 TB/s、HBM4はHBM3eに対してインタフェース幅が倍になる、と NVIDIA は説明します。NVIDIA は、容量はモデルの常駐・長い文脈・KVキャッシュのためのもの、帯域はトークンを1つずつ生成する段階のためのもの、と整理しています事実[参考資料1]。HBM の構造と規格(JEDEC の HBM4 は2025年4月、2,048本の配線で1スタックあたり最大2 TB/s)は、本シリーズ『HBM』編で扱います[参考資料27・28]
- SRAM は速いが小さい:Cerebras の WSE-3 は、44 GBのSRAM を43.2 PB/s で使うと説明します[参考資料6]。GPU の HBM 288 GB・22 TB/s と比べると、容量は約15%(約1/6.5、44÷288)、帯域は約2,000倍です(1 PB/s=1,000 TB/s として、43,200÷22。異なるチップの公称値の比較で、優劣を示すものではありません)本稿の計算
- データの移動を減らす工夫:FlashAttention は、GPU の HBM とオンチップ SRAM の間の読み書きの回数を数えて減らす(IO を意識した)厳密なアテンションのアルゴリズムで、HBM へのアクセスを減らすことで、BERT-large の学習で15%の高速化を示したと報告されています事実[参考資料19]。同じ計算でも、メモリの使い方で速さが変わる例です
5. メモリ帯域がボトルネックになる理由 ― ルーフライン
Gholami らは、過去20年で、サーバーのピーク演算性能は2年で3.0倍のペースで伸びた一方、DRAM の帯域は1.6倍、相互接続の帯域は1.4倍にとどまったと整理し、特にデコーダ型のTransformer(文章生成)で、メモリ帯域が主な律速になると述べています事実[参考資料17]。 この関係を図にしたのがルーフラインです。縦軸に到達できる演算性能、横軸に「読んだデータ1バイトあたり何回演算するか(演算強度)」をとると、左側はメモリの帯域が天井、右側は演算器のピークが天井になります[参考資料18]。
文章を1トークン生成するたびに、モデルの重みを読み出します。重みをBF16(1パラメータ2バイト)で読んで、1パラメータあたり2回の演算(掛け算と足し算)をするとき、演算強度は 2÷2=1 FLOP/byte で、バッチ(同時に処理する要求の数)が B なら、ほぼ B FLOP/byte になります(重みだけを数えた理想化)本稿の計算。
| 条件(TPU7xの公称値による例) | 到達できる上限(本稿の計算) | ピークに対する割合 |
|---|---|---|
| バッチ1(BF16、演算強度 1) | 7.4 TFLOPS | 0.3% |
| バッチ32(演算強度 32) | 236 TFLOPS | 10.2% |
| バッチ256(演算強度 256) | 1,889 TFLOPS | 81.9% |
| 折れ点(ridge) | BF16 約313、FP8 約625 FLOP/byte | ― |
すべて本稿の計算。Google Cloud が公表する TPU7x の値(BF16 2,307 TFLOPS、FP8 4,614 TFLOPS、HBM 7,380 GB/s)[参考資料2]から、ピーク÷帯域で折れ点を、帯域×演算強度で上限を求めました。KV キャッシュ・活性化・通信を含まない理想化で、実機の速度ではありません。
もう一つの見方:トークン生成の上限
仮に、重みが700億パラメータの密なモデルがあり、すべての重みをチップのHBMに載せて、バッチ1で生成するとします。1トークンごとに全重みを1回読むので、上限は「帯域÷重みの大きさ」です本稿の計算。TPU7x の帯域7.38 TB/s を使うと、
- BF16(重み140 GB):約52.7トークン/秒
- FP8(重み70 GB):約105トークン/秒
- 4ビット(重み35 GB、倍率を無視):約211トークン/秒
です。精度を下げると、読むバイト数が減るので、メモリが律速の領域の上限が精度に反比例して上がります(精度を下げた結果の品質は別に確認が要ります)。バッチを増やせば、同じ重みの読み出しを複数の要求で分け合うため、1チップの合計のトークン数は増えます。逆に、文脈が長く KV キャッシュが大きくなると、重み以外の読み出しも増え、上限は下がります(例示の仮定で、特定のモデル・実機の値ではありません)。推論の最適化は、本シリーズ『推論の最適化とサービング』編で扱います。
6. ピーク性能と実効性能 ― 仕様表とMLPerfの読み方
(1) 仕様表を、条件つきで読む
次の表は、メーカー・事業者の公式ページに載る値を、条件を添えて転記したものです。条件の違う値が並んでいるため、行どうしや列どうしの優劣を読み取ってはいけません。
| チップ(状態) | 演算のピーク(公称。精度と疎密の別) | メモリ(容量・帯域) | 電力 | この行の読み方 |
|---|---|---|---|---|
| NVIDIA H100 SXM(Hopper。製品ページに掲載)[参考資料14] | BF16 1,979 TFLOPS、FP8 3,958 TFLOPS(いずれも疎性ありの値、ページに「With sparsity」の注記) | 80 GB(HBM3)、3.35 TB/s | TDP は最大700 W(設定可) | 密の値はページに書かれていない。ページの精度の一覧に FP4 はない |
| NVIDIA B200(Blackwell。HGX B200 は「出荷中」と同社ページに記載)[参考資料7・16] | 公表は8GPUの合計:FP16/BF16 36 PFLOPS、FP8/FP6 72 PFLOPS(いずれも疎性の値、密は半分)、FP4 144(疎)|72(密)PFLOPS。1GPUあたり(÷8)は BF16 4.5(疎)/2.25(密)、FP8 9/4.5、FP4 18/9 PFLOPS本稿の計算 | DGX B200 は8GPUで合計1,440 GB、64 TB/s(1GPUあたり180 GB、8 TB/s本稿の計算)。GB200 NVL72 のページは2GPUあたり372 GB、16 TB/s[参考資料15] | DGX B200 のシステム全体で最大約14.3 kW(空冷。CPU等を含む) | GPU1個の TDP は確認できなかった。システム電力の÷8は GPU単体の電力ではない |
| NVIDIA Rubin(HGX Rubin NVL8。MLPerf Inference v6.1 では「プレビュー」区分)[参考資料7・23] | 1GPUあたり:NVFP4 推論 50 PFLOPS(疎)、NVFP4 学習 35、FP8/FP6 学習 17.5、FP16/BF16 4 PFLOPS(いずれも密) | 288 GB(HBM4)、22 TB/s | GPU単体の電力は確認できなかった。入口の液温は45 ℃(HGX ページ) | 同じ表の中で、推論は疎、学習は密の値。予告・プレビューの段階の値で、出荷の状況は確認できなかった未確定/将来 |
| AMD Instinct MI355X(CDNA 4。ページの発売日は2025年6月12日)[参考資料13] | BF16 2.5(密)/5(構造的疎性)、FP8 5(密)/10.1(疎性)、MXFP4 10.1 PFLOPS(疎性の区別の記載なし) | 288 GB(HBM3E)、8 TB/s | TBP 1,400 W | MXFP4 の値の疎密は、同ページに書かれていない |
| Google TPU7x(Ironwood。Google Cloud の資料に掲載)[参考資料2] | チップあたりのピーク:BF16 2,307、FP8 4,614 TFLOPs(疎性の条件の記載なし) | 192 GiB(HBM)、7,380 GB/s。チップ間 1,200 GB/s(双方向) | 記載なし | 1ポッドは9,216チップ。クラウドで使う前提で、チップ単体の販売ではない |
| AWS Trainium3(UltraServer として提供と同社ページに記載)[参考資料5] | UltraServer(144チップ)で MXFP8 362 PFLOPs。1チップあたりでは約2.5 PFLOPS本稿の計算(疎性の記載なし) | 1チップあたり144 GB(HBM3e)、4.9 TB/s | 記載なし | チップ単体の演算ピークの公表は確認できなかった |
| Cerebras WSE-3 Turbo(同社ページ)[参考資料6] | 250 PFLOPS(精度・疎性の記載なし) | WSE-3:オンチップSRAM 44 GB、43.2 PB/s | 記載なし | 同社の「他社比○倍」は条件の記載がなく使えない |
すべて事実(メーカー・事業者の公称値)。本稿の計算と記した値(÷8、÷144)は、システム全体の値を個数で割った概算です。TDP(熱設計電力)、TBP(標準的なボード電力)、システム電力は同じ量ではありません。
この表から分かるのは、「何をピークと呼ぶか」が会社と製品で違うことです。疎性ありの値だけを出すもの、密と疎を分けるもの、推論は疎・学習は密と使い分けるもの、条件を書かないもの。本記事は、条件が書かれていない値を「確認できなかった」と扱い、行どうしの比較をしません。
NVIDIA の H100 のページは、第三者の SemiAnalysis の InferenceX(2026年4月時点)にもとづき、H100 の推論は100万トークンあたり約0.09ドル(GPT-OSS-120B、vLLM、1ユーザーあたり66 TPS)、B200 は約0.02ドル(同じモデル、TensorRT-LLM、1ユーザーあたり55 TPS)で、約4.5倍安いと書いています。ソフトウェア(vLLM と TensorRT-LLM)と1ユーザーあたりの速度が異なることがページ自身の記述から読み取れ、これはチップだけの差を示す比較ではありません事実[参考資料14]。メーカーのページに載る比較は、条件を確かめて読みます。
(2) 実効性能:MLPerf
ピークでなく実際に測った速さを、共通の課題で比べる取り組みが MLCommons の MLPerf です。2026年6月16日公表の MLPerf Training v6.0 では、24組織が95のシステム、13種類のアクセラレータで提出し、DeepSeek V3(総パラメータ671B、1トークンあたり活性37B)と GPT-OSS 20B(総21B、活性3.6B)の2つの課題が加わり、複数の FP4 の方式の提出があった、と発表されています事実[参考資料22]。2026年9月16日公表の MLPerf Inference v6.1 は、過去最多の30組織が参加し、最大で512個のアクセラレータの構成が提出され、RAG と端末のエージェント推論の課題が加わりました。同じ発表は、AMD Instinct MI350P などを「available」、NVIDIA の Rubin と Vera Rubin NVL72 を「preview」と区分しています事実[参考資料23]。
- 精度の基準を満たした提出だけが比べられる:MLPerf Training の発表は、提出が精度の閾値を満たす必要があるため、ハードウェアと実装の違いによる性能差を公平に比べられる、と説明します[参考資料22]
- 提出区分とシステム構成を読む:結果は、アクセラレータの種類、台数、ソフトウェア、「available(購入可能)」か「preview(次回までの提供見込み)」かで意味が変わります[参考資料23]。本記事は、提出区分のうち確認できた「available/preview」のみ記します(closed/open の部門の詳細は確認していません)
- バージョンをまたいだ比較に注意:Inference v6.1 の発表の見出しの改善率(DeepSeek-R1 は1年前の v5.1 比で5.7倍、VLM は v6.0 比で2.99倍)は、異なる版の最良の結果どうしの比較です。同じ構成の同じ条件の比較ではありません(本記事の注意。数値の出典は MLCommons の発表)[参考資料23]
- メーカー自身の比較との違い:NVIDIA は Rubin について「Blackwell に対して、エージェント推論のスループット/エネルギーが最大10倍」と述べますが、その測定は社内の2兆パラメータの MoE の負荷によるもので、条件は同社のものです[参考資料1]。MLPerf の提出結果とは別に読みます
7. 素材技術者の視点:パッケージ・熱・冷却
元のSVG模式図・数値・出典注記を見る
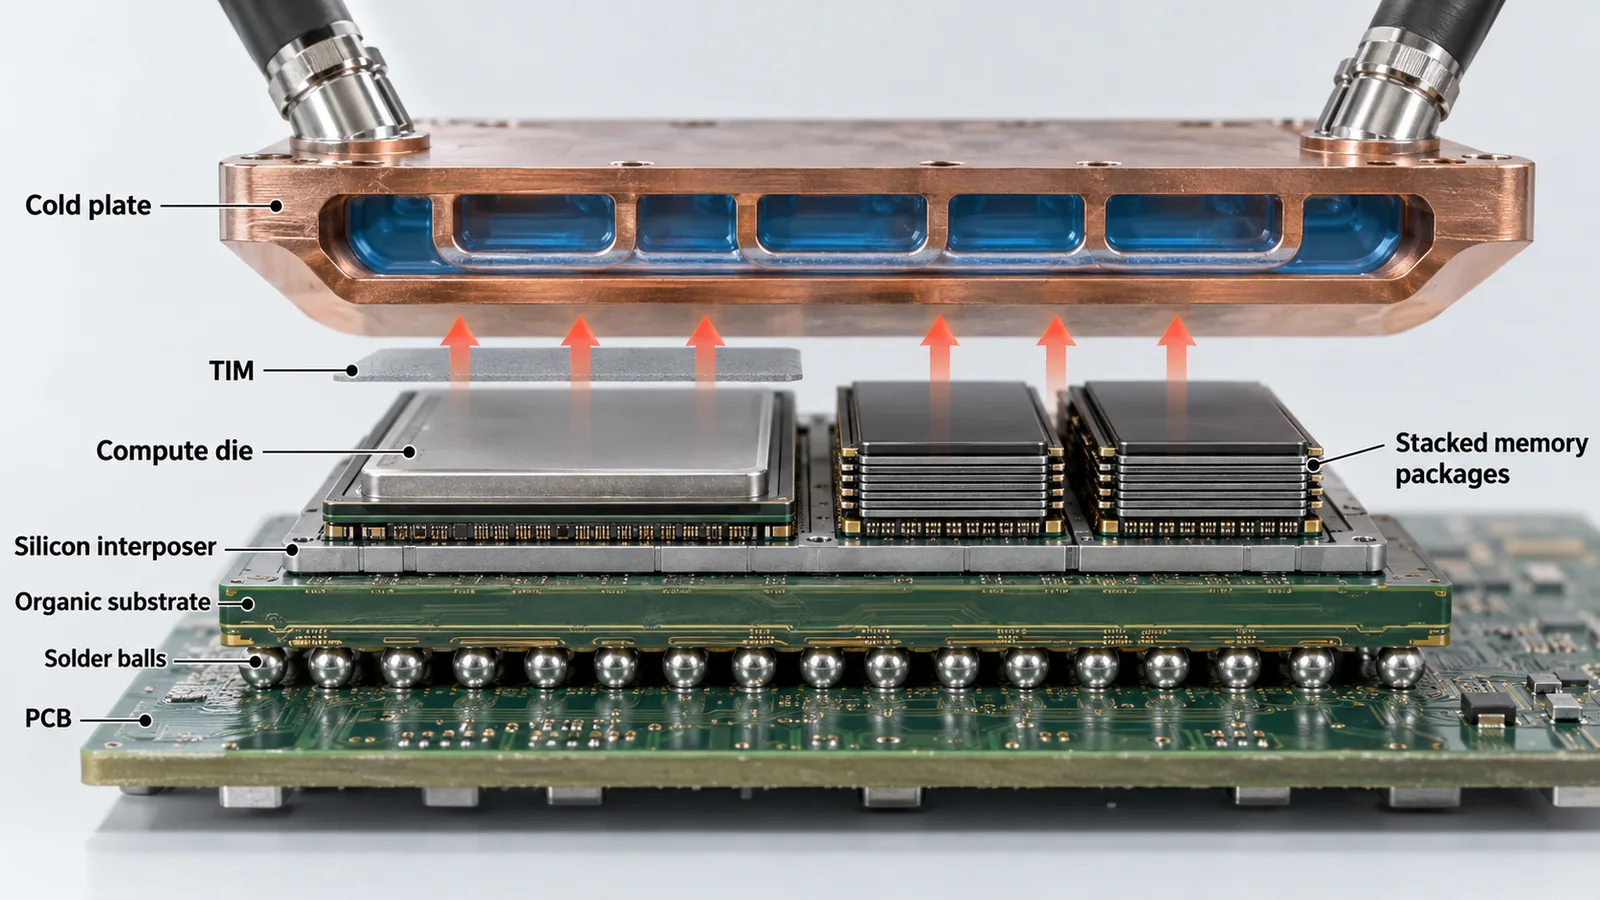
公称値を並べると、電力の水準が世代で大きく動いています。H100 SXM の TDP は最大700 W[参考資料14]、MI355X の TBP は1,400 W[参考資料13]で、2倍です本稿の計算(TDP と TBP は定義が違い、厳密な比較ではありません)。8GPUの空冷システム DGX B200 は最大約14.3 kW[参考資料16]で、GPU1個あたりの割り当ては約1.8 kW本稿の計算(CPU・ネットワーク・ファン等を含む上限)です。NVIDIA の Rubin のラック(Vera Rubin NVL72)は、入口の水温45 ℃の液冷を前提とすると説明されています[参考資料1・7]。
素材から見ると、これは、ダイからコールドプレートまでの熱の通り道(図6の層)の熱抵抗が、そのまま許される電力と動作温度を決めることを意味します。層ごとに材料の境目があり、熱界面材料(TIM)はダイとプレートの隙間を埋める層です。電力が上がるほど、TIM の熱抵抗と、温度サイクルによる劣化・はみ出し(ポンプアウト)などの信頼性が効いてきます(本記事による解説。具体的な材料の性能は本記事では評価しません)。TIM は本シリーズ『熱界面材料TIM』編、冷却を含むデータセンターは『AIデータセンターの電力と冷却』編で扱います。
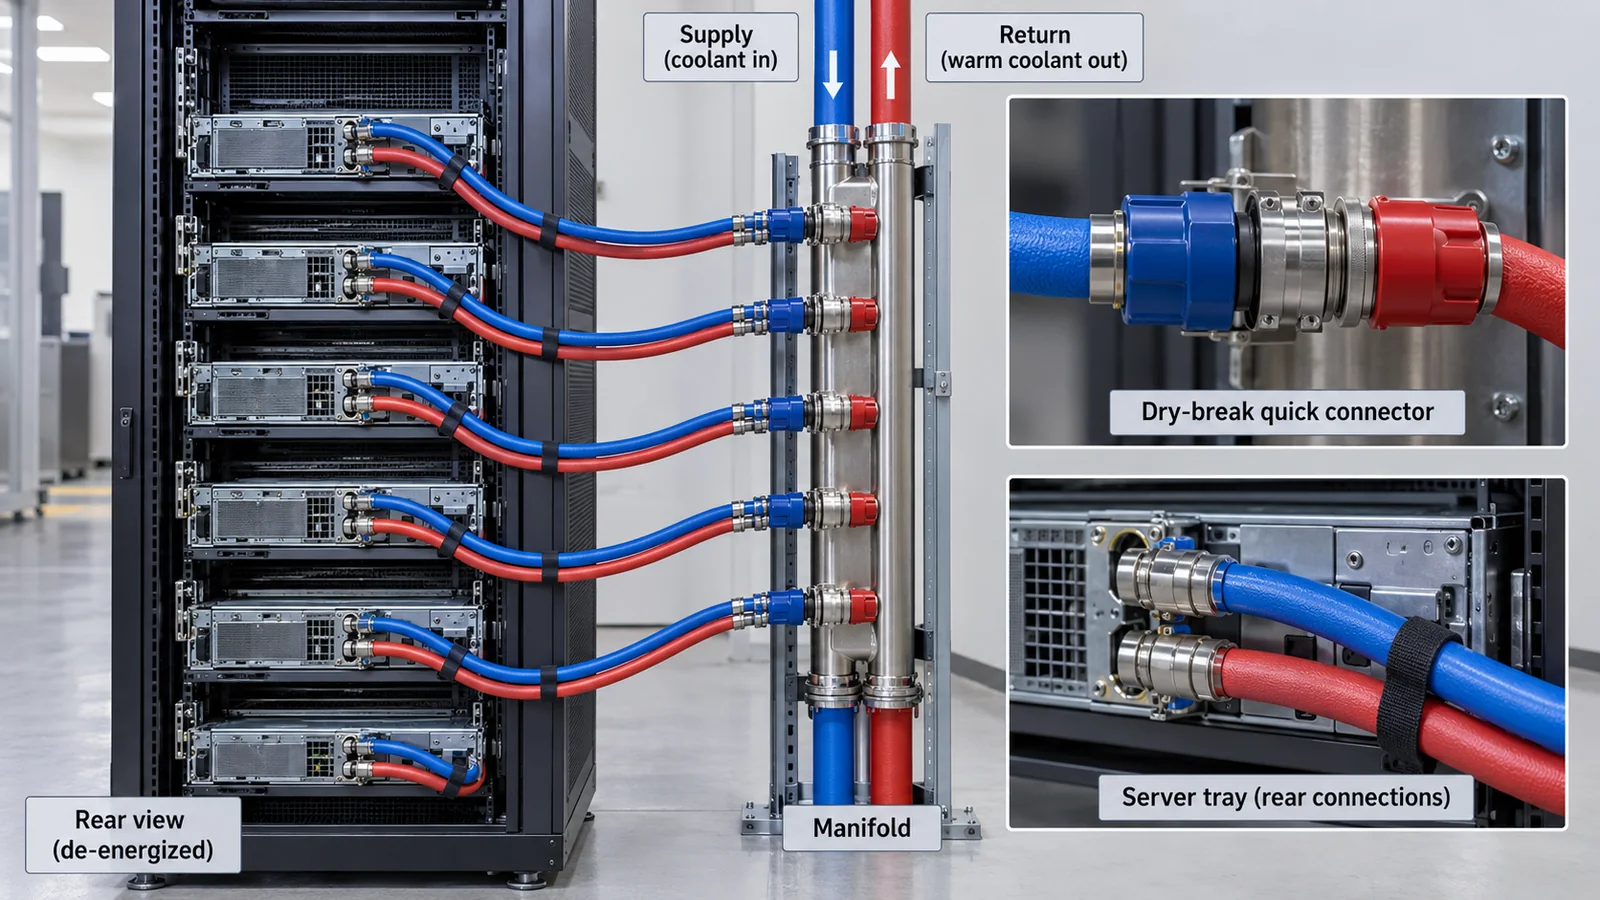
第2章のとおり、複数の系統が、1つの大きなダイでなく、複数のダイとHBMを1つのパッケージで結ぶ方向を取っています。Rubin は2個の演算ダイ[参考資料1]、TPU7x は2個のチップレット[参考資料2]、AMD の MI455X は3次元の積層結合の演算ダイと、12スタックのHBM4(432 GB、23.3 TB/s)を CoWoS-L のパッケージで結ぶと説明されます事実[参考資料12]。
これは、配線のための基板・インターポーザ、ダイの間の接合、メモリの積層、封止、熱を逃がす材料が、AIアクセラレータの性能の一部になる、ということです。層の数が増えるほど、材料の熱膨張の差による反り、接合部の信頼性、熱の通り道の抵抗が、設計の制約になります(本記事による解説。推測:どの材料がどの世代で律速になるかは、公開資料では確認できませんでした)。個別の技術は、本シリーズ『HBM』『CoWoS』『チップレット』『異種統合』の各編で扱います。
8. 限界と、確認できなかったこと
(1) 仕様の網羅
本記事は、確認日時点で公式ページに掲載された値の一部を転記したもので、全製品の網羅ではありません。ここにない製品が劣るという意味ではなく、製品間の優劣は論じていません。
(2) 条件の記載がない値
疎性・精度の条件が書かれていない値(TPU7x、Trainium3、Cerebras の一部)は、条件を推測せず「記載なし」としました。電力も、記載のない製品は確認できなかったと扱いました。
(3) 出荷・提供の状況
Rubin は、MLCommons が「preview」と区分した段階で、提供の状況は確認できませんでした。MI455X など予告の製品は、出荷の実績を確認していません。
(4) 実効性能
MLPerf の提出ごとの点数は、構成・ソフトウェア・版が異なり並べて比べられないため、掲載していません。ルーフラインの計算は、公称のピーク値からの理想化です。
(5) 素材レベルの評価
TIM・基板・インターポーザなどの材料の性能や、どの材料が律速かは、公式資料で確認できなかったため、評価していません。
(6) 規格の本文
IEEE 754、IEEE P3109、OCP の MX 仕様の本文は確認していません(題名・状態・提案の範囲のみ)。
- 設計の系統は複数ある:GPU、TPU、NPU、カスタムチップ、ウェハスケール。複数のダイをパッケージで結ぶ方向は共通して見られます事実
- 精度は FP32→FP16/BF16→FP8→FP4 と下がってきました。その際、疎性とブロックごとの倍率の扱いまで読む必要があります事実
- 文章生成はメモリ帯域が律速になりやすい。TPU7x の公称値で、バッチ1の上限はピークの約0.3%、折れ点はBF16で約313 FLOP/byte です本稿の計算
- 仕様表の数字は、精度・疎密・ピークか実効かの条件つきで読み、条件の違う数字を並べて優劣をつけません。MLPerf は精度の閾値つきの実測ですが、版・区分・構成を読みます事実
- 電力が上がるほど、熱を通す層の性能が性能になります。H100 の最大700 W から MI355X の1,400 W へ事実
9. 評価・標準の読み方
AIアクセラレータの性能は、①公称のピーク性能(精度・疎性の条件つき)、②共通の課題で測った実効性能(MLPerf)、③数値形式やメモリなどの規格への適合、④電力・冷却の条件に分けて評価されます。①は規格でなくメーカーの公称、②は MLCommons の結果、③は IEEE・OCP・JEDEC の規格が関わります。確認日(2026年10月15日)時点で、「ピーク性能の表記の仕方」を定めた確定の国際規格は確認できませんでした。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・出典) | 標準・指針(IEEE・OCP・JEDEC・ISO/IEC など) | 読み方の注意 |
|---|---|---|---|
| ピーク性能の表記 事実 | 各社の仕様表(NVIDIA、AMD、Google Cloud、AWS、Cerebras)[参考資料2・5〜7・13〜16] | 表記を定めた確定の国際規格は確認できなかった | 精度・疎密・ピークか実効か・チップかシステムかを、値ごとに確認する(第3・6章)。メーカー公称であり、第三者の測定ではない |
| 実効性能(学習・推論) 事実 | MLPerf Training v6.0(2026年6月16日)[参考資料22]。MLPerf Inference v6.1(2026年9月16日)[参考資料23]。いずれも MLCommons の公表 | MLPerf は業界団体 MLCommons のベンチマークで、ISO/IEC や IEEE の規格ではない | 精度の閾値を満たす提出のみ比較できる。提出区分(available/preview)、台数、ソフトウェア、版を読む。版をまたぐ改善率は同条件の比較ではない。結果はハードウェアの優劣の断定に使わない |
| 数値形式 事実未確定/将来 | FP8 形式の提案(arXiv 2209.05433)[参考資料9]。BF16 の研究(arXiv 1905.12322)[参考資料8]。MX 形式の評価(arXiv 2310.10537)[参考資料10]。NVFP4 の学習(arXiv 2509.25149)[参考資料11] | IEEE Std 754-2019「IEEE Standard for Floating-Point Arithmetic」[参考資料24]。OCP「Microscaling Formats (MX) Specification v1.0」(OCP の発表は2023年10月17日、MXFP8・MXFP6・MXFP4・MXINT8)[参考資料25]。IEEE P3109「Standard for Arithmetic Formats for Machine Learning」(Active PAR、承認日2023年2月15日、策定中)[参考資料26] | FP8(E4M3/E5M2)や NVFP4 の細部は、メーカーや提案者の仕様が先行しうる。IEEE P3109 は策定中で、確定した要求ではない。規格の本文は未確認 |
| メモリ(HBM) 事実 | メーカーの公称値(本記事ではNVIDIA・AMD・Google の値) | JEDEC の HBM4 規格 JESD270-4(2025年4月公表、2,048本の配線、1スタックあたり最大2 TB/s)。JESD270-4A(Version 1.1、2025年12月)[参考資料27・28] | JEDEC の規格値は互換性の基準で、製品の値が上回ることがある。HBM の詳細は本シリーズ『HBM』編 |
| 電力・冷却 事実 | TDP・TBP・システム電力の公称値[参考資料13・14・16]。NVIDIA は Rubin のラックの液冷を、入口の水温45 ℃と説明[参考資料1・7] | 電力の表記や液冷の条件を定めた確定の国際規格は、本記事では確認できなかった | TDP、TBP、システムの最大電力は別の量。ラック・データセンターの電力と冷却は本シリーズ『AIデータセンターの電力と冷却』編 |
表の整理は本稿の計算(本記事による編集)。規格の本文は未確認のため、要求事項の中身は書いていません。
読み方の注意
- ベンチマークの数値は、設定と実施主体で変わります。MLPerf の結果は、構成・ソフトウェア・版・提出区分とセットの値です。メーカー自身の「○倍」は、同社が選んだ負荷と条件の値で、MLPerf の提出結果と別に読みます
- 飽和と汚染に注意します。MLPerf は課題を更新して(今回の版では MoE モデルや RAG・エージェントの課題が加わった)、時代の負荷に合わせています[参考資料22・23]。古い課題の結果は、最新の負荷を表さないことがあります
- 「規格」と「業界団体の仕様」と「メーカー公称」は別です。IEEE 754 は規格、OCP MX は業界団体の仕様、IEEE P3109 は策定中、MLPerf は業界団体のベンチマーク、仕様表はメーカー公称です。どれも、それ自体が法令ではありません
- 宣言値と実測値の違い。ピークの PFLOPS は、全部の演算器が動き、データが間に合う場合の上限です。実際の速さは、メモリ帯域、通信、ソフトウェアで決まります(第5章)
10. 用語集
- GPU/TPU/NPU
- 汎用の並列演算に由来するチップ/Google の行列演算特化チップ/端末向けのAI演算器。
- Tensor Core
- NVIDIA の GPU にある、行列の積和を行う専用ユニット。
- FP8/FP4
- 8ビット/4ビットの浮動小数点。指数と仮数のビット数で E4M3 などと表す。
- BF16
- 指数の範囲が FP32 と同じ16ビット形式。
- 微小スケーリング(MX、NVFP4)
- 要素のブロックごとに倍率を持つことで、狭いビット幅でも範囲を保つ方式。
- 疎性(sparsity)
- ゼロが多い行列の計算を省く機能。密の値は疎性の値の半分とされることが多い。
- ピーク性能/実効性能
- 演算器が全部動く場合の上限/実際に測った速さ。
- HBM
- DRAM を縦に積んでチップの隣に置く広帯域メモリ。
- SRAM/KVキャッシュ
- チップ内の高速で小さいメモリ/文章生成中に溜まる過去の注意の記録。
- ルーフライン
- 演算強度と到達できる性能の関係を示す図。メモリの天井と演算の天井がある。
- 演算強度
- 読んだデータ1バイトあたりの演算回数(FLOP/byte)。
- TDP/TBP
- 熱設計電力/標準的なボード電力。定義はメーカーで違う。
- MLPerf
- MLCommons による共通課題のベンチマーク。精度の閾値つき。
- TOPS/FLOPS
- 毎秒の演算回数(整数/浮動小数点)。
11. 参考資料(一次情報)
- NVIDIA "Inside NVIDIA Rubin GPU Architecture: Powering the Era of Agentic AI", NVIDIA Technical Blog (2026年7月21日) — developer.nvidia.com/blog/inside-nvidia-rubin-gpu-architecture-powering-the-era-of-agentic-ai/
- Google Cloud "TPU7x (Ironwood)", Cloud TPU documentation — docs.cloud.google.com/tpu/docs/tpu7x
- Jouppi N. P. ほか "In-Datacenter Performance Analysis of a Tensor Processing Unit", arXiv:1704.04760 — arxiv.org/abs/1704.04760
- Microsoft "Copilot+ PCs developer guide" (Microsoft Learn) — learn.microsoft.com/en-us/windows/ai/npu-devices/
- AWS "AI Accelerator - AWS Trainium" — aws.amazon.com/ai/machine-learning/trainium/
- Cerebras "Cerebras WSE-3 Turbo | Wafer-Scale AI Chip" — www.cerebras.ai/chip
- NVIDIA "NVIDIA HGX Platform" (specifications of HGX Rubin NVL8, B300 and B200) — www.nvidia.com/en-us/data-center/hgx/
- Kalamkar D. ほか "A Study of BFLOAT16 for Deep Learning Training", arXiv:1905.12322 — arxiv.org/abs/1905.12322
- Micikevicius P. ほか "FP8 Formats for Deep Learning", arXiv:2209.05433 — arxiv.org/abs/2209.05433
- Rouhani B. D. ほか "Microscaling Data Formats for Deep Learning", arXiv:2310.10537 — arxiv.org/abs/2310.10537
- NVIDIA ほか "Pretraining Large Language Models with NVFP4", arXiv:2509.25149 — arxiv.org/abs/2509.25149
- AMD "AMD Instinct MI400 Series GPUs" — www.amd.com/en/products/accelerators/instinct/mi400.html
- AMD "AMD Instinct MI355X GPUs" — www.amd.com/en/products/accelerators/instinct/mi350/mi355x.html
- NVIDIA "H100 GPU" — www.nvidia.com/en-us/data-center/h100/
- NVIDIA "GB200 NVL72" — www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA "DGX B200: The Foundation for Your AI Factory" — www.nvidia.com/en-us/data-center/dgx-b200/
- Gholami A. ほか "AI and Memory Wall", arXiv:2403.14123 — arxiv.org/abs/2403.14123
- Williams S. ほか "Roofline: An Insightful Visual Performance Model for Multicore Architectures", Commun. ACM 52(4), 65-76 (2009), DOI 10.1145/1498765.1498785 — doi.org/10.1145/1498765.1498785
- Dao T. ほか "FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness", arXiv:2205.14135 — arxiv.org/abs/2205.14135
- Micikevicius P. ほか "Mixed Precision Training", arXiv:1710.03740 — arxiv.org/abs/1710.03740
- Jouppi N. P. ほか "TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings", arXiv:2304.01433 — arxiv.org/abs/2304.01433
- MLCommons "MLCommons Releases MLPerf Training v6.0 Results" (2026年6月16日) — mlcommons.org/2026/06/mlperf-training-v6-0-results/
- MLCommons "MLCommons Sets Participation Record with New MLPerf Inference v6.1 Benchmark Results" (2026年9月16日) — mlcommons.org/2026/09/mlperf-inference-v6-1-results/
- IEEE "IEEE Standard for Floating-Point Arithmetic" (IEEE Std 754-2019) — doi.org/10.1109/IEEESTD.2019.8766229
- Open Compute Project "AMD, Arm, Intel, Meta, Microsoft, NVIDIA, and Qualcomm Standardize Next-Generation Narrow Precision Data Formats for AI" (OCP Microscaling Formats (MX) Specification v1.0) (2023年10月17日) — opencompute.org/news/…narrow-precision-data-formats-for-ai/
- IEEE SA "Standard for Arithmetic Formats for Machine Learning" (P3109) (Active PAR、承認日 2023-02-15) — standards.ieee.org/ieee/3109/11165/
- JEDEC "JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard" (2025年4月) — jedec.org/news/pressreleases/…jesd270-4-hbm4-standard-advancing
- JEDEC "High Bandwidth Memory (HBM4) DRAM", JESD270-4A (Version 1.1、2025年12月) — www.jedec.org/standards-documents/docs/jesd270-4a
12. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| Rubin GPU の構成(336B トランジスタ、224 SM、896 Tensor Core、2個のレチクル限界のダイ、HBM4 288 GB・22 TB/s、NVLink 6 の 3.6 TB/s、NVLink-C2C 1.8 TB/s、PCIe Gen6 x16 の 256 GB/s、45 ℃の液冷、容量と帯域の役割の整理、最大10倍の主張が社内の2兆パラメータ MoE の負荷によること) | NVIDIA の技術ブログ(2026年7月21日) 出典1 https://developer.nvidia.com/blog/inside-nvidia-rubin-gpu-architecture-powering-the-era-of-agentic-ai/ | 事実 |
| TPU7x(BF16 2,307・FP8 4,614 TFLOPs、HBM 192 GiB・7,380 GB/s、ICI 1,200 GB/s、1ポッド9,216チップ、2 TensorCore・4 SparseCore、2チップレット、メモリ階層、JAX と PyTorch に対応)、初代 TPU(65,536個の8ビット積和器、92 TOPS、28 MiB)、TPU v4 の SparseCore | Google Cloud の資料と TPU の論文 出典2 https://docs.cloud.google.com/tpu/docs/tpu7x 出典3 https://arxiv.org/abs/1704.04760 出典21 https://arxiv.org/abs/2304.01433 | 事実 |
| Copilot+ PC の NPU の要件(40 TOPS 超)、Trainium3 の構成(8コア、144 GB HBM3e、4.9 TB/s、UltraServer 144チップで362 MXFP8 PFLOPs、20.7 TB、706 TB/s)、Cerebras WSE-3 Turbo(46,225 mm²、4兆トランジスタ、900,000コア、250 PFLOPS)と WSE-3 のSRAM 44 GB・43.2 PB/s、欠陥に耐える設計 | Microsoft・AWS・Cerebras の公式ページ 出典4 https://learn.microsoft.com/en-us/windows/ai/npu-devices/ 出典5 https://aws.amazon.com/ai/machine-learning/trainium/ 出典6 https://www.cerebras.ai/chip | 事実 |
| HGX B300/B200 の仕様(FP4 疎|密、FP8/FP16 は疎の値で密は半分、総メモリ、NVLink)、HGX Rubin NVL8 の1GPUあたりの仕様(NVFP4 推論50 PFLOPS[疎]、学習35、FP8/FP6 17.5、BF16 4 PFLOPS[密]、288 GB・22 TB/s、入口温度45 ℃)、HGX B200 が出荷中との記載 | NVIDIA の HGX ページ 出典7 https://www.nvidia.com/en-us/data-center/hgx/ | 事実 |
| H100 SXM の仕様(BF16 1,979・FP8 3,958 TFLOPS は疎性ありの値、80 GB、3.35 TB/s、TDP 最大700 W、NVLink 900 GB/s)、およびコストの比較(ソフトウェアと1ユーザーあたりの速度が異なる記述) | NVIDIA の H100 ページ 出典14 https://www.nvidia.com/en-us/data-center/h100/ | 事実 |
| GB200 NVL72 のメモリ(2GPUあたり372 GB・16 TB/s)、DGX B200(8GPUで1,440 GB・64 TB/s、最大約14.3 kW) | NVIDIA の製品ページ 出典15 https://www.nvidia.com/en-us/data-center/gb200-nvl72/ 出典16 https://www.nvidia.com/en-us/data-center/dgx-b200/ | 事実 |
| MI355X の仕様(BF16 2.5/5、FP8 5/10.1、MXFP4 10.1 PFLOPS、288 GB HBM3E、8 TB/s、TBP 1,400 W、発売日2025年6月12日)、MI455X(432 GB の HBM4、23.3 TB/s、12スタック、CoWoS-L、3次元の積層結合の演算ダイ) | AMD の製品ページ 出典12 https://www.amd.com/en/products/accelerators/instinct/mi400.html 出典13 https://www.amd.com/en/products/accelerators/instinct/mi350/mi355x.html | 事実 |
| 数値形式のビット構成と最大値(FP32 1・8・23、FP16 1・5・10、BF16 1・8・7、FP8 E4M3 最大448・E5M2 最大57,344、FP4 E2M1 の表せる値)、混合精度の学習(FP32の重みの写しと損失のスケーリング) | 各論文 出典8 https://arxiv.org/abs/1905.12322 出典9 https://arxiv.org/abs/2209.05433 出典11 https://arxiv.org/abs/2509.25149 出典20 https://arxiv.org/abs/1710.03740 | 事実 |
| MX 形式(ブロック32、E8M0 の倍率、MXFP8・MXFP6・MXFP4・MXINT8)、NVFP4(16要素のブロック、E4M3 の倍率、テンソル全体の FP32 の倍率、120億パラメータを10兆トークンで学習)、IEEE Std 754-2019 の題名、OCP MX 仕様 v1.0 の発表日、IEEE P3109 の状態 | 論文、IEEE・OCP のページ 出典10 https://arxiv.org/abs/2310.10537 出典11 https://arxiv.org/abs/2509.25149 出典24 https://doi.org/10.1109/IEEESTD.2019.8766229 出典25 http://www.opencompute.org/news/amd-arm-intel-meta-microsoft-nvidia-and-qualcomm-standardize-next-generation-narrow-precision-data-formats-for-ai/ 出典26 https://standards.ieee.org/ieee/3109/11165/ | 事実 |
| メモリの壁(20年でピーク演算は2年で3.0倍、DRAM 帯域は1.6倍、相互接続は1.4倍)、ルーフラインの考え方、FlashAttention(HBM と SRAM の読み書きを減らす、BERT-large で15%の高速化) | 各論文 出典17 https://arxiv.org/abs/2403.14123 出典18 https://doi.org/10.1145/1498765.1498785 出典19 https://arxiv.org/abs/2205.14135 | 事実 |
| MLPerf Training v6.0(2026年6月16日、24組織・95システム・13種類のアクセラレータ、DeepSeek V3 と GPT-OSS 20B の追加、FP4 の複数の方式、精度の閾値)、MLPerf Inference v6.1(2026年9月16日、30組織、最大512アクセラレータ、RAG と Edge Agentic の追加、available と preview の区分) | MLCommons の発表 出典22 https://mlcommons.org/2026/06/mlperf-training-v6-0-results/ 出典23 https://mlcommons.org/2026/09/mlperf-inference-v6-1-results/ | 事実 |
| HBM4 の JEDEC 規格(JESD270-4、2025年4月、2,048本、最大2 TB/s)と JESD270-4A(Version 1.1、2025年12月) | JEDEC のページ 出典27 https://www.jedec.org/news/pressreleases/jedec%C2%AE-and-industry-leaders-collaborate-release-jesd270-4-hbm4-standard-advancing 出典28 https://www.jedec.org/standards-documents/docs/jesd270-4a | 事実 |
| TDP・TBP・システム電力の水準の比較(H100 の700 W に対し MI355X は1,400 W で2倍、DGX B200 の約14.3 kW÷8=約1.8 kW)、ルーフラインの数値(折れ点 約313・約625、バッチ別の上限 7.4・236・1,889 TFLOPS)、トークン生成の上限(52.7・105・211 トークン/秒)、43,200÷22、44÷288、MXFP4 の4.25ビット、GPUあたりへの換算(÷8、÷144) | 本稿の計算。公称値からの理想化で、重みだけを数え、KV キャッシュ・通信は含まない。TDP と TBP は定義が違う | 本稿の計算 |
| チップ間の優劣、条件の記載のない値、出荷の実績、素材レベルの評価、MLPerf の提出ごとの点数、規格の本文 | 本稿の調査範囲では確認していない、または優劣の断定を避けるため記載していない | 解説 |
| 「電力が上がるほど熱を通す層の性能が性能になる」「複数のダイとメモリを材料で結ぶ」という読み取り、TIM の信頼性の指摘、設計の系統の分類、図の整理 | 公表内容にもとづく本記事の整理・解説。各社が表明した見解ではない | 解説 |
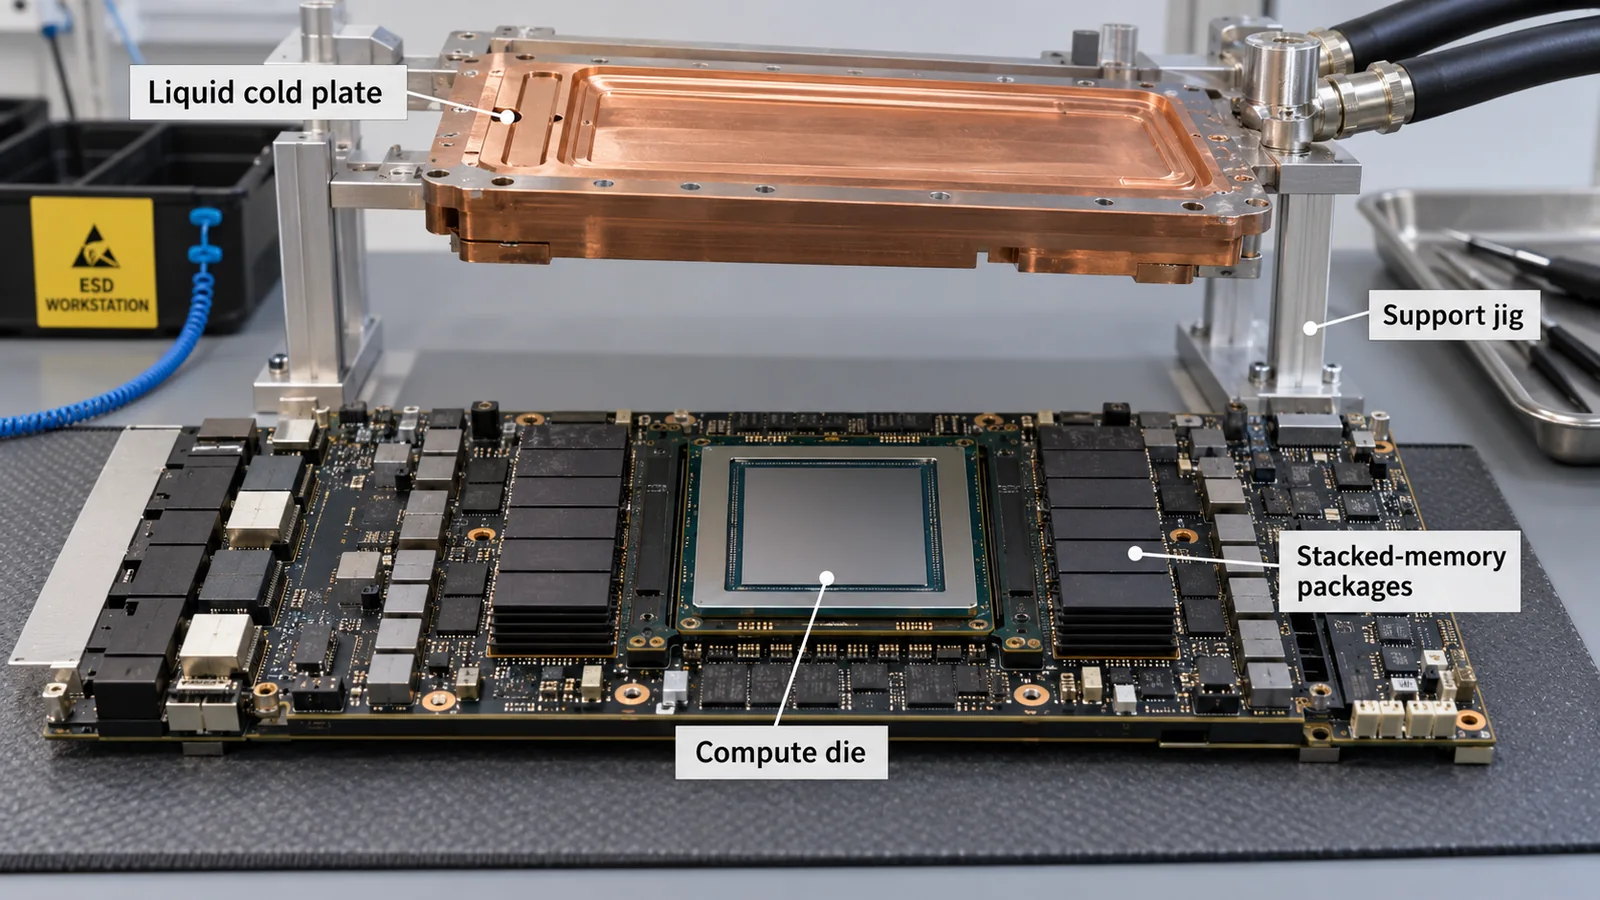
| 図2〜図6が実在の製品の構造やデータではなく説明のための作図であること。図1と図7がAI生成イメージであること | 本記事による注記 | 解説 |
最終更新:2026年10月15日/出典は一次情報(NVIDIA・AMD・Google Cloud・AWS・Cerebras・Microsoft の公式資料、MLCommons の発表、arXiv の論文、IEEE・OCP・JEDEC のページ)に限定しています。規格の本文は確認していません。 この分野は変化が速く、仕様・出荷状況・版は確認日(2026年10月15日)のものです。 チップ間の優劣、条件の記載のない値、素材レベルの評価、MLPerf の提出ごとの点数、規格の本文については、確認できなかったため、または優劣の断定を避けるため、記載していません。 図2〜図6はベクター作図、図1と図7はAI生成イメージであり、いずれも実在の施設・製品・測定結果を示すものではありません。