TECHNOLOGY EXPLAINER
エッジAIとオンデバイスAI
― 「何TOPSか」より先に、「メモリは何GB、帯域は何GB/sか」を見る
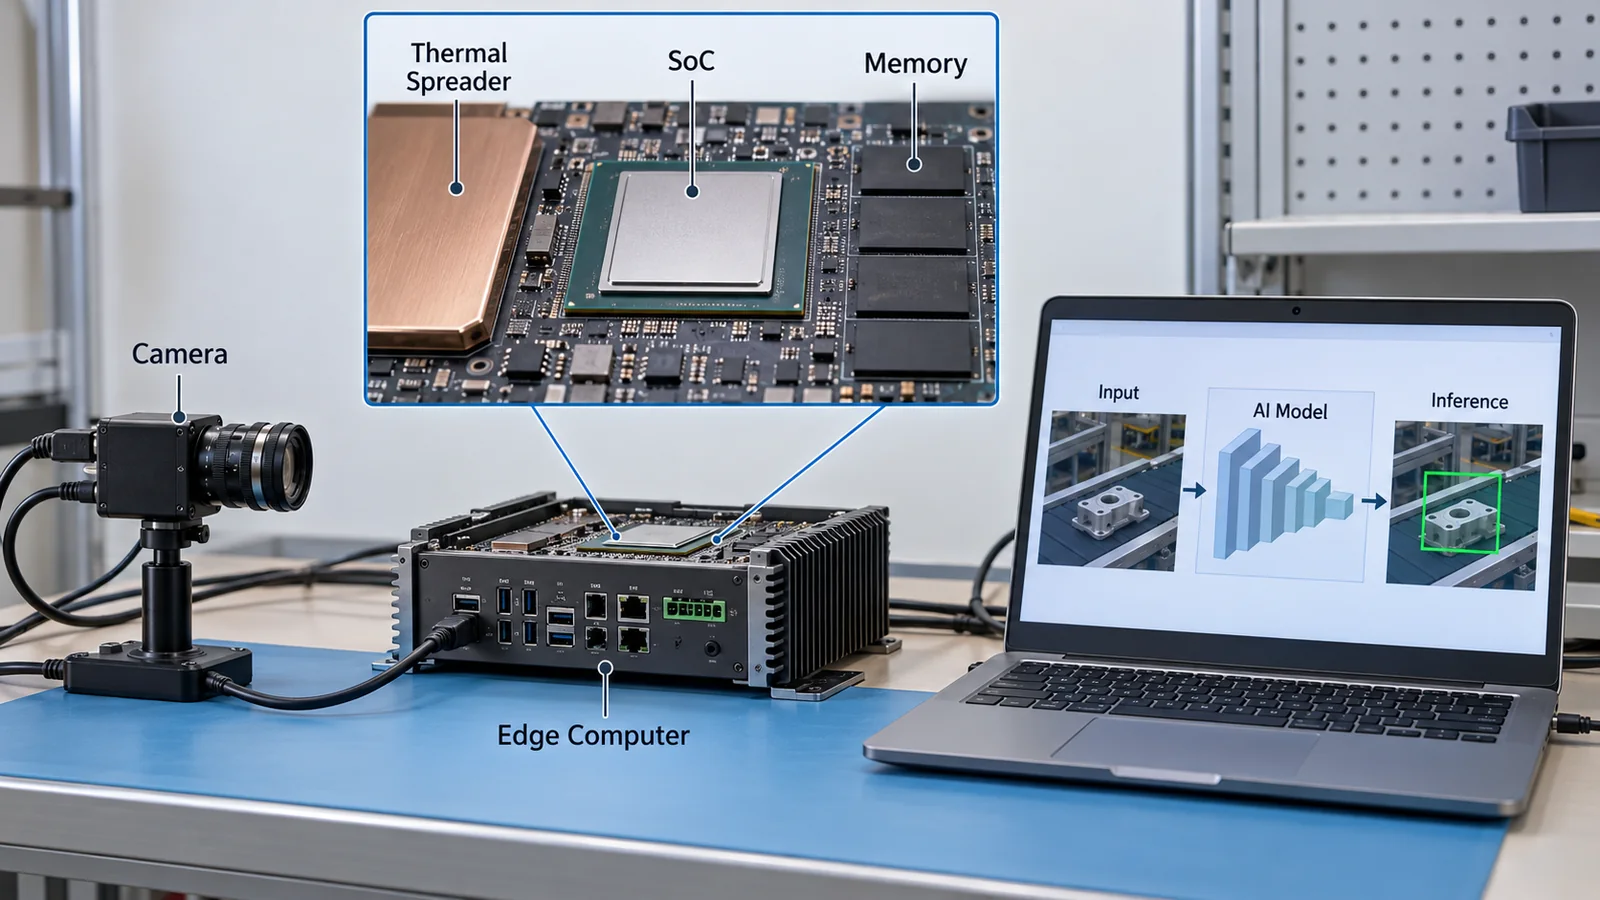
スマートフォンやAI PC、組み込み機器の中でAIを動かすエッジAI(オンデバイスAI)は、クラウドに送らず端末で処理することで、遅延、通信、プライバシーの面で別の選択肢になります。一方で、NPUの「TOPS」は大きく書かれていても、小さな言語モデルの文章生成の速さを決めているのは、多くの場合メモリの容量と帯域です。この記事では、NPU・小型モデル・量子化・メモリ・電力・プライバシーを、Microsoft・Qualcomm・Apple・Arm・NVIDIA・Hailo などの公式資料の範囲で整理し、本稿の計算で数字の感覚をつかみます。製品や企業の優劣は論じません。
- エッジAI・オンデバイスAIとは(3行でつかむ)
- どこで動かすか ― 端末の種類と、公称値の見取り図
- NPUとTOPS ― 何を数えた数字か
- メモリが決める ― 容量と帯域
- 小型モデルと「小さくする」工夫 ― 量子化、KVキャッシュ、フラッシュ
- 電力と熱 ― 端末では「ワット」が最初の制約
- プライバシーとデータ ― 「端末内」の意味と限界
- 素材技術者の視点:工場・研究所のエッジAI ― 小さな機器で、現場のデータを現場で処理する
- 限界と、確認できなかったこと
- 評価・標準の読み方
- 用語集
- 参考資料(一次情報)
- 主張と出典の対応表(監査)
事実=公表資料に記載のある内容(出典リンクあり)
本稿の計算=明示した前提をもとに本記事が算出した値
未確定/将来=計画・予定・提案であり、実績や確定が確認できていない事項
このほか、読み取りや整理は「解説」として区別しています。推測は太字で示します。
TOPS、メモリ帯域、消費電力は、メーカーの公称値です。TOPS は「1秒あたり何兆回の演算」のピーク値で、どの数値精度(INT8 など)で、疎性(sparsity)を使った値かが製品ごとに違い、実際の速さを示しません。モデルの速さ・サイズは、各社・各論文が自社の条件で報告した値です。製品や企業の優劣は論じません。将来の製品・機能は「未確定/将来」として扱います。本稿の計算は、単純な上限の見積もりで、実機の性能の予測ではありません。
1. エッジAI・オンデバイスAIとは(3行でつかむ)
- 端末の中でAIを動かすこと:クラウドのサーバーではなく、スマートフォン、PC、組み込み機器、工場の機器の内部(エッジ)で推論します。Apple は、約30億パラメータのオンデバイスのモデルと、Private Cloud Compute 上のサーバーモデルを組み合わせる設計を公開しています事実[参考資料4][参考資料5]
- TOPS は入口の数字:Microsoft は Copilot+ PC の条件として「40+ TOPS の NPU、16 GB のメモリ、256 GB のストレージ」を挙げています事実[参考資料1]。しかし、小型モデルの文章生成は、重みを毎トークン読み出すため、メモリの帯域で上限が決まります(第4章の本稿の計算)本稿の計算
- 小さくする工夫が中心:小型モデル、量子化(Apple は2ビット)、KVキャッシュの削減、重みをフラッシュに置いて必要なぶんだけメモリに読み込む設計、などが公式資料で報告されています事実[参考資料3][参考資料5][参考資料6]
端末のAIは、「NPUが速いか」より先に、「モデルが何GBで、メモリが何GB/sで読み出せるか」で速さの上限が決まります。同じ45 TOPSの NPU でも、メモリ帯域が違えば、文章を作る速さの上限は変わります(第4章)。TOPS はピーク値で、精度・疎性・測り方が製品ごとに異なります。
2. どこで動かすか ― 端末の種類と、公称値の見取り図
エッジAIの機器は、電力もメモリも桁違いに幅があります。Arm の Ethos-U85 は、Cortex-M(マイコン)や Cortex-A の機器向けの NPU の設計(IP)で、128〜2,048個の積和演算器(MAC)の構成で、1 GHz のとき最大4 TOPS、トランスフォーマーネットワークの直接の対応をうたっています事実[参考資料12]。Hailo-8 は M.2 や PCIe のモジュールで、最大26 TOPS、標準的な消費電力2.5 W としています事実[参考資料14]。NVIDIA の Jetson AGX Orin は最大275 TOPS(疎なINT8)、15〜60 W、メモリ帯域204.8 GB/s です事実[参考資料13]。PC では、Qualcomm の Snapdragon X が最大45 TOPS、LPDDR5x で最大135 GB/s、Snapdragon X2 Elite が80〜85 TOPS、最大152〜228 GB/s とされています事実[参考資料2]。
| 機器の例 | 公称値(出典の記載) | 読むときの注意 |
|---|---|---|
| マイコン向け NPU(Arm Ethos-U85) | 128〜2,048 MAC、1 GHz で最大4 TOPS、トランスフォーマーに対応、前世代より約20%省エネ(Arm の記載)[12] | IP(設計)で、実際の性能はメモリや組込み先の構成で決まる。ページには注記がない |
| 組み込みアクセラレータ(Hailo-8) | 最大26 TOPS、標準的な消費電力2.5 W、M.2・PCIe(Hailo の記載)[14] | ピークのTOPSと標準消費電力を割った値は、同じ条件の測定ではない |
| 組み込みモジュール(Jetson AGX Orin) | 最大275 TOPS(疎なINT8)、15〜60 W、64 GB・256ビット LPDDR5、204.8 GB/s(NVIDIA の記載)[13] | 疎性ありの値。密な値は、ページでは一部の行にしか記載がない |
| PC(Snapdragon X/X2 Elite) | X:最大45 TOPS・LPDDR5x 最大135 GB/s。X2 Elite:80〜85 TOPS・152〜228 GB/s(Qualcomm の記載)[2] | 同じシリーズでも型番でTOPSとメモリ帯域が異なる。NPU がその帯域をすべて使えるとは限らない |
すべて事実(各社の公式ページの記載・メーカー公称値。確認日 2026年10月15日)。
3. NPUとTOPS ― 何を数えた数字か
NPU(neural processing unit)は、ニューラルネットワークの行列演算を、CPUやGPUより少ない電力で行うために作られた演算器です。TOPS(tera operations per second)は、「1秒あたり何兆回の演算ができるか」のピーク値で、どの数値精度で数えたか(INT8、INT4、FP16 など)と、疎性(すべての数のうち一部が0であることを使った高速化)を使った値かで、同じNPUでも数字が変わります。NVIDIA の Jetson のページは、全体のAI性能を「疎なINT8」のTOPSで表し、密な値は一部の行にだけ併記しています事実[参考資料13]。Hailo は、TOPS の条件の注記をページに載せていません事実[参考資料14]。
TOPS は、PCの条件づけにも使われます。Microsoft は、Copilot+ PC の最小条件として、40+ TOPS の NPU、16 GB の DDR5/LPDDR5 メモリ、256 GB の SSD/UFS を挙げ、現在これに当てはまるのは AMD Ryzen AI 300・400 シリーズ、Intel Core Ultra 200V・300V シリーズ、Snapdragon X シリーズだとしています。ページは「これらの条件は時間とともに変わりうる」と断っています事実[参考資料1]。この「40+ TOPS」は Microsoft の製品の条件で、国際規格ではありません。
ISO/IEC は、機械学習の演算装置の全体像を整理した技術報告 ISO/IEC TR 17903:2024「Overview of machine learning computing devices」を発行しています(ISO の規格一覧で確認、確認日 2026年10月15日)事実[参考資料20]。本文は未確認で、題名を確認したにとどまります。
4. メモリが決める ― 容量と帯域
小さな言語モデルの文章生成(デコード)は、1トークンごとに重みをメモリから全部読み出します(本シリーズ「推論の最適化とサービング」編の整理)。だから速さの上限は、帯域 ÷ 読み出すバイト数で決まり、モデルを小さくする(量子化)ことは、そのまま速さの上限を上げることです。Microsoft の Phi-3 の報告は、3.8Bパラメータの phi-3-mini を4ビットに量子化すると約1.8 GBのメモリに収まり、iPhone 14(A16 Bionic)で端末内で完全にオフラインで動かして、毎秒12トークン超を得たと述べています(同社の報告)事実[参考資料6]。
| モデル(パラメータ数) | 16ビット | 8ビット | 4ビット |
|---|---|---|---|
| 1B | 2.0 GB | 1.0 GB | 0.5 GB |
| 3B | 6.0 GB | 3.0 GB | 1.5 GB |
| 8B | 16.0 GB | 8.0 GB | 4.0 GB |
すべて本稿の計算(重みだけ。パラメータ数×ビット数÷8、1 GB=10^9バイト)。埋め込み表のビット数の違い、量子化の追加データ(スケールなど)、KVキャッシュ、アプリの領域は含みません。
本稿の計算 モデル:8Bのモデルを4ビットにすると重みは 4.0 GB。KVキャッシュは、Llama 3 8B の構成(32層、Key/Value ヘッド8、ヘッド次元128)事実[参考資料22]で、8ビットのKVとすると1トークン 2×32×8×128×1 = 65,536バイト、8,192トークンで約0.54 GB。合計 約4.54 GB を1トークンごとに読む、と置きます。
上限:帯域 ÷ 約4.54 GB。Snapdragon X(最大135 GB/s)事実[参考資料2]では約30トークン/秒、Snapdragon X2 Elite の最大構成(最大228 GB/s)では約50トークン/秒。3Bの4ビット(1.5 GB)なら、135 GB/s で約90、228 GB/s で約152トークン/秒です。
演算の側の上限:8Bは1トークンあたり約 2×8×10^9 = 160億回の演算。45 TOPS のピークなら約2,812 トークン/秒で、メモリ側の上限(約30)の約95倍です。つまり、この条件では演算ではなくメモリが律速です。
前提と限界:NPU がSoCのメモリ帯域をすべて使えること、重みがすべてメモリ上にあること、帯域をピークで使い切ることを仮定した上限の見積もりです。実際はCPU・GPUとの帯域の分け合い、キャッシュ、スケジューリングで、これより遅くなります。TOPS の精度・疎性の条件が不明なため、演算側は目安にとどまります。また、Phi-3 の報告値(4ビット約1.8 GB、毎秒12トークン超)から逆算すると、重みの読み出しだけで最低約22 GB/s が実際に使われた計算になります(1.8 GB × 12/秒)。
5. 小型モデルと「小さくする」工夫 ― 量子化、KVキャッシュ、フラッシュ
小型モデル。Microsoft の phi-3-mini は3.8Bパラメータで、報告では3.3兆トークンで学習しており、「スマートフォンに載せられる大きさ」と述べています事実[参考資料6]。Meta は MobileLLM で、10億未満のパラメータでも、深く細い構造、埋め込みの共有、グループ化クエリ注意などの設計が精度に効くと報告しています事実[参考資料8]。Google の Gemma 3 は1〜27Bパラメータで、長文でKVキャッシュのメモリが爆発的に増える問題に対し、局所注意の層と全体注意の層の比率を変えてKVキャッシュを減らす設計に変えたと述べています事実[参考資料7]。
量子化。重みを少ないビットで表す方法です。GPTQ は生成型の事前学習済みTransformer向けの事後量子化(再学習なし)の手法事実[参考資料9]、AWQ は、重みの一部がより重要だという観察にもとづき、活性化を見て重みを量子化する手法です事実[参考資料10]。数値形式については、AMD・Arm・Intel・Meta・Microsoft・NVIDIA・Qualcomm が共同で、OCP Microscaling Formats(MX)仕様 第1版(2023年9月)を公開し、FP8・FP6・FP4・INT8 の要素形式と、ブロックごとの共有スケールを定めました事実[参考資料11]。量子化の詳細は本シリーズ「モデルの効率化」編で扱います。
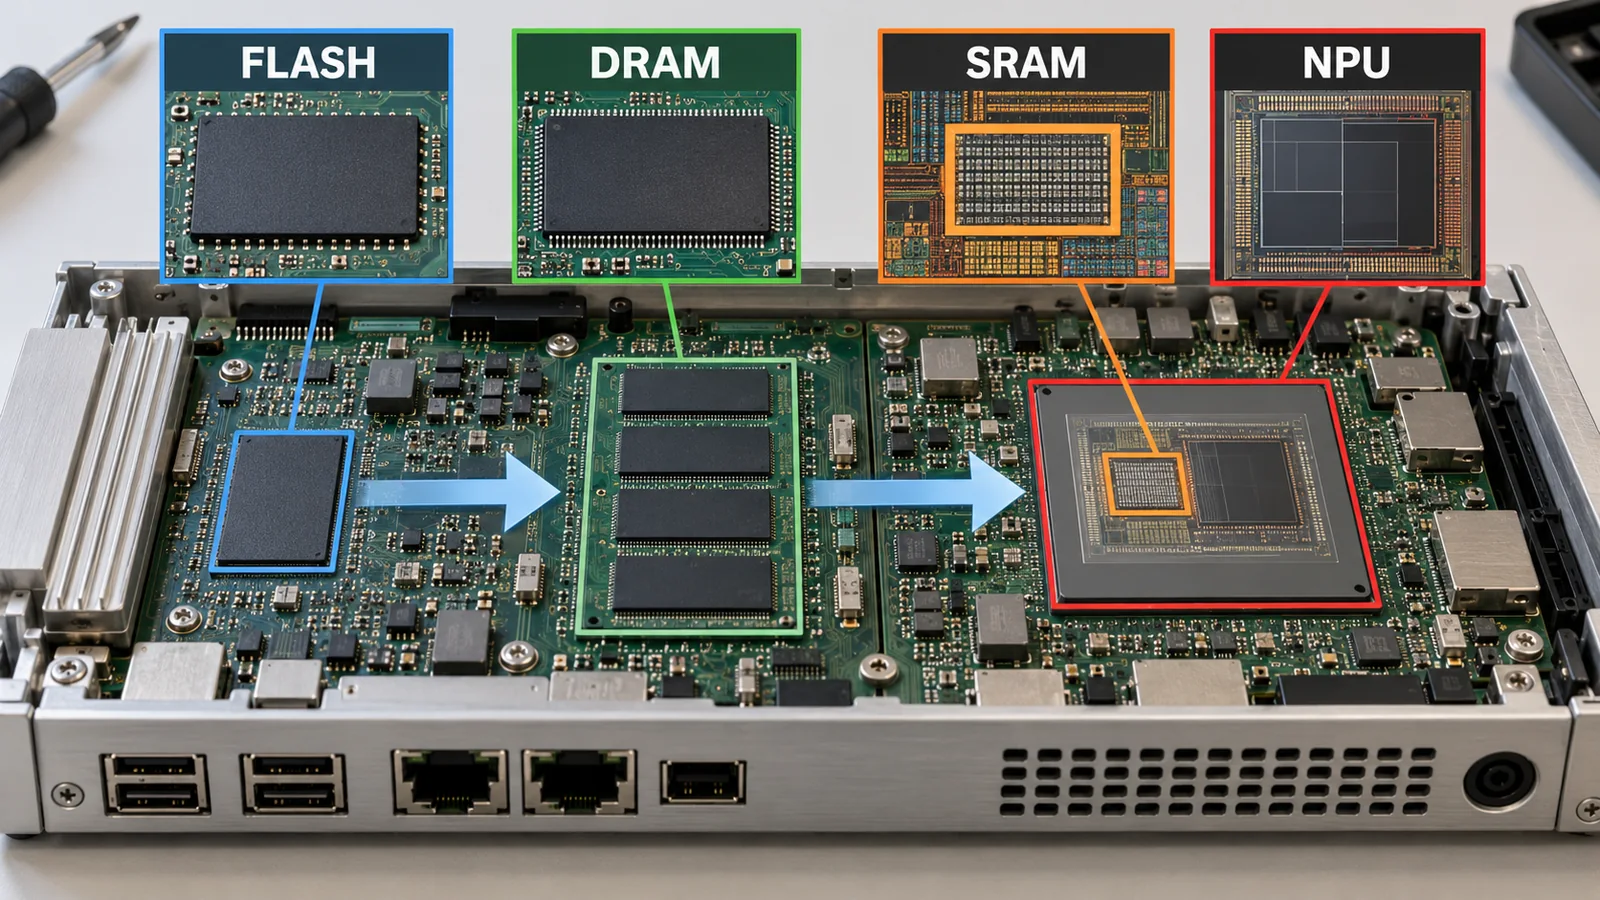
Apple の例(企業の公開資料)。Apple の2025年の技術報告は、約30億パラメータのオンデバイスモデルについて、(1) モデルを2つのブロックに分け、後ろの37.5%の層でKey/Valueの投影を持たず前のブロックのKVキャッシュを共有することで、KVキャッシュのメモリを37.5%減らし、最初のトークンまでの時間も約37.5%短縮、(2) 量子化を考慮した学習(QAT)で重みを2ビットに圧縮、(3) 埋め込み表を4ビット、KVキャッシュを8ビットに、(4) 失われた品質を回復する低ランクアダプタ、を述べています事実[参考資料5]。2026年6月8日の Apple のページは、第3世代の基盤モデルを発表し、オンデバイスモデルは AFM 3 Core(30億パラメータの密なモデルの次世代)と AFM 3 Core Advanced(200億パラメータのスパースなモデルで、1回に10〜40億パラメータを使う)で、モデル全体をフラッシュメモリ(NAND)に置き、必要な専門家だけをDRAMに読み込む設計だと述べています(同社の記載・設計)事実[参考資料3]。技術報告は「今夏後半に公開する」とされ、2026年10月15日時点では確認できませんでした。
元のSVG模式図・数値・出典注記を見る
本稿の計算 AFM 3 Core Advanced は、200億パラメータで、1回に10〜40億パラメータを使うと Apple は記しています事実[参考資料3]。Apple はビット数を公表していません。仮に4ビットなら 200億×4÷8 = 10 GB、仮に2ビットなら 5 GB です。16 GB のメモリの機器で全体を載せるのが難しい大きさで、Apple が全体をフラッシュに置き、必要な専門家だけを読み込む設計にした理由と整合します(これは本稿の解説で、Apple が理由を述べたものではありません)。
端末の速さの上限を決めるのは、DRAMの帯域と、フラッシュ(NAND)から読み込む速さです(第4・5章)。帯域は、メモリチップとプロセッサのあいだの配線とパッケージで決まります。LPDDR は、スマートフォンやPCのために消費電力を抑えたDRAMの規格群で、JEDEC は2025年7月9日に LPDDR6(JESD209-6)を公開し、2つのサブチャネル構成や低電圧の電源、低帯域用の効率モードなどを挙げ、対象にモバイルとAI、エッジAIを含めています事実[参考資料21]。
素材技術者にとっての含意は、モデルを小さくする(量子化)ことが、メモリチップの数・積層・実装面積・消費電力を減らす方向に効く一方、端末の薄さ・放熱・コストの制約の中でメモリを増やすのは、材料とパッケージの課題だという点です。AIの機能が増えるほど、メモリの容量が機種の価格帯を分ける要因になりうる、という見方もありますが、それは本記事の推測です(出典なし)。本シリーズ「HBM」編が扱うデータセンターのメモリとは構造が違いますが、帯域と容量が性能の天井を決める点は共通です。
6. 電力と熱 ― 端末では「ワット」が最初の制約
端末は、バッテリーと放熱の制約から、データセンターのような電力を使えません。公称値を見ると、Hailo-8 の標準消費電力は2.5 W事実[参考資料14]、Jetson AGX Orin は15〜60 W事実[参考資料13]と、機器ごとに大きな差があります。Arm は Ethos-U85 を、前世代の Ethos-U55・U65 より約20%省エネだと述べています(Arm の記載)事実[参考資料12]。これらの消費電力は機器全体か、アクセラレータだけか、どの負荷かが条件で、横並びの比較には使えません。
1トークンあたりのエネルギー[J] = 電力[W] ÷ 速さ[トークン/秒]。本稿の計算 仮に、AI処理に8 W、毎秒25トークンなら 0.32 J/トークン、1 Wh(=3,600 J)で約11,250 トークンです。
前提と限界:8 Wと25トークン/秒は完全に仮定の値で、特定の製品の性能ではありません。画面、通信、他のアプリの電力は含みません。目的は、「速さを上げても電力が同じなら1トークンのエネルギーは下がるが、電力も上がれば下がらない」という見方を示すことです。
持続的な性能(熱で速度が落ちずに長く続けられるか)や、実機の電力あたりの速さは、公式資料の範囲では確認できませんでした。この点は、第9章の評価(MLPerf Mobile・Client の電力・持続性)で見るのが筋です。
7. プライバシーとデータ ― 「端末内」の意味と限界
オンデバイスAIの利点としてよく挙げられるのは、データを端末の外に送らずに済む場合があることです。Apple は、基盤モデルの学習に利用者の私的な個人データや操作を使わない、サーバー側の処理は Private Cloud Compute で行い、利用者のデータは保存も共有もされない、と述べています(同社の方針・保証の記載)事実[参考資料3]。同じページは、端末内のモデルと Private Cloud Compute 上のモデルを使い分ける構成です。
| 処理する場所 | データの動き(一般論) | 評価で確認すること |
|---|---|---|
| 端末内のみ | 入力と結果が端末の外に出ない設計にできる | 実際にネットワーク通信が発生しないか、ログや診断データの送信、端末を失ったときの保護 |
| 端末+専用のクラウド(例:Private Cloud Compute) | 難しい処理だけを外に出す。どの処理がどちらで動くかは設計と設定による | どの条件で外に出るか、利用者への表示、保存の有無(企業の説明を確認) |
| クラウドのみ | 入力が事業者のサーバーに送られる | 契約・規約、保存期間、学習への利用の有無 |
第2列の整理は本稿の解説(一般論)で、特定の製品の保証ではありません。Apple の記載は同社の方針・保証として引用しました。
「端末内で処理する」ことは、個人情報保護や各国のAI規制の義務を自動的に不要にするものではありません。個別の法令の適用は、本稿の対象外(本シリーズ「EU AI法」「米国・中国・日本のAI政策」編を参照)で、本稿は法的助言をしません。
8. 素材技術者の視点:工場・研究所のエッジAI ― 小さな機器で、現場のデータを現場で処理する
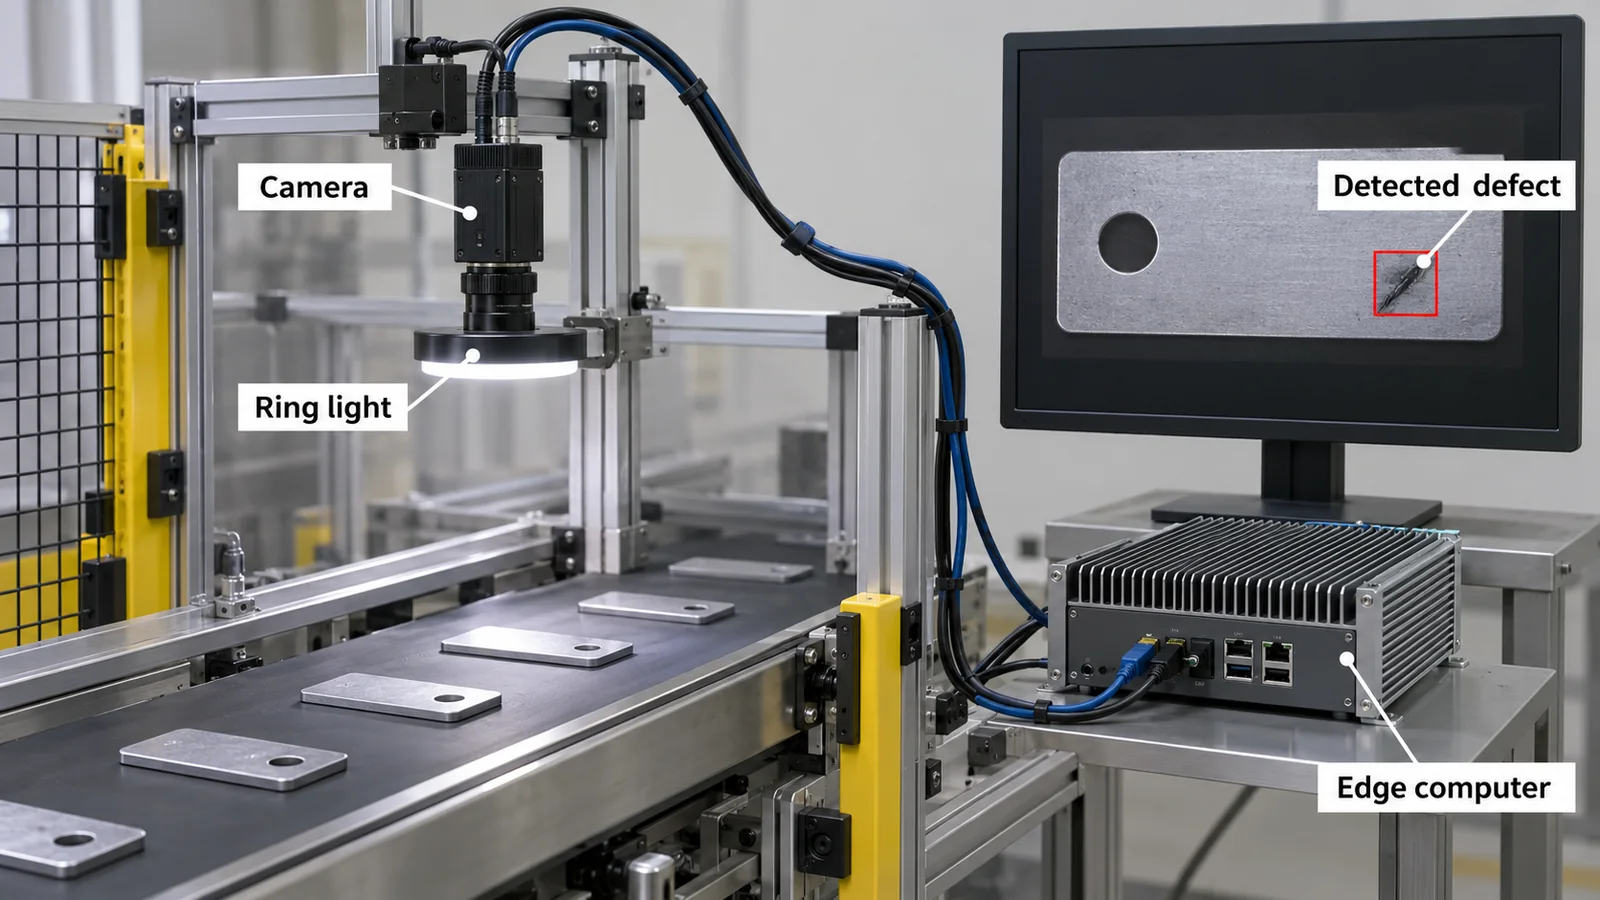
製造や分析の現場では、カメラの画像、振動や電流のセンサー、顕微鏡や分光計のデータなど、現場で毎秒大量に出るデータがあります。これを全部クラウドに送らず、現場の小さな機器で処理するのが、組み込み・産業用のエッジAIです。Arm の Ethos-U85 は、公式ページで、モーターやロボットの高速コントローラーなどの産業用IoTを用途に挙げています事実[参考資料12]。Hailo-8 は M.2・PCIe のモジュールで、既存の機器に追加できる形です事実[参考資料14]。
評価は実機で:量子化や小型化で、モデルの精度が変わることがあります。MLPerf Mobile は、画像分類や物体検出などで「FP32の参照の約93〜98%」のように精度の目標を決めています事実[参考資料15]。自社の画像・信号で、実際に載せる機器とビット数で評価し直すのが筋です(本記事による解説)。
安全に関わる使い方:人や設備の安全に関わる機能にAIを使う場合の機能安全は、ISO/IEC TR 5469:2024「Artificial intelligence — Functional safety and AI systems」が扱っています(ISO の規格一覧で題名を確認。本文は未確認)事実[参考資料20]。AIを安全機能の主役にする設計は、本稿の範囲を超えるため、規格と専門家の確認が必要です。
データの質と再現性:現場のデータは、照明、汚れ、装置の個体差、材料のロット差で分布が変わります。ISO/IEC 5259 シリーズ(AI・機械学習のためのデータ品質)が、データ品質の測定・管理・ガバナンスの規格群として発行されています(題名を確認)事実[参考資料20]。AIを入れる前に、データの測り方と保存を整えることが、小さな機器でも大きな機器でも同じく効きます(本記事による解説)。
AIを材料開発・自律実験室に使う話は、本シリーズ「マテリアルインフォマティクス」編で、ロボットの機構やドローンは「ドローン・ロボティクス」編で扱います。
9. 限界と、確認できなかったこと
- 実機の性能:文章生成の速さ、電力、持続性能の実測は載せていません。本稿の計算は、メモリ帯域を使った上限の見積もりです。MLPerf の個別の提出結果や、各社の端末の比較は、設定が揃わないため載せていません
- TOPS の条件:Qualcomm の Snapdragon X2 Elite のページで、TOPS の測定条件の注記(脚注)は、取得できたテキストに記載がありませんでした。Arm と Hailo のページにも注記がありません。精度・疎性は不明です
- Apple の第3世代モデル:2026年6月8日のページの記載(同社の主張・設計)を引用しましたが、技術報告は確認できず、モデルのビット数や文脈長は不明です
- 規格の本文:ISO/IEC TR 17903:2024、TR 5469:2024、ISO/IEC 25059:2023、TS 4213:2022 などは題名のみを確認し、本文は未確認です。JEDEC LPDDR5X の速度の規格値は、本文を確認できなかったため記載していません
- 扱っていない領域:スマートフォンの熱設計、電池、センサーの材料、自動運転の車載コンピューター(本シリーズ「自動運転とAI」編)、ウェアラブル、ロボットの機構などは詳しく扱っていません
- 端末のAIの速さの上限は、多くの場合メモリ帯域が決めます。8Bの4ビットモデルでは、本稿の計算で、45 TOPS の演算上限はメモリ側の上限の約95倍でした本稿の計算
- TOPS は条件つきのピーク値で、Microsoft の Copilot+ PC の「40+ TOPS」は製品の条件、国際規格ではありません事実
- 小さくする工夫が中心です。Apple は2ビットのQAT、KVキャッシュ共有(37.5%減)、第3世代ではフラッシュからの専門家の読み込みを述べています(企業の公開資料)事実
- 電力は機器ごとに桁違い(Hailo-8は標準2.5 W、Jetson AGX Orinは15〜60 W)で、公称値は条件が違います事実
- 評価は MLPerf Mobile・Client・Tiny が中心で、機能安全やデータ品質は ISO/IEC の技術報告・規格が別にあります事実
10. 評価・標準の読み方
エッジAIの性能は、(1) 遅延・スループット(最初のトークンまでの時間、トークン/秒、画像の処理時間)、(2) 精度(参照モデルに対する割合)、(3) 電力・エネルギー、(4) メモリ・ストレージ、で評価します。公開の枠組みとして、MLCommons が、端末向けの MLPerf Mobile、PC 向けの MLPerf Client、マイコン級の MLPerf Tiny を運営し、データセンター向けの MLPerf Inference にもエッジのテストがあります。
| 評価項目 | 代表的なベンチマーク・評価手法(名称・版・出典) | 標準・指針 | 読み方の注意 |
|---|---|---|---|
| スマートフォン・端末のAI(遅延・精度) | MLPerf Mobile(MLCommons):ページの表示で多くのタスクが v6.0。LLM(Llama 3.1 8B Instruct、Llama 3.2 3B Instruct、TinyMMLU・IFEval-33)、Stable Diffusion 1.5、物体検出、セグメンテーションなど。単一ストリームが基本、精度の目標つき(例:Llama 3.2 3B は TinyMMLU で FP16 の約59%水準)[15]事実。設計は Reddi ら(arXiv 2012.02328)[18] | ISO/IEC TR 17903:2024(機械学習の演算装置の概観)、ISO/IEC TS 42119-2:2025(AIのテストの概観)、ISO/IEC TR 42106:2026(AIシステムの品質特性の差別化されたベンチマークの概観)。いずれも題名のみ確認[20]事実 | 提出の条件(端末・OS・ソフト)と版で数字が変わる。「精度の目標」は、そのタスクの指標での話 |
| PCのAI(TTFT・トークン/秒) | MLPerf Client v2.0(MLCommons):LLM(Llama 3.1 8B Instruct、Phi 4 Mini Instruct、Phi 4 Reasoning 14B、Qwen 3 8B〔実験的〕)、画像生成、エージェント処理。指標は TTFT と TPS。Windows 11(x86-64・Arm)、macOS、iPadOS[16]事実 | Microsoft の Copilot+ PC の条件(40+ TOPS、16 GB、256 GB)は製品の条件で、国際規格ではない[1]事実 | 比較対象は同じ版・同じモデル・同じ精度に。実行基盤(NPU・GPU・CPU)の選択が結果を変える |
| マイコン級(遅延・エネルギー) | MLPerf Tiny(MLCommons):ページは v1.4 を最新の回、表は v1.3 と表示(ページ内で不一致)。画像分類(CIFAR-10・ResNet)、人物検出、キーワード検出、異常検知、ストリーミングのウェイクワード。遅延と、任意でエネルギー[17]事実。設計は Banbury ら(arXiv 2106.07597)[19] | 確認できなかった(マイコン級のAIの性能を定める国際規格) | エネルギーは任意の提出項目。測定範囲(チップだけか、ボードか)を確認する |
| エッジのエージェント処理 | MLPerf Inference v6.1(2026年9月16日)で、複数ターンのエージェント処理(コーディングなど)を端末で測るエッジのテストが追加[23]事実 | 確認できなかった | データセンター向けの枠組みの中のエッジ部門。端末向けの MLPerf Mobile・Client とは別体系 |
| 信頼性・安全・データ品質 | 確認できなかった(個別の機器の適合結果) | ISO/IEC TR 5469:2024(機能安全とAI)、ISO/IEC TR 24029-1:2021・24029-2:2023(ニューラルネットワークの頑健性の評価)、ISO/IEC 5259 シリーズ(データ品質)、ISO/IEC 25059:2023(AIシステムの品質モデル)、ISO/IEC 22989:2022(用語)。題名と版を確認[20]事実 | 技術報告(TR)は参考情報で、要求事項ではない。本文は未確認で、要求事項を推測しない |
| 数値形式・メモリ | 確認できなかった(端末のAIの精度を標準化した評価手法) | OCP Microscaling Formats (MX) Specification 第1版(2023年9月)[11]、JEDEC LPDDR6(JESD209-6、2025年7月9日)[21]事実。LPDDR5/5X は JESD209-5C(JEDEC のページで改訂を確認) | MX は仕様(業界の取り決め)で法的な拘束力はなく、採用の有無は製品ごと。JEDEC は部品の規格で、端末のAI性能の規格ではない |
| 将来の製品・機能 | Apple の第3世代モデルの技術報告「今夏後半に公開」[3]未確定/将来 | 確認できなかった | 企業の予告で、公開の有無と内容は未確認 |
区分タグは各セルに付けています。MLPerf の版・ベンチマークの構成は、MLCommons の各ページ(2026年10月15日確認)の表示です。ISO/IEC の題名・版は ISO の規格一覧(SC 42)で確認しました。表の整理は本稿によるものです。
読み方の注意は3つです。
- TOPS は入口の数字:精度、疎性、測り方が不明なピーク値は、メモリ帯域・モデルの大きさ・電力とあわせて読みます。TOPS だけで端末の速さは決まりません(第4章)
- ベンチマークは版・モデル・実行基盤で変わる:MLPerf Mobile・Client はモデルとタスクが版ごとに入れ替わり、実行基盤(NPU・GPU・CPU)の選択も結果に影響します。古い版や異なる設定の数字を並べて優劣をつけません
- 標準は「用語・概観・安全・データ品質」が中心:端末のAI性能そのものを要求事項として定める国際規格は、本稿の調査では確認できませんでした。ISO/IEC の技術報告は参考情報で、法的な拘束力はありません。製品の条件(Copilot+ PC など)は企業の取り決めです
11. 用語集
- エッジAI/オンデバイスAI
- クラウドではなく、端末や現場の機器の内部でAIの推論を行うこと。
- NPU
- Neural processing unit。ニューラルネットワークの演算に特化した演算器。
- TOPS
- Tera operations per second。1秒あたり何兆回の演算かのピーク値。
- 疎性
- 一部の値が0であることを使った高速化。TOPS の値が倍になることがある。
- 量子化
- 重みなどを少ないビットで表す方法。
- QAT
- Quantization-aware training。量子化の影響を学習中に取り込む方法。
- KVキャッシュ
- 過去のトークンのKeyとValueの保存。
- LPDDR
- モバイル・PC向けの低消費電力DRAMの規格群。
- NAND(フラッシュ)
- 大容量で遅い不揮発メモリ。端末のストレージ。
- TTFT/TPS
- 最初のトークンまでの時間/トークン/秒。
- MX(Microscaling)
- ブロックごとの共有スケールと低ビット要素の数値形式の仕様(OCP)。
- 機能安全
- 機器の故障や誤動作が安全に与える影響を管理する考え方。
12. 参考資料(一次情報)
- Microsoft "Windows 11 Specs and System Requirements"(Copilot+ PC の最小条件:40+ TOPS の NPU、16 GB の DDR5/LPDDR5、256 GB の SSD/UFS、対象プロセッサ。条件は変わりうるとの注記/確認日 2026年10月15日) — microsoft.com/windows/windows-11-specifications
- Qualcomm "Snapdragon X2 Elite" 製品ページ(Snapdragon X/X Plus/X Elite/X2 の各型番のNPUのTOPSとLPDDR5xのメモリ帯域の表/確認日 2026年10月15日) — qualcomm.com/laptops/products/snapdragon-x2-elite
- Apple Machine Learning Research "Introducing the Third Generation of Apple's Foundation Models"(2026年6月8日、2026年9月9日更新。AFM 3 Core・Core Advanced、フラッシュ(NAND)から専門家をDRAMへ、Private Cloud Compute、技術報告の予告) — machinelearning.apple.com/research/introducing-third-gene...
- Apple Machine Learning Research "Updates to Apple's On-Device and Server Foundation Language Models"(2025年6月9日、7月17日更新。約30億パラメータ、2ビットQAT、プライバシーの方針) — machinelearning.apple.com/research/apple-foundation-model...
- Li E. ほか(Apple) "Apple Intelligence Foundation Language Models: Tech Report 2025", arXiv 2507.13575(KVキャッシュ共有で37.5%減、2ビットQAT、埋め込み4ビット、KV 8ビット、低ランクアダプタ) — arxiv.org/abs/2507.13575
- Abdin M. ほか(Microsoft) "Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone", arXiv 2404.14219(phi-3-mini 3.8B、4ビットで約1.8 GB、iPhone 14 で毎秒12トークン超) — arxiv.org/abs/2404.14219
- Gemma Team(Google) "Gemma 3 Technical Report", arXiv 2503.19786(1〜27B、局所注意と全体注意の比率でKVキャッシュを削減) — arxiv.org/abs/2503.19786
- Liu Z. ほか(Meta) "MobileLLM: Optimizing Sub-billion Parameter Language Models for On-Device Use Cases", arXiv 2402.14905 — arxiv.org/abs/2402.14905
- Frantar E. ほか "GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers", arXiv 2210.17323 — arxiv.org/abs/2210.17323
- Lin J. ほか "AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration", arXiv 2306.00978 — arxiv.org/abs/2306.00978
- Open Compute Project "OCP Microscaling Formats (MX) Specification", Version 1.0 (2023年9月)(AMD・Arm・Intel・Meta・Microsoft・NVIDIA・Qualcomm の共同。FP8・FP6・FP4・INT8) — opencompute.org/documents/ocp-microscaling-formats-mx-v1-...
- Arm "Arm Ethos-U85" 製品ページ(128〜2,048 MAC、1 GHz で最大4 TOPS、トランスフォーマー対応、前世代より約20%省エネ、産業用IoT/確認日 2026年10月15日) — arm.com/products/silicon-ip-cpu/ethos/ethos-u85
- NVIDIA "Jetson Orin" ページ(AGX Orin:275 TOPS〔疎なINT8〕、15〜60 W、204.8 GB/s、Orin Nano のメモリ帯域51・102 GB/s/確認日 2026年10月15日) — nvidia.com/en-us/autonomous-machines/embedded-systems/jet...
- Hailo "Hailo-8 AI Accelerator" 製品ページ(最大26 TOPS、標準的な消費電力2.5 W、M.2・PCIe/確認日 2026年10月15日) — hailo.ai/products/ai-accelerators/hailo-8-ai-accelerator/
- MLCommons "MLPerf Mobile"(Inference: Mobile)ベンチマークのページ(多くのタスクが v6.0、LLM・画像・検出、精度の目標、単一ストリーム/確認日 2026年10月15日) — mlcommons.org/benchmarks/inference-mobile/
- MLCommons "MLPerf Client" ベンチマークのページ(v2.0、LLM・画像生成・エージェント、TTFT・TPS、対応OS/確認日 2026年10月15日) — mlcommons.org/benchmarks/client/
- MLCommons "MLPerf Tiny" ベンチマークのページ(v1.3/v1.4、5タスク、遅延と任意のエネルギー/確認日 2026年10月15日) — mlcommons.org/benchmarks/inference-tiny/
- Reddi V. J. ほか "MLPerf Mobile Inference Benchmark", arXiv 2012.02328 (2020) — arxiv.org/abs/2012.02328
- Banbury C. ほか "MLPerf Tiny Benchmark", arXiv 2106.07597 (2021) — arxiv.org/abs/2106.07597
- ISO/IEC JTC 1/SC 42 SC 42「Artificial intelligence」の規格一覧(ISO/IEC TR 17903:2024、TR 5469:2024、TS 4213:2022、5259シリーズ、24029、25059:2023、TS 42119-2:2025、TR 42106:2026、22989:2022 ほか/確認日 2026年10月15日) — iso.org/committee/6794475/x/catalogue/p/1/u/0/w/0/d/0
- JEDEC "JEDEC Releases New LPDDR6 Standard to Enhance Mobile and AI Memory Performance"(JESD209-6、2025年7月9日) — jedec.org/news/pressreleases/jedec-releases-new-lpddr6-st...
- Grattafiori A. ほか(Meta) "The Llama 3 Herd of Models", arXiv 2407.21783(表3:8B は32層、Key/Value ヘッド8、ヘッド32、モデル次元4,096) — arxiv.org/abs/2407.21783
- MLCommons "MLCommons Sets Participation Record with New MLPerf Inference v6.1 Benchmark Results"(2026年9月16日の発表。エッジのエージェント処理のテストの追加。GlobeNewswire 配信の転載ページ) — financialcontent.com/article/gnwcq-2026-9-16-mlcommons-se...
13. 主張と出典の対応表(監査)
| 本文の主張 | 根拠 | 区分 |
|---|---|---|
| Copilot+ PC の最小条件(40+ TOPS の NPU、16 GB の DDR5/LPDDR5、256 GB の SSD/UFS)、対象プロセッサの系列、条件は変わりうるという注記 | 出典1 https://www.microsoft.com/windows/windows-11-specifications | 事実 |
| Snapdragon X(最大45 TOPS・最大135 GB/s)、X2 Plus、X2 Elite(80〜85 TOPS、最大152〜228 GB/s)の型番別の値。TOPS の注記が取得テキストに無いこと | 出典2 https://www.qualcomm.com/laptops/products/snapdragon-x2-elite | 事実 |
| Apple の第3世代モデル(AFM 3 Core・Core Advanced:30億の密、200億のスパース〔1〜4Bを使用〕)、フラッシュに全体を置き必要な専門家をDRAMへ、プライバシーの方針と Private Cloud Compute、技術報告の予告(2026年6月8日) | 技術報告は予告(未確定/将来) 出典3 https://machinelearning.apple.com/research/introducing-third-generation-of-apple-foundation-models | 未確定/将来 |
| Apple の2025年のオンデバイスモデル(約30億パラメータ、2ビットQAT)とプライバシーの記載 | 出典4 https://machinelearning.apple.com/research/apple-foundation-models-2025-updates | 事実 |
| KVキャッシュ共有(後ろの37.5%の層)でKVのメモリ37.5%減・TTFT約37.5%減、2ビットQAT、埋め込み4ビット、KV 8ビット、低ランクアダプタ | 出典5 https://arxiv.org/abs/2507.13575 | 事実 |
| phi-3-mini:3.8B、3.3兆トークン、4ビットで約1.8 GB、iPhone 14(A16)で毎秒12トークン超 | 出典6 https://arxiv.org/abs/2404.14219 | 事実 |
| Gemma 3:1〜27B、局所注意と全体注意の比率の変更でKVキャッシュを削減 | 出典7 https://arxiv.org/abs/2503.19786 | 事実 |
| MobileLLM:10億未満のパラメータで深く細い構造・埋め込み共有・グループ化クエリ注意が効くこと | 出典8 https://arxiv.org/abs/2402.14905 | 事実 |
| GPTQ(事後量子化)、AWQ(活性化を見る重み量子化) | 出典9 https://arxiv.org/abs/2210.17323 出典10 https://arxiv.org/abs/2306.00978 | 事実 |
| OCP MX 仕様 第1版(2023年9月)、共同の7社、FP8・FP6・FP4・INT8 | 出典11 https://www.opencompute.org/documents/ocp-microscaling-formats-mx-v1-0-spec-final-pdf | 事実 |
| Arm Ethos-U85:128〜2,048 MAC、1 GHz で最大4 TOPS、トランスフォーマー対応、前世代より約20%省エネ、産業用IoT | 出典12 https://www.arm.com/products/silicon-ip-cpu/ethos/ethos-u85 | 事実 |
| Jetson AGX Orin:最大275 TOPS(疎なINT8)、15〜60 W、64 GB・256ビット LPDDR5、204.8 GB/s、Orin Nano のメモリ帯域 | 出典13 https://www.nvidia.com/en-us/autonomous-machines/embedded-systems/jetson-orin/ | 事実 |
| Hailo-8:最大26 TOPS、標準的な消費電力2.5 W、M.2・PCIe、TOPS の注記なし | 出典14 https://hailo.ai/products/ai-accelerators/hailo-8-ai-accelerator/ | 事実 |
| MLPerf Mobile:多くのタスクが v6.0、LLM(Llama 3.1 8B・Llama 3.2 3B)・画像・検出、精度の目標、単一ストリーム | 出典15 https://mlcommons.org/benchmarks/inference-mobile/ | 事実 |
| MLPerf Client v2.0:モデル(Llama 3.1 8B など)、TTFT・TPS、対応OS | 出典16 https://mlcommons.org/benchmarks/client/ | 事実 |
| MLPerf Tiny:v1.3/v1.4(ページ内で不一致)、5タスク、遅延と任意のエネルギー | 出典17 https://mlcommons.org/benchmarks/inference-tiny/ | 事実 |
| MLPerf Mobile・Tiny の設計の論文 | 出典18 https://arxiv.org/abs/2012.02328 出典19 https://arxiv.org/abs/2106.07597 | 事実 |
| ISO/IEC TR 17903:2024、TR 5469:2024、TS 4213:2022、5259シリーズ、24029、25059:2023、TS 42119-2:2025、TR 42106:2026、22989:2022 の題名・版・状態(SC 42 の規格一覧) | 出典20 https://www.iso.org/committee/6794475/x/catalogue/p/1/u/0/w/0/d/0 | 事実 |
| JEDEC LPDDR6(JESD209-6、2025年7月9日)の構成と対象用途 | 出典21 https://www.jedec.org/news/pressreleases/jedec-releases-new-lpddr6-standard-enhance-mobile-and-ai-memory-performance | 事実 |
| Llama 3 8B の構成(32層、Key/Value ヘッド8、ヘッド次元128) | 出典22 https://arxiv.org/abs/2407.21783 | 事実 |
| MLPerf Inference v6.1 でエッジのエージェント処理のテストが追加されたこと | 出典23 https://www.financialcontent.com/article/gnwcq-2026-9-16-mlcommons-sets-participation-record-with-new-mlperf-inference-v61-benchmark-results | 事実 |
| 重みの大きさの表(パラメータ数×ビット数÷8)、メモリ帯域から見たトークン/秒の上限(8B・4ビット+8ビットKV 8,192トークン=約4.54 GB、135 GB/s で約30、228 GB/s で約50)、演算側の上限との比(約95倍)、Phi-3 の報告値からの逆算(約22 GB/s)、Apple の200億パラメータの仮のビット数での大きさ(10 GB・5 GB)、1トークンあたりのエネルギー(8 W・25トークン/秒の仮定) | 本稿の計算。メモリ帯域・重みの大きさに基づく上限の見積もりで、仮定(予約なし、帯域を使い切る、ビット数、8 W・25トークン/秒)を明記。実機の予測ではない | 本稿の計算 |
| 「TOPS は入口の数字」「端末のAIはメモリ・ストレージの材料と実装の問題」「現場で使うときの3つの注意」「端末内処理の意味と限界」の読み取り。メモリ需要が価格帯を分けうるという見方(推測) | 公表内容にもとづく本記事の整理・解説。各社が表明した見解ではない | 解説 |
| 実機の速さ・電力、TOPS の測定条件(注記)、Apple 第3世代モデルの技術報告、規格の本文、LPDDR5X の速度規格値 | 本稿の調査範囲では確認できなかったため記載していない。解説 | 解説 |
最終更新:2026年10月15日/出典は一次情報(Microsoft・Qualcomm・Arm・NVIDIA・Hailo・Apple の公式ページ、Phi-3・Gemma 3・MobileLLM などの論文、OCP の仕様、MLCommons のページ、ISO の規格一覧、JEDEC の発表)に限定しています。実機の速さ・電力、TOPS の測定条件、Apple 第3世代モデルの技術報告、規格の本文については、確認できなかったため記載していません。将来の製品・機能は「未確定/将来」です。図2・5はベクター作図、図3・4は本稿の計算を含む作図、図1と図6はAI生成イメージ(枠のみ)です。