主要成果
arXivで発表された最新の研究は、大規模言語モデル(LLM)エージェントシステムの構築において、深層学習の原則を適用する革新的なアプローチを提案しています。この手法を用いることで、LLMエージェントシステムは、自動プロンプト最適化を通じて少なくとも5%の性能向上を実現し、さらにニューラルアーキテクチャ探索(NAS)に匹敵するアルゴリズムでは、ランダムに設計されたアーキテクチャと比較して11%もの顕著な性能向上を達成しました。
技術詳細
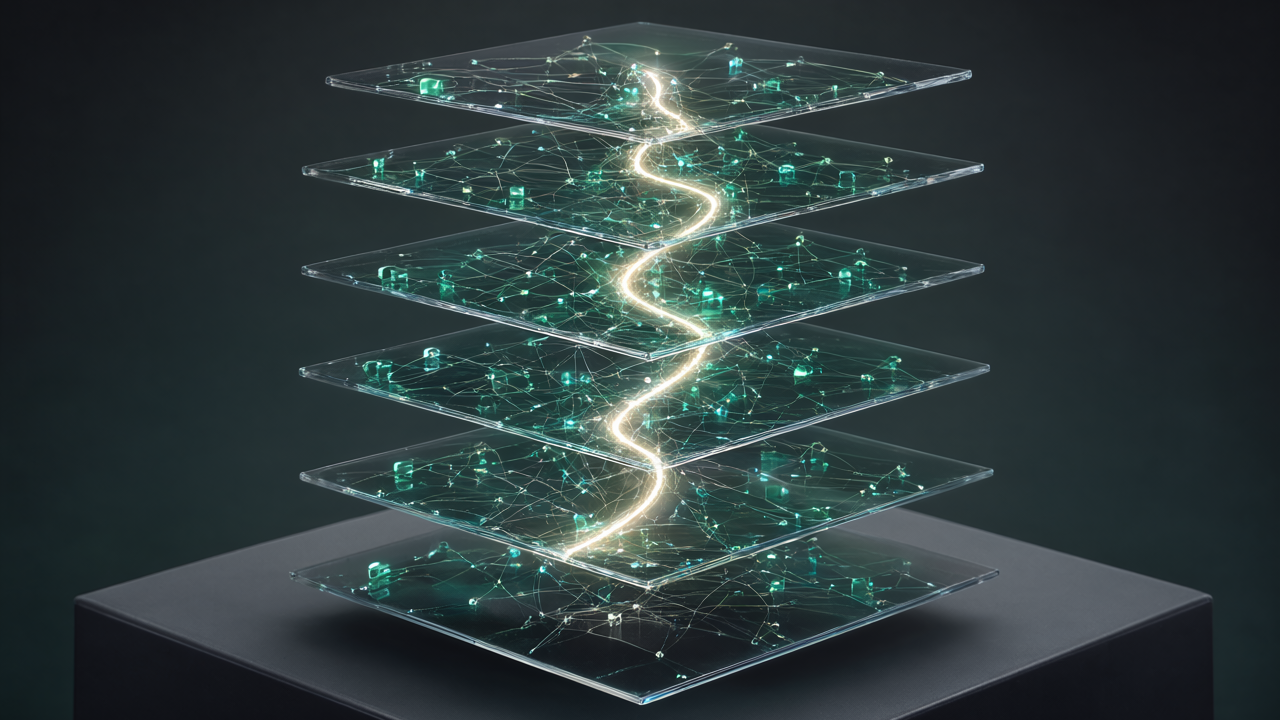
この研究では、LLMエージェントシステムの構成要素である情報検索(retrievals)、記憶(memories)、プロンプト戦略(prompting strategies)を、深層学習における多層パーセプトロン(MLPs)やアテンションメカニズムなどのモジュールと類似するものとして捉えます。これにより、モジュラー設計の原則がLLMエージェントにも適用可能であることを示しました。さらに、LLMのプロンプトを深層学習における重み(weights)と見なし、プロンプトの最適化プロセスをバックプロパゲーション(back-propagation)に例えることで、LLMのためのフォワード推論(forward inference)とフィードバックメカニズムを設計しています。このフレームワークにより、LLMモジュールを深層学習スタイルのアーキテクチャに組織化することが可能となり、実験では大幅な性能改善が確認されました。
背景・業界文脈
LLMエージェントは、複雑なタスクを自律的に実行するために注目されていますが、その設計と最適化は依然として課題です。従来のLLMエージェントはヒューリスティックな設計が多く、体系的な性能向上手法が不足していました。本研究は、深層学習がこれまでのAI分野にもたらした成功のパターンをLLMエージェントに持ち込むことで、より堅牢で効率的な開発パスを開拓します。これにより、LLMエージェントが金融、医療、製造業などの多様な産業で、より信頼性の高い自動化ツールとして機能する可能性が高まります。
今後の展望
この深層学習的アプローチは、LLMエージェントシステムの設計、最適化、およびスケーラビリティに革命をもたらす可能性があります。自動プロンプト最適化とアーキテクチャ探索の成功は、手作業によるプロンプトエンジニアリングの限界を超え、より効率的で高性能なエージェントの開発を可能にします。将来的には、人間が関与する部分を最小限に抑えながら、タスク固有の最適なLLMエージェントアーキテクチャを自律的に発見・構築するAIが実現し、これまで自動化が困難だった領域でのブレークスルーが期待されます。
元記事: https://arxiv.org/abs/2610.04961
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます