主要成果
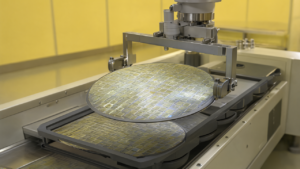
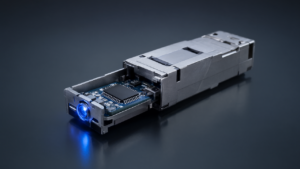
OFC 2026において、IntelはAIインフラストラクチャのスケールアップに不可欠となる光学演算インターコネクト(OCI)チップレットを発表しました。この革新的なOCIチップレットは、約5ピコジュール/ビット(pJ/b)という極めて高いエネルギー効率と、1テラビット/秒/ミリメートル(Tbps/mm)のショアライン密度を達成しています。これは、従来の800Gプラガブルモジュールが約21 pJ/bであるのと比較して、70%以上の大幅な電力削減を意味します。この成果は、インジウムリン(InP)レーザーをシリコンウェハーに直接接合するIntel独自のシリコンフォトニクス(SiPh)ヘテロジニアス集積技術によって可能となりました。
技術・臨床詳細
IntelのOCIチップレットは、データセンター内のAIアクセラレータやCPU間におけるデータ転送のボトルネックを解消するために設計されました。AIワークロードは膨大な量のデータを高速で処理する必要があり、それに伴う電力消費は大きな課題です。OCIチップレットは、光信号を用いてデータを伝送することで、電気信号の限界を超える性能を実現します。具体的には、5 pJ/bという低いエネルギー消費は、データセンター全体の運用コストと発熱を劇的に削減します。また、1 Tbps/mmというショアライン密度は、チップエッジからの非常に高い帯域幅密度を意味し、限られた物理スペース内で最大限のデータ転送能力を確保します。この技術の核心は、異種材料であるInPレーザーを標準的なシリコンフォトニクスプラットフォームに直接統合する「ヘテロジニアス集積」にあります。InPレーザーは、シリコンでは生成できない高品質の光を生成できるため、この統合により、高性能かつ高効率な光インターコネクトが実現されます。
背景・業界文脈
AIの爆発的な成長は、データセンターのコンピューティングとネットワークインフラに前例のない要求を突きつけています。特に、大規模なAIモデルのトレーニングには、多数の処理ユニット(GPU、AIアクセラレータなど)が連携し、ペタビット級のデータを効率的にやり取りする必要があります。従来の電気配線やプラガブル光モジュールでは、消費電力、遅延、物理的スペースの面で限界に達しつつあります。Intelは、長年にわたりシリコンフォトニクスの研究開発に投資しており、このOCIチップレットはその成果の一つです。ヘテロジニアス集積技術は、異なる材料の利点を組み合わせることで、単一材料では達成できない性能を実現する、半導体業界の重要なトレンドです。Intelのこのアプローチは、AI時代におけるデータセンターの「電力の壁」と「帯域幅の壁」を突破するための戦略的な一歩と位置づけられます。
今後の展望
IntelのOCIチップレットは、AIデータセンターの将来の設計と運用に大きな影響を与える可能性を秘めています。70%以上の電力削減は、AIインフラのTCO(総所有コスト)を劇的に改善し、持続可能な大規模AIコンピューティングを可能にします。この技術の普及により、より強力で効率的なAIアクセラレータの開発が促進され、生成AI、自動運転、科学計算など、幅広い分野でのイノベーションが加速するでしょう。今後の課題としては、ヘテロジニアス集積プロセスのさらなる量産化とコスト最適化、そしてOCIチップレットと他のデータセンターコンポーネントとのエコシステム構築が挙げられます。Intelがこの分野でリーダーシップを発揮することで、AI時代のコンピューティングの未来を形作ることが期待されます。
元記事: https://www.simpletechtrend.com/en/post/ofc2026-intel-oci-siph-chiplet-scaling-en
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます