
主要成果
EVLF-FMは、広範な診断能力と微細な説明可能性(fine-grain explainability)を兼ね備えた医療用ビジョン言語基盤モデルである。内部検証における疾患診断では、既存の汎用モデルや専門モデルを上回る平均精度0.895を記録した。また、医療ビジュアルグラウンディング(画像内の関連部位を特定するタスク)においても、9つのモダリティで平均精度(Acc@0.5)0.842という妥当な性能を示した。さらに、17の追加データセットを用いた外部検証においても、モデルサイズが小さいながら競争力のあるF1スコアを維持し、ゼロショットおよび少数のサンプル(few-shot)での一貫した性能が確認されている。
技術・詳細
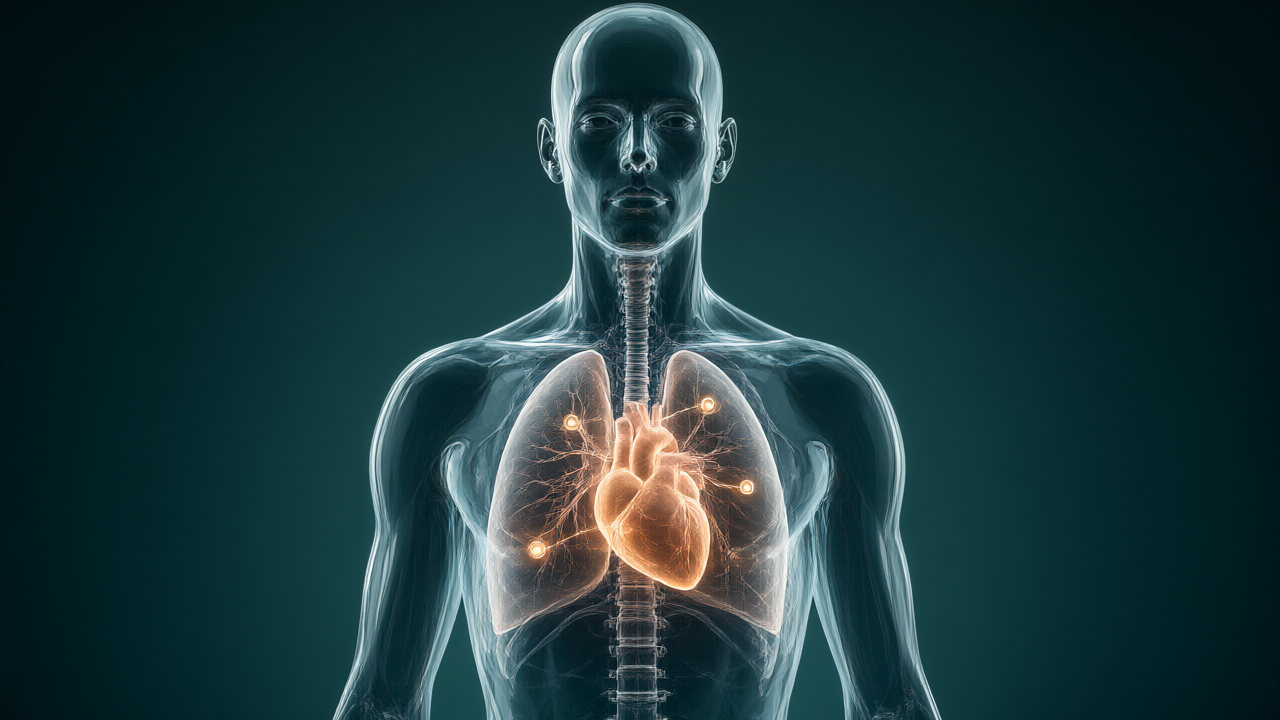
本モデルは、皮膚科、肝臓学、眼科、病理学、呼吸器科、放射線科の6つの臨床専門分野に関連する、10種類の画像モダリティ(CT、MRI、X線、超音波、PET、組織病理画像、ダーモスコピー、カラー眼底写真、OCT、内視鏡画像)からなる130万件以上のサンプルを用いて開発された。主な機能として、疾患診断、視覚的質疑応答(VQA)、および推論能力を伴うピクセルレベルのビジュアルグラウンディングをサポートしている。
技術的な特徴は、教師あり微調整(SFT)と視覚的強化微調整(RFT)を組み合わせたハイブリッド学習戦略にある。これにより、視覚的な根拠に基づいた臨床的に解釈可能な説明の生成が可能となった。この推論出力の質をS.C.O.R.E.フレームワークを用いて人間が評価したところ、5点満点中平均4.25点という高いスコアを獲得し、臨床的な解釈可能性が裏付けられた。
背景・業界の文脈
従来の医療AIは、特定の疾患のみを診断する教師あり深層学習モデルが主流であったが、現在は大規模な事前学習を行う基盤モデル(FM)へとパラダイムシフトが起きている。しかし、既存のモデルには課題が残っていた。単一モダリティのモデルは計算コストが高く拡張性に欠け、一方でマルチモーダルモデルは、臓器や腫瘍の領域を特定するセグメンテーションやビジュアルグラウンディングといったピクセルレベルの精度を要するタスクで性能が低下する傾向があった。また、多くのモデルが「ブラックボックス」であり、出力の根拠が不透明であるため、臨床現場での信頼性と透明性の確保が急務となっていた。
今後の展望
EVLF-FMは、汎用モデルの広範さと専門システムの精度・説明可能性を統合することを目指している。ただし、現状では多様なヘルスケア環境におけるさらなる検証が必要であるとしている。日常的な臨床展開に向けては、今後、安全性、有効性、および臨床的有用性を評価するための前向き臨床研究(prospective clinical studies)が不可欠であるとしている。
元記事: https://www.nature.com/articles/s41591-026-04655-5
毎週の技術動向レポートを無料でお届け
各分野の分析レポートを読む価値があるかどうか一目で判断できるインフォグラフィックをメールで受け取れます。
📢 メールマガジンに無料登録(週刊・技術動向レポート)
ご登録いただくと、Troy-Technical から週刊で技術動向レポート(メールマガジン)をお届けします。
- 取得したメールアドレス・選択分野は配信目的にのみ使用します。
- 第三者へ提供することはありません。
- 配信はいつでも解除できます(各メール下部のリンクから)。
詳しくはプライバシーポリシーをご覧ください。
登録は1分・いつでも解除できます